

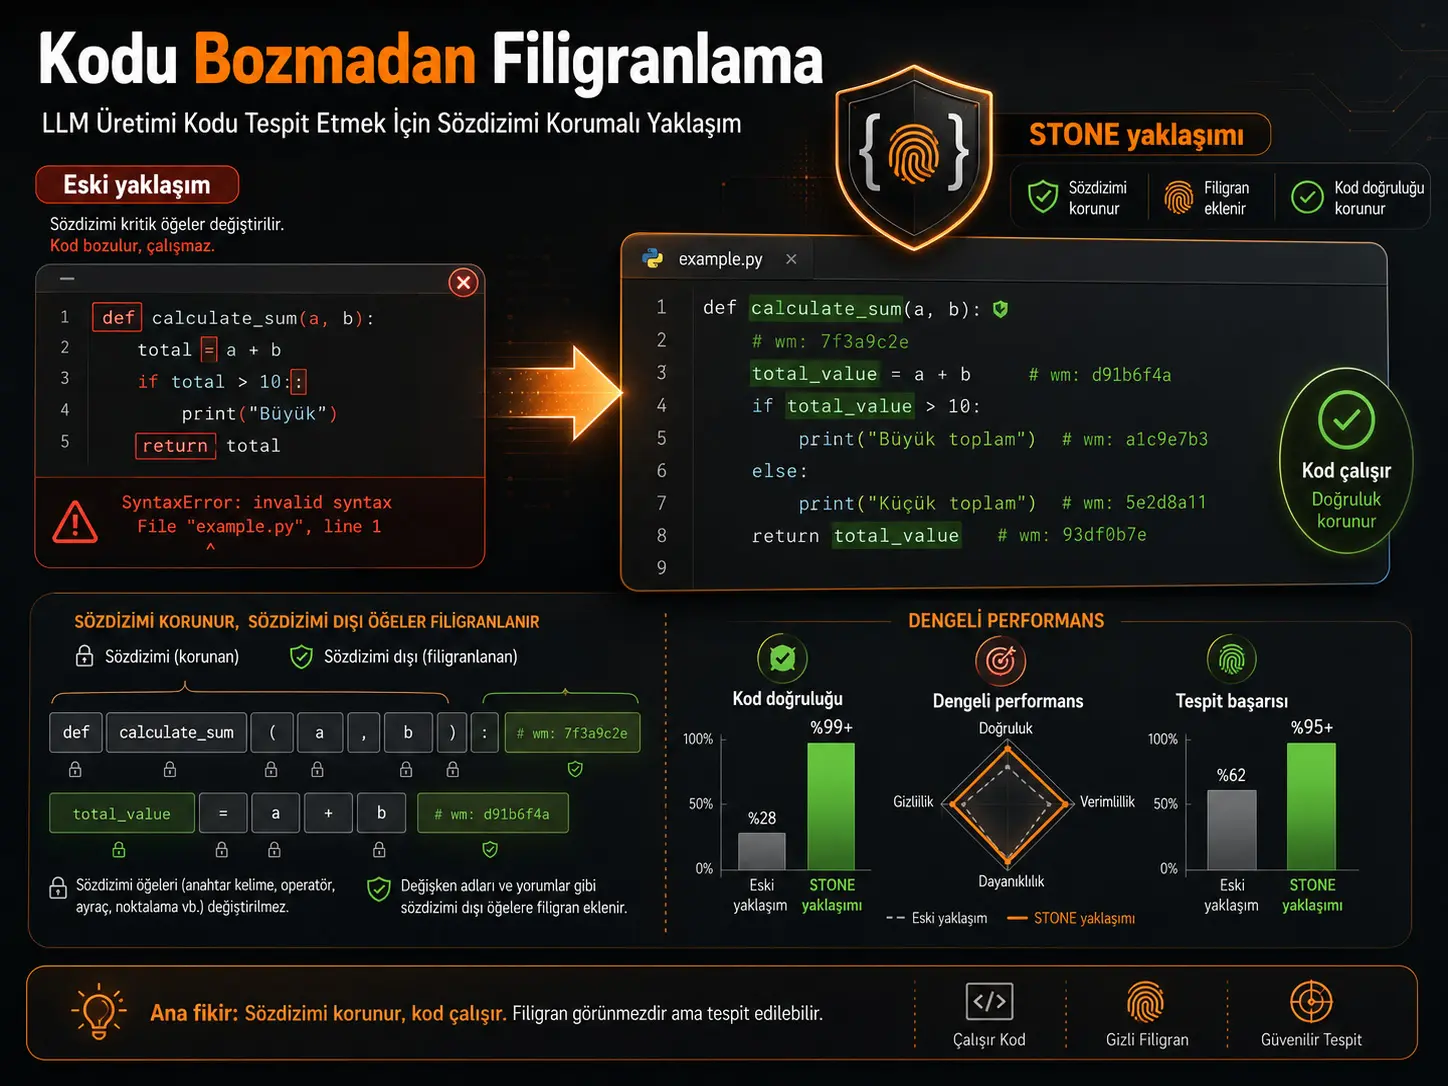
Tadqiqotchilar katta til modellari tomonidan yaratilgan dastur kodiga keyinchalik aniqlanishi mumkin bo‘lgan filigran joylashtirishda kodning sintaksisi yoki ishlash mantiqini buzish xavfini kamaytirishga qaratilgan STONE nomli usulni ishlab chiqdilar. STONE ning asosiy yondashuvi filigranni barcha tokenlarga yoki faqat yuqori entropiyali tokenlarga qo‘llash o‘rniga, dastur ishlashi uchun kritik deb hisoblangan sintaktik tokenlarni himoya qilishdir.
Tadqiqotning boshlang‘ich nuqtasi e’tiborga molik kuzatuvdir: “yuqori entropiyali tokenlarni o‘zgartirish xavfsizroq” degan faraz dastur kodida har doim ham to‘g‘ri emas. Python ustida o‘tkazilgan dastlabki tahlilda keywords, ya’ni kalit so‘zlar, eng yuqori o‘rtacha token entropiyasiga ega kategoriya ekanligi aniqlangan. MBPP+ da kalit so‘zlarning o‘rtacha entropiyasi 2,81 bo‘lgan bo‘lsa, filigranlash uchun nishonga olingan “etc” kategoriyasida bu ko‘rsatkich 1,98 dir. HumanEval+ da ham kalit so‘zlar 1,58 bilan eng yuqori kategoriya bo‘lib, “etc” kategoriyasi 1,11 ni tashkil etadi.
Bu natija muhim, chunki def, return, True, False, if yoki for kabi yuqori entropiyali tokenlarni o‘zgartirish nafaqat matn uslubini, balki dastur sintaksisi yoki mantiqini ham o‘zgartirishi mumkin. Avvalgi SWEET usuli yuqori entropiyali tokenlarni nishonga olgani sababli tadqiqotchilar tanlangan tokenlarning bir qismi sintaktik elementlar ekanini ko‘rsatgan. HumanEval+ uchun SWEET ning optimal sozlamasida tanlangan tokenlarning taxminan %12,6 qismi sintaksis bilan bog‘liq tokenlardir.
STONE buning o‘rniga keywords, whitespace, types, delimiters va operators dan iborat beshta sintaksis sinfini filigran nishonidan tashqarida qoldirishni maqsad qiladi. Filigran signali ushbu sinflarga kirmaydigan token hududida yaratiladi. Generatsiya vaqtida token nomzodlari yashil va qizil ro‘yxatlarga ajratiladi; yashil ro‘yxatdagi tokenlarning logit qiymatlari oshirilib, yaratilgan kodda statistik jihatdan aniqlanishi mumkin bo‘lgan naqsh qoldiriladi. Aniqlash bosqichida ham faqat sintaktik bo‘lmagan tokenlar orqali yashil token ulushi va z-skori hisoblanadi.
Tadqiqotning asosiy Qwen2.5-Coder-7B tajribalarida STONE to‘rtta baholash to‘plamining barchasida eng yuqori STEM birlashtirilgan skorini berdi. Teng og‘irlikli STEM qiymatlari MBPP+ uchun 0,848, HumanEval+ uchun 0,781, HumanEvalPack-C++ uchun 0,780 va HumanEvalPack-Java uchun 0,715 deb hisobot qilingan.
Funksional aniqlik jihatidan STONE ning correctness qiymatlari ayni tartibda 0,571, 0,587, 0,622 va 0,445 dir. Tadqiqotchilar bu qiymatlar SWEET ga nisbatan to‘rtta benchmark bo‘yicha o‘rtacha %7,57 yuqori aniqlik berganini hisoblagan. MBPP+ uchun filigransiz kodning pass@1 qiymati 0,571 bo‘lgan, STONE ning qiymati ham 0,571 dir. HumanEval+ da filigransiz natija 0,595, STONE esa 0,587 dir.
Aniqlash muvaffaqiyatida ham STONE to‘rtta asosiy ma’lumotlar to‘plamida mos ravishda 0,982, 0,777, 0,729 va 0,721 AUROC ga erishgan. Bunga qarshi, usul ko‘rinmaslik mezonida har bir benchmark da eng yuqori natijaga ega emas. Masalan, MBPP+ da KGW va EWD uchun imperceptibility 0,994 bo‘lgan, STONE esa 0,990 dir. Demak, tadqiqotning kuchli xulosasi “STONE har bir mezonda eng yaxshisi” emas, balki uchta maqsad o‘rtasida muvozanatliroq umumiy natija berishidir.
STONE ning yana bir afzalligi aniqlash vaqtidir. Filigran qo‘shish vaqtlari taqqoslangan usullar bilan o‘xshash darajada bo‘lgan bo‘lsa-da, tadqiqotchilar STONE ning ma’lumotlar to‘plami darajasidagi filigran aniqlashi SWEET va EWD ga nisbatan o‘rtacha taxminan %86 tezroq ekanini bildirishgan. Buning asosiy sababi STONE aniqlashi token entropiyasini qayta hisoblash o‘rniga oldindan belgilangan yashil ro‘yxat mexanizmidan foydalanishidir.
Usul hujumlarga to‘liq chidamli emas. HumanEval+ da STONE ning aniqlash qiymati hujum bo‘lmaganda 0,777, kod qayta tuzilganda 0,664 va kod paraphrase qilinganda 0,600 gacha tushgan. MBPP+ da tegishli qiymatlar 0,982, 0,907 va 0,824 dir. Shunga qaramay, ayni tajribalarda STONE SWEET dan yuqoriroq aniqlash ko‘rsatkichini namoyon qilgan.
Turkiya nuqtayi nazaridan baholash: Ushbu tadqiqot Turkiyadagi muayyan dasturiy ta’minot ishlab chiqish muhiti, universitet topshiriq tizimi yoki tijoriy kod generatsiyasi xizmatida sinovdan o‘tkazilmagan. Shunga qaramay, sun’iy intellekt tomonidan yaratilgan kod manbasini kuzatish, dasturiy ta’minot ta’minot zanjiri, ta’limda kod generatsiyasi, korporativ kod siyosatlari va model provayderlari yaratgan kontentni belgilash nuqtayi nazaridan Turkiyadagi tadqiqot va dasturiy ta’minot jamoalari uchun o‘rganilishi mumkin. Biroq STONE “AI kod detektori” sifatida istalgan kod parchasini retrospektiv va aniq tarzda tasniflamaydi; filigran kod yaratilayotganda tegishli usul bilan ataylab joylashtirilgan bo‘lishi kerak. Shu sababli usuldan foydalanish “bu kodni albatta sun’iy intellekt yozgan” degan universal kriminalistik dalil sifatida talqin qilinmasligi kerak.
Kod filigranlash muammosi nega tabiiy tildan farq qiladi?
Tabiiy til filigranlashda kichik so‘z tanlovlari ko‘pincha matnning asosiy ma’nosi yoki yaroqliligini buzmaydi. Kod generatsiyasida esa bitta belgi yoki token dasturning kompilyatsiya qilinishi yoki ishlashini butunlay o‘zgartirishi mumkin.
Masalan:
- ikki nuqta belgisining olib tashlanishi Python sintaksis xatosini keltirib chiqarishi mumkin,
+o‘rniga-ishlatilishi dastur hisobini o‘zgartirishi mumkin,Trueo‘rnigaFalseishlatilishi boshqaruv oqimini teskarisiga aylantirishi mumkin,- qavs yoki kvadrat qavsning o‘zgartirilishi parsing xatosiga sabab bo‘lishi mumkin.
Tadqiqotning 1-sahifasidagi 1-rasm bu muammoni oddiy is_even funksiyasi orqali vizuallashtiradi: tadqiqotchilar oldingi filigranlash yondashuvining sintaksis tokenlarini o‘zgartira olishini “syntax error” xavfi bilan taqqoslar ekan, STONE sintaktik tokenlarni himoya qilishga qaratilganini ko‘rsatadi.
Nega yuqori entropiya xavfsiz token degani emas?
Avvalgi SWEET yondashuvi til modeli qaysi tokenni tanlashiga kamroq ishonch hosil qiladigan, ya’ni entropiya yuqori bo‘lgan nuqtalarda filigran joylashtirish chiqish sifatini kamroq buzadi degan g‘oyaga asoslanadi.
Token entropiyasi manbada Shannon entropiyasi bilan:
\[ H_t = -\sum_{i=1}^{|V|} P(y_t=v_i\mid y_{
tarzida ta’riflanadi.
Bu yerda \(V\) model lug‘atini, \(y_{
Tadqiqotchilarning Qwen2.5-Coder-7B bilan o‘tkazgan dastlabki tahlili Python da sintaksis jihatidan kritik bo‘lgan ayrim kategoriyalar bir vaqtning o‘zida yuqori entropiyali ham bo‘lishi mumkinligini ko‘rsatdi.
| Token kategoriyasi | MBPP+ o‘rtacha entropiya | HumanEval+ o‘rtacha entropiya |
|---|---|---|
| Keywords | 2,81 | 1,58 |
| Etc | 1,98 | 1,11 |
| Types | 1,83 | 1,09 |
| Delimiters | 1,06 | 0,78 |
| Whitespace | 0,93 | 0,46 |
| Operators | 0,93 | 0,63 |
Shu sababli faqat “yuqori entropiyali token” mezoni ishlatilsa, dastur tuzilishi uchun kritik token ham filigran nishoniga aylanishi mumkin.
STONE qaysi tokenlarni sintaktik deb hisoblaydi?
STONE uchta dasturlash tili uchun beshta asosiy sintaksis sinfini belgilaydi:
- Keywords: tilning rezervlangan kalit so‘zlari,
- Whitespace: bo‘shliq, qator oxiri va tab,
- Types: asosiy tur belgilagichlari,
- Delimiters: qavs, ajratgich, tinish belgisi va shunga o‘xshash tuzilmaviy belgilar,
- Operators: arifmetik, mantiqiy, taqqoslash va tayinlash operatorlari.
Ushbu besh guruhga kirmaydigan tokenlar tadqiqotda “etc” kategoriyasida baholanadi va STONE ning asosiy filigran nishon hududini tashkil etadi.
STONE filigranni qanday qo‘shadi?
Generatsiyaning \(t\) bosqichida til modeli avval standart logit vektorini hisoblaydi:
\[ l_t=f_{LM}(x,y_{
va ushbu qiymatlardan boshlang‘ich ehtimollik taqsimoti olinadi:
\[ p_{t,i} = \frac{e^{l_t[i]}} {\sum_{j=1}^{|V|}e^{l_t[j]}} \]
STONE avval ushbu taqsimotdan nomzod token namuna oladi. Nomzod sintaksis to‘plamiga kirmasa, oldingi tokenning hash qiymati seed sifatida ishlatiladi va lug‘at yashil \(G_t\) hamda qizil \(R_t\) ro‘yxatlarga bo‘linadi.
Yashil ro‘yxatdagi tokenlarning logitlariga doimiy \(\delta\) qo‘shiladi:
\[ l_t[i]\leftarrow l_t[i]+\delta, \qquad i\in G_t \]
Bu o‘zgarish yashil tokenlarning hosil bo‘lish ehtimolini oshiradi. Keyin tuzatilgan taqsimotdan yakuniy token namuna olinadi.
Verianla Live: STONE filigran joylashtirish zanjiri
Ushbu jarayon tadqiqotning 1-algoritm va 2-algoritmda ta’riflagan generatsiya va aniqlash mantiqining soddalashtirilgan ilmiy xulosasidir.
| Bosqich | Jarayon | Maqsad |
|---|---|---|
| 1. Standart generatsiya | Til modeli joriy kontekstga ko‘ra token logitlari va ehtimollarini hisoblaydi. | Normal kod generatsiyasi taqsimotini olish. |
| 2. Sintaksis tekshiruvi | Namuna olingan nomzod token syntax element set ga nisbatan tekshiriladi. | Sintaksis kritik hududlarda filigran aralashuvining oldini olish. |
| 3. Yashil/qizil ro‘yxat | Oldingi tokenning hash qiymati orqali lug‘at yashil va qizil ro‘yxatlarga ajratiladi. | Takror ishlab chiqariladigan yashirin filigran naqshini yaratish. |
| 4. Logit siljitish | Yashil ro‘yxatdagi tokenlarning logitlariga δ qo‘shiladi. | Yashil tokenlar generatsiyasi ehtimolini oshirish. |
| 5. Kod generatsiyasi | Tuzatilgan taqsimotdan yakuniy token namuna olinadi. | Filigran signalini kod generatsiyasiga olib kirish. |
| 6. Filigranni aniqlash | Sintaktik bo‘lmagan tokenlar orasidagi yashil tokenlar soni va z-skori hisoblanadi. | Kodda STONE filigrani uchun statistik dalil izlash. |
Verianla Live: Vizualizatsiya yuqoridagi ko‘rinadigan ilmiy jarayon jadvalidan yaratiladi. Jadval ilmiy source-of-truth sifatida saqlanadi.
Aniqlash z-skori qanday hisoblanadi?
STONE aniqlash vaqtida faqat “etc” deb hisoblangan sintaktik bo‘lmagan tokenlarni sanaydi. Ularning umumiy soni \(N^E\), yashil ro‘yxatda bo‘lganlar soni esa \(N_G^E\) deb belgilanadi.
Z-skori:
\[ z= \frac{ N_G^E-\gamma N^E }{ \sqrt{\gamma(1-\gamma)N^E} } \]
ko‘rinishidadir.
Hisoblangan qiymat oldindan belgilangan \(z_{threshold}\) chegarasidan yuqoriga chiqsa, ketma-ketlik filigranlangan deb tasniflanadi.
Ushbu mexanizm faqat filigran yaratishda ishlatilgan ro‘yxatlash qoidasi ma’lum yoki qayta ishlab chiqarilishi mumkin bo‘lgan kodlarda ishlaydi. U umumiy maqsadli “LLM kodini tanish” usuli emas.
STEM nega ishlab chiqildi?
Tadqiqotchilar mavjud kod filigranlash tadqiqotlari turli mezonlarga e’tibor qaratishi va bu usullar o‘rtasida muvozanatli taqqoslashni qiyinlashtirishini ta’kidlaydi. Bir tizim filigranni juda oson aniqlatishi mumkin, biroq ko‘p xato dasturlar yaratishi mumkin; boshqa tizim esa kodni saqlashi, lekin filigran signali juda zaif bo‘lishi mumkin.
STONE bilan birga taklif etilgan STEM metrikasi uchta o‘lchamni yagona vaznli skor ostida birlashtiradi:
\[ STEM= \alpha\cdot Correctness+ \beta\cdot Detectability+ \zeta\cdot Imperceptibility \]
va:
\[ \alpha+\beta+\zeta=1 \]
sharti qo‘llanadi.
Correctness qanday o‘lchanadi?
Funksional aniqlik uchun kod generatsiyasi tadqiqotlarida qo‘llanadigan pass@k mezoni ishlatiladi. Ushbu mezon yaratilgan \(k\) yechimdan kamida bittasining barcha testlardan o‘tish ehtimolini baholaydi.
Asosiy tajribalarda hisobot qilingan correctness ustunlari pass@1 asosidagi baholashni ifodalaydi.
Detectability qanday o‘lchanadi?
Yashil token ulushidan olingan z-skorning turli chegaralarda inson yozgan va filigranlangan kodlarni qanchalik ajrata olishi ROC egri chizig‘i orqali baholangan; natija AUROC bilan hisobot qilingan.
AUROC oshgan sari ikki kod guruhini filigran statistikasi orqali ajratish osonlashadi.
Imperceptibility nimani o‘lchaydi?
Tadqiqotchilar filigran kodning tabiiy token ehtimollik taqsimotini qay darajada o‘zgartirishini perplexity orqali baholaydi.
Imperceptibility:
\[ 1- \frac{ |PPL(C_{wm})-PPL(C)| }{ PPL(C) } \]
tarzida ta’riflangan.
Bu yerda \(C_{wm}\) filigranlangan kod, \(C\) esa filigransiz kod to‘plamidir. Skor 1 ga yaqinlashgan sari filigran token taqsimotida kichikroq nisbiy o‘zgarish qilgan deb qabul qilinadi. Juda katta taqsimot o‘zgarishlarida metrika manfiy qiymat olishi ham mumkin; tadqiqotning CodeIP takror tajribasida bunga misollar mavjud.
Qaysi ma’lumotlar to‘plamlaridan foydalanildi?
| Ma’lumotlar to‘plami | Til | Muammolar soni | O‘rtacha yechim uzunligi (token) |
|---|---|---|---|
| MBPP+ | Python | 399 | 40,25 |
| HumanEval+ | Python | 164 | 188,28 |
| HumanEvalPack-C++ | C++ | 164 | 223,10 |
| HumanEvalPack-Java | Java | 164 | 237,36 |
Qaysi usullar bilan taqqoslandi?
Asosiy taqqoslashda uchta training-free usul ishlatildi:
- KGW: har bir generatsiya bosqichida lug‘atni yashil va qizil ro‘yxatlarga bo‘lib, yashil tokenlarni afzal ko‘radigan asosiy yondashuv,
- EWD: aniqlashda token entropiyasini vaznlovchi usul,
- SWEET: filigranni faqat yuqori entropiyali tokenlarga joylashtirishga qaratilgan kod filigranlash usuli.
CodeIP asosiy baseline guruhiga kiritilmagan, chunki u qo‘shimcha type-prediction modelini o‘qitishni talab qiladi, STONE va asosiy taqqoslashlar esa training-free dir. Tadqiqotchilar CodeIP ni alohida A-ilovada qayta amalga oshirib, natijalarini hisobot qilgan.
Asosiy model va generatsiya sozlamalari qanday?
Asosiy tajribalarda Qwen2.5-Coder-7B ishlatilgan. B-ilovada Llama-3.1-8B bilan ham tajriba o‘tkazilgan.
Asosiy generatsiya sozlamalari:
- top-k = 50,
- temperature = 1,0,
- \(\gamma=0,5\),
- MBPP+ uchun \(\delta=1,0\),
- HumanEval+, C++ va Java uchun \(\delta=0,5\).
Imperceptibility baholashida perplexity hisoblash uchun StarCoder2-7B ishlatilgan. Tajribalar NVIDIA A6000 GPU da o‘tkazilgani ko‘rsatiladi.
STONE ning asosiy natijalari qanday?
Aniqlik natijalari alohida qanday?
| Usul | MBPP+ | HumanEval+ | C++ | Java |
|---|---|---|---|---|
| KGW | 0,499 | 0,573 | 0,576 | 0,387 |
| EWD | 0,499 | 0,573 | 0,576 | 0,387 |
| SWEET | 0,502 | 0,574 | 0,584 | 0,413 |
| STONE | 0,571 | 0,587 | 0,622 | 0,445 |
STONE to‘rtta asosiy benchmark ning barchasida eng yuqori correctness qiymatiga erishgan. Tadqiqotchilar SWEET ga nisbatan o‘rtacha nisbiy farqni %7,57 deb hisobot qiladi.
Filigransiz kod bilan taqqoslanganda nima bo‘ladi?
F-ilovada filigransiz kod tajribalari ham berilgan:
| Usul | MBPP+ pass@1 | HumanEval+ pass@1 |
|---|---|---|
| Filigran yo‘q | 0,571 | 0,595 |
| STONE | 0,571 | 0,587 |
| SWEET | 0,502 | 0,574 |
| KGW | 0,499 | 0,573 |
| EWD | 0,499 | 0,573 |
MBPP+ da STONE filigranlangan va filigransiz generatsiyaning pass@1 qiymati bir xil. HumanEval+ da esa 0,595 dan 0,587 ga kichik pasayish ko‘riladi. Shu sababli “STONE hech qanday holatda aniqlikni pasaytirmaydi” deyish manba natijalaridan ortiqcha xulosa bo‘ladi; aniqroq ifoda, o‘rganilgan testlarda aniqlik yo‘qotilishi boshqa filigran usullariga qaraganda kichikroq bo‘lganidir.
Aniqlash muvaffaqiyati qanday?
| Usul | MBPP+ AUROC | HumanEval+ AUROC | C++ AUROC | Java AUROC |
|---|---|---|---|---|
| KGW | 0,831 | 0,523 | 0,621 | 0,546 |
| EWD | 0,965 | 0,730 | 0,681 | 0,646 |
| SWEET | 0,867 | 0,710 | 0,641 | 0,580 |
| STONE | 0,982 | 0,777 | 0,729 | 0,721 |
Asosiy Qwen2.5-Coder-7B tajribasida STONE to‘rtta ma’lumotlar to‘plamining barchasida eng yuqori detectability qiymatini bergan.
Ko‘rinmaslikda ham eng yaxshimi?
Yo‘q. Imperceptibility natijalari:
| Usul | MBPP+ | HumanEval+ | C++ | Java |
|---|---|---|---|---|
| KGW | 0,994 | 0,986 | 0,993 | 0,993 |
| EWD | 0,994 | 0,986 | 0,993 | 0,993 |
| SWEET | 0,992 | 0,978 | 0,979 | 0,901 |
| STONE | 0,990 | 0,978 | 0,990 | 0,979 |
KGW va EWD bu mezonda biroz yuqoriroq qiymatlarga ega. STONE ning da’vo qilinayotgan afzalligi ko‘rinmaslikda mutlaq birinchilik emas; ko‘rinmaslikni yuqori darajada ushlab turib, correctness va detectability ni birgalikda kuchaytirishidir.
66 xil STEM og‘irligida natija o‘zgaradimi?
Tadqiqotchilar \(\alpha\), \(\beta\) va \(\zeta\) qiymatlarini 0,0–1,0 oralig‘ida 0,1 qadam bilan o‘zgartirib, yig‘indisi 1 bo‘lgan 66 xil og‘irlik kombinatsiyasini baholagan.
STONE eng yuqori STEM skorini olgan kombinatsiyalar ulushi:
- MBPP+: %97,0,
- HumanEval+: %90,9,
- HumanEvalPack-C++: %98,5,
- HumanEvalPack-Java: %95,5.
Ushbu tahlil asosiy natijalar faqat teng og‘irlik tanlovining mahsuli emasligini ko‘rsatadi. Biroq bu istalgan foydalanuvchi tanlashi mumkin bo‘lgan barcha uzluksiz og‘irlik kombinatsiyalari sinovdan o‘tkazilgan degani emas; tadqiqot 0,1 oraliqli ko‘rsatilgan 66 kombinatsiyani baholagan.
STONE qanchalik tez?
Ma’lumotlar to‘plami darajasidagi umumiy aniqlash vaqtlari:
| Usul | MBPP+ (s) | HumanEval+ (s) | C++ (s) | Java (s) |
|---|---|---|---|---|
| KGW | 12,90 | 4,19 | 8,01 | 8,95 |
| EWD | 100,43 | 34,51 | 56,85 | 59,84 |
| SWEET | 100,94 | 34,68 | 58,08 | 59,22 |
| STONE | 13,27 | 4,62 | 8,48 | 9,24 |
STONE ning aniqlash vaqti KGW ga juda yaqin, EWD va SWEET dan esa sezilarli darajada past. Tadqiqotchilar buning sababini EWD va SWEET aniqlash paytida token ehtimollik taqsimoti/entropiya hisobini amalga oshirishi, STONE esa yashil ro‘yxat tekshiruvi bilan ishlashi deb ko‘rsatadi.
Filigran qo‘shish vaqtlari esa barcha usullarda bir xil tartibda; STONE ning katta tezlik afzalligi ayniqsa aniqlash bosqichidadir.
Refactoring hujumiga qanchalik chidamli?
HumanEval+ da:
| Sharoit | SWEET | STONE |
|---|---|---|
| Hujum yo‘q | 0,710 | 0,777 |
| Kod refactoring | 0,539 | 0,664 |
| Kod paraphrasing | 0,563 | 0,600 |
MBPP+ da:
| Sharoit | SWEET | STONE |
|---|---|---|
| Hujum yo‘q | 0,679 | 0,982 |
| Kod refactoring | 0,359 | 0,907 |
| Kod paraphrasing | 0,385 | 0,824 |
STONE har ikkala hujum turida ham taqqoslangan SWEET dan yuqori aniqlash ko‘rsatkichini ko‘rsatgan. Ammo qiymatlarning hujum bo‘lmagan holatga nisbatan pasayishi filigran o‘zgarishlardan ta’sirlanishi mumkinligini aniq ko‘rsatadi.
Nega paraphrasing STONE ga ta’sir qiladi?
Tadqiqotchilar refactoring jarayoni ko‘p sintaksis chegaralarini saqlab qolishini va shu sababli non-syntax token hududidagi filigranning muhim qismi qolishi mumkinligini ta’kidlaydi.
Paraphrasing esa o‘zgaruvchi nomlari va ifodalar kabi sintaksisdan tashqari hududlarni o‘zgartirishi mumkin. Ular STONE ning filigran nishonlari bilan to‘g‘ridan-to‘g‘ri ustma-ust tushgani uchun aniqlash signali kamayishi mumkin.
STONE algoritmni biladigan hujumchiga qarshi sinovdan o‘tkazildimi?
Yo‘q. Bu tadqiqotning o‘z cheklovlar bo‘limida ochiq aytilgan.
STONE algoritmini biladigan hujumchi, ayniqsa sintaktik bo‘lmagan tokenlarni nishonga olib:
- barcha o‘zgaruvchilarni tizimli ravishda qayta nomlashi,
- izohlarni olib tashlashi,
- STONE filigran zichligini kamaytiradigan nishonli transformatsiyalarni qo‘llashi mumkin.
Tadqiqotchilar bunday algorithm-aware hujumlarga qarshi yangi himoyalarni kelajakdagi tadqiqot yo‘nalishi sifatida belgilaydi.
Code golf va obfuscated kod nega muammo bo‘lishi mumkin?
STONE tashiy oladigan filigran miqdori sintaksisdan tashqari tokenlar zichligiga bog‘liq. Oddiy benchmark kodlarida yetarli miqdorda nishon token mavjud.
Biroq juda qisqa, siqilgan “code golf” yechimlarida yoki ataylab obfuscate qilingan kodlarda bu tokenlar soni kamayishi mumkin. Bunday hollarda filigran juda siyraklashib, ishonchli aniqlash uchun yetarli bo‘lmasligi mumkin.
Llama-3.1-8B natijalari ham ayni tendensiyani ko‘rsatadimi?
Qo‘shimcha tajribalarda MBPP+ va HumanEval+ da Llama-3.1-8B ishlatilgan. STONE yana teng og‘irlikli STEM da eng yuqori skorlarni bergan:
- MBPP+: STONE 0,782,
- HumanEval+: STONE 0,699.
Biroq HumanEval+ detectability qiymatida EWD 0,755 bilan STONE ning 0,741 qiymatidan biroz yuqori. Shunga qaramay, STONE yuqoriroq correctness hisobiga birlashtirilgan STEM skorida oldinda qolgan.
Bu natija ham usulning da’vosi “har bir modelda har bir submetrikada yutish” emas, balki umumiy muvozanatni saqlash ekanini qo‘llab-quvvatlaydi.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- Yuqori token entropiyasi dastur kodida sintaksis jihatidan xavfsiz o‘zgarish degani emas.
- Python dastlabki tahlilida keywords kategoriyasi o‘rganilgan ikki benchmark da eng yuqori o‘rtacha entropiyaga ega.
- SWEET optimal HumanEval+ sozlamasida tanlangan tokenlarning taxminan %12,6 qismi syntax tokenlardir.
- STONE sintaktik tokenlarni filigran nishonidan ajratadigan generatsiya va aniqlash yondashuvini taklif qiladi.
- Qwen2.5-Coder-7B asosiy tajribasida STONE to‘rtta benchmark da eng yuqori correctness, detectability va teng og‘irlikli STEM qiymatini bergan.
- STONE ning imperceptibility qiymati yuqori qolgan, biroq bu submetrikaning mutlaq eng yaxshi qiymati har doim STONE ga tegishli bo‘lmagan.
- STONE SWEET ga nisbatan o‘rtacha %7,57 yuqori correctness natijasini bergan.
- STONE aniqlashi EWD va SWEET ning entropy asosidagi aniqlashiga nisbatan o‘rtacha taxminan %86 tezroq deb hisobot qilingan.
- 66 STEM vaznlash kombinatsiyasining katta ko‘pchiligida STONE birinchi o‘rinda qolgan.
- Refactoring va paraphrasing hujumlaridan keyin detectability pasaysa ham, o‘rganilgan tajribalarda STONE SWEET dan chidamliroq bo‘lib qolgan.
Tadqiqot qo‘llab-quvvatlamaydigan yoki hali ko‘rsatmagan xulosalar
- STONE filigransiz istalgan noma’lum kodning LLM tomonidan yozilganini aniqlaydigan umumiy maqsadli detektor emas.
- Filigranning barcha kod transformatsiyalariga qarshi o‘chirib bo‘lmaydigan ekani ko‘rsatilmagan.
- STONE algoritmini biladigan nishonli hujumchilarga qarshi chidamlilik tajribaviy ravishda ko‘rsatilmagan.
- Obfuscated yoki code-golf kodlarda ishonchli aniqlash kafolatlanmaydi.
- Har bir dasturlash tili baholanmagan; asosiy tajribalar Python, C++ va Java bilan cheklangan.
- Haqiqiy korporativ dasturiy ta’minot repozitoriylari yoki millionlab qator ishlab chiqarish kodi ustida maydon baholashi o‘tkazilmagan.
- STONE barcha submetrikalarda har doim eng yuqori natijani bermaydi.
- Filigranlangan kod aniqlanishining o‘zi muallif shaxsi, yomon niyat, akademik qoidabuzarlik yoki huquqiy javobgarlik dalili emas.
Tadqiqot Usuli va Natijalari
Tadqiqot savollari
Tadqiqot uchta asosiy savolga qaratiladi:
- STONE funksional aniqlikni saqlab qola oladimi?
- Correctness, detectability va imperceptibility o‘rtasida STEM bilan o‘lchanadigan muvozanatli natija ta’minlay oladimi?
- Filigran joylashtirish va aniqlash nuqtayi nazaridan hisoblash xarajati qanday?
Asosiy Qwen2.5-Coder-7B natijalarining to‘liq ko‘rinishi
| Dataset | Usul | Correctness | Detectability | Imperceptibility | STEM |
|---|---|---|---|---|---|
| MBPP+ | KGW | 0,499 | 0,831 | 0,994 | 0,775 |
| MBPP+ | EWD | 0,499 | 0,965 | 0,994 | 0,819 |
| MBPP+ | SWEET | 0,502 | 0,867 | 0,992 | 0,787 |
| MBPP+ | STONE | 0,571 | 0,982 | 0,990 | 0,848 |
| HumanEval+ | KGW | 0,573 | 0,523 | 0,986 | 0,694 |
| HumanEval+ | EWD | 0,573 | 0,730 | 0,986 | 0,763 |
| HumanEval+ | SWEET | 0,574 | 0,710 | 0,978 | 0,754 |
| HumanEval+ | STONE | 0,587 | 0,777 | 0,978 | 0,781 |
| HEP-C++ | KGW | 0,576 | 0,621 | 0,993 | 0,730 |
| HEP-C++ | EWD | 0,576 | 0,681 | 0,993 | 0,750 |
| HEP-C++ | SWEET | 0,584 | 0,641 | 0,979 | 0,735 |
| HEP-C++ | STONE | 0,622 | 0,729 | 0,990 | 0,780 |
| HEP-Java | KGW | 0,387 | 0,546 | 0,993 | 0,642 |
| HEP-Java | EWD | 0,387 | 0,646 | 0,993 | 0,675 |
| HEP-Java | SWEET | 0,413 | 0,580 | 0,901 | 0,631 |
| HEP-Java | STONE | 0,445 | 0,721 | 0,979 | 0,715 |
Hisoblash vaqti
| Dataset | Usul | Insertion (s) | Detection (s) |
|---|---|---|---|
| MBPP+ | KGW | 3320 | 12,90 |
| MBPP+ | EWD | 3320 | 100,43 |
| MBPP+ | SWEET | 3300 | 100,94 |
| MBPP+ | STONE | 3266 | 13,27 |
| HumanEval+ | KGW | 1268 | 4,19 |
| HumanEval+ | EWD | 1268 | 34,51 |
| HumanEval+ | SWEET | 1270 | 34,68 |
| HumanEval+ | STONE | 1277 | 4,62 |
| HEP-C++ | KGW | 1308 | 8,01 |
| HEP-C++ | EWD | 1308 | 56,85 |
| HEP-C++ | SWEET | 1454 | 58,08 |
| HEP-C++ | STONE | 1300 | 8,48 |
| HEP-Java | KGW | 1506 | 8,95 |
| HEP-Java | EWD | 1506 | 59,84 |
| HEP-Java | SWEET | 1480 | 59,22 |
| HEP-Java | STONE | 1459 | 9,24 |
SWEET ning syntax-token qamrovi
E-ilovada entropy threshold o‘zgarganda SWEET nechta token tanlashi va tanlanganlarning qanchasi syntax tokeni ekani o‘rganilgan.
HumanEval+ uchun optimal entropy threshold 0,9 bo‘lganida:
- yaratilgan barcha tokenlarning %28,98 qismi tanlangan,
- tanlanganlarning %12,60 qismi syntax tokenidir.
Ushbu syntax tokenlar ichida manbada berilgan taqsimot:
- delimiters: %49,29,
- whitespace: %38,17,
- keywords: %9,44,
- types: %3,17,
- operators: %2,78.
Ushbu foizlar subkategoriya hisoboti manbada berilgan shaklda ko‘chirilgan; yaxlitlash va kategoriya hisobot usuli sababli jami aniq %100 ga teng bo‘lishi kutilmasligi kerak.
CodeIP qo‘shimcha taqqoslashining natijasi
Tadqiqotchilar training talab qilgani sababli CodeIP ni asosiy baseline guruhiga kiritmagan, biroq A-ilovada uning rasmiy implementatsiyasini qayta ishga tushirgan.
CodeIP detectability qiymatlari 0,945–0,994 oralig‘ida yuqori bo‘lib qolgan, correctness natijalari esa MBPP+ uchun 0,093, HumanEval+ uchun 0,018, C++ uchun 0,000 va Java uchun 0,073 deb topilgan.
Ushbu tajriba faqat yuqori aniqlash muvaffaqiyati muvozanatli kod filigranlash usuli uchun yetarli emasligini ko‘rsatish maqsadida ishlatilgan. Biroq bu natijalar mualliflarning o‘z qayta ishlab chiqarish sozlamalariga tegishli bo‘lib, CodeIP ning barcha ehtimoliy sozlamalari yoki keyingi versiyalari haqida umumiy hukm sifatida talqin qilinmasligi kerak.
Usulning asosiy cheklovlari
- Filigran sig‘imi sintaksisdan tashqari tokenlar zichligiga bog‘liq.
- Code-golf yoki obfuscated kodda yetarli filigran signali shakllanmasligi mumkin.
- Algoritmni biladigan hujumchining nishonli token qayta nomlashiga qarshi keng qamrovli himoya ko‘rsatilmagan.
- Robustlik tajribalari ikkita umumiy hujum turi bilan cheklangan.
- Asosiy baholash uch dasturlash tili va to‘rtta benchmark bilan cheklangan.
- Asosiy model Qwen2.5-Coder-7B; ikkinchi model tahlili faqat qo‘shimcha bo‘limda ikkita Python benchmark ida o‘tkazilgan.
- Haqiqiy katta hajmdagi dasturiy ta’minot loyihalarida inson dasturchi tahrirlari bilan uzoq muddatli filigran saqlanishi sinovdan o‘tkazilmagan.
Algoritm tushuntirishida e’tibor berilishi kerak bo‘lgan tafsilot
Tadqiqot bayoni STONE ni “faqat non-syntax tokenlarga filigran joylashtiradigan” usul sifatida ta’riflaydi. 1-algoritmning bosma psevdokodida esa filigranlash jarayonining faollashtirilishi yoki faollashtirilmasligi avval namuna olingan candidate token ning syntax to‘plamida bo‘lish-bo‘lmasligiga ko‘ra belgilanadi, keyin esa yakuniy token tuzatilgan taqsimotdan qayta namuna olinadi.
Psevdokod ushbu ikkinchi namunalashda yakuniy tokenning syntax to‘plamidan tanlanishini alohida taqiqlaydigan mustaqil qatorni ko‘rsatmaydi. Manba buning implementatsiya kodida qanday hal qilinganini matn ichida alohida tushuntirmaydi. Shu sababli bu yerda mualliflar bergan “syntax-aware/non-syntax nishonlash” ta’rifi saqlangan; psevdokod tafsilotidan kelib chiqib boshqa algoritm faraz qilinmagan.
Manba va Usul Haqida Izoh
To‘liq original tadqiqot nomi: Marking Code Without Breaking It: Code Watermarking for Detecting LLM-Generated Code
Mualliflar va original tartib: Jungin Kim; Shinwoo Park; Yo-Sub Han.
Teng hissa: Jungin Kim va Shinwoo Park manbada teng hissa qo‘shgan mualliflar sifatida belgilangan.
Mas’ul muallif: Yo-Sub Han.
Muassasa: Yonsei University, Seoul, Republic of Korea.
Manba turi va taqriz: Taqrizdan o‘tgan konferensiya nashri; Findings of the Association for Computational Linguistics: EACL 2026.
Nashr: Findings of the Association for Computational Linguistics: EACL 2026.
Nashriyot: Association for Computational Linguistics.
Sahifalar: 3990–4002.
Konferensiya: 19th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2026), Rabat, Morocco, 24–29 March 2026.
ACL Anthology identifikatori: 2026.findings-eacl.207
DOI: 10.18653/v1/2026.findings-eacl.207
Rasmiy nashr havolasi: https://aclanthology.org/2026.findings-eacl.207/
DOI havolasi: https://doi.org/10.18653/v1/2026.findings-eacl.207
Litsenziya: ACL Anthology ning 2016 va undan keyin nashr etilgan ACL materiallari uchun qo‘llaydigan Creative Commons Attribution 4.0 International (CC BY 4.0) litsenziyasi.
Moliyalashtirish: Tadqiqot NRF grant RS-2025-00562134 va Koreya hukumati tomonidan moliyalashtirilgan AI Graduate School Program RS-2020-II201361 ko‘magini bildiradi.
Implementatsiya kodi: Manba tadqiqot STONE implementatsiyasi https://github.com/inistory/STONE-watermarking manzilida mavjudligini ko‘rsatadi.
Asosiy model: Qwen2.5-Coder-7B.
Qo‘shimcha model: Llama-3.1-8B.
Perplexity baholash modeli: StarCoder2-7B.
Dasturlash tillari: Python, C++ va Java.
Benchmark lar: MBPP+, HumanEval+, HumanEvalPack-C++ va HumanEvalPack-Java.
Asosiy taqqoslashlar: KGW, EWD va SWEET. CodeIP training talab qilgani uchun asosiy training-free baseline guruhiga kiritilmagan va A-ilovada alohida qayta baholangan.
Asosiy baholash mezonlari: Correctness uchun pass@k; detectability uchun z-score asosidagi AUROC; imperceptibility uchun perplexity o‘zgarishi; birlashtirilgan baholash uchun STEM.
Hisoblash infratuzilmasi: NVIDIA A6000 GPU.
Robustlik tahlili: HumanEval+ va MBPP+ da kod refactoring va GPT-4o bilan kod paraphrasing hujumlari qo‘llangan.
Asosiy metodologik chegara: STONE faqat filigran generatsiya vaqtida ataylab joylashtirilgan chiqishlarda ishlatilishi mumkin bo‘lgan provenance mexanizmidir. Filigransiz, boshqa provayder tomonidan yaratilgan yoki inson tomonidan yozilgan istalgan kodni faqat uslubiga qarab ishonchli tarzda “LLM generatsiyasi” deb belgilaydigan umumiy detektor emas.
Hujum chegarasi: Refactoring va paraphrasing dan keyin STONE ning detectability qiymati pasayadi. Algoritmni biladigan va ayniqsa non-syntax tokenlarni nishonga oladigan hujumchilarga qarshi keng qamrovli chidamlilik ko‘rsatilmagan.
Umumlashtirish chegarasi: Natijalar benchmark asosidagi kod generatsiyasi vazifalariga tayanadi. Katta real dunyo repozitoriylari, uzoq muddatli inson tahrirlari, turli dasturlash tillari va keng model oilalari uchun ayni ko‘rsatkichlar kafolatlanmaydi.
Taqqoslash chegarasi: STONE barcha alohida submetrikalarda mutlaq eng yaxshi emas. Ayniqsa imperceptibility jihatidan KGW va EWD ayrim asosiy tajribalarda yuqoriroq skor bergan. Tadqiqotning asosiy natijasi STONE correctness, detectability va imperceptibility birgalikda baholanganda yuqori va barqaror STEM natijalarini berishidir.
Manba ichidagi algoritm izohi: 1-algoritm psevdokodida filigranlashni faollashtirish candidate tokenning syntax to‘plamida bo‘lish-bo‘lmasligiga qarab belgilanadi, yakuniy token esa keyin tuzatilgan taqsimotdan qayta namuna olinadi. Matn usulni non-syntax-only watermarking sifatida ta’riflasa-da, psevdokod yakuniy token uchun ikkinchi syntax bloklash qadamini aniq ko‘rsatmaydi. Bu nuqta manbada alohida muvofiqlashtirilmaganligi sababli Verianla tushuntirishida taxminga asoslangan tuzatish kiritilmagan.
Ilmiy mazmun doirasi: Ushbu Verianla izohidagi algoritmlar, formulalar, benchmark qiymatlari, hujum natijalari, ishlash vaqtlari, STEM taqqoslashlari va cheklovlar manba tadqiqotga asoslangan. Tashqi manba faqat rasmiy bibliografik identifikatsiya, EACL/ACL nashr holati va litsenziya ma’lumotini tasdiqlash uchun ishlatilgan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan