

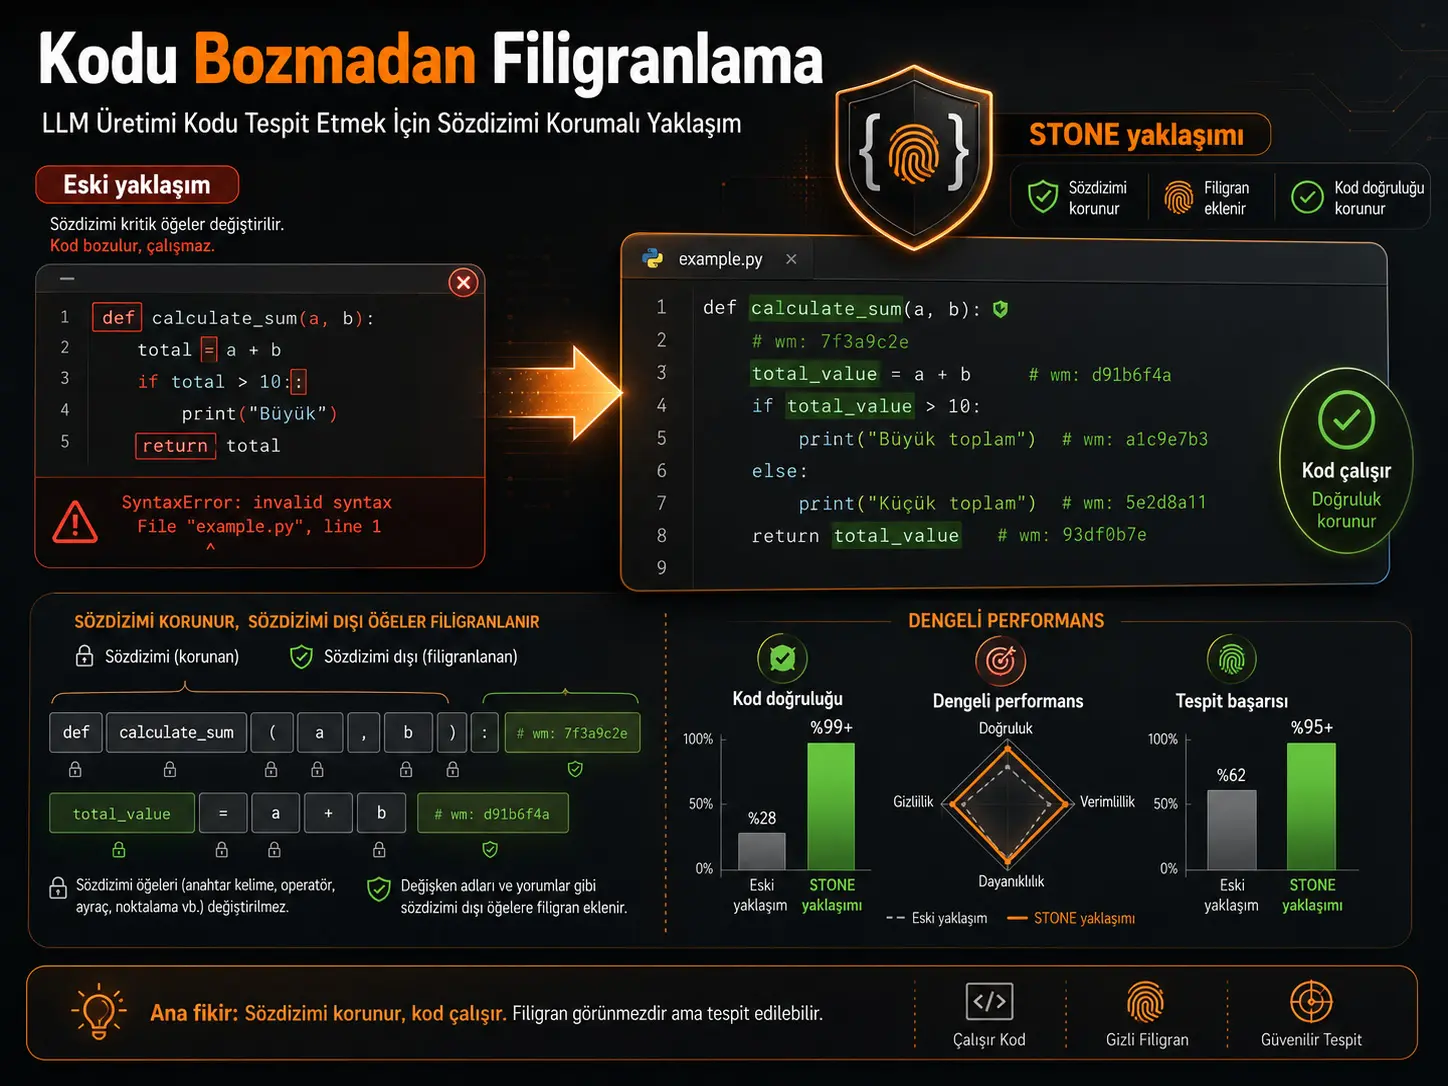
Tədqiqatçılar böyük dil modellərinin yaratdığı proqram koduna sonradan aşkarlana bilən su nişanı yerləşdirərkən kodun sintaksisini və ya iş məntiqini pozmaq riskini azaltmağı hədəfləyən STONE adlı STONE metodu hazırlayıblar. STONE-un əsas yanaşması su nişanını bütün tokenlərə və ya yalnız yüksək entropiyalı tokenlərə tətbiq etmək əvəzinə proqramın işləməsi baxımından kritik hesab olunan sintaktik tokenləri qorumaqdır.
Tədqiqatın çıxış nöqtəsi diqqətçəkən müşahidədir: “yüksək entropiyalı tokenləri dəyişdirmək daha təhlükəsizdir” fərziyyəsi proqram kodunda həmişə doğru deyil. Python üzərində aparılan ilkin analizdə keywords, yəni açar sözlər ən yüksək orta token entropiyasına malik kateqoriya kimi müəyyən edilmişdir. MBPP+ üzərində açar sözlərin orta entropiyası 2,81 olduğu halda, su nişanlama üçün hədəflənən “etc” kateqoriyasında 1,98-dir. HumanEval+-da da açar sözlər 1,58 ilə ən yüksək kateqoriyadır; “etc” kateqoriyası 1,11-dir.
Bu nəticə vacibdir, çünki def, return, True, False, if və ya for kimi yüksək entropiyalı tokenlərin dəyişdirilməsi yalnız mətnin üslubunu deyil, proqramın sintaksisini və ya məntiqini də dəyişə bilər. Əvvəlki SWEET metodu yüksək entropiyalı tokenləri hədəflədiyi üçün tədqiqatçılar seçilmiş tokenlərin bir hissəsinin sintaktik elementlər olduğunu göstərmişlər. HumanEval+ üçün SWEET-in optimal ayarında seçdiyi tokenlərin təxminən %12,6-sı sintaksislə əlaqəli tokenlərdir.
STONE bunun əvəzinə keywords, whitespace, types, delimiters və operators olmaqla beş sintaksis sinfini su nişanı hədəfindən kənarda saxlamağı nəzərdə tutur. Su nişanı siqnalı bu siniflərə daxil olmayan token sahəsində yaradılır. Generasiya zamanı token namizədləri yaşıl və qırmızı siyahılara ayrılır; yaşıl siyahıdakı tokenlərin logit dəyərləri artırılaraq yaradılan kodda statistik olaraq aşkarlana bilən nümunə buraxılır. Aşkarlama mərhələsində də yalnız sintaktik olmayan tokenlər üzrə yaşıl token nisbəti və z-skoru hesablanır.
Tədqiqatın əsas Qwen2.5-Coder-7B təcrübələrində STONE dörd qiymətləndirmə dəstinin hamısında ən yüksək STEM birləşdirilmiş skorunu verdi. Bərabər çəkili STEM dəyərləri MBPP+ üçün 0,848, HumanEval+ üçün 0,781, HumanEvalPack-C++ üçün 0,780 və HumanEvalPack-Java üçün 0,715 olaraq bildirildi.
Funksional düzgünlük baxımından STONE-un correctness dəyərləri eyni ardıcıllıqla 0,571, 0,587, 0,622 və 0,445-dir. Tədqiqatçılar bu dəyərlərin SWEET-lə müqayisədə dörd benchmark üzrə orta hesabla %7,57 daha yüksək düzgünlük təmin etdiyini hesablayıblar. MBPP+ üçün su nişansız kodun pass@1 dəyəri 0,571 olduğu halda STONE-un dəyəri də 0,571-dir. HumanEval+-da su nişansız nəticə 0,595, STONE isə 0,587-dir.
Aşkarlama uğurunda da STONE dörd əsas məlumat dəstində müvafiq olaraq 0,982, 0,777, 0,729 və 0,721 AUROC əldə etdi. Bununla belə, metod görünməzlik göstəricisində hər benchmark-da ən yüksək nəticəyə malik deyil. Məsələn, MBPP+-da KGW və EWD üçün imperceptibility 0,994 olduğu halda STONE 0,990-dır. Buna görə tədqiqatın güclü nəticəsi “STONE hər göstəricidə ən yaxşıdır” deyil, üç məqsəd arasında daha balanslı ümumi performans təqdim etməsidir.
STONE-un digər üstünlüyü aşkarlama müddətidir. Su nişanı əlavə etmə müddətləri müqayisə olunan metodlarla oxşar səviyyədə olduğu halda, tədqiqatçılar STONE-un məlumat dəsti səviyyəsində su nişanı aşkarlamasının SWEET və EWD-yə nisbətən orta hesabla təxminən %86 daha sürətli olduğunu bildirirlər. Bunun əsas səbəbi STONE aşkarlamasının token entropiyasını yenidən hesablamaq əvəzinə əvvəlcədən müəyyən edilmiş yaşıl siyahı mexanizmindən istifadə etməsidir.
Metod hücumlara tam dayanıqlı deyil. HumanEval+ üzərində STONE-un aşkarlama dəyəri hücum olmadıqda 0,777, kod refaktorinq edildikdə 0,664 və kod paraphrase edildikdə 0,600-ə düşmüşdür. MBPP+-da uyğun dəyərlər 0,982, 0,907 və 0,824-dür. Buna baxmayaraq, eyni təcrübələrdə STONE SWEET-dən daha yüksək aşkarlama performansı göstərmişdir.
Türkiyə baxımından qiymətləndirmə: Bu tədqiqat Türkiyədə konkret proqram təminatı hazırlama mühitində, universitet tapşırıq sistemində və ya kommersiya kod generasiya xidmətində sınaqdan keçirilməyib. Buna baxmayaraq, süni intellekt tərəfindən yaradılan kodun mənbəyinin izlənməsi, proqram təminatı təchizat zənciri, təhsildə kod generasiyası, korporativ kod siyasətləri və model təminatçılarının yaratdığı məzmunun işarələnməsi baxımından Türkiyədəki tədqiqat və proqram təminatı komandaları üçün araşdırıla bilər. Lakin STONE “AI kod detektoru” kimi hər hansı kod parçasını geriyə dönük və qəti şəkildə təsnif etmir; su nişanının kod yaradılarkən müvafiq metodla qəsdən yerləşdirilməsi lazımdır. Buna görə metodun istifadəsi “bu kod mütləq süni intellekt tərəfindən yazılıb” şəklində universal məhkəmə-sübut vasitəsi kimi şərh edilməməlidir.
Kodun su nişanlanması problemi niyə təbii dildən fərqlidir?
Təbii dil su nişanlamasında kiçik söz seçimləri çox vaxt mətnin əsas mənasını və ya etibarlılığını pozmur. Kod generasiyasında isə tək bir simvol və ya token proqramın kompilyasiya olunmasını və ya işləməsini tamamilə dəyişə bilər.
Məsələn:
- iki nöqtə işarəsinin silinməsi Python sintaksis xətası yarada bilər,
+əvəzinə-istifadə edilməsi proqramın hesablamasını dəyişə bilər,TrueəvəzinəFalseistifadə edilməsi idarəetmə axınını tərsinə çevirə bilər,- mötərizənin və ya kvadrat mötərizənin dəyişdirilməsi parse xətasına səbəb ola bilər.
Tədqiqatın 1. səhifəsindəki Şəkil 1 bu problemi sadə is_even funksiyası üzərindən vizuallaşdırır: tədqiqatçılar əvvəlki su nişanlama yanaşmasının sintaksis tokenlərini dəyişə bilməsini “syntax error” riski ilə müqayisə edərkən STONE-un sintaktik tokenləri qorumağı hədəflədiyini göstərirlər.
Yüksək entropiya niyə təhlükəsiz token demək deyil?
Əvvəlki SWEET yanaşması dil modelinin hansı tokeni seçəcəyinə daha az əmin olduğu, yəni entropiyanın yüksək olduğu nöqtələrdə su nişanı yerləşdirməyin çıxış keyfiyyətini daha az pozacağı fikrinə əsaslanır.
Token entropiyası mənbədə Shannon entropiyası ilə:
\[ H_t = -\sum_{i=1}^{|V|} P(y_t=v_i\mid y_{
kimi müəyyən edilir.
Burada \(V\) modelin söz ehtiyatını, \(y_{
Tədqiqatçıların Qwen2.5-Coder-7B ilə apardığı ilkin analiz Python-da sintaksis baxımından kritik bəzi kateqoriyaların eyni zamanda yüksək entropiyalı ola biləcəyini göstərmişdir.
| Token kateqoriyası | MBPP+ orta entropiya | HumanEval+ orta entropiya |
|---|---|---|
| Keywords | 2,81 | 1,58 |
| Etc | 1,98 | 1,11 |
| Types | 1,83 | 1,09 |
| Delimiters | 1,06 | 0,78 |
| Whitespace | 0,93 | 0,46 |
| Operators | 0,93 | 0,63 |
Beləliklə, yalnız “yüksək entropiyalı token” meyarı istifadə edilərsə, proqramın quruluşu baxımından kritik token də su nişanı hədəfinə çevrilə bilər.
STONE hansı tokenləri sintaktik hesab edir?
STONE üç proqramlaşdırma dili üçün beş əsas sintaksis sinfi müəyyən edir:
- Keywords: dilin rezerv edilmiş açar sözləri,
- Whitespace: boşluq, sətirsonu və tabulyasiya,
- Types: əsas tip göstəriciləri,
- Delimiters: mötərizə, ayırıcı, durğu işarəsi və bənzər struktur simvolları,
- Operators: arifmetik, məntiqi, müqayisə və mənimsətmə operatorları.
Bu beş qrupa daxil olmayan tokenlər tədqiqatda “etc” kateqoriyasında qiymətləndirilir və STONE-un əsas su nişanı hədəf sahəsini təşkil edir.
STONE su nişanını necə əlavə edir?
Generasiyanın \(t\) addımında dil modeli əvvəlcə standart logit vektorunu hesablayır:
\[ l_t=f_{LM}(x,y_{
və bu dəyərlərdən başlanğıc ehtimal paylanması alınır:
\[ p_{t,i} = \frac{e^{l_t[i]}} {\sum_{j=1}^{|V|}e^{l_t[j]}} \]
STONE əvvəlcə bu paylanmadan namizəd token nümunələyir. Namizəd sintaksis çoxluğuna aid deyilsə, əvvəlki tokenin hash dəyəri seed kimi istifadə olunur və söz ehtiyatı yaşıl \(G_t\) və qırmızı \(R_t\) siyahılara bölünür.
Yaşıl siyahıdakı tokenlərin logitlərinə sabit \(\delta\) əlavə edilir:
\[ l_t[i]\leftarrow l_t[i]+\delta, \qquad i\in G_t \]
Bu dəyişiklik yaşıl tokenlərin yaradılma ehtimalını artırır. Daha sonra düzəldilmiş paylanmadan yekun token nümunələnir.
Verianla Live: STONE su nişanı yerləşdirmə zənciri
Bu proses tədqiqatın Alqoritm 1 və Alqoritm 2-də müəyyən etdiyi generasiya və aşkarlama məntiqinin sadələşdirilmiş elmi xülasəsidir.
| Mərhələ | Əməliyyat | Məqsəd |
|---|---|---|
| 1. Standart generasiya | Dil modeli mövcud kontekstə görə token logitlərini və ehtimallarını hesablayır. | Normal kod generasiya paylanmasını əldə etmək. |
| 2. Sintaksis yoxlaması | Nümunələnmiş namizəd token syntax element set ilə yoxlanılır. | Sintaksis baxımından kritik sahələrdə su nişanı müdaxiləsinin qarşısını almaq. |
| 3. Yaşıl/qırmızı siyahı | Əvvəlki tokenin hash dəyərindən istifadə edilərək söz ehtiyatı yaşıl və qırmızı siyahıya bölünür. | Təkrarlana bilən gizli su nişanı nümunəsi yaratmaq. |
| 4. Logit sürüşdürülməsi | Yaşıl siyahıdakı tokenlərin logitlərinə δ əlavə edilir. | Yaşıl tokenlərin yaradılma ehtimalını artırmaq. |
| 5. Kod generasiyası | Düzəldilmiş paylanmadan yekun token nümunələnir. | Su nişanı siqnalını kod generasiyasına daşımaq. |
| 6. Su nişanının aşkarlanması | Sintaktik olmayan tokenlər arasındakı yaşıl token sayı və z-skoru hesablanır. | Kodda STONE su nişanı üçün statistik dəlil axtarmaq. |
Verianla Live: Vizuallaşdırma yuxarıdakı görünən elmi proses cədvəlindən yaradılır. Cədvəl elmi source-of-truth kimi qorunur.
Aşkarlama z-skoru necə hesablanır?
STONE aşkarlama zamanı yalnız “etc” kimi qəbul edilən sintaktik olmayan tokenləri sayır. Onların ümumi sayı \(N^E\), yaşıl siyahıda olanların sayı isə \(N_G^E\) kimi müəyyən edilir.
Z-skoru:
\[ z= \frac{ N_G^E-\gamma N^E }{ \sqrt{\gamma(1-\gamma)N^E} } \]
şəklindədir.
Hesablanan dəyər əvvəlcədən müəyyən edilmiş \(z_{threshold}\) həddini keçərsə, ardıcıllıq su nişanlı kimi təsnif edilir.
Bu mexanizm yalnız su nişanını yaradarkən istifadə edilən siyahılama qaydası məlum olan və ya yenidən yaradıla bilən kodlarda işləyir. Ümumi təyinatlı “LLM kodunu tanıma” metodu deyil.
STEM niyə hazırlanıb?
Tədqiqatçılar mövcud kod su nişanlama işlərinin fərqli göstəricilərə fokuslandığını və bunun metodlar arasında balanslı müqayisəni çətinləşdirdiyini irəli sürürlər. Bir sistem su nişanını çox asan aşkarlada bilər, lakin çoxlu səhv proqram yarada bilər; başqa sistem kodu qoruya bilər, amma su nişanı siqnalı çox zəif ola bilər.
STONE ilə birlikdə təklif olunan STEM metrikası üç ölçünü bir çəkili skor altında birləşdirir:
\[ STEM= \alpha\cdot Correctness+ \beta\cdot Detectability+ \zeta\cdot Imperceptibility \]
və:
\[ \alpha+\beta+\zeta=1 \]
şərti istifadə olunur.
Correctness necə ölçülür?
Funksional düzgünlük üçün kod generasiya tədqiqatlarında istifadə olunan pass@k göstəricisi tətbiq edilir. Bu göstərici yaradılmış \(k\) həlldən ən azı birinin bütün testlərdən keçmə ehtimalını qiymətləndirir.
Əsas təcrübələrdə bildirilən correctness sütunları pass@1 əsaslı qiymətləndirməni ifadə edir.
Detectability necə ölçülür?
Yaşıl token nisbətindən alınan z-skorunun fərqli hədlərdə insan tərəfindən yazılmış və su nişanlı kodları nə dərəcədə ayıra bildiyi ROC əyrisi ilə qiymətləndirilmiş; nəticə AUROC ilə bildirilmişdir.
AUROC yüksəldikcə iki kod qrupunu su nişanı statistikası ilə ayırmaq asanlaşır.
Imperceptibility nəyi ölçür?
Tədqiqatçılar su nişanının kodun təbii token ehtimal paylanmasını nə dərəcədə dəyişdirdiyini perplexity vasitəsilə qiymətləndirirlər.
Imperceptibility:
\[ 1- \frac{ |PPL(C_{wm})-PPL(C)| }{ PPL(C) } \]
kimi müəyyən edilmişdir.
Burada \(C_{wm}\) su nişanlı kod, \(C\) isə su nişansız kod çoxluğudur. Skor 1-ə yaxınlaşdıqca su nişanının token paylanmasında daha kiçik nisbi dəyişiklik yaratdığı qəbul edilir. Çox böyük paylanma dəyişikliklərində metrikanın mənfi dəyər alması da mümkündür; tədqiqatın CodeIP təkrar təcrübəsində bunun nümunələri vardır.
Hansı məlumat dəstlərindən istifadə edildi?
| Məlumat dəsti | Dil | Problem sayı | Orta həll uzunluğu (token) |
|---|---|---|---|
| MBPP+ | Python | 399 | 40,25 |
| HumanEval+ | Python | 164 | 188,28 |
| HumanEvalPack-C++ | C++ | 164 | 223,10 |
| HumanEvalPack-Java | Java | 164 | 237,36 |
Hansı metodlarla müqayisə edildi?
Əsas müqayisədə üç training-free metod istifadə edildi:
- KGW: hər generasiya addımında söz ehtiyatını yaşıl və qırmızı siyahılara bölərək yaşıl tokenlərə üstünlük verən əsas yanaşma,
- EWD: aşkarlamada token entropiyasını çəkiləndirən metod,
- SWEET: su nişanını yalnız yüksək entropiyalı tokenlərə yerləşdirməyi hədəfləyən kod su nişanlama metodu.
CodeIP əsas baseline qrupuna daxil edilməyib, çünki əlavə type-prediction modelinin öyrədilməsini tələb edir, halbuki STONE və əsas müqayisələr training-free-dir. Tədqiqatçılar CodeIP-ni ayrıca Əlavə A-da yenidən tətbiq edərək nəticələri bildiriblər.
Əsas model və generasiya ayarları hansılardır?
Əsas təcrübələrdə Qwen2.5-Coder-7B istifadə edilmişdir. Əlavə B-də Llama-3.1-8B ilə də təcrübə aparılmışdır.
Əsas generasiya ayarları:
- top-k = 50,
- temperature = 1,0,
- \(\gamma=0,5\),
- MBPP+ üçün \(\delta=1,0\),
- HumanEval+, C++ və Java üçün \(\delta=0,5\).
Imperceptibility qiymətləndirməsində perplexity hesablamaq üçün StarCoder2-7B istifadə edilmişdir. Təcrübələrin NVIDIA A6000 GPU üzərində aparıldığı bildirilir.
STONE-un əsas nəticələri nədir?
Düzgünlük nəticələri ayrıca necədir?
| Metod | MBPP+ | HumanEval+ | C++ | Java |
|---|---|---|---|---|
| KGW | 0,499 | 0,573 | 0,576 | 0,387 |
| EWD | 0,499 | 0,573 | 0,576 | 0,387 |
| SWEET | 0,502 | 0,574 | 0,584 | 0,413 |
| STONE | 0,571 | 0,587 | 0,622 | 0,445 |
STONE dörd əsas benchmark-ın hamısında ən yüksək correctness dəyərinə çatmışdır. Tədqiqatçılar SWEET-lə müqayisədə orta nisbi fərqi %7,57 olaraq bildirirlər.
Su nişansız kodla müqayisə etdikdə nə baş verir?
Əlavə F-də su nişansız kod təcrübələri də verilmişdir:
| Metod | MBPP+ pass@1 | HumanEval+ pass@1 |
|---|---|---|
| Su nişanı yoxdur | 0,571 | 0,595 |
| STONE | 0,571 | 0,587 |
| SWEET | 0,502 | 0,574 |
| KGW | 0,499 | 0,573 |
| EWD | 0,499 | 0,573 |
MBPP+-da STONE su nişanlı və su nişansız generasiyanın pass@1 dəyəri eynidir. HumanEval+-da isə 0,595-dən 0,587-yə kiçik azalma görünür. Buna görə “STONE heç bir halda düzgünlüyü azaltmır” demək mənbə nəticələrini aşır; daha düzgün ifadə odur ki, araşdırılan testlərdə düzgünlük itkisi digər su nişanlama metodlarından daha kiçikdir.
Aşkarlama uğuru necədir?
| Metod | MBPP+ AUROC | HumanEval+ AUROC | C++ AUROC | Java AUROC |
|---|---|---|---|---|
| KGW | 0,831 | 0,523 | 0,621 | 0,546 |
| EWD | 0,965 | 0,730 | 0,681 | 0,646 |
| SWEET | 0,867 | 0,710 | 0,641 | 0,580 |
| STONE | 0,982 | 0,777 | 0,729 | 0,721 |
Əsas Qwen2.5-Coder-7B təcrübəsində STONE dörd məlumat dəstinin hamısında ən yüksək detectability dəyərini verir.
Görünməzlikdə də ən yaxşıdırmı?
Xeyr. Imperceptibility nəticələri:
| Metod | MBPP+ | HumanEval+ | C++ | Java |
|---|---|---|---|---|
| KGW | 0,994 | 0,986 | 0,993 | 0,993 |
| EWD | 0,994 | 0,986 | 0,993 | 0,993 |
| SWEET | 0,992 | 0,978 | 0,979 | 0,901 |
| STONE | 0,990 | 0,978 | 0,990 | 0,979 |
KGW və EWD bu göstəricidə bir qədər daha yüksək dəyərlərə malikdir. STONE-un iddia edilən üstünlüyü görünməzlikdə mütləq birincilik deyil; görünməzliyi yüksək səviyyədə saxlayarkən correctness və detectability-ni birlikdə gücləndirməsidir.
66 fərqli STEM çəkisində nəticə dəyişirmi?
Tədqiqatçılar \(\alpha\), \(\beta\) və \(\zeta\) dəyərlərini 0,0–1,0 arasında 0,1 addımlarla dəyişdirərək cəmi 1 olan 66 fərqli çəki kombinasiyasını qiymətləndirmişlər.
STONE-un ən yüksək STEM skorunu aldığı kombinasiya nisbətləri:
- MBPP+: %97,0,
- HumanEval+: %90,9,
- HumanEvalPack-C++: %98,5,
- HumanEvalPack-Java: %95,5.
Bu analiz əsas nəticələrin yalnız bərabər çəki seçiminin nəticəsi olmadığını göstərir. Bununla belə, hər hansı istifadəçinin seçə biləcəyi bütün mümkün davamlı çəki kombinasiyalarının sınaqdan keçirildiyi demək deyil; tədqiqat 0,1 intervallı göstərilən 66 kombinasiyanı qiymətləndirmişdir.
STONE nə qədər sürətlidir?
Məlumat dəsti səviyyəsində ümumi aşkarlama müddətləri:
| Metod | MBPP+ (san) | HumanEval+ (san) | C++ (san) | Java (san) |
|---|---|---|---|---|
| KGW | 12,90 | 4,19 | 8,01 | 8,95 |
| EWD | 100,43 | 34,51 | 56,85 | 59,84 |
| SWEET | 100,94 | 34,68 | 58,08 | 59,22 |
| STONE | 13,27 | 4,62 | 8,48 | 9,24 |
STONE-un aşkarlama müddəti KGW-yə çox yaxın olduğu halda EWD və SWEET-dən nəzərəçarpacaq dərəcədə aşağıdır. Tədqiqatçılar bunun EWD və SWEET-in aşkarlama zamanı token ehtimal paylanması/entropiya hesablaması aparmasına qarşılıq STONE-un yaşıl siyahı yoxlaması ilə işləməsindən qaynaqlandığını bildirirlər.
Su nişanı əlavə etmə müddətləri isə bütün metodlarda eyni miqyasdadır; STONE-un böyük sürət üstünlüyü xüsusilə aşkarlama mərhələsindədir.
Refactoring hücumuna nə qədər davamlıdır?
HumanEval+ üzərində:
| Şərait | SWEET | STONE |
|---|---|---|
| Hücum yoxdur | 0,710 | 0,777 |
| Kod refactoring | 0,539 | 0,664 |
| Kod paraphrasing | 0,563 | 0,600 |
MBPP+ üzərində:
| Şərait | SWEET | STONE |
|---|---|---|
| Hücum yoxdur | 0,679 | 0,982 |
| Kod refactoring | 0,359 | 0,907 |
| Kod paraphrasing | 0,385 | 0,824 |
STONE hər iki hücum növündə müqayisə edilən SWEET-dən daha yüksək aşkarlama performansı göstərir. Lakin dəyərlərin hücumsuz vəziyyətlə müqayisədə azalması su nişanının dəyişikliklərdən təsirlənə bildiyini açıq şəkildə göstərir.
Paraphrasing niyə STONE-a təsir edir?
Tədqiqatçılar refactoring əməliyyatının sintaksis sərhədlərinin çoxunu qoruduğunu və buna görə non-syntax token sahəsindəki su nişanının əhəmiyyətli hissəsinin qala bildiyini bildirirlər.
Paraphrasing isə dəyişən adları və ifadələr kimi sintaksisdən kənar sahələri dəyişə bilər. Bunlar STONE-un su nişanı hədəfləri ilə birbaşa üst-üstə düşdüyü üçün aşkarlama siqnalı azala bilər.
STONE alqoritmi bilən hücumçuya qarşı sınaqdan keçirilibmi?
Xeyr. Bu, tədqiqatın öz məhdudiyyətlər bölməsində açıq şəkildə qeyd olunur.
STONE-un alqoritmini bilən hücumçu xüsusilə sintaktik olmayan tokenləri hədəfləyərək:
- bütün dəyişənlərin adlarını sistemli şəkildə yenidən qoya bilər,
- şərhləri silə bilər,
- STONE-un su nişanı sıxlığını azaldacaq hədəfli transformasiyalar tətbiq edə bilər.
Tədqiqatçılar belə algorithm-aware hücumlara qarşı yeni müdafiələri gələcək iş sahəsi kimi müəyyən edirlər.
Code golf və obfuscated kod niyə problem yarada bilər?
STONE-un daşıya biləcəyi su nişanı miqdarı sintaktik olmayan token sıxlığından asılıdır. Normal benchmark kodlarında kifayət qədər hədəf token vardır.
Lakin çox qısa, sıxlaşdırılmış “code golf” həllərində və ya qəsdən obfuscate edilmiş kodlarda bu tokenlərin sayı azala bilər. Belə hallarda su nişanı çox seyrək hala gələrək etibarlı aşkarlama üçün yetərli olmaya bilər.
Llama-3.1-8B nəticələri eyni meyli göstərirmi?
Əlavə təcrübələrdə MBPP+ və HumanEval+ üzərində Llama-3.1-8B istifadə edilmişdir. STONE yenə bərabər çəkili STEM-də ən yüksək skorları yaratmışdır:
- MBPP+: STONE 0,782,
- HumanEval+: STONE 0,699.
Bununla belə, HumanEval+ detectability dəyərində EWD 0,755 ilə STONE-un 0,741 dəyərindən bir qədər yüksəkdir. Buna baxmayaraq, STONE daha yüksək correctness hesabına birləşdirilmiş STEM skorunda öndə qalmışdır.
Bu nəticə də metodun iddiasının “hər modeldə hər alt metrikanı qazanmaq” deyil, ümumi balansı qorumaq olduğunu dəstəkləyir.
Tədqiqatın dəstəklədiyi nəticələr
- Yüksək token entropiyası proqram kodunda sintaksis baxımından təhlükəsiz dəyişiklik demək deyil.
- Python ilkin analizində keywords kateqoriyası araşdırılan iki benchmark-da ən yüksək orta entropiyaya malikdir.
- SWEET-in optimal HumanEval+ ayarında seçilən tokenlərin təxminən %12,6-sı syntax tokenləridir.
- STONE sintaktik tokenləri su nişanı hədəfindən ayıran generasiya və aşkarlama yanaşması təklif edir.
- Qwen2.5-Coder-7B əsas təcrübəsində STONE dörd benchmark-da ən yüksək correctness, detectability və bərabər çəkili STEM dəyərlərini vermişdir.
- STONE-un imperceptibility dəyəri yüksək qalmış, lakin bu alt metrikanın mütləq ən yaxşı dəyəri həmişə STONE-a aid olmamışdır.
- STONE SWEET-lə müqayisədə orta hesabla %7,57 daha yüksək correctness nəticəsi vermişdir.
- STONE aşkarlamasının EWD və SWEET-in entropy əsaslı aşkarlamasından orta hesabla təxminən %86 daha sürətli olduğu bildirilmişdir.
- 66 STEM çəkiləndirməsinin böyük əksəriyyətində STONE birinci yerdə qalmışdır.
- Refactoring və paraphrasing hücumlarından sonra detectability azalsa da, araşdırılan təcrübələrdə STONE SWEET-dən daha dayanıqlı qalmışdır.
Tədqiqatın dəstəkləmədiyi və ya hələ göstərmədiyi nəticələr
- STONE hər hansı naməlum kodun LLM tərəfindən yazıldığını su nişanı olmadan müəyyən edən ümumi təyinatlı detektor deyil.
- Su nişanının bütün kod transformasiyalarına qarşı silinməz olduğu göstərilməmişdir.
- STONE alqoritmini bilən hədəfli hücumçulara qarşı dayanıqlıq eksperimental olaraq göstərilməmişdir.
- Obfuscated və ya code-golf kodlarında etibarlı aşkarlama zəmanət verilmir.
- Bütün proqramlaşdırma dilləri qiymətləndirilməyib; əsas təcrübələr Python, C++ və Java ilə məhdudlaşıb.
- Real korporativ proqram təminatı repozitoriyalarında və ya milyonlarla sətirlik istehsal kodunda sahə qiymətləndirməsi aparılmayıb.
- STONE bütün alt metriklərdə həmişə ən yüksək nəticəni vermir.
- Su nişanlı kodun aşkarlanması özlüyündə müəllif kimliyinin, pis niyyətin, akademik pozuntunun və ya hüquqi məsuliyyətin sübutu deyil.
Tədqiqatın Metodu və Nəticələri
Tədqiqat sualları
Tədqiqat üç əsas suala fokuslanır:
- STONE funksional düzgünlüyü qoruya bilirmi?
- Correctness, detectability və imperceptibility arasında STEM ilə ölçülən balanslı performans təmin edə bilirmi?
- Su nişanı yerləşdirmə və aşkarlama baxımından hesablama xərci nə qədərdir?
Əsas Qwen2.5-Coder-7B nəticələrinin hamısı
| Dataset | Metod | Correctness | Detectability | Imperceptibility | STEM |
|---|---|---|---|---|---|
| MBPP+ | KGW | 0,499 | 0,831 | 0,994 | 0,775 |
| MBPP+ | EWD | 0,499 | 0,965 | 0,994 | 0,819 |
| MBPP+ | SWEET | 0,502 | 0,867 | 0,992 | 0,787 |
| MBPP+ | STONE | 0,571 | 0,982 | 0,990 | 0,848 |
| HumanEval+ | KGW | 0,573 | 0,523 | 0,986 | 0,694 |
| HumanEval+ | EWD | 0,573 | 0,730 | 0,986 | 0,763 |
| HumanEval+ | SWEET | 0,574 | 0,710 | 0,978 | 0,754 |
| HumanEval+ | STONE | 0,587 | 0,777 | 0,978 | 0,781 |
| HEP-C++ | KGW | 0,576 | 0,621 | 0,993 | 0,730 |
| HEP-C++ | EWD | 0,576 | 0,681 | 0,993 | 0,750 |
| HEP-C++ | SWEET | 0,584 | 0,641 | 0,979 | 0,735 |
| HEP-C++ | STONE | 0,622 | 0,729 | 0,990 | 0,780 |
| HEP-Java | KGW | 0,387 | 0,546 | 0,993 | 0,642 |
| HEP-Java | EWD | 0,387 | 0,646 | 0,993 | 0,675 |
| HEP-Java | SWEET | 0,413 | 0,580 | 0,901 | 0,631 |
| HEP-Java | STONE | 0,445 | 0,721 | 0,979 | 0,715 |
Emal müddəti
| Dataset | Metod | Insertion (san) | Detection (san) |
|---|---|---|---|
| MBPP+ | KGW | 3320 | 12,90 |
| MBPP+ | EWD | 3320 | 100,43 |
| MBPP+ | SWEET | 3300 | 100,94 |
| MBPP+ | STONE | 3266 | 13,27 |
| HumanEval+ | KGW | 1268 | 4,19 |
| HumanEval+ | EWD | 1268 | 34,51 |
| HumanEval+ | SWEET | 1270 | 34,68 |
| HumanEval+ | STONE | 1277 | 4,62 |
| HEP-C++ | KGW | 1308 | 8,01 |
| HEP-C++ | EWD | 1308 | 56,85 |
| HEP-C++ | SWEET | 1454 | 58,08 |
| HEP-C++ | STONE | 1300 | 8,48 |
| HEP-Java | KGW | 1506 | 8,95 |
| HEP-Java | EWD | 1506 | 59,84 |
| HEP-Java | SWEET | 1480 | 59,22 |
| HEP-Java | STONE | 1459 | 9,24 |
SWEET-in syntax-token əhatəsi
Əlavə E-də entropy threshold dəyişdikcə SWEET-in neçə token seçdiyi və seçilənlərin nə qədərinin syntax token olduğu araşdırılmışdır.
HumanEval+ üçün optimal entropy threshold 0,9 olduqda:
- yaradılmış bütün tokenlərin %28,98-i seçilmişdir,
- seçilənlərin %12,60-ı syntax tokenidir.
Bu syntax tokenləri daxilində mənbədə verilən bölgü:
- delimiters: %49,29,
- whitespace: %38,17,
- keywords: %9,44,
- types: %3,17,
- operators: %2,78.
Bu faizlərin alt kateqoriya hesabatı mənbədə verildiyi şəkildə ötürülmüşdür; yuvarlaqlaşdırma və kateqoriya hesabat üsulu səbəbindən cəmin tam olaraq %100-ə bərabər olması gözlənilməməlidir.
CodeIP əlavə müqayisəsinin nəticəsi
Tədqiqatçılar training tələb etdiyi üçün CodeIP-ni əsas baseline qrupuna daxil etməmiş, lakin Əlavə A-da rəsmi tətbiqini yenidən işə salmışlar.
CodeIP detectability dəyərləri 0,945–0,994 arasında yüksək qaldığı halda correctness nəticələri MBPP+ üçün 0,093, HumanEval+ üçün 0,018, C++ üçün 0,000 və Java üçün 0,073 olaraq müəyyən edilmişdir.
Bu təcrübə yalnız yüksək aşkarlama uğurunun balanslı kod su nişanlama metodu üçün yetərli olmadığını göstərmək məqsədilə istifadə edilmişdir. Bununla belə, bu nəticələr müəlliflərin öz reproduksiya quruluşuna aiddir və CodeIP-nin bütün mümkün ayarları və ya sonrakı versiyaları üçün ümumi hökm kimi şərh edilməməlidir.
Metodun əsas məhdudiyyətləri
- Su nişanı tutumu sintaksisdən kənar token sıxlığından asılıdır.
- Code-golf və ya obfuscated kodda yetərli su nişanı siqnalı yaranmaya bilər.
- Alqoritmi bilən hücumçunun hədəfli token adlandırmasına qarşı əhatəli müdafiə göstərilməmişdir.
- Dayanıqlıq təcrübələri iki ümumi hücum növü ilə məhdudlaşır.
- Əsas qiymətləndirmə üç proqramlaşdırma dili və dörd benchmark ilə məhdudlaşır.
- Əsas model Qwen2.5-Coder-7B-dir; ikinci model analizi yalnız əlavə bölmədə iki Python benchmark-ında aparılmışdır.
- Real böyükmiqyaslı proqram təminatı layihələrində insan proqramçının düzəlişləri ilə uzunmüddətli su nişanı qalıcıllığı sınaqdan keçirilməmişdir.
Alqoritm izahında diqqət edilməli detal
Tədqiqatın izahı STONE-u “yalnız non-syntax tokenlərə su nişanı yerləşdirən” metod kimi müəyyən edir. Alqoritm 1-in çap olunmuş psevdokodunda isə su nişanı əməliyyatının aktivləşdirilib-aktivləşdirilməyəcəyi ilk nümunələnən candidate token-ın syntax çoxluğunda olub-olmamasına görə müəyyən edilir, daha sonra yekun token düzəldilmiş paylanmadan yenidən nümunələnir.
Psevdokod bu ikinci nümunələmədə yekun tokenin syntax çoxluğundan seçilməsini ayrıca qadağan edən müstəqil sətir göstərmir. Mənbə bunun tətbiq kodunda necə həll edildiyini mətndə ayrıca açıqlamır. Buna görə burada metodun müəlliflər tərəfindən verilən “syntax-aware/non-syntax hədəfləmə” tərifi qorunmuş; psevdokod detalından çıxış edərək fərqli alqoritm fərz edilməmişdir.
Mənbə və Metod Qeydi
Tam orijinal tədqiqat adı: Marking Code Without Breaking It: Code Watermarking for Detecting LLM-Generated Code
Müəlliflər və orijinal sıra: Jungin Kim; Shinwoo Park; Yo-Sub Han.
Bərabər töhfə: Jungin Kim və Shinwoo Park mənbədə bərabər töhfə verən müəlliflər kimi işarələnmişdir.
Məsul müəllif: Yo-Sub Han.
Qurum: Yonsei University, Seoul, Republic of Korea.
Mənbə növü və hakemlik: Hakem qiymətləndirməsindən keçmiş konfrans nəşri; Findings of the Association for Computational Linguistics: EACL 2026.
Nəşr: Findings of the Association for Computational Linguistics: EACL 2026.
Nəşriyyat: Association for Computational Linguistics.
Səhifələr: 3990–4002.
Konfrans: 19th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2026), Rabat, Morocco, 24–29 March 2026.
ACL Anthology identifikatoru: 2026.findings-eacl.207
DOI: 10.18653/v1/2026.findings-eacl.207
Rəsmi nəşr bağlantısı: https://aclanthology.org/2026.findings-eacl.207/
DOI bağlantısı: https://doi.org/10.18653/v1/2026.findings-eacl.207
Lisenziya: ACL Anthology-nin 2016 və sonrasında dərc olunan ACL materiallarına tətbiq etdiyi Creative Commons Attribution 4.0 International (CC BY 4.0) lisenziyası.
Maliyyələşdirmə: Tədqiqat NRF grant RS-2025-00562134 və Koreya hökuməti tərəfindən maliyyələşdirilən AI Graduate School Program RS-2020-II201361 dəstəyini bildirir.
Tətbiq kodu: Mənbə tədqiqat STONE tətbiqinin https://github.com/inistory/STONE-watermarking ünvanında olduğunu bildirir.
Əsas model: Qwen2.5-Coder-7B.
Əlavə model: Llama-3.1-8B.
Perplexity qiymətləndirmə modeli: StarCoder2-7B.
Proqramlaşdırma dilləri: Python, C++ və Java.
Benchmark-lar: MBPP+, HumanEval+, HumanEvalPack-C++ və HumanEvalPack-Java.
Əsas müqayisələr: KGW, EWD və SWEET. CodeIP training tələb etdiyi üçün əsas training-free baseline qrupuna daxil edilməmiş və Əlavə A-da ayrıca yenidən qiymətləndirilmişdir.
Əsas qiymətləndirmə göstəriciləri: Correctness üçün pass@k; detectability üçün z-score əsaslı AUROC; imperceptibility üçün perplexity dəyişməsi; birləşdirilmiş qiymətləndirmə üçün STEM.
Hesablama infrastrukturu: NVIDIA A6000 GPU.
Dayanıqlıq analizi: HumanEval+ və MBPP+ üzərində kod refactoring və GPT-4o ilə kod paraphrasing hücumları tətbiq edilmişdir.
Əsas metodoloji məhdudiyyət: STONE yalnız su nişanının generasiya zamanı şüurlu şəkildə yerləşdirildiyi çıxışlarda istifadə oluna bilən provenance mexanizmidir. Su nişansız, başqa təminatçı tərəfindən yaradılmış və ya insan tərəfindən yazılmış hər hansı kodu yalnız üslubuna əsasən etibarlı şəkildə “LLM istehsalı” kimi təsnif edən ümumi detektor deyil.
Hücum məhdudiyyəti: Refactoring və paraphrasing-dən sonra STONE-un detectability dəyəri azalır. Alqoritmi bilən və xüsusilə non-syntax tokenləri hədəfləyən hücumçulara qarşı əhatəli dayanıqlıq göstərilməmişdir.
Ümumiləşdirmə məhdudiyyəti: Nəticələr benchmark əsaslı kod generasiya tapşırıqlarına söykənir. Böyük real dünya repozitoriyaları, uzunmüddətli insan düzəlişləri, fərqli proqramlaşdırma dilləri və geniş model ailələri üçün eyni performans nisbətlərinə zəmanət verilmir.
Müqayisə məhdudiyyəti: STONE bütün ayrı-ayrı alt metriklərdə mütləq ən yaxşı deyil. Xüsusilə imperceptibility baxımından KGW və EWD bəzi əsas təcrübələrdə daha yüksək skor vermişdir. Tədqiqatın əsas nəticəsi STONE-un correctness, detectability və imperceptibility birlikdə qiymətləndirildikdə yüksək və sabit STEM nəticələri yaratmasıdır.
Mənbədaxili alqoritm qeydi: Alqoritm 1-in psevdokodunda su nişanlamanın aktivləşdirilməsi candidate tokenin syntax çoxluğunda olub-olmamasına görə müəyyən edilir, yekun token isə bundan sonra düzəldilmiş paylanmadan yenidən nümunələnir. Mətn metodu non-syntax-only watermarking kimi müəyyən etsə də, psevdokod yekun token üçün ikinci syntax bloklama addımını açıq şəkildə göstərmir. Bu məsələ mənbədə ayrıca uzlaşdırılmadığı üçün Verianla izahında fərziyyəyə əsaslanan düzəliş aparılmamışdır.
Elmi məzmunun əhatə dairəsi: Bu Verianla izahındakı alqoritmlər, formullar, benchmark dəyərləri, hücum nəticələri, emal müddətləri, STEM müqayisələri və məhdudiyyətlər mənbə tədqiqata əsaslanır. Xarici mənbədən yalnız rəsmi bibliografik kimlik, EACL/ACL nəşr statusu və lisenziya məlumatını təsdiqləmək üçün istifadə edilmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib