

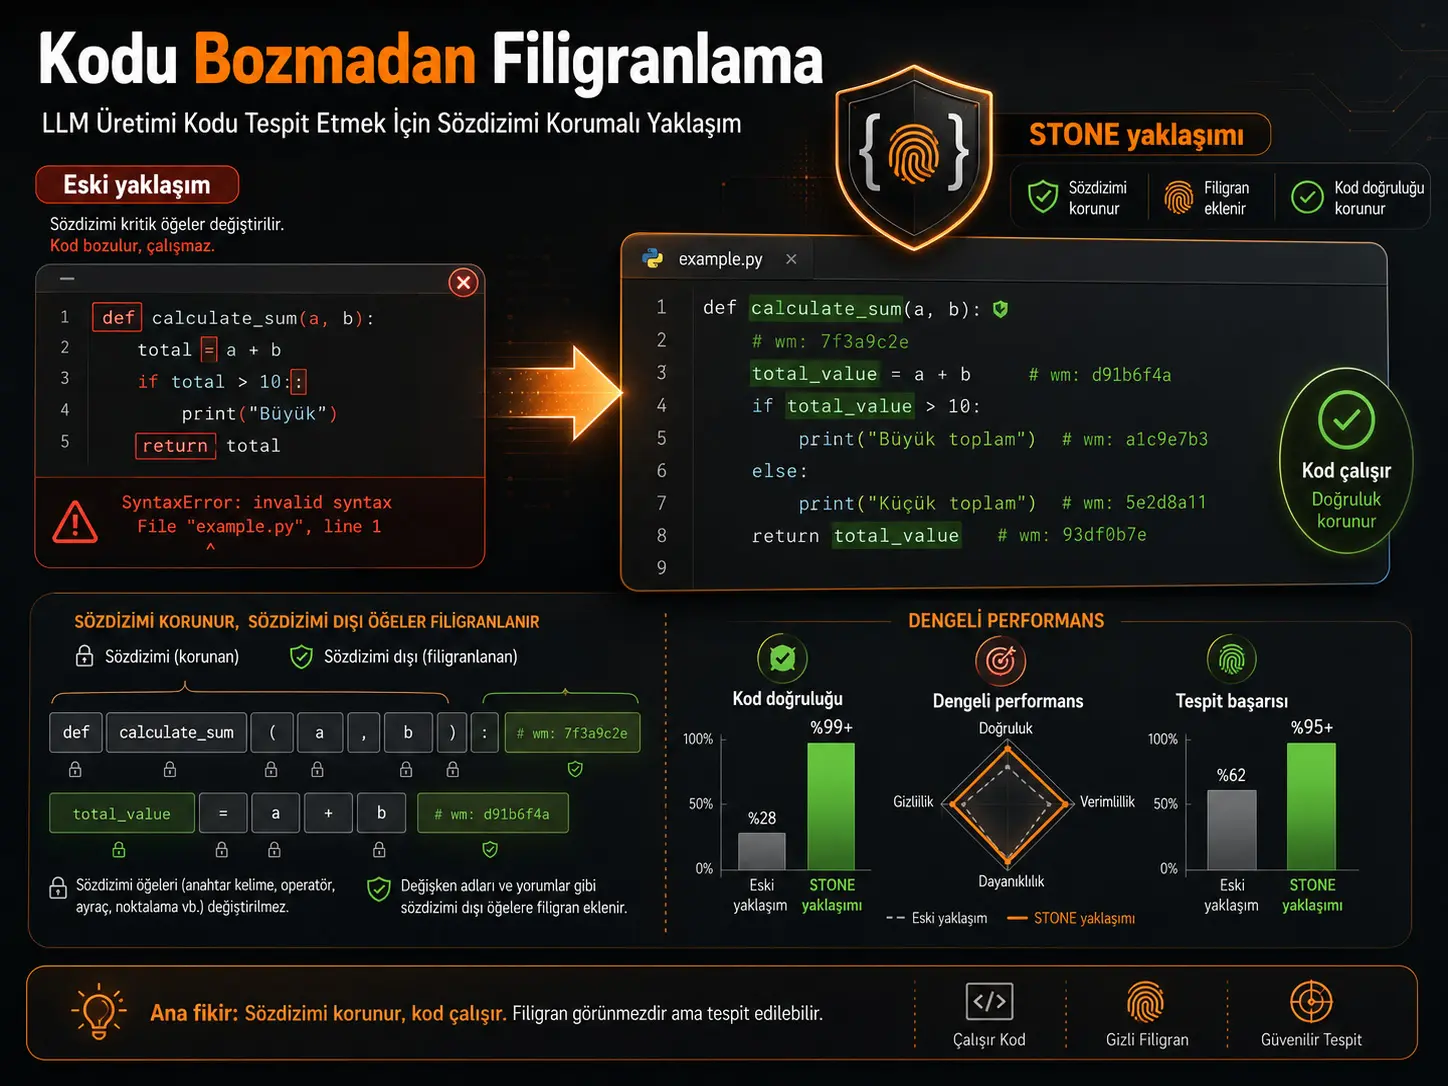
Araştırmacılar, büyük dil modellerinin ürettiği program koduna daha sonra tespit edilebilecek bir filigran yerleştirirken kodun sözdizimini veya çalışma mantığını bozma riskini azaltmayı amaçlayan STONE adlı bir yöntem geliştirdi. STONE'un temel yaklaşımı, filigranı bütün tokenlara veya yalnız yüksek entropili tokenlara uygulamak yerine programın çalışması açısından kritik kabul edilen sözdizimsel tokenları korumaktır.
Çalışmanın çıkış noktası dikkat çekici bir gözlemdir: “yüksek entropili tokenları değiştirmek daha güvenlidir” varsayımı program kodunda her zaman geçerli değildir. Python üzerinde yapılan ön analizde keywords yani anahtar sözcükler en yüksek ortalama token entropisine sahip kategori olarak bulunmuştur. MBPP+ üzerinde anahtar sözcüklerin ortalama entropisi 2,81 iken, filigranlama için hedeflenen “etc” kategorisinde 1,98'dir. HumanEval+'ta da anahtar sözcükler 1,58 ile en yüksek kategoridir; “etc” kategorisi 1,11'dir.
Bu sonuç önemlidir çünkü def, return, True, False, if veya for gibi yüksek entropili tokenların değiştirilmesi yalnız metnin üslubunu değil programın sözdizimini veya mantığını değiştirebilir. Önceki SWEET yöntemi yüksek entropili tokenları hedeflediği için araştırmacılar, seçilen tokenların bir bölümünün sözdizimsel öğeler olduğunu göstermiştir. HumanEval+ için SWEET'in optimum ayarında seçtiği tokenların yaklaşık %12,6'sı sözdizimiyle ilişkili tokenlardır.
STONE bunun yerine keywords, whitespace, types, delimiters ve operators olmak üzere beş sözdizimi sınıfını filigran hedefinin dışında bırakmayı amaçlar. Filigran sinyali, bu sınıflara girmeyen token alanında oluşturulur. Üretim sırasında token adayları yeşil ve kırmızı listelere ayrılır; yeşil listedeki tokenların logit değerleri artırılarak oluşturulan kodda istatistiksel olarak tespit edilebilir bir desen bırakılır. Tespit aşamasında da yalnız sözdizimsel olmayan tokenlar üzerinden yeşil token oranı ve z-skoru hesaplanır.
Araştırmanın ana Qwen2.5-Coder-7B deneylerinde STONE, dört değerlendirme setinin tamamında en yüksek STEM birleşik skorunu verdi. Eşit ağırlıklı STEM değerleri MBPP+ için 0,848, HumanEval+ için 0,781, HumanEvalPack-C++ için 0,780 ve HumanEvalPack-Java için 0,715 olarak raporlandı.
Fonksiyonel doğruluk açısından STONE'un correctness değerleri aynı sırayla 0,571, 0,587, 0,622 ve 0,445'tir. Araştırmacılar bu değerlerin SWEET'e göre dört benchmark genelinde ortalama %7,57 daha yüksek doğruluk sağladığını hesaplamıştır. MBPP+ için filigransız kodun pass@1 değeri 0,571 iken STONE'un değeri de 0,571'dir. HumanEval+'ta filigransız sonuç 0,595, STONE ise 0,587'dir.
Tespit başarısında da STONE dört ana veri setinde sırasıyla 0,982, 0,777, 0,729 ve 0,721 AUROC elde etti. Buna karşılık yöntem görünmezlik ölçütünde her benchmark'ta en yüksek sonuç değildir. Örneğin MBPP+'ta KGW ve EWD için imperceptibility 0,994 iken STONE 0,990'dır. Dolayısıyla çalışmanın güçlü sonucu “STONE her ölçütte en iyidir” değil, üç hedef arasında daha dengeli bir toplam performans sunduğudur.
STONE'un bir diğer avantajı tespit süresidir. Filigran ekleme süreleri karşılaştırılan yöntemlerle benzer düzeydeyken, araştırmacılar STONE'un veri seti seviyesindeki filigran tespitinin SWEET ve EWD'ye göre ortalama yaklaşık %86 daha hızlı olduğunu bildirmektedir. Bunun temel nedeni STONE tespitinin token entropisini yeniden hesaplamak yerine önceden tanımlanmış yeşil liste mekanizmasını kullanmasıdır.
Yöntem saldırılara tamamen dayanıklı değildir. HumanEval+ üzerinde STONE'un tespit değeri saldırı yokken 0,777, kod yeniden düzenlendiğinde 0,664 ve kod paraphrase edildiğinde 0,600'e düşmüştür. MBPP+'ta karşılık gelen değerler 0,982, 0,907 ve 0,824'tür. Buna rağmen aynı deneylerde STONE, SWEET'ten daha yüksek tespit performansı göstermiştir.
Türkiye açısından değerlendirme: Bu çalışma Türkiye'deki belirli bir yazılım geliştirme ortamında, üniversite ödev sisteminde veya ticari kod üretim hizmetinde test edilmemiştir. Buna rağmen yapay zekâ tarafından üretilen kodun kaynağının izlenmesi, yazılım tedarik zinciri, eğitimde kod üretimi, kurumsal kod politikaları ve model sağlayıcılarının ürettiği içeriğin işaretlenmesi açısından Türkiye'deki araştırma ve yazılım ekipleri için incelenebilir. Ancak STONE bir “AI kod dedektörü” olarak herhangi bir kod parçasını geçmişe dönük ve kesin biçimde sınıflandırmaz; filigranın kod üretilirken ilgili yöntemle kasıtlı olarak yerleştirilmiş olması gerekir. Bu nedenle yöntemin kullanımı “bu kod kesin yapay zekâ tarafından yazıldı” şeklinde evrensel bir adli kanıt olarak yorumlanmamalıdır.
Kod filigranlama problemi neden doğal dilden farklı?
Doğal dil filigranlamasında küçük kelime seçimleri çoğu zaman metnin temel anlamını veya geçerliliğini bozmaz. Kod üretiminde ise tek bir karakter veya token programın derlenmesini ya da çalışmasını tamamen değiştirebilir.
Örneğin:
- iki nokta üst üste işaretinin kaldırılması Python sözdizimi hatası oluşturabilir,
+yerine-kullanılması programın hesabını değiştirebilir,TrueyerineFalsekullanılması kontrol akışını tersine çevirebilir,- parantez veya köşeli parantezin değiştirilmesi ayrıştırma hatasına neden olabilir.
Çalışmanın 1. sayfasındaki Şekil 1 bu problemi basit bir is_even fonksiyonu üzerinden görselleştirir: araştırmacılar önceki filigranlama yaklaşımının sözdizim tokenlarını değiştirebilmesini “syntax error” riskiyle karşılaştırırken STONE'un sözdizimsel tokenları korumayı hedeflediğini gösterir.
Yüksek entropi neden güvenli token anlamına gelmiyor?
Önceki SWEET yaklaşımı, dil modelinin hangi tokenı seçeceğinden daha az emin olduğu yani entropinin yüksek olduğu noktalarda filigran yerleştirmenin çıktı kalitesini daha az bozacağı fikrine dayanır.
Token entropisi kaynakta Shannon entropisiyle:
\[ H_t = -\sum_{i=1}^{|V|} P(y_t=v_i\mid y_{
olarak tanımlanmaktadır.
Burada \(V\) modelin kelime dağarcığını, \(y_{
Araştırmacıların Qwen2.5-Coder-7B ile yaptığı ön analiz, Python'da sözdizim açısından kritik bazı kategorilerin aynı zamanda yüksek entropili olabileceğini göstermiştir.
| Token kategorisi | MBPP+ ortalama entropi | HumanEval+ ortalama entropi |
|---|---|---|
| Keywords | 2,81 | 1,58 |
| Etc | 1,98 | 1,11 |
| Types | 1,83 | 1,09 |
| Delimiters | 1,06 | 0,78 |
| Whitespace | 0,93 | 0,46 |
| Operators | 0,93 | 0,63 |
Dolayısıyla yalnız “yüksek entropili token” kriteri kullanılırsa programın yapısı açısından kritik bir token da filigran hedefi haline gelebilir.
STONE hangi tokenları sözdizimsel kabul ediyor?
STONE üç programlama dili için beş temel sözdizimi sınıfı tanımlar:
- Keywords: dilin ayrılmış anahtar sözcükleri,
- Whitespace: boşluk, satır sonu ve sekme,
- Types: temel tür belirteçleri,
- Delimiters: parantez, ayraç, noktalama ve benzeri yapısal karakterler,
- Operators: aritmetik, mantıksal, karşılaştırma ve atama operatörleri.
Bu beş gruba girmeyen tokenlar çalışmada “etc” kategorisinde değerlendirilir ve STONE'un temel filigran hedef alanını oluşturur.
STONE filigranı nasıl ekliyor?
Üretimin \(t\) adımında dil modeli önce standart logit vektörünü hesaplar:
\[ l_t=f_{LM}(x,y_{
ve bu değerlerden başlangıç olasılık dağılımı elde edilir:
\[ p_{t,i} = \frac{e^{l_t[i]}} {\sum_{j=1}^{|V|}e^{l_t[j]}} \]
STONE önce bu dağılımdan bir aday token örnekler. Aday sözdizim kümesine ait değilse, önceki tokenın hash değeri bir seed olarak kullanılır ve kelime dağarcığı yeşil \(G_t\) ve kırmızı \(R_t\) listelere ayrılır.
Yeşil listedeki tokenların logitlerine sabit bir \(\delta\) eklenir:
\[ l_t[i]\leftarrow l_t[i]+\delta, \qquad i\in G_t \]
Bu değişiklik yeşil tokenların üretilme olasılığını yükseltir. Daha sonra düzeltilmiş dağılımdan nihai token örneklenir.
Verianla Live: STONE filigran yerleştirme zinciri
Bu süreç çalışmanın Algoritma 1 ve Algoritma 2'de tanımladığı üretim ve tespit mantığının sadeleştirilmiş bilimsel özetidir.
| Aşama | İşlem | Amaç |
|---|---|---|
| 1. Standart üretim | Dil modeli mevcut bağlama göre token logitlerini ve olasılıklarını hesaplar. | Normal kod üretim dağılımını elde etmek. |
| 2. Sözdizimi kontrolü | Örneklenen aday token syntax element setine karşı kontrol edilir. | Sözdizimi kritik bölgelerde filigran müdahalesini önlemek. |
| 3. Yeşil/kırmızı liste | Önceki tokenın hash değeri kullanılarak kelime dağarcığı yeşil ve kırmızı listeye ayrılır. | Tekrarlanabilir gizli filigran deseni oluşturmak. |
| 4. Logit kaydırma | Yeşil listedeki tokenların logitlerine δ eklenir. | Yeşil tokenların üretilme olasılığını artırmak. |
| 5. Kod üretimi | Düzeltilmiş dağılımdan nihai token örneklenir. | Filigran sinyalini kod üretimine taşımak. |
| 6. Filigran tespiti | Sözdizimsel olmayan tokenlar arasındaki yeşil token sayısı ve z-skoru hesaplanır. | Kodda STONE filigranı için istatistiksel kanıt aramak. |
Verianla Live: Görselleştirme yukarıdaki görünür bilimsel süreç tablosundan oluşturulur. Tablo bilimsel kaynak-of-truth olarak korunur.
Tespit z-skoru nasıl hesaplanıyor?
STONE tespit sırasında yalnız “etc” olarak kabul edilen sözdizimsel olmayan tokenları sayar. Bunların toplam sayısı \(N^E\), yeşil listede bulunanların sayısı ise \(N_G^E\) olarak tanımlanır.
Z-skoru:
\[ z= \frac{ N_G^E-\gamma N^E }{ \sqrt{\gamma(1-\gamma)N^E} } \]
şeklindedir.
Hesaplanan değer önceden belirlenmiş \(z_{threshold}\) eşiğinin üzerine çıkarsa dizi filigranlı olarak sınıflandırılır.
Bu mekanizma yalnız filigranı oluştururken kullanılan listeleme kuralı bilinen veya yeniden üretilebilen kodlarda çalışır. Genel amaçlı bir “LLM kodu tanıma” yöntemi değildir.
STEM neden geliştirildi?
Araştırmacılar mevcut kod filigranlama çalışmalarının farklı ölçütlere odaklandığını ve bunun yöntemler arasında dengeli karşılaştırmayı zorlaştırdığını savunmaktadır. Bir sistem filigranı çok kolay tespit ettirebilir ancak çok sayıda hatalı program üretebilir; başka bir sistem kodu koruyabilir fakat filigran sinyali çok zayıf olabilir.
STONE ile birlikte önerilen STEM metriği üç boyutu tek bir ağırlıklı skor altında toplar:
\[ STEM= \alpha\cdot Correctness+ \beta\cdot Detectability+ \zeta\cdot Imperceptibility \]
ve:
\[ \alpha+\beta+\zeta=1 \]
koşulu kullanılır.
Correctness nasıl ölçülüyor?
Fonksiyonel doğruluk için kod üretim çalışmalarında kullanılan pass@k ölçütü uygulanmaktadır. Bu ölçüt, üretilen \(k\) çözümden en az birinin bütün testleri geçme olasılığını tahmin eder.
Ana deneylerde raporlanan correctness sütunları pass@1 temelli değerlendirmeyi temsil etmektedir.
Detectability nasıl ölçülüyor?
Yeşil token oranından elde edilen z-skorunun farklı eşiklerde insan tarafından yazılmış ve filigranlı kodları ne kadar ayırabildiği ROC eğrisi üzerinden değerlendirilmiş; sonuç AUROC ile raporlanmıştır.
AUROC yükseldikçe iki kod grubunun filigran istatistiğiyle ayrıştırılması kolaylaşmaktadır.
Imperceptibility neyi ölçüyor?
Araştırmacılar filigranın kodun doğal token olasılık dağılımını ne ölçüde değiştirdiğini perplexity üzerinden değerlendirmektedir.
Imperceptibility:
\[ 1- \frac{ |PPL(C_{wm})-PPL(C)| }{ PPL(C) } \]
olarak tanımlanmıştır.
Burada \(C_{wm}\) filigranlı kod, \(C\) ise filigransız kod kümesidir. Skor 1'e yaklaştıkça filigranın token dağılımında daha küçük göreli değişim yaptığı kabul edilir. Çok büyük dağılım değişikliklerinde metriğin negatif değer alması da mümkündür; çalışmanın CodeIP tekrar deneyinde bunun örnekleri bulunmaktadır.
Hangi veri setleri kullanıldı?
| Veri seti | Dil | Problem sayısı | Ortalama çözüm uzunluğu (token) |
|---|---|---|---|
| MBPP+ | Python | 399 | 40,25 |
| HumanEval+ | Python | 164 | 188,28 |
| HumanEvalPack-C++ | C++ | 164 | 223,10 |
| HumanEvalPack-Java | Java | 164 | 237,36 |
Hangi yöntemlerle karşılaştırıldı?
Ana karşılaştırmada üç training-free yöntem kullanıldı:
- KGW: her üretim adımında kelime dağarcığını yeşil ve kırmızı listelere ayırarak yeşil tokenları tercih eden temel yaklaşım,
- EWD: tespitte token entropisini ağırlıklandıran yöntem,
- SWEET: filigranı yalnız yüksek entropili tokenlara yerleştirmeyi amaçlayan kod filigranlama yöntemi.
CodeIP ana baseline grubuna dahil edilmemiştir çünkü ek bir type-prediction modelinin eğitilmesini gerektirirken STONE ve ana karşılaştırmalar training-free'dir. Araştırmacılar CodeIP'yi ayrıca Ek A'da yeniden uygulayarak sonuçlarını raporlamıştır.
Ana model ve üretim ayarları nelerdir?
Ana deneylerde Qwen2.5-Coder-7B kullanılmıştır. Ek B'de Llama-3.1-8B ile de deney yapılmıştır.
Ana üretim ayarları:
- top-k = 50,
- temperature = 1,0,
- \(\gamma=0,5\),
- MBPP+ için \(\delta=1,0\),
- HumanEval+, C++ ve Java için \(\delta=0,5\).
Imperceptibility değerlendirmesinde perplexity hesaplamak için StarCoder2-7B kullanılmıştır. Deneylerin NVIDIA A6000 GPU üzerinde gerçekleştirildiği belirtilmektedir.
STONE'un ana sonuçları ne?
Doğruluk sonuçları tek başına nasıl?
| Yöntem | MBPP+ | HumanEval+ | C++ | Java |
|---|---|---|---|---|
| KGW | 0,499 | 0,573 | 0,576 | 0,387 |
| EWD | 0,499 | 0,573 | 0,576 | 0,387 |
| SWEET | 0,502 | 0,574 | 0,584 | 0,413 |
| STONE | 0,571 | 0,587 | 0,622 | 0,445 |
STONE dört ana benchmark'ın tamamında en yüksek correctness değerine ulaşmıştır. Araştırmacılar SWEET'e karşı ortalama göreli farkı %7,57 olarak raporlamaktadır.
Filigransız kodla karşılaştırıldığında ne oluyor?
Ek F'de filigransız kod deneyleri de verilmiştir:
| Yöntem | MBPP+ pass@1 | HumanEval+ pass@1 |
|---|---|---|
| Filigran yok | 0,571 | 0,595 |
| STONE | 0,571 | 0,587 |
| SWEET | 0,502 | 0,574 |
| KGW | 0,499 | 0,573 |
| EWD | 0,499 | 0,573 |
MBPP+'ta STONE filigranlı ve filigransız üretimin pass@1 değeri aynıdır. HumanEval+'ta ise 0,595'ten 0,587'ye küçük bir düşüş görülmektedir. Dolayısıyla “STONE hiçbir durumda doğruluğu düşürmez” demek kaynak sonuçlarını aşar; daha doğru ifade, incelenen testlerde doğruluk kaybının diğer filigran yöntemlerinden daha küçük olduğudur.
Tespit başarısı nasıl?
| Yöntem | MBPP+ AUROC | HumanEval+ AUROC | C++ AUROC | Java AUROC |
|---|---|---|---|---|
| KGW | 0,831 | 0,523 | 0,621 | 0,546 |
| EWD | 0,965 | 0,730 | 0,681 | 0,646 |
| SWEET | 0,867 | 0,710 | 0,641 | 0,580 |
| STONE | 0,982 | 0,777 | 0,729 | 0,721 |
Ana Qwen2.5-Coder-7B deneyinde STONE dört veri setinde de en yüksek detectability değerini vermektedir.
Görünmezlikte de en iyi mi?
Hayır. Imperceptibility sonuçları:
| Yöntem | MBPP+ | HumanEval+ | C++ | Java |
|---|---|---|---|---|
| KGW | 0,994 | 0,986 | 0,993 | 0,993 |
| EWD | 0,994 | 0,986 | 0,993 | 0,993 |
| SWEET | 0,992 | 0,978 | 0,979 | 0,901 |
| STONE | 0,990 | 0,978 | 0,990 | 0,979 |
KGW ve EWD bu ölçütte biraz daha yüksek değerlere sahiptir. STONE'un iddia edilen avantajı görünmezlikte mutlak birincilik değil; görünmezliği yüksek düzeyde tutarken correctness ve detectability'yi birlikte güçlendirmesidir.
66 farklı STEM ağırlığında sonuç değişiyor mu?
Araştırmacılar \(\alpha\), \(\beta\) ve \(\zeta\) değerlerini 0,0–1,0 arasında 0,1 adımlarla değiştirerek toplamı 1 olan 66 farklı ağırlık kombinasyonunu değerlendirmiştir.
STONE'un en yüksek STEM skorunu aldığı kombinasyon oranları:
- MBPP+: %97,0,
- HumanEval+: %90,9,
- HumanEvalPack-C++: %98,5,
- HumanEvalPack-Java: %95,5.
Bu analiz, ana sonuçların yalnız eşit ağırlık seçiminin sonucu olmadığını göstermektedir. Bununla birlikte herhangi bir kullanıcı tarafından seçilebilecek tüm olası sürekli ağırlık kombinasyonlarının test edildiği anlamına gelmez; çalışma 0,1 aralıklı belirtilen 66 kombinasyonu değerlendirmiştir.
STONE ne kadar hızlı?
Veri seti seviyesinde toplam tespit süreleri:
| Yöntem | MBPP+ (sn) | HumanEval+ (sn) | C++ (sn) | Java (sn) |
|---|---|---|---|---|
| KGW | 12,90 | 4,19 | 8,01 | 8,95 |
| EWD | 100,43 | 34,51 | 56,85 | 59,84 |
| SWEET | 100,94 | 34,68 | 58,08 | 59,22 |
| STONE | 13,27 | 4,62 | 8,48 | 9,24 |
STONE'un tespit süresi KGW'ye çok yakınken EWD ve SWEET'ten belirgin biçimde düşüktür. Araştırmacılar bunun EWD ve SWEET'in tespit sırasında token olasılık dağılımı/entropi hesaplaması yapmasına karşılık STONE'un yeşil liste kontrolüyle çalışmasından kaynaklandığını belirtmektedir.
Filigran ekleme süreleri ise bütün yöntemlerde aynı mertebededir; STONE'un büyük hız avantajı özellikle tespit aşamasındadır.
Refactoring saldırısına ne kadar dayanıyor?
HumanEval+ üzerinde:
| Koşul | SWEET | STONE |
|---|---|---|
| Saldırı yok | 0,710 | 0,777 |
| Kod refactoring | 0,539 | 0,664 |
| Kod paraphrasing | 0,563 | 0,600 |
MBPP+ üzerinde:
| Koşul | SWEET | STONE |
|---|---|---|
| Saldırı yok | 0,679 | 0,982 |
| Kod refactoring | 0,359 | 0,907 |
| Kod paraphrasing | 0,385 | 0,824 |
STONE her iki saldırı türünde de karşılaştırılan SWEET'ten daha yüksek tespit performansı göstermektedir. Fakat değerlerin saldırı yok durumuna göre düşmesi filigranın değişikliklerden etkilenebildiğini açıkça gösterir.
Neden paraphrasing STONE'u etkiliyor?
Araştırmacılar refactoring işleminin çoğu sözdizimi sınırını koruduğunu ve bu nedenle non-syntax token alanındaki filigranın önemli bölümünün kalabildiğini belirtmektedir.
Paraphrasing ise değişken isimleri ve ifadeler gibi sözdizim dışı alanları değiştirebilir. Bunlar STONE'un filigran hedefleriyle doğrudan çakıştığı için tespit sinyali azalabilir.
STONE algoritmayı bilen saldırgana karşı test edildi mi?
Hayır. Çalışmanın kendi sınırlılıklar bölümünde bu açıkça belirtilmektedir.
STONE'un algoritmasını bilen bir saldırgan, özellikle sözdizimsel olmayan tokenları hedefleyerek:
- bütün değişkenleri sistematik biçimde yeniden adlandırabilir,
- yorumları kaldırabilir,
- STONE'un filigran yoğunluğunu azaltacak hedefli dönüşümler uygulayabilir.
Araştırmacılar böyle algorithm-aware saldırılara karşı yeni savunmaları gelecekteki çalışma alanı olarak tanımlamaktadır.
Code golf ve obfuscated kod neden problem olabilir?
STONE'un taşıyabileceği filigran miktarı sözdizimsel olmayan token yoğunluğuna bağlıdır. Normal benchmark kodlarında yeterli sayıda hedef token vardır.
Ancak çok kısa, yoğunlaştırılmış “code golf” çözümlerinde veya kasıtlı biçimde obfuscate edilmiş kodlarda bu tokenların sayısı azalabilir. Böyle durumlarda filigran çok seyrek hale gelerek güvenilir tespit için yeterli olmayabilir.
Llama-3.1-8B sonuçları aynı eğilimi gösteriyor mu?
Ek deneylerde MBPP+ ve HumanEval+ üzerinde Llama-3.1-8B kullanılmıştır. STONE yine eşit ağırlıklı STEM'de en yüksek skorları üretmiştir:
- MBPP+: STONE 0,782,
- HumanEval+: STONE 0,699.
Bununla birlikte HumanEval+ detectability değerinde EWD 0,755 ile STONE'un 0,741 değerinden biraz yüksektir. Buna rağmen STONE daha yüksek correctness sayesinde birleşik STEM skorunda önde kalmıştır.
Bu sonuç da yöntemin iddiasının “her modelde her alt metriki kazanmak” değil, toplam dengeyi korumak olduğunu desteklemektedir.
Çalışmanın desteklediği sonuçlar
- Yüksek token entropisi program kodunda sözdizim açısından güvenli değişiklik anlamına gelmemektedir.
- Python ön analizinde keywords kategorisi incelenen iki benchmark'ta en yüksek ortalama entropiye sahiptir.
- SWEET optimum HumanEval+ ayarında seçilen tokenların yaklaşık %12,6'sı syntax tokenlarıdır.
- STONE sözdizimsel tokenları filigran hedefinden ayıran bir üretim ve tespit yaklaşımı önermektedir.
- Qwen2.5-Coder-7B ana deneyinde STONE dört benchmark'ta en yüksek correctness, detectability ve eşit ağırlıklı STEM değerini vermiştir.
- STONE'un imperceptibility değeri yüksek kalmış ancak bu alt metrikin mutlak en iyi değeri her zaman STONE'a ait olmamıştır.
- STONE, SWEET'e göre ortalama %7,57 daha yüksek correctness sonucu vermiştir.
- STONE tespiti EWD ve SWEET'in entropy tabanlı tespitinden ortalama yaklaşık %86 daha hızlı raporlanmıştır.
- 66 STEM ağırlıklandırmasının büyük çoğunluğunda STONE ilk sırada kalmıştır.
- Refactoring ve paraphrasing saldırılarından sonra detectability düşse de incelenen deneylerde STONE SWEET'ten daha dirençli kalmıştır.
Çalışmanın desteklemediği veya henüz göstermediği sonuçlar
- STONE herhangi bir bilinmeyen kodun LLM tarafından yazıldığını filigran olmadan tespit eden genel amaçlı bir dedektör değildir.
- Filigranın bütün kod dönüşümlerine karşı silinemez olduğu gösterilmemiştir.
- STONE algoritmasını bilen hedefli saldırganlara karşı dayanıklılık deneysel olarak gösterilmemiştir.
- Obfuscated veya code-golf kodlarında güvenilir tespit garanti edilmemektedir.
- Her programlama dili değerlendirilmemiştir; ana deneyler Python, C++ ve Java ile sınırlıdır.
- Gerçek kurumsal yazılım depoları veya milyonlarca satırlık üretim kodu üzerinde saha değerlendirmesi yapılmamıştır.
- STONE bütün alt metriklerde her zaman en yüksek sonucu vermemektedir.
- Filigranlı kodun tespit edilmesi tek başına yazar kimliği, kötü niyet, akademik usulsüzlük veya hukuki sorumluluk kanıtı değildir.
Çalışmanın Yöntemi ve Bulguları
Araştırma soruları
Çalışma üç ana soruya odaklanmaktadır:
- STONE fonksiyonel doğruluğu koruyabiliyor mu?
- Correctness, detectability ve imperceptibility arasında STEM ile ölçülen dengeli performans sağlayabiliyor mu?
- Filigran yerleştirme ve tespit açısından hesaplama maliyeti nedir?
Ana Qwen2.5-Coder-7B sonuçlarının tamamı
| Dataset | Yöntem | Correctness | Detectability | Imperceptibility | STEM |
|---|---|---|---|---|---|
| MBPP+ | KGW | 0,499 | 0,831 | 0,994 | 0,775 |
| MBPP+ | EWD | 0,499 | 0,965 | 0,994 | 0,819 |
| MBPP+ | SWEET | 0,502 | 0,867 | 0,992 | 0,787 |
| MBPP+ | STONE | 0,571 | 0,982 | 0,990 | 0,848 |
| HumanEval+ | KGW | 0,573 | 0,523 | 0,986 | 0,694 |
| HumanEval+ | EWD | 0,573 | 0,730 | 0,986 | 0,763 |
| HumanEval+ | SWEET | 0,574 | 0,710 | 0,978 | 0,754 |
| HumanEval+ | STONE | 0,587 | 0,777 | 0,978 | 0,781 |
| HEP-C++ | KGW | 0,576 | 0,621 | 0,993 | 0,730 |
| HEP-C++ | EWD | 0,576 | 0,681 | 0,993 | 0,750 |
| HEP-C++ | SWEET | 0,584 | 0,641 | 0,979 | 0,735 |
| HEP-C++ | STONE | 0,622 | 0,729 | 0,990 | 0,780 |
| HEP-Java | KGW | 0,387 | 0,546 | 0,993 | 0,642 |
| HEP-Java | EWD | 0,387 | 0,646 | 0,993 | 0,675 |
| HEP-Java | SWEET | 0,413 | 0,580 | 0,901 | 0,631 |
| HEP-Java | STONE | 0,445 | 0,721 | 0,979 | 0,715 |
İşlem süresi
| Dataset | Yöntem | Insertion (sn) | Detection (sn) |
|---|---|---|---|
| MBPP+ | KGW | 3320 | 12,90 |
| MBPP+ | EWD | 3320 | 100,43 |
| MBPP+ | SWEET | 3300 | 100,94 |
| MBPP+ | STONE | 3266 | 13,27 |
| HumanEval+ | KGW | 1268 | 4,19 |
| HumanEval+ | EWD | 1268 | 34,51 |
| HumanEval+ | SWEET | 1270 | 34,68 |
| HumanEval+ | STONE | 1277 | 4,62 |
| HEP-C++ | KGW | 1308 | 8,01 |
| HEP-C++ | EWD | 1308 | 56,85 |
| HEP-C++ | SWEET | 1454 | 58,08 |
| HEP-C++ | STONE | 1300 | 8,48 |
| HEP-Java | KGW | 1506 | 8,95 |
| HEP-Java | EWD | 1506 | 59,84 |
| HEP-Java | SWEET | 1480 | 59,22 |
| HEP-Java | STONE | 1459 | 9,24 |
SWEET'in syntax-token kapsamı
Ek E'de entropy threshold değiştikçe SWEET'in kaç token seçtiği ve seçilenlerin ne kadarının syntax tokenı olduğu incelenmiştir.
HumanEval+ için optimum entropy threshold 0,9 iken:
- üretilen bütün tokenların %28,98'i seçilmiştir,
- seçilenlerin %12,60'ı syntax tokenıdır.
Bu syntax tokenları içinde kaynakta verilen dağılım:
- delimiters: %49,29,
- whitespace: %38,17,
- keywords: %9,44,
- types: %3,17,
- operators: %2,78.
Bu yüzdelerin alt kategori raporlaması kaynakta verildiği biçimde aktarılmıştır; yuvarlama ve kategori raporlama biçimi nedeniyle toplamın tam olarak %100'e eşit olması beklenmemelidir.
CodeIP ek karşılaştırmasının sonucu
Araştırmacılar training gerektirdiği için CodeIP'yi ana baseline grubuna dahil etmemiş, ancak Ek A'da resmi uygulamasını yeniden çalıştırmıştır.
CodeIP detectability değerleri 0,945–0,994 arasında yüksek kalırken correctness sonuçları MBPP+ için 0,093, HumanEval+ için 0,018, C++ için 0,000 ve Java için 0,073 olarak bulunmuştur.
Bu deney, yalnız yüksek tespit başarısının dengeli bir kod filigranlama yöntemi için yeterli olmadığını göstermek amacıyla kullanılmıştır. Bununla birlikte bu sonuçlar yazarların kendi yeniden üretim düzenine aittir ve CodeIP'nin bütün olası ayarları veya sonraki sürümleri için genel hüküm olarak yorumlanmamalıdır.
Yöntemin temel sınırlılıkları
- Filigran kapasitesi sözdizim dışı token yoğunluğuna bağlıdır.
- Code-golf veya obfuscated kodda yeterli filigran sinyali oluşmayabilir.
- Algoritmayı bilen saldırganın hedefli token yeniden adlandırmasına karşı kapsamlı savunma gösterilmemiştir.
- Robustluk deneyleri iki genel saldırı türüyle sınırlıdır.
- Ana değerlendirme üç programlama dili ve dört benchmark ile sınırlıdır.
- Ana model Qwen2.5-Coder-7B'dir; ikinci model analizi yalnız ek bölümde iki Python benchmark'ında yapılmıştır.
- Gerçek büyük ölçekli yazılım projelerinde insan geliştirici düzenlemeleriyle uzun dönem filigran kalıcılığı test edilmemiştir.
Algoritma açıklamasında dikkat edilmesi gereken ayrıntı
Çalışmanın anlatımı STONE'u “yalnız non-syntax tokenlara filigran yerleştiren” bir yöntem olarak tanımlamaktadır. Algoritma 1'in basılı sözde kodunda ise filigran işleminin etkinleştirilip etkinleştirilmeyeceği ilk örneklenen candidate token'ın syntax kümesinde olup olmamasına göre belirlenmekte, daha sonra nihai token düzeltilmiş dağılımdan yeniden örneklenmektedir.
Sözde kod, bu ikinci örneklemede nihai tokenın syntax kümesinden seçilmesini ayrıca yasaklayan bağımsız bir satır göstermemektedir. Kaynak bunun uygulama kodunda nasıl ele alındığını metin içinde ayrıca açıklamamaktadır. Bu nedenle burada yöntemin yazarlar tarafından verilen “syntax-aware/non-syntax hedefleme” tanımı korunmuş; sözde kod ayrıntısından hareketle farklı bir algoritma varsayılmamıştır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Marking Code Without Breaking It: Code Watermarking for Detecting LLM-Generated Code
Yazarlar ve özgün sıra: Jungin Kim; Shinwoo Park; Yo-Sub Han.
Eş katkı: Jungin Kim ve Shinwoo Park kaynakta eş katkılı yazarlar olarak işaretlenmiştir.
Sorumlu yazar: Yo-Sub Han.
Kurum: Yonsei University, Seoul, Republic of Korea.
Kaynak türü ve hakemlik: Hakem değerlendirmesinden geçmiş konferans yayını; Findings of the Association for Computational Linguistics: EACL 2026.
Yayın: Findings of the Association for Computational Linguistics: EACL 2026.
Yayınevi: Association for Computational Linguistics.
Sayfalar: 3990–4002.
Konferans: 19th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2026), Rabat, Morocco, 24–29 March 2026.
ACL Anthology kimliği: 2026.findings-eacl.207
DOI: 10.18653/v1/2026.findings-eacl.207
Resmî yayın bağlantısı: https://aclanthology.org/2026.findings-eacl.207/
DOI bağlantısı: https://doi.org/10.18653/v1/2026.findings-eacl.207
Lisans: ACL Anthology'nin 2016 ve sonrasında yayımlanan ACL materyalleri için uyguladığı Creative Commons Attribution 4.0 International (CC BY 4.0) lisansı.
Finansman: Çalışma NRF grant RS-2025-00562134 ve Kore hükümeti tarafından finanse edilen AI Graduate School Program RS-2020-II201361 desteğini bildirmektedir.
Uygulama kodu: Kaynak çalışma STONE uygulamasının https://github.com/inistory/STONE-watermarking adresinde bulunduğunu belirtmektedir.
Ana model: Qwen2.5-Coder-7B.
Ek model: Llama-3.1-8B.
Perplexity değerlendirme modeli: StarCoder2-7B.
Programlama dilleri: Python, C++ ve Java.
Benchmark'lar: MBPP+, HumanEval+, HumanEvalPack-C++ ve HumanEvalPack-Java.
Ana karşılaştırmalar: KGW, EWD ve SWEET. CodeIP training gerektirdiği için ana training-free baseline grubuna dahil edilmemiş ve Ek A'da ayrıca yeniden değerlendirilmiştir.
Ana değerlendirme ölçütleri: Correctness için pass@k; detectability için z-score tabanlı AUROC; imperceptibility için perplexity değişimi; birleşik değerlendirme için STEM.
Hesaplama altyapısı: NVIDIA A6000 GPU.
Robustluk analizi: HumanEval+ ve MBPP+ üzerinde kod refactoring ve GPT-4o ile kod paraphrasing saldırıları uygulanmıştır.
Temel yöntemsel sınır: STONE yalnız filigranın üretim sırasında bilinçli olarak yerleştirildiği çıktılarda kullanılabilen provenance mekanizmasıdır. Filigransız, başka bir sağlayıcı tarafından üretilmiş veya insan tarafından yazılmış herhangi bir kodu yalnız stilinden hareketle güvenilir biçimde “LLM üretimi” olarak tanımlayan genel bir dedektör değildir.
Saldırı sınırı: Refactoring ve paraphrasing sonrasında STONE'un detectability değeri düşmektedir. Algoritmayı bilen ve özellikle non-syntax tokenları hedefleyen saldırganlara karşı kapsamlı dayanıklılık gösterilmemiştir.
Genelleme sınırı: Sonuçlar benchmark tabanlı kod üretim görevlerine dayanmaktadır. Büyük gerçek dünya depoları, uzun süreli insan düzenlemeleri, farklı programlama dilleri ve geniş model aileleri için aynı performans oranları garanti edilmemektedir.
Karşılaştırma sınırı: STONE bütün tekil alt metriklerde mutlak olarak en iyi değildir. Özellikle imperceptibility açısından KGW ve EWD bazı ana deneylerde daha yüksek skor vermiştir. Çalışmanın esas sonucu, STONE'un correctness, detectability ve imperceptibility birlikte değerlendirildiğinde yüksek ve istikrarlı STEM sonuçları üretmesidir.
Kaynak içi algoritma notu: Algoritma 1'in sözde kodunda filigranlamanın etkinleştirilmesi candidate tokenın syntax kümesinde olup olmadığına göre belirlenmekte, nihai token ise ardından düzeltilmiş dağılımdan yeniden örneklenmektedir. Metin yöntemi non-syntax-only watermarking olarak tanımlasa da sözde kod nihai token için ikinci bir syntax engelleme adımını açık biçimde göstermemektedir. Bu nokta kaynakta ayrıca uzlaştırılmadığından Verianla açıklamasında tahmine dayalı düzeltme yapılmamıştır.
Bilimsel içerik kapsamı: Bu Verianla açıklamasındaki algoritmalar, formüller, benchmark değerleri, saldırı sonuçları, işlem süreleri, STEM karşılaştırmaları ve sınırlılıklar kaynak çalışmaya dayanmaktadır. Dış kaynak yalnız resmi bibliyografik kimlik, EACL/ACL yayın durumu ve lisans bilgisini doğrulamak amacıyla kullanılmıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir