

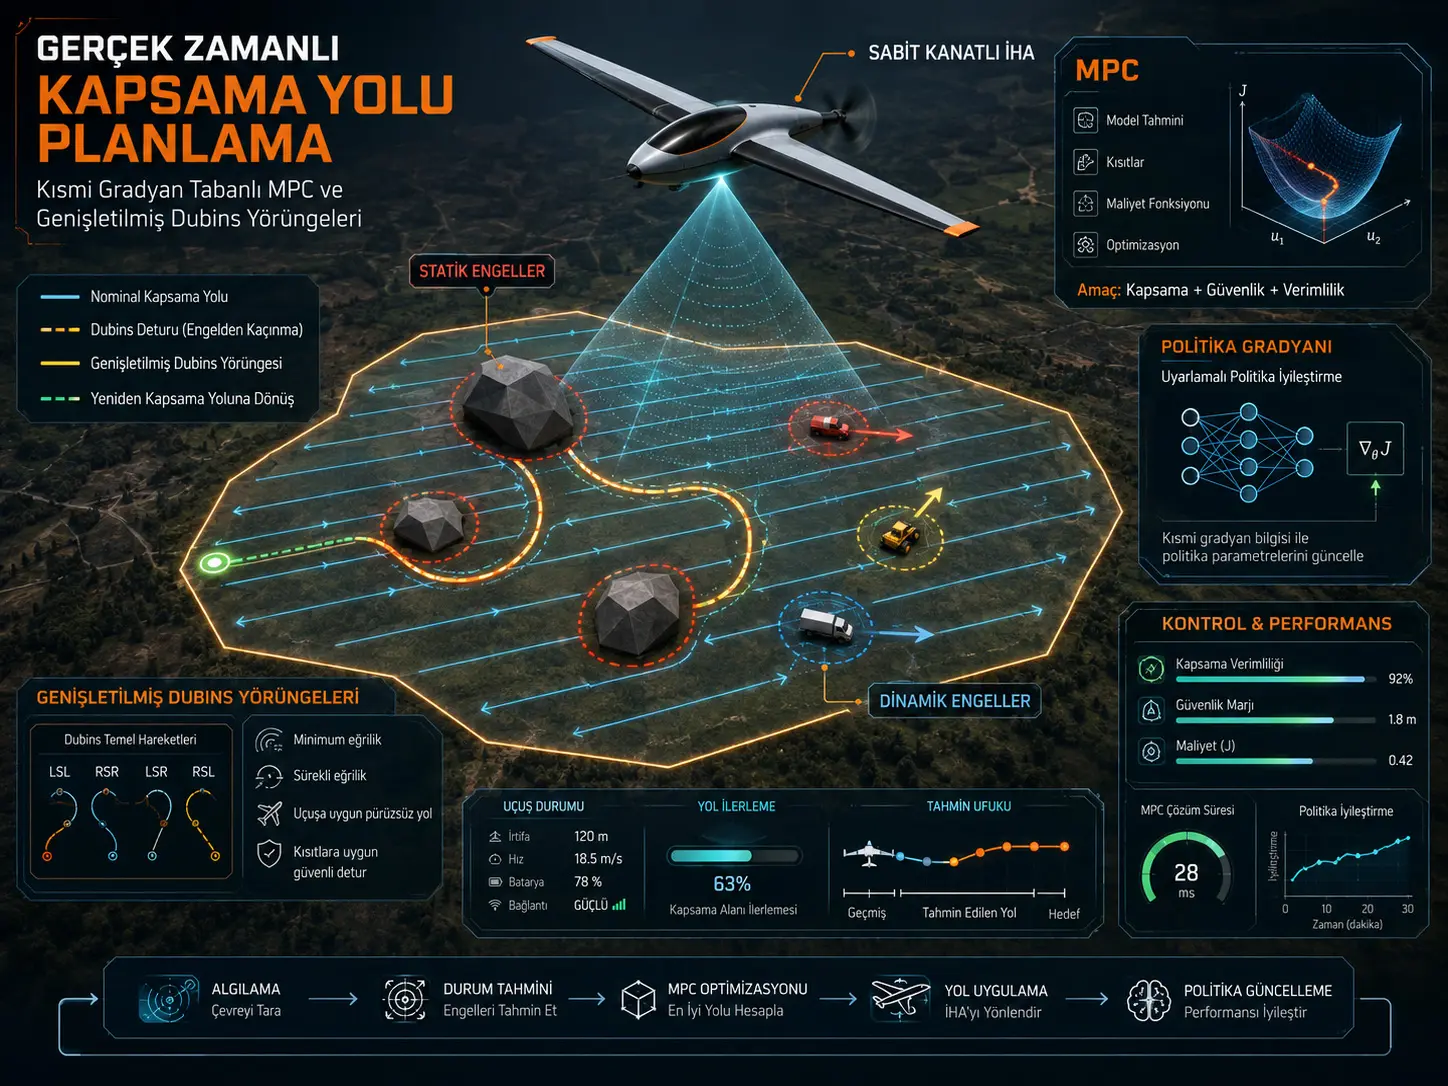
Ushbu tadqiqot qattiq qanotli uchuvchisiz havo vositasining oldindan butunlay noma’lum statik va harakatlanuvchi to‘siqlar bo‘lishi mumkin bo‘lgan hududda butun maydonni qamrab oladigan tarzda uchishini ta’minlaydigan gibrid yo‘l rejalashtirish va boshqaruv doirasini ishlab chiqadi. Usul avval oflayn bosqichda back-and-forth ko‘rinishida nominal qamrov yo‘lini hosil qiladi; parvozning onlayn bosqichida esa Model Predictive Control (MPC), Policy Gradient (PG) asosidagi boshqaruv yangilanishi va virtual waypoint-lar bilan kengaytirilgan Dubins Path (ADP) geometriyasidan birgalikda foydalanadi. Uchta simulyatsiya ssenariysida taklif qilingan PG-MPC, ayniqsa murakkab muhitlarda klassik gradient-based NLP-MPC ga nisbatan maksimal hisoblash yukini kamaytirgan va optimallashtirishning yaqinlashish darajasini oshirgan. Eng qiyin uchinchi ssenariyda maksimal hisoblash vaqti 0,9157 soniyadan 0,5404 soniyaga tushgan, biroq tadqiqotning o‘zidagi 0,5 soniyalik real vaqt namunalash chegarasidan ozgina oshib ketgan. Natijalar faqat simulyatsiyaga asoslangan; ushbu tadqiqotda haqiqiy qattiq qanotli UAV parvozi va birlashtirilgan PG-MPC tuzilmasining nazariy yopiq kontur barqarorligi isboti mavjud emas.
Taklif etilgan arxitektura ikki qatlamlidir. Oflayn bosqich kamera ko‘rish maydoni va hudud geometriyasiga ko‘ra butun maqsad maydonini qamrab oluvchi parallel sweep line-lardan tashkil topgan nominal marshrutni yaratadi. Onlayn bosqichda LiDAR tomonidan aniqlangan deb faraz qilingan yangi to‘siqlar muhit modeliga qo‘shiladi; MPC boshqaruv kirishlari va bashorat qilingan holatni optimallashtiradi; Policy Gradient qismi boshqaruv siyosatini yangi holatlarga mos ravishda yangilaydi; kengaytirilgan Dubins usuli esa to‘siqdan qochish uchun nominal chiziqdan chiqqan vositaning qattiq qanotli parvozning burilish radiusi cheklovlariga mos, silliqroq yo‘l bilan qamrov chizig‘iga qaytishini maqsad qiladi.
PG-MPC ning ustunligi barcha hisoblash mezonlarida bir xil emas. Scenario 1 va Scenario 2 da o‘rtacha ishlov berish vaqti klassik NLP-MPC dan biroz yuqori. Biroq muhit murakkabligi oshganda cho‘qqi ishlov berish vaqtlari sezilarli kamayadi. Scenario 2 da maksimal vaqt 0,718 s dan 0,3621 s ga, Scenario 3 da 0,9157 s dan 0,5404 s ga pasaygan. Yaqinlashish darajasi Scenario 2 da %92,30 dan %96,87 ga, Scenario 3 da %91,919 dan %94,34 ga ko‘tarilgan.
Augmented Dubins Path yondashuvi klassik Dubins Path ga nisbatan silliqroq va qattiq qanotli vositaning kinematik burilish cheklovlariga mosroq o‘tishlarni ta’minlashni ko‘zlaydi. Ammo bu geometrik afzallik bepul emas: 4-jadvalda ADP uchala ssenariyning barchasida klassik DP ga qaraganda biroz uzunroq umumiy yo‘l va biroz yuqoriroq umumiy execution time hosil qilgan. Demak, tadqiqot “ADP har doim yo‘lni qisqartiradi” degan xulosani qo‘llab-quvvatlamaydi.
Türkiye nuqtayi nazaridan: Tadqiqot guruhida Adana Alparslan Türkeş Science and Technology University hamda Gebze Technical University tadqiqotchilarining ishtiroki va ishning TÜBİTAK tomonidan qo‘llab-quvvatlanishi qattiq qanotli avtonom tizimlarda mahalliy akademik boshqaruv va yo‘l rejalashtirish ishlarining ko‘lamiga aniq misol beradi. Ishlab chiqilgan yondashuv nazariy jihatdan katta hududlarni ekologik monitoring qilish, ofatdan keyingi skanerlash yoki shunga o‘xshash qamrov vazifalari uchun o‘rganilishi mumkin. Biroq mavjud natijalarning barchasi simulyatsiyadir; Türkiye dagi haqiqiy havo hududida, haqiqiy sensorlar yoki haqiqiy qattiq qanotli platformada vazifa muvaffaqiyati ushbu tadqiqot bilan isbotlanmagan.
Tadqiqot qanday muammoni hal qilishga urinadi?
Coverage Path Planning (CPP) havo robotining erishish mumkin bo‘lgan maqsad hududning barchasini kuzatadigan yoki uning ustidan o‘tadigan yo‘l yaratish muammosidir. Qattiq qanotli UAVlarda bu muammo multirotor tizimlarga qaraganda murakkabroq; chunki vosita joyida burila olmaydi, minimal burilish radiusi va doimiy oldinga harakatga bog‘liq kinematik cheklovlarga ega.
Tadqiqot nishonga olgan ikkinchi muammo muhitning oldindan to‘liq noma’lum bo‘lishidir. Klassik back-and-forth qamrov yo‘llari geometrik jihatdan butun hududni skanerlashi mumkin; biroq parvoz vaqtida xaritada oldindan bo‘lmagan bino, taqiqlangan zona yoki harakatlanuvchi havo vositasi paydo bo‘lsa, yo‘lni mahalliy ravishda qayta tuzish kerak bo‘ladi.
Shu sababli tadqiqot uch talabni bitta matematik doirada birlashtirishga harakat qiladi:
- hudud qamrovining yaxlitligini saqlash,
- qattiq qanotli vositaning kinematik va boshqaruv cheklovlariga rioya qilish,
- yangi statik va dinamik to‘siqlarga onlayn ravishda javob berish.
Nega tizim ikki bosqichli qilib ishlab chiqilgan?
Tizim oflayn va onlayn bo‘lgan ikki asosiy fazadan iborat. Oflayn bosqichda to‘siqlar hisobga olinmay turib ideal nominal qamrov marshruti tayyorlanadi. Onlayn bosqichda esa vosita ushbu marshrutni kuzatayotganda sensor ma’lumotiga ko‘ra yangi to‘siqlarni aniqlaydi, qisqa muddatli boshqaruv qarorlarini yangilaydi va zarur bo‘lsa nominal yo‘ldan chiqib, keyin yana o‘sha qamrov tartibiga qaytadi.
Tadqiqot tizimi arxitekturasini ko‘rsatgan 4-rasm bu ajratishni aniq ko‘rsatadi. Chap tomonda hudud chegarasini aniqlash, sweep-line yaratish va nominal back-and-forth marshrut; o‘ng tomonda feature detection/localization, MPC, policy update va Augmented Dubins Path komponentlari joylashgan.
Nominal qamrov yo‘li qanday yaratiladi?
Maqsad hudud hisoblash murakkabligini kamaytirish uchun notekis qirralarga ega, ammo qavariq poligon sifatida modellashtirilgan. Sweep yo‘nalishi aniqlanganda har bir poligon qirrasidan eng uzoq cho‘qqigacha bo‘lgan masofa hisoblanadi; nomzod maksimal kengliklar ichidan eng kichigi qamrov chiziqlarining yo‘nalishini belgilash uchun ishlatiladi.
Hosil bo‘lgan marshrut parallel skanerlash chiziqlaridan iborat klassik zigzag yoki back-and-forth tuzilmasidir. Har bir sweep segmentining tugash nuqtasi keyingi segmentning boshlanish referensi sifatida ishlatiladi.
Kamera qamrov chiziqlari oralig‘iga qanday ta’sir qiladi?
Tadqiqot qo‘shni parvoz chiziqlari orasidagi masofani kamera ko‘rish burchagi, tasvirlar ustma-ust tushishi va parvoz balandligi bilan bog‘laydi. Manbada chiziqlar oralig‘i quyidagicha berilgan:
\[ d= 2\frac{A(1-v)}{\tan(\mu)} \]
Bu yerda \(A\) parvoz balandligi, \(v\) zarur tasvir overlap nisbati va \(\mu\) kameraning vertikal ko‘rish maydonining yarim burchagidir. Verianla manba formulasini o‘zgartirmasdan keltiradi.
Simulyatsiyada qanday qattiq qanotli platforma faraz qilingan?
| Parametr | Manba qiymati |
|---|---|
| UAV massasi | 3,9 kg |
| Minimal cruise tezligi | 10 m/s |
| Cruise balandligi | 100 m |
| Endurance | 460 daqiqa |
| Minimal burilish radiusi | 28 m |
| Kamera fokus masofasi | 2,75 mm |
| Kamera sensori | 6,45 × 3,63 mm |
| Kamera aniqligi | 11,9 MP |
| Gorizontal / vertikal FoV | 102° / 67° |
| LiDAR maksimal diapazoni | 60 m |
| LiDAR minimal diapazoni | 0,05 m |
| LiDAR FoV | 70° |
| LiDAR skanerlash chastotasi | 10 Hz |
Bu qiymatlar simulyatsiyadagi agent va sezish tizimining parametrlaridir; tadqiqotda shu xususiyatlarga ega jismoniy havo vositasining parvoz sinovi o‘tkazilmagan.
Qattiq qanotli UAVning harakat modeli qanday ta’riflangan?
Umumiy uch o‘lchovli kinematika manbada:
\[ \dot{x}=V\cos\theta\cos\psi \]
\[ \dot{y}=V\cos\theta\sin\psi \]
\[ \dot{z}=V\sin\theta \]
\[ \dot{\theta}=q \]
\[ \dot{\psi}=r= \frac{g\tan\phi} {V\cos\theta} \]
ko‘rinishida berilgan.
Tadqiqotda parvoz balandligi doimiy deb qabul qilingani sabab \(\dot{z}=0\), \(\theta=0\) va \(q=0\) olingan; boshqaruv muammosi tekislikdagi harakatga soddalashtirilgan. Bu soddalashtirish haqiqiy qattiq qanotli parvozning to‘liq olti erkinlik darajali aerodinamik modelini ifodalamaydi.
Muhit ssenariylari qanday yaratilgan?
Tadqiqotda uch xil simulyatsiya muhiti ishlatilgan:
- Scenario 1: statik yoki harakatlanuvchi to‘siq bo‘lmagan asosiy muhit.
- Scenario 2: oldindan noma’lum statik poligonal to‘siqlar va harakatlanuvchi to‘siq.
- Scenario 3: muhit murakkabligini oshirish uchun bir xil hududda bir nechta dinamik to‘siq.
Harakatlanuvchi to‘siqlar yopiq traektoriyalarda doimiy 20 m/s tezlik bilan harakatlanadi. Statik to‘siqlar qavariq hamda non-konveks poligonlar ko‘rinishida yaratilgan.
3-rasmda ikkinchi ssenariyda poligonal to‘siqlar bilan bitta dinamik to‘siq, uchinchi ssenariyda esa turli yopiq traektoriyalarda harakatlanayotgan bir nechta dinamik to‘siqlar ko‘rsatilgan.
To‘siqlar parvoz vaqtida qanday aniqlanadi?
Simulyatsiya tuzilmasida LiDAR muhitga oid masofa/depth ma’lumotini hosil qiladi. 6-rasm namunaviy muhit tasvirining yonida pixel-wise relative-depth xaritasini ko‘rsatadi. Yangi to‘siq aniqlanganda uning geometrik ma’lumoti muhit modeliga qo‘shiladi va MPC cheklovlari yangilanadi.
Biroq bu LiDAR natijalari real parvozda yozib olingan sensor ma’lumotlari emas; ular simulyatsiya muhitining perception modelidan olingan chiqishlardir.
MPC vazifasi nima?
Model Predictive Control har bir boshqaruv qadamida cheklangan prediction horizon bo‘yicha kelajakdagi holatlarni bashorat qiladi va eng ma’qul boshqaruv ketma-ketligini qayta hisoblaydi. Tadqiqotda uzluksiz tizim zero-order hold farazi bilan diskretlashtirilgan va holat fazosi modeli:
\[ X_{k+1}=A_kX_k+B_ku_k \]
\[ Y_k=C_kX_k \]
ko‘rinishida qurilgan.
Planar holatda holat vektori pozitsiya va tezlik komponentlarini, boshqaruv vektori esa x va y yo‘nalishidagi boshqaruv kirishlarini o‘z ichiga oladi.
Optimallashtirish bir vaqtning o‘zida nimani kamaytirishga urinadi?
CPP constrained Multi-Objective Optimization Problem sifatida shakllantirilgan. Manbadagi birlashtirilgan xarajat:
\[ J= \sum_{k=1}^{N} \left\{ \|p_k-p_{ref}\| + Q_u\|u_k\| + Q_d\|d(p_k,Z)\| \right\} \]
ko‘rinishidadir.
Uchta asosiy komponent:
- joriy pozitsiya bilan maqsad/reference nuqta orasidagi masofa,
- boshqaruv sarfi,
- nominal zigzag qamrov chizig‘idan cross-track og‘ish.
Tadqiqotda path deviation og‘irligi \(Q_d=5\), control-effort og‘irligi \(Q_u=2\) deb tanlangan. Shunday qilib nominal qamrov yo‘liga sodiqlik boshqaruv buyrug‘ini kichik tutishdan yuqoriroq og‘irlik oladi.
To‘siq xavfsizligi qanday matematik cheklovga aylantiriladi?
Statik poligonal to‘siqlar jismoniy vosita o‘lchamini va xavfsizlik masofasini qamrab oladigan tarzda Minkowski sum yondashuvi bilan kengaytiriladi. Kengaytirilgan xavfsizlik hududi:
\[ O_i^{aug} = \left\{ P_i^{aug}\in\mathbb{R}^2 \mid dist(P_i^{aug},O_i)\leq\delta \right\} \]
ko‘rinishida aniqlangan.
Optimallashtirish parametrlarida statik to‘siq safety margin qiymati 50 m, dinamik to‘siq radiusi 30 m va minimum separation distance 8 m.
Tenglama izchilligi eslatmasi: Manbaning Tenglama (11) dagi dinamik to‘siq jarima ifodasi bilan keyinroq birlashtirilgan optimallashtirishni umumlashtiruvchi Tenglama (14) dagi dinamik to‘siq ifodasi bir xil matematik shaklda emas. Verianla bu farqni jim turib bitta tenglamaga birlashtirmaydi.
Policy Gradient qismi qanday ishlaydi?
Tadqiqotda PG metod matni davomida Policy Gradient yondashuvini anglatadi. Tizim holati beshta alohida harakat buyrug‘ining ehtimollik taqsimotiga aylantiriladi:
- chapga buril,
- to‘g‘ri yur,
- o‘ngga buril,
- tezlash,
- sekinlash.
Siyosat chiziqli funksiya yaqinlashtirishi bilan:
\[ h_u(X)=\eta(X)^T\vartheta_u \]
ko‘rinishida aniqlanadi va SoftMax yordamida harakat ehtimollari:
\[ Q(u|X)= \frac{e^{h_u(X)}} {\sum_{u'}e^{h_{u'}(X)}} \]
shaklida hisoblanadi.
Critic nima uchun qo‘shilgan?
Sof Policy Gradient yangilanishlarida reward/cost signalining dispersiyasi yuqori bo‘lishi mumkinligi sababli tadqiqotda chiziqli value-function approximator ishlatilgan:
\[ V(X_k)=w^T\eta(X_k) \]
Temporal-Difference xatosi:
\[ \delta_k= J_k+\lambda V(X_{k+1})-V(X_k) \]
ko‘rinishida hisoblanadi.
Siyosat parametri esa:
\[ \vartheta_u \leftarrow \vartheta_u+ \alpha\delta_k \eta(X_k) \left( I(u_k)-Q(u_k|X_k) \right) \]
qoidasi bilan yangilanadi.
Tadqiqotchilar ushbu o‘rganish jarayoni oldindan to‘plangan ma’lumotlar to‘plami yoki experience replay ga ehtiyoj sezmasdan onlayn ravishda yuz berishini ta’kidlaydi.
Augmented Dubins Path klassik Dubins dan nimasi bilan farq qiladi?
Klassik Dubins muammosi doimiy minimal burilish radiusiga ega oldinga yuruvchi vositaning ikki konfiguratsiya orasida mos egri kombinatsiyalaridan foydalanadi. Tadqiqot virtual waypoint qo‘shib, mumkin bo‘lgan traektoriya oilasini klassik oltita turdan o‘nta turga kengaytiradi:
\[ D= \{ LSL,RSR,RSL,LSR,RLR,LRL, RLSLR,LRSRL,SLR,SRL \} \]
Yangi yo‘llardan RLSLR va LRSRL to‘rtta egri + bitta to‘g‘ri segment; SLR va SRL esa ikkita egri + bitta to‘g‘ri segmentni o‘z ichiga oladi.
7-rasm ushbu virtual waypoint-larning burilishni kechroq boshlash va yo‘nalish o‘zgarishlarini waypoint yaqinidagi torroq hududlarda bajarish imkonini beruvchi geometriyasini ko‘rsatadi.
Nega ADP albatta qisqaroq bo‘lishi shart emas?
Tadqiqotning o‘z natijalari ADP ning asosiy maqsadi mutlaq minimal masofa emasligini ko‘rsatadi. Qo‘shimcha virtual waypoint-lar va kinematik jihatdan mosroq o‘tishlar kichik masofa va execution-time oshishiga olib kelishi mumkin.
| Smoothing | Scenario 1 vaqt (s) | Scenario 2 vaqt (s) | Scenario 3 vaqt (s) | Scenario 1 masofa (m) | Scenario 2 masofa (m) | Scenario 3 masofa (m) |
|---|---|---|---|---|---|---|
| DP | 27.223 | 27.447 | 27.990,30 | 272.233,4 | 274.474,5 | 279.903,1 |
| ADP | 27.294 | 27.532 | 28.127,72 | 272.937,3 | 275.325,7 | 281.277,21 |
Jadvaldagi natija ADP uchala ssenariyda ham klassik DP ga qaraganda biroz uzunroq masofa va vaqt hosil qilgan bo‘lsa-da, mualliflar bahosiga ko‘ra silliqroq va kinematik jihatdan amalga oshirish mumkinroq lokal o‘tishlar yaratganini ko‘rsatadi.
O‘rganish parametrlari qanday tanlangan?
Policy learning rate va discount factor to‘g‘ridan-to‘g‘ri bitta qiymat deb olinmagan; 100 ta simulyatsiya ishga tushirishga asoslangan sensitivity analysis bilan baholangan.
Learning rate uchun:
\[ 0.0001,\;0.0005,\;0.001,\;0.005,\;0.01 \]
qiymatlari; discount factor uchun:
\[ 0.90,\;0.93,\;0.96,\;0.99 \]
qiymatlari sinovdan o‘tkazilgan.
9-rasmdagi korrelyatsiya xaritalari past–o‘rta o‘rganish tezliklari va 0,93–0,96 discount factor hududi cost bilan computation time o‘rtasida yaxshiroq muvozanat berganini ko‘rsatadi. Yakuniy modelda learning rate 0,001, discount factor 0,96 tanlangan.
Simulyatsiyadagi asosiy optimallashtirish parametrlari qaysilar?
| Parametr | Qiymat | Izoh |
|---|---|---|
| Sampling time | 0,5 s | MPC boshqaruvini yangilash oralig‘i |
| Prediction horizon | 100 | MPC bashorat ufqi |
| Policy learning rate | 0,001 | PG yangilanishi |
| Discount factor | 0,96 | Kelajak TD ta’sirining og‘irligi |
| Minimum separation | 8 m | To‘siq / agent xavfsizlik ajratilishi |
| Control input quyi chegarasi | −2 m/s² | Minimal acceleration command |
| Control input yuqori chegarasi | 2 m/s² | Maksimal acceleration command |
| Statik to‘siqlar soni | 4 | Poligonal to‘siqlar |
| Obstacle safety margin | 50 m | Statik to‘siq buffer masofasi |
| Dynamic obstacle radius | 30 m | Dinamik to‘siq modeli |
| Waypoint acceptance threshold | 20 m | Keyingi segmentga o‘tish chegarasi |
| Control effort weight | 2 | \(Q_u\) |
| Path deviation weight | 5 | \(Q_d\) |
PG-MPC real vaqtda ishlaydimi?
Scenario 2 da o‘zining real vaqt mezonini bajaradi; Scenario 3 dagi eng yomon holat esa 0,5 soniyalik chegaradan oshadi. Tadqiqotchilar bitta boshqaruv sikli real vaqtli deb hisoblanishi uchun perception, optimization va control jarayonlarining jami sampling interval dan oshmasligi kerakligini bildiradi. Sampling interval 0,5 soniya.
10-rasmda Scenario 2 uchun maksimal computation time taxminan 0,36 soniya. 4-jadval bu qiymatni 0,3621 soniya deb beradi va u 0,5 soniyalik chegaradan past.
Ammo Scenario 3 uchun PG-MPC maksimal qiymati 0,5404 soniya. Shu sababli tadqiqotning “real-time feasibility” xulosasi eng qiyin ssenariyda barcha boshqaruv sikllari 0,5 soniyadan past bo‘lgan degan ma’noni anglatmasligi kerak.
Klassik NLP-MPC va PG-MPC o‘rtasidagi to‘liq natijalar qanday?
| Metrika | NLP-MPC S1 | NLP-MPC S2 | NLP-MPC S3 | PG-MPC S1 | PG-MPC S2 | PG-MPC S3 |
|---|---|---|---|---|---|---|
| O‘rtacha computation time (s) | 0,095 | 0,1618 | 0,1898 | 0,128 | 0,2000 | 0,1891 |
| Maksimal computation time (s) | 0,2295 | 0,7180 | 0,9157 | 0,2549 | 0,3621 | 0,5404 |
| Optimization convergence rate (%) | 99,993 | 92,30 | 91,919 | 99,993 | 96,87 | 94,34 |
| Constraint violation occurrence (%) | 0 | 5,67 | 3,2938 | 0 | 4,22 | 3,2864 |
Jadval taklif qilingan usulning afzalligi ayniqsa murakkab ssenariylarda cho‘qqi ishlov berish yukini cheklash va yaqinlashish darajasini oshirish ekanini ko‘rsatadi. Biroq PG-MPC Scenario 1 va 2 da o‘rtacha hisoblash vaqti bo‘yicha klassik NLP-MPC dan tezroq emas.
Constraint violation Scenario 2 da %5,67 dan %4,22 ga pasaygan, Scenario 3 da esa %3,2938 dan %3,2864 ga juda kichik o‘zgarish ko‘rsatgan. Manba bu natijalarni improved constraint satisfaction deb sharhlaydi; biroq alohida statistik ahamiyat testi hisobot qilinmagan.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- Back-and-forth CPP, MPC, onlayn Policy Gradient yangilanishi va augmented Dubins smoothing bir xil simulyatsiya doirasida birgalikda qo‘llanilgan.
- Taklif qilingan tuzilma statik va dinamik to‘siqlar bo‘lgan simulyatsiyalarda nominal qamrov yo‘lidan mahalliy ravishda chiqib, keyin yana marshrutga qayta oladi.
- PG-MPC Scenario 2 va Scenario 3 da klassik NLP-MPC ga nisbatan maksimal hisoblash vaqtini kamaytirgan.
- Scenario 2 da convergence rate %92,30 dan %96,87 ga ko‘tarilgan.
- Scenario 3 da convergence rate %91,919 dan %94,34 ga ko‘tarilgan.
- Scenario 2 da constraint violation occurrence %5,67 dan %4,22 ga tushgan.
- Augmented Dubins yondashuvi simulyatsiya tasvirlarida klassik Dubins ga qaraganda silliqroq va kinematik jihatdan amalga oshirish mumkinroq lokal o‘tishlar hosil qiladi.
- Scenario 2 da PG-MPC ning maksimal ishlov vaqti 0,3621 s bo‘lib, 0,5 s namunalash davridan past qolgan.
Tadqiqot qo‘llab-quvvatlamaydigan yoki sinamagan natijalar
- Usul haqiqiy qattiq qanotli UAV da parvoz sinovi bilan tasdiqlanmagan.
- Haqiqiy LiDAR shovqini, sensor kechikishi yoki paket yo‘qotilishi sharoitida ishlash o‘lchanmagan.
- Haqiqiy shamol va atmosfera disturbance sharoitida jismoniy parvoz muvaffaqiyati ko‘rsatilmagan.
- Haqiqiy aktuator to‘yinishi va aerodinamik model noaniqligi apparatda sinovdan o‘tkazilmagan.
- Birlashtirilgan PG-MPC tizimining yopiq kontur barqarorligi uchun rigoroz nazariy isbot berilmagan.
- Scenario 3 da barcha boshqaruv sikllari 0,5 soniyalik real vaqt chegarasidan past qolishi ko‘rsatilmagan; maksimal vaqt 0,5404 s.
- ADP klassik Dubins yo‘lidan qisqaroq marshrut hosil qilishi ko‘rsatilmagan; uchala ssenariyda ham kumulyativ masofa biroz yuqori.
- PG-MPC klassik NLP-MPC ga qaraganda har doim pastroq o‘rtacha computation time berishi ko‘rsatilmagan.
- Simulyatsiya natijalarini haqiqiy ofat, qishloq xo‘jaligi yoki ekologik monitoring vazifalariga aynan shu samaradorlik raqamlari bilan umumlashtirish mumkinligi isbotlanmagan.
- Tadqiqot to‘liq olti erkinlik darajali aerodinamik fixed-wing model ishlatmaydi; boshqaruv muammosi doimiy balandlikdagi planar modelga soddalashtirilgan.
Tadqiqot Usuli va Natijalari
Dasturiy ta’minot va hisoblash muhiti
Doira MATLAB R2024b muhitida amalga oshirilgan. Simulyatsiyalar ishga tushirilgan kompyuter:
- 4,7 GHz Intel Core i7 protsessor,
- 16 GB RAM,
- NVIDIA RTX 3070 GPU
dan iborat. Manba kompyuterda GPU borligini bildiradi; biroq barcha optimallashtirish hisoblari GPU da tezlashtirilganini alohida ko‘rsatmaydi.
Oflayn rejalashtirish algoritmi
Algorithm 1 qavariq poligonning har bir qirrasi bilan barcha cho‘qqilari orasidagi masofani hisoblaydi. Har bir qirra uchun eng uzoq vertex tanlanadi va ushbu maksimal masofalar ichidan eng kichigi direction sweep orientation sifatida ishlatiladi.
Kamera footprint kengligi va tasvir overlap talabi yordamida parallel sweep chiziqlari hududga joylashtiriladi. Nominal marshrut hech qanday noma’lum to‘siqsiz to‘liq qamrovni ta’minlashni ko‘zlaydi.
Onlayn PG-MPC sikli
Onlayn tizim har bir boshqaruv qadamida asosan quyidagi ishlarni bajaradi:
- Joriy holat \(X_k\) olinadi.
- Aniqlangan statik va harakatlanuvchi to‘siqlar muhit modeliga qo‘shiladi.
- Siyosat xususiyatlari hisoblanadi.
- SoftMax orqali control action ehtimollari hosil qilinadi.
- Boshqaruv kirishi belgilanadi.
- Yangi holat bashorat qilinadi.
- Joriy xarajat hisoblanadi.
- TD error topiladi.
- Critic parametri yangilanadi.
- Policy parametrlari yangilanadi.
- Lokal yo‘l Augmented Dubins geometriyasi bilan silliqlanadi.
Tadqiqot bu siklni onlayn learning deb ta’riflaydi va oldindan to‘liq o‘qitilgan siyosat talab qilmasligini bildiradi.
Ko‘p oqimli tuzilma
PG-MPC ilovasi optimization, perception va navigation modullarining bir vaqtning o‘zida ishlashini qo‘llab-quvvatlaydigan multi-threaded architecture sifatida modellashtirilgan. Maqsad haqiqiy parvoz kompyuteridagi asinxron vazifa tuzilishini taxminan ifodalashdir.
Biroq bu arxitektura jismoniy avionics kompyuterida ishlatilgan Hardware-in-the-Loop yoki flight-test benchmark emas.
Scenario 1 nimani ko‘rsatadi?
To‘siqsiz asosiy ssenariy framework ning nominal qamrov naqshini kuzatishini sinaydi. Klassik va taklif qilingan optimizer ikkalasida ham convergence rate %99,993 va constraint violation %0.
Bu eng oson holatda PG-MPC ning maksimal hisoblash vaqti 0,2549 s bo‘lib, NLP-MPC ning 0,2295 s qiymatidan biroz yuqori. Demak, taklif qilingan PG yangilanishi oddiy muhitda to‘g‘ridan-to‘g‘ri tezlik afzalligiga ega emas.
Scenario 2 nimani ko‘rsatadi?
Statik va harakatlanuvchi to‘siqlar qo‘shilganda classical NLP-MPC ning maksimal computation time qiymati 0,718 s gacha oshgan, PG-MPC esa 0,3621 s da qolgan.
Convergence rate shu ssenariyda %92,30 dan %96,87 ga, constraint violation qiymati %5,67 dan %4,22 ga o‘zgargan.
Bu ssenariy tadqiqotning “peak computation burden” bo‘yicha eng aniq afzalliklaridan birini ko‘rsatadi.
Scenario 3 nimani ko‘rsatadi?
Ko‘p dinamik to‘siqli uchinchi ssenariy eng qiyin sharoit. Klassik NLP-MPC ning maksimal hisoblash vaqti 0,9157 s, PG-MPCniki 0,5404 s.
Manba bu o‘zgarishni taxminan %41,1 kamayish deb hisobot qiladi. PG-MPC katta cho‘qqi-vaqt afzalligini bersa-da, 0,5404 s qiymati 0,5 s sampling interval dan yuqori. Shu sababli tadqiqotda aniqlangan qat’iy real vaqt mezoni bo‘yicha alohida worst-case oshib ketish holati mavjud.
Yaqinlashish darajasi %91,919 dan %94,34 ga ko‘tarilgan; constraint violation occurrence esa %3,2938 dan %3,2864 ga juda oz miqdorda kamaygan.
10-rasmning asosiy xabari nima?
10-rasm muhitdagi ayrim to‘siq hududlari yaqinida hisoblash vaqti va objective cost oshishini ko‘rsatadi. Bu nuqtalar controller to‘g‘ridan-to‘g‘ri nominal yo‘lni kuzatish o‘rniga collision avoidance va feasibility shartlariga ustuvorlik bergan hududlardir.
Hisoblash yukining butun muhit bo‘ylab doimiy emasligi usulning worst-case vaqti nega o‘rtacha vaqtdan muhimroq ekanini ham ko‘rsatadi. Real vaqt flight-control ilovasida boshqaruv siklining deadline ini belgilovchi metrika ko‘pincha o‘rtacha emas, cho‘qqi hisoblash vaqtidir.
11-rasm nimani ko‘rsatadi?
11-rasm uch ssenariyda MPC-ADP va MPC-DP yo‘llarini yonma-yon taqqoslaydi. To‘siqsiz holatda ikkala tuzilma nominal sweep pattern ga yaqin harakat qiladi. Statik va dinamik to‘siqlar qo‘shilganda lokal og‘ishlar yuzaga keladi.
Yaqinlashtirilgan hududlarda ADP burilishlarining klassik DP ga qaraganda bosqichma-bosqich ko‘rinishi mualliflarning “smoother and dynamically feasible” sharhining vizual asosidir.
Biroq ayni tadqiqotning 4-jadvali ADP ning umumiy masofani uchala ssenariyda ham biroz oshirganini ko‘rsatadi. Rasmdagi silliqlik va umumiy yo‘l uzunligi bir xil samaradorlik mezoni emas.
Usulning asosiy trade-off i nima?
Tadqiqot ma’lumotlari bitta “har jihatdan yaxshiroq” algoritm xulosasini bermaydi. Taklif qilingan usul ayniqsa murakkab to‘siq muhitlarida peak optimisation time va convergence bo‘yicha afzallik ko‘rsatadi; biroq onlayn policy update ayrim ssenariylarda o‘rtacha hisoblash yukini oshiradi.
Xuddi shuningdek, Augmented Dubins marshrut geometriyasi silliqroq va kinematik jihatdan amalga oshirish mumkin bo‘lgan o‘tishlar bersa-da, oz miqdorda qo‘shimcha masofa va execution time yaratadi.
Shuning uchun doiraning asosiy muhandislik murosasi sof minimal hisoblash vaqti yoki minimal masofa o‘rniga qamrov uzluksizligi + kinematik amalga oshirish mumkinligi + dinamik to‘siqqa moslashuv kombinatsiyasiga ustuvorlik berishdir.
Tadqiqotning kuchli tomonlari
- Qamrov rejalashtirish va onlayn boshqaruvni bitta optimallashtirish tuzilmasida birlashtiradi.
- Qattiq qanotli vositaning minimal burilish xatti-harakatini Dubins geometriyasi bilan aniq hisobga oladi.
- Noma’lum statik va dinamik to‘siqlarni bitta doirada ko‘rib chiqadi.
- Policy Gradient ni MPC yangilanishiga to‘g‘ridan-to‘g‘ri integratsiya qiladi.
- O‘rganish tezligi va discount factor uchun sensitivity analysis o‘tkazadi.
- Klassik NLP-MPC bilan bir xil sharoitda miqdoriy taqqoslash beradi.
- Average va maximum computation time qiymatlarini alohida hisobot qiladi.
- Convergence va constraint violation metrikalarini birgalikda beradi.
- DP va ADP smoothing xarajatlarini alohida taqqoslaydi.
Tadqiqotning asosiy cheklovlari
- Barcha tekshiruvlar simulyatsiyadir.
- Jismoniy fixed-wing UAV parvoz sinovi yo‘q.
- Haqiqiy sensor noise va communication delay sinovdan o‘tkazilmagan.
- Shamol va haqiqiy atmosfera disturbance kelajakdagi ishga qoldirilgan.
- Aktuator noaniqliklari va haqiqiy flight-computer deadline xatti-harakati tekshirilmagan.
- Model doimiy balandlikdagi, past aniqlikdagi planar dynamics yondashuvidan foydalanadi.
- Yopiq kontur PG-MPC barqarorligining rigoroz nazariy tahlili bajarilmagan.
- Scenario 3 worst-case vaqti 0,5 s boshqaruv davridan yuqori.
- ADP oz bo‘lsa-da qo‘shimcha yo‘l uzunligi va execution time hosil qiladi.
- Tadqiqot sarlavhasidagi “Partial Gradient” bilan usul ichidagi “Policy Gradient” terminologiyasi mos kelmaydi.
Kelajak tadqiqotlari qaysi muammolarni hal qilishi kerak?
Mualliflar usulni haqiqiy qattiq qanotli platformalarda qo‘llashni muhim kelajak qadami deb ko‘rsatadi. Ushbu tekshiruvga shamol buzilishlari, sensor shovqini, communication delays va actuator uncertainties ni kiritish tavsiya etiladi.
Tadqiqot, shuningdek, birlashtirilgan PG-MPC tuzilmasining rigorous closed-loop stability analysis i amalga oshirilmaganini ochiq tan oladi va buni kelajakdagi nazariy ish yo‘nalishi sifatida belgilaydi.
Qo‘shimcha ravishda Sliding Mode Control kabi robust nonlinear control yondashuvlarini disturbance rejection va model uncertainty bardoshliligini oshirish uchun doiraga integratsiya qilish taklif qilinadi.
Manba va Usul Eslatmasi
To‘liq original tadqiqot nomi: Real-Time Coverage Path Planning for Fixed-Wing Aerial Robots Using Partial Gradient-Based MPC and Augmented Dubins Trajectories
Mualliflar: Mohammad Khaneghaei; Benyamin Ebrahimi; Davood Asadi; Onder Tutsoy; Seyed-Yaser Nabavi-Chashmi; Hassan Haghighi.
Mualliflar tartibi: Manbadagi original tartib aynan saqlangan.
Teng hissa/teng birinchi muallif: Manbada ko‘rsatilmagan.
Mas’ul muallif: Davood Asadi.
Muassasalar: Department of Electrical Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; Department of Aerospace Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; College of Arts, Technology and Environment, University of the West England, Bristol, UK; Department of Aeronautical Engineering, Gebze Technical University, Gebze, Türkiye; Laboratoire d’Informatique et Systèmes, Aix-Marseille University, Marseille, France.
Affiliatsiya eslatmasi: Manbaning uchinchi affiliatsiyasi “University of the West England” shaklida berilgan. Verianla bibliografik yozuvni manbada qanday bo‘lsa shunday saqlagan va muassasa nomini jim turib qayta yozmagan.
Sarlavha terminologiyasi eslatmasi: Original sarlavhada “Partial Gradient-Based MPC” iborasi ishlatilgan. Maqola tanasidagi PG usuli esa “Policy Gradient” sifatida ta’riflangan va tenglamalar shu yondashuv asosida qurilgan. Verianla original sarlavhani o‘zgartirmagan.
Manba turi: Hakemlikdan o‘tgan tadqiqot maqolasi; algoritm ishlab chiqish va simulyatsiyaga asoslangan qiyosiy tekshirish tadqiqoti.
Jurnal: Aerospace
Nashriyot: MDPI
Jild / son / maqola raqami: 13(8), 713
Nashr sanasi: 9-avgust 2026
DOI: 10.3390/aerospace13080713
Rasmiy nashr havolasi: https://www.mdpi.com/2226-4310/13/8/713
DOI havolasi: https://doi.org/10.3390/aerospace13080713
Hakemlik holati: Tadqiqot hakemlikdan o‘tadigan Aerospace jurnalida chop etilgan tadqiqot maqolasidir.
Litsenziya: Creative Commons Attribution (CC BY) ochiq kirish litsenziyasi.
Moliyalashtirish: Tadqiqot Türkiye Bilimsel ve Teknolojik Araştırma Kurumu (TÜBİTAK) tomonidan 125M675 va 223M312 raqamli grantlar doirasida moliyalashtirilgan.
Ma’lumotlar mavjudligi: Ma’lumotlar so‘rov bo‘yicha taqdim etilishi aytilgan.
Manfaatlar to‘qnashuvi: Mualliflar ma’lum raqobat qiluvchi moliyaviy manfaatlar yoki tadqiqotga ta’sir ko‘rsatishi mumkin bo‘lgan shaxsiy munosabatlar haqida xabar bermagan.
Muallif hissalari: Mohammad Khaneghaei; ko‘rib chiqish va tahrirlash, dastlabki qoralama, vizualizatsiya, tekshirish, metodologiya, resurslar, tadqiqot, formal tahlil, ma’lumotlar kuratsiyasi va konseptuallashtirish. Benyamin Ebrahimi; ko‘rib chiqish va tahrirlash, dastlabki qoralama, vizualizatsiya, tekshirish, metodologiya, tadqiqot, formal tahlil, ma’lumotlar kuratsiyasi va konseptuallashtirish. Davood Asadi; ko‘rib chiqish va tahrirlash, dastlabki qoralama, nazorat, tadqiqot, formal tahlil, ma’lumotlar kuratsiyasi va konseptuallashtirish. Onder Tutsoy; ko‘rib chiqish va tahrirlash, dastlabki qoralama, tekshirish, metodologiya, resurslar va nazorat. Seyed-Yaser Nabavi-Chashmi; ko‘rib chiqish va tahrirlash, tekshirish va nazorat. Hassan Haghighi; ko‘rib chiqish va tahrirlash hamda tekshirish.
Simulyatsiya darajasi: Barcha taqqoslashlar MATLAB R2024b da bajarilgan simulyatsiyalarga asoslanadi. Tadqiqot haqiqiy qattiq qanotli UAV parvoz eksperimenti, hardware-in-the-loop testi yoki dala demonstratsiyasini o‘z ichiga olmaydi.
Real vaqt chegarasi: Manba real vaqt mezonini computation/control vaqti 0,5 s sampling interval dan oshmasligi deb belgilaydi. PG-MPC Scenario 2 da 0,3621 s maksimal qiymat bilan bunga mos keladi; Scenario 3 da 0,5404 s maksimal qiymat bilan chegaradan yuqori qoladi. Shu sababli Verianla “barcha ssenariylarda har bir boshqaruv qadami qat’iy real vaqtli” degan iborani ishlatmaydi.
Tenglama izchilligi eslatmasi: Manbaning dinamik obstacle penalty termini Tenglama (11) va birlashtirilgan muammo ifodasi Tenglama (14) da bir xil matematik shaklda taqdim etilmagan. Verianla bu farqni taxmin bilan tuzatmagan.
ADP talqin chegarasi: Augmented Dubins Path ning afzalligi silliqroq va kinematik jihatdan amalga oshirish mumkin bo‘lgan transition yaratishdir. Manbaning 4-jadval qiymatlari ADP uchala ssenariyda ham klassik DP ga qaraganda biroz yuqoriroq kumulyativ masofa va execution time yaratganini ko‘rsatadi.
Barqarorlik chegarasi: Mualliflar birlashtirilgan PG-MPC tizimining closed-loop stability si uchun rigoroz nazariy tahlil taqdim etmaganini va buni kelajakdagi ishga qoldirganini aniq bildirgan.
Ilmiy chegara: Model natijalari sintetik statik/dinamik to‘siqlar, ideallashtirilgan perception modeli va doimiy balandlikdagi planar fixed-wing dinamikasi sharoitida olingan. Haqiqiy shamol, sensor noise, communication delay, actuator uncertainty va jismoniy parvoz tizimi ta’sirlari eksperimental ravishda baholanmagan.
Kontent ishlab chiqarish usuli: Ushbu Verianla izohidagi ilmiy usul, tenglamalar, simulyatsiya parametrlari, samaradorlik metrikalari, rasm sharhlari va cheklovlar yuklangan manba tadqiqotiga asoslangan. Tashqi tekshirish faqat bibliografik identifikatsiya, rasmiy nashr yozuvi va hakemlik holatini tekshirish uchun ishlatilgan; tashqi manbalardan yangi ilmiy samaradorlik natijasi yoki manbada bo‘lmagan algoritmik xulosa asosiy matnga qo‘shilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan