


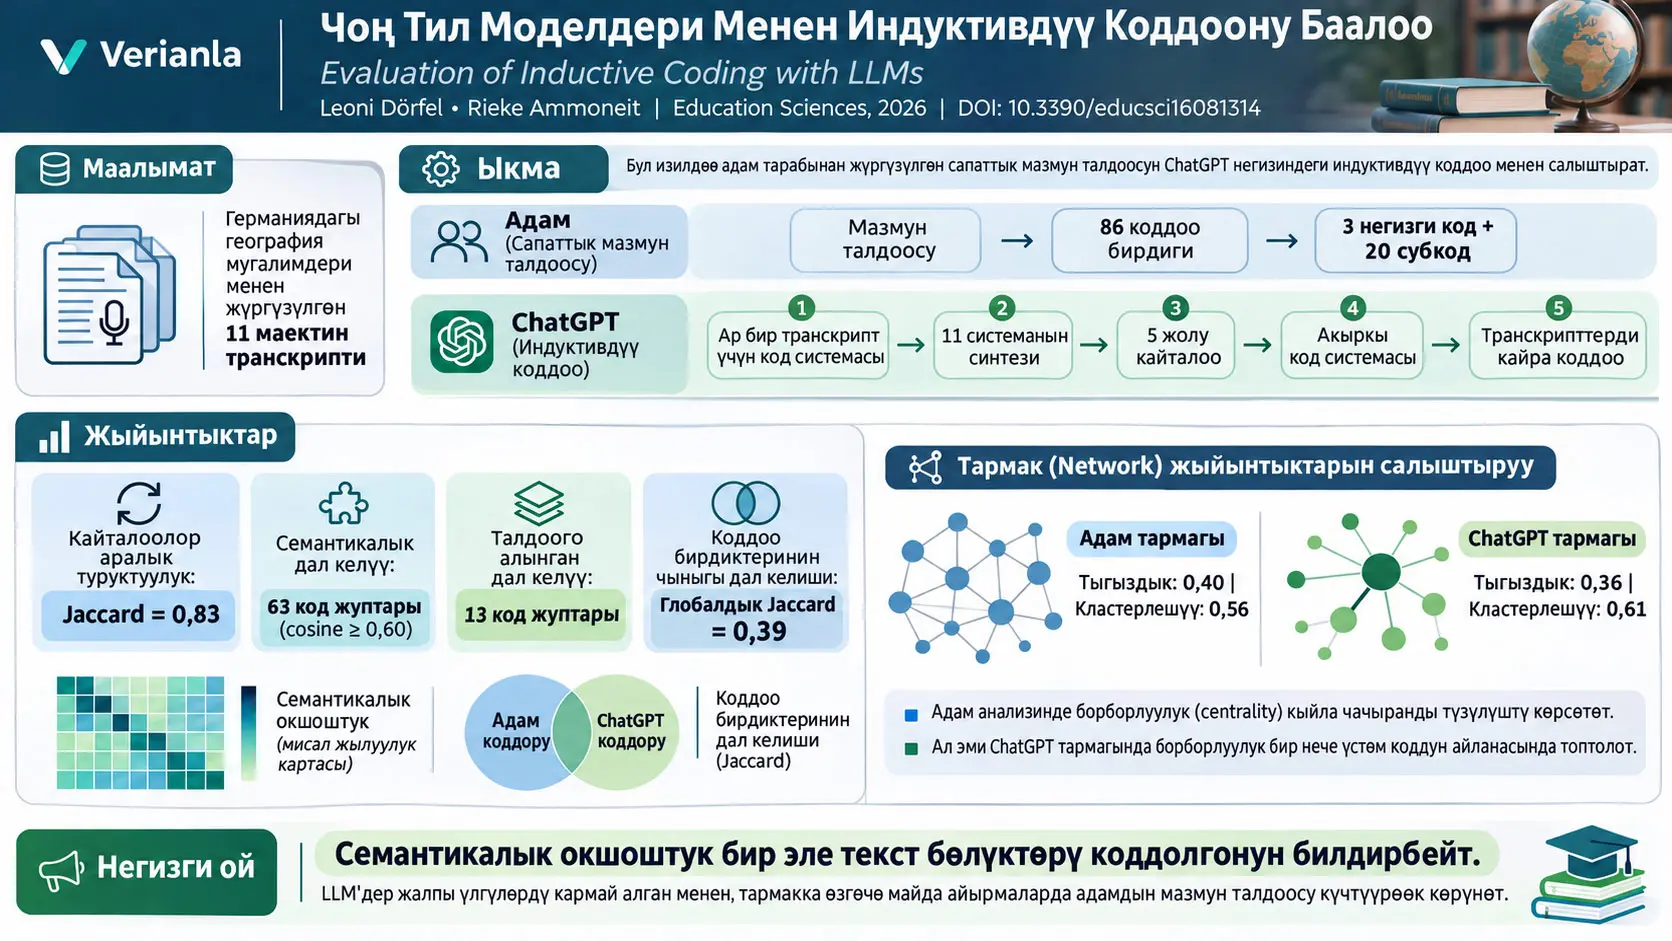
Чоң тил модели колдогон индуктивдүү коддоо — алдын ала даярдалган код китебин жөн гана колдонуу ордуна, интервьюлардагы же башка сапаттык тексттердеги үлгүлөрдөн код жана категория түзүмдөрүн түзүүдө чоң тил моделин пайдаланган сапаттык маалыматтарды талдоо ыкмасы. Бул изилдөө ChatGPT 11 немис география мугалими менен жүргүзүлгөн интервьюлардан итеративдүү промпт инженериясы аркылуу түзгөн код системасын ошол эле интервьюлар боюнча мурда адам изилдөөчүлөр жүргүзгөн сапаттык мазмундук талдоо менен салыштырат. Салыштыруу код аталыштарынын окшоштугу менен гана чектелбейт; кайсы текст бөлүктөрү коддолгонуна, коддордун тармак ичиндеги түзүмдүк байланыштарына жана тармакка мүнөздүү контекст канчалык деңгээлде сакталганына чейин кеңейтилген.
Изилдөөдө адегенде ChatGPT менен ар бир интервью үчүн өзүнчө код системасы түзүлүп, андан кийин бул системалар бириктирилген, синтез процесси беш жолу өз алдынча кайталанган жана беш синтездин кеминде үчөөндө болгон коддор пайдаланылып акыркы код системасы түзүлгөн. Акыркы система кийин ар бир интервьюга беш өз алдынча коддоо иштетүүсүндө колдонулган; бир эле коддун беш иштетүүнүн кеминде үчөөндө болушу акыркы баалоодо сактоо критерийи катары колдонулган. Бул кайталанма процессте интервью боюнча иштетүүлөр арасындагы жалпы Jaccard окшоштугу 0,83 деп билдирилген.
ChatGPT түзгөн акыркы код системасы 3 негизги коддон жана 14 кошумча коддон турса, адамга негизделген сапаттык мазмундук талдоо 3 негизги кодду жана 20 кошумча кодду камтыйт. SBERT негизиндеги семантикалык салыштырууда косинустук окшоштугу 0,60 же андан жогору болгон 63 код жуп табылган. Hungarian Algorithm менен түзүлгөн бирден-бирге дал келтирүүдө 14 талапкер дал келүүнүн бирөө гана 0,60 чегинен төмөн калган жана кийинки талдоолор 13 дал келтирилген код жуп боюнча жүргүзүлгөн.
Бирок коддордун мааниси жагынан окшош болушу ошол эле интервью бөлүктөрү коддолгонун билдирген эмес. Дал келтирилген 13 код жуп үчүн глобалдык Jaccard индекси болгону 0,39 түзгөн. Айрым жуптарда коддоо бирдиктеринин дал келиши жогору болсо, айрымдарында нөл болгон. Мисалы, “Material and textbook influence” менен “Resources: Textbooks” ортосунда Jaccard 0,86 болсо, “Diagnostic assessment” менен “Outside the classroom” жана “Knowledge deficits as breeding ground” менен “Educational policy factors” жуптарында Jaccard 0 болгон.
Тармактык талдоодо адамдын мазмундук талдоо тармагынын тыгыздыгы 0,40 жана глобалдык кластерлешүү коэффициенти 0,56; ChatGPT тармагынын тыгыздыгы 0,36 жана глобалдык кластерлешүү коэффициенти 0,61 деп табылган. Бул глобалдык көрсөткүчтөр бири-бирине жакын болгону менен, түйүндөрдүн борбордуулугу башка түзүмдү көрсөткөн: адам талдоосунда борбордуулук кеңири код топтомуна тараса, ChatGPT системасында бир нече жалпы код көбүрөөк үстөмдүк кылган. Изилдөөнүн негизги чечмелөөсү — түзүмдөштүрүлгөн жана итеративдүү промпттоо LLM коддоосун туруктуу кыла алат; бирок бул маалымат топтомунда ChatGPT тармакка мүнөздүү контекстти жана майда концептуалдык айырмачылыктарды адамдын мазмундук талдоосундай деталдап көрсөтө алган эмес.
Бул жыйынтыктар “ChatGPT сапаттык талдоодо адам менен бирдей жыйынтык берет” же “Jaccard 0,83 адам талдоосу менен %83 тактыкты билдирет” деп чечмеленбеши керек. 0,83 мааниси ChatGPTнин өзүнүн кайталанган иштетүүлөрүнүн ортосундагы туруктуулукту өлчөйт. Адам–ChatGPT салыштыруусундагы глобалдык коддоо бирдиктеринин дал келиши болсо 0,39. Мындан тышкары, изилдөөчүлөр адам код системасын абсолюттук объективдүү чындык катары эмес, ошол эле материалдын башка бир негиздүү аналитикалык чечмелөөсү катары карашат.
Изилдөөнүн негизги көйгөйү
Сапаттык изилдөөдө коддоо узун текст бөлүктөрүн изилдөө суроолоруна байланыштуу маанилүү категорияларга айландырууга мүмкүндүк берет. Бир интервьюда мугалимдер айткан нерселер жүздөгөн өзүнчө сүйлөмдөрдү же үзүндүлөрдү камтышы мүмкүн. Изилдөөчү бул материалда кайсы үзүндүлөр бир эле концептуалдык үлгүгө таандык экенин аныктайт, коддорду түзөт, окшош коддорду бириктирет жана зарыл болгондо жогорку категорияларды иштеп чыгат.
Чоң тил моделдери бар болгон код китебин текстке колдоно алат же чоң тексттердеги кайталанган темаларды аныктай алат. Бул изилдөөнүн көңүл борборундагы татаалыраак маселе — коддор алдын ала толук берилбеген учурда LLM код системасынын өзүн кантип өнүктүрөрү. Башкача айтканда, изилдөө “ChatGPT туура энбелгини тандайбы?” деген суроо менен гана чектелбейт; модель сапаттык материалдан кандай категорияларды чыгарары, бул категориялар адам түзгөн система менен кантип дал келери жана ошол эле тексттик далилдерге таянабы же жокпу изилденет.
Изилдөөдө эки башка изилдөө суроосунун деңгээли бар
Булакта бири-биринен айырмаланышы керек болгон эки суроо деңгээли бар. Биринчи деңгээл — баштапкы интервью маалымат топтомунун мазмунун изилдеген суроолор: география билиминде стереотиптештирүү пайда болобу, ал кантип жана эмне үчүн чыгат жана мугалимдер аны менен күрөшүү үчүн кандай стратегияларды колдонушат. Экинчи деңгээл — бул макаланын методологиялык баалоо суроолору: ChatGPT код системасын адамдын мазмундук талдоо системасына семантикалык жактан дал келтирүүгө болобу, семантикалык жактан дал келген коддор ошол эле коддоо бирдиктерин тандайбы жана эки код системасынын түзүмүнүн ортосунда системалуу айырмачылыктар барбы?
Бул айырма маанилүү. Интервьюлардын темасы стереотиптештирүү; ал эми бул макаланын негизги методологиялык темасы — ChatGPT менен түзүлгөн индуктивдүү коддоо системасын адамга негизделген мазмундук талдоо менен салыштыруу.
Индуктивдүү Коддоо Деген Эмне жана Бул Изилдөөдө ChatGPT Кантип Колдонулган?
Индуктивдүү коддоо — категориялар менен кошумча категорияларды алдын ала толук бекитип коюунун ордуна, талданып жаткан сапаттык материалдагы маанилүү үлгүлөрдөн өнүктүрүү процесси; бул изилдөөдө ChatGPT ар бир интервью үчүн маалыматка негизделген код системасын түзүп, бул системаларды кайталанма синтез кадамдары аркылуу бириктирип, алынган акыркы код системасын интервью транскрипттерине кайра колдонгон.
Адамга негизделген мазмундук талдоо кантип жүргүзүлгөн?
Адамдын мазмундук талдоосу Kuckartz жана Rädikerдин жети баскычтуу ыкмасын колдонгон. Изилдөөчүлөр адегенде интервьюларды кылдат окуп, жазууларды жана учурлардын кыскача баяндарын даярдашкан; андан кийин 11 транскрипт боюнча жалпысынан 86 коддоо бирдигин аныкташкан.
Биринчи баскычта үч негизги код колдонулган: стереотиптештирүүнүн мисалдары, стереотиптештирүүнүн себептери жана стереотиптештирүү менен күрөшүү стратегиялары. Бул негизги түзүмдүн алдында материалдан индуктивдүү түрдө 20 кошумча код иштелип чыгып, код түзүмү кайра каралып, бардык материал акыркы код системасы менен кайра коддолгон. Аналитикалык стратегиялар изилдөө суроолоруна жараша колдонулуп, адам талдоосу MAXQDA Analytics Pro 24.4.0 аркылуу жүргүзүлгөн.
ChatGPT коддоо процессинин беш баскычы
I баскыч — Алгачкы иштеп чыгуу: 11 интервьюнун ар бири өзүнчө ChatGPTге берилген жана ар бир транскрипт үчүн өзүнчө индуктивдүү код системасы иштелип чыккан. Промпт моделдин изилдөө ассистенти катары ролун, тапшырманы, изилдөө суроолорун, коддоо эрежелерин жана чыгуу форматын аныктаган. Бир убакта бир гана транскрипт колдонуу менен узун контекст жаратышы мүмкүн болгон иштетүү көйгөйлөрүн азайтуу максат кылынган.
Алгачкы сыноолордо ChatGPT изилдөө суроолоруна караганда жалпыраак “стереотип деген эмне?” сыяктуу жогорку деңгээлдеги сүрөттөөчү коддорго багыт алуу тенденциясын көрсөткөндүктөн, промпт такталган. Ошентип, код түзүүнү жалпы стереотип теориясына эмес, интервьюлардагы изилдөө суроолоруна көбүрөөк байланыштыруу көздөлгөн.
II баскыч — Он бир системанын синтези: Ар бир транскрипттен алынган 11 код системасы чогуу салыштырылган. Мазмуну боюнча окшош коддор бириктирилип, тематикалык жактан негиздөөгө боло турган жогорку коддор түзүлүп, кайталануулар чечилип, жаңы системага биринчи баскычта чындап колдонулган коддорду гана киргизүүгө уруксат берилген.
III баскыч — Синтезди кайталоо: LLM чыгыштары детерминисттик болбогондуктан, синтез процесси беш жолу өз алдынча кайталанган. Ар бир синтез өзүнчө чат сессиясында жүргүзүлүп, бул баскычта эс тутум функциясы өчүрүлгөнү белгиленген. Максат — бир гана кокустук модель чыгышына көз каранды болбостон, кайсы коддор кайталанган өндүрүүдө туруктуу экенин байкоо.
IV баскыч — Акыркы синтез: Беш синтезделген код системасы кайра бириктирилген. Код акыркы системага кириши үчүн беш системанын кеминде үчөөндө болушу талап кылынган. Бул “3/5” эрежеси сейрек жана бир жолку модель чыгыштарынын акыркы код системасын аныктоосун чектеген.
V баскыч — Транскрипттерди акыркы код системасы менен коддоо: Акыркы код системасы кийин баштапкы интервью транскрипттерине колдонулган. Модель аныкталган коддорду гана колдонушу, код аныктамасынын чегинен чыкпашы, жаңы код түзбөшү, код берүүнү негиздеши жана эч бир код туура келбесе муну ачык көрсөтүшү үчүн эрежелер колдонулган.
Ар бир транскрипт беш өз алдынча иштетүүдө коддолгон. Акыркы талдоодо код дайындоосун сактоо үчүн ал беш баалоонун кеминде үчөөндө болушу керек болгон. Бул экинчи 3/5 эрежеси код системасын түзүү баскычындагы 3/5 эрежесинен айырмаланат: биринчиси кайсы коддор акыркы код китебине кирерин, экинчиси болсо кайсы код дайындоолор акыркы баалоого алынарын аныктайт.
Тиркемелердеги промпттар илимий жактан эмне үчүн маанилүү?
Изилдөөнүн А тиркемеси бир гана мисал промпт бербестен, LLM колдогон коддоо процессин кайра көзөмөлдөөгө мүмкүн болсун үчүн колдонулган промпт архитектурасын документтештирет.
А.1 тиркемеси ар бир транскрипт үчүн код системасын иштеп чыккан алгачкы промпт. Моделден сапаттык билим берүү изилдөөсүнүн чөйрөсүндө изилдөөчү ролунда иштөө, транскрипттеги тиешелүү материалдан гана индуктивдүү категория түзүү, категорияларды бири-биринен айырмалоо жана код аталышы менен түшүндүрмөсүн таблица түрүндө берүү талап кылынат.
А.2 тиркемеси 11 өзүнчө код системасын интеграцияланган түзүмгө бириктирүүгө багытталган. Коддорду аталышы боюнча гана эмес, мазмуну боюнча салыштыруу, окшош коддорду бириктирүү, жогорку категорияларды тематикалык жактан негиздөө мүмкүн болгондо гана түзүү жана баштапкы системаларда такыр колдонулбаган кодду синтезге кошпоо шарттары бар.
А.3 тиркемеси беш кайталанган синтезди бир акыркы код системасына айлантат. Бул жердеги негизги тандоо эрежеси — код беш системанын кеминде үчөөндө болушу керек.
А.4 тиркемеси акыркы код китебин транскрипттерге колдонуу тартибин жөнгө салат. Модель код аныктамаларынан чыкпашы, кайра сөз менен айтып жаңы маани жаратпашы, жаңы код түзбөшү, бир коддоо бирдигинде бир нече коддун болушуна уруксат бериши, ылайыктуу код жок болсо муну көрсөтүшү жана ар бир дайындоону код аныктамасына таянып негиздеши талап кылынат.
Бул деталдар маанилүү; анткени изилдөөнүн жыйынтыктары “ChatGPTге коддо деп айтканда эмне болот?” сыяктуу жалпы колдонуунун натыйжасы эмес. Жыйынтыктар абдан түзүмдөштүрүлгөн жана кайталануулар аркылуу туруктуу кылууга аракет жасалган конкреттүү промпт протоколуна тиешелүү.
Косинустук Окшоштук менен Jaccard Индекси Эмне Үчүн Бир Эле Нерсени Өлчөбөйт?
Косинустук окшоштук эки коддун аталышы жана түшүндүрмөлөрү мааниси боюнча канчалык жакын экенин өлчөсө, Jaccard индекси коддор чындыгында кайсы коддоо бирдиктерине дайындалганы канчалык дал келгенин өлчөйт; ошондуктан эки коддун мааниси абдан окшош болсо да, интервьюларда ар башка текст бөлүктөрүнө колдонулушу мүмкүн.
SBERT менен коддордун семантикалык өкүлчүлүгү
Ар бир код үчүн код аталышы жана код аныктамасы бир тексттик билдирүүгө бириктирилген. Бул тексттер Sentence-BERT (SBERT) ыкмасы менен сандык векторлорго айландырылган. Изилдөөдө алдын ала үйрөтүлгөн paraphrase-multilingual-MiniLM-L12-v2 модели колдонулган.
Embedding деп аталган бул векторлор сөздөрдүн так дал келишин гана эмес, тексттик маанинин жакындыгын сандык мейкиндикте көрсөтүү үчүн колдонулат. Ошентип, мисалы, эки код ар башка сөздөрдү колдонсо да окшош маани берсе, бири-бирине жакын векторлорду түзүшү мүмкүн.
Косинустук окшоштуктун математикалык логикасы
Окутуучу эскертүү: Макала косинустук окшоштук теңдемесин өзүнчө басылган теңдеме катары бербейт. Төмөнкү туюнтма изилдөөдө колдонулган метриканын стандарттык математикалык аныктамасы; изилдөөнүн жаңы формуласы эмес.
\[ \mathrm{cosine}(\mathbf{a},\mathbf{b}) = \frac{\mathbf{a}\cdot\mathbf{b}} {\|\mathbf{a}\|\,\|\mathbf{b}\|} \]
\(\mathbf{a}\) жана \(\mathbf{b}\) — эки коддун SBERT аркылуу алынган embedding векторлору. Алымдагы скалярдык көбөйтүү эки вектордун жалпы багытын, бөлүмдөгү нормалардын көбөйтүндүсү болсо векторлордун чоңдуктарын нормалдаштырат. Ошентип салыштыруу негизинен векторлордун багытына, башкача айтканда семантикалык жакындыкка таянат.
Бул метрика өлчөмсүз. Изилдөөдө маани 1ге жакындаган сайын концептуалдык дал келүү күчтүүрөөк деп кабыл алынган. Кийинки талдоо үчүн 0,60 косинустук окшоштук чеги колдонулган.
Hungarian Algorithm эмне үчүн колдонулган?
Бир ChatGPT кодун анын эң жогорку окшоштук упайы бар адам коду менен өз алдынча дал келтирүү бир эле адам кодунун бир нече ChatGPT кодуна дайындалышына алып келиши мүмкүн. Изилдөө мунун ордуна бардык дал келүүлөрдү чогуу баалап, жалпы семантикалык окшоштукту максималдаштырган бирден-бирге дайындоо комбинациясын издеген.
Окутуучу стандарттык көрсөтүү: Макала төмөнкү оптималдаштыруу теңдемесин дал ушул формада баспайт; туюнтма Hungarian дайындоо маселесинин изилдөөдөгү колдонулушун түшүндүрүү үчүн берилген.
\[ \max \sum_i\sum_j s_{ij}x_{ij} \]
Бул жерде \(s_{ij}\) — ChatGPT коду \(i\) менен адамдын мазмундук талдоо коду \(j\) ортосундагы косинустук окшоштук. \(x_{ij}=1\) болсо эки код дал келтирилген, \(x_{ij}=0\) болсо дал келтирилген эмес. Бирден-бирге дал келтирүүдөн улам ар бир код эң көп дегенде бир каршы код менен дал келе алат.
ChatGPT системасында 14, адам системасында 20 кошумча код болгондуктан, Hungarian Algorithm эң көп 14 бирден-бирге талапкер дал келүү түзө алат. Изилдөөдө 14 талапкер дал келүүнүн бири 0,56 косинустук окшоштук менен 0,60 чегинен төмөн калып, кийинки талдоолор 13 дал келтирилген жуп боюнча жүргүзүлгөн.
Jaccard индекси эмнени эсептейт?
Окутуучу стандарттык аныктама: Макала Jaccard индексин сөз менен аныктайт; төмөнкү теңдеме ошол аныктаманын стандарттык математикалык көрсөтүлүшү.
\[ J(A,B) = \frac{|A\cap B|} {|A\cup B|} \]
\(A\) — код биринчи коддоо ыкмасы тарабынан дайындалган коддоо бирдиктери; \(B\) — тиешелүү код экинчи ыкма тарабынан дайындалган коддоо бирдиктеринин жыйындысы. \(|A\cap B|\) эки ыкма тең коддогон жалпы бирдиктердин санын; \(|A\cup B|\) болсо жок дегенде бир ыкма коддогон бардык бирдиктерди көрсөтөт.
\(J=1\) эки жыйын толугу менен бирдей экенин; \(J=0\) жалпы эч бир коддоо бирдиги жок экенин билдирет.
Изилдөө Jaccard индексин эки башка максатта колдонгон. Биринчиси — бир эле транскрипт беш ChatGPT иштетүүсүнүн арасында канчалык туруктуу коддолгонун баалоо. Экинчиси — семантикалык жактан дал келтирилген ChatGPT жана адам коддору ошол эле текст бөлүктөрүнө колдонулганбы же жокпу баалоо. Бул эки Jaccard жыйынтыгы бир эле илимий суроого жооп бербейт.
Тармактык талдоо эмнени кошот?
Семантикалык дал келтирүү өзүнчө код жуптарын салыштырса, тармактык талдоо бүт код системасынын түзүмүн изилдейт. Ар бир код түйүн, бир коддоо бирдигинде чогуу көрүнгөн эки коддун ортосундагы байланыш кыр катары аныкталган. Кырдын салмагы эки код канча коддоо бирдигинде чогуу болгонуна байланыштуу.
Тармак тыгыздыгы байкалган код-код байланыштары мүмкүн болгон байланыштардын канчасын түзөрүн өлчөйт. Жөнөкөй багытсыз тармак үчүн стандарттык окутуучу туюнтма төмөнкүдөй:
\[ D=\frac{2E}{V(V-1)} \]
\(V\) — түйүн, башкача айтканда коддордун саны; \(E\) — байкалган байланыштардын саны. Маани жогорулаган сайын тармактагы коддордун бири-бири менен байланышкан үлүшү өсөт. Бул формула изилдөөнүн жаңы формуласы эмес; макаладагы тармак тыгыздыгы түшүнүгүнүн стандарттык түшүндүрмөсү.
Глобалдык кластерлешүү коэффициенти бир кодго байланышкан коддордун өз ара да байланышып, кластер түзүү тенденциясын баалайт. Булак белгилүү бир теңдеме жазбайт; ошондуктан Verianla бул жерде макалада жок так колдонмо формуласын божомолдобойт.
Менчик вектордук борбордуулук (eigenvector centrality, EV-centrality) коддун канча байланышы бар экенине гана эмес, ошол код байланышкан башка коддор канчалык борбордук экенине да маани берет. Стандарттык менчик вектордук байланыш окутуучу түрдө:
\[ x_i = \frac{1}{\lambda} \sum_j A_{ij}x_j \]
түрүндө көрсөтүлүшү мүмкүн. \(x_i\) — код \(i\)нин борбордуулугу; \(A_{ij}\) — тармактын байланыш матрицасы; \(\lambda\) болсо тиешелүү менчик маани. Борбордук коддор менен байланышкан түйүндөр жогору EV-борбордуулук алышат.
Fruchterman–Reingold жайгашуусу статистикалык жыйынтык эмес
Тармак визуалдарында түйүндөрдүн экрандагы орду Fruchterman–Reingold алгоритми менен аныкталган. Алгоритм күчтүү байланышкан түйүндөрдү визуалдык жактан жакындатып, тармакты окууну жеңилдетет. Түйүндүн сүрөттө оңдо, солдо, жогоруда же төмөндө болушу өзүнчө илимий өлчөм эмес; илимий өлчөмдөр — байланыштар, кыр салмактары жана борбордуулук маанилери.
Curveball null модели эмне үчүн керек?
Эки тармактын тыгыздык же кластерлешүү маанилери бар болгон код жыштыктарынан улам гана пайда болгонбу же жокпу баалоо үчүн өзүнчө null моделдер түзүлгөн. Curveball алгоритми коддоо бирдиги × код экилик матрицасын кокусташтырганда эки маанилүү касиетти сактаган: ар бир коддоо бирдигине дайындалган жалпы коддордун саны жана ар бир коддун бүт маалымат топтомундагы жалпы кездешүү жыштыгы.
Ар бир код системасы үчүн 10.000 кокусташтырылган экилик матрица түзүлүп, алардан коддордун чогуу-кездешүү тармактары кайра курулуп, тыгыздык жана глобалдык кластерлешүү үчүн null бөлүштүрүүлөр алынган.
Стандартташтырылган салыштыруунун окутуучу формасы:
\[ z = \frac{T_{\mathrm{obs}}-\mu_{\mathrm{null}}} {\sigma_{\mathrm{null}}} \]
деп кароого болот. \(T_{\mathrm{obs}}\) — байкалган тармак метрикасы, \(\mu_{\mathrm{null}}\) — кокустук null бөлүштүрүүнүн орточо мааниси жана \(\sigma_{\mathrm{null}}\) — null бөлүштүрүүнүн стандарттык четтөөсү. Булак ошондой эле эки тараптуу Monte Carlo p-маанилери жана %95 null интервалдары эсептелгенин билдирет. Негизги жыйынтык текстинде %95 null интервалдарынын сандык чектери берилбегендиктен, Verianla бул чектерди түзбөйт.
Жогорку Семантикалык Окшоштук Ошол Эле Текст Бөлүктөрү Коддолгонун Көрсөтөбү?
Жок. Бул изилдөөдө айрым код жуптарынын косинустук окшоштугу жогору болгону менен Jaccard дал келиши абдан төмөн болгон; мисалы, “Perspective shift and irritation” менен “Teaching methods” семантикалык жактан болжол менен 0,78 окшоштук көрсөткөнүнө карабастан, коддоо бирдиктеринин дал келиши болгону 0,10 болгон.
Бул айырма изилдөөнүн эң маанилүү табылгаларынын бири. Код аталыштары жана аныктамалары окшош концептуалдык мааниге ээ болушу мүмкүн; бирок эки коддоо системасы бул түшүнүктү интервьюнун ар башка бөлүктөрүндө, ар башка кеңдикте же ар башка контексттик критерийлер менен колдонушу мүмкүн.
Авторлордун чечмелөөсүнө ылайык, мунун маанилүү себептеринин бири коддун гранулярдуулугу. ChatGPT кең түшүнүктөрдү бир коддун алдында бириктирүүгө ык болсо, адамдын мазмундук талдоосу ошол эле концептуалдык талааны майда кошумча коддорго бөлгөн. Ошондуктан ChatGPTнин кең кодуна кирген текст бөлүктөрүнүн бир бөлүгү гана Hungarian Algorithm менен дал келтирилген тар адам кодуна туура келиши мүмкүн.
Код гранулярдуулугу деген эмне?
Гранулярдуулук код системасы концептуалдык айырмачылыктарды канчалык майда же кең кармай турганын билдирет. Мисалы, ChatGPT системасы “Spatial and developmental stereotypes” деген кең категория түзсө, адамдын мазмундук талдоосу мейкиндиктик стереотиптерди “Continents”, “Countries” жана “Country groups” сыяктуу өзүнчө коддорго көбүрөөк бөлгөн.
Эки ыкма бир эле жалпы феноменди таанышы мүмкүн; бирок бири аны бир чоң кутуга, экинчиси үч өзүнчө кутуга жайгаштырса, код аталыштарынын ортосунда жогорку семантикалык окшоштук болсо да, кайсы үзүндүлөр бирден-бирге дал келери төмөн чыгышы мүмкүн.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Маалымат топтому жана маалыматтарды даярдоо
| Өзгөчөлүк | Булакта берилген маалымат |
|---|---|
| Интервьюлардын саны | 11 анонимдүү жарым түзүмдөштүрүлгөн онлайн интервью |
| Катышуучулар | Немис география мугалимдери |
| Иштеп жаткан мугалим | n = 9 |
| Мугалимдикке талапкер | n = 2 |
| Интервью темасы | География сабагындагы стереотиптештирүү |
| Транскрипция | noScribe 0.4.1 жана андан кийин эки айлампа кол менен оңдоо |
| Адам талдоосундагы коддоо бирдиги | 86 |
| Адам талдоо программасы | MAXQDA Analytics Pro 24.4.0 |
| ChatGPT системасы | ChatGPT-5.2, 11 декабрь 2025 snapshot — булакта колдонулган аталыш |
| Коддоо тили | Немис тили |
| Акыркы ChatGPT код системасынын котормосу | DeepL менен англис тилине, 8 июнь 2026 |
Адамдын мазмундук талдоосундагы 20 кошумча код
| Негизги код | Кошумча код | n |
|---|---|---|
| Стереотиптештирүү мисалдары | Continents | 4 |
| Стереотиптештирүү мисалдары | Country groups | 3 |
| Стереотиптештирүү мисалдары | Students' background | 7 |
| Стереотиптештирүү мисалдары | Countries | 8 |
| Стереотиптештирүү мисалдары | Subject content | 13 |
| Стереотиптештирүүнүн себептери | Teachers (causes) | 2 |
| Стереотиптештирүүнүн себептери | Educational policy factors | 2 |
| Стереотиптештирүүнүн себептери | Geography-specific factors | 7 |
| Стереотиптештирүүнүн себептери | Students (causes) | 8 |
| Стереотиптештирүүнүн себептери | Sociocultural influences | 5 |
| Стереотиптештирүүнүн себептери | Resources: Textbooks | 6 |
| Стереотиптештирүү менен күрөшүү стратегиялары | Perspective shift | 6 |
| Стереотиптештирүү менен күрөшүү стратегиялары | Causal analysis | 3 |
| Стереотиптештирүү менен күрөшүү стратегиялары | Student-oriented strategies | 4 |
| Стереотиптештирүү менен күрөшүү стратегиялары | Teachers (strategies) | 3 |
| Стереотиптештирүү менен күрөшүү стратегиялары | Teaching methods | 6 |
| Стереотиптештирүү менен күрөшүү стратегиялары | Outside the classroom | 2 |
| Стереотиптештирүү менен күрөшүү стратегиялары | Dialogue and reflection | 7 |
| Стереотиптештирүү менен күрөшүү стратегиялары | Increasing complexity | 5 |
| Стереотиптештирүү менен күрөшүү стратегиялары | Evidence-based working | 5 |
Булактагы Кошумча таблица A1де стратегия кошумча коддорунун номерлениши 3.8ден түз эле 3.10го өтөт; 3.9 коду көрсөтүлгөн эмес. Ошого карабастан, таблица жалпысынан 20 кошумча кодду билдирет. Verianla жетишпеген номер кайсы кодго тиешелүү экенин божомолдобойт.
Кошумча таблица A1деги коддордун жалпы кездешүү саны 106. Бул сан 86 коддоо бирдигинен көп болушу мүмкүн; анткени бир коддоо бирдигине бир нече ар башка код дайындалышы мүмкүн. Бул макаладагы салыштырууну ChatGPT коддоосуна көбүрөөк ылайыкташтыруу үчүн бир эле коддун бир коддоо бирдигиндеги кайталоолору эң көп 1 деп эсептелген.
ChatGPT түзгөн акыркы код системасы
| Негизги код | Кошумча код | Код камтыган негизги идея |
|---|---|---|
| Manifestations | Spatial and developmental stereotypes | Аймактар менен коомдорду бир тектүү, артта калган же бир жактуу өнүккөн образдар аркылуу көрсөтүү |
| Manifestations | Problem and deficit focus | Аймактарды негизинен кризис, жакырчылык, конфликт же жетишсиздик аркылуу көрсөтүү |
| Manifestations | Social and origin stereotypes | Этникалык келип чыгыш, улут, социалдык фон же жөндөм боюнча жалпылоочу мүнөздөмөлөрдү берүү |
| Manifestations | Migration and religion | Миграция жана дин сыяктуу татаал тармактарды аз сандагы өзгөчөлүккө же себепке кыскартуу |
| Conditions of emergence | Didactic reduction and time pressure | Сабак убактысы жана дидактикалык жөнөкөйлөтүү ашыкча жалпылоолорду жеңилдетиши мүмкүн болушу |
| Conditions of emergence | Material and textbook influence | Окуу китеби, визуал, карикатура же окуу программасындагы көрсөтүүлөр стереотиптерди кайра жаратышы мүмкүн болушу |
| Conditions of emergence | Knowledge deficits as a breeding ground | Тармактык билимдин жетишсиздиги татаал байланыштардын ордуна жөнөкөй түшүндүрмө схемаларына багытташы мүмкүн болушу |
| Conditions of emergence | Eurocentrism | Европа борборлуу критерийлерди башка аймактарды баалоодо норма катары колдонуу |
| Pedagogical strategies | Diagnostic assessment | Сабактын башында окуучулардын учурдагы ойлорун жана элестерин аныктоо |
| Pedagogical strategies | Dialogue-based reflection and intervention | Жалпылоочу билдирүүлөрдү суроого алуу, талкуулоо жана альтернативдүү перспективаларды сунуштоо |
| Pedagogical strategies | Perspective shift and irritation | Ролдук оюн же кадимки көз карашты бузган ыкмалар аркылуу ой жүгүртүү перспективасын өзгөртүүгө түрткү берүү |
| Pedagogical strategies | Work with data and contextualization | Дооматтарды маалымат жана кеңири контекст аркылуу текшерүү |
| Pedagogical strategies | Making diversity and differentiation visible | Өлкөлөрдүн, аймактардын жана топтордун ички ар түрдүүлүгүн көрүнүктүү кылуу |
| Pedagogical strategies | Professional self-reflection | Мугалимдин өз ой жүгүртүү калыптары жана мүмкүн болгон стереотиптери жөнүндө сын көз менен ой жүгүртүүсү |
Беш синтез иштетүүсүндөгү коддордун саны
Беш өзүнчө синтез бирдей санда кошумча код түзгөн эмес. Trial 1 жана Trial 5те 16, Trial 2де 18, Trial 3тө 24 жана Trial 4тө 20 кошумча код пайда болгон. Trial 4 мындан тышкары ошол иштетүүдө гана көрүнгөн “Perception and Evaluation” аттуу жогорку деңгээлдеги кодду түзгөн. Код бир гана синтезде көрүнгөндүктөн акыркы 3/5 тандоо эрежесинен өтө алган эмес.
Акыркы коддоонун иштетүүдөн иштетүүгө туруктуулугу
| Транскрипт | Jaccard |
|---|---|
| 1 | 0,88 |
| 2 | 0,77 |
| 3 | 0,79 |
| 4 | 0,84 |
| 5 | 0,91 |
| 6 | 0,91 |
| 7 | 0,83 |
| 8 | 0,78 |
| 9 | 0,86 |
| 10 | 0,87 |
| 11 | 0,66 |
| Жалпы | 0,83 |
Иштетүүлөр аралык эң жогорку Jaccard 5-жана 6-транскрипттерде 0,91; эң төмөнкү маани 11-транскриптте 0,66. Жалпы маани 0,83.
Бул таблицанын мааниси өзгөчө чектелиши керек: 0,83 ChatGPT адам коддоосуна %83 туура келет же %83 так дегенди билдирбейт. Бул өлчөм бир эле ChatGPT протоколу өз алдынча кайталоолордо канчалык окшош код дайындоолорун бергенине гана байланыштуу.
SBERT жылуулук картасынын негизги билдирүүсү
Булак жылуулук картасында жалпысынан 63 код жуптун косинустук окшоштугу 0,60 же андан жогору деп табылган. “Professional self-reflection”, “Didactic reduction and time pressure”, “Working with data and contextualization” жана “Perspective shift” сыяктуу ChatGPT коддору адам коддору менен 0,70тен жогору окшоштуктарды көрсөткөн.
Тескерисинче, “Migration and religion” жана “Problem and deficit focus” сыяктуу коддордун адам системасындагы эң жакын дал келүүлөрү салыштырмалуу алсызыраак семантикалык окшоштук көрсөткөн.
Булак жылуулук картасындагы бардык уячалардын так сандык маанилерин таблица түрүндө жарыялабайт. Ошондуктан Verianla түстөрдөн болжолдуу сандарды чыгарып жаңы сандык матрица түзбөйт.
Hungarian Algorithm менен бирден-бирге дал келтирүү жыйынтыктары
| No. | ChatGPT коду | Адамдын мазмундук талдоо коду | Косинустук окшоштук |
|---|---|---|---|
| 1 | Dialogue-based reflection and intervention | Dialogue and reflection | 0,81 |
| 2 | Perspective shift and irritation | Teaching methods | 0,78 |
| 3 | Making diversity and differentiation visible | Increasing complexity | 0,77 |
| 4 | Professional self-reflection | Teachers (strategies) | 0,77 |
| 5 | Diagnostic assessment | Outside the classroom | 0,73 |
| 6 | Work with data and contextualization | Evidence-based learning | 0,72 |
| 7 | Knowledge deficits as breeding ground | Educational policy factors | 0,71 |
| 8 | Spatial and developmental stereotypes | Continents | 0,69 |
| 9 | Social and origin stereotypes | Students' background | 0,66 |
| 10 | Didactic reduction and time pressure | Geography-specific factors | 0,65 |
| 11 | Material and textbook influence | Resources: Textbooks | 0,63 |
| 12 | Migration and religion | Sociocultural influences | 0,61 |
| 13 | Eurocentrism | Perspective shift | 0,60 |
| 14 | Problem and deficit focus | Country groups | 0,56 — чектен төмөн |
Акыркы дал келүү 0,60 чегинен төмөн болгондуктан кийинки коддоо-бирдиги Jaccard салыштыруусуна киргизилген эмес.
Адамдын мазмундук талдоосу ChatGPT системасынан алты кодго көп болгондуктан, толук 14түк бирден-бирге дайындоодо алты адам коду дал келбей калган: Subject content, Countries, Teachers (causes), Students (causes), Causal analysis жана Student-oriented strategies.
Бул алты коддун мүнөзү изилдөөнүн чечмелөөсүндө маанилүү. Алардын олуттуу бөлүгү географияга мүнөздүү мазмун, класстагы белгилүү акторлор же майда стратегия айырмачылыктары. Авторлор муну ChatGPT системасы кеңири, жалпылоого боло турган үлгүлөрдү кармап, тармакка жана акторго мүнөздүү айырмачылыктарды азыраак деталдаганы тууралуу табылга менен байланыштырышат.
Семантикалык дал келтирүүдөн кийинки чыныгы коддоо бирдигинин дал келиши
| ChatGPT коду | Адам коду | Jaccard |
|---|---|---|
| Dialogue-based reflection and intervention | Dialogue and reflection | 0,66 |
| Perspective shift and irritation | Teaching methods | 0,10 |
| Making diversity and differentiation visible | Increasing complexity | 0,66 |
| Professional self-reflection | Teachers (strategies) | 0,75 |
| Diagnostic assessment | Outside the classroom | 0 |
| Working with data and contextualization | Evidence-based working | 0,80 |
| Knowledge deficits as breeding ground | Educational policy factors | 0 |
| Spatial and developmental stereotypes | Continents | 0,33 |
| Social and origin stereotypes | Students' background | 0,38 |
| Complexity reduction and time pressure | Geography-specific factors | 0,33 |
| Material and textbook influence | Resources: Textbooks | 0,86 |
| Eurocentrism | Perspective shift | 0,14 |
| Migration and religion | Sociocultural influences | 0 |
| Глобалдык Jaccard | 13 дал келтирилген жуптун жалпысы | 0,39 |
Беш код жупта Jaccard 0,60тан жогору. Эң жогорку маани “Material and textbook influence” менен “Resources: Textbooks” ортосунда 0,86. Тескерисинче, үч дал келүүдө Jaccard нөл.
Булактын жыйынтык тексти төмөн-орто топту болжол менен 0,30–0,40 деп сүрөттөйт. Булак ошондой эле калган беш жуп үчүн “J<0,14” деген туюнтманы колдонот; бирок 7-таблицада Eurocentrism–Perspective shift мааниси так 0,14. Verianla таблицадагы маанини өзгөртпөйт.
Талкуу бөлүмүндө жогорку макулдашуу диапазону бир жерде 0,66–0,89 деп жазылган; бирок 7-таблицада байкалган эң жогорку маани 0,86. Ошондуктан Verianla так сандык маанилерде 7-таблицадагы 0,86ны колдонот.
Эмне үчүн 0,78 семантикалык окшоштук 0,10 Jaccard менен бирге көрүнүшү мүмкүн?
“Perspective shift and irritation” менен “Teaching methods” концептуалдык аныктамалары бири-бирине кыйла жакын болгондуктан, косинустук окшоштук 0,78. Бирок адам жана ChatGPT системалары бул түшүнүктөрдү ошол эле интервью үзүндүлөрүнө өтө аз колдонуп, Jaccard болгону 0,10 болгон.
Тескерисинче, “Dialogue-based reflection and intervention” менен “Dialogue and reflection” семантикалык деңгээлде 0,81 сыяктуу жогорку окшоштукка жана коддоо бирдиктеринде 0,66 Jaccard дал келишине ээ. Демек, изилдөөдө семантикалык жакындык менен тексттик колдонуудагы дал келүүнүн ортосунда милдеттүү бирден-бирге байланыш жок.
Тармак Тыгыздыгы Окшош Болсо, Эки Код Системасы Түзүмдүк Жактан Бирдейби?
Жок. Адам жана ChatGPT тармактарынын жалпы тыгыздык жана кластерлешүү маанилери бири-бирине жакын болгону менен, менчик вектордук борбордуулуктун коддор арасындагы бөлүштүрүлүшү айырмаланат; адам системасында түзүмдүк маанилүүлүк көбүрөөк кодго тараса, ChatGPT системасында бир нече кең код борбордо топтолгон.
| Метрика | Адамдын мазмундук талдоосу | ChatGPT |
|---|---|---|
| Тармак тыгыздыгы | 0,40 | 0,36 |
| Тыгыздык үчүн z | −0,60 | −1,66 |
| Тыгыздык үчүн p | 0,611 | 0,154 |
| Глобалдык кластерлешүү коэффициенти | 0,56 | 0,61 |
| Кластерлешүү үчүн z | 0,34 | 1,19 |
| Кластерлешүү үчүн p | 0,683 | 0,239 |
Авторлордун чечмелөөсүнө ылайык, эки тармактын тең тыгыздык жана глобалдык кластерлешүү маанилери өз null моделдеринен олуттуу айырмаланган эмес. Булактын метод бөлүмүндө %95 null интервалдары да эсептелгени айтылганы менен, негизги жыйынтыктарда бул интервалдардын сандык төмөнкү жана жогорку чектери берилбейт.
Булак бул тармактык салыштыруу үчүн өзүнчө альфа чегин ачык жазбайт; ошондуктан Verianla булакта жок маанилүүлүк чегин кошпойт. Авторлордун өз жыйынтык чечмелөөсү билдирилген p-маанилердин негизинде глобалдык тыгыздык жана кластерлешүү null күтүүдөн ашпаганы тууралуу.
Менчик вектордук борбордуулук башка көрүнүштү көрсөтөт
Адамдын мазмундук талдоо тармагында эң борбордук код Subject content, EV = 1,00, экинчи эң борбордук код Continents, EV = 0,71. Булак ошондой эле Students (causes), Resources: Textbooks жана Teaching methods коддору салыштырмалуу жогорку борбордуулукту көрсөткөнүн белгилейт.
ChatGPT тармагында болсо Spatial and developmental stereotypes, EV = 1,00; Problem and deficit focus, EV = 0,91 жана Material and textbook influence, EV = 0,90 маанилери менен бир нече код ачык түрдө борбордо топтолгон.
Null-model жыйынтыктары эмнени билдирет?
Глобалдык тармак тыгыздыгы жана кластерлешүү үчүн null-model p-маанилеринин жогору болушу байкалган глобалдык байланыштуулук жана кластерлешүү код жыштыктары менен коддоо бирдигине туура келген коддордун саны гана сакталып түзүлгөн кокустук тармактардан ачык айырмаланбаганын көрсөтөт.
Бирок бул жыйынтык “эки тармак бирдей” дегенди билдирбейт. Эки глобалдык сан окшош болсо да, кайсы коддор борбордо экени, кайсы түшүнүктөр бири-бири менен байланыш түзөрү жана түзүмдүк маанилүүлүк коддор арасында кантип бөлүштүрүлгөнү айырмаланышы мүмкүн. Изилдөөнүн EV-борбордуулук табылгасы дал ушул жергиликтүүрөөк түзүмдүк айырманы көрсөтөт.
Сапаттык баалоо: түзүмдүк курам
ChatGPT түзгөн система талап кылынган таблица форматын жана үч негизги концептуалдык тармакты негизинен сактаган. 13 семантикалык дал келүүнүн 11инде коддор ошол эле жалпы негизги тема деңгээлинде туура келген: стереотип мисалдары ChatGPTнин manifestations тармагына, себептер conditions of emergence тармагына жана стратегиялар pedagogical strategies тармагына туура келген.
Эки дал келүү негизги тема деңгээлинен ашкан: Migration and religion менен Sociocultural influences; Eurocentrism менен Perspective shift. Авторлор муну Hungarian Algorithmдин бирден-бирге дал келтирүү талабынан келип чыккан мүмкүн болгон кошумча таасир деп белгилешет. Анткени алгоритм жалпы окшоштукту глобалдык түрдө максималдаштырып, ар бир кодго бир гана дал келүүгө уруксат берет; айрым коддордун эң табигый өнөктөштөрү буга чейин башка дал келүүлөргө бөлүнүп калышы мүмкүн.
Сапаттык баалоо: гранулярдуулук жана тармакка мүнөздүүлүк
Адамдын мазмундук талдоосу ChatGPTден алтыга көп кошумча категория түзгөн. Айрыкча адам системасындагы Subject content кодунун ChatGPT системасында дал келүүсү жок экени көңүл бурат; анткени Subject content адам тармагындагы эң көп колдонулган коддордун бири жана EV = 1,00 менен эң борбордук түйүн.
Адам системасы Continents, Countries жана Country groups сыяктуу майда мейкиндиктик айырмачылыктарды түзсө, ChatGPT аларды кеңири Spatial and developmental stereotypes категориясынын алдында бириктирген.
Авторлордун баалоосу боюнча, ChatGPT күчтүү кайталанган жалпы үлгүлөрдү кармай алат; бирок бул маалымат топтомунда география билимине мүнөздүү айырмачылыктар азыраак ачык көрсөтүлгөн.
Сапаттык баалоо: себептерди түшүндүрүүдөгү акторлор
Адамдын мазмундук талдоосунда стереотиптештирүүнүн себептери мугалимдер, окуучулар, социалдык фон, сабактын мазмундук түзүмү, окуу китептери жана билим берүү саясаты сыяктуу ар башка актордук жана түзүмдүк деңгээлдерге бөлүнгөн.
ChatGPT системасында болсо себептер көбүрөөк түзүмдүк шарттарга багытталган; мугалим жана окуучу сыяктуу класстын негизги акторлору өзүнчө себеп категориялары катары адам системасындагыдай так көрсөтүлгөн эмес.
Айрыкча Students (causes) адам тармагында түзүмдүк жактан маанилүү код; ChatGPTде окуучу өлчөмү негизинен Knowledge deficits as a breeding ground ичинде чектелүү түрдө көрүнөт. Ошондуктан изилдөө адам талдоосу аталган изилдөө суроосуна карата көбүрөөк дифференцияланган актордук түзүмдү берет деп эсептейт.
Эки системага тең жалпы болгон жогорку деңгээлдеги үлгү
Эки тармакта тең стереотиптештирүүнүн мисалдары жана себептери менен байланышкан коддор борбордук позицияларда көбүрөөк болууга ык. Педагогикалык стратегия коддору болсо жалпысынан төмөн борбордуулук жана аз байланыш көрсөтөт.
Бул табылга эки талдоо ыкмасы тең маалымат топтомунда “феномен эмне жана эмне үчүн пайда болот?” деген суроолорду “кантип кийлигишүү жасалат?” деген суроого караганда түзүмдүк жактан борбордуураак көрсөтөрүн болжолдойт. Бул булак авторлорунун тармак түзүмүнөн чыгарган чечмелөөсү; себептик механизмдин далили эмес.
Изилдөө колдогон жыйынтыктар
- Түзүмдөштүрүлгөн, итеративдүү промпттоо шартында ChatGPT кайталануулар арасында салыштырмалуу туруктуу коддоо системасын түзө алган.
- Беш өз алдынча коддоо иштетүүсүндө жалпы run-to-run Jaccard 0,83.
- ChatGPT жана адам код системаларынын арасында көптөгөн орто-жогорку семантикалык окшоштуктар табылган.
- 0,60 чегинен жогору 13 бирден-бирге код дал келүүсү кийинки салыштырууга киргизилген.
- Семантикалык жактан окшош коддор ошол эле текст бөлүктөрүн коддойт деген кепилдик жок; глобалдык Jaccard 0,39.
- ChatGPT системасы кеңири код категорияларына багытталса, адамдын мазмундук талдоосу майда жана тармакка мүнөздүү айырмачылыктарды жараткан.
- Эки тармактын глобалдык тыгыздыгы жана кластерлешүүсү окшош көрүнгөнү менен, борбордуулук бөлүштүрүүлөрү ар башка.
- Бул маалымат топтомунда ChatGPT тармагынын түзүмдүк маанилүүлүгү азыраак сандагы үстөм коддордо топтолгон.
- Адамдын мазмундук талдоосунда географияга жана акторго мүнөздүү түшүнүктөр көбүрөөк көрүнөт.
- LLM чыгыштарын адам тарабынан сын көз менен текшерүү изилдөөдө зарыл деп эсептелет.
Изилдөө колдобогон жыйынтыктар
- ChatGPT бардык сапаттык изилдөөлөрдө адам коддоосуна эквиваленттүү деп жыйынтык чыгарууга болбойт.
- Jaccard 0,83 адам коддоосуна каршы %83 тактыкты билдирбейт.
- Косинустук окшоштуктун жогору болушу ошол эле текст үзүндүлөрү коддолгонун далилдебейт.
- Глобалдык тармак тыгыздыгынын жакын болушу эки код системасынын концептуалдык түзүмү бирдей экенин көрсөтпөйт.
- Адамдын мазмундук талдоосу бул изилдөөдө объективдүү жана жалгыз мүмкүн болгон “ground truth” катары аныкталган эмес.
- 11 интервьюдан алынган жыйынтыктарды бардык дисциплиналарга, бардык LLMлерге же бардык сапаттык маалымат түрлөрүнө жалпылоого болбойт.
- Жыйынтыктар жалпы жана түзүмдөштүрүлбөгөн ChatGPT колдонуусун эмес, изилдөөдөгү деталдаштырылган жана итеративдүү промпт протоколун билдирет.
- Изилдөө LLM код категорияларын ичинде кандай когнитивдик же алгоритмдик механизм менен түзөрүн түшүндүрбөйт.
LLMдин “кара куту” көйгөйү
Адамдын сапаттык талдоосунда изилдөөчү кайсы коддоо бирдиктерин салыштырганын, кодду эмне үчүн бөлгөнүн же эки кодду кайсы концептуалдык негиз менен бириктиргенин кадам сайын документтештире алат. LLMдин ички иштетүүсүндө болсо кең категориялар адам талдоосундагыдай итеративдүү концептуалдык абстракция аркылуу түзүлөбү же башка статистикалык үлгү таануу механизми аркылуу жаралабы — муну түз байкоо мүмкүн эмес.
Ошондуктан изилдөө эки системанын ортосунда семантикалык жакындык болгонуна карабастан, айрым коддоо бирдиктери эмне үчүн абдан башкача тандалганын толук түшүндүрө албайт. Код гранулярдуулугу мунун бир бөлүгүн түшүндүрө алат; бирок авторлор бул бүт айырманы түшүндүрбөй турганын белгилешет.
Промпт сезимталдыгы
LLM чыгышы колдонулган промпт түзүмүнө сезимтал. Бул изилдөөдө промпттар роль аныктамасы, көрсөтмө, контекст, кайталоо, синтез жана изилдөө суроолоруна багыттоо сыяктуу элементтер менен итеративдүү түрдө такталган.
Ошондуктан жыйынтыктарды “ChatGPTнин табигый жана өзгөрбөс коддоо жүрүм-туруму” деп чечмелөө туура эмес. Ар башка промпт түзүмдөрү башка код системаларын түзүшү мүмкүн. Изилдөө муну келечектеги изилдөөлөр үчүн ачык изилдөө багыты катары калтырат.
Негизги чектөөлөр
Кичине жана темага мүнөздүү маалымат топтому: Изилдөө болгону 11 интервьюга жана география сабагындагы стереотиптештирүү сыяктуу чечмелөө жагынан сезимтал бир гана темага негизделген. Чоңураак жана ар башка дисциплиналардагы маалымат топтомдорунда ошол эле үлгүлөр пайда болобу же жокпу белгисиз.
Промпт сезимталдыгы: Деталдаштырылган жана кайталанган промпт инженериясы колдонулганына карабастан, альтернативдүү промпттар башка категория түзүмдөрүн жаратышы мүмкүн.
Дал келтирүү ыкмасына көз карандылык: Hungarian Algorithm кайра чыгарууга мүмкүн болгон бирден-бирге дал келтирүүнү камсыз кылат; бирок башка дал келтирүү ыкмалары башка код жуптарын салыштырып, жыйынтыктарды белгилүү деңгээлде өзгөртүшү мүмкүн.
Сапаттык талдоонун чечмелөөчү табияты: Бир эле материалдан илимий жактан негиздөөгө боло турган бир нече код системасы чыгышы мүмкүн. Ошондуктан адам системасы менен ChatGPT системасынын айырмасы өзү эле “ChatGPT катасы” катары окулбашы керек.
LLMдин ички процессин байкоого мүмкүн эместиги: Изилдөө моделдин категория синтездөө процессин ичтен көзөмөлдөй албайт. Коддор кайсы аралык чечимдер чынжыры аркылуу кең же тар болуп калганы толук түшүндүрүлбөйт.
Тармакка мүнөздүү контекст: Бул маалымат топтомунда адам системасы география билими менен түз байланышкан майда коддорду түзгөн. Мунун бардык тармактарда ушундай болору изилдөөдө текшерилген эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: Evaluation of Inductive Coding with LLMs
Авторлор: Leoni Dörfel, Rieke Ammoneit.
Авторлордун тартиби: Булактагы тартип так сакталган.
Тең салым: Булакта тең биринчи авторлук же тең салым тууралуу билдирүү жок.
Жооптуу автор: Leoni Dörfel.
Мекеме: Department for Mathematics and Science Education, Institute for Geography Education, University of Cologne, Gronewaldstraße 2, 50931 Cologne, Germany.
Журнал: Education Sciences.
Басма: MDPI.
Том / сан / макала номери: 16(8), 1314.
DOI: 10.3390/educsci16081314.
Расмий DOI шилтемеси: https://doi.org/10.3390/educsci16081314
Тапшырылган: 14 июль 2026.
Кайра каралган: 7 август 2026.
Кабыл алынган: 13 август 2026.
Жарыяланган: 17 август 2026.
Булак түрү: Рецензияланган изилдөө макаласы. Методологиялык жактан сапаттык мазмундук талдоону, LLM колдогон индуктивдүү коддоону, NLP негизиндеги семантикалык талдоону, коддоо-бирдигинин дал келүү талдоосун, тармактык талдоону жана сапаттык салыштырууну бириктирген аралаш ыкмалуу методологиялык баалоо.
Лицензия: Creative Commons Attribution (CC BY).
Каржылоо: Изилдөө тышкы каржылоо алган эмес.
Институционалдык этика билдирүүсү: Изилдөө мурда чогултулган жана толугу менен анонимдештирилген интервью транскрипттерин кайра талдайт. Булак учурдагы талдоодо жеке адамды аныктоочу маалымат жок экенин жана кайра идентификациялоо мүмкүн эместигин билдирет.
Маалымдалган макулдук: Баштапкы интервьюларга катышкан бардык катышуучулардан маалымдалган макулдук алынган.
Маалыматтардын жеткиликтүүлүгү: Маалыматтар, R скрипттери жана талдоолордун чийки маалыматтары Zenodoдо жарыяланган. Маалымат DOIси: 10.5281/zenodo.21108082.
Жасалма интеллект колдонуу билдирүүсү: Авторлор изилдөө учурунда сапаттык коддоо чыгыштарын түзүү үчүн ChatGPTнин булакта “GPT-5.2, 11 December 2025 snapshot” деп көрсөтүлгөн версиясын колдонушкан. Жасалма интеллект чыгыштары изилдөөчүлөр тарабынан сын көз менен каралып, текшерилип жана чечмеленгени; жарыянын мазмуну үчүн жоопкерчилик авторлорго таандык экени айтылган.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышын билдиришкен эмес.
Авторлордун салымдары: Концептуалдаштыруу Leoni Dörfel жана Rieke Ammoneit; ыкма Leoni Dörfel жана Rieke Ammoneit; программалык камсыздоо Leoni Dörfel; валидация Leoni Dörfel; формалдык талдоо Leoni Dörfel; маалыматтарды куроо Leoni Dörfel; алгачкы долбоор Leoni Dörfel; визуалдаштыруу Leoni Dörfel; жетекчилик Rieke Ammoneit; долбоорду башкаруу Leoni Dörfel.
Колдонулган негизги техникалык куралдар: noScribe 0.4.1, MAXQDA Analytics Pro 24.4.0, булакта көрсөтүлгөн ChatGPT-5.2 11 декабрь 2025 snapshot, SBERT paraphrase-multilingual-MiniLM-L12-v2, Hungarian Algorithm, Jaccard Index, R, igraph, vegan Curveball null модели жана ggplot2.
Булак ичиндеги карама-каршылык 1: 7-таблицада эң жогорку код-жуп Jaccard мааниси 0,86; талкуу бөлүмүндө болсо жогорку дал келүү диапазонунун жогорку чеги 0,89 деп жазылган. Verianla так маани катары таблицаны сактайт.
Булак ичиндеги карама-каршылык 2: Жыйынтык тексти калган беш төмөн дал келүүчү код жупту J<0,14 деп сүрөттөйт, бирок 7-таблицада Eurocentrism–Perspective shift жубу так 0,14.
Булак ичиндеги карама-каршылык 3: Кошумча таблица A1 стратегия коддорун 3.8ден 3.10го өткөрөт; 3.9 коду көрсөтүлбөйт. Verianla жетишпеген номердин мазмунун божомолдобойт.
Булак ичиндеги аталыш айырмасы: Адам коддорунун бири 6-таблицада “Evidence-based learning”, 7-таблицада жана Кошумча таблица A1де “Evidence-based working” деп көрсөтүлгөн. Ошо сыяктуу, ChatGPTнин “Didactic reduction and time pressure” коду 7-таблицада “Complexity reduction and time pressure” деп жазылган. Бул айырмачылыктар жаңы коддор катары чечмеленген эмес.
Изилдөө суроосунун айтылышына байланыштуу булак чеги: Метод бөлүмүндөгү баштапкы интервью маалыматтары эки мазмундук изилдөө суроосунун айланасында уюштурулган. Булактын айрым жыйынтык/корутунду сүйлөмдөрү үч негизги ChatGPT коду “RQ1–3” менен байланыштуу экенин айтат; бирок макаланын үч методологиялык RQсу коддордун мазмундук тармактарын эмес, эки коддоо системасын салыштырууну сурайт. Verianla бул билдирүүнү үч өзүнчө баштапкы интервью изилдөө суроосу бардай кеңейтпейт.
Негизги чечмелөө чеги: Изилдөөнүн табылгалары белгилүү интервью маалымат топтому, белгилүү ChatGPT snapshotы, белгилүү промпт протоколу жана белгилүү салыштыруу ыкмалары шартында алынган. Жыйынтыктар бардык LLMдердин же бардык сапаттык изилдөө контексттеринин жалпы натыйжалуулук өлчөмү эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген