

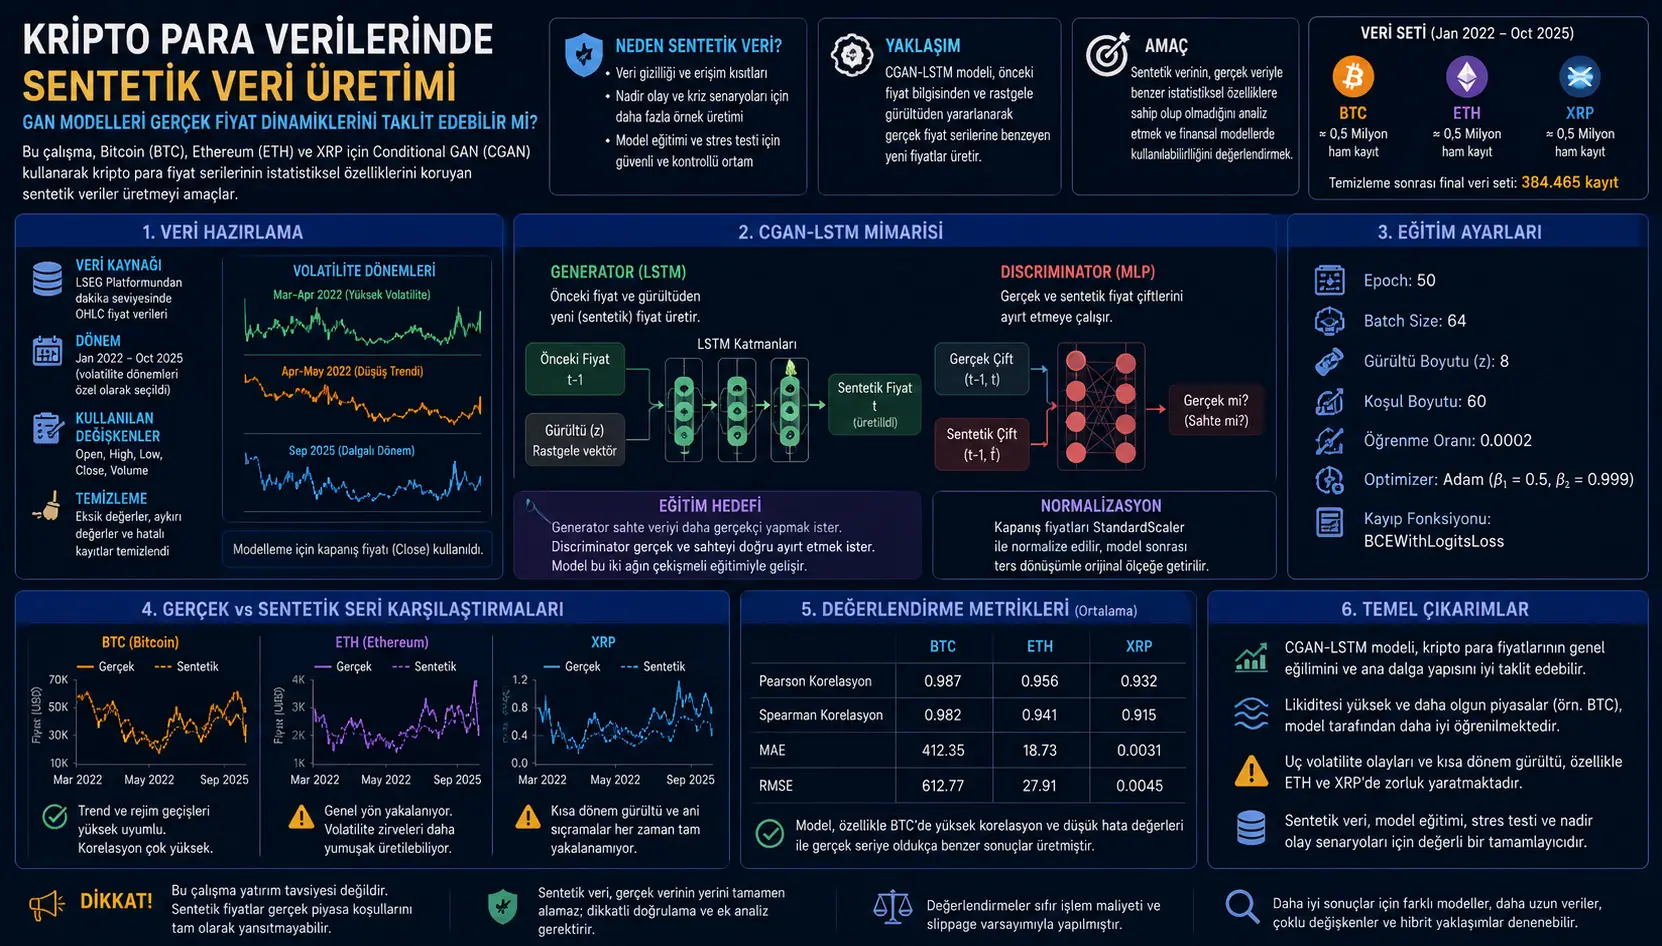
Finansal yapay zekâ modellerinin eğitilebilmesi için kaliteli, uzun ve güvenilir veri gerekir. Ancak finans alanında gerçek veriye erişim her zaman mümkün değildir. Kurumlar işlem kayıtlarını paylaşmak istemeyebilir, kullanıcı gizliliği korunmak zorundadır veya nadir görülen anomali örnekleri model eğitimi için yetersiz kalabilir. Bu nedenle sentetik veri üretimi, finansal modelleme için önemli bir araştırma alanı hâline gelmiştir.
Bu çalışma, kripto para fiyat zaman serilerinde sentetik veri üretmek için Conditional Generative Adversarial Network yani koşullu üretici çekişmeli ağ yaklaşımını kullanıyor. Modelde generator tarafında LSTM tipi tekrar eden ağ, discriminator tarafında ise MLP yapısı yer alıyor. Amaç, önceki fiyat bilgisinden ve gürültüden yararlanarak gerçek fiyat serilerine istatistiksel olarak benzeyen yeni kapanış fiyatları üretmektir.
Deneyler BTC, ETH ve XRP üzerinde yapılmıştır. Veri Ocak 2022–Ekim 2025 dönemini kapsayan daha geniş bir aralıktan alınmış; özellikle Mart–Nisan 2022, Nisan–Mayıs 2022 ve Eylül 2025 gibi yüksek oynaklık dönemleri incelenmiştir. Sonuçlar, modelin özellikle BTC gibi daha likit ve olgun piyasalarda fiyat eğilimini oldukça iyi taklit ettiğini, ETH ve XRP gibi daha gürültülü veya dış olaylara duyarlı varlıklarda ise bazı volatilite zirvelerini yumuşatma eğiliminde olduğunu göstermektedir.
Problem Ne?
Finansal veriler, yapay zekâ modelleri için çok değerlidir; fakat bu veriler çoğu zaman hassastır. Bankacılık, ödeme sistemleri, kripto işlemleri, dolandırıcılık tespiti ve kara para aklama analizi gibi alanlarda gerçek işlem kayıtlarının paylaşılması mahremiyet, regülasyon ve stratejik gizlilik nedeniyle sınırlanabilir.
Bu durum model geliştirmeyi zorlaştırır. Eğer yeterli gerçek veri yoksa, nadir görülen anomali veya kriz dönemleri az temsil edilir. Model yalnızca normal dönemleri öğrenir ve olağan dışı piyasa hareketlerinde zayıf kalabilir. Sentetik veri üretimi bu noktada devreye girer: Gerçek verinin istatistiksel özelliklerini koruyan ama birebir gerçek kayıt olmayan yeni örnekler üretmek, hem araştırma hem model testleri için faydalı olabilir.
Kripto para piyasaları bu problem için uygun bir test alanıdır. Çünkü yüksek volatilite, ani rejim değişimleri, dış olaylara hassasiyet ve sürekli işlem akışı barındırır. Ancak tam da bu özellikler nedeniyle modelleme zordur. Üretici model yalnızca fiyatın genel yönünü değil, zaman içindeki dalgalanmayı, ani sıçramaları ve kriz dönemlerindeki farklı davranış biçimlerini de yakalamaya çalışmalıdır.
Yöntem Ne Öneriyor?
Çalışma, kripto para kapanış fiyatlarından sentetik zaman serisi üretmek için Conditional GAN mimarisi öneriyor. Bu mimaride iki ana ağ birlikte eğitilir:
Generator: LSTM tipi bir ağdır. Önceki fiyat bilgisini ve gürültü sinyalini kullanarak mevcut fiyatın sentetik karşılığını üretmeye çalışır. LSTM tercihinin nedeni, finansal fiyat serilerinin sıralı ve zamana bağlı olmasıdır.
Discriminator: MLP tabanlı bir sınıflandırıcıdır. Kendisine verilen fiyat çiftinin gerçek veriden mi yoksa generator tarafından mı üretildiğini ayırt etmeye çalışır.
Modelin mantığı adversarial yani çekişmeli öğrenmeye dayanır. Generator daha gerçekçi sentetik fiyat üretmeye çalışırken, discriminator gerçek ve sentetik örnekleri ayırt etmeye çalışır. Eğitim ilerledikçe generator, discriminator’ı kandırabilecek kadar gerçekçi örnekler üretmeyi öğrenir.
Veri işleme tarafında kapanış fiyatları StandardScaler ile normalize edilir. Model eğitildikten sonra ters dönüşüm uygulanarak sentetik fiyatlar orijinal ölçeğe geri çevrilir. Bu sayede sonuçlar ekonomik olarak yorumlanabilir hâle gelir.
Formüller Ne Anlatıyor?
PDF’te yapay sinir ağları, RNN/LSTM, GAN hedef fonksiyonu, StandardScaler ve kayıp fonksiyonu için temel formüller bulunuyor. Aşağıdaki formüller, makaledeki notasyona mümkün olduğunca sadık kalınarak MathJax uyumlu biçimde verilmiştir.
1. Yapay sinir ağında bir düğümün çıktısı
Bu formül, klasik bir yapay sinir ağı düğümünün nasıl çalıştığını gösterir. Önce önceki düğümlerden gelen çıktılar ağırlıklarla çarpılıp toplanır; sonra aktivasyon fonksiyonu uygulanarak yeni çıktı üretilir. Burada \(w_{i,j}\), \(i\) düğümünden \(j\) düğümüne giden ağırlığı; \(g_j\), aktivasyon fonksiyonunu; \(in_j\), ağırlıklı toplam girdiyi temsil eder.
2. RNN’de zaman bağımlılığı
RNN, geçmiş durum \(z_{t-1}\) ile mevcut girdi \(x_t\)’yi birlikte kullanarak yeni durum \(z_t\)’yi üretir. Bu yapı, zaman serilerinde geçmiş bilginin bugünkü çıktıyı etkilemesini sağlar. Kripto fiyat serileri zamana bağlı olduğu için RNN ve LSTM gibi yapılar bu tür verilerde sık kullanılır.
3. LSTM kapıları
LSTM, klasik RNN’in uzun dönem bağımlılıkları öğrenme zorluğunu azaltmak için kapı mekanizmaları kullanır. \(f_t\) unutma kapısı, \(i_t\) giriş kapısı, \(o_t\) çıkış kapısıdır. \(c_t\), hücre belleğini; \(z_t\), kısa dönem çıktıyı temsil eder. Finansal serilerde geçmiş fiyat rejimlerinin etkisini korumak için bu bellek yapısı önemlidir.
4. GAN minimax oyunu
Bu formül, GAN eğitimini iki oyunculu bir oyun olarak tanımlar. Generator \(g\), discriminator \(d\)’yi kandırmaya çalışır; discriminator ise gerçek ve sahte örnekleri ayırmaya çalışır. Eğitimde amaç, generator’ın gerçek veri dağılımına benzeyen örnekler üretmesidir.
5. GAN değer fonksiyonu
Bu formül, discriminator’ın gerçek örnekleri gerçek, generator örneklerini sahte olarak ayırt etme başarısını ölçer. \(x\), gerçek veriden gelen örneği; \(z\), generator’a verilen gürültüyü; \(g(z)\), üretilmiş örneği; \(d(x)\), discriminator’ın gerçeklik olasılığını gösterir.
6. StandardScaler normalizasyonu
Bu formül, fiyat verisinin nasıl standartlaştırıldığını gösterir. \(x\) orijinal gözlem, \(\mu\) serinin ortalaması, \(\sigma\) standart sapmasıdır. Böylece veriler ortalaması sıfır, varyansı bir olacak şekilde ölçeklenir. Bu işlem, GAN ve LSTM gibi gradyan tabanlı modellerde eğitimi daha kararlı hâle getirebilir.
7. Koşullu fiyat çifti yapısı
Çalışmada veri, önceki fiyat ile mevcut fiyat arasında koşullu çiftler hâlinde düzenlenir. Generator, önceki fiyat bilgisini koşul olarak kullanarak mevcut fiyatın sentetik karşılığını üretmeye çalışır. Discriminator ise bu çiftin gerçek mi yoksa sentetik mi olduğunu sınıflandırır.
8. Binary cross-entropy kaybı
Bu kayıp fonksiyonu, discriminator’ın gerçek/sahte sınıflandırma hatasını ölçmek için kullanılır. \(y=1\) gerçek örneği, \(y=0\) sentetik örneği gösterir. Model çıktısı \(x\), sigmoid fonksiyonuyla olasılığa dönüştürülür.
9. Sigmoid fonksiyonu
Sigmoid fonksiyonu, model çıktısını 0 ile 1 arasında bir olasılık değerine dönüştürür. Çalışmada BCEWithLogitsLoss kullanıldığı için sigmoid ve binary cross-entropy işlemleri sayısal olarak daha kararlı tek bir yapı içinde uygulanır.
10. Discriminator kaybı
Discriminator hem gerçek örnekler hem de generator tarafından üretilen sahte örnekler üzerinde eğitilir. Toplam discriminator kaybı bu iki kaybın ortalamasıdır.
Grafik, Tablo ve Şema Ana Mesajı
Sayfa 4’teki ANN/RNN/LSTM şeması: Şema, klasik yapay sinir ağı, RNN ve LSTM yapılarını yan yana gösteriyor. Ana mesaj, sıradan ağların tekil girdi-çıktı ilişkilerine odaklanırken, RNN ve LSTM’nin zaman bağımlılığını saklayabilmesidir. Bu nedenle LSTM, kripto fiyat serileri gibi sıralı veriler için daha uygundur.
Sayfa 6’daki metodolojik akış şeması: Çalışmanın iş akışı veri çıkarma, veri işleme, model analizi, CGAN-LSTM modelinin kurulması, volatilite dönemlerinin seçilmesi, normalizasyon, GAN literatürü incelemesi ve sonuç analizinden oluşuyor. Bu şema, çalışmanın yalnızca model eğitimi değil, veri seçimi ve volatilite dönemlerinin ayrıştırılması üzerine de kurulduğunu gösteriyor.
Sayfa 7’deki kripto para evrimi grafikleri: BTC, ETH ve XRP’nin 2022–2025 arasındaki fiyat ve değişim dinamikleri gösteriliyor. Ana mesaj, kripto varlıkların farklı dönemlerde sert fiyat hareketleri ve yüksek oynaklık sergilediğidir. Bu nedenle sentetik veri üretiminde yalnızca ortalama fiyat eğilimini değil, volatilite davranışını da yakalamak gerekir.
Sayfa 8’deki volatilite dönemleri grafiği: Üç farklı dönem karşılaştırılıyor. Mart–Nisan 2022 döneminde yüksek frekanslı dalgalanmalar görülüyor. Nisan–Mayıs 2022 döneminde daha yönlü ve sert düşüşler öne çıkıyor. Eylül 2025 döneminde ise oynaklık daha sınırlı olsa da hâlâ ani sıçramalar mevcut. Bu grafiklerin ana mesajı, her volatilite döneminin aynı karakterde olmadığıdır.
Sayfa 9’daki CGAN-LSTM mimari şeması: Generator tarafında LSTM, önceki fiyat ve gürültüden sentetik fiyat üretir. Discriminator ise gerçek ve sahte fiyat çiftlerini ayırt etmeye çalışır. Ana mesaj, modelin yalnızca rastgele fiyat üretmediği; önceki fiyatı koşul olarak kullanarak zaman bağımlılığı kurduğudur.
Sayfa 11–13’teki eğitim kaybı grafikleri: BTC, ETH ve XRP için generator ve discriminator kayıpları gösteriliyor. Grafiklerde eğitim sürecinin ilk dönemlerde hızlı değiştiği, ardından daha kararlı bir seviyeye oturduğu görülüyor. Bu, adversarial eğitimin belirli bir dengeye yaklaştığını düşündürür.
Sayfa 14’teki gerçek-sentetik dağılım grafikleri: BTC, ETH ve XRP için gerçek ve üretilmiş değerlerin dağılımı neredeyse doğrusal çizgi üzerinde toplanıyor. Bu, modelin fiyat seviyelerini oldukça yakın ürettiğini gösterir. Ancak yüksek korelasyon tek başına uç olayların ve dağılım kuyruklarının tam yakalandığı anlamına gelmez.
Sayfa 15–20’deki gerçek ve üretilmiş seri karşılaştırmaları: Grafiklerde gerçek fiyat serisi ile sentetik seri çoğu dönemde birbirine çok yakın ilerliyor. BTC’de genel trend ve rejim geçişleri daha iyi korunurken, ETH ve XRP’de bazı ani zirve veya kısa dönem gürültülerin daha yumuşak üretildiği görülüyor. Ana mesaj, modelin genel fiyat eğilimini iyi yakaladığı; fakat volatilite uçlarını her varlıkta aynı güçle üretmediğidir.
Deneyler Nasıl Yapılmış?
Çalışma BTC, ETH ve XRP için dakika düzeyinde fiyat verileri kullanıyor. Genel dönem Ocak 2022–Ekim 2025 olarak belirtiliyor; deneylerde özellikle üç yüksek oynaklık dönemi seçiliyor: Mart–Nisan 2022, Nisan–Mayıs 2022 ve Eylül 2025.
Veri LSEG Platform’dan alınmıştır. Ham veri yaklaşık 0,5 milyon kayıt içermektedir. Temizleme ve kalite kontrollerinden sonra final veri seti 384.465 kayda indiriliyor. Kullanılan değişkenler period, open, high, low ve close olarak veriliyor; modelleme tarafında özellikle kapanış fiyatı üzerinde çalışılıyor.
Her kripto varlık ve dönem için model ayrı ayrı eğitiliyor. Eğitimde 50 epoch kullanılıyor. Algorithm 1’de verilen ayarlara göre gürültü boyutu 8, koşul boyutu 60, batch size 64, öğrenme oranı 0.0002, Adam parametreleri \(\beta_1=0.5\), \(\beta_2=0.999\) olarak seçiliyor.
Model önce kapanış fiyatlarını StandardScaler ile normalize ediyor. Daha sonra eğitim çiftleri oluşturuluyor: koşul olarak \(t-1\) fiyatı, gerçek veri olarak \(t\) fiyatı kullanılıyor. Generator sentetik \(t\) fiyatı üretirken, discriminator gerçek ve sentetik çiftleri ayırmaya çalışıyor.
Sonuçların değerlendirilmesinde Pearson korelasyonu, Spearman korelasyonu, MAE, RMSE ve grafiksel karşılaştırma kullanılıyor. Bu metrikler, sentetik serinin gerçek seriyle ne kadar benzer hareket ettiğini anlamaya yardımcı oluyor.
Sonuçlar Ne Gösteriyor?
1. Model genel fiyat eğilimini iyi taklit ediyor. Grafiksel karşılaştırmalarda sentetik seri, gerçek fiyat serisinin genel yönünü ve ana dalga yapısını büyük ölçüde takip ediyor. Özellikle BTC’de trend geçişleri ve orta-uzun dönem desenler daha iyi korunmuş görünüyor.
2. BTC’de uyum en güçlü görünüyor. BTC için raporlanan Pearson ve Spearman korelasyonları oldukça yüksektir. Çalışma bunu Bitcoin piyasasının daha likit, olgun ve görece daha istikrarlı istatistiksel desenlere sahip olmasıyla ilişkilendiriyor.
3. ETH’de genel yön yakalansa da volatilite zirveleri yumuşayabiliyor. ETH için model fiyat hareketinin ana yönünü takip edebiliyor; ancak bazı ani volatilite tepelerinde üretilen seri daha düşük amplitüd gösterebiliyor. Bu durum GAN modellerinde uç olayları ve ağır kuyrukları üretmenin zorluğuyla uyumludur.
4. XRP’de kısa dönem gürültü daha belirgin sorun yaratıyor. XRP sonuçlarında bazı aralıklarda iyi yerel uyum görülse de kısa dönem gürültüye duyarlılık daha yüksektir. Makale bunu XRP’nin dış olaylara, regülasyon haberlerine ve kurumsal gelişmelere daha duyarlı olabileceği şeklinde yorumluyor.
5. StandardScaler seçimi eğitim kararlılığına katkı sağlıyor. Finansal seriler uç değerler ve yüksek oynaklık içerdiği için ölçekleme kritik önemdedir. StandardScaler, gradyan patlaması veya kaybolması riskini azaltarak GAN-LSTM eğitimini daha kararlı hâle getirebilir.
6. BCEWithLogitsLoss sayısal kararlılık sağlıyor. Çalışmada sigmoid ve binary cross-entropy ayrı ayrı uygulanmak yerine BCEWithLogitsLoss kullanılıyor. Bu tercih, discriminator’ın aşırı güvenli çıktılarında oluşabilecek sayısal kararsızlıkları azaltabilir.
Bu Neden Önemli?
Sentetik finansal veri üretimi, yalnızca akademik bir veri çoğaltma yöntemi değildir. Doğru kullanıldığında gizlilik koruma, model dayanıklılığı, stres testi, anomali tespiti ve nadir senaryo simülasyonu için yararlı olabilir. Özellikle finansal kurumlar gerçek işlem verilerini paylaşmak istemediğinde, gerçek veriye benzeyen fakat birebir gerçek kayıt olmayan sentetik veriler araştırmayı kolaylaştırabilir.
Kripto piyasaları bu açıdan öğretici bir test ortamı sunar. Çünkü yüksek volatilite ve ani rejim değişimleri, üretici modellerin yalnızca ortalama fiyat düzeyini değil, zaman içindeki dinamikleri de öğrenmesini gerektirir. Bu çalışma, basit ama hedefli bir CGAN-LSTM mimarisinin bu dinamikleri belirli ölçüde yakalayabildiğini gösteriyor.
Ancak sonuçlar aynı zamanda önemli bir uyarı içeriyor: Yüksek korelasyon, sentetik verinin her açıdan gerçek veriyle eşdeğer olduğu anlamına gelmez. Özellikle uç olaylar, nadir kriz davranışları, ani likidite boşlukları ve dış haber kaynaklı fiyat sıçramaları sentetik veride daha zayıf temsil edilebilir. Bu nedenle sentetik veri, gerçek verinin yerine sorgusuzca konmamalı; kontrollü yardımcı veri olarak değerlendirilmelidir.
Dikkat Noktaları
1. Bu çalışma yatırım tavsiyesi değildir. Sentetik fiyat üretimi, canlı piyasa tahmini veya al-sat önerisi anlamına gelmez.
2. Preprint niteliğindedir. Bulgular hakemli nihai sürüm kesinliğiyle okunmamalıdır.
3. Sentetik veri gerçek verinin tam ikamesi değildir. Model genel fiyat desenlerini yakalayabilir; ancak uç olayları, likidite krizlerini ve dış haber etkilerini eksik temsil edebilir.
4. Yüksek korelasyon tek başına yeterli kalite kanıtı değildir. Finansal zaman serilerinde volatilite kümelenmesi, ağır kuyruklar, drawdown davranışı ve rejim geçişleri ayrıca değerlendirilmelidir.
5. Model yalnızca kapanış fiyatına odaklanıyor. OHLC verisi mevcut olsa da modelleme ağırlıklı olarak kapanış fiyatı üzerinden yürütülüyor. Hacim, order book, on-chain veri veya haber sinyalleri modele dahil edilmemiştir.
6. Dış olaylar sentetik üretimi zorlaştırır. ETH güncellemeleri, XRP regülasyon haberleri veya makroekonomik şoklar gibi dış faktörler yalnızca geçmiş fiyat dizisinden tam öğrenilemeyebilir.
7. Mode collapse ve aşırı yumuşatma riski vardır. GAN modelleri bazı durumlarda çeşitliliği azaltabilir veya aşırı düzgün seriler üretebilir. Bu nedenle sentetik veri üretiminde görsel kontrol kadar dağılımsal testler de gerekir.
Riskli alan notu: Çalışma kripto para fiyat verileriyle ilgilidir. Bu yazı yatırım tavsiyesi değildir. Burada anlatılan yöntemler Bitcoin, Ethereum veya XRP için fiyat tahmini, al-sat stratejisi ya da kesin piyasa yönü çıkarımı olarak yorumlanmamalıdır. Makale, sentetik finansal veri üretimi ve modelleme açısından değerlendirilmelidir.
Genel değerlendirme: Makale, gerçek finansal verilerin her zaman kolay erişilebilir veya paylaşılabilir olmamasından yola çıkıyor. Özellikle finansal işlemler, kurum içi kayıtlar, anomali tespiti ve dolandırıcılık analizi gibi alanlarda veri gizliliği, erişim kısıtları ve dengesiz sınıf dağılımları önemli sorunlar yaratabilir. Çalışma, bu soruna kripto para fiyat zaman serileri üzerinden Conditional GAN tabanlı sentetik veri üretimiyle yaklaşır.
Sonuç
Bu çalışma, kripto para fiyat serilerinde CGAN-LSTM mimarisiyle sentetik veri üretmenin mümkün ve öğretici bir yaklaşım olabileceğini gösteriyor. Generator’ın LSTM yapısı, önceki fiyat bilgisinden zaman bağımlılığı kurarken; discriminator gerçek ve sentetik fiyat çiftlerini ayırt etmeye çalışıyor. Bu çekişmeli eğitim, gerçek seriye benzeyen yeni fiyat dizileri üretmeyi hedefliyor.
Deneyler, modelin özellikle BTC gibi daha likit ve olgun piyasalarda güçlü uyum verdiğini; ETH ve XRP gibi daha yüksek yapısal oynaklık ve dış olay hassasiyeti taşıyan varlıklarda ise bazı sınırlılıklar gösterdiğini ortaya koyuyor. Bu sonuç, sentetik finansal veri üretiminde varlık bazlı farklılıkların önemli olduğunu gösterir.
Verianla okuru için ana mesaj şudur: Sentetik veri üretimi, finansal yapay zekâda önemli bir yardımcı araç olabilir; fakat üretilen verinin gerçek piyasa davranışını hangi yönlerden koruduğu ve hangi yönlerden yumuşattığı dikkatle incelenmelidir. GAN modeli gerçek fiyat çizgisini taklit edebilir, ama finansal risk analizi için asıl kritik olan uç olayları ve rejim değişimlerini ne kadar koruduğudur.
Kaynak ve Yöntem Notu
Bu yazı, “Synthetic Data in Cryptocurrencies Using Generative Models” başlıklı akademik PDF temel alınarak hazırlanmış özgün Türkçe editoryal içeriktir. Metin birebir çeviri değildir; çalışmadaki problem, yöntem, formüller, veri seti, grafikler, sonuçlar ve sınırlılıklar sadeleştirilerek anlatılmıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir