

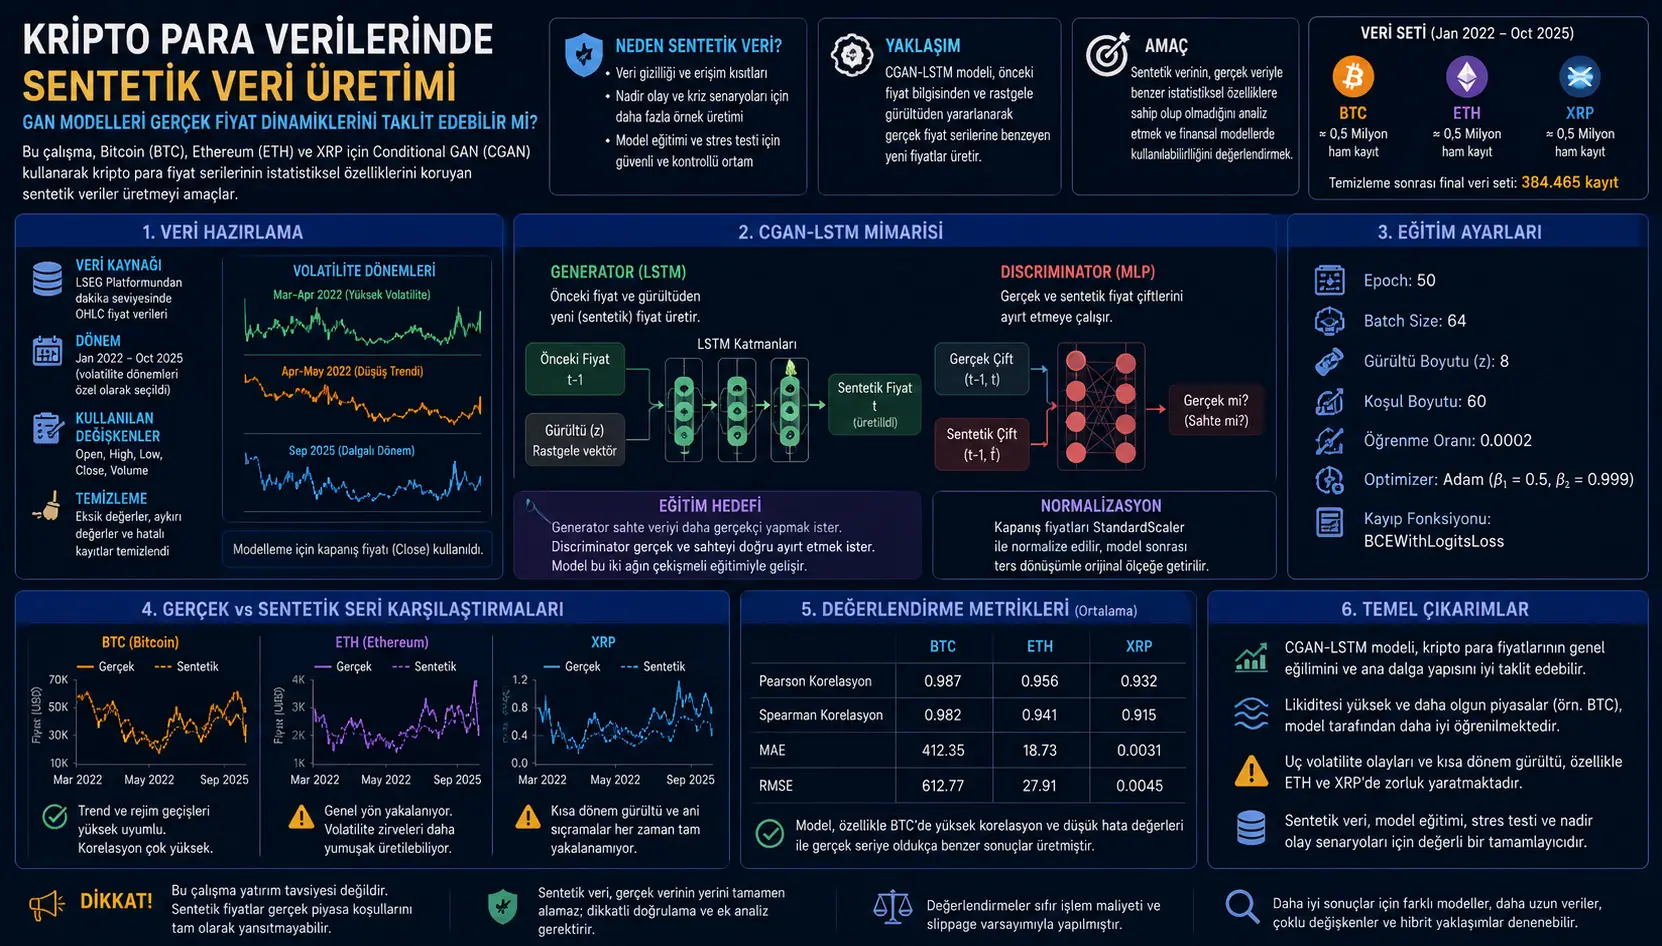
Data ya ubora, ndefu na inayotegemewa inahitajika ili kufunza miundo ya kijasusi ya kifedha. Hata hivyo, kupata data halisi katika uwanja wa fedha si mara zote inawezekana. Huenda taasisi zisitake kushiriki rekodi za miamala, faragha ya mtumiaji lazima ilindwe, au sampuli za hitilafu nadra zinaweza kuwa hazitoshi kwa mafunzo ya kielelezo. Kwa hivyo, uzalishaji wa data ya syntetisk imekuwa eneo muhimu la utafiti kwa uundaji wa kifedha.
Utafiti huu unatumia mkabala wa Mtandao wa Masharti ya Kuzalisha Masharti ili kutoa data sanisi katika mfululizo wa muda wa bei ya cryptocurrency. Katika mfano, kuna mtandao wa kawaida wa aina ya LSTM kwenye upande wa jenereta na muundo wa MLP kwa upande wa kibaguzi. Lengo ni kuzalisha bei mpya za kufunga ambazo kitakwimu zinafanana na mfululizo wa bei halisi kwa kuchukua faida ya maelezo ya bei ya awali na kelele.
Majaribio yalifanyika kwenye BTC, ETH na XRP. Data ilichukuliwa kutoka masafa mapana zaidi ya kipindi cha Januari 2022–Oktoba 2025; Hasa, vipindi vya juu vya tetemeko kama vile Machi–Aprili 2022, Aprili–Mei 2022 na Septemba 2025 vilichunguzwa. Matokeo yanaonyesha kuwa muundo huu unaiga mwelekeo wa bei vizuri kabisa, hasa katika masoko ya majimaji na ya watu wazima zaidi kama vile BTC, huku inaelekea kulainisha baadhi ya vilele vya tete katika vipengee ambavyo vina kelele au nyeti kwa matukio ya nje kama vile ETH na XRP.
Tatizo ni nini?
Data ya fedha ni ya thamani sana kwa mifano ya AI; lakini data hii mara nyingi ni nyeti. Kushiriki rekodi halisi za miamala katika maeneo kama vile benki, mifumo ya malipo, miamala ya crypto, kugundua ulaghai na uchanganuzi wa ufujaji wa pesa kunaweza kuwa mdogo kwa sababu ya faragha, udhibiti na usiri wa kimkakati.
Hii inafanya maendeleo ya mfano kuwa magumu. Ikiwa hakuna data halisi ya kutosha, hitilafu nadra au vipindi vya shida vitawakilishwa kidogo. Mfano hujifunza tu kuhusu vipindi vya kawaida na inaweza kuwa dhaifu wakati wa harakati zisizo za kawaida za soko. Hapa ndipo uundaji wa data sanisi unapohusika: Kuzalisha sampuli mpya zinazohifadhi sifa za takwimu za data halisi lakini si rekodi halisi kunaweza kuwa muhimu kwa utafiti na majaribio ya modeli.
Masoko ya Cryptocurrency ni uwanja unaofaa wa majaribio kwa tatizo hili. Kwa sababu inahusisha tete ya juu, mabadiliko ya ghafla ya utawala, unyeti kwa matukio ya nje na mtiririko wa shughuli unaoendelea. Hata hivyo, hasa kwa sababu ya vipengele hivi, modeli ni vigumu. Mtindo wa uzalishaji unapaswa kujaribu kukamata sio tu mwelekeo wa jumla wa bei, lakini pia mabadiliko ya wakati, kuruka kwa ghafla, na mifumo tofauti ya tabia wakati wa shida.
Je, Njia Inapendekeza Nini?
Utafiti unapendekeza usanifu wa Masharti wa GAN ili kuzalisha mfululizo wa saa wa syntetisk kutoka kwa bei za kufunga za cryptocurrency. Katika usanifu huu, mitandao miwili kuu imefunzwa pamoja:
Jenereta: Ni mtandao wa aina ya LSTM. Inajaribu kuzalisha sawa ya synthetic ya bei ya sasa kwa kutumia maelezo ya awali ya bei na ishara ya kelele. Sababu ya kuchagua LSTM ni kwamba mfululizo wa bei za kifedha ni mfuatano na unategemea wakati.
Mbaguzi: Ni kiainishaji cha msingi wa MLP. Inajaribu kutofautisha ikiwa jozi ya bei iliyopewa ni kutoka kwa data halisi au iliyotolewa na jenereta.
Mantiki ya mfano inategemea kujifunza kwa wapinzani. Wakati jenereta inajaribu kutoa bei ya uhalisia zaidi ya sintetiki, kibaguzi hujaribu kutofautisha kati ya sampuli halisi na za sintetiki. Mafunzo yanapoendelea, jenereta hujifunza kutoa mifano ambayo ni ya kweli ya kutosha kumpumbaza mbaguzi.
Kwa upande wa usindikaji wa data, bei za kufunga zinasawazishwa na StandardScaler. Pindi tu muundo unapofunzwa, ubadilishaji kinyume hutumika kubadilisha bei ya sintetiki kurudi kwenye kiwango cha asili. Kwa njia hii, matokeo yanatafsiriwa kiuchumi.
Je! Mifumo Inasemaje?
PDF ina fomula za kimsingi za mitandao ya neva bandia, RNN/LSTM, utendaji wa lengo la GAN, StandardScaler na utendaji wa hasara. Fomula zilizo hapa chini zimetolewa katika umbizo linalooana na MathJax, zikiambatana na nukuu katika makala kadri inavyowezekana.
1. Pato la nodi katika mtandao wa neva wa bandia
Bu formül, klasik bir yapay sinir ağı düğümünün nasıl çalıştığını gösterir. Önce önceki düğümlerden gelen çıktılar ağırlıklarla çarpılıp toplanır; sonra aktivasyon fonksiyonu uygulanarak yeni çıktı üretilir. Burada \(w_{i,j}\), \(i\) düğümünden \(j\) düğümüne giden ağırlığı; \(g_j\), aktivasyon fonksiyonunu; \(in_j\), ağırlıklı toplam girdiyi temsil eder.
2. Utegemezi wa wakati katika RNN
RNN inazalisha hali mpya \(z_t\) kwa kutumia hali iliyopita \(z_{t-1}\) na ingizo la sasa \(x_t\). Muundo huu unahakikisha kuwa maelezo ya awali katika mfululizo wa saa huathiri matokeo ya leo. Kwa kuwa mfululizo wa bei za crypto hutegemea wakati, miundo kama vile RNN na LSTM hutumiwa mara kwa mara katika aina hii ya data.
3. Milango ya LSTM
LSTM hutumia mifumo ya lango ili kupunguza ugumu wa RNN ya zamani katika kujifunza utegemezi wa muda mrefu. \(f_t\) ni mlango wa kusahau, \(i_t\) ni mlango wa kuingilia, \(o_t\) ni mlango wa kutokea. \(c_t\), kumbukumbu ya seli; \(z_t\) inawakilisha matokeo ya muda mfupi. Muundo huu wa kumbukumbu ni muhimu ili kuhifadhi athari za kanuni za bei zilizopita katika mfululizo wa kifedha.
4. GAN minimax mchezo
Fomula hii inaelezea mafunzo ya GAN kama mchezo wa wachezaji wawili. Jenereta \(g\) inajaribu kumpumbaza mbaguzi \(d\); Mbaguzi anajaribu kutenganisha sampuli halisi na bandia. Lengo la mafunzo ni jenereta kutoa sampuli zinazofanana na usambazaji halisi wa data.
5. Kitendakazi cha thamani cha GAN
Fomula hii hupima mafanikio ya kibaguzi katika kutofautisha sampuli halisi kutoka kwa sampuli halisi na sampuli za jenereta na zile bandia. \(x\), sampuli kutoka kwa data halisi; \(z\) ni kelele inayotolewa kwa jenereta; \(g(z)\), sampuli iliyotolewa; \(d(x)\) inaonyesha uwezekano wa ukweli wa kibaguzi.
6. Urekebishaji wa kiwango cha kawaida
Fomula hii inaonyesha jinsi data ya bei inavyosawazishwa. \(x\) ni uchunguzi wa asili, \(\mu\) ndio maana ya mfululizo, \(\sigma\) ni mkengeuko wa kawaida. Kwa hivyo, data imepimwa ili kuwa na maana ya sifuri na tofauti ya moja. Mchakato huu unaweza kufanya mafunzo kuwa thabiti zaidi katika miundo inayotegemea gradient kama vile GAN na LSTM.
7. Muundo wa jozi wa bei ya masharti
Katika utafiti, data imepangwa katika jozi za masharti kati ya bei ya awali na bei ya sasa. Jenereta hujaribu kuzalisha sawa na bei ya sasa kwa kutumia maelezo ya bei ya awali kama sharti. Kibaguzi huainisha iwapo jozi hii ni halisi au ya sintetiki.
8. Binary cross-entropy hasara
Chaguo hili la kukokotoa la upotevu hutumika kupima hitilafu halisi ya uainishaji/uongo wa kibaguzi. \(y=1\) inawakilisha sampuli halisi, \(y=0\) inawakilisha sampuli ya sintetiki. Toleo la modeli \(x\) hubadilishwa kuwa uwezekano na chaguo za kukokotoa za sigmoid.
9. Kazi ya Sigmoid
Chaguo za kukokotoa za sigmoid hubadilisha pato la modeli kuwa thamani ya uwezekano kati ya 0 na 1. Kwa kuwa BCEWithLogitsLoss inatumiwa katika utafiti, shughuli za sigmoid na binary cross-entropy zinatekelezwa katika muundo mmoja, thabiti zaidi kiidadi.
10. Hasara ya kibaguzi
Kibaguzi hufunzwa juu ya sampuli halisi na sampuli bandia zinazozalishwa na jenereta. Jumla ya hasara ya kibaguzi ni wastani wa hasara hizi mbili.
Ujumbe Mkuu wa Grafu, Jedwali na Mchoro
Mchoro wa ANN/RNN/LSTM kwenye ukurasa wa 4: Mchoro unaonyesha mtandao wa kawaida wa neva, miundo ya RNN na LSTM kando. Ujumbe mkuu ni kwamba wakati mitandao ya kawaida inazingatia uhusiano wa pembejeo-pato moja, RNN na LSTM zinaweza kuficha utegemezi wa wakati. Kwa hivyo, LSTM inafaa zaidi kwa data mfuatano kama vile mfululizo wa bei ya crypto.
Mtiririko wa kimbinu kwenye ukurasa wa 6: Mtiririko wa kazi wa utafiti una uchimbaji wa data, usindikaji wa data, uchanganuzi wa kielelezo, uanzishwaji wa modeli ya CGAN-LSTM, uteuzi wa vipindi tete, urekebishaji, uhakiki wa fasihi ya GAN na uchanganuzi wa matokeo. Mchoro huu unaonyesha kwamba kazi inategemea sio tu juu ya mafunzo ya mfano, lakini pia juu ya uteuzi wa data na mgawanyiko wa vipindi vya tete.
Chati za mageuzi ya Cryptocurrency kwenye ukurasa wa 7: Mabadiliko ya bei na mabadiliko ya BTC, ETH na XRP kati ya 2022 na 2025 yanaonyeshwa. Ujumbe kuu ni kwamba mali za crypto zinaonyesha harakati za bei kali na tete ya juu katika vipindi tofauti. Kwa hiyo, katika uzalishaji wa data ya synthetic, ni muhimu kukamata sio tu mwenendo wa wastani wa bei lakini pia tabia ya tete.
Chati ya vipindi vya tete kwenye ukurasa wa 8: Vipindi vitatu tofauti vinalinganishwa. Mabadiliko ya masafa ya juu yanazingatiwa katika kipindi cha Machi–Aprili 2022. Upungufu zaidi wa mwelekeo na mkali huonekana katika kipindi cha Aprili-Mei 2022. Ingawa tete ni mdogo zaidi katika kipindi cha Septemba 2025, bado kuna miruko ya ghafla. Ujumbe kuu wa chati hizi ni kwamba si kila kipindi cha tete kina tabia sawa.
Mchoro wa usanifu wa CGAN-LSTM kwenye ukurasa wa 9: Kwa upande wa jenereta, LSTM huzalisha bei ya sintetiki kutoka kwa bei ya awali na kelele. Mbaguzi anajaribu kutofautisha jozi za bei halisi na bandia. Ujumbe kuu ni kwamba mtindo hautoi tu bei za nasibu; ni kwamba inaanzisha utegemezi wa wakati kwa kutumia bei ya awali kama hali.
Grafu za upotezaji wa mafunzo kwenye ukurasa wa 11-13: Hasara za jenereta na kibaguzi zinaonyeshwa kwa BTC, ETH na XRP. Grafu zinaonyesha kuwa mchakato wa elimu ulibadilika haraka katika vipindi vya kwanza na kisha ukatulia katika kiwango thabiti zaidi. Hii inaonyesha kwamba mafunzo ya wapinzani yanakaribia usawa fulani.
Viwanja halisi vya usambazaji kwenye ukurasa wa 14: Usambazaji wa maadili halisi na yaliyotengenezwa kwa BTC, ETH na XRP ni karibu sawa. Hii inaonyesha kuwa mtindo hutoa viwango vya bei karibu kabisa. Hata hivyo, uwiano wa juu pekee haimaanishi kuwa matukio makubwa na mikia ya usambazaji imekamatwa kikamilifu.
Ulinganisho wa mfululizo halisi na uliotengenezwa kwenye ukurasa wa 15-20: Katika chati, mfululizo wa bei halisi na mfululizo wa sintetiki husogea karibu sana katika vipindi vingi. Wakati mwelekeo wa jumla na mabadiliko ya serikali yamehifadhiwa vyema katika BTC, baadhi ya kilele cha ghafla au kelele za muda mfupi zinaonekana kuzalishwa kwa urahisi zaidi katika ETH na XRP. Ujumbe kuu ni kwamba mtindo unakamata mwenendo wa bei ya jumla vizuri; Lakini uhakika ni kwamba haitoi hali tete kwa nguvu sawa katika kila mali.
Majaribio Yalifanywaje?
Utafiti unatumia data ya bei ya kiwango cha dakika kwa BTC, ETH, na XRP. Kipindi cha jumla kinatajwa kama Januari 2022–Oktoba 2025; Hasa, vipindi vitatu vya tete ya juu vimechaguliwa katika majaribio: Machi–Aprili 2022, Aprili–Mei 2022 na Septemba 2025.
Data iliyochukuliwa kutoka kwa LSEG Platform. Data ghafi ina takriban rekodi milioni 0.5. Baada ya kusafisha na ukaguzi wa ubora, seti ya mwisho ya data imepunguzwa hadi rekodi 384,465. Vigezo vinavyotumiwa vinatolewa kama kipindi, wazi, cha juu, cha chini na cha karibu; Kwa upande wa modeling, hasa bei ya kufunga inafanyiwa kazi.
Muundo huo umefunzwa kando kwa kila mali na kipindi cha crypto. Epoch 50 hutumiwa katika mafunzo. Kwa mujibu wa mipangilio iliyotolewa katika Algorithm 1, ukubwa wa kelele ni 8, ukubwa wa hali ni 60, ukubwa wa kundi ni 64, kiwango cha kujifunza ni 0.0002, na vigezo vya Adam vinachaguliwa kama \(\beta_1=0.5\), \(\beta_2=0.999\).
Mtindo kwanza hurekebisha bei za kufunga na StandardScaler. Kisha jozi za mafunzo huundwa: bei \(t-1\) inatumika kama hali, bei \(t\) inatumika kama data halisi. Wakati jenereta inazalisha bei ya synthetic \(t\), kibaguzi hujaribu kutenganisha jozi halisi na za syntetisk.
Uwiano wa Pearson, uunganisho wa Spearman, MAE, RMSE na ulinganisho wa picha hutumiwa kutathmini matokeo. Vipimo hivi husaidia kuelewa jinsi mfululizo wa sanisi unavyofanana na mfululizo halisi.
Je! Matokeo Yanaonyesha Nini?
Mfano wa 1 unaiga mwenendo wa bei ya jumla vizuri. Grafiksel karşılaştırmalarda sentetik seri, gerçek fiyat serisinin genel yönünü ve ana dalga yapısını büyük ölçüde takip ediyor. Özellikle BTC’de trend geçişleri ve orta-uzun dönem desenler daha iyi korunmuş görünüyor.
2. Urekebishaji unaonekana kuwa na nguvu zaidi katika BTC. Mahusiano ya Pearson na Spearman yaliyoripotiwa kwa BTC ni ya juu sana. Utafiti huo unahusisha hii na ukweli kwamba soko la Bitcoin ni kioevu zaidi, limekomaa na lina mifumo thabiti zaidi ya takwimu.
3. Ingawa mwelekeo wa jumla unapatikana katika ETH, vilele vya tete vinaweza kupungua. Kwa ETH, mfano huo unaweza kufuata mwelekeo kuu wa harakati za bei; Hata hivyo, mfululizo unaozalishwa wakati wa vilele vya tete vya ghafla unaweza kuonyesha amplitude ya chini. Hii inalingana na ugumu wa kuzalisha matukio makali na mikia mizito katika miundo ya GAN.
4. Kelele ya muda mfupi hujenga tatizo la wazi zaidi katika XRP. Ingawa matokeo ya XRP yanaonyesha makubaliano mazuri ya ndani katika safu kadhaa, usikivu kwa kelele ya muda mfupi ni kubwa zaidi. Kifungu kinafasiri hii kumaanisha kuwa XRP inaweza kuwa nyeti zaidi kwa matukio ya nje, habari za udhibiti na maendeleo ya shirika.
5. Kuchagua StandardScaler inachangia utulivu wa mafunzo. Kuongeza ni muhimu kwa sababu mfululizo wa fedha una thamani kubwa na tete ya juu. StandardScaler inaweza kufanya mafunzo ya GAN-LSTM kuwa thabiti zaidi kwa kupunguza hatari ya mlipuko wa upinde rangi au kutoweka.
6. BCEWithLogitsLoss hutoa utulivu wa nambari. Katika utafiti, BCEWithLogitsLoss inatumika badala ya kutumia sigmoid na binary cross-entropy kando. Chaguo hili linaweza kupunguza uthabiti wa nambari ambao unaweza kutokea katika matokeo ya kujiamini kupita kiasi ya kibaguzi.
Kwa Nini Hili Ni Muhimu?
Uzalishaji wa data ya kifedha ya syntetisk sio tu mbinu ya kitaaluma ya urudufishaji wa data. Inapotumiwa kwa usahihi, inaweza kuwa muhimu kwa ulinzi wa faragha, uimara wa mfano, kupima mfadhaiko, utambuzi wa hitilafu na uigaji wa matukio nadra. Hasa wakati taasisi za fedha hazitaki kushiriki data halisi ya shughuli, data ya syntetisk ambayo inafanana na data halisi lakini si rekodi halisi inaweza kuwezesha utafiti.
Kripto piyasaları bu açıdan öğretici bir test ortamı sunar. Çünkü yüksek volatilite ve ani rejim değişimleri, üretici modellerin yalnızca ortalama fiyat düzeyini değil, zaman içindeki dinamikleri de öğrenmesini gerektirir. Bu çalışma, basit ama hedefli bir CGAN-LSTM mimarisinin bu dinamikleri belirli ölçüde yakalayabildiğini gösteriyor.
Lakini matokeo pia yana tahadhari muhimu: Uunganisho wa juu haimaanishi kuwa data ya syntetisk ni sawa na data halisi katika kila jambo. Hasa, matukio ya hali ya juu, tabia nadra za shida, mapungufu ya ghafla ya ukwasi na kuruka kwa bei kunakosababishwa na habari za kigeni kunaweza kuwakilishwa vyema katika data sanisi. Kwa sababu hii, data ya syntetisk haipaswi kubadilishwa kwa data halisi bila swali; Inapaswa kuzingatiwa kama data inayodhibitiwa.
Pointi za Tahadhari
1. Utafiti huu sio ushauri wa uwekezaji. Uzalishaji wa bei ya usanifu haujumuishi ubashiri wa soko la moja kwa moja au pendekezo la kununua au kuuza.
2. Ni maandishi ya awali. Matokeo hayapaswi kusomwa kwa ukali wa toleo la mwisho lililopitiwa na marika.
3. Data ya syntetisk sio kibadala kabisa cha data halisi. Mfano huo unaweza kukamata mifumo ya bei ya jumla; hata hivyo, inaweza kuwasilisha matukio mabaya sana, migogoro ya ukwasi na athari za habari za kigeni.
4. Uwiano wa juu pekee sio ushahidi wa kutosha wa ubora. Nguzo tete, mikia mizito, tabia ya kupunguza kasi na mabadiliko ya utawala lazima pia yatathminiwe katika mfululizo wa muda wa kifedha.
5. Mfano huo unazingatia tu bei ya kufunga. Ingawa data ya OHLC inapatikana, uundaji wa muundo unafanywa hasa kwa bei ya kufunga. Kiasi, kitabu cha agizo, data ya mtandaoni au ishara za habari hazijajumuishwa kwenye muundo.
6. Matukio ya nje hufanya uzalishaji wa syntetisk kuwa mgumu. Mambo ya nje kama vile masasisho ya ETH, habari za udhibiti wa XRP au majanga ya kiuchumi yanaweza yasijulikane kikamilifu kutokana na mfululizo wa bei za kihistoria pekee.
7. Kuna hatari ya kuanguka kwa mode na kulainisha zaidi. Miundo ya GAN inaweza kupunguza utofauti au kutoa mfululizo laini kupita kiasi katika baadhi ya matukio. Kwa hiyo, vipimo vya usambazaji pamoja na udhibiti wa kuona vinahitajika katika uzalishaji wa data ya synthetic.
Kumbuka eneo la hatari: Utafiti unahusu data ya bei ya cryptocurrency. Nakala hii sio ushauri wa uwekezaji. Mbinu zilizoelezewa hapa hazipaswi kufasiriwa kama utabiri wa bei, mkakati wa kuuza, au makisio mahususi ya mwelekeo wa soko kwa Bitcoin, Ethereum, au XRP. Makala yanapaswa kutathminiwa kulingana na uzalishaji na uundaji wa data ya kifedha ya kisanii.
Ukadiriaji wa jumla: Kifungu kinaanza kutokana na ukweli kwamba data halisi ya kifedha haipatikani kwa urahisi au kushirikiwa kila wakati. Usiri wa data, vizuizi vya ufikiaji na usambazaji wa darasa usio na uwiano unaweza kuleta matatizo makubwa, hasa katika maeneo kama vile miamala ya kifedha, rekodi za ndani, utambuzi wa hitilafu na uchanganuzi wa ulaghai. Utafiti unashughulikia tatizo hili kwa kuzalisha data ya syntetisk yenye Masharti ya GAN juu ya mfululizo wa muda wa bei ya cryptocurrency.
Hitimisho
Utafiti huu unaonyesha kwamba kuzalisha data ya syntetisk na usanifu wa CGAN-LSTM katika mfululizo wa bei ya cryptocurrency inaweza kuwa mbinu inayowezekana na ya kufundisha. Wakati muundo wa LSTM wa Jenereta huanzisha utegemezi wa wakati kutoka kwa habari ya bei ya hapo awali; Mbaguzi anajaribu kutofautisha kati ya jozi za bei halisi na sintetiki. Mafunzo haya ya wapinzani yanalenga kutoa mfululizo mpya wa bei unaofanana na mfululizo halisi.
Majaribio yanaonyesha kuwa mtindo huo unafaa sana, haswa katika masoko ya majimaji na ya kukomaa zaidi kama vile BTC; Inaonyesha kuwa mali zilizo na tete ya juu ya muundo na unyeti wa matukio ya nje, kama vile ETH na XRP, zinaonyesha mapungufu. Matokeo haya yanaonyesha kuwa tofauti zinazotegemea mali ni muhimu katika utayarishaji wa data sanisi za kifedha.
Ujumbe mkuu kwa msomaji wa Verianla ni huu: Uzalishaji wa data ya syntetisk inaweza kuwa chombo muhimu kisaidizi katika AI ya kifedha; Hata hivyo, vipengele ambavyo data inayotolewa hulinda na kulainisha tabia halisi ya soko vinapaswa kuchunguzwa kwa makini. Muundo wa GAN unaweza kuiga mstari wa bei halisi, lakini kilicho muhimu kwa uchanganuzi wa hatari za kifedha ni jinsi unavyolinda dhidi ya matukio mabaya na mabadiliko ya serikali.
Kaynak ve Yöntem Notu
Makala haya ni maudhui halisi ya uhariri wa Kituruki kulingana na PDF ya kitaaluma yenye jina la "Data Sinifu katika Fedha za Crypto Kwa Kutumia Miundo ya Kuzalisha". Maandishi si tafsiri halisi; Tatizo, mbinu, fomula, seti ya data, michoro, matokeo na mapungufu katika utafiti yamefafanuliwa kwa njia iliyorahisishwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *