

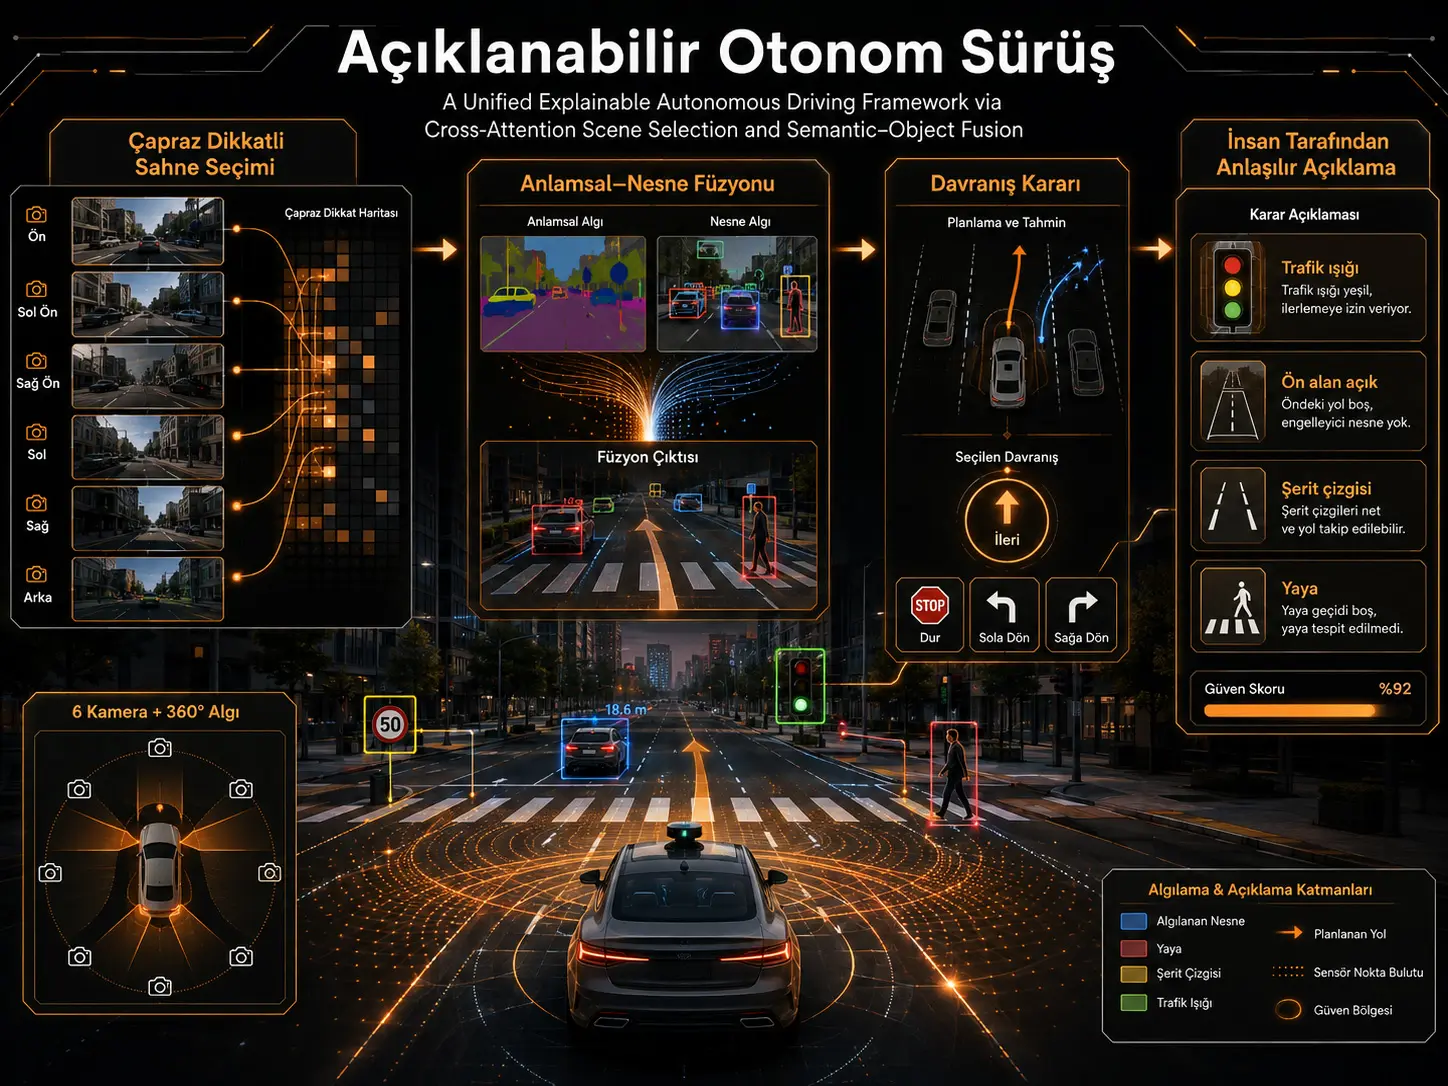
Bu araştırma, bir otonom sürüş modelinin yalnız “ileri git”, “dur”, “sola dön” veya “sağa dön” gibi davranış kararları üretmesini değil, aynı görsel temsil üzerinden bu kararlarla ilişkili insan tarafından yorumlanabilir nedenleri de tahmin etmesini amaçlamaktadır. CrossAD adı verilen sistem, Swin Transformer tabanlı ortak bir görsel kodlayıcıyı; sahne düzeyindeki anlamı çıkaran Object Selection Module (OSM), sınıftan bağımsız yerel nesne token'larını koruyan Object-Token Extractor (OTE) ve bu iki bilgi türünü birleştiren Semantic–Object Fusion (SOF) modülüyle birleştirmektedir. BDD-OIA benchmark'ında CrossAD yorumlama tarafında \(F1_m=0,417\) ve \(F1_{all}=0,584\) ile karşılaştırılan yöntemler arasındaki en yüksek değerleri bildirirken, nu-AD'de davranış için \(0,848/0,887\), yorumlama için \(0,909/0,919\) değerlerine ulaşmıştır. Bununla birlikte sonuçlar çevrimdışı benchmark değerlendirmeleridir; sistem gerçek araçta kapalı çevrim sürüş güvenliği veya saha performansı açısından doğrulanmamıştır.
CrossAD'ın temel mimari fikri, “sahnenin genel olarak ne anlattığı” ile “kararı etkileyebilecek belirli yerel nesne veya bölgelerin ne olduğu” bilgisini aynı temsil içinde eritmeden önce ayrı tutmaktır. OSM, yol görüntüsündeki bütün görsel token'ların aynı derecede önemli olmadığını varsayarak bunları puanlar ve en bilgilendirici alt kümeyi çapraz dikkat ile sahne düzeyindeki tek bir anlamsal vektöre dönüştürür. OTE ise aynı Swin-T token dizisinden ayrı bir skorlayıcı kullanarak sekiz yerel token seçer. Bu token'ların trafik ışığı, öndeki araç veya bisikletli gibi anlamlı nesnelere karşılık gelmesi için ayrıca kutu veya segmentasyon etiketi verilmez; seçim davranış ve yorumlama görevlerinin ortak eğitim hedefinden öğrenilir.
Davranış ve açıklama kolları sistemde aynı girdiyi kullansa da son karar aşamasında aynı özellik vektörünü okumaz. Davranış başlığı, OSM'den gelen anlamsal vektör ile OTE'den gelen yerel token'ların çapraz dikkat yoluyla birleştirilmiş temsilini kullanır. Yorumlama başlığı ise bir skip connection aracılığıyla OSM'nin sahne düzeyindeki anlamsal vektörünü doğrudan kullanır. Araştırmacılar bu asimetrik yönlendirmeyi, davranış kararının belirli yerel nesnelerden; açıklama etiketlerinin ise daha genel sahne durumundan farklı düzeylerde yararlanması fikrine dayandırmaktadır.
Altı kameralı nu-AD kullanımında kameraların yalnız bir araya getirilmesi yeterli değildir. Çalışmanın ablasyonunda altı kameranın token'larını kamera kimliğini korumadan ortalamak, tek ön kamera kullanımından bile daha düşük sonuç üretmiştir. Yazarlar bunun ön-sol ile arka-sol gibi uzamsal olarak benzer fakat anlam olarak farklı görüşlerin ağ tarafından ayırt edilememesiyle ilişkili olduğunu değerlendirmektedir. Bu nedenle her kameraya yalnız 768 boyutlu öğrenilebilir bir kimlik vektörü eklenmiş; altı kamera için toplam ek yük 4608 parametre olmuştur.
Doğal dil açıklaması tarafında önemli bir sınır vardır. LoRA ile uyarlanan TinyLlama-1.1B, kameranın ham görüntüsünü doğrudan okuyarak serbest bir gerekçe üretmemektedir. Model, CrossAD tarafından önceden tahmin edilen davranış ve yorum etiketleriyle koşullandırılmaktadır. Dolayısıyla çalışma, üretilen cümlenin yapılandırılmış karar çıktısıyla ne kadar tutarlı olduğunu test etmektedir; dil modelinin kararın görsel nedenini nedensel biçimde keşfettiğini göstermemektedir.
Türkiye açısından çalışma, otonom araç araştırmalarında yalnız karar doğruluğuna değil, modelin hangi sahne durumunu karar gerekçesi olarak raporladığına da ayrı bir çıktı olarak bakılabileceğini gösteren bir mimari örnektir. Ancak bu benchmark sonuçlarının Türkiye'deki yol geometrisi, trafik işaretleri, sürücü davranışları, hava koşulları veya gerçek araç sensör düzeni için geçerli olduğu mevcut araştırmadan çıkarılamaz. Böyle bir kullanım için yerel veri üzerinde yeniden eğitim, bağımsız doğrulama ve gerçek araç testleri gerekir.
CrossAD hangi problemi çözmeye çalışıyor?
Otonom sürüşte bir modelin doğru eylemi tahmin etmesi tek başına modelin neden o kararı verdiğini göstermez. Çalışmanın ele aldığı problem bu ayrımdır: aynı model hem sürüş davranışını hem de bu davranışla ilişkili insan tarafından anlaşılabilir sahne nedenlerini birlikte üretebilir mi?
Araştırmacılar üç yaygın yaklaşımın sınırlılığından hareket etmektedir. Birincisi, önce nesne algılama veya segmentasyon yapıp sonra bu çıktıyı doğal dile dönüştüren çok aşamalı sistemlerde erken algılama hataları sonraki açıklamaya taşınabilir. İkincisi, Grad-CAM benzeri sonradan oluşturulan önem haritaları bir piksel bölgesinin önemli olduğunu gösterebilse de “neden önemli olduğunu” semantik bir cümleyle açıklamayabilir. Üçüncüsü, karar ve açıklama ayrı ağlardan geldiğinde açıklamanın davranış kararında kullanılan kanıtla aynı kanıta dayandığı garanti edilemez.
CrossAD bu nedenle davranış tahmini ile yorum etiketlerini ortak Swin-T görsel kodlayıcıdan üretmektedir.
Model hangi davranışları tahmin ediyor?
Her iki benchmark da dört davranış etiketi kullanmaktadır:
- Forward — ileri hareket,
- Stop — durma veya yavaşlama,
- Left — sola dönüş,
- Right — sağa dönüş.
Bu görev klasik tek sınıflı sınıflandırma değildir. Bir sahnede birden fazla davranış etiketi aynı anda etkin olabildiği için davranış ve yorum başlıklarının ikisinde de sigmoid aktivasyonu kullanılmıştır.
BDD-OIA'da ayrıca 21 yorum etiketi, nu-AD'de 8 yorum etiketi bulunmaktadır. BDD-OIA daha çok trafik işareti, şerit çizgisi veya engel gibi kavramsal nedenlere; nu-AD ise ön, ön-sol, arka-sol gibi çevresel alanların açıklığına ve trafik ışığı durumuna odaklanan uzamsal yorumlara sahiptir.
Görsel kodlayıcı ne yapıyor?
Ana görsel kodlayıcı ImageNet üzerinde önceden eğitilmiş Swin-T modelidir. 224 × 224 piksel tek görüntü, son aşamada 7 × 7 uzamsal özellik haritasına ve buradan:
\[ N=49 \]
uzamsal token'a dönüştürülmektedir. Her token'ın özellik boyutu:
\[ d=768 \]
olarak verilmiştir.
BDD-OIA'da dolayısıyla temel token dizisinin boyutu \(49\times768\), altı kamera kullanılan nu-AD'de ise altı kameradan gelen diziler birleştirildiğinde \(294\times768\)'dir.
Object Selection Module neden gerekli?
Bir sürüş görüntüsünün büyük kısmı gökyüzü, bina cephesi, tekdüze yol yüzeyi veya bitki örtüsü gibi karar açısından her zaman aynı ölçüde yararlı olmayan görsel bölgeler içerebilir. OSM'nin görevi, bütün token'ları eşit ağırlıkla özetlemek yerine karar açısından daha bilgilendirici token'ları seçmektir.
Önce her token'a yatay konum bilgisi eklenmektedir. 7 × 7 token ızgarasında token'ın yatay koordinatı:
\[ x_j\in[-1,1] \]
olarak ifade edilir ve öğrenilebilir bir doğrusal dönüşümle 768 boyutlu token uzayına taşınır:
\[ p_j=W_px_j+b_p \]
\[ \tilde z_j=z_j+p_j \]
Bu ek bilginin amacı özellikle sağ/sol yönlü sürüş kararlarında görsel kanıtın görüntünün hangi yatay bölgesinden geldiğini korumaktır.
Ardından her token:
\[ s_j=W_s\tilde z_j+b_s \]
ile skorlanır ve en yüksek puanlı token'lar korunur.
| Veri kümesi | Başlangıç token sayısı | OSM tarafından tutulan token |
|---|---|---|
| BDD-OIA | 49 | 16 |
| nu-AD | 294 | 64 |
OSM'nin pooled query tanımında kaynak içi farklılık var
Bölüm 3.3'teki Denklem (5), cross-attention sorgusunun bütün konum-bilgili token dizisinin ortalaması olduğunu belirtmektedir:
\[ q_{pool} = \frac{1}{N} \sum_{j=1}^{N}\tilde z_j \]
ve ardından:
\[ h_{sem} = MHA(q_{pool},Z_{top},Z_{top}) \]
işlemi uygulanmaktadır.
Buna karşılık makalenin Algorithm 1 bölümünün 4. adımı sorguyu:
qpool ← Mean(Ztop)
olarak tanımlar. Yani burada yalnız seçilmiş top-K token'ların ortalaması kullanılmaktadır. İki tanım aynı değildir. Kaynak gerçek uygulamanın hangisini kullandığını bu metin içinde açıkça uzlaştırmadığı için Verianla makalesi bu iki tanımdan birini sessizce “doğru” ilan etmemektedir.
Object-Token Extractor ne yapıyor?
OSM sahnenin genel semantik özetini üretirken OTE belirli yerel kanıtların kaybolmasını engellemeyi amaçlamaktadır. Aynı görsel token dizisi ayrı bir küçük MLP ile skorlanır:
\[ r_j=g(z_j) \]
ve en yüksek puanlı:
\[ K_{obj}=8 \]
token seçilir.
Seçilen token'lar doğrusal katman, GELU, dropout ve LayerNorm'dan geçirilerek nihai nesne-token kümesine dönüştürülür:
\[ O\in\mathbb{R}^{8\times768} \]
Buradaki “object” ifadesi klasik nesne algılayıcı anlamında kullanılmamalıdır. Modelin insan tarafından etiketlenmiş bounding box, sınıf adı veya segmentasyon maskesi yoktur. Token'ların neyi temsil edeceği davranış ve açıklama kayıplarından uçtan uca öğrenilmektedir.
Semantic–Object Fusion nasıl çalışıyor?
SOF modülünde anlamsal vektör sorgu, sekiz object token ise anahtar ve değer olarak kullanılır:
\[ a=MHA(h_{sem},O,O) \]
Ardından residual bağlantı ve LayerNorm uygulanır:
\[ u=LayerNorm(h_{sem}+a) \]
ve iki katmanlı feed-forward network sonrasında:
\[ h_{fuse} = LayerNorm(u+FFN(u)) \]
elde edilir.
Bu \(h_{fuse}\) vektörü davranış başlığının girdisidir.
Neden davranış ve yorum başlıkları farklı özellikleri okuyor?
Davranış başlığı:
\[ \hat B_i = \sigma(MLP_{beh}(h_{fuse})) \]
ile, yorumlama başlığı ise:
\[ \hat E_i = \sigma(MLP_{int}(h_{sem})) \]
ile hesaplanmaktadır.
Araştırmacıların hipotezi, yorum etiketlerinin “kırmızı ışık var”, “ön alan açık” veya “sağda düz çizgi var” gibi sahne seviyesindeki özelliklere daha uygun olması; davranış kararının ise sahne bağlamıyla birlikte belirli yerel nesnelerden yararlanmasıdır.
Bu nedenle yorumlama başlığı nesne füzyonundan geçirilmeden semantic vector'a doğrudan bağlanmaktadır.
Nesne token'larının birbirinin kopyası olması nasıl engelleniyor?
OTE'nin sekiz token'ının aynı görsel kanıtı tekrar tekrar seçmesini azaltmak amacıyla diversity regularizer kullanılmıştır. Satır bazında L2 normalize edilmiş token matrisi \(\tilde O\) için:
\[ L_{div} = \left\| \tilde O\tilde O^T-I_{K_{obj}} \right\|_F^2 \]
hesaplanmaktadır.
Toplam kayıp:
\[ L_{total} = \alpha L_{VB} + \beta L_{des} + \lambda L_{div} \]
ve kullanılan ağırlıklar:
\[ (\alpha,\beta,\lambda) = (0,5,\ 1,0,\ 0,005) \]
şeklindedir.
Davranış kaybında Forward, Stop, Left ve Right için sabit sınıf ağırlıkları:
\[ [1,0,\ 1,0,\ 2,0,\ 2,0] \]
olarak kullanılmış; böylece daha az temsil edilen dönüş sınıfları daha fazla ağırlıklandırılmıştır.
Altı kamera nasıl birleştiriliyor?
nu-AD'de altı kameranın her biri Swin-T tarafından ayrı ayrı işlenmektedir. Her kameraya 768 boyutlu öğrenilebilir bir kimlik embedding'i eklenir:
\[ T= Concat( Z^{(1)}+e_1,\ldots,Z^{(6)}+e_6 ) \]
Bu yöntem token boyutunu büyütmeden kamera kimliğini özelliklerin içine taşır.
Altı kamera için ek parametre sayısı:
\[ 6\times768=4608 \]
olduğu için görsel ağın büyüklüğüne kıyasla oldukça küçüktür.
Kamera kimliğinin gerçekten önemli olduğu gösterildi mi?
Ablasyon çalışması bu konuda güçlü fakat tamamen izole olmayan bir bulgu sağlamaktadır.
| Varyant | Yapı | Davranış F1m | Yorum F1m | Overall davranış F1 |
|---|---|---|---|---|
| V1 | Tek ön kamera | 0,825 | 0,862 | 0,851 |
| V2 | 6 kamera, token ortalama | 0,757 | 0,747 | 0,792 |
| V3 | 6 kamera + kamera embedding + cyclic LR | 0,838 | 0,905 | 0,877 |
| V4 | Tam model | 0,848 | 0,909 | 0,887 |
Altı kamerayı kimlik bilgisi olmadan birleştirmek V1'e göre davranış F1m'yi 0,825'ten 0,757'ye, yorum F1m'yi 0,862'den 0,747'ye düşürmüştür.
V3'te performans güçlü biçimde toparlanmaktadır. Ancak V3 aynı anda üç değişiklik içerir: kamera embedding, cyclic learning-rate ve farklı eğitim bütçesi. Araştırmacılar bu nedenle V2→V3 kazancının yalnız kamera embedding'ine ait izole bir nedensel etki olarak okunmaması gerektiğini açıkça belirtmektedir.
Additive kamera embedding mi, concatenation mı?
Ayrı bir karşılaştırmada kamera kimliğinin token'a eklenmesi ile kamera kimliğinin concatenation + projection yoluyla verilmesi karşılaştırılmıştır.
Additive yöntem yorumlama \(F1_m=0,909\), concatenation yöntemi ise \(0,908\) vermiştir. Performans neredeyse aynıyken concatenation yaklaşımı yaklaşık 0,59 milyon ek parametre gerektirmiş; additive embedding yalnız 4608 parametre eklemiştir.
BDD-OIA sonuçları ne gösteriyor?
| Yöntem | Davranış F1m | Davranış F1all | Yorum F1m | Yorum F1all |
|---|---|---|---|---|
| OIA | 0,718 | 0,734 | 0,208 | 0,422 |
| Inaction | 0,694 | 0,714 | 0,347 | 0,565 |
| NLE-DM | 0,723 | 0,733 | 0,312 | 0,517 |
| Interrelation | 0,701 | 0,722 | 0,335 | 0,537 |
| CrossAD | 0,716 | 0,739 | 0,417 | 0,584 |
CrossAD yorumlama tarafında iki metriğin de en yüksek değerini vermektedir. Davranış tarafında ise overall F1 en yüksek olmasına rağmen class-mean F1 değeri NLE-DM'den düşüktür.
Sol dönüş neden problemli?
BDD-OIA eğitim verisindeki davranış dağılımı:
| Davranış | Örnek sayısı | Frekans |
|---|---|---|
| Forward | 8734 | %54,3 |
| Stop | 7277 | %45,2 |
| Left | 1210 | %7,5 |
| Right | 10.660 | %66,3 |
Etiketlerin birbirini dışlamadığı unutulmamalıdır; yüzdelerin toplamının %100'ü aşması bu nedenle hata değildir.
CrossAD'ın sınıf F1 sonuçları:
| Sınıf | CrossAD F1 |
|---|---|
| Forward | 0,839 |
| Stop | 0,803 |
| Left | 0,580 |
| Right | 0,641 |
Sol dönüş, CrossAD'ın davranış ortalamasını aşağı çeken ana sınıftır. NLE-DM aynı sınıfta 0,651 raporlamaktadır.
nu-AD sonuçları ne gösteriyor?
Verianla Live: nu-AD üzerinde CrossAD ve önceki yöntemler
Tablo, çalışmanın nu-AD test split karşılaştırmasındaki dört aggregate F1 metriğini göstermektedir.
| Yöntem | Davranış F1m | Davranış F1all | Yorum F1m | Yorum F1all |
|---|---|---|---|---|
| OIA | 0,739 | 0,771 | 0,853 | 0,852 |
| NLE-DM | 0,760 | 0,836 | 0,882 | 0,879 |
| VB-CASeg | 0,767 | 0,844 | 0,907 | 0,903 |
| CrossAD | 0,848 | 0,887 | 0,909 | 0,919 |
Verianla Live: Değerler çalışmanın nu-AD test split karşılaştırmasından alınmıştır. Grafik motoru devre dışı kalsa bile bilimsel kaynak değerleri yukarıdaki tabloda korunur.
nu-AD'de CrossAD dört aggregate ölçütte de tablodaki en yüksek değere ulaşmaktadır. VB-CASeg'e göre davranış class-mean F1 kazancı 0,081; overall davranış F1 kazancı 0,043'tür. Yorumlama tarafındaki fark daha küçüktür: class-mean F1'de 0,002, overall F1'de 0,016.
OSM gerçekten trafikle ilgili alanlara mı bakıyor?
Çalışmanın OSM görselleştirmesinde 7 × 7 token grid'i üzerindeki dikkat ağırlıkları giriş görüntüsünün üzerine bindirilmiştir. Örnek sahnede daha yüksek ağırlıklar şerit işaretleri, yol yön okları ve aracın ileri sürüş koridoru üzerinde yoğunlaşırken, kenardaki binaların daha düşük ağırlık aldığı gösterilmektedir.
Bu görsel OSM'nin en azından sunulan örnekte görevle ilişkili bölgeleri öne çıkarabildiğini göstermektedir. Bununla birlikte tekil dikkat haritası, modelin tüm kararlarının nedensel açıklaması olarak yorumlanmamalıdır.
Doğal dil açıklaması nasıl üretiliyor?
Sistemde iki açıklama üretim yolu bulunmaktadır.
Birinci yol: deterministik kural motorudur. BDD-OIA için 47, nu-AD için 18 şablon bulunmaktadır. Aktif davranış ve neden etiketleri kurallar üzerinden okunarak denetlenebilir bir cümle oluşturulur.
İkinci yol: TinyLlama-1.1B modelinin Low-Rank Adaptation ile uyarlanmış sürümüdür.
LoRA parametreleri:
- rank \(r=2\),
- ölçek \(\alpha_{LoRA}=64\),
- yaklaşık 12.300 prompt–completion çifti,
- %90 eğitim / %10 doğrulama ayrımı.
Prompt, tahmin edilen davranış ve yorum vektörlerini içermektedir. Yani TinyLlama sahne görüntüsünü doğrudan görmez.
Verianla Live: Görüntüden davranış ve doğal dil açıklamasına CrossAD zinciri
Aşağıdaki süreç çalışmanın mimari ve inference açıklamalarında verilen ana adımları özetler.
| Aşama | İşlem | Çıktı / amaç |
|---|---|---|
| 1. Görsel kodlama | Tek kamera veya altı kamera görüntüsü Swin-T ile uzamsal token'lara dönüştürülür. | Ortak görsel özellik dizisi |
| 2. Sahne seçimi | OSM yatay konum bilgisini ekler, token'ları skorlar ve top-K sahne token'larını seçer. | Karar açısından önemli sahne alt kümesi |
| 3. Semantik özet | Cross-attention ile sahne düzeyindeki semantic vector üretilir. | hsem |
| 4. Yerel token seçimi | OTE aynı görsel token dizisinden ayrı bir skorlayıcıyla sekiz object token seçer. | O ∈ R8×768 |
| 5. Semantic–object fusion | Semantic vector sorgu, object token'lar anahtar/değer olarak çapraz dikkatle birleştirilir. | hfuse |
| 6. Davranış tahmini | Davranış başlığı fused representation'ı okur. | Forward / Stop / Left / Right olasılıkları |
| 7. Yorum tahmini | Yorum başlığı semantic vector'ı skip connection üzerinden doğrudan okur. | Çoklu insan-yorumlu neden etiketleri |
| 8. Dil üretimi | Tahmin edilen davranış ve yorum etiketleri kural motoruna veya LoRA-TinyLlama'ya verilir. | Doğal dil gerekçesi |
Verianla Live: Akış kaynak mimarisine dayanır. Dil üreticisinin ham görüntü token'larını doğrudan kullanmadığı özellikle korunmuştur.
Doğal dil açıklamaları ne kadar tutarlı?
BDD-OIA held-out test setinde \(n=4572\) örnek üzerinde üç temel kontrol raporlanmıştır:
| Kontrol ölçütü | Sonuç |
|---|---|
| Tahmin edilen davranışın cümlede belirtilmesi | %99,93 |
| Tahmin güvenine ilişkin sözcük kullanımı | %99,80 |
| En az bir sahne ipucuyla hizalanma | %92,11 |
Bu sonuçlar, dil üreticisinin model tarafından kendisine verilen yapılandırılmış çıktıları büyük oranda cümlede koruduğunu göstermektedir. Ancak bunlar açıklamanın gerçek dünyada doğru olduğunu veya görsel kanıta nedensel olarak bağlı olduğunu tek başına göstermez.
Karar doğru olduğunda açıklama daha mı iyi?
Araştırmacılar davranış vektörü tamamen doğru ve yanlış tahmin edilen örnekleri ayrı değerlendirmiştir.
| Alt küme | n | ROUGE-L | Sahne ipucu hizalanması |
|---|---|---|---|
| Davranış tahmini doğru | 1111 | 0,8016 | %92,64 |
| Davranış tahmini yanlış | 3461 | 0,6788 | %91,94 |
ROUGE-L farkı:
\[ 0,8016-0,6788=0,1228 \]
olarak raporlanmıştır.
Ayrıca aynı dil üreticisine tahmin edilen etiketler yerine gerçek etiketler verildiğinde ROUGE-L:
\[ 0,7087\rightarrow0,9226 \]
yükselmiş ve fark 0,2139 olmuştur.
Araştırmacılar bunu doğal dil üretim kalitesinin upstream davranış tahminiyle sınırlandığı yönünde yorumlamaktadır.
Bu “açıklama sadakati” tam olarak neyi kanıtlıyor?
Çalışmanın kendi ayrımı burada özellikle önemlidir. Dil üreticisi yapılandırılmış tahminlere koşullandırıldığı için davranış yanlış olduğunda yanlış davranışı tutarlı biçimde açıklayabilir. Bu, dil üreticisinin model kararına sadık olduğunu gösterebilir; fakat modelin kararı gerçekten doğru görsel nesne nedeniyle verdiğini kanıtlamaz.
Yazarlar bunu açıkça “decision-level faithfulness to the structured outputs” ile “causal grounding to the raw visual evidence” arasında ayırmaktadır.
Dolayısıyla mevcut çalışma şu iddiayı destekler:
“Dil üreticisi büyük ölçüde CrossAD'ın yapılandırılmış tahminlerine uygun gerekçe üretmektedir.”
Fakat şu daha güçlü iddiayı desteklemez:
“Üretilen cümle modelin ham görüntü üzerinde karar vermesine neden olan gerçek nedensel görsel kanıtı kanıtlamaktadır.”
Stres testlerinde ne oldu?
Çalışma 15 zorlu varyantı beş senaryo grubunda incelemiştir:
- sol dönüş,
- örtülme/occlusion,
- gece koşulu,
- karmaşık trafik işaretleri,
- çok nesneli sahneler.
| Senaryo | BDD-OIA güven | nu-AD güven | BDD-OIA entropi |
|---|---|---|---|
| Sol dönüş | 0,2878 ± 0,0267 | 0,2754 ± 0,0017 | 1,3747 ± 0,0103 |
| Occlusion | 0,2904 ± 0,0131 | 0,2580 ± 0,0014 | 1,3768 ± 0,0054 |
| Gece | 0,3109 ± 0,0160 | 0,2684 ± 0,0005 | 1,3689 ± 0,0063 |
| Karmaşık işaretler | 0,2771 ± 0,0000 | 0,2719 ± 0,0000 | 1,3835 ± 0,0000 |
| Çok nesneli | 0,3031 ± 0,0290 | 0,2641 ± 0,0043 | 1,3666 ± 0,0184 |
Dört sınıf için teorik maksimum entropi:
\[ \ln4\approx1,386 \]
olduğundan yaklaşık 1,37 düzeyindeki değerler bu örneklerde yüksek belirsizliğe işaret etmektedir. Kaynağın kendisi bu stres-test sonuçlarını popülasyon istatistiği değil, zorlu koşullardaki model davranışını teşhis eden sonuçlar olarak tanımlamaktadır.
Çalışmanın desteklediği sonuçlar
- Tek bir Swin-T görsel kodlayıcı üzerinden davranış ve insan-yorumlu neden etiketleri birlikte tahmin edilebilmiştir.
- OSM sahne düzeyindeki semantic representation'ı top-K token seçimi ve cross-attention ile üretmektedir.
- OTE bounding-box veya segmentasyon supervision olmadan sekiz class-agnostic object token seçmektedir.
- SOF semantic vector ile object token'ları çapraz dikkat üzerinden birleştirmektedir.
- BDD-OIA'da CrossAD karşılaştırılan yöntemler içinde en yüksek iki interpretation F1 metriğini bildirmiştir.
- nu-AD'de CrossAD karşılaştırılan yöntemler içinde dört aggregate davranış/yorumlama F1 metriğinin tamamında en yüksek sonucu bildirmiştir.
- nu-AD'de kamera kimliği korunmadan yapılan altı kamera token ortalaması performansı tek kameraya göre düşürmüştür.
- Additive kamera embedding çözümü concatenation alternatifine çok benzer doğrulukla çok daha az ek parametre kullanmıştır.
- LoRA-TinyLlama'nın ürettiği açıklamalar yapılandırılmış model çıktılarıyla yüksek oranda tutarlı bulunmuştur.
- Yanlış davranış tahminlerinde ROUGE-L'nin düşmesi dil üretiminin upstream tahmin doğruluğuyla sınırlı olduğunu desteklemiştir.
Çalışmanın desteklemediği veya henüz doğrulamadığı sonuçlar
- CrossAD gerçek araçta kapalı çevrim otonom sürüş testiyle doğrulanmamıştır.
- Benchmark F1 değerleri gerçek yol güvenliği oranı değildir.
- Modelin BDD-OIA ve nu-AD dışındaki veri kümelerinde aynı performansı göstereceği kanıtlanmamıştır.
- Türkiye yol ve trafik koşullarına doğrudan genellenebilirlik test edilmemiştir.
- Model uzun zaman dizilerini kullanmamaktadır; temel yapı tek kare veya aynı anda alınan kamera görüntülerine dayanır.
- Object token'lar denetimli nesne etiketleriyle adlandırılmış veya bounding-box düzeyinde doğrulanmış değildir.
- OSM attention görselleştirmesi tek başına nedensel açıklama kanıtı değildir.
- LoRA-TinyLlama ham görsel token'lara doğrudan koşullandırılmadığı için doğal dil çıktısının görsel nedensel sadakati kanıtlanmamıştır.
- V2→V3 ablasyon farkının tamamı yalnız kamera embedding mekanizmasına bağlanamaz.
- 27,4 milyonluk parametre değeri dondurulmuş TinyLlama-1.1B temel ağının bütün parametrelerini temsil etmez.
Çalışmanın Yöntemi ve Bulguları
Benchmark veri kümeleri
| Veri kümesi | Kaynak | Kamera | Davranış sınıfı | Yorum kategorisi |
|---|---|---|---|---|
| BDD-OIA | BDD100K | 1 | 4 | 21 |
| nu-AD | nuScenes | 6 | 4 | 8 |
CrossAD temel tensor boyutları
| Bileşen | BDD-OIA | nu-AD |
|---|---|---|
| Girdi | 3 × 224 × 224 | 6 × 3 × 224 × 224 |
| Swin-T token dizisi | 49 × 768 | 294 × 768 |
| OSM seçilmiş token | 16 × 768 | 64 × 768 |
| Semantic vector | 768 | 768 |
| Object token | 8 × 768 | 8 × 768 |
| Fused representation | 768 | 768 |
| Davranış çıktısı | 4 | 4 |
| Yorum çıktısı | 21 | 8 |
Eğitim ortamı ve optimizasyon
| Parametre | Kaynakta verilen ayar |
|---|---|
| Framework | PyTorch 2.7.1 |
| CUDA | 11.8 |
| GPU | NVIDIA RTX 3080 Ti |
| Eğitim görüntüsü | 256 × 256 yeniden boyutlandırma → rastgele 224 × 224 crop |
| Inference | Deterministik center crop |
| Optimizer | AdamW |
| Weight decay | 10⁻⁴ |
| Swin-T learning rate | 2 × 10⁻⁶ |
| Görev modülleri learning rate | 10⁻⁴ |
| Warm-up | 3 epoch linear |
| Precision | bfloat16 mixed precision |
| Gradient clipping | L2 norm 0,5 |
| nu-AD mini-batch | 2 surround-view tuple |
| Gradient accumulation | 8 mini-batch |
| Efektif batch size | 16 |
Swin-T ilk üç epoch boyunca dondurulmuş, daha sonra kademeli olarak açılmıştır. BDD-OIA'da yatay çevirme kullanılmamıştır; çünkü bunun sağ/sol anlamını tersine çevireceği belirtilmektedir. nu-AD'de ise kameralar ve ilgili etiketler birlikte yeniden eşlenerek geometrik olarak tutarlı bir flip uygulanmıştır.
Kayıp fonksiyonu
Davranış için sınıf ağırlıklı binary cross-entropy:
\[ L_{VB} = BCE_{w_B}(\hat B_i,B_i) \]
kullanılmıştır.
Yorumlama için eğitim veri frekanslarından hesaplanan ve üst sınırla kırpılan pozitif sınıf ağırlıklarıyla:
\[ L_{des} = BCE_{w+}(\hat E_i,E_i) \]
kullanılmıştır.
Nesne token çeşitliliğiyle birlikte nihai hedef:
\[ L_{total} = 0,5L_{VB} + 1,0L_{des} + 0,005L_{div} \]
şeklindedir.
BDD-OIA ana sonuçları
| Yöntem | F1beh m | F1beh all | F1des m | F1des all | Forward | Stop | Left | Right |
|---|---|---|---|---|---|---|---|---|
| Local selector | 0,699 | 0,711 | 0,196 | 0,406 | 0,810 | 0,762 | 0,600 | 0,624 |
| OIA | 0,718 | 0,734 | 0,208 | 0,422 | 0,829 | 0,781 | 0,630 | 0,634 |
| Inaction | 0,694 | 0,714 | 0,347 | 0,565 | 0,800 | 0,747 | 0,612 | 0,619 |
| NLE-DM | 0,723 | 0,733 | 0,312 | 0,517 | 0,827 | 0,760 | 0,651 | 0,653 |
| Interrelation | 0,701 | 0,722 | 0,335 | 0,537 | 0,802 | 0,753 | 0,619 | 0,625 |
| CrossAD | 0,716 | 0,739 | 0,417 | 0,584 | 0,839 | 0,803 | 0,580 | 0,641 |
CrossAD yorumlamada güçlü olmakla birlikte BDD-OIA davranış class-mean F1 açısından tablodaki en yüksek yöntem değildir. Bu ayrım sonuç yorumunda korunmalıdır.
nu-AD ana sonuçları
| Yöntem | F1beh m | F1beh all | F1des m | F1des all |
|---|---|---|---|---|
| OIA | 0,739 | 0,771 | 0,853 | 0,852 |
| NLE-DM | 0,760 | 0,836 | 0,882 | 0,879 |
| VB-CASeg | 0,767 | 0,844 | 0,907 | 0,903 |
| CrossAD | 0,848 | 0,887 | 0,909 | 0,919 |
nu-AD CrossAD sınıf sonuçları
| Davranış | F1 |
|---|---|
| Forward | 0,963 |
| Stop | 0,852 |
| Left | 0,760 |
| Right | 0,818 |
Çok kameralı ablasyon
| Varyant | Kamera | Forward | Stop | Left | Right | F1des m | F1des all | F1beh all |
|---|---|---|---|---|---|---|---|---|
| V1 — tek kamera | 1 | 0,963 | 0,824 | 0,739 | 0,773 | 0,862 | 0,867 | 0,851 |
| V2 — token ortalama | 6 | 0,954 | 0,785 | 0,582 | 0,708 | 0,747 | 0,780 | 0,792 |
| V3 — cam embedding + cyclic LR | 6 | 0,958 | 0,837 | 0,752 | 0,805 | 0,905 | 0,917 | 0,877 |
| V4 — tam model | 6 | 0,963 | 0,852 | 0,760 | 0,818 | 0,909 | 0,919 | 0,887 |
V3 ile V2 arasındaki karşılaştırma yalnız kamera embedding etkisinin saf ablasyonu değildir; makalenin kendisi V3'ün optimiser schedule ve eğitim bütçesi bakımından da V2'den farklı olduğunu belirtmektedir.
Verimlilik karşılaştırması
| Yöntem | Parametre | Runtime / görüntü | nu-AD F1beh m | nu-AD F1des all |
|---|---|---|---|---|
| OIA | 21,68 M | 65,63 ms | 0,739 | 0,852 |
| NLE-DM | 41,55 M | 47,10 ms | 0,760 | 0,879 |
| VB-CASeg | 28,11 M | 52,78 ms | 0,767 | 0,903 |
| CrossAD | 27,4 M | 50,9 ms | 0,848 | 0,919 |
Kaynağın ayrıntılı karmaşıklık tablosunda CrossAD görsel dalı 22,21 M parametre, 17,89 G MAC ve 35,78 G FLOP olarak raporlanmaktadır. Bu profil nu-AD altı kameralı giriş ve batch size 1 için yapılmıştır.
TinyLLaMA-LoRA modülü için 4,51 M sayısı yalnız eğitilebilir LoRA adapter parametrelerini temsil etmektedir. TinyLlama-1.1B ana modeli dondurulmuştur; bu nedenle 27,4 M değeri dil modelinin bütün fiziksel model parametrelerini içeren toplam sistem büyüklüğü olarak yorumlanmamalıdır.
Doğal dil sadakat analizi
| Ölçüt | Alt küme | Değer |
|---|---|---|
| Davranışın cümlede geçmesi | Tüm test | %99,93 |
| Güven ifadesi geçmesi | Tüm test | %99,80 |
| Sahne ipucu hizalanması | Tüm test | %92,11 |
| ROUGE-L | Davranış tamamen doğru, n=1111 | 0,8016 |
| ROUGE-L | Davranış yanlış, n=3461 | 0,6788 |
| ROUGE-L | Tahmin etiketleriyle üretim | 0,7087 |
| ROUGE-L | Gerçek etiketlerle oracle üretim | 0,9226 |
Buradaki sadakat yapılandırılmış davranış ve yorum etiketlerine yöneliktir. Çalışmanın kendisi, bu sonuçların ham görsel kanıta yönelik causal faithfulness sağlamadığını belirtmektedir.
Kaynak içindeki teknik dikkat noktaları
OSM pooled query: Denklem (5) bütün position-aware token dizisinin ortalamasını kullanırken Algorithm 1 seçilmiş \(Z_{top}\) token'larının ortalamasını kullanmaktadır.
V2–V3 ablasyonu: Kamera embedding ile birlikte cyclic learning rate ve eğitim bütçesi de değiştiği için kazanç yalnız kamera embedding'e nedensel olarak atanamaz.
Parametre sayısı: CrossAD için verilen 27,4 M rakamı, TinyLlama-1.1B'nin tüm dondurulmuş temel parametrelerini kapsayan toplam deployed model büyüklüğü değildir.
BDD-OIA F1 terminolojisi: 0,716 değeri Table 6'da class-mean behaviour F1'dir; overall behaviour F1 0,739'dur. Daha sonraki metinde 0,716 “behaviour-prediction accuracy” olarak anılmıştır.
Açıklama sadakati: Language generator etiket-koşulludur. Bu nedenle karar-düzeyi sadakat ile ham görsel kanıta yönelik nedensel sadakat birbirinden ayrılmalıdır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: A Unified Explainable Autonomous Driving Framework via Cross-Attention Scene Selection and Semantic–Object Fusion
Yazarlar: Habib Dhahri, Fahad Alotaibi, Awais Mahmood, Mousa Jari.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Sorumlu yazar: Habib Dhahri.
Eş katkı/eş birinci yazar: Kaynakta böyle bir beyan bulunmamaktadır.
Kurum: College of Applied Computer Science, King Saud University, Riyadh 11545, Saudi Arabia.
Dergi: Machines.
Yayınevi: MDPI.
Bibliyografik kayıt: Machines 2026, 14, 677.
DOI: 10.3390/machines14060677.
Resmî yayın bağlantısı:https://doi.org/10.3390/machines14060677
Yayın tarihi: 10 Haziran 2026.
Kaynak türü ve hakemlik durumu: Hakemli özgün araştırma makalesidir. Çalışma BDD-OIA ve nu-AD açık benchmark veri kümeleri üzerinde derin öğrenme modeli geliştirme ve değerlendirmesine dayanmaktadır.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Çalışma King Saud University, Riyadh tarafından Ongoing Research Funding programı kapsamında ORF-2026-2100 numarasıyla desteklenmiştir.
Veri ve kod erişilebilirliği: Araştırmada BDD-OIA ve nu-AD açık benchmark'ları kullanılmıştır. Yazarlar stratified subset manifest, sampling scriptleri, eğitim kodu, rule-engine şablonları ve değerlendirme scriptlerinin GitHub üzerinden sunulduğunu; LoRA uyarlanmış TinyLlama checkpoint'inin kabul sonrasında yayımlanacağını belirtmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmiştir.
Yazar katkıları: Habib Dhahri ve Fahad Alotaibi kavramsallaştırmada; Habib Dhahri, Awais Mahmood ve Mousa Jari yöntemde; Habib Dhahri yazılımda; dört yazar doğrulamada; Habib Dhahri biçimsel analiz ve veri düzenlemede; Habib Dhahri ve Mousa Jari araştırmada; Fahad Alotaibi ve Awais Mahmood kaynak sağlamada; Habib Dhahri ilk taslak ve görselleştirmede; Fahad Alotaibi, Awais Mahmood ve Mousa Jari inceleme/düzenlemede; Awais Mahmood ve Mousa Jari gözetimde; Fahad Alotaibi proje yönetimi ve finansman ediniminde görev almıştır.
Bu Verianla makalesindeki mimari, tensor boyutları, kayıp fonksiyonları, eğitim ayarları, benchmark sonuçları, ablasyonlar, verimlilik değerleri, doğal dil açıklama sonuçları, stres testleri ve sınırlılıklar incelenen kaynak çalışmaya dayanmaktadır. Bibliyografik kimlik doğrulaması dışında dış kaynaklardan yeni bilimsel model sonucu veya performans iddiası eklenmemiştir.
Temel yöntemsel sınır: Çalışma BDD-OIA ve nu-AD benchmark'larında çevrimdışı model değerlendirmesi sunmaktadır. Gerçek araçta kapalı çevrim sürüş, saha testi, uzun dönemli kullanım, güvenlik sertifikasyonu veya farklı ülke ve trafik dağılımlarında bağımsız doğrulama yapılmamıştır. Model temel olarak statik görüntü/kamera karelerini kullanmaktadır ve uzun dönemli temporal reasoning mevcut mimarinin ana parçası değildir.
Açıklanabilirlik sınırı: LoRA-TinyLlama açıklama üreticisi ham görsel token'lara doğrudan koşullandırılmamakta; tahmin edilen davranış ve yorum etiketlerinden açıklama oluşturmaktadır. Bu nedenle çalışma yapılandırılmış kararlara yönelik decision-level faithfulness bulgusu sunmaktadır; ham görsel kanıta yönelik causal faithfulness kanıtı sunmamaktadır.
OSM kaynak içi tutarsızlık notu: Bölüm 3.3 Denklem (5) pooled query'yi bütün position-aware token'ların ortalaması olarak tanımlarken Algorithm 1'in 4. adımı yalnız seçilmiş top-K token'ların ortalamasını kullanmaktadır. Kaynak iki tanımı tek bir nihai uygulama olarak uzlaştırmamaktadır.
Ablasyon sınırı: V2 ve V3 arasındaki değişiklik yalnız kamera embedding değildir; cyclic learning-rate schedule ve eğitim bütçesi de değişmektedir. Kaynak bu nedenle V2→V3 kazancını camera embedding'in tek başına nedensel etkisi olarak değerlendirmemektedir.
Model büyüklüğü notu: Verimlilik tablosundaki CrossAD 27,4 M değeri ile TinyLLaMA-LoRA için verilen 4,51 M değer, dondurulmuş yaklaşık 1,1 milyar parametreli TinyLlama temel ağının bütün parametrelerini temsil etmez. 4,51 M yalnız eğitilebilir LoRA adapter parametreleridir.
F1 terminolojisi notu: BDD-OIA Tablo 6'da CrossAD'ın behaviour mean F1 değeri 0,716, overall behaviour F1 değeri 0,739'dur. Daha sonraki doğal dil açıklaması tartışmasında 0,716 değeri “behaviour-prediction accuracy” biçiminde anılmıştır. Verianla makalesinde iki ölçüt ayrı tutulmuştur.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir