

Kanser tedavisiyle ilgili klinik kılavuzlar, ilaç ruhsatlandırma kararları ve hasta bakım protokolleri büyük ölçüde randomize kontrollü çalışmaların yayımlanmış raporlarına dayanır. Bu nedenle onkoloji araştırmalarında kullanılan dil yalnızca üslup meselesi değildir. Araştırma yönteminin, sonuçların, sınırlılıkların ve klinik anlamın doğru aktarılması, kanser tedavisine yön veren kanıt sisteminin güvenilirliği açısından önem taşır.
Bu çalışmada, ChatGPT ve diğer büyük dil modellerinin yaygın erişilebilir hâle geldiği 2022 sonrasındaki dönemde onkoloji randomize kontrollü çalışma yayınlarının dilinde ölçülebilir bir değişiklik oluşup oluşmadığı araştırılmıştır. PubMed’de 2019 ile Mayıs 2026 arasında indekslenen 21.392 onkoloji randomize kontrollü çalışması incelenmiştir. Yayınlar 2019-2022 arasını kapsayan “LLM öncesi dönem” ve 2023-Mayıs 2026 arasını kapsayan “LLM sonrası dönem” olarak ikiye ayrılmıştır.
Araştırmacılar daha önceki hesaplamalı dilbilim çalışmalarında büyük dil modellerinin yaygınlaşmasından sonraki biyomedikal yayınlarda orantısız biçimde arttığı bildirilen 34 kalıplaşmış İngilizce ifadeyi önceden belirlemiştir. Her yayında bu ifadelerin kaç kez geçtiği küçük harfe dönüştürülmüş metin üzerinde tam alt dize eşleştirmesiyle sayılmıştır. Yayınların 10.483’ü için PubMed Central’dan tam metin elde edilmiş; kalan 10.909 yayında başlık ve özet kullanılmıştır.
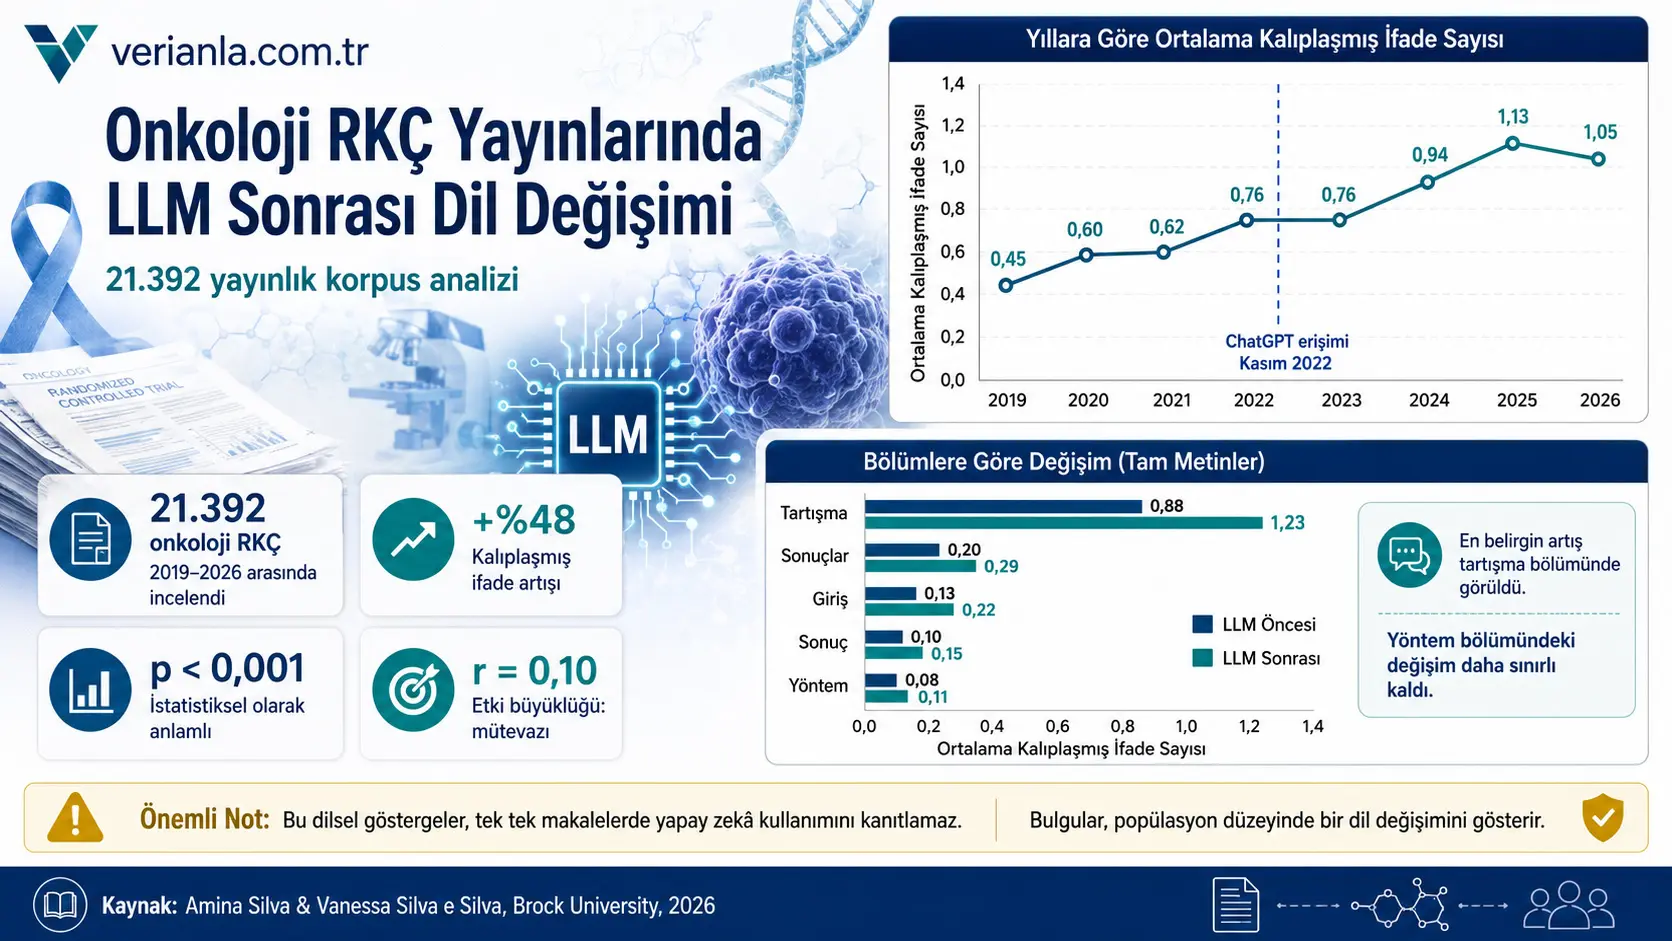
LLM sonrası dönemde yayın başına ortalama kalıplaşmış ifade sayısı 0,96, LLM öncesi dönemde ise 0,65 bulunmuştur. Mutlak fark yayın başına 0,31 ifade, göreli artış yaklaşık %48’dir. Fark istatistiksel olarak anlamlıdır; ancak etki büyüklüğü r=0,10 ile mütevazıdır. Başka bir ifadeyle çok büyük yayın kümesinde küçük fakat sistematik bir dilsel değişim saptanmıştır.
Yıllara göre ortalama ifade sayısı 2019’da 0,45’ten 2025’te 1,13’e yükselmiştir. 2022 ve 2023 değerleri 0,76 ile aynıdır. Araştırmacılar bunu, bir makalenin yazılması, değerlendirilmesi ve yayımlanması arasındaki gecikmeyle ilişkilendirmektedir. Artışın 2024 ve 2025’te hızlandığı görülmüştür. Yalnızca Mayıs ayına kadar taranan 2026 verisinde ortalama 1,05’tir.
Tam metinli yayınlarda en büyük mutlak değişim tartışma bölümlerinde görülmüştür. Tartışma bölümlerindeki ortalama ifade sayısı 0,88’den 1,23’e yükselmiş; mutlak artış 0,35, göreli artış %40 olmuştur. Yöntem bölümlerindeki değişim ise 0,08’den 0,11’e çıkarak yalnızca 0,03 düzeyinde kalmıştır. Araştırmacılar bu dağılımı, yorumlama ve sentez gerektiren metinlerin büyük dil modeli desteğine daha açık olabileceği düşüncesiyle uyumlu bulmaktadır.
Bununla birlikte çalışma, herhangi bir makalenin yapay zekâ kullanılarak yazıldığını belirleyememektedir. İncelenen ifadeler insanlar tarafından da yaygın biçimde kullanılabilir. Zaman içinde görülen değişim; büyük dil modeli kullanımı, İngilizceyi ikinci dil olarak kullanan yazarların artması, dil düzenleme hizmetleri, dergi üslup kuralları veya bilimsel yazım geleneklerindeki genel değişim gibi birden fazla etkenden kaynaklanabilir.
Dolayısıyla çalışmanın sonucu “onkoloji makaleleri yapay zekâ tarafından yazılıyor” değildir. Sonuç, büyük dil modellerinin yaygınlaşmasıyla aynı zaman diliminde onkoloji randomize kontrollü çalışma raporlarının dilinde popülasyon düzeyinde küçük fakat ölçülebilir bir değişim bulunduğudur. Bu ilişki bireysel yazarlık sürecini, etik ihlali veya araştırma sonuçlarının doğruluğunu tek başına göstermez.
Çalışmanın temel problemi nedir?
Büyük dil modelleri bilimsel metin yazımında dil düzeltme, metin özetleme, paragraf oluşturma, tartışma yazma, başlık geliştirme ve kod üretme gibi amaçlarla kullanılabilmektedir. Bu araçların bilimsel üretime girmesi, iki farklı tartışmayı beraberinde getirmiştir.
İlk tartışma, büyük dil modellerinin yazım sürecini kolaylaştırmasıdır. Özellikle İngilizceyi birinci dil olarak kullanmayan araştırmacılar için metin akıcılığını iyileştirebilir, teknik ifadelerin düzenlenmesine yardımcı olabilir ve zaman kazandırabilir.
İkinci tartışma ise şeffaflık ve doğruluktur. Büyük dil modelleri akıcı görünen fakat yanlış bilgi, uydurulmuş kaynak, hatalı istatistik veya sonuçların aşırı yorumlanmasını içeren metinler oluşturabilir. Araştırmacıların yapay zekâ kullanımını açıklamaması hâlinde editörlerin ve okuyucuların metnin hangi bölümlerinde insan muhakemesi, hangi bölümlerinde otomatik üretim kullanıldığını anlaması güçleşebilir.
Bu çalışma doğrudan metin doğruluğunu veya yapay zekâ kaynaklı hataları ölçmemektedir. Araştırmanın ele aldığı daha sınırlı soru şudur:
Büyük dil modellerinin yaygın erişilebilir hâle gelmesinden sonra onkoloji randomize kontrollü çalışma yayınlarında, daha önce LLM ilişkili biyomedikal yazımla bağlantılı olduğu bildirilen kalıplaşmış ifadelerin sıklığı değişmiş midir?
Neden özellikle onkoloji randomize kontrollü çalışmaları seçildi?
Randomize kontrollü çalışmalar, müdahalelerin etkisini karşılaştırmada klinik araştırmaların en önemli tasarımlarından biridir. Onkoloji alanında bu çalışmalar:
- Yeni kanser ilaçlarının ruhsatlandırılmasını,
- Tedavi kılavuzlarının hazırlanmasını,
- İlaçların hangi hasta gruplarında kullanılacağını,
- Sağkalım ve hastalık ilerlemesi beklentilerini,
- Tedavi toksisitelerinin değerlendirilmesini,
- Sağlık sistemlerinin geri ödeme kararlarını
etkileyebilir.
Bu nedenle araştırmacılar, dilsel değişimin klinik etkisi en yüksek yayın türlerinden birinde incelenmesini önemli görmüştür. Ancak dilsel değişim bulunması, çalışmalardaki klinik verilerin yanlış olduğu anlamına gelmemektedir. Çalışma tedavi sonuçlarının doğruluğunu, randomizasyon kalitesini veya hasta güvenliğini doğrudan değerlendirmemiştir.
Korpus dilbilimi ne anlama geliyor?
Korpus dilbilimi, çok sayıda yazılı veya sözlü metinden oluşan büyük koleksiyonlarda dilin nasıl kullanıldığını sistematik yöntemlerle inceleyen bir alandır. Tek tek makalelerin öznel biçimde “yapay zekâ yazımına benzediğine” karar vermek yerine, önceden tanımlanmış sözcük veya ifade örüntülerinin binlerce yayındaki sıklığını ölçer.
Bu yaklaşımın temel avantajları şunlardır:
- Aynı ölçütün bütün yayınlara uygulanması,
- Büyük örneklem üzerinde çalışılabilmesi,
- Yıllara göre değişimin nicel olarak izlenmesi,
- Analizin tekrar edilebilir bir kodlama sistemiyle yürütülebilmesi,
- Tek tek yazarlar hakkında öznel hüküm verilmemesi.
Ancak yöntemin temel sınırı da buradadır. Metindeki bir dil örüntüsü yazım sürecinin doğrudan kaydı değildir. Aynı ifade hem bir insan tarafından hem de büyük dil modeli tarafından yazılabilir. Korpus analizi yalnızca metnin nihai görünümünü gözlemler; metnin nasıl üretildiğini göremez.
Veri kümesi nasıl oluşturuldu?
Çalışmada onkolojiyle ilişkili Medical Subject Headings, yani MeSH terimleri, PubMed’in randomize kontrollü çalışma yayın türü filtresiyle birleştirilmiştir. Tarama NCBI E-utilities uygulama programlama arayüzü üzerinden gerçekleştirilmiştir.
Arama Mayıs 2026’da yapılmış ve 2019’dan 2026’ya kadar olan yayınları kapsamıştır. PubMed sorgularında 10.000’den fazla kayıt bulunduğunda oluşabilecek sayfalama sorunlarını önlemek için her takvim yılı ayrı ayrı sorgulanmıştır.
Toplam 21.392 yayın elde edilmiştir:
- LLM öncesi dönem, 2019-2022: 11.345 yayın, %53,0.
- LLM sonrası dönem, 2023-Mayıs 2026: 10.047 yayın, %47,0.
PubMed Central’da açık erişimli tam metni bulunan 10.483 yayın için XML biçimindeki makale metni indirilmiştir. Tam metnine erişilemeyen 10.909 yayında ise PubMed başlığı ve özeti kullanılmıştır.
Bu ayrım önemlidir. Tam metin, özetten çok daha fazla sözcük içerdiği için kalıplaşmış ifadelerin bulunma ihtimali doğal olarak daha yüksektir. Araştırmacılar bu sorunu:
- Tam metinli ve yalnızca özetli yayınları ayrı alt gruplarda analiz ederek,
- Çok değişkenli modelde metin kaynağını ve sözcük sayısını dikkate alarak
azaltmaya çalışmıştır.
Neden 2022 LLM öncesi döneme dahil edildi?
ChatGPT Kasım 2022’de kamuya açılmıştır. Buna rağmen araştırmacılar 2022 yılında yayımlanan makaleleri LLM öncesi döneme dahil etmiştir.
Bu kararın gerekçesi, bilimsel yayın sürecinin gecikmeli işlemesidir. Bir makalenin:
- Verilerinin analiz edilmesi,
- Metninin yazılması,
- Dergiye gönderilmesi,
- Hakem değerlendirmesinden geçmesi,
- Düzeltmelerinin tamamlanması,
- Yayımlanması
aylar sürebilir. Dolayısıyla 2022’de yayımlanan çalışmaların büyük bölümünün Kasım 2022’den önce hazırlanmış olması beklenmiştir.
Bu sınıflandırma makul bir yaklaşım olsa da her yayın için gerçek yazım tarihi bilinmemektedir. Bazı 2023 yayınları da LLM’lerden önce yazılmış, bazı 2022 yayınlarının son düzenlemeleri ise LLM erişimi sonrasında yapılmış olabilir. Dönem sınıflaması bireysel yayın düzeyinde kesin değildir.
İncelenen 34 kalıplaşmış ifade
Araştırmacılar ifadeleri öznel olarak “kötü yazım” saydıkları için seçmemiştir. İzleme listesi, daha önceki hesaplamalı dilbilim çalışmalarında 2023 sonrasındaki biyomedikal metinlerde orantısız biçimde arttığı bildirilen ifadelerden oluşturulmuştur.
| it is important to note | plays a crucial role | delve into |
| further research is needed | significantly enhances | it is worth noting |
| highlights the importance | comprehensive understanding | valuable insights |
| shed light on | underscores the need | pivotal role |
| multifaceted | nuanced understanding | holistic approach |
| pave the way | robust framework | in the realm of |
| it should be noted | growing body of evidence | demonstrates the |
| novel approach | cutting-edge | leverage |
| notably | in conclusion | noteworthy |
| rigorous | in summary | taken together |
| collectively | importantly | interestingly |
| of note | ||
Bu ifadelerin hiçbirisi tek başına yapay zekâ kullanımının kanıtı değildir. “In conclusion”, “further research is needed”, “notably” veya “of note” gibi ifadeler bilimsel metinlerde büyük dil modellerinden çok önce de kullanılmaktaydı.
Araştırmanın ölçtüğü şey, belirli bir ifadenin varlığı değil; önceden tanımlanmış ifade grubunun büyük yayın topluluğundaki ortalama kullanım sıklığının zaman içinde değişmesidir.
İfadeler nasıl sayıldı?
Metinler küçük harfe dönüştürülmüş ve ifadeler tam alt dize eşleştirmesiyle aranmıştır. Örneğin “it is important to note” ifadesi metnin içinde aynı karakter dizisiyle geçtiğinde bir eşleşme olarak sayılmıştır.
Tam metinli yayınlarda bütün bölümlerdeki eşleşmeler toplanmıştır. Yalnızca özeti bulunan yayınlarda başlık ve özet kullanılmıştır.
Bu yöntemin avantajı açık ve tekrar edilebilir olmasıdır. Ancak bazı sınırlılıkları vardır:
- İfadenin hangi bağlamda kullanıldığını değerlendirmez.
- Bir ifadenin yazarın kendi anlatımında mı, alıntıda mı geçtiğini ayırmayabilir.
- Aynı anlamı taşıyan fakat farklı sözcüklerle yazılan ifadeleri yakalayamaz.
- Büyük dil modelinin farklı bir üslup kullanması hâlinde onu saptayamaz.
- İnsanların bilinçli olarak kullandığı yaygın akademik kalıpları da sayar.
Bu nedenle ifade sayımı bir “AI dedektörü” değildir.
Ana sonuç: 0,65’ten 0,96’ya yükseliş
LLM öncesi dönemde yayın başına ortalama kalıplaşmış ifade sayısı 0,65, standart sapma 1,14’tür. LLM sonrası dönemde ortalama 0,96, standart sapma 1,50’dir.
Ortalama fark:
[ 0.96 - 0.65 = 0.31 ]
Yani iki dönem arasındaki mutlak fark, yayın başına ortalama 0,31 ifadedir.
Göreli artış, çalışmanın sonucunu açıklamak için şu ilişkiyle hesaplanabilir:
\[ \%\Delta = \frac{0.96-0.65}{0.65}\times 100 \approx 47.7\% \]
Bu değer çalışmanın grafiğinde yuvarlanarak yaklaşık %48 olarak gösterilmiştir.
Göreli artışın yüksek görünmesine rağmen başlangıç değerinin düşük olduğu unutulmamalıdır. Mutlak değişim bir yayın başına yaklaşık üçte bir ifade düzeyindedir.
İstatistiksel anlamlılık ve etki büyüklüğü aynı şey değildir
Dönemler Mann-Whitney U testiyle karşılaştırılmıştır. Sonuçlar:
- U=51.334.465,
- Z=-14,56,
- p<0,001,
- r=0,10.
Mann-Whitney U testi, değerlerin normal dağılım göstermediği iki bağımsız grubun dağılımlarını sıralamalar üzerinden karşılaştırır.
Çalışmada etki büyüklüğü şu ilişkiyle hesaplanmıştır:
\[ r = \frac{Z}{\sqrt{N}} \]
Burada:
- r, sıra temelli etki büyüklüğüdür.
- Z, Mann-Whitney U testinin standartlaştırılmış test değeridir.
- N, analizdeki toplam yayın sayısıdır.
p değerinin çok küçük olması, dönemler arasındaki farkın rastlantısal dalgalanmayla açıklanmasının güç olduğunu göstermektedir. Ancak r=0,10, farkın büyüklüğünün mütevazı olduğunu göstermektedir.
21.392 yayın gibi çok büyük bir örneklemde küçük farklılıklar dahi yüksek istatistiksel anlamlılığa ulaşabilir. Bu nedenle sonuç yalnızca “p<0,001” üzerinden değil, 0,31’lik mutlak fark ve r=0,10’luk etki büyüklüğüyle birlikte okunmalıdır.
Güven aralıkları
Ortalama ifade sayısının %95 güven aralığı:
- LLM öncesi dönem için 0,63-0,67,
- LLM sonrası dönem için 0,93-0,99
olarak bildirilmiştir.
Büyük örneklem nedeniyle bu aralıklar dardır. Dar güven aralığı ortalama tahmininin hassas olduğunu gösterir; ancak gözlenen ilişkinin nedenini açıklamaz.
Yıllara göre değişim
| Yıl | Dönem | Yayın sayısı | Ortalama ifade sayısı |
|---|---|---|---|
| 2019 | LLM öncesi | 908 | 0,45 |
| 2020 | LLM öncesi | 2.712 | 0,60 |
| 2021 | LLM öncesi | 4.031 | 0,62 |
| 2022 | LLM öncesi | 3.656 | 0,76 |
| 2023 | LLM sonrası | 2.813 | 0,76 |
| 2024 | LLM sonrası | 2.864 | 0,94 |
| 2025 | LLM sonrası | 3.206 | 1,13 |
| 2026, kısmi | LLM sonrası | 1.201 | 1,05 |
Grafik, ortalamanın 2019’dan itibaren zaten yükselmeye başladığını göstermektedir. Artış yalnızca 2023’te aniden ortaya çıkmamıştır. Özellikle 2019 ile 2022 arasında 0,45’ten 0,76’ya yükseliş vardır.
2022 ve 2023 değerlerinin aynı olması, büyük dil modeli erişiminin yayın diline anında yansımadığını düşündürmektedir. Yazarlar, gönderim ve hakemlik gecikmesi nedeniyle etkilerin 2024 ve 2025 yayınlarında daha görünür hâle gelmesini beklenen bir durum olarak yorumlamıştır.
Bununla birlikte bu eğilim büyük dil modeli kullanımına özgü değildir. Bilimsel yazım kültüründeki genel değişim, dergi dil standartları veya uluslararası yazar dağılımı da aynı zaman çizelgesinde değişmiş olabilir.
2026 değeri neden dikkatli okunmalı?
2026 yılı için arama Mayıs ayında yapılmıştır. Dolayısıyla 1.201 yayınlık 2026 örneklemi tam bir takvim yılını temsil etmemektedir.
2025’teki 1,13 ortalamasının 2026’da 1,05’e düşmesi gerçek bir gerileme olabilir; fakat kısmi yıl etkisi, yayınların yıl içindeki dağılımı veya indeksleme gecikmeleri nedeniyle kesin yorum yapılamaz.
Tam metin ve yalnızca özet alt grupları
| Analiz grubu | LLM öncesi ortalama | LLM sonrası ortalama | p değeri | Etki büyüklüğü |
|---|---|---|---|---|
| Bütün yayınlar, n=21.392 | 0,65 | 0,96 | <0,001 | r=0,10 |
| Tam metin, n=10.483 | 0,88 | 1,28 | <0,001 | r=0,11 |
| Yalnızca özet, n=10.909 | 0,45 | 0,62 | <0,001 | r=0,05 |
Tam metin grubundaki farkın daha büyük olması beklenebilir; çünkü incelenen sözcük miktarı çok daha fazladır. Yalnızca özet grubunda da aynı yönde istatistiksel fark bulunması, sonucun yalnızca açık erişimli tam metinlerden kaynaklanmadığını göstermektedir.
Ancak ana karşılaştırmada kullanılan sonuç yayın başına ham ifade sayısıdır. Tam metin ve özet uzunlukları aynı değildir. Araştırmacılar alt grup analizi ve sözcük sayısını dikkate alan regresyonla bu sorunu azaltmaya çalışmış, ancak ham sayıların metin uzunluğuna duyarlılığı tamamen ortadan kalkmamıştır.
Makale bölümlerine göre değişim
Bölüm bazlı analiz yalnızca tam metnine erişilebilen 10.483 yayın üzerinde gerçekleştirilmiştir. Bölümler başlık anahtar sözcükleriyle tanımlanmıştır.
| Makale bölümü | LLM öncesi ortalama | LLM sonrası ortalama | Mutlak fark | Göreli değişim |
|---|---|---|---|---|
| Giriş | 0,13 | 0,22 | +0,09 | +%69 |
| Yöntem | 0,08 | 0,11 | +0,03 | +%38 |
| Sonuçlar | 0,20 | 0,29 | +0,09 | +%45 |
| Tartışma | 0,88 | 1,23 | +0,35 | +%40 |
| Sonuç | 0,10 | 0,15 | +0,05 | +%50 |
Göreli artış açısından en yüksek değer giriş bölümünde %69’dur. Ancak girişte başlangıç ortalaması düşük olduğu için mutlak artış yalnızca 0,09’dur.
Mutlak artış açısından en belirgin değişim tartışma bölümündedir: 0,35 ifade. Bu ayrım önemlidir. Bir bölümün göreli yüzdesi yüksek olabilir, ancak yayın başına eklenen gerçek ifade sayısı küçük kalabilir.
Yöntem bölümü hem mutlak hem de genel kullanım düzeyi bakımından en küçük değişimi göstermiştir. Araştırmacılar bunu yöntem metinlerinin deney protokolleri, dozlar, cihazlar ve analiz yöntemleri gibi daha kesin ayrıntılar gerektirmesiyle ilişkilendirmektedir.
Tartışma bölümü ise:
- Sonuçların yorumlanması,
- Önceki literatürle ilişkilendirilmesi,
- Klinik önem çıkarımı,
- Sınırlılıkların anlatılması,
- Gelecekteki araştırmaların önerilmesi
gibi daha sentezleyici yazım görevleri içerir. Büyük dil modelleri bu tür metinleri akıcı biçimde üretebildiği için bölüm örüntüsü LLM kullanım olasılığıyla uyumlu görünmektedir. Fakat yine de bu dağılım kullanımın doğrudan kanıtı değildir.
Çok değişkenli regresyon neyi amaçladı?
Araştırmacılar dönem ile kalıplaşmış ifade sayısı arasındaki ilişkiyi değerlendirirken:
- Yayın yılını,
- Metnin tam metin veya özet olmasını,
- Sözcük sayısını
dikkate alan çok değişkenli doğrusal regresyon kullandıklarını bildirmiştir.
Tartışma bölümünde ilişkinin bu düzeltmelerden sonra da sürdüğü ifade edilmektedir. Ancak ana PDF’de regresyon katsayıları, standart hatalar, güven aralıkları ve ayrıntılı model tablosu gösterilmemiştir. Bu nedenle modelin büyüklüğü ve her değişkenin bağımsız katkısı mevcut metinden ayrıntılı biçimde değerlendirilememektedir.
GRIM testi nedir?
GRIM, “Granularity-Related Inconsistency of Means” ifadesinin kısaltmasıdır. Tam sayı değerlerinden oluşan ölçeklerde bildirilen ortalamanın örneklem büyüklüğüyle matematiksel olarak uyumlu olup olmadığını kontrol eder.
Çalışmanın mantığını açıklamak için temel ortalama ilişkisi şöyledir:
\[ \bar{x} = \frac{\sum_{i=1}^{n} x_i}{n} \]
Burada:
- \bar{x}, bildirilen ortalamadır.
- xi, her katılımcının tam sayı ölçek değeridir.
- n, örneklem büyüklüğüdür.
Eğer bütün bireysel değerler tam sayıysa, bu değerlerin toplamı da tam sayı olmak zorundadır. Belirli bir örneklem büyüklüğünde yalnızca belirli ortalamalar matematiksel olarak mümkündür. Bildirilen ortalama bu olası değerlerle uyuşmuyorsa bir raporlama, yuvarlama veya veri hatası bulunabilir.
Çalışmada düzenli ifadeler kullanılarak makalelerden ortalama-örneklem büyüklüğü çiftleri çıkarılmış, yayın başına en fazla 15 çift incelenmiş ve örneklem büyüklüğü 2 ile 10.000 arasında sınırlandırılmıştır.
GRIM sonucu neden güçlü bir sonuç değildir?
21.392 yayının yalnızca 48’inde, yani yaklaşık %0,2’sinde test için uygun tam sayı ölçeği ortalaması ve örneklem büyüklüğü çıkarılabilmiştir.
Bu 48 yayının 29’unda, yani %60,4’ünde en az bir GRIM uyumsuzluğu bulunmuştur. Ancak dönemler arasındaki fark istatistiksel anlamlılığa ulaşmamıştır:
- Z=-1,72,
- p=0,085.
Onkoloji randomize kontrollü çalışmalarında sağkalım süresi, tehlike oranı, sürekli biyobelirteçler ve zaman-aşımı sonuçları sık kullanıldığı için GRIM testinin gerektirdiği tam sayı ölçek ortalamaları nadirdir.
Yalnızca 48 yayına uygulanabilmesi nedeniyle analiz ciddi biçimde güçsüzdür. Anlamlı fark bulunmaması, LLM sonrasında sayısal raporlama hatalarının değişmediğini veya bulunmadığını göstermez.
Çalışma yapay zekâ kullanımını tespit ediyor mu?
Hayır. Araştırmacılar bunu açıkça belirtmektedir. Bir makalede izleme listesindeki ifadelerin çok sayıda bulunması:
- Metnin yapay zekâ tarafından yazıldığını,
- Yazarın bunu gizlediğini,
- Bilimsel verilerin yanlış olduğunu,
- Etik ihlal gerçekleştiğini
kanıtlamaz.
Aynı şekilde bir makalede bu ifadelerin bulunmaması da yapay zekâ kullanılmadığını göstermez. Büyük dil modelleri farklı komutlarla farklı üsluplar üretebilir veya yapay zekâ çıktısı insan tarafından tamamen yeniden düzenlenebilir.
Çalışma bir sınıflandırıcı geliştirmemiş, duyarlılık veya özgüllük ölçmemiş ve bilinen yapay zekâ destekli metinlerden oluşan doğrulama kümesi kullanmamıştır.
Başka hangi açıklamalar mümkündür?
Yazarlar gözlenen değişimin birden fazla eş zamanlı süreçten kaynaklanabileceğini kabul etmektedir:
- Büyük dil modellerinin yazım desteğinde kullanılması,
- İngilizceyi ana dili olarak kullanmayan araştırmacıların yayınlara daha fazla katılması,
- Profesyonel dil düzenleme hizmetlerinin yaygınlaşması,
- Dergilerin ortak bir akademik üsluba yönelmesi,
- Editör ve hakemlerin belirli ifadeleri tercih etmesi,
- Bilimsel yazım eğitiminde kalıplaşmış ifadelerin yaygınlaşması,
- Onkoloji yayınlarının konu ve yazar coğrafyasındaki değişimler.
Retrospektif metin analizi bu açıklamaları birbirinden ayıramamaktadır.
Yapay zekâ destekli yazım bilimsel açıdan neden otomatik olarak kötü değildir?
Büyük dil modelleri dil bilgisi düzeltme, anlatımı sadeleştirme veya başka bir dilde yazılmış metni akademik İngilizceye dönüştürme amacıyla kullanılabilir. Araç kullanılmış olsa bile:
- Veriler gerçek olabilir,
- İstatistikler doğru olabilir,
- Kaynaklar yazarlar tarafından doğrulanmış olabilir,
- Bilimsel yorumlar araştırmacılara ait olabilir.
Temel sorun kullanımın kendisinden çok, kullanımın açıklanmaması, çıktının doğrulanmaması veya aracın araştırmacının eleştirel değerlendirmesinin yerini almasıdır.
Bu çalışma yapay zekâ destekli yazımın hata oranını ölçmediğinden, kalıplaşmış dildeki artışın araştırma kalitesini azalttığı sonucuna varılamaz.
Editoryal politikalar açısından anlamı
Yazarlar, birçok tıp ve onkoloji dergisinin yapay zekâ kullanımının açıklanmasını istediğini, ancak bu politikaların uygulanmasının ve doğrulanmasının tutarsız olabildiğini belirtmektedir.
Çalışma, büyük yayın topluluklarında zaman içindeki dilsel değişimin izlenebileceğini göstermektedir. Araştırmacılar bunu, gönüllü beyan sistemlerinin yeterliliğini değerlendirmek ve yayıncılık politikalarını geliştirmek için kullanılabilecek bir gözetim yaklaşımı olarak sunmaktadır.
Ancak popülasyon düzeyindeki dil gözetimi bireysel makaleleri suçlamak için kullanılmamalıdır. Bir makalenin etik açıdan değerlendirilmesi için:
- Yazar beyanı,
- Veri ve analiz kayıtları,
- Kaynak doğruluğu,
- Editoryal yazışmalar,
- Metnin bilimsel tutarlılığı
gibi daha doğrudan kanıtlar gerekir.
Kanser hastaları açısından dolaylı önem
Bu çalışma herhangi bir kanser tedavisini veya hasta sonucunu incelememektedir. Hastalara doğrudan klinik öneri sunmaz.
Gündelik yaşama etkisi dolaylıdır. Kanser hastaları için tedavi kararları yayımlanmış araştırmalara dayandığından, bilimsel raporların:
- Doğru,
- Şeffaf,
- Denetlenebilir,
- Yöntem ve sonuçları birbirinden ayıran,
- Belirsizliği açıkça bildiren
metinler olması gerekir.
Yapay zekâ araçları bu süreci iyileştirebilir veya kötüleştirebilir. Sonuç, aracın kullanılmasından çok araştırmacıların doğrulama ve açıklama uygulamalarına bağlıdır.
Çalışmanın güçlü yönleri
- 21.392 yayınla geniş bir onkoloji RCT korpusu analiz edilmiştir.
- 2019’dan 2026’ya uzanan zaman eğilimi incelenmiştir.
- İfadeler veri analizinden önce belirlenen bir izleme listesinden alınmıştır.
- Yayınlar yıllara göre ayrı sorgulanarak PubMed sayfalama sorunları azaltılmıştır.
- Tam metin ve yalnızca özet yayınlar ayrı alt gruplarda analiz edilmiştir.
- Makale bölümleri ayrı ayrı değerlendirilmiştir.
- İstatistiksel anlamlılığın yanında etki büyüklüğü raporlanmıştır.
- Yazarlar sonuçların bireysel makalelerde yapay zekâ kullanımını göstermediğini açıkça belirtmiştir.
- Veri toplama ve analiz süreci programlı olarak yürütülmüştür.
- Çalışma, dilsel değişim ile bilimsel suistimali birbirine eşitlememeye dikkat etmiştir.
Çalışmanın sınırlılıkları
- Nedensellik kurulamaz: 2022 sonrasındaki değişimin büyük dil modellerinden kaynaklandığı kanıtlanmamıştır.
- İfade listesi doğrudan doğrulanmamıştır: İzleme listesi bilinen yapay zekâ destekli onkoloji makalelerinde duyarlılık ve özgüllük açısından test edilmemiştir.
- İfadeler insan yazımında da bulunabilir: Hiçbir ifade yapay zekâya özgü değildir.
- Tam metin kapsamı sınırlıdır: Yayınların yalnızca %49’u için tam metin kullanılmıştır.
- Açık erişim seçilimi olabilir: PubMed Central’da tam metni bulunan yayınlar bütün onkoloji literatürünü temsil etmeyebilir.
- Metin uzunluğu farklıdır: Tam metin ile özetlerde aynı ham ifade sayımı kullanılmıştır; regresyon ve alt grup analizleri sorunu azaltmış ancak tamamen ortadan kaldırmamıştır.
- Tam alt dize eşleştirmesi bağlamı değerlendirmez: İfadenin anlamı veya kullanım amacı analiz edilmemiştir.
- Bölüm tanımlama başlıklara dayanır: Standart dışı bölüm adları yanlış veya eksik sınıflandırılabilir.
- Ölçülmeyen karıştırıcılar vardır: Yazar ülkesi, ana dil, dergi politikası, profesyonel düzenleme hizmeti ve yayın konusu kontrol edilmemiştir.
- 2026 kısmi yıldır: Son yılın eğilimi tam takvim yılı verisi değildir.
- Etki büyüklüğü küçüktür: r=0,10 ve mutlak fark 0,31 ifadedir.
- GRIM analizi uygulanabilir değildir: Yayınların yalnızca 48’inde test yapılabilmiştir.
- Regresyon ayrıntıları eksiktir: Ana PDF’de model katsayıları ve tam sonuç tablosu sunulmamıştır.
- Veri ve kod herkese açık bir depoda bulunmamaktadır: Veri seti ve analiz hattının makul talep üzerine sağlanacağı belirtilmiştir.
- Raporlama kalitesi ölçülmemiştir: CONSORT uyumu, kaynak doğruluğu veya sonuçların klinik doğruluğu doğrudan analiz edilmemiştir.
Çalışma ne söylüyor?
- Onkoloji RCT yayınlarında belirlenen 34 kalıplaşmış ifadenin ortalama kullanımı 2023-2026 döneminde 2019-2022 döneminden daha yüksektir.
- Fark büyük örneklemde istatistiksel olarak anlamlıdır.
- Etki büyüklüğü mütevazıdır.
- Yıllık ortalama 2019’dan 2025’e doğru genel olarak yükselmiştir.
- 2022 ve 2023 değerleri aynıdır; daha belirgin yükseliş 2024 ve 2025’te görülmüştür.
- Değişim tam metin ve yalnızca özet alt gruplarında aynı yöndedir.
- En büyük mutlak bölüm değişimi tartışma metinlerinde görülmüştür.
- Yöntem bölümlerindeki mutlak değişim daha küçüktür.
- Onkoloji yayın dilinde popülasyon düzeyinde ölçülebilir bir zaman değişimi vardır.
Çalışma ne söylemiyor?
- Herhangi bir bireysel makalenin yapay zekâyla yazıldığı söylenemez.
- Belirlenen ifadeleri kullanan yazarların etik ihlal yaptığı gösterilmemiştir.
- LLM sonrası yayınların bilimsel olarak daha hatalı olduğu kanıtlanmamıştır.
- Onkoloji RCT sonuçlarının güvenilmez hâle geldiği gösterilmemiştir.
- Kalınlaşmış dil örüntülerinin yalnızca LLM kullanımından kaynaklandığı kanıtlanmamıştır.
- İfadenin bulunmamasının insan yazarlığını gösterdiği söylenemez.
- GRIM testindeki anlamsız dönem farkı sayısal raporlama sorunlarının bulunmadığını göstermez.
- Çalışma bir yapay zekâ tespit aracı geliştirmemiştir.
- Yapay zekâ kullanımının yasaklanması gerektiği deneysel olarak gösterilmemiştir.
- Gönüllü açıklama politikalarının etkisiz olduğu doğrudan karşılaştırmalı olarak test edilmemiştir.
Geçmiş, bugün ve gelecek açısından önemi
Bilimsel metinler geçmişte yazarlar, ortak yazarlar, profesyonel editörler ve dergi ekipleri tarafından hazırlanıyordu. Büyük dil modelleri bu üretim zincirine yeni ve ölçeklenebilir bir araç eklemiştir.
Bugün açısından çalışma, dildeki değişimin büyük yayın koleksiyonlarında ölçülebileceğini göstermektedir. Bununla birlikte ölçülebilir olmak, sebebin bilindiği anlamına gelmez.
Gelecekte şu araştırmaların yapılması gerekmektedir:
- Zorunlu yapay zekâ kullanım beyanlarının gerçek yazım verileriyle eşleştirilmesi,
- Bilinen insan yazımı ve LLM destekli metinlerden doğrulama veri kümeleri oluşturulması,
- Dil değişiminin CONSORT uyumu ile ilişkisinin incelenmesi,
- Kaynak doğruluğu ve uydurulmuş atıflarla bağlantısının değerlendirilmesi,
- Seçici sonuç raporlama ve aşırı yorumlama göstergelerinin analiz edilmesi,
- Dergi ve ülke bazlı farklılıkların kontrol edilmesi,
- LLM kullanımının araştırmacıların eleştirel düşünme ve yazma becerileri üzerindeki etkisinin incelenmesi,
- Yapay zekânın yalnızca dil düzenleme amacıyla kullanıldığı metinlerle içerik üretiminde kullanıldığı metinlerin ayrılması.
Çalışmanın Yöntemi ve Bulguları
Teknik çalışma tasarımı
| Özellik | Açıklama |
|---|---|
| Çalışma türü | Retrospektif korpus dilbilimi ve yayın metni analizi |
| Veri kaynağı | PubMed ve PubMed Central |
| Arama tarihi | Mayıs 2026 |
| İncelenen dönem | 2019-Mayıs 2026 |
| Toplam yayın | 21.392 onkoloji randomize kontrollü çalışması |
| LLM öncesi dönem | 2019-2022; n=11.345 |
| LLM sonrası dönem | 2023-Mayıs 2026; n=10.047 |
| Tam metin | 10.483 yayın, %49,0 |
| Başlık ve özet | 10.909 yayın, %51,0 |
| Birincil sonuç | Önceden belirlenmiş 34 kalıplaşmış ifadenin yayın başına sayısı |
| İkincil keşifsel sonuç | GRIM testiyle sayısal raporlama uyumsuzluğu |
| Yazılım | Python 3.11 ile veri toplama; IBM SPSS Statistics 29 ile analiz |
Veri toplama akışı
- Onkoloji MeSH terimleri RCT yayın türü filtresiyle birleştirildi.
- 2019-2026 arasındaki her yıl ayrı PubMed sorgusuyla tarandı.
- PubMed kimlikleri NCBI E-utilities aracılığıyla alındı.
- PubMed Central kaydı bulunan yayınların XML tam metni indirildi.
- Tam metni olmayan yayınlarda PubMed başlığı ve özeti kullanıldı.
- Metinler küçük harfe dönüştürüldü.
- 34 ifade tam alt dize eşleştirmesiyle sayıldı.
- Tam metinli yayınlarda bölüm bazlı sayımlar yapıldı.
- Dönemler Mann-Whitney U testiyle karşılaştırıldı.
- Metin kaynağı, yayın yılı ve kelime sayısının etkisini değerlendirmek için regresyon planlandı.
- Uygun sayısal verilerde keşifsel GRIM testi yapıldı.
Ana dönem karşılaştırması
| Sonuç | LLM öncesi | LLM sonrası |
|---|---|---|
| Yayın sayısı | 11.345 | 10.047 |
| Ortalama ifade sayısı | 0,65 | 0,96 |
| Standart sapma | 1,14 | 1,50 |
| %95 güven aralığı | 0,63-0,67 | 0,93-0,99 |
| Mutlak fark | 0,31 ifade/yayın | |
| Yaklaşık göreli artış | %48 | |
| Mann-Whitney U | 51.334.465 | |
| Z | -14,56 | |
| p | <0,001 | |
| Etki büyüklüğü | r=0,10; mütevazı | |
Tam metin ve özet sonuçları
| Alt grup | LLM öncesi ortalama | LLM sonrası ortalama | Z | p | r |
|---|---|---|---|---|---|
| Tam metin, n=10.483 | 0,88 | 1,28 | -15,46 | <0,001 | 0,11 |
| Yalnızca özet, n=10.909 | 0,45 | 0,62 | -5,27 | <0,001 | 0,05 |
Bölüm bazlı sonuçların teknik özeti
| Bölüm | LLM öncesi ortalama | LLM sonrası ortalama | Mutlak değişim | Göreli değişim |
|---|---|---|---|---|
| Giriş | 0,13 ± 0,38 | 0,22 ± 0,55 | +0,09 | +%69 |
| Yöntem | 0,08 ± 0,30 | 0,11 ± 0,38 | +0,03 | +%38 |
| Sonuçlar | 0,20 ± 0,55 | 0,29 ± 0,68 | +0,09 | +%45 |
| Tartışma | 0,88 ± 1,06 | 1,23 ± 1,29 | +0,35 | +%40 |
| Sonuç | 0,10 ± 0,33 | 0,15 ± 0,42 | +0,05 | +%50 |
GRIM testi sonuçları
| Değişken | Sonuç |
|---|---|
| Toplam yayın | 21.392 |
| GRIM için uygun yayın | 48, yaklaşık %0,2 |
| En az bir GRIM uyumsuzluğu bulunan | 29/48, %60,4 |
| Dönem karşılaştırması | Z=-1,72 |
| p değeri | 0,085 |
| Yorum | Örneklem son derece küçük ve analiz yetersiz güçlüdür; dönem farkı hakkında güvenilir sonuç vermez. |
Şeklin anlattığı temel sonuç
Çalışmanın sonuç şeklinin sol bölümünde 2019-2026 arasındaki yıllık ortalama ifade sayısı çizgi grafikle gösterilmektedir. Kasım 2022’deki ChatGPT erişimi kırmızı kesikli çizgiyle işaretlenmiştir. Grafik, ortalamanın 2019’daki 0,45 seviyesinden 2025’te 1,13’e yükseldiğini, ancak 2022 ile 2023 arasında artış olmadığını göstermektedir.
Şeklin sağ bölümündeki yatay çubuklar tam metinli yayınlarda bölümlere göre iki dönemi karşılaştırmaktadır. En uzun çubuklar tartışma bölümüne aittir. LLM öncesi dönemde 0,88 olan tartışma ortalaması, LLM sonrası dönemde 1,23’e yükselmiştir.
Şeklin altındaki uyarı, dilsel göstergelerin herhangi bir makale veya yazar için yapay zekâ kullanımını doğrulayamayacağını özellikle belirtmektedir. Uluslararası yazarlık örüntüleri, editoryal normlar ve LLM kullanımının bu yöntemle birbirinden ayrılamadığı vurgulanmıştır.
Kaynak ve Yöntem Notu
Bu içerik, Amina Silva ve Vanessa Silva e Silva tarafından hazırlanan “Temporal Linguistic Shifts in Oncology Randomized Controlled Trials Following Large Language Model Availability: A Corpus Analysis of 21,392 Publications” başlıklı çalışmaya dayanmaktadır.
Yazarlar Kanada’daki Brock University School of Nursing bünyesinde görev yapmaktadır.
Bu çalışma bir klinik araştırma, hasta kohortu veya randomize kontrollü deney değildir. PubMed’de indekslenen onkoloji randomize kontrollü çalışma yayınlarının metinlerini inceleyen retrospektif korpus dilbilimi araştırmasıdır. Yeni hasta verisi, tedavi müdahalesi veya klinik sonuç üretmemiştir.
Çalışma SSRN’de yayımlanmış bir preprinttir. Metinde açıkça “This preprint research paper has not been peer reviewed” yazmaktadır. Dolayısıyla çalışma hakem değerlendirmesinden geçmemiştir. Bulgular ve özellikle editoryal politika önerileri bağımsız değerlendirme ve tekrar analiz gerektirmektedir.
Çalışmada insan katılımcı bulunmadığı ve yalnızca yayımlanmış, halka açık metinlerin analiz edildiği belirtilmiştir. Bu nedenle araştırmanın etik kurul değerlendirmesinden muaf olduğu bildirilmiştir.
Yazarlar herhangi bir çıkar çatışması olmadığını ve çalışmanın dış finansman almadığını açıklamıştır.
Yazarlar, Claude adlı büyük dil modelini yalnızca veri toplama kodunun geliştirilmesine yardımcı olmak amacıyla kullandıklarını bildirmiştir. Claude’un makalenin yazımı, analizi, yorumlanması veya düzenlenmesinde kullanılmadığı; bütün içeriğin yazarlar tarafından doğrulanıp gözden geçirildiği belirtilmiştir.
Tam veri seti ve analiz hattının herkese açık bir depoda yayımlandığı belirtilmemiş; makul talep üzerine sorumlu yazardan alınabileceği ifade edilmiştir.
Çalışmada görülen 0,31 ifadeyle sınırlı mutlak artış ve r=0,10 etki büyüklüğü, istatistiksel olarak anlamlı olsa da büyük bir dilsel dönüşüm olarak yorumlanmamalıdır. Büyük örneklem küçük farkların güçlü p değerlerine ulaşmasını sağlamıştır.
İzleme listesindeki ifadeler yapay zekâya özgü değildir. Bu nedenle çalışma bireysel yayınlarda LLM kullanımı, gizli kullanım, etik ihlal, metin doğruluğu veya araştırma suistimali hakkında hüküm veremez.
GRIM testi yalnızca 48 yayına uygulanabildiği için sayısal raporlama düzensizliklerine ilişkin ikincil sonuç belirleyici değildir. p=0,085 sonucu, dönemler arasında fark olmadığını kanıtlamamaktadır.
Bu makale yalnızca yüklenen PDF’deki yöntem, sayısal bulgular, tablolar, şekil ve yazarların yorumları temel alınarak hazırlanmıştır. PDF’de bulunmayan yapay zekâ kullanım iddiası, bireysel yazar suçlaması, yayın güvenilmezliği veya onkoloji tedavilerine ilişkin klinik sonuç eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir