

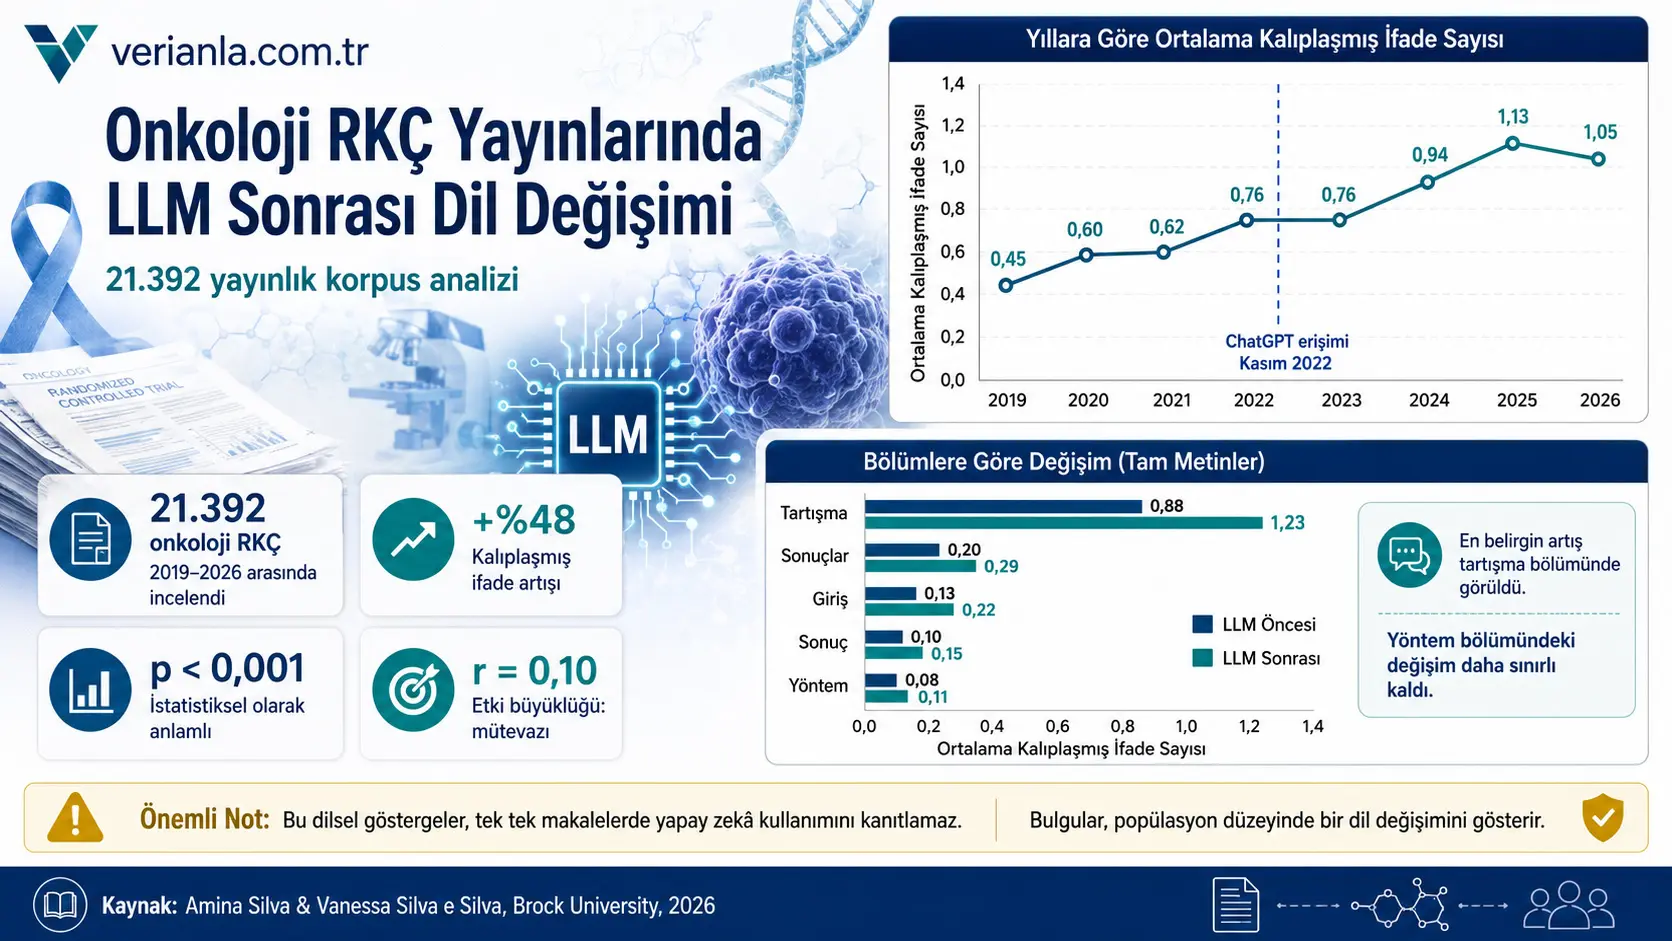
Saratonni davolash bo‘yicha klinik qo‘llanmalar, dorilarni ro‘yxatga olish qarorlari va bemorlarni parvarishlash bayonnomalari asosan randomizatsiyalangan nazorat qilinadigan tadqiqotlarning (RCT) e’lon qilingan hisobotlariga tayanadi[cite: 10]. Shu sababli onkologiya tadqiqotlarida qo‘llaniladigan til shunchaki uslub masalasi emas[cite: 10]. Tadqiqot usullari, natijalar, cheklovlar va klinik ahamiyatning to‘g‘ri yetkazilishi saratonni davolashga yo‘naltirilgan dalillar tizimining ishonchliligi uchun muhim ahamiyat kasb etadi[cite: 10].
Ushbu ishda ChatGPT va boshqa katta til modellari (LLM) keng foydalanishga kiritilgan 2022-yildan keyingi davrda onkologiyaga oid RCT nashrlarining tilida o‘lchash mumkin bo‘lgan o‘zgarishlar yuz bergan-bermagani o‘rganildi[cite: 10]. PubMed bazasida 2019-yildan 2026-yilning may oyigacha indekslangan 21 392 ta onkologik RCT tahlil qilindi[cite: 10]. Nashrlar 2019–2022 yillarni qamrab oluvchi “LLMdan oldingi davr” va 2023–2026-yil may oyigacha bo‘lgan “LLMdan keyingi davr”ga ajratildi[cite: 10].
Tadqiqotchilar oldingi hisoblash tilshunosligi tadqiqotlarida katta til modellari ommalashgandan so‘ng biotibbiyot nashrlarida nomutanosib ravishda ortgani xabar qilingan 34 ta qolipli (shablon) ingliz iborasini oldindan aniqlab oldilar[cite: 10]. Har bir nashrda ushbu iboralar qancha marta uchrashi kichik harflarga o‘zgartirilgan matn ustida to‘liq quyi qator (substring) mosligini qidirish orqali hisoblandi[cite: 10]. 10 483 ta nashr uchun PubMed Central dan to‘liq matn olindi; qolgan 10 909 ta nashrda sarlavha va annotatsiyadan (abstrakt) foydalanildi[cite: 10].
LLMdan keyingi davrda har bir nashrga to‘g‘ri keladigan qolipli iboralarning o‘rtacha soni 0,96 ni, LLMdan oldingi davrda esa 0,65 ni tashkil etdi[cite: 10]. Mutlaq farq nashr boshiga 0,31 ta ibora bo‘lib, nisbiy o‘sish taxminan 48% ni tashkil etadi[cite: 10]. Farq statistik jihatdan ahamiyatli; biroq ta’sir kattaligi r=0,10 bilan o‘rtamiyona darajada[cite: 10]. Boshqacha qilib aytganda, juda katta nashrlar to‘plamida kichik, ammo tizimli til o‘zgarishi aniqlandi[cite: 10].
Yillar kesimida o‘rtacha iboralar soni 2019-yildagi 0,45 dan 2025-yilda 1,13 ga ko‘tarildi[cite: 10]. 2022 va 2023-yilgi ko‘rsatkichlar 0,76 bilan bir xil[cite: 10]. Tadqiqotchilar buni maqola yozilishi, taqriz qilinishi va nashr etilishi o‘rtasidagi kechikish bilan bog‘lamoqdalar[cite: 10]. O‘sish 2024 va 2025-yillarda tezlashgani kuzatildi[cite: 10]. Faqat may oyigacha skaner qilingan 2026-yilgi ma’lumotlarda bu ko‘rsatkich o‘rtacha 1,05 ga teng[cite: 10].
To‘liq matnli nashrlarda eng katta mutlaq o‘zgarish muhokama (discussion) qismlarida kuzatildi[cite: 10]. Muhokama qismlaridagi o‘rtacha iboralar soni 0,88 dan 1,23 ga ko‘tarildi; mutlaq o‘sish 0,35 ni, nisbiy o‘sish 40% ni tashkil etdi[cite: 10]. Uslubiyat qismlaridagi o‘zgarish esa 0,08 dan 0,11 ga oshib, atigi 0,03 darajasida qoldi[cite: 10]. Tadqiqotchilar bu taqsimotni talqin va sintez talab qiluvchi matnlar katta til modeli ko‘magiga ko‘proq moyil bo‘lishi mumkinligi haqidagi taxmin bilan mos kelishini bildirishdi[cite: 10].
Biroq mazkur tadqiqot qaysidir aniq bir maqola sun’iy intellekt yordamida yozilganini tasdiqlay olmaydi[cite: 10]. O‘rganilgan iboralar odamlar tomonidan ham keng qo‘llanilishi mumkin[cite: 10]. Vaqt o‘tishi bilan kuzatilgan o‘zgarishlar bir nechta omillar — katta til modellari qullanilishi, ingliz tilidan ikkinchi til sifatida foydalanuvchi mualliflar soni ortishi, tahrirlash xizmatlari, jurnallarning uslubiy qoidalari yoki ilmiy yozish an’analaridagi umumiy o‘zgarishlar natijasi bo‘lishi mumkin[cite: 10].
Shu sababli tadqiqot xulosasi “onkologiya maqolalari sun’iy intellekt tomonidan yozilmoqda” degani emas[cite: 10]. Xulosa shuki, katta til modellari keng tarqalgan davrda onkologiya sohasidagi RCT hisobotlarining tilida populyatsiya darajasida kichik, ammo o‘lchash mumkin bo‘lgan o‘zgarish bor[cite: 10]. Bu bog‘liqlikning o‘zi yakka mualliflik jarayonini, axloqiy qoidabuzarlikni yoki tadqiqot natijalarining ishonchliligini bevosita ko‘rsatmaydi[cite: 10].
Tadqiqotning asosiy muammosi nima?
Katta til modellari ilmiy matn yozishda tilni tahrirlash, matnni xulosalash, abzaslar tuzish, muhokama yozish, sarlavha yaratish va kod ishlab chiqish kabi maqsadlarda ishlatilishi mumkin[cite: 10]. Ushbu vositalarning ilmiy faoliyatga kirib kelishi ikkita alohida bahsni keltirib chiqardi[cite: 10].
Birinchi bahs katta til modellarining yozish jarayonini osonlashtirishi bilan bog‘liq[cite: 10]. Ayniqsa, ingliz tili ona tili bo‘lmagan tadqiqotchilar uchun bu modellar matnning ravonligini oshirishi, texnik atamalarni tartibga solishda yordam berishi va vaqtni tejashi mumkin[cite: 10].
Ikkinchi bahs esa shaffoflik va aniqlik haqida[cite: 10]. Katta til modellari ravon ko‘rinsa-da, noto‘g‘ri ma’lumotlar, o‘ylab topilgan manbalar, xato statistikalar yoki natijalarning bo‘rttirib talqin qilinishini o‘z ichiga olgan matnlarni yaratishi mumkin[cite: 10]. Agar tadqiqotchilar sun’iy intellektdan foydalanganliklarini oshkor qilmasalar, muharrirlar va o‘quvchilarga matnning qaysi qismlarida inson mulohazasi, qaysilarida esa avtomatik generatsiya qilinganini tushunish qiyinlashadi[cite: 10].
Ushbu tadqiqot bevosita matn aniqligi yoki sun’iy intellekt xatolarini o‘lchamaydi[cite: 10]. Tadqiqot ancha cheklangan savolga javob izlaydi[cite: 10]:
Katta til modellari hamma uchun ochiq bo‘lgandan keyin, onkologiyadagi RCT nashrlarida avvalroq biotibbiyot matnlarida LLMlar bilan bog‘liqligi qayd etilgan qolipli iboralarning uchrash chastotasi o‘zgarganmi[cite: 10]?
Nima sababdan aynan onkologiya RCT lari tanlandi?
Randomizatsiyalangan nazorat qilinadigan tadqiqotlar turli muolajalar ta’sirini solishtirishda eng muhim klinik sinov dizaynlaridan biridir[cite: 10]. Onkologiya sohasida bu tadqiqotlar[cite: 10]:
- Yangi saraton dori vositalarini ro‘yxatdan o‘tkazishni[cite: 10],
- Davolash protokollarini ishlab chiqishni[cite: 10],
- Dori vositalarining qaysi bemor guruhlarida qo‘llanishini[cite: 10],
- Yashab qolish va kasallikning kuchayishi ehtimollarini[cite: 10],
- Davolashning zaharli (toksik) ta’sirlarini baholashni[cite: 10],
- Sog‘liqni saqlash tizimlarining xarajatlarni qoplash qarorlarini ta’sir qilishi mumkin[cite: 10].
Shu sababli tadqiqotchilar tillardagi o‘zgarishlarni klinik ta’siri eng yuqori bo‘lgan nashr turlaridan birida tekshirishni zarur deb bildilar[cite: 10]. Ammo tildagi o‘zgarishlar tadqiqotlardagi klinik ma’lumotlarning noto‘g‘ri ekanligini anglatmaydi[cite: 10]. Tadqiqot davolash natijalarining aniqligini, randomizatsiya sifatini yoki bemorlar xavfsizligini bevosita baholamagan[cite: 10].
Korpus tilshunosligi nimani anglatadi?
Korpus tilshunosligi ko‘p sonli yozma yoki og‘zaki matnlardan iborat yirik to‘plamlarda tildan qanday foydalanilishini tizimli usullar bilan o‘rganuvchi fandir[cite: 10]. Ayrim maqolalar haqida “sun’iy intellekt yozuviga o‘xshaydi” deb subyektiv xulosa qilish o‘rniga, avvaldan belgilangan so‘z yoki iboralar naqshlarining minglab nashrlardagi takrorlanish darajasini o‘lchaydi[cite: 10].
Ushbu yondashuvning asosiy afzalliklari quyidagilardir[cite: 10]:
- Barcha nashrlarga bir xil mezonning qo‘llanilishi[cite: 10],
- Katta tanlanma ustida ishlash imkoniyati[cite: 10],
- Vaqt o‘tishi bilan yuz beradigan o‘zgarishlarni miqdoriy jihatdan kuzatish[cite: 10],
- Tahlilni takrorlanuvchi kodlash tizimi orqali bajarish[cite: 10],
- Alohida mualliflar bo‘yicha subyektiv xulosa chiqarilmasligi[cite: 10].
Ammo usulning asosiy cheklovi ham shu yerdadir[cite: 10]. Matndagi tillik naqsh yozish jarayonining aniq yozuvi emas[cite: 10]. Bir xil ibora ham inson, ham katta til modeli tomonidan yozilishi mumkin[cite: 10]. Korpus tahlili faqat matnning yakuniy ko‘rinishini kuzatadi; uning qanday yaratilganini ko‘ra olmaydi[cite: 10].
Ma’lumotlar to‘plami qanday tuzildi?
Tadqiqotda onkologiya bilan bog‘liq bo‘lgan Medical Subject Headings (MeSH) atamalari PubMed ning RCT nashr turi filtri bilan birlashtirildi[cite: 10]. Izlash ishlari NCBI E-utilities amaliy dasturlash interfeysi (API) orqali bajarildi[cite: 10].
Qidiruv 2026-yil may oyida amalga oshirildi va 2019-yildan 2026-yilgacha bo‘lgan nashrlarni qamrab oldi[cite: 10]. PubMed so‘rovlarida 10 000 dan ortiq yozuv topilganda yuzaga kelishi mumkin bo‘lgan sahifalash (pagination) muammolarining oldini olish uchun har bir kalendar yili alohida so‘raldi[cite: 10].
Jami 21 392 ta nashr yig‘ildi[cite: 10]:
- LLMdan oldingi davr, 2019–2022 yillar: 11 345 ta nashr (53,0%)[cite: 10].
- LLMdan keyingi davr, 2023–2026 yil may oyigacha: 10 047 ta nashr (47,0%)[cite: 10].
PubMed Central’da ochiq ruxsatdagi to‘liq matni mavjud bo‘lgan 10 483 ta nashr uchun XML formatidagi maqola matni yuklab olindi[cite: 10]. To‘liq matni bo‘lmagan 10 909 ta nashrda esa PubMed sarlavhasi va annotatsiyasi (abstrakt) ishlatildi[cite: 10].
Bu farqlash muhimdir[cite: 10]. To‘liq matn annotatsiyaga nisbatan ancha ko‘p so‘z o‘z ichiga olgani uchun, qolipli iboralarning uchrash ehtimoli tabiiy ravishda yuqori bo‘ladi[cite: 10]. Tadqiqotchilar ushbu muammoni quyidagicha yumshatishga harakat qilishdi[cite: 10]:
- To‘liq matnli va faqat annotatsiyadan iborat nashrlarni alohida kichik guruhlarda tahlil qilish[cite: 10],
- Ko‘p o‘zgaruvchili modelda matn manbasi va so‘zlar sonini hisobga olish[cite: 10].
Nima uchun 2022-yil LLMdan oldingi davrga kiritildi?
ChatGPT 2022-yil noyabr oyida jamoatchilikka taqdim etildi[cite: 10]. Shunga qaramay, tadqiqotchilar 2022-yilda chop etilgan maqolalarni LLMdan oldingi davrga kiritishdi[cite: 10].
Ushbu qaror ilmiy nashr jarayonining kechikishlar bilan ishlashi asosida qabul qilindi[cite: 10]. Bir maqolaning[cite: 10]:
- Ma’lumotlari tahlil qilinishi[cite: 10],
- Matni yozilishi[cite: 10],
- Jurnalga yuborilishi[cite: 10],
- Taqrizdan (peer review) o‘tishi[cite: 10],
- Tuzatishlari bajarilishi[cite: 10],
- Chop etilishi oylar talab etishi mumkin[cite: 10].
Shu sababli, 2022-yilda e’lon qilingan tadqiqotlarning ko‘pchiligi 2022-yil noyabrigacha yozib tugatilgan deb taxmin qilindi[cite: 10].
Ushbu tasnif mantiqiy bo‘lsa-da, har bir nashr uchun aniq yozilish sanasi noma’lum[cite: 10]. 2023-yildagi ba’zi maqolalar ham LLM lardan oldin yozilgan, ayrim 2022-yilgi nashrlarning so‘nggi tahrirlari esa LLM lar mavjud bo‘lgan paytda qilingan bo‘lishi mumkin[cite: 10]. Davrlarga ajratish har bir alohida nashr uchun mutlaq aniq emas[cite: 10].
O‘rganilgan 34 ta qolipli ibora
Tadqiqotchilar iboralarni shaxsan o‘zlari “yomon yozuv” deb bilganlari uchun tanlashmagan[cite: 10]. Kuzatuv ro‘yxati avvalgi hisoblash tilshunosligi ishlarida 2023-yildan so‘ng biotibbiyot matnlarida keskin ko‘paygani xabar qilingan iboralardan iborat[cite: 10].
| it is important to note | plays a crucial role | delve into |
| further research is needed | significantly enhances | it is worth noting |
| highlights the importance | comprehensive understanding | valuable insights |
| shed light on | underscores the need | pivotal role |
| multifaceted | nuanced understanding | holistic approach |
| pave the way | robust framework | in the realm of |
| it should be noted | growing body of evidence | demonstrates the |
| novel approach | cutting-edge | leverage |
| notably | in conclusion | noteworthy |
| rigorous | in summary | taken together |
| collectively | importantly | interestingly |
| of note | ||
Bu iboralarning hech biri o‘z-o‘zidan sun’iy intellekt ishlatilganligining dalili emas[cite: 10]. “In conclusion”, “further research is needed”, “notably” yoki “of note” kabi so‘zlar ilmiy matnlarda katta til modellaridan ancha avval ham keng qo‘llanilgan[cite: 10].
Tadqiqot aynan qandaydir iboraning mavjudligini emas, balki oldindan belgilangan iboralar guruhining katta nashrlar to‘plamidagi o‘rtacha qo‘llanish chastotasining vaqt o‘tishi bilan qanday o‘zgarganini o‘lchagan[cite: 10].
Iboralar qanday hisoblandi?
Matnlar kichik harflarga o‘tkazildi va iboralar to‘liq quyi qator (substring) mosligini qidirish yo‘li bilan topildi[cite: 10]. Masalan, “it is important to note” iborasi matn ichida xuddi shu belgilar ketma-ketligida kelganda bitta moslik deb sanalgan[cite: 10].
To‘liq matnli nashrlarda barcha qismlardagi mosliklar qo‘shilgan[cite: 10]. Faqat annotatsiyasi bo‘lgan nashrlarda esa sarlavha va annotatsiyadan foydalanilgan[cite: 10].
Ushbu usulning afzalligi aniqlik va takrorlanuvchanlikdadir[cite: 10]. Ammo ba’zi cheklovlar mavjud[cite: 10]:
- Iboraning qanday kontekstda ishlatilgani baholanmaydi[cite: 10].
- Iboraning muallifning o‘z so‘zi ekanligi yoki iqtibos ekanligi ajratilmasligi mumkin[cite: 10].
- Ayni shu ma’noni bildiruvchi, ammo boshqacha so‘zlar bilan yozilgan iboralarni topa olmaydi[cite: 10].
- Agar katta til modeli boshqacha uslubda yozsa, uni aniqlay olmaydi[cite: 10].
- Odamlar ongli ravishda qo‘llaydigan odatiy ilmiy qoliplarni ham sanaydi[cite: 10].
Shu sababli bu iboralarni sanash “AI detektori” hisoblanmaydi[cite: 10].
Asosiy natija: 0,65 dan 0,96 gacha ko‘tarilish
LLMdan oldingi davrda nashr boshiga to‘g‘ri keluvchi qolipli iboralarning o‘rtacha soni 0,65, standart og‘ish (standard deviation) 1,14 ni tashkil etdi[cite: 10]. LLMdan keyingi davrda bu o‘rtacha ko‘rsatkich 0,96 ga, standart og‘ish esa 1,50 ga yetdi[cite: 10].
O‘rtacha farq[cite: 10]:
[ 0.96 - 0.65 = 0.31 ]
Ya’ni, ikki davr oralig‘idagi mutlaq farq har bir nashr uchun o‘rtacha 0,31 ta iboraga teng[cite: 10].
Tadqiqot xulosasini tushuntirish uchun nisbiy o‘sishni quyidagicha hisoblash mumkin[cite: 10]:
\[ \%\Delta = \frac{0.96-0.65}{0.65}\times 100 \approx 47.7\% \]
Bu ko‘rsatkich tadqiqot grafigida yaxlitlanib taxminan 48% qilib ko‘rsatilgan[cite: 10].
Nisbiy o‘sish yuqori ko‘rinsa-da, boshlang‘ich qiymat past bo‘lganini yodda tutish kerak[cite: 10]. Mutlaq o‘zgarish har bir maqolaga o‘rtacha uchdan bir (1/3) ibora darajasida bo‘lgan[cite: 10].
Statistik ahamiyatlilik va ta’sir kattaligi bir xil emas
Davrlar Mann-Whitney U testi yordamida qiyoslandi[cite: 10]. Natijalar[cite: 10]:
- U=51.334.465[cite: 10],
- Z=-14,56[cite: 10],
- p<0,001[cite: 10],
- r=0,10[cite: 10].
Mann-Whitney U testi me’yoriy (normal) taqsimlanmagan ikkita mustaqil guruhning taqsimotini darajalar (ranks) orqali solishtiradi[cite: 10].
Tadqiqotda ta’sir kattaligi (effect size) quyidagi formula orqali hisoblangan[cite: 10]:
\[ r = \frac{Z}{\sqrt{N}} \]
Bu yerda[cite: 10]:
- r — darajaga asoslangan ta’sir kattaligi[cite: 10].
- Z — Mann-Whitney U testining standartlashgan test qiymati[cite: 10].
- N — tahlildagi jami nashrlar soni[cite: 10].
P-qiymatining (p-value) juda kichikligi, davrlar orasidagi farqni tasodifiy o‘zgaruvchanlik bilan tushuntirish qiyinligini ko‘rsatadi[cite: 10]. Ammo r=0,10 qiymati farqning miqdori unchalik katta emasligini (mütevazı ekanligini) tasdiqlaydi[cite: 10].
21 392 ta nashrdek ulkan tanlanmada hattoki kichik farqlar ham yuqori statistik ahamiyatlilikka ega bo‘lishi mumkin[cite: 10]. Shu sababli natijani faqat “p<0,001” ga qarab emas, balki 0,31 mutlaq farq va r=0,10 ta’sir kattaligi bilan birgalikda baholash kerak[cite: 10].
Ishonch oraliqlari
O‘rtacha iboralar sonining 95% ishonch oralig‘i[cite: 10]:
- LLMdan oldingi davr uchun 0,63–0,67[cite: 10],
- LLMdan keyingi davr uchun 0,93–0,99 deb qayd etilgan[cite: 10].
Tanlanmaning katta ekanligi bu oraliqlarning torligini ta’minlagan[cite: 10]. Tor ishonch oralig‘i o‘rtacha ko‘rsatkich aniq hisoblanganligini ko‘rsatadi; ammo bu o‘zgarishning sababini tushuntirmaydi[cite: 10].
Yillar kesimida o‘zgarishlar
| Yil | Davr | Nashrlar soni | O‘rtacha iboralar soni |
|---|---|---|---|
| 2019 | LLMdan oldin | 908 | 0,45 |
| 2020 | LLMdan oldin | 2 712 | 0,60 |
| 2021 | LLMdan oldin | 4 031 | 0,62 |
| 2022 | LLMdan oldin | 3 656 | 0,76 |
| 2023 | LLMdan keyin | 2 813 | 0,76 |
| 2024 | LLMdan keyin | 2 864 | 0,94 |
| 2025 | LLMdan keyin | 3 206 | 1,13 |
| 2026, qisman | LLMdan keyin | 1 201 | 1,05 |
Grafik o‘rtacha ko‘rsatkich 2019-yildan boshlab ko‘tarilishni boshlaganini ko‘rsatadi[cite: 10]. O‘sish faqat 2023-yilda to‘satdan paydo bo‘lmagan[cite: 10]. Xususan, 2019-yildan 2022-yilgacha 0,45 dan 0,76 ga ko‘tarilish bo‘lgan[cite: 10].
2022 va 2023-yillardagi ko‘rsatkichlarning bir xil bo‘lishi katta til modellaridan foydalanishning nashr tilida bir vaqtning o‘zida aks etmaganini anglatadi[cite: 10]. Mualliflar yuborish va taqriz jarayonidagi kechikishlar tufayli ta’sirlarning 2024 va 2025-yillardagi nashrlarda ko‘proq sezilishini kutilgan holat sifatida izohlashdi[cite: 10].
Biroq bu tendensiya faqatgina katta til modellaridan foydalanish bilan bog‘liq bo‘lmasligi ham mumkin[cite: 10]. Ilmiy yozish madaniyatidagi umumiy o‘zgarishlar, jurnallarning tahrir standartlari yoki xalqaro mualliflar taqsimoti ham aynan shu davrda o‘zgargan bo‘lishi mumkin[cite: 10].
Nima sababdan 2026-yil ko‘rsatkichi ehtiyotkorlik bilan o‘qilishi kerak?
2026-yil uchun qidiruv may oyida olib borilgan[cite: 10]. Demak, 1 201 ta nashrni o‘z ichiga olgan 2026-yilgi tanlanma to‘liq kalendar yilini ifodalamaydi[cite: 10].
2025-yildagi 1,13 lik o‘rtacha ko‘rsatkich 2026-yilda 1,05 ga tushishi haqiqiy pasayish bo‘lishi mumkin; lekin yilning to‘liq emasligi, maqolalarning yil davomidagi taqsimoti yoki indekslash kechikishlari tufayli qat’iy xulosa qilib bo‘lmaydi[cite: 10].
To‘liq matnli va faqat annotatsiyadan iborat kichik guruhlar
| Tahlil guruhi | LLMdan oldingi o‘rtacha | LLMdan keyingi o‘rtacha | p qiymati | Ta’sir kattaligi |
|---|---|---|---|---|
| Barcha nashrlar, n=21 392 | 0,65 | 0,96 | <0,001 | r=0,10 |
| To‘liq matn, n=10 483 | 0,88 | 1,28 | <0,001 | r=0,11 |
| Faqat annotatsiya, n=10 909 | 0,45 | 0,62 | <0,001 | r=0,05 |
To‘liq matn guruhidagi farqning kattaroq bo‘lishi kutilgan holat; chunki tahlil qilingan so‘zlar soni ancha ko‘p[cite: 10]. Faqat annotatsiya guruhida ham statistik ahamiyatli farq qayd etilishi natija faqatgina ochiq ruxsatdagi to‘liq matnlarga bog‘liq emasligini ko‘rsatadi[cite: 10].
Biroq asosiy taqqoslashda nashr boshiga to‘g‘ri keladigan iboralarning xom sonidan foydalanilgan[cite: 10]. To‘liq matn va annotatsiyalar uzunligi bir xil emas[cite: 10]. Tadqiqotchilar kichik guruhlar tahlili va so‘zlar sonini hisobga oluvchi regressiya orqali bu muammoni kamaytirishga uringanlar, ammo xom ko‘rsatkichlarning matn uzunligiga ta’sirchanligi to‘liq bartaraf etilmagan[cite: 10].
Maqola qismlari bo‘yicha o‘zgarish
Qismlar bo‘yicha tahlil faqat to‘liq matni mavjud bo‘lgan 10 483 ta nashrda bajarildi[cite: 10]. Qismlar sarlavhalardagi kalit so‘zlar orqali aniqlandi[cite: 10].
| Maqola qismi | LLMdan oldingi o‘rtacha | LLMdan keyingi o‘rtacha | Mutlaq farq | Nisbiy o‘zgarish |
|---|---|---|---|---|
| Kirish (Introduction) | 0,13 | 0,22 | +0,09 | +69% |
| Uslubiyat (Method) | 0,08 | 0,11 | +0,03 | +38% |
| Natijalar (Results) | 0,20 | 0,29 | +0,09 | +45% |
| Muhokama (Discussion) | 0,88 | 1,23 | +0,35 | +40% |
| Xulosa (Conclusion) | 0,10 | 0,15 | +0,05 | +50% |
Nisbiy o‘sish nuqtai nazaridan eng katta ko‘rsatkich kirish qismida (69%) qayd etilgan[cite: 10]. Biroq kirish qismida dastlabki ko‘rsatkich past bo‘lgani sababli, mutlaq o‘sish atigi 0,09 ni tashkil etgan[cite: 10].
Mutlaq o‘sish bo‘yicha eng ko‘zga ko‘ringan o‘zgarish muhokama qismida bo‘ldi: 0,35 ta ibora[cite: 10]. Bu farq muhimdir[cite: 10]. Qaysidir qismning nisbiy foizi yuqori bo‘lishi mumkin, ammo har bir nashrga qo‘shilgan aniq iboralar soni kam bo‘lib qolishi mumkin[cite: 10].
Uslubiyat qismi ham mutlaq, ham umumiy foydalanish jihatidan eng kichik o‘zgarishni ko‘rsatdi[cite: 10]. Tadqiqotchilar buni uslubiyat qismining tajriba protokollari, dozalar, apparatlar va tahlil usullari kabi aniq tafsilotlarni talab qilishi bilan izohlamoqdalar[cite: 10].
Muhokama qismi esa quyidagilarni o‘z ichiga oladi[cite: 10]:
- Natijalarni talqin qilish[cite: 10],
- Oldingi adabiyotlar bilan bog‘lash[cite: 10],
- Klinik ahamiyatni xulosa qilish[cite: 10],
- Cheklovlarni bayon qilish[cite: 10],
- Kelajakdagi tadqiqotlarni taklif qilish[cite: 10].
Katta til modellari bunday turdagi matnlarni ravon yozish xususiyatiga ega bo‘lganligi sababli, qismlarga oid bu tendensiya LLM dan foydalanish ehtimoliga to‘g‘ri keladi[cite: 10]. Ammo bu ham foydalanishning bevosita dalili emas[cite: 10].
Ko‘p o‘zgaruvchili regressiyaning maqsadi nima edi?
Tadqiqotchilar davr va qolipli iboralar soni o‘rtasidagi bog‘liqlikni baholashda[cite: 10]:
- Nashr yili[cite: 10],
- Matnning to‘liq matn yoki faqat annotatsiya ekanligi[cite: 10],
- So‘zlar sonini[cite: 10]
hisobga oluvchi ko‘p o‘zgaruvchili chiziqli regressiyadan foydalanganini ta’kidlashdi[cite: 10].
Muhokama qismida ushbu tuzatishlardan keyin ham bog‘liqlik saqlanib qolgani qayd etilgan[cite: 10]. Biroq asosiy PDF faylda regressiya koeffitsiyentlari, standart xatolar, ishonch oraliqlari va modelning batafsil jadvali berilmagan[cite: 10]. Shu sababli modelning ko‘lami va har bir o‘zgaruvchining mustaqil hissasi haqidagi ma’lumotlarni mavjud matndan to‘liq baholab bo‘lmaydi[cite: 10].
GRIM testi nima?
GRIM — bu “Granularity-Related Inconsistency of Means” (Vositalarning strukturaga bog‘liq nomuvofiqligi) iborasining qisqartmasi[cite: 10]. U butun sonlardan iborat o‘lchovlar asosida keltirilgan o‘rtacha qiymatning tanlanma o‘lchamiga matematik jihatdan to‘g‘ri kelish-kelmasligini tekshiradi[cite: 10].
Tadqiqot mantig‘ini tushuntirish uchun o‘rtacha qiymatning asosiy formulasi quyidagicha[cite: 10]:
\[ \bar{x} = \frac{\sum_{i=1}^{n} x_i}{n} \]
Bu yerda[cite: 10]:
- \bar{x} — keltirilgan o‘rtacha qiymat[cite: 10].
- xi — har bir qatnashchining butun sondan iborat o‘lchov ko‘rsatkichi[cite: 10].
- n — tanlanma hajmi[cite: 10].
Agar barcha individual qiymatlar butun son bo‘lsa, ularning yig‘indisi ham butun son bo‘lishi shart[cite: 10]. Muayyan tanlanma hajmida faqat ma’lum o‘rtacha qiymatlar matematik jihatdan bo‘lishi mumkin[cite: 10]. Agar keltirilgan o‘rtacha qiymat ushbu mumkin bo‘lgan natijalarga to‘g‘ri kelmasa, hisobotda, yaxlitlashda yoki ma’lumotlarning o‘zida xatolik mavjud bo‘lishi mumkin[cite: 10].
Tadqiqotda muntazam iboralar yordamida maqolalardan o‘rtacha ko‘rsatkich va tanlanma o‘lchami juftliklari ajratib olingan, bitta nashrdan maksimal 15 ta juftlik o‘rganilgan hamda tanlanma hajmi 2 dan 10 000 gacha cheklangan[cite: 10].
GRIM natijasi nima uchun ishonchli emas?
21 392 ta nashrdan faqat 48 tasida (qariyb 0,2 foiz) test uchun yetarli bo‘lgan butun sonli o‘rtacha ko‘rsatkich va tanlanma hajmi juftliklarini olish imkoni bo‘ldi[cite: 10].
Ushbu 48 ta nashrdan 29 tasida (60,4 foiz) kamida bitta GRIM nomuvofiqligi qayd etildi[cite: 10]. Ammo davrlar o‘rtasidagi tafovut statistik ahamiyatlilik darajasiga chiqmadi[cite: 10]:
- Z=-1,72[cite: 10],
- p=0,085[cite: 10].
Onkologiya RCT larida yashovchanlik davri, xavf ko‘rsatkichi (hazard ratio), uzluksiz biomarkerlar va vaqtga bog‘liq natijalar tez-tez qo‘llanilganligi bois, GRIM testi talab qiladigan butun sonli o‘rtachalar kam uchraydi[cite: 10].
Faqat 48 ta nashrga qo‘llash mumkin bo‘lgani uchun tahlil kuchi yetarli emas[cite: 10]. Ahamiyatli farq topilmaganligi LLM paydo bo‘lgandan so‘ng raqamli xatoliklar o‘zgarmaganini yoki xato umuman yo‘qligini tasdiqlamaydi[cite: 10].
Tadqiqot sun’iy intellekt ishlatilishini fosh etadimi?
Yo‘q[cite: 10]. Tadqiqotchilar buni ochiq-oydin ta’kidlashadi[cite: 10]. Qaysidir maqolada kuzatuv ro‘yxatidagi iboralarning ko‘pligi[cite: 10]:
- Matn sun’iy intellekt tomonidan yozilganini[cite: 10],
- Muallif buni ataylab yashirganini[cite: 10],
- Ilmiy ma’lumotlar soxta ekanini[cite: 10],
- Axloq qoidalari buzilganini anglatmaydi[cite: 10].
Xuddi shuningdek, maqolada bu iboralar yo‘qligi unda sun’iy intellekt qo‘llanilmaganidan darak bermaydi[cite: 10]. Katta til modellari turli ko‘rsatmalar bilan turli uslubdagi matnlar yaratishi yoki uning natijasi inson tomonidan to‘liq qayta tahrirlangan bo‘lishi mumkin[cite: 10].
Tadqiqot klassifikator yaratmadi, uning sezuvchanlik yoki o‘ziga xosligini o‘lchamadi hamda sun’iy intellekt yordamida yozilgani isbotlangan test guruhidan (validation set) foydalanmadi[cite: 10].
Yana qanday sabablar bo‘lishi mumkin?
Mualliflar kuzatilgan o‘zgarish bir vaqtning o‘zida yuz bergan bir qator jarayonlardan kelib chiqqan bo‘lishi mumkinligini inkor etishmaydi[cite: 10]:
- Katta til modellarining matn yozishda yordamchi vosita sifatida ishlatilishi[cite: 10],
- Ingliz tilidan ona tili sifatida foydalanmaydigan tadqiqotchilarning nashrlarda faol ishtirok etishi[cite: 10],
- Professional til tahriri xizmatlarining keng tarqalishi[cite: 10],
- Jurnallarning yagona ilmiy uslubga intilishi[cite: 10],
- Muharrir va taqrizchilarning ma’lum iboralarni yoqtirishi[cite: 10],
- Ilmiy maqola yozish ta’limida ma’lum qoliplarning an’anaga aylanishi[cite: 10],
- Onkologiya nashrlarining mavzular doirasi va mualliflar yashaydigan davlatlarga ko‘ra o‘zgarishi[cite: 10].
O‘tmishga yo‘naltirilgan (retrospektiv) matn tahlili bu sabablarni bir-biridan ajratib bera olmaydi[cite: 10].
Sun’iy intellekt orqali matn yozish nima uchun har doim ham yomon emas?
Katta til modellari grammatik xatolarni tuzatish, bayonni soddalashtirish yoki boshqa tildagi matnni akademik ingliz tiliga aylantirish uchun ishlatilishi mumkin[cite: 10]. Ushbu vositalardan foydalanilgan bo‘lsa ham[cite: 10]:
- Ma’lumotlar haqiqiy bo‘lishi[cite: 10],
- Statistik tahlil aniq o‘tkazilgan bo‘lishi[cite: 10],
- Manbalar mualliflar tomonidan tasdiqlangan bo‘lishi[cite: 10],
- Ilmiy xulosalar bevosita tadqiqotchilarning o‘ziga tegishli bo‘lishi mumkin[cite: 10].
Asosiy muammo vositaning ishlatilishida emas, balki bu haqda oshkor etilmasligi, olingan matn tekshirilmasligi yoki vosita tadqiqotchining tanqidiy fikrlashi o‘rnini egallab olishidadir[cite: 10].
Mazkur tadqiqot AI yordamida yozishning xato ehtimolini o‘lchamaganligi sababli, iboralarning ko‘payishi tadqiqot sifatiga salbiy ta’sir ko‘rsatgan degan xulosaga kelib bo‘lmaydi[cite: 10].
Tahririyat siyosatlari uchun ahamiyati
Mualliflar ko‘plab tibbiyot va onkologiya jurnallari AI dan qanday foydalanilganligini ma’lum qilishni talab qilayotganini, ammo bu talabning ijrosi va nazorati doim ham izchil emasligini aytishmoqda[cite: 10].
Tadqiqot yirik nashrlar yig‘indilarida vaqt o‘tishi bilan ro‘y beradigan til o‘zgarishlarini kuzatish mumkinligini isbotlaydi[cite: 10]. Tadqiqotchilar buni ixtiyoriy axborot berish tizimlarining samarasini baholash hamda nashriyot qoidalarini takomillashtirishga xizmat qiladigan nazorat yondashuvi sifatida tavsiya etishmoqda[cite: 10].
Ammo populyatsiya miqyosidagi tildan foydalanish nazorati alohida olingan maqolalarni ayblash vositasi bo‘lmasligi kerak[cite: 10]. Maqolani axloqiy nuqtai nazardan baholash uchun quyidagi to‘g‘ridan-to‘g‘ri dalillar talab qilinadi[cite: 10]:
- Muallifning deklaratsiyasi[cite: 10],
- Dastlabki ma’lumotlar va tahlil hisobotlari[cite: 10],
- Keltirilgan manbalar haqqoniyligi[cite: 10],
- Tahririyat yozishmalari[cite: 10],
- Matnning ilmiy mantiqan izchilligi[cite: 10].
Saraton kasallariga bilvosita ta’siri
Mazkur tadqiqot biror saraton davolash usulini yoki bemor ahvolini o‘rganmagan[cite: 10]. Bemorlarga bevosita klinik tavsiya bermaydi[cite: 10].
Kundalik hayotdagi ta’siri bilvositadir[cite: 10]. Saraton kasalligini davolash qarorlari nashr etilgan maqolalarga asoslangani uchun, ilmiy xabarlar[cite: 10]:
- To‘g‘ri[cite: 10],
- Shaffof[cite: 10],
- Tekshirishga imkon beruvchi[cite: 10],
- Usul va natijalarni farqlovchi[cite: 10],
- Noaniqliklarni aniq bayon qiluvchi bo‘lishi lozim[cite: 10].
Sun’iy intellekt vositalari bu jarayonni yaxshilashi yoxud yomonlashtirishi mumkin[cite: 10]. Natija vositaning qo‘llanilishidan ham ko‘proq tadqiqotchilarning matnni tasdiqlashi va tushuntirish kiritish jarayonlariga bog‘liqdir[cite: 10].
Tadqiqotning kuchli tomonlari
- 21 392 ta nashrdan iborat onkologiya RCTlarining keng korpusi tahlil qilingan[cite: 10].
- 2019-yildan 2026-yilgacha bo‘lgan vaqt oralig‘idagi dinamika o‘rganilgan[cite: 10].
- Iboralar ro‘yxati ma’lumotlarni tahlil qilishdan avval aniq belgilangan[cite: 10].
- PubMed dagi sahifalash muammolarini kamaytirish uchun nashrlar har bir yil uchun alohida qidirilgan[cite: 10].
- To‘liq matnli va faqat annotatsiyadan iborat nashrlar alohida kichik guruhlarda ko‘rib chiqilgan[cite: 10].
- Maqola qismlari bo‘yicha tahlil amalga oshirilgan[cite: 10].
- Statistik ishonchlilik bilan birga ta’sir kattaligi (effect size) ham qayd etilgan[cite: 10].
- Mualliflar natijalar alohida olingan maqolalarda sun’iy intellekt qo‘llanganini isbotlamasligini ochiq e’tirof etishgan[cite: 10].
- Ma’lumot yig‘ish va tahlil jarayoni dasturiy usulda bajarilgan[cite: 10].
- Tadqiqot tilning o‘zgarishini ilmiy soxtakorlik bilan tenglashtirmaslikka e’tibor bergan[cite: 10].
Tadqiqotning zaif tomonlari (cheklovlari)
- Sabab-oqibatni bog‘lab bo‘lmaydi: 2022-yildan keyingi o‘zgarishlar aynan LLM lardan kelib chiqqanligi isbotlanmagan[cite: 10].
- Ibora ro‘yxati to‘g‘ridan-to‘g‘ri sinovdan o‘tmagan: Kuzatuv ro‘yxati sun’iy intellekt yordamida yozilganligi tasdiqlangan onkologiya maqolalarida sezuvchanlik va xoslik jihatidan tekshirilmagan[cite: 10].
- Iboralar insonlar nutqida ham uchraydi: Iboralarning birortasi faqat sun’iy intellektga xos emas[cite: 10].
- To‘liq matn qamrovi cheklangan: Nashrlarning faqat 49% i uchun to‘liq matn topilgan[cite: 10].
- Ochiq foydalanishga oid tanlanma xatosi bo‘lishi mumkin: PubMed Central da to‘liq matni bor nashrlar butun onkologiya sohasidagi adabiyotlarni to‘liq ifodalamasligi mumkin[cite: 10].
- Matn uzunligi turlicha: To‘liq matn va annotatsiyalar uchun bitta o‘lchovdan (xom sonidan) foydalanilgan; regressiya va kichik guruh tahlili bu muammoni kamaytirsa ham, uni butkul bartaraf etmagan[cite: 10].
- Quyi qator (substring) qidiruvi kontekstni ajratmaydi: Iboraning mazmuni yoki qo‘llanilish sababi hisobga olinmagan[cite: 10].
- Bo‘limlarni aniqlash sarlavhalarga bog‘liq: Noodatiy bo‘lim nomlari noto‘g‘ri yoki to‘liqsiz tasniflanishi mumkin[cite: 10].
- O‘lchanmagan qo‘shimcha omillar mavjud: Muallif mamlakati, ona tili, jurnal siyosati, professional tahrir xizmati va nashr mavzusi kabi omillar tekshirilmagan[cite: 10].
- 2026-yil to‘liq emas: So‘nggi yilning ko‘rsatkichi butun taqvim yiliga to‘g‘ri kelmaydi[cite: 10].
- Ta’sir kattaligi kichik: r=0,10 va mutlaq farq 0,31 tani tashkil qiladi[cite: 10].
- GRIM tahlili kam sonli maqolalarga mos: Nashrlarning atigi 48 tasida tahlilni o‘tkazish mumkin bo‘lgan[cite: 10].
- Regressiya detallari yetarli emas: PDF hujjatda model koeffitsiyentlari va to‘liq jadval berilmagan[cite: 10].
- Ma’lumotlar va kod barchaga ochiq repozitoriylarda mavjud emas: Ma’lumotlar bazasi va tahlil kodi o‘rinli talabga asosan muallifdan olinishi aytilgan[cite: 10].
- Hisobot sifatiga baho berilmagan: CONSORT talablariga moslik, manbalarning ishonchliligi yoki klinik xulosalar aniqligi tahlil etilmagan[cite: 10].
Tadqiqot nimani tasdiqlaydi?
- Onkologiya RCT maqolalarida 34 ta qolipli iboraning o‘rtacha qo‘llanishi 2023–2026 yillarda 2019–2022 yillarga qaraganda yuqori ekani kuzatildi[cite: 10].
- Farq katta tanlanmada statistik ahamiyatlilik kasb etdi[cite: 10].
- Ammo bu farqning ko‘lami o‘rtacha darajada (kichik)[cite: 10].
- Yillik o‘rtacha ko‘rsatkich 2019-yildan 2025-yilgacha doimiy ravishda ko‘tarilib bordi[cite: 10].
- 2022 va 2023-yil ko‘rsatkichlari bir xil; yaqqol o‘sish 2024 va 2025-yillarga to‘g‘ri keldi[cite: 10].
- O‘zgarish to‘liq matnli va faqat annotatsiyali guruhlarda bir xil yo‘nalishda kuzatildi[cite: 10].
- Eng katta mutlaq qism o‘zgarishi muhokama bo‘limida yuz berdi[cite: 10].
- Uslubiyat bo‘limidagi mutlaq o‘zgarish sezilarli darajada kichikroq bo‘ldi[cite: 10].
- Onkologik nashrlar tilida butun soha bo‘ylab o‘lchash imkoni bor vaqtinchalik o‘zgarish borligi ma’lum bo‘ldi[cite: 10].
Tadqiqot nimani tasdiqlamaydi?
- Hech qaysi bitta alohida maqola sun’iy intellekt orqali yozilgan deb tasdiqlanmagan[cite: 10].
- Aniqlangan iboralardan foydalangan olimlarning qoidabuzarlik qilganligi ko‘rsatilmagan[cite: 10].
- LLM dan keyingi nashrlarning ilmiy jihatdan xato ko‘proq qilinganligi isbotlanmagan[cite: 10].
- Onkologiya bo‘yicha RCT natijalariga endi ishonib bo‘lmaydi degan xulosa mavjud emas[cite: 10].
- Kuchayib borayotgan uslubiy yondashuv faqat LLM sababli deya tasdiqlanmagan[cite: 10].
- Iboralarning yo‘qligi asarning bevosita odam tomonidan yozilganini bildirmaydi[cite: 10].
- GRIM testida davrlar o‘rtasidagi farq aniqlanmagani sonli hisobot muammolari yo‘qligini anglatmaydi[cite: 10].
- Tadqiqot sun’iy intellektni fosh qiluvchi detektor vositasini yaratgani yo‘q[cite: 10].
- Sun’iy intellektdan foydalanishni taqiqlash kerakligini asoslab bergani yo‘q[cite: 10].
- Ixtiyoriy tarzda sun’iy intellekt ishlatilganini bildirish siyosatlari ta’sirsiz ekanini qiyosiy tekshirmadi[cite: 10].
O‘tmish, bugun va kelajak uchun ahamiyati
O‘tmishda ilmiy maqolalar mualliflar, hammualliflar, malakali muharrirlar hamda nashriyot xodimlari tomonidan yozilgan[cite: 10]. Katta til modellari ushbu ijod jarayoniga keng ko‘lamda va qulay vosita qo‘shdi[cite: 10].
Bugungi kun uchun ushbu tadqiqot ulkan nashrlar zaxirasida tilning o‘zgarish tendensiyasini o‘lchash mumkinligini ochib berdi[cite: 10]. Biroq o‘zgarishning hisobga olinishi uning yagona va aniq sababini ko‘rsatib bermaydi[cite: 10].
Kelajakda quyidagi ishlarning qilinishi zarur[cite: 10]:
- Tadqiqotchilar tomonidan berilgan sun’iy intellektdan foydalanish to‘g‘risidagi ma’lumotlarni real maqola yozilish amaliyoti bilan o‘zaro solishtirish[cite: 10],
- Insonlar va LLM yordamida yozilgan deb kafolatlangan matnlardan tekshiruvchi (validation) ma’lumotlar bazalarini yaratish[cite: 10],
- Til o‘zgarishining CONSORT standartlariga mosligini tekshirish[cite: 10],
- Manbalarning aniqligi hamda soxta havolalar bilan aloqadorlikni baholash[cite: 10],
- Olingan natijalarni saralab berish va ortiqcha xulosalar chiqarish hollarini tadqiq qilish[cite: 10],
- Jurnallar va mamlakatlar bo‘yicha farqlarni hisobga olish[cite: 10],
- LLM dan foydalanishning olimlarning tanqidiy mulohaza va yozish layoqatiga ta’sirini izlanish[cite: 10],
- Sun’iy intellektni faqat tahrirlash uchun hamda to‘liq yozish uchun ishlatilgan matnlarni ajratib o‘rganish[cite: 10].
Tadqiqot uslubi va natijalari
Texnik tadqiqot dizayni
| Xususiyat | Izoh |
|---|---|
| Tadqiqot turi | Retrospektiv korpus tilshunosligi va nashr matni tahlili[cite: 10] |
| Ma’lumot manbai | PubMed va PubMed Central[cite: 10] |
| Qidiruv qilingan sana | 2026-yil may[cite: 10] |
| O‘rganilgan davr | 2019-yildan 2026-yil mayigacha[cite: 10] |
| Jami nashrlar | 21 392 ta onkologiya bo‘yicha randomizatsiyalangan nazorat qilinadigan tadqiqotlar[cite: 10] |
| LLMdan oldingi davr | 2019–2022; n=11 345[cite: 10] |
| LLMdan keyingi davr | 2023–2026-yil may; n=10 047[cite: 10] |
| To‘liq matnli qism | 10 483 ta nashr, 49,0%[cite: 10] |
| Sarlavha va annotatsiya qismi | 10 909 ta nashr, 51,0%[cite: 10] |
| Birlamchi natija | Oldindan tanlangan 34 ta qolipli iboraning maqola boshiga o‘rtacha hisobi[cite: 10] |
| Ikkilamchi qidiruv natijasi | GRIM testi orqali sonli ma’lumotlarning hisobotdagi nomuvofiqligi[cite: 10] |
| Dasturiy vositalar | Python 3.11 bilan axborot izlash; IBM SPSS Statistics 29 tahlil uchun[cite: 10] |
Ma’lumot yig‘ish ketma-ketligi
- Onkologiyaga doir MeSH atamalari RCT nashr filtri bilan qo‘shib foydalanildi[cite: 10].
- 2019–2026 yillar oralig‘ida har yili uchun alohida PubMed so‘rovi berildi[cite: 10].
- PubMed IDlari NCBI E-utilities API si yordamida yig‘ildi[cite: 10].
- PubMed Central bazasida ochiq bo‘lgan XML formatidagi to‘liq matnlar ko‘chirildi[cite: 10].
- To‘liq matni yo‘q nashrlarda sarlavha va annotatsiya olindi[cite: 10].
- Matnlar kichik harf shakliga keltirildi[cite: 10].
- 34 iborani to‘liq mos kelish qoidasi bilan hisoblash amalga oshirildi[cite: 10].
- To‘liq matnli nashrlarda bo‘limlarga bo‘lib sanaldi[cite: 10].
- Davrlar orasidagi tafovutlar Mann-Whitney U testi yordamida aniqlandi[cite: 10].
- Matn turi, e’lon qilingan yil va so‘zlar sonini baholaydigan regressiya rejalashtirildi[cite: 10].
- Raqamli ko‘rsatkichlari mos tushadigan qismga izlanuvchanlik asosidagi GRIM testi bajarildi[cite: 10].
Asosiy davrlar taqqoslanishi
| Natija | LLMdan oldin | LLMdan keyin |
|---|---|---|
| Nashrlar soni | 11 345 | 10 047[cite: 10] |
| O‘rtacha iboralar soni | 0,65 | 0,96[cite: 10] |
| Standart og‘ish | 1,14 | 1,50[cite: 10] |
| 95% ishonch oralig‘i | 0,63–0,67 | 0,93–0,99[cite: 10] |
| Mutlaq farq | Har nashr uchun 0,31 ibora[cite: 10] | |
| Taxminiy nisbiy o‘sish | 48%[cite: 10] | |
| Mann-Whitney U | 51 334 465[cite: 10] | |
| Z ko‘rsatkichi | -14,56[cite: 10] | |
| p qiymati | <0,001[cite: 10] | |
| Ta’sir kattaligi | r=0,10; kichik[cite: 10] | |
To‘liq matnli va faqat annotatsiyali guruhlarning natijalari
| Kichik guruh | LLMdan oldingi o‘rtacha | LLMdan keyingi o‘rtacha | Z | p | r |
|---|---|---|---|---|---|
| To‘liq matn, n=10 483 | 0,88 | 1,28 | -15,46 | <0,001 | 0,11[cite: 10] |
| Faqat annotatsiya, n=10 909 | 0,45 | 0,62 | -5,27 | <0,001 | 0,05[cite: 10] |
Bo‘limlar bo‘yicha texnik qisqacha xulosa
| Bo‘lim | LLMdan oldingi o‘rtacha | LLMdan keyingi o‘rtacha | Mutlaq o‘zgarish | Nisbiy o‘zgarish |
|---|---|---|---|---|
| Kirish | 0,13 ± 0,38 | 0,22 ± 0,55 | +0,09 | +69%[cite: 10] |
| Uslubiyat | 0,08 ± 0,30 | 0,11 ± 0,38 | +0,03 | +38%[cite: 10] |
| Natijalar | 0,20 ± 0,55 | 0,29 ± 0,68 | +0,09 | +45%[cite: 10] |
| Muhokama | 0,88 ± 1,06 | 1,23 ± 1,29 | +0,35 | +40%[cite: 10] |
| Xulosa | 0,10 ± 0,33 | 0,15 ± 0,42 | +0,05 | +50%[cite: 10] |
GRIM tahlili xulosasi
| O‘zgaruvchi | Natija |
|---|---|
| Jami nashrlar | 21 392[cite: 10] |
| GRIM testi uchun yaroqli nashrlar | 48, taxminan 0,2%[cite: 10] |
| Kamida 1 ta nomuvofiqlik chiqqanlari | 29/48, 60,4%[cite: 10] |
| Davrlar qiyoslanishi | Z=-1,72[cite: 10] |
| p qiymati | 0,085[cite: 10] |
| Izoh | Tanlanma o‘ta kichikligi uchun bu ishonchli emas; u davrlar orasida farqni aniqlashga quvvatsizdir.[cite: 10] |
Suratdagi asosiy xulosa nima?
Tadqiqotning natijalar qismidagi chap tarafdagi chiziqli grafikda 2019-2026 yillarda nashriga nisbatan yillik o‘rtacha iboralar tushirilgan[cite: 10]. ChatGPT dan ochiq foydalanish imkoniyati paydo bo‘lgan 2022-yil noyabri qizil uzuq chiziq bilan belgilangan[cite: 10]. Grafik 2019-yildagi o‘rtacha 0,45 ko‘rsatkichi 2025-yilda 1,13 ga o‘sganini, ammo 2022 bilan 2023 oralig‘ida sakrash yo‘qligini ochiqlaydi[cite: 10].
O‘ng tarafda esa gorizontal bar grafik yordamida to‘liq matnlardagi maqola qismlarining ikki davr o‘rtasidagi taqqoslanishi berilgan[cite: 10]. Eng uzun qismlar muhokama bo‘limida yotadi[cite: 10]. LLMdan oldin 0,88 o‘rtacha chiqqan bo‘lsa, keyin u 1,23 ni tashkil etdi[cite: 10].
Grafikning quyi qismida tillik xosliklarni sanab o‘tish aniq bir tadqiqotchi yoki izlanish sun’iy intellektda yozilganini ko‘rsatib bera olmasligiga yana bir karra ishora qiladi[cite: 10]. Turli xalqaro nashriyot tartiblari hamda sun’iy yordamni ushbu tahlil bilan aniq ikkiga bo‘lishning u qadar samarasi yo‘q ekani ham qayd etildi[cite: 10].
Manba va uslubiy izoh
Mazkur material Amina Silva (Amina Silva) va Vanessa Silva ye Silva (Vanessa Silva e Silva) muallifligidagi “Temporal Linguistic Shifts in Oncology Randomized Controlled Trials Following Large Language Model Availability: A Corpus Analysis of 21,392 Publications” nomli ishga asoslanadi[cite: 10].
Mualliflar Kanadadagi Brolk Universitetining (Brock University) Hamshiralik maktabida xizmat qiladi[cite: 10].
Ushbu loyiha bemorlar ishtirok etadigan klinik tajriba, kogorta yoinki randomizatsiyalangan tekshiruv hisoblanmaydi[cite: 10]. Bu PubMed tizimida joylashgan onkologiya RCT maqolalarining so‘zlari bazasini ko‘zdan kechirgan retrospektiv korpus tilshunosligi ishidir[cite: 10]. Ya’ni davolash amaliyotiga daxldor tibbiy yoki bemor haqidagi xulosalarni namoyon etmaydi[cite: 10].
Mazkur ish SSRN sahifasiga preprint holida chiqarilgan[cite: 10]. Xususan, “This preprint research paper has not been peer reviewed” matni aks etgan. Demak, taqriz qilingani yo‘q[cite: 10]. Unga qo‘yilgan jurnalistika siyosatlari haqidagi ko‘rsatmalar ham mustaqil tekshiruv talab qiladi[cite: 10].
Maqolada insonlar haqida to‘g‘ridan-to‘g‘ri ma’lumot to‘planmagan va ochiq bazadan matnlar ajratib olingani bois, uni etika qo‘mitasining tahlilidan mustasno deb ko‘rsatildi[cite: 10].
Mualliflar birorta xolislikka putur yetkazuvchi moliyaviy va manfaatlar to‘qnashuvi yo‘qligini bayon qilganlar[cite: 10].
Shuningdek, Claude nomli katta til modeli faqat bazadan yig‘ish (data collection) kodini shakllantirishda yordam sifatida kiritilgan[cite: 10]. Maqola matnini tayyorlashda yoki baholash va izohlarda Claude foydalanilmagan; yozuv to‘laligicha mualliflar tasdig‘idan o‘tkazilgan[cite: 10].
Bazaviy data set va analiz kodlari ommaga bir tizim asosida tarqatilmagan, lekin so‘rovlar orqali tegishli shaxsdan so‘ralganda berilishi ma’lum qilingan[cite: 10].
Statistik tahlillarda, r=0,10 va 0,31 lik qo‘shimchalar katta ta’sir kuchiga ega emas, deb ko‘rib chiqilishi muhim[cite: 10]. Gigant hajm hisobiga p ni hisoblaganda juda muhim tafovut ko‘rinishi mumkin[cite: 10].
Sanab o‘tilgan iboralar sun’iy intellekt mulki emas[cite: 10]. Shuning uchun har bir e’lon qilingan yoki alohida asarda firibgarlik yuz berdi deya ishonchli hukm qilib bo‘lmaydi[cite: 10].
Aynan shu sababli, GRIM ham zo‘rg‘a 48 maqolaga tatbiq bo‘lgan. P=0,085 natijasi hech bir xatolik qolmagan, deb talqin qilinmasligi ta’kidlanadi[cite: 10].
Ushbu axborot o‘rganilayotgan PDF faylining uslubiyati, natija raqamlari, jadval-grafik va tadqiqotchi tahlilidan kelib chiqqan[cite: 10]. Hujjat taqdim etmagan – mualliflarga tuhmat, AI hukmidagi jurnalistika, muolaja borasidagi klinik bayonlar matnga berilmadi[cite: 10].
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan