

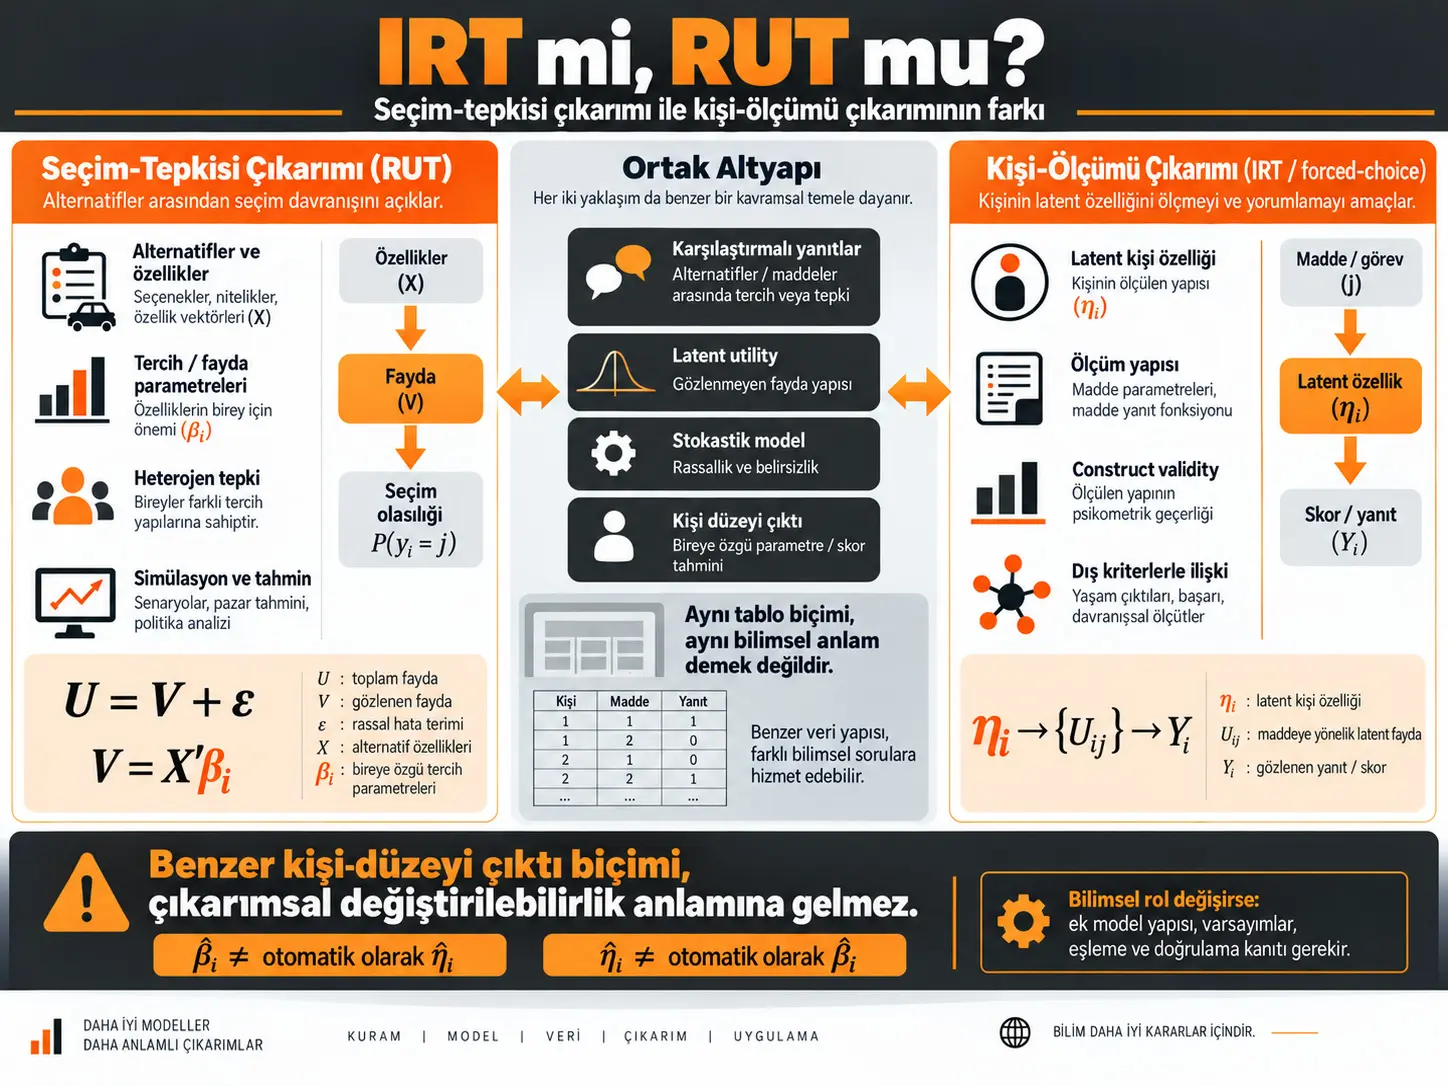
Bu çalışma, IRT tabanlı kişi-ölçümü sistemleri ile Random Utility Theory (RUT) tabanlı seçim modellerinin benzer karşılaştırmalı görevler, latent utility yapıları, heterojenlik modelleri ve kişi-düzeyi tahminler üretebilmesine rağmen bu tahminlere farklı bilimsel roller yükleyebileceğini savunmaktadır. Seçim-tepkisi çıkarımı, bir kişinin alternatifler ve özellikler karşısındaki seçim tepkisini açıklamak ve öngörmek için kişi-düzeyi tercih veya fayda parametreleri üretir. Kişi-ölçümü çıkarımı ise karşılaştırmalı yanıtları ek bir ölçüm yapısı üzerinden belirli bir kişi özelliğinin latent ölçeğinde ölçmeye çalışır.
Kaynağın ana uyarısı, iki yaklaşımın kişi başına tek satırlık benzer tablolar üretmesinin bu tahminleri bilimsel olarak değiştirilebilir hâle getirmediğidir. Bir kişi için \(\beta_i\) biçiminde seçim parametresi elde edilmesi, bunun otomatik olarak \(\eta_i\) türünde kişi özelliği skoru olduğu anlamına gelmez. Ters yönde de aynı sınırlama geçerlidir. Bir tahmine üretildiği rolden farklı bir bilimsel görev yüklemek isteyen analist, bu geçişi destekleyecek ek model yapısı, varsayımlar, eşlemeler ve doğrulama kanıtı sağlamak zorundadır.
Çalışma iki rolü sıralamamaktadır. Temel amaç, hangi soruyu yanıtlamak istediğimiz değiştiğinde hangi model yapısının ve hangi kanıtların gerekli olduğunun değiştiğini görünür kılmaktır. Seçim-tepkisi çıkarımında genelleme, öğrenilen yanıt ilişkisinin yeni seçim ortamlarına taşınmasına odaklanırken; kişi-ölçümünde esas sorun, gözlenen karşılaştırmalı yanıt ile ölçüldüğü ileri sürülen latent kişi özelliği arasındaki ölçüm ilişkisinin yeni bağlamlarda korunmasıdır.
IRT ve RUT Aynı Şeyi mi Ölçer?
Hayır. IRT ve RUT benzer karşılaştırmalı görevler ve latent utility mekanizmaları kullanabilir, ancak bir modelin kişi düzeyinde tahmin üretmesi tek başına onun aynı bilimsel yapıyı ölçtüğü anlamına gelmez; seçim-tepkisi modelleri öncelikle tercih ve tepki ilişkisini, kişi-ölçümü modelleri ise önceden tanımlanmış bir kişi özelliğini ölçmeye çalışır.
Kaynak açısından asıl ayrım iki “model ailesi” arasında değil, iki bilimsel iş arasındadır.
| Rol | Temel amaç | Kişi düzeyi çıktı |
|---|---|---|
| Choice-response inference | Seçim davranışının alternatifler, özellikler ve kişiler arasında nasıl değiştiğini açıklamak ve öngörmek. | Tercih/fayda veya tepki parametreleri, örneğin \(\beta_i\). |
| Person-measurement inference | Karşılaştırmalı yanıtlar üzerinden belirli bir latent kişi özelliğini ölçmek. | Kişinin ilgili yapıda tahmini konumu, örneğin \(\eta_i\). |
İki sistemin matematiksel olarak benzer olması, bilimsel yorumlarının aynı olduğu anlamına gelmez.
Neden karışıklık ortaya çıkıyor?
Her iki gelenek de karşılaştırmalı görevler kullanabilir. Her ikisi de gözlenen yanıtların arkasında latent utility veya benzeri gizil değişkenler tanımlayabilir. Her ikisi de kişi heterojenliğini modelleyebilir ve sonuçta kişi-düzeyi sayılar üretebilir.
Bu nedenle sonuçlar sıradan bir respondent-by-variable tablosuna aktarıldığında, yalnız tabloya bakarak bu sayıların seçim modeli katsayıları mı yoksa kişi-ölçümü skorları mı olduğu anlaşılamayabilir.
| Katılımcı | Değişken 1 | Değişken 2 | Değişken 3 |
|---|---|---|---|
| 1 | 0.42 | -0.17 | 0.81 |
| 2 | 0.11 | 0.53 | -0.24 |
| 3 | -0.28 | 0.06 | 0.47 |
Kaynağın vurgusu tam olarak budur: tablo biçimi, tahminin çıkarımsal kökenini göstermez.
Choice-Response Inference Nedir?
Choice-response inference, kişinin alternatifler ve özellikler karşısında nasıl seçim yaptığına ilişkin sistematik utility ilişkisini modelleyen ve bu ilişkiyi yeni seçim ortamlarındaki davranışları, trade-off'ları veya karar sonuçlarını öngörmek için kullanan çıkarımsal roldür.
RUT tabanlı tipik bir modelde kişi \(i\), alternatif \(j\) ve görev \(t\) için utility şu şekilde temsil edilebilir:
\[ U_{ijt}=V_{ijt}+\varepsilon_{ijt} \]
Burada \(V_{ijt}\) model tarafından açıklanan sistematik utility bileşeni, \(\varepsilon_{ijt}\) ise gözlenmeyen bileşendir.
Yaygın bir sistematik utility gösterimi:
\[ V_{ijt}=X'_{ijt}\beta_i \]
şeklindedir.
\(\beta_i\), kişi \(i\)'nin alternatif özelliklerine verdiği yanıtı veya duyarlılığı temsil eder. Conjoint-benzeri yapılarda bunlar “part-worth” olarak da adlandırılabilir.
Bu parametreler ne işe yarar?
Seçim-tepkisi modelinde katsayıların ana gücü, tekrar seçim sistemine sokulabilmeleridir:
\[ (X,\beta_i)\rightarrow V\rightarrow P(Y|X,\beta_i) \]
Böylece fiyat, ürün özelliği veya seçim ortamındaki başka bir unsur değiştirildiğinde model seçim olasılıklarının nasıl değişebileceğini projekte edebilir.
Uygulamada bu yapı:
- Tercih farklılıklarını incelemek.
- Özellik trade-off'larını değerlendirmek.
- Fiyat duyarlılığını modellemek.
- Yeni ürün veya senaryolardaki seçimleri simüle etmek.
- Karar vericiler için olası piyasa veya talep sonuçlarını öngörmek.
gibi amaçlarla kullanılabilir.
Kişi düzeyi tahmin üretmek bilimsel rolü değiştirir mi?
Hayır. Modern Hierarchical Bayes ve random-coefficient modelleri kişi veya hane düzeyinde \(\beta_i\) tahminleri üretebilir.
Ancak kaynak, kişi başına ayrı katsayı elde edilmesinin bu katsayıyı otomatik olarak psikometrik bir “kişi özelliği ölçümü”ne dönüştürmediğini özellikle vurgulamaktadır.
Tahmin hâlâ, ek ölçüm yapısı ve geçerlilik kanıtı bulunmadıkça, seçim sisteminin içindeki kişi heterojenliğinin parametresidir.
Person-Measurement Inference Nedir?
Person-measurement inference, karşılaştırmalı yanıtları yalnız seçim tepkisi olarak açıklamakla yetinmeyip ek bir ölçüm modeli aracılığıyla bu yanıtları önceden tanımlanmış latent kişi özelliklerine bağlamayı ve kişilerin ortak bir ölçüm ölçeğindeki konumlarını tahmin etmeyi amaçlayan çıkarımsal roldür.
Kaynak, forced-choice kişi-ölçümü sistemini şematik olarak şöyle göstermektedir:
\[ \eta_i \rightarrow \{U_{ij}:j\in B_t\}\rightarrow Y_{it} \]
Burada:
- \(\eta_i\): ölçülmek istenen latent kişi özelliği.
- \(U_{ij}\): kişinin belirli maddeye ilişkin latent utility'si.
- \(B_t\): görev \(t\)'de sunulan madde kümesi.
- \(Y_{it}\): gözlenen karşılaştırmalı yanıt.
Sağ taraftaki ilişki decision model tarafından, sol taraftaki ilişki ise measurement model tarafından açıklanır.
Karşılaştırmalı yanıt tek başına neden yeterli değildir?
Bir kişinin A maddesini B maddesine tercih etmesi yalnızca göreli seçim bilgisidir. Bu yanıtın “dışadönüklük”, “dürüstlük” veya başka bir belirlenmiş psikolojik yapı üzerindeki konuma dönüştürülebilmesi için maddelerin bu yapıyla ilişkisini tanımlayan ek ölçüm yapısı gerekir.
Kaynak bu nedenle karşılaştırmalı görev ile ölçüm sistemini aynı şey saymamaktadır.
Latent ölçeğin tanımlanması geçerliliği otomatik sağlar mı?
Hayır. Bir ortak latent metriğin matematiksel olarak tanımlanması yalnızca skorun tahmin edilebilir olmasını sağlar. Bu skorun gerçekten verilen psikolojik veya davranışsal yapıyı ölçtüğü yorumu ayrıca doğrulama kanıtı gerektirir.
Başka bir ifadeyle:
identification ≠ substantive validity
Kaynak, kişinin latent skorunun diğer ölçülerle beklenen ilişkileri göstermesi ve ilgili dış sonuçları öngörmesi gibi kanıtların ölçüm yorumunu destekleyebileceğini belirtmektedir.
Çalışmanın Yöntemi ve Bulguları
Çalışma tasarımı
Bu makale yeni bir deney, simülasyon benchmark'ı veya IRT–RUT performans yarışması değildir. Çalışma, psikometri ve discrete-choice literatürünü kavramsal olarak karşılaştırarak iki çıkarımsal rol arasındaki sınırı açıklamaktadır.
Başlıca referanslar arasında Böckenholt (2006), Brown (2016), Louviere, Flynn ve Carson (2010), Rossi ve Allenby (1993), Stark, Chernyshenko ve Drasgow (2005) ile Train (2009) bulunmaktadır.
IRT ile RUT Neden Benzer Matematik Kullanabilir?
Her iki yaklaşım da karşılaştırmalı görevlerden gözlenen yanıt üretmek için latent utility ve stokastik seçim mekanizmalarından yararlanabilir; tarihsel olarak Thurstonian comparative judgment geleneği hem psikometrik karşılaştırma modelleriyle hem de sonraki discrete-choice gelişmeleriyle bağlantılıdır.
Kaynak, bu ortak kökenin terminolojik karışıklığı da artırabildiğini belirtmektedir.
Özellikle “conjoint” teriminin geniş kullanımı, geleneksel conjoint analysis ile Random Utility Theory’ye dayalı discrete-choice experiments arasındaki teorik farkların bulanıklaşmasına yol açabilir.
Ortak olanlar
| Ortak unsur | Açıklama |
|---|---|
| Karşılaştırmalı yanıtlar | Kişi iki veya daha fazla seçenek/madde arasında seçim yapabilir. |
| Latent utility | Gözlenen yanıtın arkasında gizil fayda veya tercih yapısı bulunabilir. |
| Stokastik karar modeli | Yanıt deterministik olmak zorunda değildir. |
| Heterojenlik | Kişiler arasında farklı parametreler modellenebilir. |
| Kişi-düzeyi çıktı | Her katılımcı için bir veya daha fazla sayı üretilebilir. |
Ancak bunlar bilimsel rolü belirlemeye yeterli değildir.
Aynı Kişi-Düzeyi Sayı Hem Tercih Parametresi Hem de Kişilik Ölçümü Olabilir mi?
Teorik olarak olabilir; ancak aynı sayının her iki bilimsel rolü de taşıyabilmesi için model yapısının, varsayımların, gerekli eşlemelerin ve doğrulama kanıtının hem seçim-tepkisi hem de kişi-ölçümü yorumunu ayrı ayrı desteklemesi gerekir.
Kaynak bu nedenle şu iki otomatik çıkarımı reddetmektedir:
\[ \hat{\beta}_i \nRightarrow \hat{\eta}_i \]
\[ \hat{\eta}_i \nRightarrow \hat{\beta}_i \]
Bir seçim modelinden kişi başına katsayı üretmek, tek başına onun bir psikolojik özellik ölçümü olduğunu göstermez.
Aynı şekilde, bir psikometrik skorun davranış öngörmesi de onu otomatik olarak seçim sisteminin utility parametresi yapmaz.
Validation neden role göre değişir?
Her iki alanda da doğrulama gerekir; ancak doğrulamanın desteklemeye çalıştığı iddia farklıdır.
| Choice-response inference | Person-measurement inference |
|---|---|
| Öğrenilen seçim ilişkisi yeni seçimlerde ve hedef popülasyonlarda yeterince iyi çalışıyor mu? | Skor, ölçtüğü ileri sürülen kişi özelliği gibi davranıyor mu? |
| Model yeni senaryolardaki seçimleri ve karar sonuçlarını öngörebiliyor mu? | Skor diğer geçerli ölçülerle beklenen biçimde ilişkili mi? |
| Response relationship hedef ortamda genelleniyor mu? | Measurement relationship hedef ortamda korunuyor mu? |
Downstream analiz neden önemlidir?
Person-measurement skorları özellikle kişi-düzeyi değişkenler olarak başka ölçülerle karşılaştırılmak, trait ilişkilerini incelemek veya dış sonuçları tahmin etmek üzere üretilir.
Choice-response parametreleri de kişi düzeyinde heterojenlik analizi için kullanılabilir, ancak merkezi kullanım yollarından biri onları tekrar seçim sistemine koyarak yeni senaryoları simüle etmektir.
Dolayısıyla aynı “regresyon” veya “tahmin” işlemi iki bilimsel rolde farklı anlam taşıyabilir.
Genelleme İki Yaklaşımda Aynı Şeyi mi Gerektirir?
Hayır. Seçim-tepkisi çıkarımında yeni ortamlara taşınması gereken şey seçim yanıtı ile alternatif özellikleri arasındaki öğrenilmiş ilişkidir; kişi-ölçümünde ise gözlenen yanıtlarla latent kişi özelliği arasındaki ölçüm ilişkisinin hedef grup ve koşullarda korunması gerekir.
Bu nedenle bir sayı aynı kalsa bile yeni kullanım bağlamında o sayıya bağlanan bilimsel iddia değişirse yeni bir çıkarımsal yük başlayabilir.
Bilimsel rol değiştiğinde ne gerekir?
Kaynağın en doğrudan sonucu şudur:
Bir tahmini üretildiği bilimsel rolden farklı bir role taşımak isteyen analist, çıkarımsal köprüyü kendisi kurmak zorundadır.
Bu köprü aşağıdakileri gerektirebilir:
- Ek model yapısı.
- Yeni varsayımlar.
- Parametreler arası açık eşleme.
- Yeni identification koşulları.
- Yeni validation kanıtı.
- Hedef popülasyonda genelleme kanıtı.
Çalışmanın desteklediği sonuçlar
- IRT ve RUT benzer matematiksel ve veri yapıları kullanabilir.
- Kişi düzeyinde çıktı üretmek iki yaklaşımı bilimsel olarak aynı yapmaz.
- Choice-response parametrelerinin anlamı tanımlandıkları seçim sistemine bağlıdır.
- Person-measurement skorları ek measurement structure gerektirir.
- Latent metric identification tek başına construct validity değildir.
- Validation ve generalization soruları bilimsel role göre değişir.
- Yeni bilimsel role geçiş ek kanıt gerektirir.
Çalışmanın desteklemediği sonuçlar
- IRT’nin RUT’tan üstün olduğu ileri sürülmemektedir.
- RUT’un IRT’den üstün olduğu ileri sürülmemektedir.
- Kişi-düzeyi choice coefficients hiçbir zaman person measure olamaz denmemektedir.
- Person-measurement skorları hiçbir zaman seçim davranışıyla ilişkili olamaz denmemektedir.
- İki alan arasında kalıcı disipliner sınır bulunduğu savunulmamaktadır.
- Benzer matematik kullanan bütün modellerin aynı inferential role sahip olduğu söylenmemektedir.
Temel sınırlılık
Çalışma kavramsal ayrımı açıklamakta, ancak belirli bir IRT ve RUT modelini aynı veri üzerinde doğrudan ampirik performans karşılaştırmasına tabi tutmamaktadır.
Dolayısıyla başlıktaki “Who Wins?” ifadesi gerçek bir yarışma sonucunu değil, yanlış kurulan üstünlük sorusunu problemleştiren retorik bir çerçeveyi ifade etmektedir.
Kaynak ve Yöntem Notu
Özgün başlık: IRT vs. RUT: Who Wins? Choice-Response Inference, Person-Measurement Inference, and the Limits of Inferential Interchangeability
Yazar: Jake Lee
Kurum: Red Analytics
Tarih: Ağustos 2026
DOI: Kaynak PDF’de verilmemiştir.
Dergi / yayınevi / cilt / sayı: Kaynak PDF’de belirtilmemiştir.
Hakemlik durumu: PDF içinde hakemli yayın bilgisi bulunmamaktadır.
Lisans: Kaynakta açık lisans beyanı bulunmamaktadır.
Çalışma türü: Kavramsal ve metodolojik karşılaştırma.
Ana kavramlar: Choice-response inference, person-measurement inference, Random Utility Theory, Item Response Theory, forced-choice measurement, latent utility, person-level heterogeneity, construct validity.
Temel seçim modeli gösterimi: \(U_{ijt}=V_{ijt}+\varepsilon_{ijt}\), \(V_{ijt}=X'_{ijt}\beta_i\).
Temel kişi-ölçümü gösterimi: \(\eta_i \rightarrow \{U_{ij}:j\in B_t\}\rightarrow Y_{it}\).
Temel çıkarımsal sınır: \(\hat{\beta}_i \nRightarrow \hat{\eta}_i\) ve \(\hat{\eta}_i \nRightarrow \hat{\beta}_i\).
Başlıca kaynaklar: Böckenholt (2006), Brown (2016), Louviere, Flynn ve Carson (2010), Rossi ve Allenby (1993), Stark, Chernyshenko ve Drasgow (2005), Train (2009).
Temel yorum sınırı: Çalışma iki metodolojiyi sıralamamakta; aynı kişi-düzeyi tahmin biçiminin farklı bilimsel rolleri otomatik olarak desteklemediğini göstermektedir. Başka bir role geçiş ancak gerekli ek yapı ve kanıt sağlanırsa savunulabilir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir