

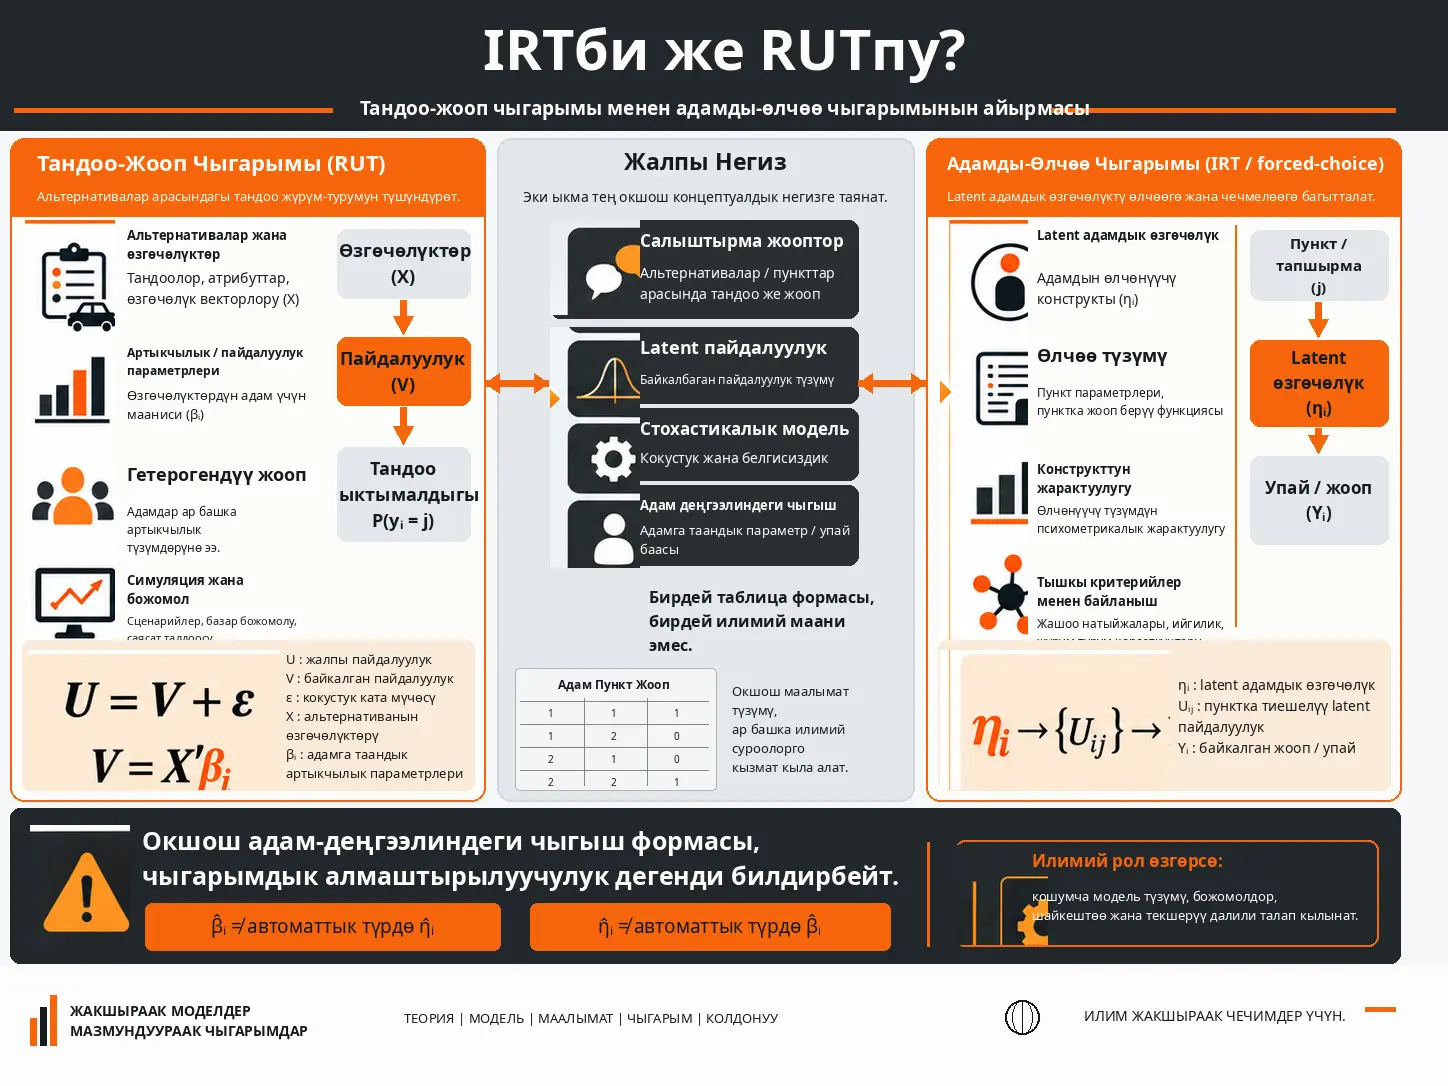
Бул изилдөө IRT негизиндеги адамды-өлчөө системалары менен Random Utility Theory (RUT) негизиндеги тандоо моделдери окшош салыштырма тапшырмаларды, latent utility түзүмдөрүн, гетерогендүүлүк моделдерин жана адам-деңгээлиндеги баалоолорду түзө алганына карабастан, бул баалоолорго ар башка илимий ролдор жүктөлүшү мүмкүн экенин көрсөтөт. Тандоо-жооп чыгарымы адамдын альтернативаларга жана өзгөчөлүктөргө карата тандоо жообун түшүндүрүү жана божомолдоо үчүн адам-деңгээлиндеги артыкчылык же пайдалуулук параметрлерин түзөт. Адамды-өлчөө чыгарымы болсо салыштырма жоопторду кошумча өлчөө түзүмү аркылуу белгилүү бир адамдык өзгөчөлүктүн latent шкаласында өлчөөгө аракет кылат.
Булактын негизги эскертүүсү — эки ыкма ар бир адам үчүн бир саптан турган окшош таблицаларды түзгөнү менен, бул баалоолор илимий жактан өз ара алмаштырылуучу болуп калбайт. Бир адам үчүн \(\beta_i\) түрүндөгү тандоо параметри алынганы анын автоматтык түрдө \(\eta_i\) тибиндеги адамдык өзгөчөлүк упайы экенин билдирбейт. Тескери багытта да ошол эле чектөө колдонулат. Баалоого ал түзүлгөн ролдон башка илимий милдет жүктөгүсү келген аналитик бул өтүүнү колдой турган кошумча модель түзүмүн, божомолдорду, дал келтирүүлөрдү жана текшерүү далилдерин берүүгө тийиш.
Изилдөө эки ролду рейтингдебейт. Негизги максат — жооп бергибиз келген суроо өзгөргөндө кайсы модель түзүмү жана кандай далилдер талап кылынары да өзгөрөрүн көрсөтүү. Тандоо-жооп чыгарымында жалпылоо үйрөнүлгөн жооп мамилесин жаңы тандоо чөйрөлөрүнө көчүрүүгө багытталат; адамды-өлчөөдө болсо негизги маселе байкалган салыштырма жооп менен өлчөнөт деп айтылган latent адамдык өзгөчөлүктүн ортосундагы өлчөө мамилесинин жаңы контексттерде сакталышы болуп саналат.
IRT менен RUT Бир Эле Нерсени Өлчөйбү?
Жок. IRT жана RUT окшош салыштырма тапшырмаларды жана latent utility механизмдерин колдонушу мүмкүн, бирок моделдин адам деңгээлинде баалоо чыгарышы өзүнөн өзү анын ошол эле илимий конструкцияны өлчөп жатканын билдирбейт; тандоо-жооп моделдери биринчи кезекте артыкчылык менен жооп мамилесин, ал эми адамды-өлчөө моделдери алдын ала аныкталган адамдык өзгөчөлүктү өлчөөгө аракет кылат.
Булактын көз карашында негизги айырма эки “модель үй-бүлөсүнүн” ортосунда эмес, эки илимий иштин ортосунда.
| Рол | Негизги максат | Адам деңгээлиндеги чыгыш |
|---|---|---|
| Choice-response inference | Тандоо жүрүм-турумунун альтернативалар, өзгөчөлүктөр жана адамдар арасында кантип өзгөрөрүн түшүндүрүү жана божомолдоо. | Артыкчылык/пайдалуулук же жооп параметрлери, мисалы \(\beta_i\). |
| Person-measurement inference | Салыштырма жооптор аркылуу белгилүү бир latent адамдык өзгөчөлүктү өлчөө. | Адамдын тиешелүү конструкциядагы болжолдуу орду, мисалы \(\eta_i\). |
Эки системанын математикалык жактан окшош болушу алардын илимий түшүндүрмөлөрү бирдей дегенди билдирбейт.
Эмне үчүн чаташуу пайда болот?
Эки салт тең салыштырма тапшырмаларды колдоно алат. Экөө тең байкалган жооптордун артында latent utility же ага окшош жашыруун өзгөрмөлөрдү аныктай алат. Экөө тең адамдык гетерогендүүлүктү моделдеп, натыйжада адам-деңгээлиндеги сандарды чыгара алат.
Ошондуктан натыйжалар кадимки respondent-by-variable таблицасына өткөрүлгөндө, таблицаны эле карап бул сандар тандоо моделинин коэффициенттериби же адамды-өлчөө упайларыбы экенин түшүнүү кыйын болушу мүмкүн.
| Катышуучу | Өзгөрмө 1 | Өзгөрмө 2 | Өзгөрмө 3 |
|---|---|---|---|
| 1 | 0.42 | -0.17 | 0.81 |
| 2 | 0.11 | 0.53 | -0.24 |
| 3 | -0.28 | 0.06 | 0.47 |
Булак баса белгилеген нерсе дал ушул: таблицанын форматы баалоонун чыгарымдык келип чыгышын көрсөтпөйт.
Choice-Response Inference Деген Эмне?
Choice-response inference — адам альтернативалар жана өзгөчөлүктөр алдында кандай тандоо жасаарын сүрөттөгөн системалуу utility мамилесин моделдеген жана бул мамилени жаңы тандоо чөйрөлөрүндөгү жүрүм-турумду, trade-off'тарды же чечим натыйжаларын божомолдоо үчүн колдонгон чыгарымдык рол.
RUT негизиндеги типтүү моделде адам \(i\), альтернатива \(j\) жана тапшырма \(t\) үчүн utility төмөнкүдөй көрсөтүлүшү мүмкүн:
\[ U_{ijt}=V_{ijt}+\varepsilon_{ijt} \]
Бул жерде \(V_{ijt}\) модель түшүндүргөн системалуу utility компоненти, ал эми \(\varepsilon_{ijt}\) — байкалбаган компонент.
Кеңири колдонулган системалуу utility көрсөтүлүшү:
\[ V_{ijt}=X'_{ijt}\beta_i \]
түрүндө.
\(\beta_i\), адам \(i\)'нин альтернатива өзгөчөлүктөрүнө берген жообун же сезгичтигин билдирет. Conjoint сыяктуу түзүмдөрдө алар “part-worth” деп да аталышы мүмкүн.
Бул параметрлер эмне үчүн колдонулат?
Тандоо-жооп моделинде коэффициенттердин негизги күчү — аларды кайра тандоо системасына киргизүүгө болот:
\[ (X,\beta_i)\rightarrow V\rightarrow P(Y|X,\beta_i) \]
Ошентип баа, продукт өзгөчөлүгү же тандоо чөйрөсүндөгү башка элемент өзгөргөндө, модель тандоо ыктымалдыктары кандай өзгөрөрүн проекциялай алат.
Практикада бул түзүм:
- Артыкчылыктардагы айырмачылыктарды изилдөө.
- Өзгөчөлүк trade-off'тарын баалоо.
- Бага сезгичтикти моделдөө.
- Жаңы продукт же сценарийлердеги тандоолорду симуляциялоо.
- Чечим кабыл алуучулар үчүн мүмкүн болгон рынок же суроо-талап натыйжаларын божомолдоо.
сыяктуу максаттарда колдонулушу мүмкүн.
Адам деңгээлиндеги баалоо чыгаруу илимий ролду өзгөртөбү?
Жок. Заманбап Hierarchical Bayes жана random-coefficient моделдери адам же үй-бүлө деңгээлинде \(\beta_i\) баалоолорун чыгара алат.
Бирок булак ар бир адам үчүн өзүнчө коэффициент алынышы ал коэффициентти автоматтык түрдө психометрикалык “адамдык өзгөчөлүк өлчөөсүнө” айлантпай турганын өзгөчө белгилейт.
Кошумча өлчөө түзүмү жана жарактуулук далили болмоюнча, баалоо тандоо системасындагы адамдык гетерогендүүлүктүн параметри бойдон калат.
Person-Measurement Inference Деген Эмне?
Person-measurement inference — салыштырма жоопторду тандоо реакциясы катары гана түшүндүрүп токтобостон, кошумча өлчөө модели аркылуу аларды алдын ала аныкталган latent адамдык өзгөчөлүктөргө байланыштырууну жана адамдардын жалпы өлчөө шкаласындагы орундарын баалоону көздөгөн чыгарымдык рол.
Булак forced-choice адамды-өлчөө системасын схемалык түрдө мындай көрсөтөт:
\[ \eta_i \rightarrow \{U_{ij}:j\in B_t\}\rightarrow Y_{it} \]
Бул жерде:
- \(\eta_i\): өлчөнүүгө тийиш болгон latent адамдык өзгөчөлүк.
- \(U_{ij}\): адамдын белгилүү бир пунктка карата latent utility-си.
- \(B_t\): тапшырма \(t\)'де сунушталган пункттар топтому.
- \(Y_{it}\): байкалган салыштырма жооп.
Оң жактагы мамиле decision model аркылуу, сол жактагы мамиле болсо measurement model аркылуу түшүндүрүлөт.
Эмне үчүн салыштырма жооп өзү эле жетишсиз?
Адамдын A пунктун B пунктуна артык көрүшү салыштырмалуу тандоо маалыматы гана. Бул жоопту “экстраверсия”, “чынчылдык” же башка аныкталган психологиялык конструкциядагы орунга айландыруу үчүн пункттардын ошол конструкция менен байланышын аныктаган кошумча өлчөө түзүмү керек.
Ошондуктан булак салыштырма тапшырма менен өлчөө системасын бир нерсе деп эсептебейт.
Latent шкаланы аныктоо жарактуулукту автоматтык камсыздайбы?
Жок. Жалпы latent метриканы математикалык жактан аныктоо упайдын эсептелишин гана камсыздайт. Бул упай чынында айтылган психологиялык же жүрүм-турумдук конструкцияны өлчөйт деген түшүндүрмө өзүнчө текшерүү далилин талап кылат.
Башкача айтканда:
identification ≠ substantive validity
Булак адамдын latent упайы башка өлчөөлөр менен күтүлгөн мамилелерди көрсөтүшү жана тиешелүү тышкы натыйжаларды божомолдошу сыяктуу далилдер өлчөө түшүндүрмөсүн колдой аларын белгилейт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Изилдөө дизайны
Бул макала жаңы эксперимент, симуляция benchmark'ы же IRT–RUT натыйжалуулук жарышы эмес. Изилдөө психометрия жана discrete-choice адабиятын концептуалдык түрдө салыштырып, эки чыгарымдык ролдун ортосундагы чекти түшүндүрөт.
Негизги шилтемелердин арасында Böckenholt (2006), Brown (2016), Louviere, Flynn жана Carson (2010), Rossi жана Allenby (1993), Stark, Chernyshenko жана Drasgow (2005) менен Train (2009) бар.
IRT менен RUT Эмне үчүн Окшош Математиканы Колдоно Алат?
Эки ыкма тең салыштырма тапшырмалардан байкалган жоопту жаратуу үчүн latent utility жана стохастикалык тандоо механизмдерин колдоно алат; тарыхый жактан Thurstonian comparative judgment салты психометрикалык салыштыруу моделдери менен да, кийинки discrete-choice өнүгүүлөрү менен да байланыштуу.
Булак бул жалпы келип чыгыш терминологиялык чаташууну да күчөтө аларын белгилейт.
Айрыкча “conjoint” термининин кеңири колдонулушу салттуу conjoint analysis менен Random Utility Theory'ге негизделген discrete-choice experiments ортосундагы теориялык айырмачылыктардын бүдөмүктөшүнө алып келиши мүмкүн.
Жалпы элементтер
| Жалпы элемент | Түшүндүрмө |
|---|---|
| Салыштырма жооптор | Адам эки же андан көп вариант/пункт арасында тандоо жасай алат. |
| Latent utility | Байкалган жооптун артында жашыруун пайдалуулук же артыкчылык түзүмү болушу мүмкүн. |
| Стохастикалык чечим модели | Жооп детерминисттик болушу шарт эмес. |
| Гетерогендүүлүк | Адамдар арасында ар башка параметрлер моделдениши мүмкүн. |
| Адам-деңгээлиндеги чыгыш | Ар бир катышуучу үчүн бир же бир нече сан чыгарылышы мүмкүн. |
Бирок булар илимий ролду аныктоого жетишсиз.
Бир Эле Адам-Деңгээлиндеги Сан Артыкчылык Параметри да, Инсандык Өлчөө да Боло Алабы?
Теориялык жактан мүмкүн; бирок бир эле сан эки илимий ролду тең аткара алышы үчүн модель түзүмү, божомолдор, зарыл болгон дал келтирүүлөр жана текшерүү далили тандоо-жооп жана адамды-өлчөө түшүндүрмөлөрүн өз-өзүнчө колдошу керек.
Ошондуктан булак төмөнкү эки автоматтык чыгарымды четке кагат:
\[ \hat{\beta}_i \nRightarrow \hat{\eta}_i \]
\[ \hat{\eta}_i \nRightarrow \hat{\beta}_i \]
Тандоо моделинен ар бир адам үчүн коэффициент чыгаруу анын психологиялык өзгөчөлүк өлчөөсү экенин өзүнөн өзү көрсөтпөйт.
Ошондой эле психометрикалык упай жүрүм-турумду божомолдошу аны автоматтык түрдө тандоо системасынын utility параметрине айлантпайт.
Validation эмне үчүн ролго жараша өзгөрөт?
Эки тармакта тең текшерүү керек; бирок текшерүү колдогусу келген доомат башка.
| Choice-response inference | Person-measurement inference |
|---|---|
| Үйрөнүлгөн тандоо мамилеси жаңы тандоолордо жана максаттуу популяцияларда жетиштүү жакшы иштейби? | Упай өлчөйт деп айтылган адамдык өзгөчөлүк сыяктуу жүрөбү? |
| Модель жаңы сценарийлердеги тандоолорду жана чечим натыйжаларын божомолдой алабы? | Упай башка жарактуу өлчөөлөр менен күтүлгөндөй байланышабы? |
| Response relationship максаттуу чөйрөдө жалпыланабы? | Measurement relationship максаттуу чөйрөдө сакталып калабы? |
Downstream анализ эмне үчүн маанилүү?
Person-measurement упайлары өзгөчө адам-деңгээлиндеги өзгөрмөлөр катары башка өлчөөлөр менен салыштыруу, trait мамилелерин изилдөө же тышкы натыйжаларды божомолдоо үчүн чыгарылат.
Choice-response параметрлери да адам деңгээлиндеги гетерогендүүлүктү талдоо үчүн колдонулушу мүмкүн, бирок алардын негизги колдонуу жолдорунун бири — аларды кайра тандоо системасына киргизип, жаңы сценарийлерди симуляциялоо.
Демек бир эле “регрессия” же “баалоо” операциясы эки илимий ролдо ар башка мааниге ээ болушу мүмкүн.
Жалпылоо Эки Ыкмада Бир Эле Нерсени Талап Кылабы?
Жок. Тандоо-жооп чыгарымында жаңы чөйрөлөргө көчүрүлүшү керек болгон нерсе — тандоо жообу менен альтернатива өзгөчөлүктөрүнүн ортосундагы үйрөнүлгөн мамиле; адамды-өлчөөдө болсо байкалган жооптор менен latent адамдык өзгөчөлүктүн ортосундагы өлчөө мамилеси максаттуу топ жана шарттарда сакталышы керек.
Ошондуктан сан өзгөрбөсө да, жаңы колдонуу контекстинде ал санга байланыштырылган илимий доомат өзгөрсө, жаңы чыгарымдык жүк башталат.
Илимий рол өзгөргөндө эмне керек?
Булактын эң түз жыйынтыгы төмөнкүдөй:
Баалоону ал түзүлгөн илимий ролдон башка ролго өткөргүсү келген аналитик чыгарымдык көпүрөнү өзү курушу керек.
Бул көпүрө төмөнкүлөрдү талап кылышы мүмкүн:
- Кошумча модель түзүмү.
- Жаңы божомолдор.
- Параметрлер ортосунда ачык дал келтирүү.
- Жаңы identification шарттары.
- Жаңы validation далили.
- Максаттуу популяцияда жалпылоо далили.
Изилдөө колдогон жыйынтыктар
- IRT жана RUT окшош математикалык жана маалымат түзүмдөрүн колдоно алат.
- Адам деңгээлинде чыгыш чыгаруу эки ыкманы илимий жактан бирдей кылбайт.
- Choice-response параметрлеринин мааниси алар аныкталган тандоо системасына байланыштуу.
- Person-measurement упайлары кошумча measurement structure талап кылат.
- Latent metric identification өзүнөн өзү construct validity эмес.
- Validation жана generalization суроолору илимий ролго жараша өзгөрөт.
- Жаңы илимий ролго өтүү кошумча далил талап кылат.
Изилдөө колдобогон жыйынтыктар
- IRT RUTтан жогору деп айтылбайт.
- RUT IRTден жогору деп айтылбайт.
- Адам-деңгээлиндеги choice coefficients эч качан person measure боло албайт деп айтылбайт.
- Person-measurement упайлары эч качан тандоо жүрүм-туруму менен байланышта боло албайт деп айтылбайт.
- Эки тармактын ортосунда туруктуу дисциплиналык чек бар деп ырасталбайт.
- Окшош математиканы колдонгон бардык моделдер бирдей inferential role'го ээ деп айтылбайт.
Негизги чектөө
Изилдөө концептуалдык айырманы түшүндүрөт, бирок белгилүү бир IRT жана RUT моделин бир эле маалыматтын үстүндө түз эмпирикалык натыйжалуулук салыштыруусуна салбайт.
Ошондуктан аталыштагы “Who Wins?” сөзү чыныгы жарыштын жыйынтыгын эмес, туура эмес коюлган артыкчылык суроосун көйгөйлөштүргөн риторикалык алкакты билдирет.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: IRT vs. RUT: Who Wins? Choice-Response Inference, Person-Measurement Inference, and the Limits of Inferential Interchangeability
Автор: Jake Lee
Мекеме: Red Analytics
Дата: Август 2026
DOI: Булак PDFде берилген эмес.
Журнал / басмакана / том / номер: Булак PDFде көрсөтүлгөн эмес.
Рецензия абалы: PDF ичинде рецензияланган жарыя тууралуу маалымат жок.
Лицензия: Булакта ачык лицензия тууралуу билдирүү жок.
Изилдөө түрү: Концептуалдык жана методологиялык салыштыруу.
Негизги түшүнүктөр: Choice-response inference, person-measurement inference, Random Utility Theory, Item Response Theory, forced-choice measurement, latent utility, person-level heterogeneity, construct validity.
Негизги тандоо модели көрсөтүлүшү: \(U_{ijt}=V_{ijt}+\varepsilon_{ijt}\), \(V_{ijt}=X'_{ijt}\beta_i\).
Негизги адамды-өлчөө көрсөтүлүшү: \(\eta_i \rightarrow \{U_{ij}:j\in B_t\}\rightarrow Y_{it}\).
Негизги чыгарымдык чек: \(\hat{\beta}_i \nRightarrow \hat{\eta}_i\) жана \(\hat{\eta}_i \nRightarrow \hat{\beta}_i\).
Негизги булактар: Böckenholt (2006), Brown (2016), Louviere, Flynn жана Carson (2010), Rossi жана Allenby (1993), Stark, Chernyshenko жана Drasgow (2005), Train (2009).
Негизги түшүндүрмө чеги: Изилдөө эки методологияны рейтингдебейт; бирдей адам-деңгээлиндеги баалоо формасы ар башка илимий ролдорду автоматтык түрдө колдобой турганын көрсөтөт. Башка ролго өтүү зарыл кошумча түзүм жана далил берилгенде гана корголушу мүмкүн.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген