

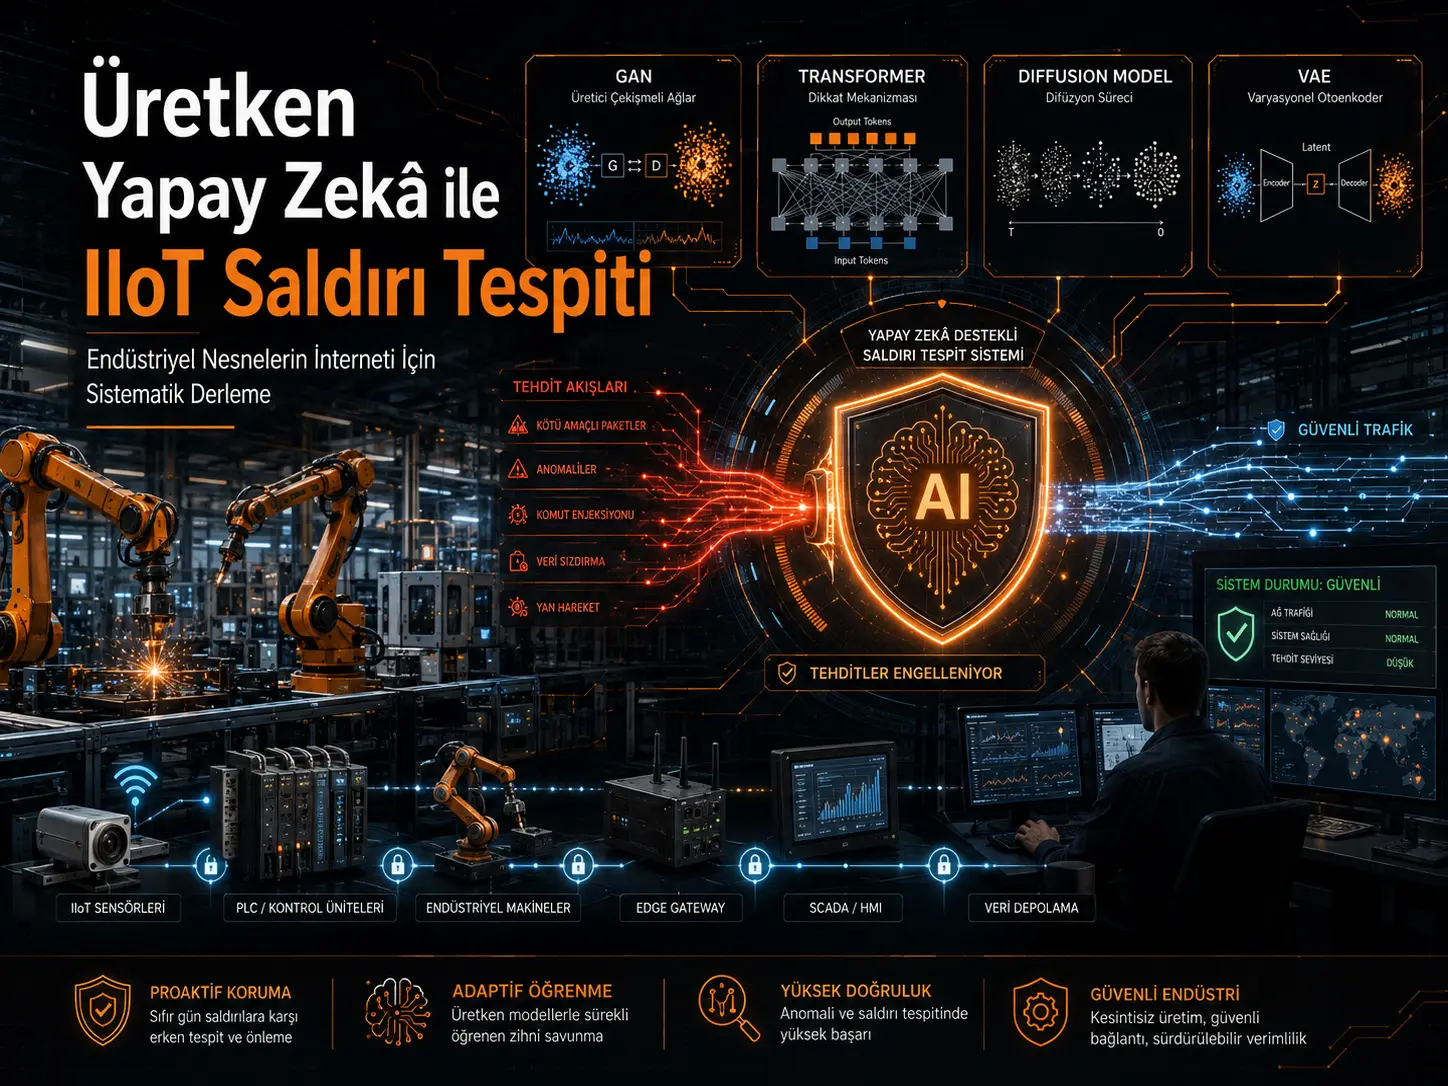
Bu sistematik derleme, Endüstriyel Nesnelerin İnterneti (Industrial Internet of Things, IIoT) ortamlarında saldırı tespit sistemlerinin üretken yapay zekâ ile nasıl güçlendirilebileceğini inceliyor. Araştırmacılar IEEE Xplore, ACM Digital Library, Springer, ScienceDirect ve arXiv üzerinde Ocak 2019-Aralık 2025 dönemini taramış; 342 başlangıç kaydını aşamalı olarak eleyerek 42 çalışmayı sistematik senteze dahil etmiştir. İnceleme dört ana üretken yapay zekâ paradigmasına odaklanıyor: Üretken Çekişmeli Ağlar (GAN), Transformer mimarileri, üretken difüzyon modelleri ve Değişimsel Otokodlayıcılar (VAE). Dokuz uygulama çerçevesinin karşılaştırılması, Transformer tabanlı hibritlerin özellikle yüksek doğruluk ve kararlılık açısından güçlü sonuçlar verdiğini, Diff-IDS gibi difüzyon tabanlı yaklaşımların ise model sıkıştırma bakımından daha kaynak-verimli seçenekler sunduğunu gösteriyor. Bununla birlikte çalışmaların farklı veri kümeleri, deney protokolleri ve istatistiksel doğrulama yöntemleri kullanması nedeniyle bildirilen yüksek doğruluk değerleri doğrudan gerçek endüstriyel saha başarısı olarak yorumlanamaz.
Derlemenin temel mesajı, IIoT güvenliğinde tek bir üretken yapay zekâ mimarisinin her saldırı ve donanım koşulu için üstün olmadığıdır. GAN'lar az görülen saldırı sınıfları için sentetik veri üretiminde, Transformer'lar uzun zaman aralıklarına yayılan çok aşamalı saldırı örüntülerinde, VAE'ler etiketli saldırı verisinin sınırlı olduğu anomalilerin ve sıfırıncı gün tehditlerinin belirlenmesinde, difüzyon modelleri ise yüksek kaliteli üretim ve bazı sıkıştırılmış uygulamalarda kaynak verimliliğinde öne çıkmaktadır. Buna karşılık gerçek tesis verisi, endüstriyel protokol çeşitliliği, kavram kayması, açıklanabilirlik, düşük yanlış alarm oranı ve çok sıkı gerçek zaman gereksinimleri hâlen önemli araştırma açıklarıdır.
IIoT güvenliği neden klasik ağ güvenliğinden farklı?
Endüstriyel Nesnelerin İnterneti; sensörleri, aktüatörleri, programlanabilir mantık denetleyicilerini (PLC), uzak terminal birimlerini (RTU), SCADA sistemlerini, endüstriyel uygulamaları, ağ geçitlerini ve bulut altyapılarını birbirine bağlar. Bu bağlantı, üretim ve kontrol süreçlerinin daha görünür ve otomatik hâle gelmesini sağlarken saldırı yüzeyini de büyütür.
Derlemenin vurguladığı temel ayrım, klasik bilgi teknolojisi ortamlarında gizlilik öncelikli olabilirken operasyonel teknoloji (Operational Technology, OT) ortamlarında kullanılabilirlik, bütünlük ve fiziksel süreç güvenliğinin kritik hâle gelmesidir. Yanlış bir güvenlik kararı yalnızca bilgisayar hizmetini kesmeyebilir; üretim hattının durmasına, kontrol komutlarının değişmesine veya güvenlik mekanizmalarının işleyişinin etkilenmesine yol açabilir. Bu nedenle IIoT saldırı tespit sistemi yalnızca yüksek doğruluk değil, düşük yanlış alarm oranı, kabul edilebilir gecikme ve fiziksel süreçle uyum da sağlamalıdır.
Geleneksel makine öğrenmesi neden yeterli olmayabiliyor?
Derleme dört temel problemi öne çıkarıyor. Birincisi, gerçek endüstriyel saldırılar görece seyrek olduğu için etiketlenmiş saldırı örneği azdır. İkincisi, normal trafik saldırı trafiğini bazı durumlarda 1000:1'i aşan oranlarda geride bırakabilir; bu sınıf dengesizliği yüksek toplam doğruluk veren fakat nadir saldırıları kaçıran modeller oluşturabilir. Üçüncüsü, saldırı teknikleri ve normal işletme davranışı zamanla değişmektedir. Dördüncüsü, güçlü derin öğrenme modellerinin bellek ve hesaplama gereksinimleri endüstriyel uç cihazların kapasitesini aşabilir.
Üretken yapay zekânın araştırmadaki rolü tam olarak bu noktada ortaya çıkıyor: saldırı örnekleri üretmek, normal davranış dağılımını modellemek, bilinmeyen örüntüleri anomali olarak belirlemek ve uzun trafik dizilerindeki bağlamı analiz etmek.
Dört üretken yapay zekâ paradigması ne yapıyor?
| Paradigma | IIoT güvenliğindeki temel rolü | Öne çıkan avantaj | Temel sınırlılık |
|---|---|---|---|
| GAN | Azınlık saldırı sınıfları için sentetik veri üretimi, veri dengeleme ve çekişmeli güvenlik testi | Nadir saldırı örneklerini çoğaltabilme | Mode collapse ve eğitim kararsızlığı; yüksek hesaplama gereksinimi |
| Transformer | Uzun zaman aralıklarına yayılan trafik ve saldırı dizilerinin modellenmesi | Uzun menzilli bağımlılıkları ve çok aşamalı saldırıları yakalama | Yüksek bellek ve hesaplama maliyeti; self-attention karmaşıklığı |
| Difüzyon modeli | Sentetik saldırı üretimi ve yeniden yapılandırma tabanlı anomali analizi | Kararlı eğitim ve yüksek kaliteli örnek üretimi; sıkıştırılmış modellerde kaynak avantajı | Çok adımlı denoising nedeniyle çıkarım gecikmesi |
| VAE | Normal davranışın olasılıksal modellenmesi ve yeniden yapılandırma hatasıyla anomali tespiti | Etiketli saldırı örneğine daha az bağımlılık ve belirsizlik modelleme | Yaklaşık posterior çıkarımı ve üretilen örneklerin daha düşük keskinliği |
Bu karşılaştırmanın önemli sonucu, “en iyi üretken yapay zekâ modeli” şeklinde tek bir cevap bulunmamasıdır. Model seçimi saldırının yapısına, veri miktarına, kullanılabilecek donanıma, gecikme bütçesine ve veri gizliliği gereksinimlerine göre değişmektedir.
GAN'lar sınıf dengesizliğini nasıl ele alıyor?
GAN mimarisi bir üretici (generator) ile bir ayırt edicinin (discriminator) rekabetine dayanır. Üretici gerçek saldırı trafiğine benzeyen sentetik örnekler oluşturmaya, ayırt edici ise gerçek ile sentetik örnekleri ayırmaya çalışır. İncelenen güvenlik uygulamalarında CGAN, WGAN, BiGAN, DCGAN, AC-GAN ve SAGAN gibi varyantlar kullanılmıştır.
IIoT açısından en önemli kullanım, nadir saldırı sınıflarını sentetik örneklerle güçlendirmektir. Ancak sentetik veri otomatik olarak “gerçekçi” kabul edilemez. GAN yalnızca eğitim verisinde temsil edilen dağılımları öğrenebilir; yetersiz veya tekdüze saldırı örneklerinden üretilen sentetik trafik sınıflandırıcının gerçek dünyadaki başarısını artırmak yerine yanıltabilir. Bu nedenle çalışma, üretken veri artırmanın bağımsız test kümelerinde doğrulanmasının önemini vurgulamaktadır.
Transformer'lar neden APT ve çok aşamalı saldırılar için ilgi çekiyor?
Transformer mimarilerindeki self-attention mekanizması, trafik dizisinin farklı bölümleri arasındaki ilişkileri aynı model içinde değerlendirebilir. Bu özellik, tek bir paket veya kısa zaman penceresi içinde belirgin olmayan; keşif, erişim, yanal hareket ve etki gibi aşamalara yayılan saldırı dizilerinin incelenmesi açısından önemlidir.
Derlemede BERT tabanlı, GPT tabanlı, Vision Transformer ve federated Transformer türleri ele alınmaktadır. Buna karşılık attention işleminin dizi uzunluğuna bağlı yüksek hesaplama maliyeti, Transformer'ları doğrudan PLC ve benzeri düşük kaynaklı cihazlara yerleştirmeyi güçleştirmektedir. İncelenen pratik çerçevelerde bu nedenle Transformer'lar daha çok merkezi bulut veya güvenlik katmanlarında konumlandırılmaktadır.
Difüzyon modellerinde denoising ne anlama geliyor?
Difüzyon modelleri veriyi ileri süreçte aşamalı olarak gürültüye dönüştürür; öğrenilen ters süreç ise bu gürültülü temsilden veri yapısını yeniden kurmaya çalışır. Çalışmada verilen temel eğitim hedefi şöyledir:
\[ \min_{\theta}\mathbb{E}\left[\left\|\epsilon-\epsilon_{\theta}(x_t,t)\right\|^2\right] \]
Burada \(\epsilon\) örneğe eklenen gerçek gürültüyü, \(\epsilon_{\theta}(x_t,t)\) modelin \(t\) adımındaki gürültü tahminini, \(\theta\) ise öğrenilen model parametrelerini temsil eder. Amaç, gerçek gürültü ile model tarafından tahmin edilen gürültü arasındaki karesel farkı küçültmektir. Çalışmanın Şekil 6'sı ileri Markov zinciriyle özgün veriden gürültüye geçişi ve ters zincirle yeniden yapılandırmayı birlikte göstermektedir.
Difüzyon yaklaşımının avantajı GAN'lardaki mode collapse problemine karşı daha kararlı bir eğitim mekanizması sunabilmesidir. Dezavantajı ise ters denoising işleminin çok sayıda adım gerektirebilmesi ve bunun çıkarım gecikmesini artırmasıdır.
VAE'ler bilinmeyen saldırıları nasıl yakalamaya çalışıyor?
Değişimsel Otokodlayıcılar (Variational Autoencoders, VAE) normal trafiği tek bir sabit kodla değil, olasılıksal bir gizil uzay dağılımıyla temsil eder. Encoder giriş verisini gizil dağılım parametrelerine dönüştürür; decoder bu gizil örnekten girdiyi yeniden oluşturmaya çalışır. Normal davranış üzerinde eğitilmiş bir VAE'nin saldırı veya olağandışı trafik karşısında yeniden yapılandırma hatasının yükselmesi, anomali işareti olarak kullanılabilir.
Bu yaklaşım özellikle çok sayıda etiketlenmiş saldırı örneğinin bulunmadığı durumlarda değerlidir. Bununla birlikte “modelin daha önce görmediği her şey saldırıdır” sonucu çıkarılamaz. Üretim planındaki değişiklik, yeni cihaz eklenmesi, firmware güncellemesi veya bakım modu gibi meşru işletme değişiklikleri de normal veri dağılımını kaydırabilir.
Kavram kayması neden IIoT için kritik?
Çalışma concept drift sorununu endüstriyel IDS için merkezi bir problem olarak ele almaktadır. Bir fabrikanın gece ve gündüz çalışma düzeni, bakım dönemleri, yeni üretim reçeteleri, cihaz değişimleri, firmware güncellemeleri veya ağ topolojisi değişiklikleri “normal” kabul edilen trafik dağılımını zaman içinde değiştirebilir.
Statik model bu değişiklikleri saldırı olarak işaretleyebilir veya sürekli yeniden eğitildiğinde geçmiş saldırı bilgilerini unutabilir. Derleme bu nedenle drift tespiti, drift'in nedenini belirleme, güvenli model uyarlaması ve uyarlama sonrası doğrulamanın tek bir sürekli öğrenme zinciri içinde ele alınmasını gelecekteki temel araştırma alanlarından biri olarak göstermektedir.
Endüstriyel protokoller neden ayrıca modellenmeli?
Derlemede Modbus TCP, MQTT, CoAP ve OPC UA başta olmak üzere endüstriyel iletişim protokollerinin farklı güvenlik özelliklerine sahip olduğu vurgulanmaktadır. Bu nedenle yalnız paket istatistiklerine bakan genel bir IDS, protokolün anlamını ihlal eden fakat biçimsel olarak geçerli görünen komutları kaçırabilir.
Çalışmanın yaklaşımına göre protokol-farkındalıklı modeller, mesaj sırasını, işlev kodlarını, normal komut-cevap ilişkilerini ve proses bağlamını da hesaba katmalıdır. Ancak incelenen veri kümelerinde gerçek OT protokollerinin temsilinin sınırlı olması, protokol bazlı üstünlük iddialarının önemli bir bölümünü henüz tam olarak doğrulanmamış bırakmaktadır.
Çalışmanın desteklediği ve desteklemediği sonuçlar
Çalışmanın desteklediği sonuç: Üretken yapay zekâ; sınıf dengesizliği, sentetik veri üretimi, olasılıksal anomali tespiti ve uzun dönemli saldırı örüntülerinin analizi için yararlı araçlar sunmaktadır. Farklı paradigmaların farklı tehdit ve altyapı koşullarında avantajları vardır. Hibrit ve katmanlı mimariler, tek modele dayalı çözümlerden daha gerçekçi bir endüstriyel tasarım yaklaşımı olarak ortaya çıkmaktadır.
Çalışmanın desteklemediği sonuç: İncelenen yüksek benchmark doğrulukları, herhangi bir modelin gerçek fabrikalarda aynı başarıyı göstereceğini kanıtlamamaktadır. Çalışma bütün modellerin aynı veri setinde ve aynı donanımda karşılaştırıldığı kontrollü bir deney değildir. Bu nedenle %99 civarındaki iki sonuç yalnız rakamlarına bakılarak birbirinden üstün ilan edilemez. Derleme ayrıca üretken yapay zekânın tek başına geleneksel güvenlik kontrollerinin veya defense-in-depth mimarisinin yerine geçmesini önermemektedir.
Türkiye açısından ne ifade ediyor?
Çalışma Türkiye'ye özgü endüstriyel tesis verisi kullanmamaktadır ve Türkiye'deki fabrikalar için doğrudan performans sonucu vermemektedir. Bu nedenle bildirilen doğrulukların Türkiye'deki bir üretim tesisine doğrudan aktarılması doğru olmaz. Yerel uygulamada kullanılan PLC/SCADA donanımı, endüstriyel protokoller, ağ topolojisi, normal üretim davranışı, saldırı sınıf dağılımı ve kullanılabilir hesaplama altyapısı üzerinde yeniden doğrulama gerekir. Çalışmadan Türkiye için çıkarılabilecek en güvenli sonuç, model seçiminin yalnız laboratuvar doğruluğuna değil gerçek tesisin OT mimarisine ve gecikme gereksinimine göre yapılması gerektiğidir.
Çalışmanın Yöntemi ve Bulguları
Sistematik derleme nasıl yürütüldü?
Araştırma PRISMA 2020 ilkelerinden uyarlanmış yapılandırılmış bir sistematik inceleme yöntemi kullanmıştır. Taramalar IEEE Xplore, ACM Digital Library, Springer, ScienceDirect ve arXiv üzerinde yürütülmüş ve Ocak 2019-Aralık 2025 dönemindeki yayınlar hedeflenmiştir. Arama sorguları üç kavram grubunu birleştirmiştir: üretken yapay zekâ teknikleri; intrusion/anomaly/threat detection ve cybersecurity kavramları; IIoT, SCADA, ICS, OT ve cyber-physical system kavramları.
Veritabanı taramasına ileri atıf izleme, geriye doğru kaynak taraması ve belirli güvenlik konferanslarının ilgili çalışmalarının manuel incelenmesi de eklenmiştir. İnceleme Open Science Framework üzerinde kaydedilmiş olmakla birlikte, araştırmacılar çalışma başlamadan önce resmî bir protokol hazırlamadıklarını açıkça belirtmiştir.
| Kaynak | Başlangıç kaydı |
|---|---|
| IEEE Xplore | 145 |
| ACM Digital Library | 87 |
| Springer | 58 |
| ScienceDirect | 32 |
| arXiv | 20 |
| Toplam | 342 |
Verianla Live: 342 kayıttan 42 çalışmaya sistematik seçim
Bu süreç, çalışmanın PRISMA seçim akışındaki gerçek sayıları gösterir. Aşamalar araştırmacıların bildirdiği sırada tutulmuştur; araya kaynakta olmayan eleme basamağı eklenmemiştir.
| Aşama | Açıklama | Kaynak |
|---|---|---|
| 1. Tanımlama | Beş veri tabanında toplam 342 kayıt belirlendi. | Şekil 2 / Bölüm 1.2.3 |
| 2. Başlık ve özet taraması | 342 kayıt tarandı; 172 kayıt dışlandı ve 170 çalışma tam metin değerlendirmesine aday kaldı. | Şekil 2 / Bölüm 1.2.3 |
| 3. Tam metin uygunluk değerlendirmesi | 170 çalışmadan 43'ü dışlandı; 127 çalışma kalite değerlendirmesine geçti. | Şekil 2 / Bölüm 1.2.3 |
| 4. Kalite değerlendirmesi ve nihai seçim | 127 çalışmadan 85'i dışlandı; sistematik senteze 42 çalışma dahil edildi. | Şekil 2 / Bölüm 1.2.3 |
Verianla Live: Görselleştirme, bu makaledeki görünür bilimsel veri tablosundan tarayıcıda oluşturulur. Tablo bilimsel kaynak-of-truth olarak korunur.
Seçim ve kalite değerlendirmesinin sınırı
Başlık/özet, tam metin ve kalite aşamalarındaki tarama baş yazar tarafından, kıdemli yazarın gözetimi altında yürütülmüştür. Araştırmacılar PRISMA'nın bağımsız iki değerlendiricili taramayı önerdiğini, ancak kaynak kısıtları nedeniyle tek değerlendirici ve danışman gözetimi yaklaşımını kullandıklarını belirtmektedir.
Kalite değerlendirmesinde standartlaştırılmış nicel bir puanlama aracı kullanılmamıştır. Çalışmalar benchmark veri seti kullanımı, baseline karşılaştırması, deney protokolünün açıklığı, istatistiksel geçerlilik, yeniden üretilebilirlik göstergeleri ve endüstriyel uygulanabilirlik gibi ölçütlerle anlatısal olarak değerlendirilmiştir. Kanıt kesinliği de resmi GRADE benzeri bir sistem yerine tutarlılık, önyargı riski, IIoT'ye doğrudanlık ve istatistiksel hassasiyet temelinde anlatısal biçimde sınıflandırılmıştır.
İncelenen dokuz uygulama çerçevesi
Derleme dokuz çerçeveyi ayrıntılı olarak analiz etmektedir: DRL-GAN, EO-WGAN, Diff-IDS, AE-AnoWGAN, FedGenID, Transformer-GAN, Transformer-GAN-AE, SAPGAN ve HMFFGAN. Bunlar aynı deneyin dokuz kolu değildir; farklı çalışmaların, farklı veri kümelerinin ve farklı donanım koşullarının sonuçlarıdır.
| Çerçeve / veri kümesi | Kaynakta bildirilen temel sonuç | Yorum sınırı |
|---|---|---|
| DRL-GAN — DS2OS | Doğruluk %99,05; precision %99,17; F1 %99,09 | Aşırı dengesiz DS2OS bağlamındaki sonuçtur; yüksek hesaplama gereksinimi bildirilmiştir. |
| Transformer-GAN — CIC-IoT-2023 | Doğruluk %99,67; F1 %99,61; AUC %99,80 | Başka veri kümelerinde elde edilen modellerle doğrudan sıralama yapılamaz. |
| Transformer-GAN — TON_IoT | Doğruluk %98,84; F1 %98,79; AUC %99,12 | TON_IoT'nin veri dağılımı ve deney protokolüne bağlıdır. |
| Transformer-GAN-AE — WUSTL-IIoT-2021 | Doğruluk %97,86; recall %98,63; AUC %99,18 | Üç bileşenli mimari yüksek kaynak ve uzmanlık gerektirir. |
| Transformer-GAN-AE — Edge-IIoTset | Doğruluk %98,63; recall %98,79; AUC %99,53 | Benchmark sonucu gerçek tesis doğrulaması değildir. |
| Transformer-GAN-AE — TON_IoT | Doğruluk %98,92; recall %99,52; AUC %99,87 | Kaynak, düşük varyans bildirse de çapraz çalışma sıralaması sınırlıdır. |
| Diff-IDS — CIC-IDS2017 | Doğruluk %99,93 | Çalışma ayrıca modele göre 76× boyut küçülmesi bildirir; benchmark endüstriyel saha testi değildir. |
| Diff-IDS — KDD99 | Doğruluk %99,97 | KDD99 modern IIoT operasyonunun doğrudan temsili değildir. |
| Diff-IDS — NSL-KDD | Doğruluk %99,84 | Endüstriyel protokol çeşitliliğini sınırlı temsil eder. |
| FedGenID — Real-TestSet | DP olmadan %92,72; diferansiyel gizlilik ile %92,47 | Kaynakta bu iki değer arasında 0,25 yüzde puanı doğruluk maliyeti görülmektedir. |
| FedGenID — Augmented-TestSet | DP olmadan %92,17; DP ile %92,17 | Kaynak anlatımındaki “14 yüzde puanı” ifadesi tablo değerleriyle aritmetik olarak uyuşmamaktadır. |
Bu tablo, en yüksek sayıyı “kazanan model” olarak göstermek için değil, derlemenin hangi sonuçları hangi veri kümeleri bağlamında aktardığını görünür kılmak için hazırlanmıştır.
Performansın arkasındaki asıl bulgu: doğruluk kadar dağıtım katmanı da önemli
Derlemenin mimari analizi, dokuz çerçeveden altısının ağırlıklı olarak merkezi bulut altyapısına ihtiyaç duyduğunu bildiriyor. Diff-IDS Edge/Processing katmanına yönelik sıkıştırılmış bir seçenek olarak, FedGenID ise edge ve cloud katmanlarını birleştiren federated yapı olarak ayrışıyor. Transformer-GAN ve Transformer-GAN-AE gibi modeller daha yüksek hesaplama altyapısı gerektiriyor.
| Dağıtım gereksinimi | Çalışmanın öne çıkardığı yaklaşım | Temel gerekçe |
|---|---|---|
| Edge üzerinde otonom tespit | Diff-IDS | 76× model sıkıştırması ve yerel çalışma potansiyeli |
| Maksimum benchmark performansı / kritik altyapı | Transformer-GAN-AE | Düşük bildirilen varyans ve yüksek AUC; ancak yüksek donanım maliyeti |
| Aşırı sınıf dengesizliği | EO-WGAN | SMOTE + WGAN ile iki aşamalı örnek artırma |
| Çok aşamalı APT | Transformer-GAN / Transformer-GAN-AE | Uzun dönemli zamansal ilişkilerin modellenmesi |
| Sıfırıncı gün / etiketsiz anomali | AE-AnoWGAN veya VAE tabanlı yaklaşımlar | Yeniden yapılandırma ve normal davranış modelleme |
| Çok tesisli, veri gizliliği kısıtlı ortam | FedGenID | Ham veriyi merkezileştirmeden federated öğrenme |
| <10 ms gerçek zamanlı kontrol | İncelenen GenAI çerçevelerinden hiçbiri | Çalışmanın nihai karar ağacı bu seviyede klasik/kural tabanlı ilk savunmayı önermektedir. |
En güçlü metodolojik uyarı: %99 doğruluk gerçek fabrika garantisi değil
Derlemenin kendi karşılaştırmalı analizine göre veri seti heterojenliği, farklı train/test bölmeleri, farklı preprocessing yöntemleri, farklı baseline modeller ve farklı donanımlar doğrudan karşılaştırmayı sınırlandırmaktadır. Aynı mimari farklı deney protokollerinde birkaç yüzde puan değişebileceği için çapraz çalışma performans farklarının mutlak bir lig tablosuna dönüştürülmemesi gerekir.
Dokuz ayrıntılı çerçeveden yalnız üçünün formal istatistiksel anlamlılık değerlendirmesi bildirdiği belirtilmektedir. Transformer-GAN-AE için çok düşük varyans değerleri rapor edilse de, tüm modellerin aynı koşullarda karşılaştırılmamış olması nedeniyle derlemenin genel kanıt kesinliği doğrudan model sıralamalarında düşük; Transformer'ların zamansal modelleme avantajında orta; GAN tabanlı veri artırmanın dengesiz veri üzerindeki yararında ise daha yüksek olarak yorumlanmaktadır.
Veri kümeleri neden kritik?
Derleme Edge-IIoTset, CIC-IoT-2023, TON_IoT, WUSTL-EHMS, DS2OS, NSL-KDD, SWaT ve WADI gibi veri kümelerini tartışmaktadır. Çalışmanın önemli tespitlerinden biri, gerçek endüstriyel protokol trafiğinin benchmark literatüründe yetersiz temsil edilmesidir. Özellikle WUSTL-EHMS gerçek Modbus TCP trafiği bakımından öne çıkarılırken, bazı yaygın benchmarkların tüketici IoT'sine veya geleneksel BT ağlarına daha yakın olduğu belirtilmektedir.
Kontrollü laboratuvar veri setleri gerçek fabrikanın vardiya değişimlerini, ekipman yaşlanmasını, bakım hareketlerini, çok aylı concept drift'i, heterojen eski cihazları ve ileri düzey saldırganların uzun süreli davranışlarını tam olarak temsil etmeyebilir. Bu nedenle araştırmacılar çoklu veri seti doğrulaması, protokol-bağlam eşleşmesi, zamansal tutarlılık, gerçekçi sınıf dengesizliği ve çoklu random seed ile güven aralığı raporlamasını gelecekteki değerlendirmeler için önermektedir.
Gelecekte çözülmesi gereken başlıca problemler
Çalışmanın geleceğe dönük araştırma gündemi yalnız yeni bir model geliştirmekten ibaret değildir. Hesaplama ve bellek tüketiminin azaltılması, gerçek OT verisine erişim, sentetik verinin istatistiksel sadakati, adversarial manipülasyona direnç, gerçek zamanlı drift tespiti, benign drift ile saldırı kaynaklı dağılım kaymasının ayrılması, catastrophic forgetting olmadan continual learning, güvenli ve sıfır-kesintili model güncellemeleri, açıklanabilirlik ve endüstriyel standartlarla uyum birlikte çözülmesi gereken sorunlardır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Generative AI-Driven Intrusion Detection Systems for the Industrial Internet of Things: A Systematic Review
Yazarlar: Mohammed Houache; Djallel Eddine Boubiche; Homero Toral-Cruz; Rafael Martínez-Peláez; Rafael Sanchez-Lara.
Eş katkı/eş birinci yazar: Kaynakta böyle bir beyan bulunmamaktadır.
Sorumlu yazarlar: Djallel Eddine Boubiche ve Homero Toral-Cruz.
Kurumlar: LEREESI Laboratory, Higher National School of Renewable Energies, Environment & Sustainable Development (HNS-RE2SD), Batna, Cezayir; Departamento de Ingeniería y Tecnología, Universidad Autónoma del Estado de Quintana Roo, Chetumal, Meksika; Unidad Académica de Computación, Universidad Politécnica de Sinaloa, Mazatlán, Meksika; Departamento de Ingeniería de Sistemas y Computación, Universidad Católica del Norte, Antofagasta, Şili; Facultad de Ingeniería y Arquitectura, Universidad Autónoma del Carmen, Ciudad del Carmen, Meksika.
Kaynak türü: Sistematik derleme.
Hakemlik durumu: Hakemli dergi yayınıdır.
Dergi: AI.
Yayınevi: MDPI, Basel, İsviçre.
Bibliyografik kayıt: AI, 2026, Cilt 7, Sayı 5, Makale 179.
DOI: 10.3390/ai7050179.
Alınma / revizyon / kabul / yayın: 8 Ocak 2026 / 27 Şubat 2026 / 9 Mart 2026 / 21 Mayıs 2026.
Resmî yayın bağlantısı: DOI 10.3390/ai7050179 üzerinden MDPI'nin resmî makale kaydı.
Lisans: Creative Commons Attribution (CC BY); telif © 2026 yazarlara aittir.
Sistematik inceleme kaydı: Open Science Framework, DOI 10.17605/OSF.IO/TWZM6. Çalışma öncesinde resmî bir inceleme protokolü hazırlanmadığı ve metodolojinin PRISMA 2020 doğrultusunda iteratif biçimde geliştirildiği yazarlar tarafından belirtilmektedir.
Finansman: Araştırma dış finansman almamıştır.
Veri erişilebilirliği: Derlemede değerlendirilen benchmark veri kümeleri kamuya açıktır ve çalışmada/Supplementary Table S0-B'de kaynakları gösterilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yazar katkıları: Mohammed Houache kavramsallaştırma, veri toplama, ilk taslak ve şekil tasarımına katkıda bulunmuştur. Djallel Eddine Boubiche içerik ve yapı gözetimini yürütmüş ve ilk taslağa katkı vermiştir. Djallel Eddine Boubiche, Homero Toral-Cruz, Rafael Martínez-Peláez ve Rafael Sanchez-Lara düzenleme ve revizyonlara katkı sağlamıştır. Tüm yazarların yayımlanan sürümü okuyup onayladığı belirtilmektedir.
Kaynak içi tutarlılık notları
Kaynakta bazı editoryal ve sayısal uyuşmazlıklar bulunmaktadır ve bunlar sessizce düzeltilmemiştir. Çalışma dokuz ayrıntılı uygulama çerçevesi listelerken 4.2.10'da bir yerde “sekiz çerçeve” ifadesi kullanılmaktadır. FedGenID için aynı grafikte verilen %92,17 ve %35,27 değerlerinin farkı 56,90 yüzde puanı olmasına rağmen açıklayıcı metinde “14 yüzde puanı” denmektedir. Ayrıca önceki bir karşılaştırma bölümündeki <10 ms difüzyon modeli ifadesi, daha sonraki 100–500 ms difüzyon gecikmesi değerlendirmesi ve <10 ms için hiçbir incelenen GenAI çerçevesinin uygun olmadığı yönündeki nihai karar kuralıyla uyuşmamaktadır. Bu makalede, gecikme konusunda çalışmanın ayrıntılı dağıtım değerlendirmesi ve nihai karar ağacı esas alınmış; çelişki açıkça korunmuştur.
Şekil 2'nin açıklamasında nihai 42 çalışmanın sekiz sistematik derleme ve 34 ampirik çalışmadan oluştuğu belirtilirken, 1.2.4 bölümünde “primary study” teriminin tanımı doğrudan bir üretken yapay zekâ tekniğini öneren veya ampirik olarak değerlendiren çalışmalar şeklinde verilmektedir. Bu nedenle 42 “primary study” ifadesinin iç sınıflandırması terminolojik açıdan tam olarak tutarlı değildir.
Temel yöntemsel sınırlılık
Bu çalışma yeni bir IDS modeli üzerinde ortak, kontrollü deney yürütmemiştir; farklı araştırmaların sonuçlarını sistematik olarak sentezlemektedir. Veri kümeleri, saldırı dağılımları, ön işleme adımları, train/test bölmeleri, donanım, metrik hesaplama biçimleri ve istatistiksel raporlama standartları çalışmalar arasında farklıdır. Bu nedenle derlemedeki performans sayıları bağlamlarından koparılarak kesin model sıralaması oluşturmak için kullanılmamalıdır.
İncelenen çerçevelerin büyük bölümü benchmark veya kontrollü test ortamlarında değerlendirilmiştir. Operasyonel fabrikalarda, uzun dönemli concept drift altında, eski OT donanımlarıyla ve gerçek ileri düzey saldırganlara karşı kapsamlı doğrulama eksikliği derlemenin en önemli uygulama sınırlarından biridir. Bilimsel içerik yüklenen çalışmaya dayanmakta; dış kaynaklardan yeni deneysel sonuç veya mekanizma eklenmemektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir