

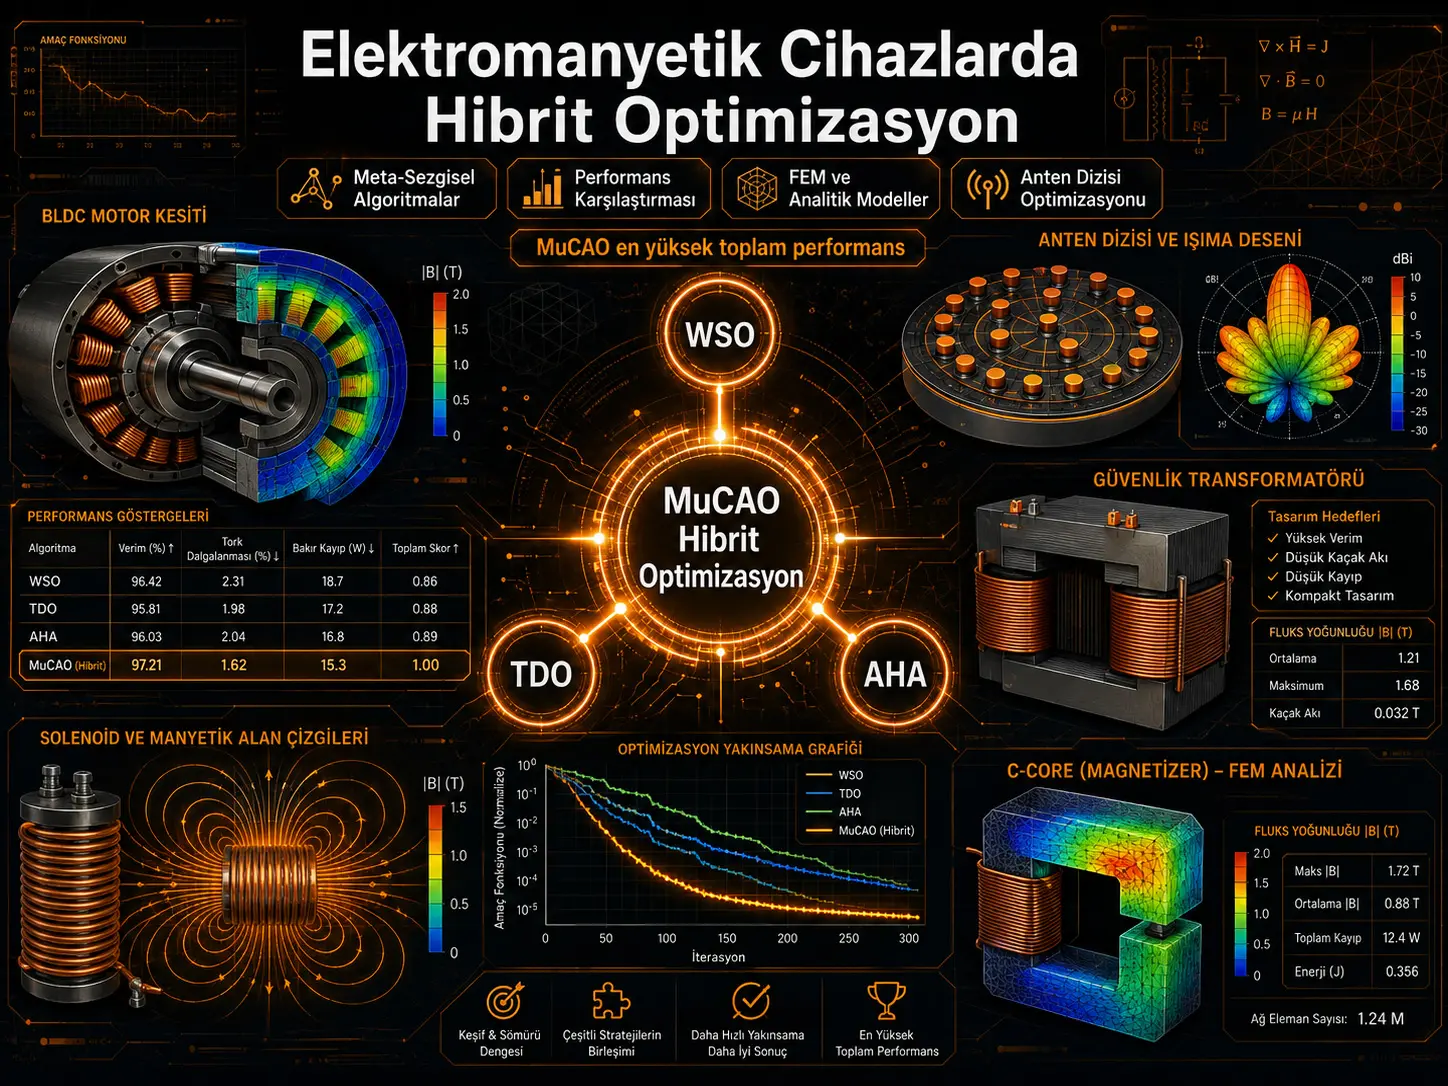
Araştırma, elektromanyetik cihazların optimal tasarımında on modern meta-sezgisel algoritmayı yedi yerleşik referans algoritmayla karşılaştırmakta ve en güçlü yöntemlerin tamamlayıcı özelliklerini uyarlamalı biçimde kullanmak için Multiple Combined Algorithms for Optimization (MuCAO) adlı yeni bir hibrit optimizasyon çerçevesi önermektedir. MuCAO dahil toplam 18 yöntem; analitik ve Sonlu Elemanlar Yöntemi (Finite Element Method, FEM) tabanlı altı elektromanyetik benchmark üzerinde değerlendirilmiştir. Ana karşılaştırmada MuCAO 50.534,5 toplam performans puanıyla genel sıralamada birinci olmuş; WSO 48.408,5, TDO 48.075,5 ve AHA 43.353,5 puanla onu izlemiştir. En iyi klasik referans yöntem Differential Evolution (DE), 41.166 puanla genel sıralamada beşinci olmuştur. MuCAO hiçbir tek benchmark'ta birinci olmamasına rağmen altı problemde 2. ile 6. sıra arasında kalarak çalışmadaki en düşük sıralama değişkenliğini göstermiştir.
Çalışmanın önemli yönü, yalnız “hangi algoritma birinci?” sorusuna bakmamasıdır. Araştırmacılar çözüm kalitesiyle birlikte istatistiksel sıralama, 25 bağımsız koşudaki performans dağılımı, hesaplama süresi, yakınsama davranışı, MuCAO'nun seçim ağırlıkları ve hibritteki algoritma sayısının etkisini de incelemiştir. MuCAO ayrıca 12 elemanlı ve 24 tasarım değişkenli bir dairesel anten dizisinin yan lob seviyesini azaltma probleminde test edilmiş ve 9516 toplam puanla bu ek karşılaştırmada da birinci sıraya yerleşmiştir.
MuCAO'nun temel mantığı tek bir meta-sezgisel yöntemin bütün optimizasyon problemlerinde en iyi olamayacağı varsayımına dayanır. Ana yapı WSO, TDO ve AHA'yı bir aday havuzu içinde kullanmaktadır. Başlangıçta yöntemlerin seçilme olasılıkları eşittir; bağımsız optimizasyon koşuları ilerledikçe her algoritmanın ortalama geçmiş performansı ve şimdiye kadarki en iyi performansı hesaplanır. Bu iki ölçüt eşit ağırlıkla birleştirilerek sonraki koşuda hangi algoritmanın kullanılacağına ilişkin seçim olasılıkları güncellenir.
Sonuçların sınırı önemlidir. Çalışma altı bilinen elektromanyetik tasarım benchmark'ı ve bir anten dizisi optimizasyon modeli üzerinde hesaplamalı değerlendirme yapmaktadır. FEM tabanlı C-Core ve Magnetizer problemleri fiziksel prototip deneyleri değildir. Benzer şekilde dairesel anten dizisi uygulaması da matematiksel array-factor modeli üzerinden değerlendirilmiştir. Dolayısıyla çalışma MuCAO'nun gerçek üretilmiş elektromanyetik cihazlarda her durumda daha iyi tasarım sağlayacağını deneysel olarak göstermemektedir.
Türkiye açısından değerlendirme: Çalışmanın yaklaşımı elektrik makineleri, manyetik devreler, transformatörler, aktüatörler, anten dizileri ve FEM destekli elektromanyetik tasarım üzerinde çalışan Türkiye'deki mühendislik ekipleri açısından yöntemsel olarak değerlendirilebilir. Özellikle pahalı FEM analizlerinin optimizasyon döngüsü içine girdiği problemlerde yalnız en iyi tek çözüme değil, algoritmanın kararlılığına ve hesaplama maliyetine birlikte bakılması önemlidir. Ancak çalışmadaki benchmark sonuçları belirli problem tanımlarına ve algoritma ayarlarına aittir; farklı motor, anten veya elektromanyetik cihaz geometrilerine doğrudan aynı sıralamanın taşınacağı sonucu çıkarılamaz.
Araştırmanın temel problemi nedir?
Elektromanyetik cihaz tasarımı genellikle doğrusal olmayan, kısıtlı, çok değişkenli ve bazı durumlarda her bir tasarım adayının FEM ile çözülmesini gerektiren pahalı optimizasyon problemlerine dönüşür. Motor geometrisi, bobin boyutları, manyetik kutup şekli veya akım yoğunluğu gibi parametrelerin birlikte değiştirilmesi çok geniş bir arama uzayı oluşturabilir.
Meta-sezgisel algoritmalar türev bilgisi gerektirmeden bu tür karmaşık uzaylarda çözüm arayabilir. Ancak farklı algoritmalar keşif ve sömürü arasında farklı dengeler kurduğundan bir yöntemin bir problemde güçlü olması başka bir problemde aynı sonucu vereceği anlamına gelmez.
Araştırmacılar literatürde elektromanyetik cihazlar için çok sayıda algoritma uygulanmış olmasına rağmen yeni nesil meta-sezgisel yöntemleri aynı deney koşullarında geniş bir benchmark seti üzerinde karşılaştıran çalışmaların sınırlı olduğunu belirtmektedir.
Kaç algoritma karşılaştırıldı?
Araştırma üç algoritma grubunu ayırmaktadır.
On modern meta-sezgisel yöntem:
- Ali Baba and the Forty Thieves Optimization (AFT),
- Golden Eagle Optimizer (GEO),
- Hunger Games Search (HGS),
- Rat Swarm Optimizer (RSO),
- Tiki-Taka Algorithm (TTA),
- Pelican Optimization Algorithm (POA),
- Tasmanian Devil Optimization (TDO),
- White Shark Optimizer (WSO),
- Zebra Optimization Algorithm (ZOA),
- Artificial Hummingbird Algorithm (AHA).
Yedi referans meta-sezgisel yöntem:
- Biogeography-Based Optimization (BBO),
- Differential Evolution (DE),
- Grey Wolf Optimizer (GWO),
- Particle Swarm Optimization (PSO),
- Salp Swarm Algorithm (SSA),
- Teaching–Learning-Based Optimization (TLBO),
- Most Valuable Player Algorithm (MVPA).
Bunlara araştırmacıların geliştirdiği MuCAO eklendiğinde ana performans karşılaştırmasında toplam 18 yöntem bulunmaktadır.
MuCAO nedir?
MuCAO, birden fazla optimizasyon algoritması arasından geçmiş performansa göre olasılıksal seçim yapan uyarlamalı bir çok-algoritmalı çerçevedir. Yöntemin motivasyonu No Free Lunch yaklaşımıdır: tek bir optimizasyon algoritmasının bütün problem sınıflarında sürekli en iyi olması beklenmez.
Aday algoritma kümesi:
\[ A=\{A_1,A_2,\ldots,A_N\} \]
olarak tanımlanmaktadır. Başlangıçta bütün algoritmalar aynı seçilme olasılığına sahiptir:
\[ p_i^{(0)}=\frac{1}{N} \]
Her algoritma için iki tarihsel performans ölçütü tutulur:
- şimdiye kadarki koşuların ortalama amaç fonksiyonu değeri \(\bar{f}_i\),
- şimdiye kadar elde edilen en iyi amaç fonksiyonu değeri \(f_i^{best}\).
Algoritma seçim puanı nasıl hesaplanıyor?
Çalışma minimizasyon problemi için ortalama performans skorunu:
\[ S_i^{avg}= \max_j(\bar{f}_j)-\bar{f}_i+\delta \]
ve en iyi performans skorunu:
\[ S_i^{best}= \max_j(f_j^{best})-f_i^{best}+\delta \]
olarak tanımlar. Buradaki \(\delta\), hiçbir algoritmanın sıfır seçim olasılığına düşmemesi için kullanılan küçük pozitif sabittir.
İki bileşen:
\[ S_i=w_1S_i^{avg}+w_2S_i^{best} \]
ile birleştirilir.
Ana deneylerde:
\[ w_1=w_2=0.5 \]
kullanılmıştır. Son seçim olasılığı:
\[ p_i= \frac{S_i} {\sum_{j=1}^{N}S_j} \]
olarak güncellenmektedir. Toplam skor sıfır olursa bütün algoritmalar yeniden eşit olasılığa döndürülmektedir.
MuCAO algoritmaları aynı optimizasyon koşusu içinde karıştırıyor mu?
Hayır; Algorithm 1'e göre temel seçim bir bağımsız koşu düzeyinde yapılmaktadır. Her koşunun başında aday algoritmalardan biri güncel olasılık dağılımına göre seçilir ve seçilen algoritma o koşuyu yürütür. Sonuç daha sonra ilgili algoritmanın geçmiş performansına eklenerek gelecek seçim olasılıkları güncellenir.
Dolayısıyla MuCAO'yu, WSO, TDO ve AHA'nın hareket denklemlerini aynı popülasyonda her iterasyonda doğrudan harmanlayan tek bir yeni arama operatörü şeklinde yorumlamak doğru değildir. Yenilik, farklı algoritmalar arasındaki performans güdümlü adaptif seçim mekanizmasındadır.
Hangi altı elektromanyetik benchmark kullanıldı?
| Benchmark | Model | Çalışmada verilen değişken sayısı | Optimizasyon amacı |
|---|---|---|---|
| Loney solenoidi | Analitik | 2 | Kontrol bölgesinde düzgün manyetik akı yoğunluğu |
| BLDC tekerlek motoru | Analitik | 5 | Motor verimini maksimize etmek |
| TEAM22 | Analitik | 8 | Enerji sapması ve kaçak alanın ağırlıklı toplamını küçültmek |
| Safety Transformer | Analitik / çok-fizikli | 9 | Demir ve bakır toplam kütlesini küçültmek |
| C-Core | FEM | Tablo 1: 7; Bölüm 3.5: 6 | Hava aralığında düzgün manyetik alan dağılımı |
| Magnetizer | FEM | 4 | AB doğrusu boyunca düzgün manyetik akı dağılımı |
C-Core satırındaki sayı kaynak içindeki önemli bir tutarsızlığı yansıtmaktadır. Tablo 1 yedi değişken bildirirken, C-Core'un ayrıntılı matematiksel tanımında \(x_1\)–\(x_6\) olmak üzere altı değişken bulunmaktadır.
BLDC motor probleminde ne optimize ediliyor?
BLDC benchmark'ı güneş yarış aracı için geliştirilen bir tekerlek içi motor modeline dayanır. Beş karar değişkeni diş manyetik indüksiyonu \(B_d\), hava aralığı indüksiyonu \(B_e\), stator sırt demiri indüksiyonu \(B_{cs}\), iletken akım yoğunluğu \(\delta\) ve stator iç çapı \(D_s\)'dir.
Amaç verimi maksimize etmektir. Algoritmalar minimizasyon çerçevesinde çalıştığı için:
\[ OF=-\eta \]
kullanılmıştır.
Problem ayrıca aktif bileşen kütlesi, maksimum akım, dış/iç çap ve mıknatıs sıcaklığı dahil altı eşitsizlik kısıtı içermektedir.
Loney solenoidi neyi test ediyor?
Loney problemi, bir ana bobin ile iki simetrik düzeltme bobininin geometrisini ayarlayarak merkezi bölgede mümkün olduğunca düzgün bir manyetik akı yoğunluğu üretmeyi amaçlayan iki değişkenli bir benchmark'tır.
Amaç fonksiyonu:
\[ OF= \frac{B_{max}-B_{min}}{B_0} \]
olarak tanımlanmıştır. \(B_{max}\) ve \(B_{min}\) kontrol aralığındaki en yüksek ve en düşük manyetik akı yoğunluğunu, \(B_0\) merkezdeki değeri temsil eder. Daha küçük değer daha düzgün alan anlamına gelir.
TEAM22 neden daha karmaşık?
TEAM22, Superconducting Magnetic Energy Storage (SMES) tasarım problemidir. Sekiz sürekli tasarım değişkeni kullanılır ve iki amaç aynı fonksiyonda birleştirilir: depolanan enerjinin 180 MJ referans değerine yaklaşması ve kaçak manyetik alanın azaltılması.
Amaç fonksiyonu:
\[ OF= \frac{B_{stray}^{2}}{B_{norm}^{2}} + w\frac{|E-E_{ref}|}{E_{ref}} \]
şeklindedir. Çalışmada \(B_{norm}=200\,\mu T\), \(E_{ref}=180\) MJ ve \(w=100\) kullanılmıştır.
Problem ayrıca iki solenoidin çakışmasını önleyen geometrik kısıt ve süperiletkenin quench sınırını aşmasını önleyen fiziksel kısıt içermektedir.
Safety Transformer neden çok-fizikli bir problem?
Safety Transformer benchmark'ında termal, elektrik ve manyetik davranış birbirine bağlıdır. Amaç aktif demir ve bakır malzemelerin toplam kütlesini küçültmektir.
Problemde sıcaklık, gerilim düşümü, akım oranı, sargı doluluk oranları ve verim gibi kısıtlar birlikte uygulanmaktadır. Hesaplama maliyetini azaltmak için Individual Discipline Feasible (IDF) formülasyonu kullanılmıştır.
Kaynağın Tablo 4'ünde yedi fiziksel tasarım değişkeni listelenmesine rağmen problem toplam dokuz optimizasyon değişkeni olarak tanımlanmıştır; diğer ikisi \(T_{cond,IDF}\) ve \(\Delta V_{2,IDF}\) yardımcı IDF değişkenleridir.
FEM tabanlı C-Core problemi ne yapıyor?
C-Core benchmark'ında manyetik kutup yüzünün biçimi optimize edilerek hava aralığındaki dikdörtgen bir bölgede manyetik akı yoğunluğunun mümkün olduğunca düzgün olması hedeflenir.
Manyetik akı yoğunluğu FEM ile 35 değerlendirme noktasında hesaplanır. Amaç fonksiyonu:
\[ OF= -\sum_{i=1}^{35} \frac{|B_0-B_i|}{B_0} \]
olarak verilmiştir.
Kaynak metni kutup profili için \(x_1,x_2,\ldots,x_6\) olmak üzere altı kontrol noktası tanımlamakta ve:
\[ 18\leq x_j\leq30,\qquad j=1,\ldots,6 \]
kısıtını vermektedir. Bu ayrıntılı tanım, özet Tablo 1'deki “7 değişken” ifadesiyle uyuşmamaktadır.
Magnetizer probleminde ne optimize ediliyor?
Magnetizer benchmark'ı iki boyutlu doğrusal magnetostatik FEM problemidir. Kutup yüzü dört radyal kontrol noktasıyla tanımlanan uniform non-rational cubic B-spline eğrisiyle oluşturulur.
Amaç, AB kirişi üzerinde manyetik alanın değişimini azaltmaktır:
\[ OF= \frac{\sigma_B}{\bar{B}} \]
Burada \(\sigma_B\), AB üzerindeki manyetik akı yoğunluğunun standart sapmasını; \(\bar{B}\) ortalamasını ifade eder. Alan 35°–89° arasında toplam 50 eşit aralıklı noktada değerlendirilmiştir.
Algoritmalar nasıl adil biçimde karşılaştırıldı?
Ana deneylerde bütün algoritmalarda:
- popülasyon büyüklüğü = 50,
- maksimum iterasyon = 1000,
- maksimum fonksiyon değerlendirmesi = 20.000
olarak belirlenmiştir. Durdurma ölçütü maksimum fonksiyon değerlendirme sayısına dayandırılmıştır.
Başlangıç popülasyonları bütün yöntemlerde problem değişkenlerinin alt ve üst sınırları içinde rastgele üretilmiştir.
Bir algoritmanın özgün yönteminde özel kısıt işleme mekanizması bulunuyorsa bu mekanizma korunmuş; bulunmuyorsa ceza tabanlı yöntem uygulanmıştır.
Tekrarlanabilir rastgelelik nasıl sağlandı?
Paralel hesaplamalarda MATLAB'ın mrg32k3a sözde-rastgele sayı üreteci kullanılmıştır. Her bağımsız koşuya farklı fakat deterministik bir alt-akış atanarak paralel koşuların rastgele dizilerinin çakışmaması ve yeniden üretilebilir olması hedeflenmiştir.
Performans puanı nasıl hesaplandı?
Çalışma CEC yarışmalarındaki sıralama yaklaşımına dayanan bir rank-sum ölçütü kullanmıştır. Bir benchmark'taki tüm algoritmaların bütün bağımsız koşuları birlikte sıralanır. Daha küçük amaç fonksiyonu değerleri daha iyi kabul edilir.
Algoritma \(a\)'nın benchmark \(f\) üzerindeki puanı:
\[ S_{a,f}= \sum_{i=1}^{N} rank_{i,a,f} - \frac{N(N+1)}{2} \]
biçimindedir.
Çalışmada her algoritma için 25 bağımsız koşu kullanılmıştır. Yüksek toplam puan daha güçlü performansı temsil eder.
Neden bu puan tek başına “en iyi tek çözüm” değildir?
Bu sistem yalnız bir algoritmanın elde ettiği en iyi koşuya bakmaz. Bir algoritmanın 25 bağımsız koşusunun diğer algoritmaların koşularına göre toplu sıralamasını ölçer. Bu nedenle istikrarlı biçimde iyi sonuç üreten bir yöntem, ara sıra çok iyi fakat çoğunlukla daha zayıf sonuç veren bir yöntemden daha yüksek puan alabilir.
Bu ayrım dairesel anten dizisi uygulamasında açıkça görülmektedir: AFT'nin tek koşudaki en iyi amaç değeri MuCAO'dan daha düşük olmasına rağmen MuCAO toplam sıralama puanında birinci olmuştur.
Ana sıralamada hangi yöntemler öne çıktı?
| Genel sıra | Algoritma | Toplam puan | Altı benchmark'taki sıra aralığı |
|---|---|---|---|
| 1 | MuCAO | 50.534,5 | 2–6 |
| 2 | WSO | 48.408,5 | 1–9 |
| 3 | TDO | 48.075,5 | 1–9 |
| 4 | AHA | 43.353,5 | 3–10 |
| 5 | DE | 41.166 | 2–14 |
MuCAO hiçbir benchmark'ta birincilik elde etmemiştir; buna rağmen en kötü sonucu altıncılıktır. WSO üç benchmark'ta, TDO iki benchmark'ta ve TTA bir benchmark'ta birinci olmuştur. Araştırmanın temel argümanı bu nedenle MuCAO'nun tek probleme özgü en yüksek tepe performansından çok problem türleri arasında dengeli performans sağlamasıdır.
Verianla Live: Genel optimizasyon performansı
Karşılaştırma çalışmanın ana Tablo 8 toplam puanlarını kullanır. Bu rank-sum ölçütünde daha yüksek puan daha güçlü toplam performansı ifade eder.
| Algoritma | Toplam performans puanı | Genel sıra | Kaynak |
|---|---|---|---|
| MuCAO | 50534,5 | 1 | Tablo 8 |
| WSO | 48408,5 | 2 | Tablo 8 |
| TDO | 48075,5 | 3 | Tablo 8 |
| AHA | 43353,5 | 4 | Tablo 8 |
| DE | 41166 | 5 | Tablo 8 |
Referans algoritmalar ne kadar rekabetçiydi?
Referans yöntemler içinde en güçlü sonuç DE'den gelmiştir ve DE beşinci sıraya yerleşmiştir. Tablo 8'e göre diğer referans yöntemlerden MVPA sekizinci, GWO on ikinci, PSO on üçüncü, BBO on dördüncü, SSA on altıncı ve TLBO on sekizinci olmuştur.
Kaynak metninin sonuç tartışmasında MVPA'nın yedinci olduğu yazılmasına rağmen ana Tablo 8'de yedinci TTA, sekizinci MVPA'dır. Burada tablodaki sıralama korunmuştur.
Yeni olması bir algoritmayı otomatik olarak daha iyi yaptı mı?
Hayır. Araştırma özellikle bazı yeni yöntemlerin elektromanyetik tasarım problemlerinde zayıf performans gösterebildiğini ortaya koymaktadır. GEO genel sıralamada 15., RSO 17. olmuştur. TLBO ise bütün benchmark'larda son sırada yer almıştır.
Bu sonuç, yeni bir meta-sezgisel yöntemin genel matematiksel test fonksiyonlarında başarılı olmasının elektromanyetik cihaz tasarımında da otomatik üstünlük sağlayacağını göstermediğini desteklemektedir.
MuCAO ile güçlü rakipler arasındaki fark istatistiksel olarak her benchmark'ta anlamlı mıydı?
Hayır. Araştırmacılar MuCAO'yu WSO, TDO, AHA ve DE ile ikili Wilcoxon rank-sum testleriyle ayrıca karşılaştırmıştır.
- MuCAO–WSO farkı yalnız Benchmark 1 ve 2'de %5 düzeyinde anlamlıdır.
- MuCAO–TDO farkı Benchmark 1, 3, 4 ve 5'te anlamlıdır.
- MuCAO–AHA farkı Benchmark 1, 2 ve 5'te anlamlıdır.
- MuCAO–DE farkı Benchmark 1, 2, 3 ve 6'da anlamlıdır.
Dolayısıyla MuCAO'nun genel puan üstünlüğü, her tekil benchmark'ta bütün rakiplere karşı istatistiksel üstünlük anlamına gelmemektedir.
Violin grafikleri ne gösteriyor?
Çalışmanın Şekil 10'u en güçlü dört algoritma olan MuCAO, WSO, TDO ve AHA'nın 25 bağımsız koşudaki amaç fonksiyonu dağılımlarını göstermektedir. Bazı violin dağılımlarının neredeyse dikey çizgi kadar dar olması, koşular arası değişkenliğin çok düşük olduğunu göstermektedir.
Özellikle WSO'nun BLDC probleminde ve TDO'nun C-Core probleminde dağılımı son derece dardır. Her iki algoritma da ilgili benchmark'ta birinci olmuştur. Bu durum o problemlerde yalnız iyi sonuca değil, yüksek tekrar edilebilirliğe de işaret etmektedir.
MuCAO'nun yakınsama davranışı nasıldı?
Şekil 11'de MuCAO'nun altı benchmark üzerindeki normalize edilmiş best-so-far yakınsama eğrileri gösterilmiştir. Kalın çizgi bağımsız koşuların medyanını, gölgeli bölge ise çeyrekler arası aralığı temsil etmektedir.
Safety Transformer ve Magnetizer problemlerinde amaç değeri erken iterasyonlarda hızlı biçimde düşmektedir. C-Core daha uzun bir iyileştirme süreci göstermektedir. Bütün problemlerde arama ilerledikçe gölgeli bölgenin daralması, koşular arası değişkenliğin azalmasına işaret etmektedir.
FEM problemleri hesaplama maliyetini ne kadar artırdı?
Çalışma analitik ve FEM tabanlı problemlerin süreleri arasında büyük fark bulmuştur. Tablo 9'daki değerler algoritma başına 25 koşunun toplam süresidir.
MuCAO için:
| Benchmark | Model türü | 25 koşunun toplam süresi |
|---|---|---|
| Loney | Analitik | 1,83 s |
| BLDC | Analitik | 3,75 s |
| Safety Transformer | Analitik | 7,18 s |
| TEAM22 | Analitik | 00:42:06 |
| C-Core | FEM | 03:12:34 |
| Magnetizer | FEM | 01:12:27 |
Bütün algoritmalar üzerinden C-Core optimizasyonunun ortalama süresi yaklaşık 4 saat 6 dakika 39 saniye, Magnetizer'ın ise yaklaşık 1 saat 18 dakika 22 saniye olarak raporlanmıştır. Bu fark, amaç fonksiyonunun FEM çözümü gerektirdiği problemlerde optimizasyon algoritmasının kendisinden bağımsız olarak model değerlendirme maliyetinin kritik hâle gelebileceğini göstermektedir.
MuCAO'da iki performans ölçütünün ağırlığı neden önemli?
Ana MuCAO konfigürasyonunda:
\[ w_1=w_2=0.5 \]
kullanılmıştır. Araştırmacılar bunun tesadüfi bir seçim olup olmadığını görmek için üç varyant daha denemiştir:
| Varyant | Ortalama performans ağırlığı \(w_1\) | En iyi performans ağırlığı \(w_2\) | Tablo 17 içindeki genel sıra |
|---|---|---|---|
| Ana MuCAO | 0,50 | 0,50 | 1 |
| MuCAO1 | 0,25 | 0,75 | 3 |
| MuCAO2 | 0,75 | 0,25 | 4 |
| MuCAO3 | 1,00 | 0,00 | 5 |
Bu karşılaştırmada eşit ağırlıklı yapı en yüksek sıralamayı elde etmiştir. Araştırmacılar ortalama ve en iyi tarihsel performansın birbirini tamamlayan bilgi sağladığı sonucuna varmaktadır.
Tablo 17'de MuCAO puanı neden 56.644'e çıkıyor?
Bu sayı Tablo 8'deki 50.534,5 ile doğrudan karşılaştırılmamalıdır. Kullanılan rank-sum puanı, aynı karşılaştırmada yer alan algoritma ve koşuların toplam sırasına bağlıdır. Tablo 17'ye üç ek MuCAO varyantı eklendiğinde sıralama havuzunun büyüklüğü değişmiş ve mümkün olan toplam skor ölçeği de değişmiştir.
Dolayısıyla duyarlılık analizinin doğru yorumu “56.644, 50.534,5'ten daha iyi olduğu için yöntem iyileşti” değildir; doğru yorum, aynı Tablo 17 karşılaştırma havuzunda eşit ağırlıklı MuCAO'nun birinci olmasıdır.
Daha fazla algoritmayı MuCAO'ya eklemek fayda sağladı mı?
Her zaman değil. Ana MuCAO üç yöntem kullanmaktadır:
- WSO,
- TDO,
- AHA.
Dördüncü güçlü yöntem olarak DE'nin eklendiği MuCAO5 varyantı ayrıca test edilmiştir.
| Yapı | Birleştirilen yöntem sayısı | Tablo 18 toplam puanı | Tablo 18 sırası |
|---|---|---|---|
| MuCAO | 3 | 52.357,5 | 1 |
| MuCAO5 | 4 | 51.715,5 | 2 |
Dördüncü algoritmanın eklenmesi performansı artırmamıştır. Araştırmacılar daha büyük aday havuzunun çeşitlilik sağlarken güçlü algoritmaların seçim payını azaltabileceğini ve adaptif seçim sürecine ek değişkenlik getirebileceğini belirtmektedir.
Dairesel anten dizisi uygulaması nasıl kuruldu?
Ek doğrulama problemi 12 izotropik elemanın bir çember üzerinde eşit açılarla dağıtıldığı Circular Antenna Array (CAA) modelidir.
Array factor:
\[ AF(\phi)= \sum_{n=1}^{N} I_n \exp \left\{ j[ kr(\cos(\phi-\phi_n)-\cos(\phi_0-\phi_n)) +\beta_n ] \right\} \]
ile tanımlanmıştır.
Her elemanın açısal konumu:
\[ \phi_n= \frac{2\pi(n-1)}{N} \]
şeklindedir.
Amaç yan lob seviyesini düşürürken ana lobu istenen yön yakınında tutmaktır.
CAA probleminde kaç değişken optimize edildi?
Her bir 12 anten elemanı için:
- akım genliği \(I_n\): 0,2–1 A,
- faz uyarımı \(\beta_n\): −180°–180°
optimize edilmiştir.
Toplam tasarım değişkeni:
\[ 12+12=24 \]
olmuştur. İstenen ana ışın yönü \(\phi_{des}=180^\circ\) olarak seçilmiştir.
CAA uygulamasında hangi algoritma öne çıktı?
| Sıra | Algoritma | Toplam puan | En iyi amaç değeri | Ortalama amaç değeri |
|---|---|---|---|---|
| 1 | MuCAO | 9516 | −21,282 | −18,955 |
| 2 | WSO | 9069 | −21,006 | −18,216 |
| 3 | TDO | 9013 | −20,340 | −18,103 |
| 4 | AHA | 8670 | −21,184 | −17,417 |
MuCAO hem toplam sıralama puanında hem ortalama amaç değerinde birinci olmuştur.
Ancak bütün yöntemler içinde en düşük tek-koşu amaç değeri AFT tarafından −21,428 olarak elde edilmiştir. Bu, MuCAO'nun üstünlüğünün tek bir şanslı veya olağanüstü koşudan değil, bağımsız koşuların genel dağılımından geldiğini gösteren önemli bir ayrımdır.
Verianla Live: Dairesel anten dizisi doğrulaması
Çalışmanın Tablo 19'undaki toplam rank-sum puanları kullanılmıştır. Daha yüksek toplam puan, 25 bağımsız koşu boyunca daha güçlü genel performansı gösterir.
| Algoritma | Toplam puan | Genel sıra | Ortalama amaç değeri | Kaynak |
|---|---|---|---|---|
| MuCAO | 9516 | 1 | −18,955 | Tablo 19 |
| WSO | 9069 | 2 | −18,216 | Tablo 19 |
| TDO | 9013 | 3 | −18,103 | Tablo 19 |
| AHA | 8670 | 4 | −17,417 | Tablo 19 |
Çalışmanın desteklediği sonuçlar
- MuCAO, incelenen altı elektromanyetik benchmark'ın toplu rank-sum değerlendirmesinde 18 yöntem arasında en yüksek toplam puanı elde etmiştir.
- MuCAO'nun altı benchmark'taki sıralaması 2. ile 6. arasında değişmiştir ve ana karşılaştırmadaki en dar sıralama aralığıdır.
- WSO ve TDO bazı tekil benchmark'larda MuCAO'dan daha yüksek sıralama elde etmesine rağmen genel puanda MuCAO'nun gerisinde kalmıştır.
- Referans algoritmalar arasında DE beşincilikle en güçlü sonuç göstermiştir.
- Bazı modern algoritmalar, özellikle GEO ve RSO, incelenen elektromanyetik benchmark'larda düşük genel sıralama göstermiştir.
- Eşit \(w_1=w_2=0,5\) MuCAO yapılandırması, çalışmada test edilen diğer ağırlık kombinasyonlarından daha yüksek genel sıralama elde etmiştir.
- Dört algoritmalı MuCAO5, üç algoritmalı ana MuCAO yapılandırmasını geçememiştir.
- 12 elemanlı dairesel anten dizisi optimizasyonunda MuCAO toplam rank-sum puanında birinci olmuştur.
- FEM tabanlı benchmark'ların çalışma süresi analitik problemlere göre belirgin biçimde daha yüksektir.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- MuCAO'nun bütün optimizasyon problemlerinde en iyi algoritma olduğu gösterilmemiştir.
- MuCAO incelenen altı benchmark'ın hiçbirinde tekil olarak birinci sırayı almamıştır.
- MuCAO'nun her rakibe karşı her benchmark'ta istatistiksel olarak anlamlı üstünlüğü gösterilmemiştir.
- Yeni geliştirilen meta-sezgisel algoritmaların klasik yöntemlerden her zaman daha iyi olduğu gösterilmemiştir.
- Çalışma fiziksel motor, transformatör, magnetizer veya C-Core prototipi üretip test etmemiştir.
- CAA doğrulaması fiziksel anten ölçümü veya elektromanyetik oda testi değildir.
- MuCAO'nun farklı algoritma havuzları, farklı popülasyon büyüklükleri ve farklı fonksiyon değerlendirme bütçelerinde aynı sıralamayı koruyacağı gösterilmemiştir.
- Çalışmanın ana MuCAO bileşenleri benchmark setindeki global performansa göre seçildiği için tamamen yeni bir problem sınıfında aynı bileşenlerin optimum olacağı kanıtlanmamıştır.
- FEM problemlerinde raporlanan hesaplama süreleri farklı donanım, FEM çözücüsü veya paralellik yapılandırmasında aynı kalmak zorunda değildir.
Çalışmanın Yöntemi ve Bulguları
MuCAO'nun yöntem zinciri
Verianla Live: MuCAO bir sonraki algoritmayı nasıl seçiyor?
Bu süreç Algorithm 1'de verilen adaptif seçim mantığını özetler. Seçim bağımsız optimizasyon koşuları arasında yapılır.
| Aşama | MuCAO işlemi | Bilimsel anlamı |
|---|---|---|
| 1 | Aday algoritma havuzunu oluştur | Ana yapılandırmada WSO, TDO ve AHA kullanılır. |
| 2 | Başlangıç olasılıklarını eşitle | Her algoritma başlangıçta 1/N olasılığa sahiptir. |
| 3 | Bir algoritma seç ve bağımsız koşuyu yürüt | Seçim güncel olasılık dağılımına göre yapılır. |
| 4 | Koşunun amaç değerini geçmişe ekle | Seçilen algoritmanın performans geçmişi güncellenir. |
| 5 | Ortalama performansı hesapla | Algoritmanın yalnız tek iyi koşuya değil genel davranışına bakılır. |
| 6 | En iyi tarihsel performansı hesapla | Algoritmanın şimdiye kadarki en güçlü sonucu ayrıca korunur. |
| 7 | İki skoru ağırlıklı birleştir | Ana deneyde w1 = 0,5 ve w2 = 0,5 kullanılır. |
| 8 | Seçim olasılıklarını güncelle | Daha iyi geçmiş performans gösteren yöntemlerin gelecek koşularda seçilme ihtimali artar. |
Ana hesaplama ayarları
| Parametre | Çalışmada kullanılan değer |
|---|---|
| Yazılım | MATLAB 2025b |
| Hesaplama sistemi | Intel Core i7 tabanlı sistem |
| Bağımsız koşu sayısı | 25 |
| Popülasyon büyüklüğü | 50 |
| Maksimum iterasyon | 1000 |
| Maksimum fonksiyon değerlendirmesi | 20.000 |
| Durdurma ölçütü | Maksimum fonksiyon değerlendirme sayısı |
| Rastgele sayı üreteci | mrg32k3a |
| Paralel koşular | Ayrı deterministik alt-akışlar |
| MuCAO ana ağırlıkları | w1 = 0,5; w2 = 0,5 |
| MuCAO ana bileşenleri | WSO + TDO + AHA |
Altı benchmark'ın ana performans puanları
| Algoritma | Loney | BLDC | TEAM22 | Safety Transformer | C-Core | Magnetizer | Toplam | Genel sıra |
|---|---|---|---|---|---|---|---|---|
| MuCAO | 8666 | 8883 | 8696,5 | 9501 | 7891 | 6897 | 50.534,5 | 1 |
| WSO | 6703 | 9954 | 9273,5 | 9558 | 6512 | 6408 | 48.408,5 | 2 |
| TDO | 9464 | 8046 | 7403,5 | 5584 | 9822 | 7756 | 48.075,5 | 3 |
| AHA | 6423 | 7690 | 8600,5 | 9312 | 4788 | 6540 | 43.353,5 | 4 |
| DE | 6101 | 9818 | 8004,5 | 5368 | 8024,5 | 3850 | 41.166 | 5 |
Tablonun temel mesajı, WSO ve TDO'nun bazı tekil problemlerde daha yüksek skor almasına rağmen MuCAO'nun altı problemin tamamında üst sıralarda kalmasıdır.
MuCAO'nun benchmark sıraları
| Benchmark | MuCAO sırası |
|---|---|
| Loney | 2 |
| BLDC | 3 |
| TEAM22 | 2 |
| Safety Transformer | 2 |
| C-Core | 4 |
| Magnetizer | 6 |
Bu 2–6 aralığı, araştırmacıların MuCAO'nun “robust” veya dengeli genel davranışı için kullandığı temel kanıtlardan biridir.
Hesaplama süresi açısından en zor problemler
Çalışmada algoritmalardan bağımsız ortalama benchmark süreleri değerlendirildiğinde C-Core yaklaşık 4 saat 6 dakika 39 saniye ile en pahalı problem olmuştur. Magnetizer yaklaşık 1 saat 18 dakika 22 saniye ile ikinci sıradadır.
En uzun tek algoritma–benchmark toplamı TLBO'nun C-Core'daki 5 saat 26 dakika 16 saniyelik süresidir. En kısa süre POA'nın Loney problemindeki yaklaşık 1,47 saniyelik toplamıdır.
Bu süreler tek bir optimizasyon koşusu değil, ilgili algoritmanın 25 bağımsız koşusunun toplamıdır.
Pairwise istatistiksel sonuçların özeti
| Karşılaştırma | MuCAO toplam skoru | Rakip toplam skoru | MuCAO'nun toplam sırası |
|---|---|---|---|
| MuCAO vs WSO | 1944 | 1806 | 1 |
| MuCAO vs TDO | 2150 | 1600 | 1 |
| MuCAO vs AHA | 2640 | 1110 | 1 |
| MuCAO vs DE | 2250 | 1500 | 1 |
MuCAO bütün dört doğrudan ikili toplam karşılaştırmada birinci olmuştur. Ancak tek tek benchmark p değerlerinin tamamı 0,05'in altında değildir; istatistiksel üstünlük probleme bağlıdır.
CAA doğrulamasının teknik ayarları
| Özellik | Değer |
|---|---|
| Anten geometrisi | Dairesel anten dizisi |
| Eleman sayısı | 12 |
| Tasarım değişkeni | 24 |
| Akım genliği | 0,2–1 A |
| Faz uyarımı | −180°–180° |
| İstenen ışın yönü | 180° |
| Ana amaç | Yan lob seviyesinin azaltılması ve ana lob yönünün korunması |
| Popülasyon | 50 |
| Maksimum iterasyon | 1000 |
| Maksimum fonksiyon değerlendirmesi | 20.000 |
Çalışmanın temel yöntemsel sınırlılıkları
- MuCAO'nun ana bileşenleri, aynı elektromanyetik benchmark setindeki global performansa göre seçilmiştir.
- Yazarlar bu seçimin farklı problem türlerine genellenebilirliği sınırlayabileceğini açıkça kabul etmektedir.
- Bileşen algoritma sayısı sistematik olarak problem özelliklerinden türetilmemiş, ana çalışmada üç olarak belirlenmiştir.
- FEM benchmark'ları yüksek hesaplama maliyeti taşımaktadır.
- Çalışma surrogate model kullanarak FEM maliyetini azaltmayı uygulamamıştır; bunu gelecek araştırma yönü olarak belirtmektedir.
- Fiziksel elektromanyetik cihaz prototipleri üzerinde deneysel optimizasyon doğrulaması yapılmamıştır.
- CAA uygulaması fiziksel anten ölçümü değildir.
- Algoritma parametrelerinin tamamı ayrıca otomatik hiperparametre optimizasyonuna tabi tutulmamıştır.
- Rank-sum toplam skorları karşılaştırma havuzundaki yöntem sayısına bağlı olduğundan farklı tablolar arasındaki ham skorlar doğrudan karşılaştırılamaz.
- C-Core değişken sayısı ve MVPA'nın genel sırası konusunda kaynak içinde iki editoryal/sayısal tutarsızlık bulunmaktadır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Performance Evaluation and Hybrid Combination of Modern Metaheuristics for the Optimal Design of Electromagnetic Devices
Yazarlar: Houssem Rafik El-Hana Bouchekara, Mostafa Kamel Smail, Muhammad Sharjeel Javaid, Abdelhak Goudjil, Yusuf Abubakar Sha’aban, Mohammad Shoaib Shahriar, Md Nurul Islam, Ali Mukhaylif Mohammed ve Bander Marshud Alshammari.
Sorumlu yazar: Houssem Rafik El-Hana Bouchekara.
Eş katkı/eş birinci yazarlık: Kaynakta eş katkı veya eş birinci yazar beyanı bulunmamaktadır.
Kurumlar:
- Department of Electrical Engineering, University of Hafr Al Batin, Hafr Al Batin, Saudi Arabia.
- IPSA—Institut Polytechnique des Sciences Avancées, Ivry-sur-Seine, France.
- GeePs—Group of Electrical Engineering Paris, UMR CNRS 8507, CentraleSupélec, Université Paris-Saclay, Sorbonne University, Gif-sur-Yvette, France.
- Department of Electrical and Electronic Engineering, Imperial College London, London, United Kingdom.
- Department of Computer, Electrical and Software Engineering, Embry-Riddle Aeronautical University, Prescott, Arizona, USA.
Dergi: Actuators.
Yayınevi: MDPI, Basel, Switzerland.
Bibliyografik bilgi: Actuators 2026, 15(6), 284.
Resmî yayın bağlantısı:MDPI – Actuators 15(6), 284
Yayın tarihi: 25 Mayıs 2026. Çalışma 23 Mart 2026'da alınmış, 14 Mayıs 2026'da revize edilmiş ve 19 Mayıs 2026'da kabul edilmiştir.
Kaynak türü ve hakemlik durumu: Actuators dergisinde kabul edilerek yayımlanmış araştırma makalesidir.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Araştırma, Saudi Arabia Ministry of Education, Deputyship for Research & Innovation tarafından 0027-1446-S proje numarasıyla desteklenmiştir.
Etik kurul: Uygulanabilir değildir.
Bilgilendirilmiş onam: Uygulanabilir değildir.
Veri erişilebilirliği: Yazarlar çalışmanın özgün katkılarının makalede bulunduğunu ve ek soruların sorumlu yazara yöneltilebileceğini belirtmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bulunmadığını beyan etmektedir.
Yapay zekâ kullanım beyanı: Yazarlar makale hazırlığı sırasında ChatGPT-5.5 Pro'yu yalnızca dil düzenleme ve metin iyileştirme amacıyla kullandıklarını; araştırma tasarımı, yöntem, deneysel sonuçlar, analiz ve bilimsel katkıların yazarlara ait olduğunu belirtmektedir.
Yazar katkıları: Kavramsallaştırma Houssem Rafik El-Hana Bouchekara; metodoloji geniş yazar ekibi; yazılım Houssem Rafik El-Hana Bouchekara, Muhammad Sharjeel Javaid, Yusuf Abubakar Sha’aban, Mohammad Shoaib Shahriar ve Md Nurul Islam; biçimsel analiz Houssem Rafik El-Hana Bouchekara; ilk taslak Houssem Rafik El-Hana Bouchekara ve Mohammad Shoaib Shahriar; danışmanlık, proje yönetimi ve finansman edinimi Houssem Rafik El-Hana Bouchekara tarafından yürütülmüştür. Tam CRediT dağılımı özgün kaynakta ayrıntılı olarak verilmiştir.
Bilimsel kapsam: Çalışma, meta-sezgisel algoritmaların elektromanyetik cihaz tasarımındaki performansını hesaplamalı benchmark'lar üzerinde incelemekte ve adaptif çok-algoritmalı MuCAO yöntemini geliştirmektedir. Bulgular optimizasyon simülasyonlarına aittir; fiziksel elektromanyetik cihaz üretimi veya saha testi gerçekleştirilmemiştir.
Kaynak içi tutarsızlık notu 1: Tablo 1 C-Core benchmark'ında yedi tasarım değişkeni bulunduğunu bildirirken Bölüm 3.5 ve Denklem (31) yalnız x1–x6 olmak üzere altı değişken tanımlamaktadır. Bu fark kaynakta açıklanmamaktadır.
Kaynak içi tutarsızlık notu 2: Sonuç tartışmasında MVPA'nın genel sırası 7 olarak yazılmıştır; ana Tablo 8 ise TTA'yı 7., MVPA'yı 8. sırada göstermektedir. Bu içerikte Tablo 8'deki sayısal sıralama esas alınmıştır ve metin–tablo farkı korunmuştur.
Skor karşılaştırma notu: Tablo 8, Tablo 17 ve Tablo 18'de MuCAO için farklı toplam rank-sum puanları bulunmaktadır. Bunun nedeni duyarlılık analizlerinde karşılaştırma havuzuna ek algoritma varyantlarının katılmasıdır. Rank-sum ölçeği havuz büyüklüğüne bağlı olduğundan farklı tablolardaki ham toplam skorlar doğrudan büyüklük karşılaştırmasına tabi tutulmamalıdır.
CAA doğrulama sınırı: Çalışma dairesel anten dizisi problemini “real-life application” olarak tanımlamaktadır; ancak değerlendirme matematiksel array-factor modeli üzerinden hesaplamalıdır ve fiziksel anten prototipi veya ölçüm deneyi içermez.
Genellenebilirlik sınırı: Araştırmacılar MuCAO bileşenlerinin bütün benchmark'lardaki global performansa göre seçilmesinin farklı problem türlerinde sınırlama yaratabileceğini belirtmektedir. Problem imzasına göre otomatik algoritma seçimi, dinamik bileşen sayısı ve daha düşük maliyetli FEM vekil modelleri gelecek çalışma yönleri arasındadır.
Bu Verianla içeriğinin bilimsel sonuçları yalnızca incelenen çalışmaya dayanmaktadır. Dış doğrulama yalnız makalenin başlık, DOI, dergi ve yayımlanmış bibliyografik kimliğini kontrol etmek amacıyla kullanılmış; dış kaynaktan yeni optimizasyon sonucu veya bilimsel bulgu ana içeriğe eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir