

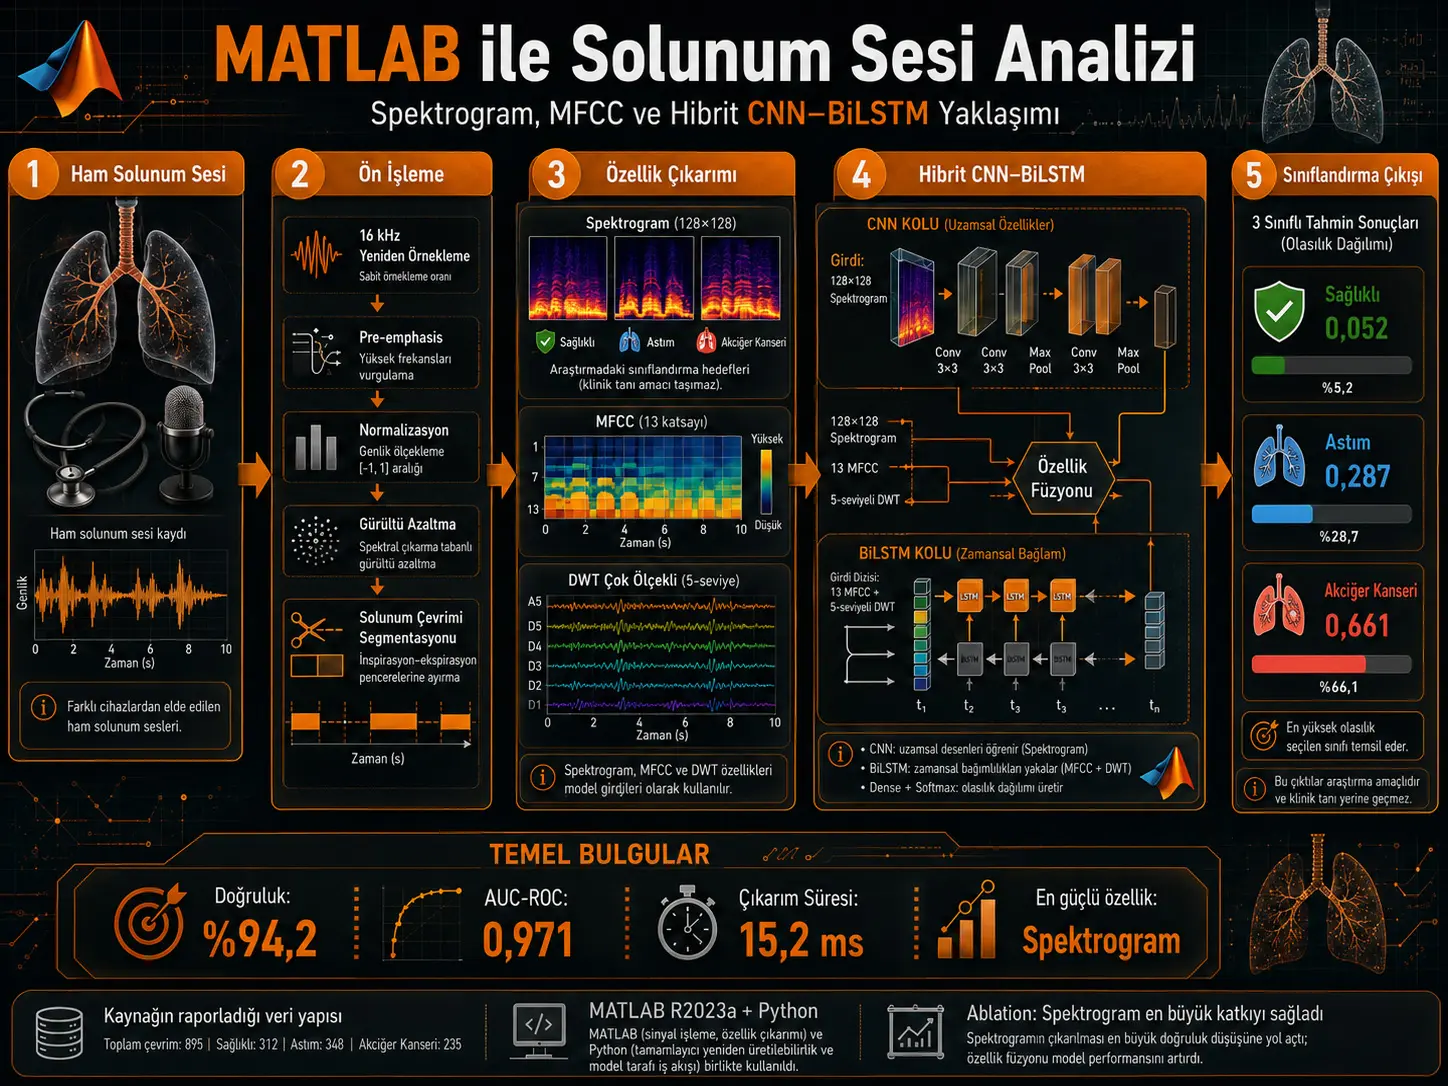
Çalışma, solunum seslerini zaman–frekans gösterimlerine dönüştürerek bir CNN–BiLSTM modeliyle üç sınıfa ayırmayı amaçlayan çift platformlu bir biyomedikal sinyal işleme iş akışı tanımlamaktadır. MATLAB, ham solunum sesinin yeniden örneklenmesi, filtrelenmesi, normalize edilmesi, spektrogram/MFCC/DWT tabanlı özelliklerin çıkarılması ve sonuçların doğrulanması için kullanılan iki ana hesaplama platformundan biridir. İkinci platform Python'dur.
Kaynak üç hedef etiketi Healthy, Asthma ve Lung Cancer olarak tanımlamaktadır. Ancak bu üçlü sınıflandırmanın özellikle “Lung Cancer” sınıfı yukarıdaki veri kaynağı doğrulama sorunu nedeniyle klinik tanı başarısı şeklinde yorumlanmamalıdır. Bu Verianla makalesi çalışmayı öncelikle MATLAB tabanlı solunum sesi işleme ve CNN–LSTM mimarisi açısından incelemektedir.
Kısa Özet
Kaynak çalışma, ICBHI 2017 Respiratory Sound Database'den seçildiğini belirttiği 895 solunum çevrimi üzerinde spektrogram, Mel-Frequency Cepstral Coefficients (MFCC), Discrete Wavelet Transform (DWT) ve zaman-alanı özelliklerini kullanan hibrit CNN–BiLSTM sınıflandırıcısı önermektedir. Sesler önce 16 kHz'e yeniden örneklenmekte, pre-emphasis uygulanmakta, z-score normalizasyonu ve spectral-subtraction gürültü azaltımı gerçekleştirilmekte, ardından solunum çevrimleri energy-envelope ve zero-crossing-rate eşikleriyle bölümlere ayrılmaktadır. CNN kolu 128×128 gri-seviye spektrogramlardan mekânsal özellik çıkarırken BiLSTM kolu MFCC tabanlı zamansal diziyi işlemektedir. Kaynağa göre birleşik model test setinde %94,2 accuracy, %93,9 precision, %93,5 recall, %93,6 F1-score ve 0,971 AUC-ROC üretmiştir. Ablation sonucunda spektrogramın çıkarılması accuracy'yi 8,5 yüzde puan düşürerek en büyük kayba yol açmıştır. Modelin raporlanan inference süresi 15,2 ms/model girdisi düzeyindedir. Ancak çalışmadaki akciğer kanseri etiketlerinin ICBHI 2017'nin doğrulanabilir tanı yapısıyla uyuşmaması nedeniyle bu performanslar doğrulanmış klinik akciğer-kanseri tanı ölçütleri olarak kabul edilmemelidir.
Solunum sesinden hastalık sınıflandırması nasıl bir MATLAB problemine dönüşüyor?
Bir akciğer ses kaydı bilgisayara girdiğinde model henüz “astım” veya başka bir klinik anlam görmez. MATLAB açısından başlangıç noktası yalnız zamana göre değişen sayısal genlik örnekleridir. Dolayısıyla araştırmanın hesaplama zinciri önce ham sesi standart bir örnekleme yapısına getirir, ardından gürültüyü azaltır ve zaman–frekans özelliklerini çıkarır. Derin öğrenme modeli ancak bu aşamaların sonrasında devreye girer.
Kaynağın sayfa 2'deki Şekil 1'i bu zinciri beş temel kutuyla göstermektedir: Raw Audio Input → Signal Preprocessing → Feature Extraction → CNN-LSTM Model → Classification Output. Veri artırımı yalnız eğitim sırasında kullanılan opsiyonel bir aşama olarak gösterilmiştir.
Veri kümesi kaynağa göre nasıl bölünmüş?
Kaynak, ICBHI 2017'deki 920 kayıttan kalite filtresi sonrasında 895 solunum çevrimi kullandığını bildirmektedir. Kaynağın verdiği tablo şöyledir:
| Kaynağın sınıf etiketi | Solunum çevrimi | Oran (%) | Training | Validation | Test |
|---|---|---|---|---|---|
| Healthy | 312 | 34,8 | 218 | 47 | 47 |
| Asthma | 348 | 38,9 | 244 | 52 | 52 |
| Lung Cancer | 235 | 26,3 | 165 | 35 | 35 |
| Toplam | 895 | 100 | 627 | 134 | 134 |
Bu tablo kaynak makalenin kendi deney tasarımını doğru biçimde aktarmaktadır. Ancak özellikle 235 Lung Cancer çevriminin ICBHI veri kümesinden nasıl elde edildiği açıklanmamıştır ve dış veri kümesi doğrulamasıyla uyuşmamaktadır. Bu yüzden sonraki bütün performans tabloları “kaynağın raporladığı sınıflandırma” olarak okunmalıdır.
Sayfa 3'teki üç spektrogram ne anlatıyor?
Kaynak Şekil 2'de aynı STFT gösterim formatında Healthy, Asthma ve Lung Cancer olarak etiketlediği üç örnek göstermektedir. Healthy örneği düşük enerjili ve daha homojen, Asthma örneği özellikle 500–2500 Hz arasında yatay/sürekli yüksek enerji bantlarına sahip, Lung Cancer olarak etiketlenen örnek ise düzensiz yüksek frekanslı kısa enerji patlamaları şeklinde yorumlanmaktadır.
Bu görüntüler CNN kolunun neden kullanılmak istendiğini açıklar: CNN yalnız toplam enerjiye bakmaz; spektrogram üzerindeki yerel şekil, bant, kenar ve zaman–frekans dokularını öğrenmeye çalışır. Ancak görsel örüntülerin akciğer kanserine özgü klinik biyobelirteç olduğu, veri etiketi sorunu giderilmeden ileri sürülemez.
MATLAB preprocessing zinciri
Kaynak preprocessing'i beş ardışık aşamaya ayırmaktadır. İlk aşama bütün kayıtların 16 kHz örnekleme hızına getirilmesidir. Böylece farklı orijinal sampling rate'lere sahip kayıtlar aynı zaman ekseninde işlenebilir. İkinci aşamada katsayısı \(\alpha=0.97\) olarak verilen first-order pre-emphasis uygulanmaktadır. Üçüncü aşamada z-score amplitude normalisation, dördüncü aşamada spectral-subtraction noise reduction ve son aşamada energy-envelope ile zero-crossing-rate thresholding tabanlı respiratory-cycle segmentation gerçekleştirilmektedir.
Kaynak bu işlemleri MATLAB R2023a üzerinde Audio Toolbox ve Signal Processing Toolbox ile, paralel doğrulama amacıyla Python üzerinde de uyguladığını belirtmektedir. Önemli bir kaynak bütünlüğü sorunu ise preprocessing denklemlerine Eq. 1, Eq. 9 ve Eq. 10 şeklinde referans verilmesine rağmen bu denklemlerin yüklenen PDF'de görünmemesidir. Bu nedenle Verianla burada eksik formülleri genel bilgiden tamamlamamaktadır.
Spektrogram neden 128×128 piksele dönüştürülüyor?
Kaynak CNN girişini 128×128×1 grayscale spectrogram olarak tanımlar. Buradaki ilk iki sayı görüntünün zaman–frekans düzlemindeki boyutunu, son sayı ise tek gri-seviye kanalını gösterir.
CNN açısından sabit giriş boyutu önemlidir. Farklı solunum çevrimlerinin süreleri değişse bile modelin convolution katmanlarına aynı geometrik boyutta veri verilmesi gerekir. Kaynak bu standardizasyonun ayrıntılı resize yöntemini açıklamamaktadır; yalnız nihai spektrogram boyutunu vermektedir.
MFCC nedir ve kaynakta kaç katsayı kullanılmıştır?
Kaynak feature-extraction görselinde her solunum örneği için 13 MFCC coefficient elde edildiğini göstermektedir. MFCC'ler sesin spektral zarfını daha sıkıştırılmış bir temsil halinde taşımak için kullanılmaktadır.
Çalışmadaki mimari açısından spektrogram ve MFCC aynı bilgiyi aynı biçimde temsil etmez. Spektrogram CNN'ye iki boyutlu görüntü verirken, MFCC dizisi BiLSTM koluna zamansal bir sıra olarak sunulur. Böylece biri mekânsal zaman–frekans yapıyı, diğeri sıralı akustik dinamiği öğrenmeye çalışır.
DWT neden ayrıca kullanılmış?
Kaynak DWT için Daubechies-4 (db4) wavelet ve 5 level decomposition kullandığını belirtmektedir. Wavelet analizi, kısa süreli geçici olayların farklı ölçeklerde temsil edilmesine olanak verir. Çalışma özellikle crackle benzeri kısa süreli geçici bilgilerin wavelet tarafından tamamlayıcı olarak yakalanabileceğini varsaymaktadır.
Ablation sonuçları bu özellik grubunun kaldırılmasının accuracy'yi %94,2'den %91,8'e indirdiğini, yani kaynak deneyinde 2,4 yüzde puanlık katkıyla ilişkilendirildiğini göstermektedir.
Sayfa 4'teki özellik bileşimi
Kaynağın Şekil 6'sındaki pasta grafik özellik bileşimini görsel olarak yaklaşık dört gruba ayırmaktadır: spektrogram, MFCC, DWT statistics ve time-domain özellikleri. Aynı şekil sağ tarafta 36-dimensional numerical feature vector göstermektedir.
Ancak aynı sayfadaki mimari metni BiLSTM'nin “MFCC sequence” işlediğini söylemektedir. DWT ve time-domain değişkenlerinin 36 boyutlu vektör üzerinden BiLSTM'ye mi verildiği, ayrı dense katmana mı gittiği veya MFCC sequence'ine nasıl eklendiği açık olarak belirtilmemiştir. Bu eksiklik, çalışmayı birebir MATLAB ortamında yeniden üretmek isteyen biri açısından önemlidir.
CNN kolu nasıl kurulmuş?
CNN kolu üç convolutional block içermektedir. Kaynak filtre sayılarını sırasıyla 32, 64 ve 128 olarak verir. Her blokta batch normalisation, 2×2 max-pooling ve \(p=0.25\) dropout kullanılır.
Bu kolun sonunda:
\[ f_{\mathrm{CNN}}\in\mathbb{R}^{128} \]
boyutlu bir temsil elde edildiği ve CNN kolunun yaklaşık 1,2 milyon parametre içerdiği belirtilmektedir.
Convolution filtreleri spektrogramın tamamını tek seferde ezberlemek yerine küçük bölgeler üzerinde tekrar kullanılan filtrelerle çalışır. Derin katmanlara geçildikçe daha basit yerel enerji desenlerinden daha karmaşık zaman–frekans örüntülerine doğru temsil oluşturulması hedeflenir.
BiLSTM kolu nasıl çalışıyor?
Kaynağa göre BiLSTM kolunda iki bidirectional LSTM layer bulunmaktadır. Bunların birincisi 128 unit, ikincisi 64 unit içerir.
Kol sonunda:
\[ f_{\mathrm{LSTM}}\in\mathbb{R}^{128} \]
boyutlu temsil üretilir ve bu kolun yaklaşık 0,8 milyon parametre taşıdığı raporlanır.
“Bidirectional” ifadesinin önemi, bir MFCC zaman adımının yalnız kendinden önceki örneklerle değil, eğitim sırasında dizinin sonraki kısmındaki bağlamla da birlikte temsil edilebilmesidir. Böylece solunum çevriminin zaman içerisindeki gelişimi CNN'nin spektrogram örüntülerini tamamlayan ikinci bilgi kanalı hâline gelir.
İki model nasıl birleştiriliyor?
Kaynağın açıkça verdiği fusion işlemi:
\[ f_{\mathrm{fused}} ================== [f_{\mathrm{CNN}};f_{\mathrm{LSTM}}] \in\mathbb{R}^{256} \]
şeklindedir.
128 boyutlu CNN ve 128 boyutlu BiLSTM çıktısı uç uca birleştirilerek 256 boyutlu feature-fusion vektörü elde edilir. Bunun ardından kaynak:
Dense(128) → Dropout(0.5) → Dense(3) → Softmax
zincirini tanımlar.
Son Dense(3) katmanındaki üç çıkış, kaynağın Healthy, Asthma ve Lung Cancer olarak tanımladığı üç sınıfı temsil etmektedir.
Model neden yaklaşık 2,1 milyon parametre?
Kaynak hesaplama tablosunda bütün CNN–LSTM sistemini yaklaşık 2,1 milyon trainable parameter ile raporlamaktadır. CNN kolu yaklaşık 1,2 milyon, BiLSTM kolu yaklaşık 0,8 milyon olarak verildiğinden kalan parametreler fusion sonrası dense sınıflandırma bölümünü de içerir.
Class imbalance nasıl ele alınmış?
Kaynak sınıflar arasındaki örnek sayısı eşit olmadığı için multi-class cross-entropy loss içerisinde class weights kullanmaktadır:
\[ w_c= \frac{N}{C,N_c} \]
Burada \(N\) toplam örnek sayısını, \(C\) sınıf sayısını ve \(N_c\) ilgili sınıfa ait örnek sayısını temsil eder. Böylece az örnekli sınıflardaki hataların loss fonksiyonundaki ağırlığının artırılması hedeflenir.
Eğitim parametreleri
| Eğitim parametresi | Kaynak değeri |
|---|---|
| Optimiser | Adam |
| Learning rate | 0,001 |
| \(\beta_1\) | 0,9 |
| \(\beta_2\) | 0,999 |
| Batch size | 32 |
| Maksimum epoch | 100 |
| Early-stopping patience | 15 |
| Cross-validation | 5-fold stratified |
| Time stretching | ×0,9–1,1 |
| Pitch shifting | ±2 semitone |
| Gaussian noise | \(\sigma=0.005\) |
Data augmentation yalnız training tarafına uygulanmaktadır. Bu ayrım önemlidir: test verisine augmentation uygulanması performans ölçümünün anlamını değiştirebilirdi.
Early stopping neden gerekli?
Kaynakta maksimum eğitim 100 epoch olarak belirlenmiş olmasına rağmen validation loss minimum değerine 45. epoch civarında ulaşmış ve en iyi model bu noktada checkpoint edilmiştir. Early stopping 60. epoch civarında devreye girmiştir.
Kaynağın raporladığı training loss başlangıçta 1,098 iken 0,142'ye kadar düşmüş; minimum validation loss ise 0,186 olmuştur. Yazarlar train ve validation eğrileri arasındaki dar farkı ciddi overfitting görülmediği şeklinde yorumlamaktadır.
Beş farklı modelin karşılaştırılması
Kaynağın kendi deneyleri içinde hibrit model bütün tek-kollu baseline modellerden daha yüksek sonuç vermektedir. CNN ile BiLSTM'nin birleşmesi, kaynakta yalnız spektrogram veya yalnız MFCC kullanımına göre daha yüksek performansla ilişkilendirilmektedir.
Accuracy neden tek başına yeterli değil?
Accuracy toplam doğru kararların oranıdır; fakat sınıflar dengesiz olduğunda tek başına yanıltıcı olabilir. Bu nedenle kaynak precision, recall, F1-score, specificity, ROC-AUC ve confusion matrix de raporlamaktadır.
Bu yaklaşım MATLAB ve yapay zekâ öğrenimi açısından son derece değerlidir. Özellikle sağlık sınıflandırmalarında modelin yalnız “kaç örneği doğru bildiği” değil, belirli sınıftaki gerçek vakaları ne oranda yakalayabildiği de önem taşır.
Kaynağın sınıf bazlı sonuçları
| Kaynak etiketi | Precision (%) | Recall (%) | F1 (%) | Specificity (%) | Test örneği |
|---|---|---|---|---|---|
| Healthy | 95,7 | 96,2 | 95,9 | 97,8 | 47 |
| Asthma | 92,8 | 94,1 | 93,4 | 96,2 | 52 |
| Lung Cancer | 93,1 | 89,2 | 91,1 | 97,5 | 35 |
| Macro average | 93,9 | 93,2 | 93,5 | 97,2 | 134 |
Kaynak, en düşük recall değerinin %89,2 ile Lung Cancer etiketinde olduğunu; bunu sınıf dengesizliği ve Asthma ile 500–2500 Hz bölgesindeki benzer wheeze akustiğiyle ilişkilendirmektedir. Bu açıklama kaynak yazarlarının yorumudur; veri etiketlerinin klinik kökeni doğrulanamadığından bağımsız klinik çıkarım olarak kabul edilmemelidir.
Confusion matrix'in gerçek sayıları
Sayfa 6'daki Şekil 5, 134 örneklik test seti için ham sayıları açık biçimde verir:
| Gerçek \ Tahmin | Healthy | Asthma | Lung Cancer |
|---|---|---|---|
| Healthy | 45 | 2 | 0 |
| Asthma | 2 | 48 | 1 |
| Lung Cancer | 0 | 4 | 33 |
Kaynağın kendi yorumunda en büyük tek off-diagonal hata, dört Lung Cancer örneğinin Asthma olarak sınıflandırılmasıdır.
ROC analizi
| Kaynak etiketi | One-vs-rest AUC |
|---|---|
| Healthy | 0,978 |
| Asthma | 0,969 |
| Lung Cancer | 0,965 |
Kaynak bütün ROC eğrilerinin rastgele sınıflandırıcının 0,5 AUC çizgisinin üzerinde bulunduğunu belirtmektedir. Beş katlı cross-validation için %95 confidence interval gölgeleri Şekil 7'de gösterilmiştir.
Ablation study nedir?
Ablation çalışmasında bir model bileşeni veya özellik grubu sırayla kaldırılır ve performansın ne kadar düştüğü gözlenir. Böylece modelin hangi bilgi kanalına daha çok bağımlı olduğu anlaşılmaya çalışılır.
Kaynağın en net modelleme sonucu budur: spektrogram kaldırıldığında performans en sert biçimde düşmektedir. Bununla birlikte yalnız spektrogram modeli %91,1'de kalırken bütün özelliklerin birleşimi %94,2'ye ulaşmaktadır. Yazarlar bunu farklı özellik modalitelerinin tamamlayıcı bilgi taşıdığı şeklinde yorumlamaktadır.
BiLSTM'nin katkısı nasıl ölçülmüş?
Kaynak, CNN-only baseline'ın %88,6 doğruluğunu hibrit sistemin %94,2 sonucu ile karşılaştırmakta; ayrıca frequency-sensitivity bölümünde BiLSTM temporal component'ın CNN-only yapıya göre 3,1 yüzde puanlık katkı verdiğini belirtmektedir. Bu iki ifade doğrudan aynı aritmetik fark değildir; kaynakta farklı bağlamlarda raporlanmıştır ve burada birbirine dönüştürülmemektedir.
Hangi frekans bölgesi daha ayırt edici?
Kaynak frequency-band sensitivity analizinde ayırt edici bilginin:
| Frekans aralığı | Kaynağın raporladığı katkı | Kaynak yorumu |
|---|---|---|
| 0–500 Hz | %23 | Normal breath |
| 500–2500 Hz | %45 | Wheeze patterns |
| 2500–8000 Hz | %32 | Crackles / high-frequency information |
olarak dağıldığını bildirmektedir. Ancak bu %23/%45/%32 değerlerinin hangi matematiksel sensitivity hesabından elde edildiği makalede ayrıntılı olarak tanımlanmamaktadır.
Hesaplama performansı
| Model | Parametre (M) | Training (dk) | Inference (ms) | Bellek (MB) |
|---|---|---|---|---|
| SVM + MFCC | — | 12,3 | 2,1 | 45 |
| Random Forest | — | 18,7 | 5,4 | 128 |
| CNN | 1,2 | 142,5 | 8,3 | 156 |
| BiLSTM | 0,8 | 98,4 | 12,7 | 98 |
| CNN–LSTM | 2,1 | 215,8 | 15,2 | 234 |
Bu tablo önemli bir makine öğrenmesi gerçeğini göstermektedir: kaynağın en yüksek accuracy değerini veren model aynı zamanda en uzun training süresine ve en yüksek bellek kullanımına sahiptir. Daha karmaşık model her ölçütte otomatik olarak “daha iyi” değildir; doğruluk ile hesaplama maliyeti arasında bir tasarım değiş tokuşu vardır.
15,2 ms ne anlama geliyor?
Kaynak CNN–LSTM için 15,2 ms inference süresi raporlamakta ve bunu 400 ms pencere uzunluğundaki streaming audio için 25 ms gereksinimden daha kısa olduğu gerekçesiyle gerçek-zamanlı kullanıma uygun olarak yorumlamaktadır.
Burada dikkat edilmesi gereken ifade birimidir. Tablo “Inference (ms)” yazarken metin “15.2 ms/sample” demektedir. Eğer “sample” burada tek bir 16 kHz audio sample anlamına gelseydi bu yorum doğru olmazdı. Kaynağın bağlamına göre kastedilenin bir model örneği / analiz penceresi olması daha olasıdır; fakat makale bunu açıkça tanımlamamıştır.
İstatistiksel anlamlılık testi
Kaynak beş katlı cross-validation sonuçları üzerinde paired t-test uyguladığını belirtmektedir:
| Karşılaştırma | t | p |
|---|---|---|
| CNN–LSTM vs CNN | 3,42 | 0,026 |
| CNN–LSTM vs BiLSTM | 4,18 | 0,013 |
| CNN–LSTM vs Random Forest | 6,73 | 0,002 |
Üç karşılaştırmada da kaynak \(p<0.05\) sonucuna ulaşmaktadır. Bununla birlikte yalnız beş fold üzerinden t-test uygulanması küçük örnekli bir istatistiksel karşılaştırmadır; performans iddiasının veri-etiketi ve subject leakage gibi temel veri sorunlarını tek başına çözmez.
Literatürde daha yüksek accuracy varken kaynak neden %94,2'yi önemli görüyor?
Makale kendi yönteminin mutlak accuracy rekoru olduğunu iddia etmemektedir. Kaynak Tablo 6'da Zhang ve arkadaşlarının 2024 tarihli dual-channel CNN-LSTM yönteminin %99,01 accuracy raporladığını açıkça kabul etmektedir.
Yazarların kendi katkı iddiası daha çok üç noktadadır: üç sınıflı disease classification, MATLAB/Python çift platformlu yeniden üretilebilirlik ve inference latency / memory footprint gibi hesaplama profilinin raporlanması.
Ancak ilk katkıdaki “lung cancer” sınıfının veri kökeni doğrulanamadığı için bu katkı Verianla tarafından kanıtlanmış klinik yenilik olarak kabul edilmemektedir.
MATLAB açısından bu araştırmadan ne öğrenebiliriz?
Çalışmanın en yararlı tarafı tek bir derin öğrenme ağı değil, uçtan uca mühendislik zinciridir. MATLAB öğrenen birinin burada görmesi gereken ilişki şudur: ham sinyal standartlaştırılmadan model eğitilemez; spektrogram ve MFCC gibi temsiller farklı bilgi taşır; CNN ve LSTM farklı veri geometrilerini işler; sınıf dengesizliği loss tasarımını etkiler; augmentation yalnız eğitimde uygulanmalıdır; training accuracy tek başına yeterli değildir; validation, test, confusion matrix, ROC, ablation ve cross-validation birbirinden farklı sorulara cevap verir; ayrıca modelin bellek ve inference süresi de gerçek bir sistem tasarımının parçasıdır.
Bu nedenle MATLAB'da biyomedikal yapay zekâ projesi “bir sinyali spectrogram'a çevirip neural network'e vermekten” çok daha geniştir. Veri kökeni ve hasta etiketlerinin doğruluğu, kodun kendisinden bile önce gelir. Bu çalışma tam olarak bu noktada çok öğretici bir karşı örnek de sunmaktadır: hesaplama zinciri ne kadar gelişmiş olursa olsun, hedef etiketlerin kaynağı doğrulanamıyorsa model performansının klinik anlamı zayıflar.
Çalışmanın Yöntemi ve Bulguları
Kaynağın araştırma soruları
Makale dört araştırma sorusu tanımlamaktadır. Birinci soru spektrogram özelliklerinin solunum sesi sınıflarını klinik açıdan anlamlı sensitivity ile ayırıp ayıramayacağıdır. İkinci soru hibrit CNN–LSTM mimarisinin tek-model baseline'ları geçip geçemeyeceğidir. Üçüncü soru hangi feature modality'nin accuracy'ye en büyük katkıyı yaptığıdır. Dördüncü soru sistemin gerçek-zamanlı kullanıma yetecek hesaplama performansına sahip olup olmadığıdır.
Veri hazırlama
Kaynak 920 ICBHI kaydından kalite filtresi sonrası 895 respiratory cycle kullandığını belirtmektedir. Bunların %70'i training, %15'i validation ve %15'i test için ayrılmıştır. Sayılar sırasıyla 627, 134 ve 134'tür.
Burada tekrar vurgulanması gereken nokta, split'in “stratified” olarak belirtilmesine karşın patient-independent olarak tanımlanmamasıdır. Bir hastaya ait farklı çevrimlerin birbirinden bağımsız veri örneği gibi farklı bölümlere düşüp düşmediği bilinmemektedir.
Preprocessing
| Sıra | Kaynak işlemi | Kaynak parametresi |
|---|---|---|
| 1 | Resampling | 16 kHz |
| 2 | Pre-emphasis | \(\alpha=0.97\) |
| 3 | Amplitude normalisation | z-score |
| 4 | Noise reduction | spectral subtraction |
| 5 | Respiratory cycle segmentation | energy envelope + ZCR thresholding |
Feature extraction
Kaynakta doğrudan doğrulanabilen ana girdiler 128×128 spektrogram, 13 MFCC katsayısı, db4 wavelet ile beş seviye DWT ve time-domain özellikleridir. Şekil 6 ayrıca 36 boyutlu numerical feature vector göstermektedir.
Model mimarisi
| Katman / bölüm | Kaynak yapı |
|---|---|
| CNN input | 128×128×1 spektrogram |
| Convolution block 1 | 32 filtre + batch norm + 2×2 max-pool + dropout 0,25 |
| Convolution block 2 | 64 filtre + batch norm + 2×2 max-pool + dropout 0,25 |
| Convolution block 3 | 128 filtre + batch norm + 2×2 max-pool + dropout 0,25 |
| CNN embedding | 128 boyut |
| BiLSTM layer 1 | 128 unit |
| BiLSTM layer 2 | 64 unit |
| BiLSTM embedding | 128 boyut |
| Fusion | 256 boyut |
| Dense | 128 |
| Dropout | 0,5 |
| Output | Dense(3) + softmax |
Ana performans sonucu
Kaynağın nihai hibrit modeli %94,2 accuracy ve 0,971 AUC-ROC üretmektedir. Tek CNN %88,6, tek BiLSTM ise %90,5 accuracy'de kalmıştır. Dolayısıyla kaynak verileri içinde fusion modeli iki tek-kollu modele göre daha yüksek performans göstermektedir.
Özellik katkısı sonucu
Ablation çalışmasının en büyük kaybı spektrogram kaldırıldığında ortaya çıkmaktadır: %94,2 → %85,7. MFCC kaldırıldığında %89,3, wavelet kaldırıldığında %91,8 ve time-domain kaldırıldığında %93,5 elde edilmektedir.
Bu, kaynağın RQ3 sorusuna verdiği cevaptır: kendi deneyinde en ayırt edici tek modalite spektrogramdır.
Hesaplama maliyeti sonucu
Hibrit sistem 2,1 milyon parametre, 215,8 dakikalık training, 15,2 ms inference ve 234 MB memory footprint ile en maliyetli test edilen modeldir. Buna karşılık en yüksek accuracy'yi de bu sistem vermektedir.
Kaynağın kendi sınırlılıkları
Yazarlar 895 çevrimlik veri kümesinin klinik ölçek açısından küçük olduğunu, Lung Cancer sınıfının %26,3 oranında az temsil edildiğini, bağımsız dış kohort validation yapılmadığını, cancer stage veya asthma severity gibi alt sınıfların ele alınmadığını, interpretability yaklaşımının formal SHAP/LIME yerine frequency-band sensitivity ile sınırlı olduğunu ve literatürdeki %99,01'lik Zhang çalışmasıyla karşılaştırmanın farklı augmentation stratejilerinden etkilendiğini kabul etmektedir.
Verianla'nın kaynağa eklediği temel doğrulama sınırı
Kaynağın kendi limitation bölümüne ek olarak Verianla açısından en önemli sorun veri etiketlerinin kökenidir. Resmî ICBHI kaydı 920 ses dosyası, 126 kişi ve 6.898 respiratory cycle bildirirken çevrimlerin uzmanlar tarafından normal, crackle, wheeze veya crackle+wheeze şeklinde işaretlendiğini açıklar. Hastalık bazlı ICBHI kullanımını açıklayan yayınlar veri kümesindeki tanıları COPD, Healthy, Bronchiectasis, Bronchiolitis, URTI, Pneumonia, Asthma ve LRTI şeklinde göstermektedir; bunların içinde lung cancer yoktur.
Bu nedenle kaynakta yer alan “235 Lung Cancer respiratory cycles” ifadesinin yeniden üretilebilir bir veri eşleştirmesi olmadan kabul edilmesi mümkün değildir. Kaynağın MATLAB kodu, hasta kimlik listesi veya 235 çevrimi hangi tanı metadata'sından oluşturduğu yayımlanırsa bu konu ayrıca yeniden değerlendirilebilir.
Sonuç
MATLAB ve derin öğrenme perspektifinden bakıldığında çalışma; ses preprocessing, spektrogram, MFCC, wavelet, CNN, BiLSTM, feature fusion, class weighting, augmentation, early stopping, cross-validation, confusion matrix, ROC, ablation ve inference profiling kavramlarının bir araştırma zincirinde nasıl bir araya getirilebileceğini gösteren zengin bir örnektir.
Bilimsel tanı perspektifinden ise aynı çalışma önemli bir ilkeyi hatırlatmaktadır: modelin %94,2 doğruluk üretmesi, hedef sınıfların doğru tanımlandığını kanıtlamaz. Yapay zekâ yalnız kendisine verilen etiketleri öğrenir. Etiketlerin klinik kaynağı doğrulanmadığında daha iyi neural network mimarisi bu temel problemi çözemez. Bu nedenle Verianla açısından bu çalışmanın en doğru kullanımı “MATLAB ile solunum sesi sınıflandırmasının teknik iş akışını öğretmek”tir; mevcut haliyle “akciğer kanserini solunum sesinden %94,2 doğrulukla teşhis eden doğrulanmış sistem” biçiminde sunmak değildir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Spectrogram-Based Detection of Lung Cancer and Asthma Using Deep Learning and MATLAB: A Hybrid CNN-LSTM Approach
Yazarlar: Mridul Vats; Pooja Sabherwal; Monika Agrawal.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Kurumlar: Kaynak PDF, Mridul Vats ve Pooja Sabherwal için The NorthCap University, Department of Electronics and Communication Engineering; Monika Agrawal için IIT Delhi, Centre for Applied Research in Electronics (CARE) bilgisini vermektedir.
Temas yazarı: SSRN kayıt sayfasında Mridul Vats Contact Author olarak gösterilmektedir.
Kaynak türü: Derin öğrenme ve biyomedikal sinyal işleme preprint'i.
Hedef dergi: Kaynak PDF üzerinde Biomedical Signal Processing and Control'a gönderilmiş manuscript olarak görünmektedir. Bu ifade yayın kabulü değildir.
Hakemlik durumu: Bu çalışma hakem değerlendirmesinden geçmemiş bir preprinttir; sonuçları bu yayın aşaması dikkate alınarak değerlendirilmelidir.
Platform: SSRN.
DOI: 10.2139/ssrn.6689273.
SSRN tarihi: 1 Mayıs 2026.
MATLAB: MATLAB R2023a, Audio Toolbox, Signal Processing Toolbox.
Python tarafı: librosa, scipy, PyWavelets.
Kaynak kod erişimi: Makale MATLAB ve Python implementation script'lerinin corresponding author'dan makul talep üzerine alınabileceğini belirtmektedir; yüklenen sürümde açık kalıcı kod deposu verilmemiştir.
Finansman: No external funding.
Çıkar çatışması: Kaynak, competing financial or personal interests olmadığını beyan etmektedir.
Veri erişimi: Kaynak ICBHI 2017 Respiratory Sound Database'i kullanmaktadır. Resmî ICBHI kaydı veri kümesini 920 kayıt, 126 kişi ve 6.898 respiratory cycle olarak tanımlar.
Kritik veri-etiketi uyarısı: Kaynak 312 Healthy, 348 Asthma ve 235 Lung Cancer çevrimi kullandığını iddia etmektedir. Dış bibliyografik doğrulamada ICBHI tanı sınıfları içerisinde akciğer kanseri bulunamamıştır. ICBHI'yi hastalık düzeyinde kullanan yayınlarda COPD, healthy, bronchiectasis, bronchiolitis, URTI, pneumonia, asthma ve LRTI sınıfları raporlanmaktadır. Kaynak makale 235 lung-cancer etiketinin nereden geldiğini açıklamamaktadır.
Hasta bazlı split uyarısı: Kaynak %70/%15/%15 stratified split ve 5-fold stratified cross-validation bildirmektedir ancak subject-independent partition açıkça belirtilmemektedir. Bu nedenle aynı hastanın farklı solunum çevrimlerinin eğitim ve test setleri arasında dağılıp dağılmadığı doğrulanamamaktadır.
Mimari yeniden üretilebilirlik uyarısı: DWT ve time-domain features ablation analizinde model bileşeni olarak görünürken mimari açıklamasında nihai fusion açıkça yalnız CNN spectrogram embedding ve BiLSTM MFCC embedding arasında gösterilmiştir. Bu özelliklerin gerçek network bağlantısı tam tanımlanmamıştır.
Denklem eksikliği: Kaynak Eq. 1–15 aralığındaki çeşitli denklemlere gönderme yapmakta fakat yüklenen PDF'de bunların önemli kısmı görünmemektedir. Eksik ifadeler Verianla tarafından dış bilgiden yeniden üretilmemiştir.
Klinik kullanım sınırı: Bu çalışma bir klinik tanı testi, prospektif hasta çalışması veya bağımsız hastane doğrulaması değildir. External validation yapılmamıştır. Veri etiketleme sorunu çözülmeden “lung-cancer detection” performansının klinik geçerliliği gösterilmiş sayılamaz.
Bilimsel içerik kaynağı: MATLAB/Python preprocessing, CNN–BiLSTM mimarisi, bütün model parametreleri, dataset tablosu, model sonuçları, confusion matrix, ROC, ablation, eğitim dinamikleri, inference/bellek değerleri ve kaynak yazarların yorumları yüklenen 10 sayfalık makaleye dayanmaktadır. Dış kaynak araştırması yalnız bibliyografik kimlik ve ICBHI veri yapısının bağımsız doğrulanması için kullanılmıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir