

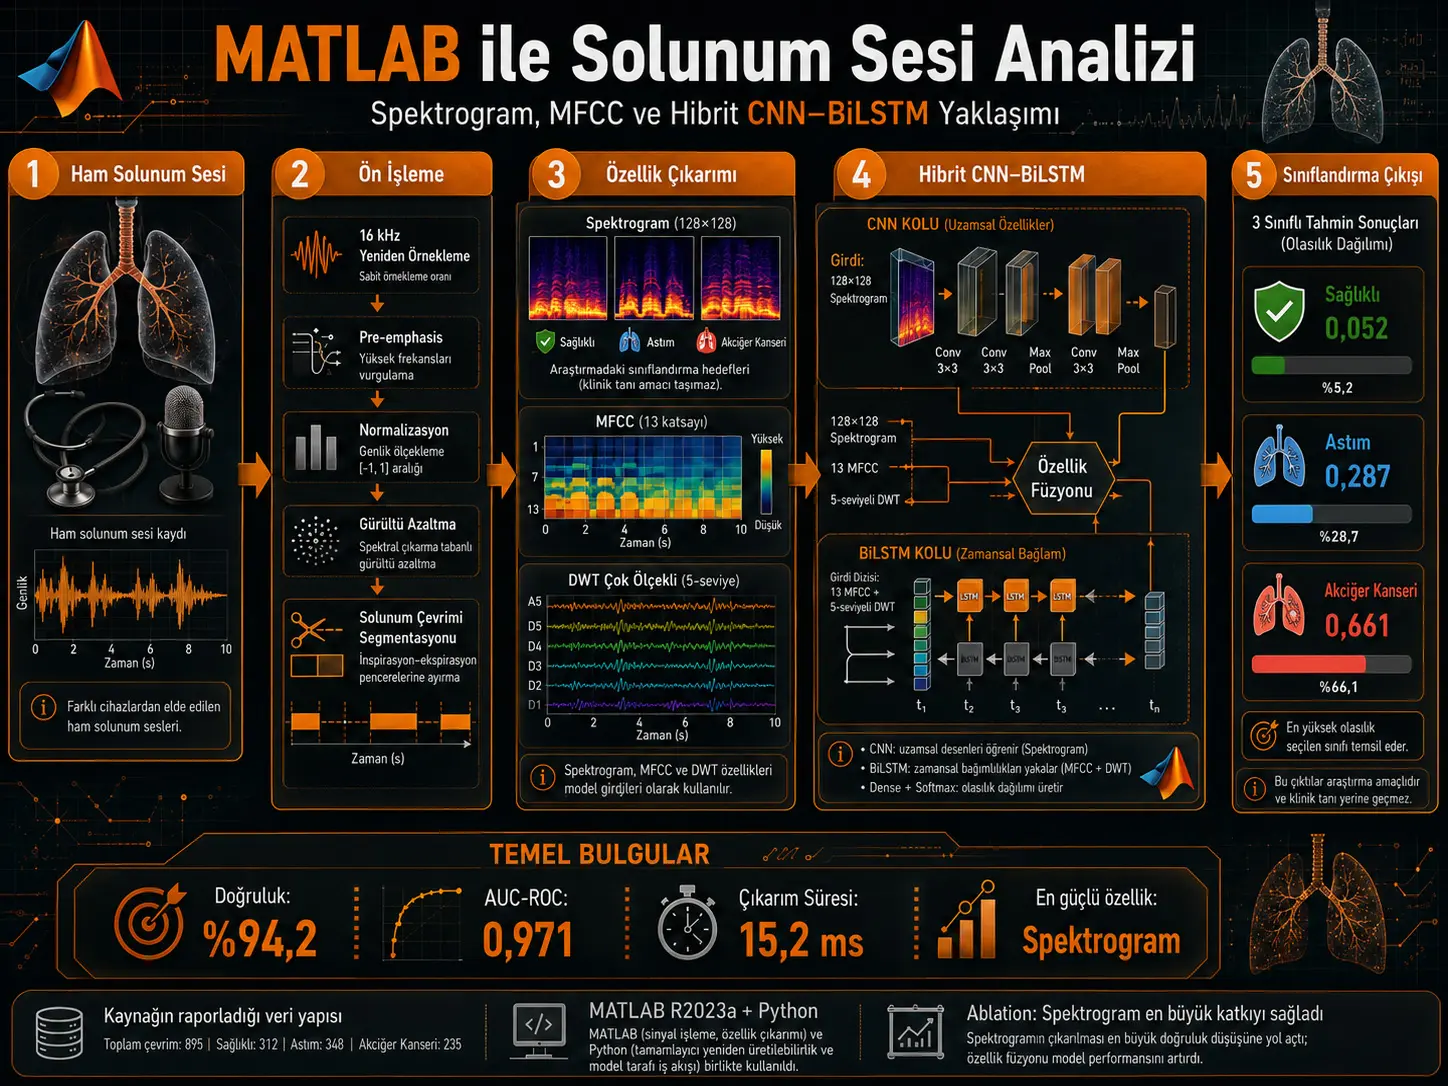
Utafiti unaeleza mtiririko wa kazi wa usindikaji wa ishara za kibiomedikali unaotumia majukwaa mawili, wenye lengo la kubadilisha sauti za upumuaji kuwa maonyesho ya muda–masafa na kuzigawa katika madarasa matatu kwa kutumia modeli ya CNN–BiLSTM. MATLAB ni mojawapo ya majukwaa mawili makuu ya kompyuta yaliyotumika kwa kusampuli upya sauti ghafi za upumuaji, kuzichuja, kuzisawazisha, kutoa vipengele vinavyotegemea spektrogramu/MFCC/DWT na kuthibitisha matokeo. Jukwaa la pili ni Python.
Chanzo kinafafanua lebo tatu lengwa kama Healthy, Asthma na Lung Cancer. Hata hivyo, uainishaji huu wa madarasa matatu, hasa darasa la “Lung Cancer”, haupaswi kutafsiriwa kama mafanikio ya uchunguzi wa kliniki kutokana na tatizo la uthibitishaji wa chanzo cha data lililoelezwa hapo juu. Makala hii ya Verianla inachunguza utafiti huu hasa kwa mtazamo wa usindikaji wa sauti za upumuaji unaotegemea MATLAB na usanifu wa CNN–LSTM.
Muhtasari Mfupi
Utafiti wa chanzo unapendekeza kiainishaji mseto cha CNN–BiLSTM kinachotumia spektrogramu, Mel-Frequency Cepstral Coefficients (MFCC), Discrete Wavelet Transform (DWT) na vipengele vya kikoa cha muda kwenye mizunguko 895 ya upumuaji ambayo chanzo kinasema ilichaguliwa kutoka ICBHI 2017 Respiratory Sound Database. Sauti kwanza husampuliwa upya hadi 16 kHz, pre-emphasis hutumika, normalisation ya z-score na upunguzaji wa kelele wa spectral-subtraction hufanywa, kisha mizunguko ya upumuaji hugawanywa kwa vizingiti vya energy-envelope na zero-crossing-rate. Tawi la CNN hutoa vipengele vya anga kutoka spektrogramu za kijivu za 128×128, huku tawi la BiLSTM likichakata mfululizo wa muda unaotegemea MFCC. Kwa mujibu wa chanzo, modeli iliyounganishwa ilitoa %94,2 accuracy, %93,9 precision, %93,5 recall, %93,6 F1-score na 0,971 AUC-ROC kwenye seti ya test. Katika ablation, kuondoa spektrogramu kulipunguza accuracy kwa pointi 8,5 za asilimia na kusababisha hasara kubwa zaidi. Muda wa inference ulioripotiwa wa modeli ni 15,2 ms/model input. Hata hivyo, kwa sababu lebo za saratani ya mapafu katika utafiti hazilingani na muundo wa uchunguzi unaoweza kuthibitishwa wa ICBHI 2017, vipimo hivi vya utendaji havipaswi kukubaliwa kama vigezo vilivyothibitishwa vya kliniki vya kutambua saratani ya mapafu.
Uainishaji wa ugonjwa kutoka sauti za upumuaji unageukaje kuwa tatizo la MATLAB?
Rekodi ya sauti ya mapafu inapoingia kwenye kompyuta, modeli bado haioni maana ya kliniki kama “pumu” au hali nyingine. Kwa mtazamo wa MATLAB, sehemu ya kuanzia ni sampuli za namba za amplitude zinazobadilika kwa muda pekee. Kwa hiyo, mnyororo wa kompyuta wa utafiti kwanza huleta sauti ghafi katika muundo wa kawaida wa usampulishaji, kisha hupunguza kelele na kutoa vipengele vya muda–masafa. Modeli ya ujifunzaji wa kina huanza kutumika baada ya hatua hizi.
Kielelezo 1 kwenye ukurasa wa 2 wa chanzo kinaonyesha mnyororo huu kwa visanduku vitano vikuu: Raw Audio Input → Signal Preprocessing → Feature Extraction → CNN-LSTM Model → Classification Output. Data augmentation imeonyeshwa kama hatua ya hiari inayotumika wakati wa training pekee.
Seti ya data imegawanywa vipi kwa mujibu wa chanzo?
Chanzo kinaripoti kuwa kilitumia mizunguko 895 ya upumuaji baada ya kichujio cha ubora kutoka rekodi 920 za ICBHI 2017. Jedwali lililotolewa na chanzo ni hili:
| Lebo ya darasa ya chanzo | Mzunguko wa upumuaji | Uwiano (%) | Training | Validation | Test |
|---|---|---|---|---|---|
| Healthy | 312 | 34,8 | 218 | 47 | 47 |
| Asthma | 348 | 38,9 | 244 | 52 | 52 |
| Lung Cancer | 235 | 26,3 | 165 | 35 | 35 |
| Jumla | 895 | 100 | 627 | 134 | 134 |
Jedwali hili linaakisi kwa usahihi muundo wa majaribio wa makala chanzo yenyewe. Hata hivyo, hasa haijaelezwa jinsi mizunguko 235 ya Lung Cancer ilivyopatikana kutoka seti ya data ya ICBHI, na hali hii haiendani na uthibitishaji wa nje wa seti ya data. Kwa hiyo, majedwali yote ya utendaji yanayofuata yanapaswa kusomwa kama “uainishaji ulioripotiwa na chanzo”.
Spektrogramu tatu kwenye ukurasa wa 3 zinaeleza nini?
Chanzo kinaonyesha kwenye Kielelezo 2 mifano mitatu iliyowekewa lebo Healthy, Asthma na Lung Cancer kwa kutumia umbizo moja la onyesho la STFT. Mfano wa Healthy unafafanuliwa kuwa na nishati ndogo na usambazaji uliosawazika zaidi, mfano wa Asthma una bendi za nishati kubwa zilizo mlalo/endelevu hasa kati ya 500–2500 Hz, na mfano uliowekewa lebo Lung Cancer unatafsiriwa kama milipuko mifupi isiyo ya kawaida ya nishati ya masafa ya juu.
Picha hizi zinaeleza kwa nini tawi la CNN linakusudiwa kutumika: CNN haliangalii nishati ya jumla pekee; hujaribu kujifunza umbo la ndani, bendi, kingo na muundo wa muda–masafa kwenye spektrogramu. Hata hivyo, haiwezekani kudai kwamba mifumo hii ya kuona ni biomarker ya kliniki inayohusiana mahsusi na saratani ya mapafu kabla ya tatizo la lebo za data kutatuliwa.
Mnyororo wa MATLAB preprocessing
Chanzo kinagawanya preprocessing katika hatua tano zinazofuatana. Hatua ya kwanza ni kuleta rekodi zote katika kiwango cha usampulishaji cha 16 kHz. Kwa njia hii, rekodi zenye sampling rate za awali tofauti zinaweza kuchakatwa kwenye mhimili mmoja wa muda. Katika hatua ya pili, first-order pre-emphasis yenye mgawo \(\alpha=0.97\) hutumika. Katika hatua ya tatu hufanywa z-score amplitude normalisation, katika hatua ya nne spectral-subtraction noise reduction, na katika hatua ya mwisho respiratory-cycle segmentation inayotegemea energy-envelope pamoja na zero-crossing-rate thresholding.
Chanzo kinasema kuwa michakato hii ilitekelezwa kwenye MATLAB R2023a kwa Audio Toolbox na Signal Processing Toolbox, na pia kwenye Python kwa madhumuni ya uthibitishaji sambamba. Tatizo muhimu la uadilifu wa chanzo ni kwamba ingawa marejeo ya milinganyo ya preprocessing yametolewa kama Eq. 1, Eq. 9 na Eq. 10, milinganyo hiyo haionekani kwenye PDF iliyopakiwa. Kwa hiyo, Verianla haitimii fomula zinazokosekana kwa kutumia maarifa ya jumla.
Kwa nini spektrogramu inabadilishwa kuwa pikseli 128×128?
Chanzo kinafafanua ingizo la CNN kama 128×128×1 grayscale spectrogram. Namba mbili za kwanza zinaonyesha vipimo vya picha kwenye uwanda wa muda–masafa, na namba ya mwisho inaonyesha chaneli moja ya kijivu.
Kwa CNN, ukubwa thabiti wa ingizo ni muhimu. Hata kama urefu wa mizunguko tofauti ya upumuaji unatofautiana, tabaka za convolution za modeli zinahitaji kupewa data yenye ukubwa uleule wa kijiometri. Chanzo hakielezi kwa undani mbinu ya resize ya usanifishaji huu; kinatoa tu ukubwa wa mwisho wa spektrogramu.
MFCC ni nini na ni coefficients ngapi zilitumika kwenye chanzo?
Katika picha ya feature-extraction, chanzo kinaonyesha kwamba 13 MFCC coefficient zilipatikana kwa kila sampuli ya upumuaji. MFCC hutumika kubeba bahasha ya spektra ya sauti katika uwakilishi uliobanwa zaidi.
Kwa mtazamo wa usanifu wa utafiti, spektrogramu na MFCC haziwakilishi taarifa ileile kwa namna ileile. Spektrogramu huipa CNN picha ya pande mbili, ilhali mfululizo wa MFCC huwasilishwa kwa tawi la BiLSTM kama mfululizo wa muda. Hivyo, moja hujaribu kujifunza muundo wa anga wa muda–masafa, na nyingine hujaribu kujifunza mienendo ya akustiki iliyo katika mfuatano.
Kwa nini DWT ilitumika pia?
Chanzo kinasema kuwa kilitumia Daubechies-4 (db4) wavelet na 5 level decomposition kwa DWT. Uchambuzi wa wavelet huruhusu matukio ya mpito ya muda mfupi kuwakilishwa katika mizani tofauti. Utafiti unadhania hasa kwamba taarifa fupi za mpito kama crackle zinaweza kukamatwa kwa njia ya ziada na wavelet.
Matokeo ya ablation yanaonyesha kwamba kuondoa kundi hili la vipengele kulipunguza accuracy kutoka %94,2 hadi %91,8, yaani kulihusishwa na mchango wa pointi 2,4 za asilimia katika jaribio la chanzo.
Muundo wa vipengele kwenye ukurasa wa 4
Chati ya duara kwenye Kielelezo 6 cha chanzo inagawanya kwa kuonekana muundo wa vipengele katika takribani makundi manne: spektrogramu, MFCC, DWT statistics na vipengele vya time-domain. Kielelezo hicho hicho kinaonyesha upande wa kulia 36-dimensional numerical feature vector.
Hata hivyo, maandishi ya usanifu kwenye ukurasa huo yanasema BiLSTM huchakata “MFCC sequence”. Haijaelezwa wazi ikiwa vigeu vya DWT na time-domain vinaingizwa kwenye BiLSTM kupitia vector ya vipimo 36, vinaenda kwenye tabaka tofauti la dense, au vinaongezwaje kwenye MFCC sequence. Upungufu huu ni muhimu kwa mtu anayetaka kurudia utafiti hatua kwa hatua katika mazingira ya MATLAB.
Tawi la CNN limeundwaje?
Tawi la CNN lina convolutional block tatu. Chanzo kinatoa idadi ya filters kama 32, 64 na 128 mtawalia. Kila block hutumia batch normalisation, 2×2 max-pooling na \(p=0.25\) dropout.
Mwishoni mwa tawi hili:
\[ f_{\mathrm{CNN}}\in\mathbb{R}^{128} \]
uwakilishi wa ukubwa huo hupatikana, na chanzo kinasema tawi la CNN lina takribani parameta milioni 1,2.
Filters za convolution hufanya kazi kwa kutumia filters zinazotumika tena kwenye maeneo madogo badala ya kukariri spektrogramu nzima kwa mara moja. Kadiri tabaka zinavyokuwa za kina zaidi, lengo ni kuunda uwakilishi kutoka mifumo rahisi ya nishati ya ndani kuelekea mifumo changamano zaidi ya muda–masafa.
Tawi la BiLSTM linafanyaje kazi?
Kwa mujibu wa chanzo, tawi la BiLSTM lina bidirectional LSTM layer mbili. Ya kwanza ina 128 unit na ya pili ina 64 unit.
Mwishoni mwa tawi:
\[ f_{\mathrm{LSTM}}\in\mathbb{R}^{128} \]
uwakilishi wa ukubwa huo huzalishwa, na tawi hili linaripotiwa kuwa na takribani parameta milioni 0,8.
Umuhimu wa neno “Bidirectional” ni kwamba hatua ya muda ya MFCC inaweza kuwakilishwa si tu pamoja na sampuli zinazotangulia, bali pia pamoja na muktadha wa sehemu inayofuata ya mfululizo wakati wa training. Hivyo, maendeleo ya mzunguko wa upumuaji kwa muda yanakuwa chaneli ya pili ya taarifa inayokamilisha mifumo ya spektrogramu inayojifunzwa na CNN.
Modeli mbili zinaunganishwaje?
Operesheni ya fusion iliyotolewa wazi na chanzo ni:
\[ f_{\mathrm{fused}} ================== [f_{\mathrm{CNN}};f_{\mathrm{LSTM}}] \in\mathbb{R}^{256} \]
kwa muundo huu.
Matokeo ya vipimo 128 kutoka CNN na vipimo 128 kutoka BiLSTM huunganishwa mwisho kwa mwisho ili kupata vector ya feature-fusion yenye vipimo 256. Baada ya hapo, chanzo kinafafanua mnyororo:
Dense(128) → Dropout(0.5) → Dense(3) → Softmax
.
Matokeo matatu katika tabaka la mwisho la Dense(3) yanawakilisha madarasa matatu ambayo chanzo kinayaita Healthy, Asthma na Lung Cancer.
Kwa nini modeli ina takribani parameta milioni 2,1?
Chanzo kinaripoti mfumo mzima wa CNN–LSTM kuwa na takribani 2,1 million trainable parameter kwenye jedwali la kompyuta. Kwa kuwa tawi la CNN limetolewa kuwa na takribani milioni 1,2 na tawi la BiLSTM takribani milioni 0,8, parameta zilizobaki pia zinajumuisha sehemu ya dense classification baada ya fusion.
Class imbalance imeshughulikiwaje?
Kwa sababu idadi ya sampuli si sawa kati ya madarasa, chanzo kinatumia class weights ndani ya multi-class cross-entropy loss:
\[ w_c= \frac{N}{C,N_c} \]
Hapa \(N\) inawakilisha jumla ya sampuli, \(C\) idadi ya madarasa na \(N_c\) idadi ya sampuli za darasa husika. Kwa njia hii, lengo ni kuongeza uzito wa makosa ya madarasa yenye sampuli chache katika loss function.
Vigezo vya training
| Kigezo cha training | Thamani ya chanzo |
|---|---|
| Optimiser | Adam |
| Learning rate | 0,001 |
| \(\beta_1\) | 0,9 |
| \(\beta_2\) | 0,999 |
| Batch size | 32 |
| Upeo wa epoch | 100 |
| Early-stopping patience | 15 |
| Cross-validation | 5-fold stratified |
| Time stretching | ×0,9–1,1 |
| Pitch shifting | ±2 semitone |
| Gaussian noise | \(\sigma=0.005\) |
Data augmentation hutumika upande wa training pekee. Tofauti hii ni muhimu: kutumia augmentation kwenye data ya test kungeweza kubadilisha maana ya kipimo cha utendaji.
Kwa nini Early stopping ni muhimu?
Ingawa kiwango cha juu cha training kiliwekwa kuwa 100 epoch kwenye chanzo, validation loss ilifikia thamani yake ya chini karibu na epoch ya 45 na modeli bora ikawekwa checkpoint hapo. Early stopping ilianza kufanya kazi karibu na epoch ya 60.
Training loss iliyoripotiwa na chanzo ilianza katika 1,098 na kushuka hadi 0,142; validation loss ya chini ilikuwa 0,186. Waandishi wanatafsiri tofauti ndogo kati ya mikunjo ya train na validation kama ishara kwamba hakukuwa na overfitting kubwa.
Ulinganisho wa modeli tano tofauti
Ndani ya majaribio ya chanzo, modeli mseto ina matokeo ya juu kuliko modeli zote za baseline za tawi moja. Kuunganisha CNN na BiLSTM kunahusishwa kwenye chanzo na utendaji wa juu zaidi kuliko kutumia spektrogramu pekee au MFCC pekee.
Kwa nini Accuracy peke yake haitoshi?
Accuracy ni uwiano wa maamuzi yote sahihi; lakini madarasa yanapokuwa hayajasawazishwa inaweza kupotosha ikiwa itatumika peke yake. Kwa hiyo, chanzo pia kinaripoti precision, recall, F1-score, specificity, ROC-AUC na confusion matrix.
Mbinu hii ni ya thamani kubwa sana kwa kujifunza MATLAB na akili bandia. Hasa katika uainishaji wa afya, si muhimu tu kujua “modeli ilipata sampuli ngapi kwa usahihi”, bali pia kujua ni kwa kiwango gani inaweza kunasa visa halisi vya darasa fulani.
Matokeo ya chanzo kwa kila darasa
| Lebo ya chanzo | Precision (%) | Recall (%) | F1 (%) | Specificity (%) | Sampuli za test |
|---|---|---|---|---|---|
| Healthy | 95,7 | 96,2 | 95,9 | 97,8 | 47 |
| Asthma | 92,8 | 94,1 | 93,4 | 96,2 | 52 |
| Lung Cancer | 93,1 | 89,2 | 91,1 | 97,5 | 35 |
| Macro average | 93,9 | 93,2 | 93,5 | 97,2 | 134 |
Chanzo kinasema kwamba recall ya chini zaidi ni %89,2 kwenye lebo ya Lung Cancer; kinaunganisha hali hii na kutokuwiana kwa madarasa na kufanana kwa akustiki ya wheeze kati ya Asthma na eneo la 500–2500 Hz. Maelezo haya ni tafsiri ya waandishi wa chanzo; kwa kuwa asili ya kliniki ya lebo za data haijathibitishwa, hayapaswi kukubaliwa kama hitimisho huru la kliniki.
Namba halisi za confusion matrix
Kielelezo 5 kwenye ukurasa wa 6 kinaonyesha wazi namba ghafi kwa seti ya test yenye sampuli 134:
| Halisi \ Utabiri | Healthy | Asthma | Lung Cancer |
|---|---|---|---|
| Healthy | 45 | 2 | 0 |
| Asthma | 2 | 48 | 1 |
| Lung Cancer | 0 | 4 | 33 |
Katika tafsiri ya chanzo chenyewe, kosa kubwa zaidi la off-diagonal ni sampuli nne za Lung Cancer kuainishwa kama Asthma.
Uchambuzi wa ROC
| Lebo ya chanzo | One-vs-rest AUC |
|---|---|
| Healthy | 0,978 |
| Asthma | 0,969 |
| Lung Cancer | 0,965 |
Chanzo kinasema mikunjo yote ya ROC iko juu ya mstari wa 0,5 AUC wa kiainishaji cha kubahatisha. Vivuli vya %95 confidence interval kwa cross-validation ya mikunjo mitano vimeonyeshwa kwenye Kielelezo 7.
Ablation study ni nini?
Katika utafiti wa ablation, sehemu moja ya modeli au kundi la vipengele huondolewa kwa zamu na kushuka kwa utendaji huchunguzwa. Kwa njia hii, hujaribiwa kuelewa ni chaneli ipi ya taarifa ambayo modeli inaitegemea zaidi.
Hili ndilo tokeo lililo wazi zaidi la modeli katika chanzo: utendaji hushuka kwa kiwango kikubwa zaidi spektrogramu inapoondolewa. Hata hivyo, modeli ya spektrogramu pekee hubaki kwenye %91,1, huku kuunganisha vipengele vyote kukifikia %94,2. Waandishi wanatafsiri hili kuwa modaliti tofauti za vipengele hubeba taarifa zinazokamilishana.
Mchango wa BiLSTM ulipimwaje?
Chanzo kinalinganisha accuracy ya %88,6 ya CNN-only baseline na matokeo ya %94,2 ya mfumo mseto; pia katika sehemu ya frequency-sensitivity kinasema BiLSTM temporal component ilitoa mchango wa pointi 3,1 za asilimia dhidi ya muundo wa CNN-only. Kauli hizi mbili si tofauti moja ya moja ya kihesabu; ziliripotiwa katika miktadha tofauti kwenye chanzo na hazibadilishwi kuwa kauli moja hapa.
Ni eneo gani la masafa lenye uwezo mkubwa zaidi wa kutofautisha?
Katika uchambuzi wa frequency-band sensitivity, chanzo kinaripoti taarifa inayotofautisha kuwa imesambazwa hivi:
| Masafa | Mchango ulioripotiwa na chanzo | Tafsiri ya chanzo |
|---|---|---|
| 0–500 Hz | %23 | Normal breath |
| 500–2500 Hz | %45 | Wheeze patterns |
| 2500–8000 Hz | %32 | Crackles / high-frequency information |
Hata hivyo, makala haielezi kwa undani ni hesabu gani ya kihisabati ya sensitivity iliyotumika kupata thamani hizi za %23/%45/%32.
Utendaji wa kompyuta
| Modeli | Parameta (M) | Training (dak) | Inference (ms) | Kumbukumbu (MB) |
|---|---|---|---|---|
| SVM + MFCC | — | 12,3 | 2,1 | 45 |
| Random Forest | — | 18,7 | 5,4 | 128 |
| CNN | 1,2 | 142,5 | 8,3 | 156 |
| BiLSTM | 0,8 | 98,4 | 12,7 | 98 |
| CNN–LSTM | 2,1 | 215,8 | 15,2 | 234 |
Jedwali hili linaonyesha ukweli muhimu wa machine learning: modeli inayotoa accuracy ya juu zaidi kwenye chanzo pia ndiyo yenye muda mrefu zaidi wa training na matumizi makubwa zaidi ya kumbukumbu. Modeli changamano zaidi si “bora” kiotomatiki kwa kila kipimo; kuna mabadilishano ya kimtindo kati ya usahihi na gharama ya kompyuta.
15,2 ms ina maana gani?
Chanzo kinaripoti muda wa inference wa 15,2 ms kwa CNN–LSTM na kinatafsiri kuwa unafaa kwa matumizi ya wakati halisi kwa sababu ni mfupi kuliko hitaji la 25 ms kwa streaming audio yenye dirisha la 400 ms.
Jambo la kuzingatia hapa ni kitengo cha kauli. Jedwali linaandika “Inference (ms)” huku maandishi yakisema “15.2 ms/sample”. Ikiwa “sample” hapa ingemaanisha audio sample moja ya 16 kHz, tafsiri hii isingekuwa sahihi. Kwa muktadha wa chanzo, inawezekana zaidi kinachomaanishwa ni sampuli moja ya modeli / dirisha la uchambuzi; hata hivyo, makala haifafanui jambo hili wazi.
Jaribio la umuhimu wa kitakwimu
Chanzo kinasema kilitumia paired t-test kwenye matokeo ya cross-validation ya mikunjo mitano:
| Ulinganisho | t | p |
|---|---|---|
| CNN–LSTM vs CNN | 3,42 | 0,026 |
| CNN–LSTM vs BiLSTM | 4,18 | 0,013 |
| CNN–LSTM vs Random Forest | 6,73 | 0,002 |
Katika ulinganisho wote watatu, chanzo kinafikia matokeo ya \(p<0.05\). Hata hivyo, kutumia t-test kwenye fold tano pekee ni ulinganisho wa kitakwimu wenye sampuli ndogo; hakuondoi kwa njia ya moja kwa moja matatizo ya msingi ya data kama data-label na subject leakage yanayohusiana na dai la utendaji.
Kwa nini chanzo kinaona %94,2 kuwa muhimu ikiwa kuna accuracy ya juu zaidi kwenye fasihi?
Makala haidai kuwa njia yake ina rekodi kamili ya accuracy. Chanzo kinakubali wazi kwenye Jedwali 6 kwamba mbinu ya dual-channel CNN-LSTM ya Zhang na wenzake ya 2024 iliripoti %99,01 accuracy.
Dai la mchango wa waandishi wao wenyewe linajikita zaidi katika mambo matatu: disease classification ya madarasa matatu, urejelewaji unaotumia majukwaa mawili ya MATLAB/Python, na kuripoti wasifu wa kompyuta kama inference latency / memory footprint.
Hata hivyo, kwa sababu asili ya data ya darasa la “lung cancer” katika mchango wa kwanza haijathibitishwa, mchango huu haukubaliwi na Verianla kama ubunifu wa kliniki uliothibitishwa.
Tunaweza kujifunza nini kutokana na utafiti huu kwa mtazamo wa MATLAB?
Sehemu yenye manufaa zaidi ya utafiti si neural network moja tu, bali mnyororo mzima wa uhandisi kutoka mwanzo hadi mwisho. Mtu anayejifunza MATLAB anapaswa kuona uhusiano huu hapa: modeli haiwezi kufundishwa kabla ya ishara ghafi kusanifishwa; uwakilishi kama spektrogramu na MFCC hubeba taarifa tofauti; CNN na LSTM hushughulikia jiometri tofauti za data; kutokuwiana kwa madarasa huathiri muundo wa loss; augmentation inapaswa kutumika kwenye training pekee; training accuracy peke yake haitoshi; validation, test, confusion matrix, ROC, ablation na cross-validation hujibu maswali tofauti; na kumbukumbu pamoja na muda wa inference wa modeli pia ni sehemu ya muundo wa mfumo halisi.
Kwa hiyo, mradi wa akili bandia wa kibiomedikali katika MATLAB ni mpana zaidi kuliko “kubadilisha ishara kuwa spectrogram na kuipeleka kwenye neural network”. Asili ya data na usahihi wa lebo za wagonjwa huja hata kabla ya msimbo wenyewe. Utafiti huu pia unatoa mfano wa kupinga wenye mafundisho makubwa katika hatua hii: hata kama mnyororo wa kompyuta ni wa hali ya juu kiasi gani, ikiwa chanzo cha lebo lengwa hakiwezi kuthibitishwa, maana ya kliniki ya utendaji wa modeli hudhoofika.
Mbinu na Matokeo ya Utafiti
Maswali ya utafiti ya chanzo
Makala inafafanua maswali manne ya utafiti. Swali la kwanza ni kama vipengele vya spektrogramu vinaweza kutenganisha madarasa ya sauti za upumuaji kwa sensitivity yenye maana ya kliniki. Swali la pili ni kama usanifu mseto wa CNN–LSTM unaweza kuzidi baseline za modeli moja. Swali la tatu ni feature modality ipi inatoa mchango mkubwa zaidi kwa accuracy. Swali la nne ni kama mfumo una utendaji wa kompyuta unaotosha kwa matumizi ya wakati halisi.
Maandalizi ya data
Chanzo kinasema kilitumia 895 respiratory cycle baada ya kichujio cha ubora kutoka rekodi 920 za ICBHI. %70 zilitengwa kwa training, %15 kwa validation na %15 kwa test. Namba ni 627, 134 na 134 mtawalia.
Jambo linalopaswa kusisitizwa tena hapa ni kwamba ingawa split imetajwa kama “stratified”, haijafafanuliwa kama patient-independent. Haijulikani ikiwa mizunguko tofauti ya mgonjwa mmoja iliangukia katika sehemu tofauti kama sampuli za data zinazojitegemea.
Preprocessing
| Mpangilio | Mchakato wa chanzo | Kigezo cha chanzo |
|---|---|---|
| 1 | Resampling | 16 kHz |
| 2 | Pre-emphasis | \(\alpha=0.97\) |
| 3 | Amplitude normalisation | z-score |
| 4 | Noise reduction | spectral subtraction |
| 5 | Respiratory cycle segmentation | energy envelope + ZCR thresholding |
Feature extraction
Ingizo kuu zinazoweza kuthibitishwa moja kwa moja kwenye chanzo ni spektrogramu ya 128×128, coefficients 13 za MFCC, DWT ya viwango vitano yenye db4 wavelet na vipengele vya time-domain. Kielelezo 6 pia kinaonyesha 36-dimensional numerical feature vector.
Usanifu wa modeli
| Tabaka / sehemu | Muundo wa chanzo |
|---|---|
| CNN input | Spektrogramu 128×128×1 |
| Convolution block 1 | 32 filter + batch norm + 2×2 max-pool + dropout 0,25 |
| Convolution block 2 | 64 filter + batch norm + 2×2 max-pool + dropout 0,25 |
| Convolution block 3 | 128 filter + batch norm + 2×2 max-pool + dropout 0,25 |
| CNN embedding | Vipimo 128 |
| BiLSTM layer 1 | 128 unit |
| BiLSTM layer 2 | 64 unit |
| BiLSTM embedding | Vipimo 128 |
| Fusion | Vipimo 256 |
| Dense | 128 |
| Dropout | 0,5 |
| Output | Dense(3) + softmax |
Matokeo makuu ya utendaji
Modeli ya mwisho mseto ya chanzo inatoa %94,2 accuracy na 0,971 AUC-ROC. CNN pekee inabaki kwenye %88,6, na BiLSTM pekee kwenye %90,5 accuracy. Hivyo, ndani ya data ya chanzo, modeli ya fusion ina utendaji wa juu zaidi kuliko modeli mbili za tawi moja.
Matokeo ya mchango wa vipengele
Upungufu mkubwa zaidi katika utafiti wa ablation hutokea spektrogramu inapoondolewa: %94,2 → %85,7. MFCC inapoondolewa hupatikana %89,3, wavelet inapoondolewa %91,8, na time-domain inapoondolewa %93,5.
Hili ndilo jibu la chanzo kwa swali la RQ3: katika jaribio lake, modaliti moja yenye uwezo mkubwa zaidi wa kutofautisha ni spektrogramu.
Matokeo ya gharama ya kompyuta
Mfumo mseto wenye parameta milioni 2,1, training ya dakika 215,8, inference ya 15,2 ms na memory footprint ya 234 MB ndiyo modeli ghali zaidi kati ya zilizojaribiwa. Kwa upande mwingine, ndiyo pia iliyotoa accuracy ya juu zaidi.
Mapungufu yaliyokubaliwa na chanzo
Waandishi wanakubali kwamba seti ya data yenye mizunguko 895 ni ndogo kwa kiwango cha kliniki, darasa la Lung Cancer limewakilishwa kwa kiwango cha chini cha %26,3, hakuna validation huru ya cohort ya nje, madarasa madogo kama cancer stage au asthma severity hayakuzingatiwa, mbinu ya interpretability ilibaki kwenye frequency-band sensitivity badala ya SHAP/LIME rasmi, na ulinganisho na utafiti wa Zhang wenye %99,01 kwenye fasihi unaweza kuathiriwa na mikakati tofauti ya augmentation.
Kikomo kikuu cha uthibitishaji kilichoongezwa na Verianla kwenye chanzo
Mbali na sehemu ya limitation ya chanzo chenyewe, tatizo muhimu zaidi kwa mtazamo wa Verianla ni asili ya lebo za data. Rekodi rasmi ya ICBHI inaripoti faili 920 za sauti, watu 126 na 6.898 respiratory cycle, na inaeleza wazi kwamba mizunguko ilitiwa lebo na wataalamu kama normal, crackle, wheeze au crackle+wheeze. Machapisho yanayoeleza matumizi ya ICBHI katika kiwango cha ugonjwa yanaonyesha utambuzi kwenye seti ya data kama COPD, Healthy, Bronchiectasis, Bronchiolitis, URTI, Pneumonia, Asthma na LRTI; lung cancer haipo kati yake.
Kwa hiyo, kauli ya “235 Lung Cancer respiratory cycles” kwenye chanzo haiwezi kukubaliwa bila ulinganishaji wa data unaoweza kurudiwa. Ikiwa msimbo wa MATLAB wa chanzo, orodha ya vitambulisho vya wagonjwa au metadata ya uchunguzi iliyotumika kuunda mizunguko 235 itachapishwa, suala hili linaweza kutathminiwa upya kando.
Hitimisho
Kwa mtazamo wa MATLAB na ujifunzaji wa kina, utafiti ni mfano tajiri unaoonyesha jinsi dhana za audio preprocessing, spektrogramu, MFCC, wavelet, CNN, BiLSTM, feature fusion, class weighting, augmentation, early stopping, cross-validation, confusion matrix, ROC, ablation na inference profiling zinavyoweza kuunganishwa katika mnyororo mmoja wa utafiti.
Kwa mtazamo wa uchunguzi wa kisayansi, utafiti huo huo unakumbusha kanuni muhimu: modeli kutoa %94,2 accuracy hakuthibitishi kwamba madarasa lengwa yalifafanuliwa kwa usahihi. Akili bandia hujifunza lebo ilizopewa tu. Ikiwa chanzo cha kliniki cha lebo hakijathibitishwa, usanifu bora zaidi wa neural network hauwezi kutatua tatizo hili la msingi. Kwa hiyo, kwa mtazamo wa Verianla, matumizi sahihi zaidi ya utafiti huu ni “kufundisha mtiririko wa kazi wa kiufundi wa uainishaji wa sauti za upumuaji kwa MATLAB”; si kuuwasilisha katika hali yake ya sasa kama “mfumo uliothibitishwa unaotambua saratani ya mapafu kutoka sauti za upumuaji kwa %94,2 accuracy”.
Maelezo ya Chanzo na Mbinu
Jina kamili la asili la utafiti: Spectrogram-Based Detection of Lung Cancer and Asthma Using Deep Learning and MATLAB: A Hybrid CNN-LSTM Approach
Waandishi: Mridul Vats; Pooja Sabherwal; Monika Agrawal.
Mpangilio wa waandishi: Mpangilio wa chanzo umehifadhiwa kama ulivyo.
Taasisi: PDF ya chanzo inatoa The NorthCap University, Department of Electronics and Communication Engineering kwa Mridul Vats na Pooja Sabherwal; na IIT Delhi, Centre for Applied Research in Electronics (CARE) kwa Monika Agrawal.
Mwandishi wa mawasiliano: Ukurasa wa rekodi wa SSRN unaonyesha Mridul Vats kama Contact Author.
Aina ya chanzo: Preprint ya ujifunzaji wa kina na usindikaji wa ishara za kibiomedikali.
Jarida lengwa: PDF ya chanzo inaonekana kama manuscript iliyowasilishwa kwa Biomedical Signal Processing and Control. Kauli hii si uthibitisho wa kukubaliwa kuchapishwa.
Hali ya mapitio ya rika: Utafiti huu ni preprint ambayo haijapitia peer review; matokeo yanapaswa kutathminiwa kwa kuzingatia hatua hii ya uchapishaji.
Jukwaa: SSRN.
DOI: 10.2139/ssrn.6689273.
Tarehe ya SSRN: 1 May 2026.
MATLAB: MATLAB R2023a, Audio Toolbox, Signal Processing Toolbox.
Upande wa Python: librosa, scipy, PyWavelets.
Upatikanaji wa msimbo: Makala inasema implementation script za MATLAB na Python zinaweza kupatikana kutoka corresponding author kwa ombi linalofaa; toleo lililopakiwa halitoi hazina wazi na ya kudumu ya msimbo.
Ufadhili: No external funding.
Mgongano wa maslahi: Chanzo kinasema hakuna competing financial or personal interests.
Upatikanaji wa data: Chanzo kinatumia ICBHI 2017 Respiratory Sound Database. Rekodi rasmi ya ICBHI inafafanua seti ya data kama rekodi 920, watu 126 na 6.898 respiratory cycle.
Onyo muhimu la data-lebo: Chanzo kinadai kutumia mizunguko 312 ya Healthy, 348 ya Asthma na 235 ya Lung Cancer. Katika uthibitishaji wa nje wa kibibliografia, saratani ya mapafu haikupatikana kati ya madarasa ya uchunguzi ya ICBHI. Machapisho yanayotumia ICBHI katika kiwango cha ugonjwa yanaripoti madarasa ya COPD, healthy, bronchiectasis, bronchiolitis, URTI, pneumonia, asthma na LRTI. Makala chanzo haielezi lebo 235 za lung-cancer zilitoka wapi.
Onyo la split kwa msingi wa mgonjwa: Chanzo kinaripoti %70/%15/%15 stratified split na 5-fold stratified cross-validation lakini subject-independent partition haijaelezwa wazi. Kwa hiyo, haiwezi kuthibitishwa kama mizunguko tofauti ya upumuaji ya mgonjwa mmoja ilisambazwa kati ya seti za training na test.
Onyo la uwezo wa kurudia usanifu: Ingawa DWT na time-domain features zinaonekana kama vipengele vya modeli katika uchambuzi wa ablation, maelezo ya usanifu yanaonyesha wazi fusion ya mwisho kati ya CNN spectrogram embedding na BiLSTM MFCC embedding pekee. Muunganisho halisi wa network wa vipengele hivi haujafafanuliwa kikamilifu.
Upungufu wa milinganyo: Chanzo kinarejelea milinganyo mbalimbali katika Eq. 1–15, lakini sehemu kubwa yake haionekani kwenye PDF iliyopakiwa. Semi zilizokosekana hazijaundwa upya na Verianla kwa kutumia maarifa ya nje.
Kikomo cha matumizi ya kliniki: Utafiti huu si kipimo cha uchunguzi wa kliniki, utafiti wa wagonjwa wa prospektivu wala uthibitishaji huru wa hospitali. External validation haikufanywa. Kabla tatizo la kuweka lebo data halijatatuliwa, utendaji wa “lung-cancer detection” hauwezi kuhesabiwa kuwa umeonyeshwa kuwa halali kliniki.
Chanzo cha maudhui ya kisayansi: MATLAB/Python preprocessing, usanifu wa CNN–BiLSTM, parameta zote za modeli, jedwali la dataset, matokeo ya modeli, confusion matrix, ROC, ablation, mienendo ya training, thamani za inference/kumbukumbu na tafsiri za waandishi wa chanzo zinategemea makala ya kurasa 10 iliyopakiwa. Utafiti wa vyanzo vya nje ulitumika tu kwa utambulisho wa kibibliografia na uthibitishaji huru wa muundo wa data wa ICBHI.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *