

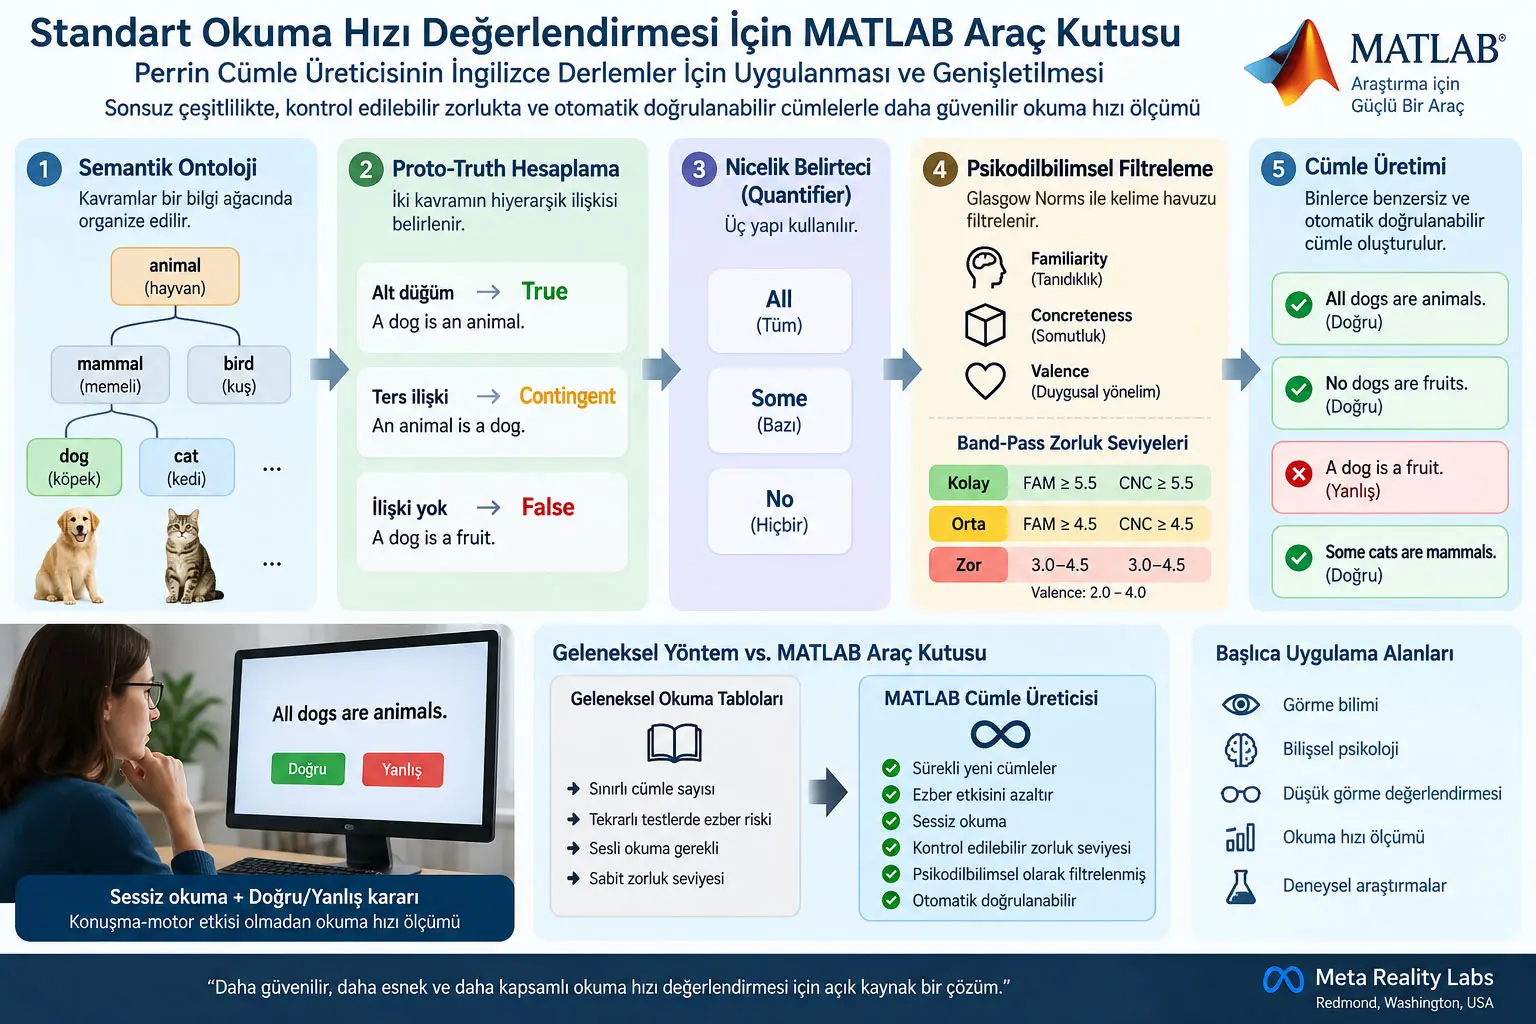
Proto-truth, bu çalışmada bir cümlede kullanılan iki kavram arasındaki semantik ilişkinin, kavramların ontoloji ağacındaki konumlarına bakılarak doğal dile dönüştürülmeden önce “doğru”, “koşullu” veya “yanlış” olarak sınıflandırılmasıdır. Daniel P. Spiegel ve Romain Bachy’nin geliştirdiği MATLAB araç kutusu, bu mantığı kullanarak okuma hızı ölçümü için binlerce benzersiz ve otomatik olarak doğrulanabilir cümle üretmektedir.
Çalışmanın çıkış noktası, MNREAD gibi standart okuma tablolarının tekrarlı testlerde sınırlı cümle sayısı nedeniyle ezber etkisi oluşturabilmesi ve sesli okuma yöntemlerinin görsel bilgi işleme hızına konuşma-motor süreçlerini karıştırabilmesidir. Araç kutusu bu sorunları azaltmak için sessiz okuma ve True/False kararına dayalı bir ölçüm paradigmasını desteklemektedir.
Sistem, Perrin, Paillé ve Baccino’nun 2014 tarihli semantik ontoloji yaklaşımını İngilizceye uyarlamaktadır. Bunun yanında Glasgow Norms kullanılarak familiarity, concreteness ve valence değişkenlerine göre kelime havuzu filtrelenmekte; İngilizceye özgü sayılamayan isimler, düzensiz çoğullar, homonimler ve gerçek dünya bilgisinden kaynaklanan çapraz kategori belirsizlikleri için ek güvenlik mekanizmaları uygulanmaktadır.
Araç kutusunun bir diğer önemli yeniliği, yalnız minimum eşik kullanan filtreleme yerine üst ve alt sınırlar tanımlayan band-pass psikodilbilimsel filtrelemedir. Bu sayede kolay, orta ve zor cümle grupları üretilebilmekte ve sistem yalnız maksimum okuma hızı ölçümünde değil, kontrollü bilişsel yük deneylerinde de kullanılabilecek hale gelmektedir.
Neden yeni bir okuma hızı ölçüm aracı gerekiyor?
Okuma hızı, görme bilimi, klinik oftalmoloji ve deneysel psikolojide önemli bir performans ölçütüdür.
Ancak klasik basılı okuma tablolarında iki temel sorun bulunmaktadır.
- Sınırlı cümle sayısı tekrarlı testlerde ezber etkisine yol açabilir.
- Sesli okuma, görsel okuma hızına ek olarak konuşma ve motor planlama süreçlerini de ölçer.
Bu nedenle ölçülen performans yalnız görsel veya bilişsel okuma kapasitesini temsil etmeyebilir.
Bu MATLAB Araç Kutusu Geleneksel Okuma Tablolarından Nasıl Farklıdır?
Araç kutusu sabit bir cümle listesi kullanmak yerine semantik ontoloji ve mantıksal kurallar aracılığıyla sürekli yeni cümleler üretir; ayrıca doğru/yanlış kararına dayalı sessiz okuma paradigmasıyla konuşma-motor performansının ölçüme karışmasını azaltmayı amaçlar.
Crossland yaklaşımından Perrin yaklaşımına
Crossland, Legge ve Dakin 2008’de nicelik belirteci, nesne ve özellikleri rastgele birleştirerek otomatik cümle üretme yaklaşımı geliştirmişti.
Bu sistem çok sayıda cümle üretmek bakımından avantajlı olsa da bazı kombinasyonlar anlamsal olarak belirsiz olabiliyordu.
Perrin, Paillé ve Baccino 2014’te bu sorunu semantik ontoloji ile çözmeye çalıştı. Kavramlar bir ağaç yapısı içinde yerleştirildi ve kavramlar arasındaki ilişki sistem tarafından doğrudan ontolojik konumdan çıkarıldı.
Ontoloji bir bilgi haritası olarak nasıl çalışıyor?
Sistem kavramları şu biçimde köklü bir ağaçta temsil eder:
\[ O=(N,E,r) \]
Burada:
- \(N\), düğümleri,
- \(E\), düğümler arasındaki bağlantıları,
- \(r\), kök düğümü
temsil eder.
Düğümler iki ana gruba ayrılır:
- Classes: animal, fruit, tool gibi geniş kategoriler,
- Entities: dog, apple, hammer gibi belirli nesneler.
Örneğin “dog” düğümü “mammal” düğümünün; “mammal” da “animal” düğümünün altındaysa sistem dog ile animal arasındaki taksonomik ilişkiyi otomatik olarak bilir.
Proto-Truth Nasıl Hesaplanıyor?
Proto-truth, iki kavramın ontoloji ağacındaki hiyerarşik ilişkisine göre belirlenir: birinci kavram ikinci kavramın alt düğümüyse True, ilişki ters yöndeyse Contingent, doğrudan soy bağı bulunmuyorsa False olarak sınıflandırılır.
Üç proto-truth durumu
| Durum | İlişki | Örnek |
|---|---|---|
| True | \(e_1\), \(e_2\)'nin alt düğümüdür | A dog is an animal |
| Contingent | İlişki ters yöndedir | An animal is a dog |
| False | Doğrudan soy ilişkisi yoktur | A dog is a fruit |
Quantifier kullanımı
Sistem cümle üretirken üç nicelik belirteci kullanmaktadır:
- All
- Some
- No
Proto-truth değeri daha sonra quantifier ile birlikte değerlendirilerek nihai True/False cümle değeri oluşturulur.
Örneğin proto-false bir dog–fruit çifti “No” ile birleştirildiğinde “No dogs are fruits” biçiminde doğru bir ifade oluşturabilir.
Neden bazı mantıksal olarak doğru cümleler yasaklanıyor?
Çalışma özellikle “Some + Proto-True” kombinasyonunu yasaklamaktadır.
Örneğin:
Some dogs are animals.
Mantıksal olarak doğrudur; ancak pragmatik olarak bazı köpeklerin hayvan olmadığı izlenimini verebilir.
Bu tür Gricean implicature etkilerinin okuyucuda gereksiz karışıklık oluşturmaması için kombinasyon tamamen dışlanmaktadır.
Geçerli kombinasyonlar ayrıca True ve False cümlelerin olasılığını tam olarak 0,5’te tutacak biçimde ağırlıklandırılmaktadır.
Sistem Neden True ve False Cümleleri %50–%50 Üretiyor?
Dengeli True/False dağılımı, katılımcının cevap stratejisini tek bir kategoriye kaydırmasını önlemek ve okuma görevinin karar yapısını dengeli tutmak için kullanılır; kaynakta geçerli cümle kombinasyonları bu dağılımı tam 0,5 olasılıkta tutacak biçimde ağırlıklandırılmaktadır.
Glasgow Norms ile psikodilbilimsel filtreleme
İngilizce kelime havuzu 5.554 sözcük içeren Glasgow Norms veri seti üzerinden filtrelenmektedir.
Üç temel boyut kullanılmaktadır:
| Değişken | Anlam | Standart eşik |
|---|---|---|
| Familiarity (FAM) | Sözcüğün okuyucuya tanıdıklığı | ≥ 4,5 / 7 |
| Concreteness (CNC) | Kavramın somutluk düzeyi | ≥ 4,5 |
| Valence (VAL) | Duygusal olumlu/olumsuz yönelim | ≥ 4,0 |
Familiarity neden kontrol ediliyor?
Tanıdıklık, okuma hızının nadir kelime geri çağırma sürecinden etkilenmesini azaltmak için kullanılır.
Yüksek familiarity değerine sahip kelimeler genellikle daha sık karşılaşılan ve daha hızlı işlenen sözcüklerdir.
Concreteness neden önemli?
Paivio’nun Dual Coding Theory yaklaşımına göre somut kavramlar hem sözel hem imgesel sistemleri aktive edebilir.
Bu nedenle somut kelimeler genellikle soyut kelimelere göre daha hızlı işlenebilir.
Valence neden filtreleniyor?
Negatif içerik dikkati daha güçlü çekebilir ve işlem süresini değiştirebilir.
Standart ölçümde bu duygusal etkiyi azaltmak için nötr veya pozitif kelimeler tercih edilmektedir.
Band-Pass Psikodilbilimsel Filtreleme Nedir?
Band-pass filtreleme, yalnız minimum familiarity, concreteness veya valence eşiği koymak yerine alt ve üst sınır tanımlayarak belirli psikodilbilimsel zorluk aralıklarını izole etmektir; böylece kolay kelimelerin tüm dağılıma hakim olması engellenebilir ve kontrollü zorluk seviyeleri oluşturulabilir.
Üç standart zorluk düzeyi
| Seviye | Familiarity | Concreteness | Valence |
|---|---|---|---|
| Easy | \([5.5,\infty)\) | \([5.5,\infty)\) | Standart |
| Medium | \([4.5,\infty)\) | \([4.5,\infty)\) | Standart |
| Hard | \([3.0,4.5]\) | \([3.0,4.5]\) | \([2.0,4.0]\) |
Medium ayarı Perrin ve arkadaşlarının orijinal ölçütlerine karşılık gelir.
Hard modu ise daha az tanıdık, daha soyut ve daha düşük valence’lı kelimeleri özellikle seçerek bilişsel yük oluşturmayı amaçlamaktadır.
Homonimlerin çıkarılması
“Bank” veya “arm” gibi birden fazla belirgin anlama sahip kelimeler semantik belirsizlik oluşturabileceğinden aktif kelime havuzundan çıkarılmaktadır.
Glasgow Norms içinde parantezli anlam ayrımı taşıyan girişler otomatik olarak elenmektedir.
İngilizce için yapılan yapısal değişiklikler
Güncel ontoloji 97 entity ve 23 class kullanmaktadır.
İngilizceye uyarlama sırasında bazı önemli morfolojik sorunların çözülmesi gerekmiştir.
Sayılamayan isimlerin çıkarılması
Cümle şablonları çoğul isim kullandığı için mass noun niteliğindeki kelimeler sorun oluşturmuştur.
Kaynak şu örnekleri aktif havuzdan çıkarmaktadır:
- beef,
- pork,
- bacon,
- ham,
- rice,
- wheat,
- oats,
- milk,
- butter,
- honey,
- corn.
Ayrıca “scissors” tekil biçimi bulunmayan plurale tantum isim olduğu için çıkarılmıştır.
Sınıf adlarının değiştirilmesi
“Clothing” sınıfı garment, “furniture” sınıfı ise furnishing olarak değiştirilmiştir.
Amaç çoğul cümle şablonlarında dilbilgisel olarak doğal ifadeler üretmektir.
Düzensiz çoğullar
Araç kutusu 38 girdilik irregular plural lookup table kullanmaktadır.
Bu yapı:
- aircraft,
- watercraft,
- bus → buses
gibi standart regex kurallarının sorun çıkarabileceği biçimleri güvenli biçimde ele almaktadır.
Animal–Food Çapraz Dal Belirsizliği Neden Özel Olarak Filtreleniyor?
Ontoloji ağacında animal ve food farklı dallarda olduğu için sistem örneğin chicken–food çiftini False olarak sınıflandırabilir; ancak gerçek dünyada tavuk aynı zamanda yiyecektir. Bu nedenle araç kutusu ontolojik olarak yanlış ama gerçek dünyada doğru olabilecek hayvan–yiyecek çiftlerini özel bir çapraz dal filtresiyle dışlar.
Cross-branch ambiguity problemi
Ontolojik yapı kategorileri birbirinden ayırırken gerçek dünya kavramları bazen birden fazla işlev taşıyabilir.
Örneğin “animal” ve “food” farklı dallardır; ancak bazı hayvanlar yiyecek olarak tüketilebilir.
Bu durumda:
Some frogs are foods.
veya
A chicken is not a food.
gibi cümleler ontolojik mantığa göre bir değer alsa da gerçek dünya açısından tartışmalı hale gelir.
isAmbiguousCrossBranch filtresi bu çiftleri otomatik olarak eleyerek False cümlelerin gerçek semantik ayrışmaya dayanmasını sağlar.
Semantik mesafe manipülasyonu
Araç kutusu yalnız cümle üretmekle kalmaz, ontoloji ağacındaki düğümler arasındaki kenar sayısını kullanarak semantik mesafeyi de kontrol edebilir.
Bu özellik bilişsel zorluk oluşturmak için kullanılabilir.
Semantik girişim
Birbirine yakın fakat farklı kardeş kategorilerden False cümleler üretilebilir:
A dog is a cat.
Dog ve cat aynı üst kategori altında bulunduğu için doğrulama, dog–fruit gibi uzak çiftlere göre daha fazla semantik girişim oluşturabilir.
Taksonomik kesinlik
True cümlelerde de mesafe değiştirilebilir.
A dog is an animal.
daha geniş bir kategori bilgisini kullanırken:
A dog is a mammal.
daha kesin taksonomik bilgi gerektirir.
Bu Araç Kutusu Yalnız Maksimum Okuma Hızını mı Ölçebilir?
Hayır. Band-pass filtreleme ve semantik mesafe kontrolü sayesinde sistem nadir kelime işleme, soyut dil işleme, duygusal girişim ve semantik çatışma gibi belirli bilişsel süreçleri zorlayan deneysel “stress test” cümleleri de oluşturabilir.
Genişletilmiş deneysel kullanım
Kaynak üç örnek vermektedir:
- Familiarity düşürülerek nadir kelimelerle lexical retrieval yükü artırılabilir.
- Concreteness düşürülerek soyut kelimelerle sözel işlemleme test edilebilir.
- Valence ters filtrelenerek negatif kelimelerle affective interference incelenebilir.
Çalışmanın Yöntemi ve Bulguları
Yöntemsel yapı
Çalışma yeni bir klinik deneyden çok bir yazılım ve yöntem geliştirme makalesidir.
Temel bileşenler şunlardır:
- Semantik ontoloji kurulması,
- proto-truth hesaplanması,
- quantifier tabanlı True/False mapping,
- Glasgow Norms filtrelemesi,
- İngilizce morfoloji ve çoğul kuralları,
- cross-branch ambiguity filtering,
- band-pass difficulty control,
- semantic distance manipulation.
Orijinal yöntemin doğrulaması
Kaynak, Perrin ve arkadaşlarının 2014’te Fransızca korpus üzerinde yaptığı doğrulamayı aktarmaktadır.
Orijinal çalışma:
- \(N=41\) katılımcı kullanmıştır,
- True/False sessiz okuma görevi ile geleneksel oral MNREAD arasında
- \(r=0.836\), \(p<0.001\)
düzeyinde güçlü korelasyon bildirmiştir.
Ayrıca True/False doğrulama yönteminin oral okuma ile istatistiksel olarak eşdeğer sonuçlar verdiği aktarılmaktadır.
İngilizce MATLAB Sürümü Psikometrik Olarak Doğrulanmış mı?
Henüz değil. Fransızca orijinal Perrin yöntemi daha önce doğrulanmış olsa da bu makalede sunulan İngilizce MATLAB implementasyonu, English MNREAD veya IReST gibi yerleşik İngilizce testlerle formal psikometrik validasyonu henüz tamamlamamıştır.
Bu ayrım neden kritik?
Fransızca yöntemin başarılı olması İngilizceye aktarımın otomatik olarak aynı psikometrik özelliklere sahip olduğunu kanıtlamaz.
Diller arasında:
- kelime sıklığı,
- morfoloji,
- psikodilbilimsel normlar,
- okuma davranışı
farklılaşabilir.
Yazarlar bu nedenle araç kutusunu tamamlanmış açık kaynak yazılım olarak sunarken İngilizce formal validasyonu bilim topluluğunun gerçekleştirmesini beklemektedir.
Çalışmanın desteklediği sonuçlar
- Semantik ontoloji kullanılarak otomatik True/False cümle üretimi gerçekleştirilebilir.
- İngilizce morfoloji ve kelime sınıfları için özel uyarlamalar gereklidir.
- Band-pass filtreleme kontrollü psikodilbilimsel zorluk bantları oluşturabilir.
- Cross-branch ambiguity filtering gerçek dünya bilgisiyle ontoloji çatışmalarını azaltabilir.
- Semantik mesafe bilişsel zorluğu manipüle etmek için kullanılabilir.
- Araç kutusu tekrarlı deneylerde pratik olarak sınırsız çeşitlilik sunmayı hedefler.
Çalışmanın desteklemediği sonuçlar
- İngilizce araç kutusunun henüz klinik altın standart olduğu gösterilmemiştir.
- English MNREAD veya IReST’e karşı formal validasyon tamamlanmamıştır.
- Fransızca N=41 doğrulama sonucu doğrudan İngilizce implementasyonun sonucu değildir.
- Hard modun belirli bir klinik bozukluğu tanısal olarak ayırdığı gösterilmemiştir.
- Band-pass filtrelerin klinik eşik değerleri olduğu ileri sürülmemektedir.
Bu Araç Kutusunun En Büyük Bilimsel Avantajı Nedir?
En büyük avantajı, semantik olarak denetlenmiş ve doğru/yanlış değeri otomatik bilinen çok sayıda benzersiz cümle üretirken kelime zorluğunu, semantik mesafeyi ve duygusal özellikleri parametrik olarak kontrol edebilmesidir; böylece hem tekrar testlerinde ezber etkisini azaltabilir hem de farklı bilişsel yük koşulları oluşturabilir.
Yöntemsel sınırlılıklar
Birinci sınırlılık, İngilizce implementasyonun henüz formal psikometrik validasyonunun bulunmamasıdır.
İkinci olarak mevcut ontoloji 97 entity ve 23 class ile sınırlıdır; dolayısıyla “sonsuz” varyasyon kombinatorik anlamda geniş olsa da kavramsal evren tamamen sınırsız değildir.
Üçüncü olarak semantic distance’ın bilişsel zorlukla ne ölçüde doğrusal ilişki taşıdığı bu çalışmada ampirik olarak ölçülmemiştir.
Dördüncü olarak Hard preset içindeki düşük valence ve düşük concreteness kombinasyonlarının farklı katılımcı gruplarında aynı bilişsel yükü oluşturacağı doğrulanmamıştır.
Kaynak ve Yöntem Notu
Özgün başlık:A MATLAB Toolbox for Standardized Reading Speed Assessment: Implementing and Extending the Perrin Sentence Generator for English Corpora
Yazarlar: Daniel P. Spiegel, Romain Bachy.
Kurum: Meta Reality Labs, 9805 Willows Rd, Redmond, WA 98052, USA.
arXiv: 2606.06297v1 [cs.HC].
Tarih: 4 Haziran 2026.
Kaynak türü: Açık kaynak MATLAB yazılımı ve yöntem geliştirme makalesi.
Ana veri kaynağı: Glasgow Norms, 5.554 kelime; CC BY 4.0.
Temel yöntem: Köklü semantik ontoloji, proto-truth sınıflandırması, quantifier tabanlı truth mapping, psycholinguistic band-pass filtering, İngilizce morfolojik güvenlik kontrolleri ve semantic-distance manipulation.
Validasyon durumu: Perrin ve arkadaşlarının Fransızca orijinal yaklaşımı N=41 ile doğrulanmış ve sessiz True/False görevi ile oral MNREAD arasında \(r=0.836,\ p<0.001\) korelasyon bildirilmiştir. Bu makaledeki İngilizce MATLAB implementasyonu ise henüz English MNREAD veya IReST’e karşı formal psikometrik doğrulama beklemektedir.
Lisans notu: Araç kutusunda kullanılan Glasgow Norms üçüncü taraf veri seti CC BY 4.0 lisansıyla sunulmaktadır; yeniden dağıtımda özgün lisans ve telif bilgilerinin korunması gerekir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir