

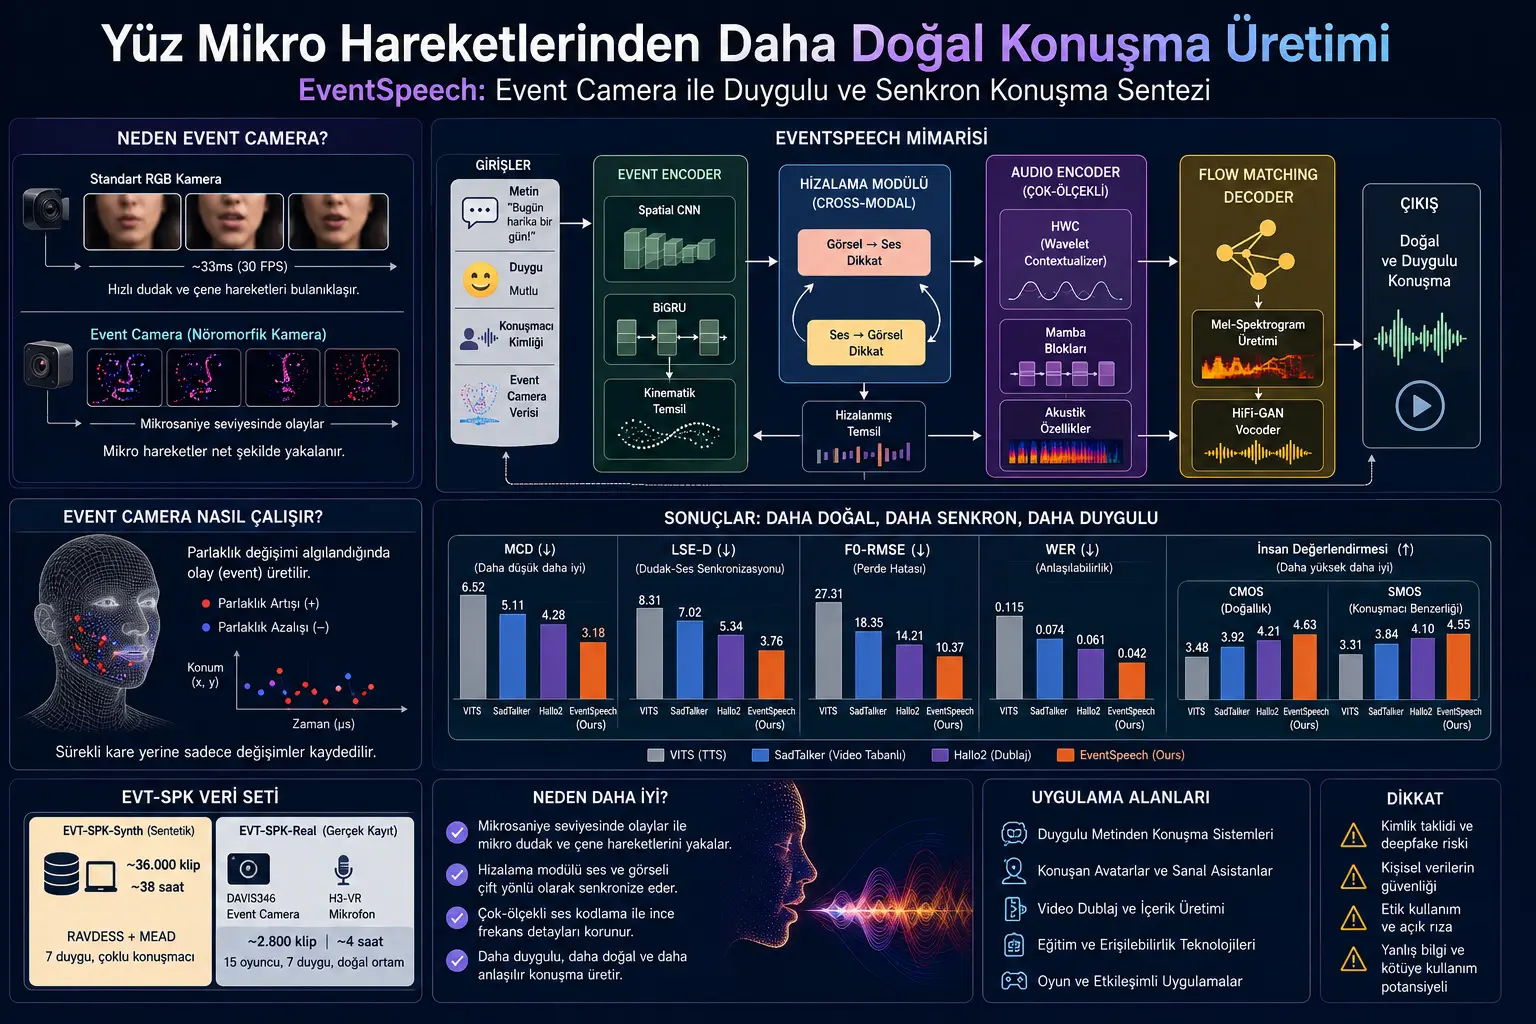
Uzalishaji wa usemi kwa akili bandia sasa umeendelea sana. Mifumo inayoweza kubadilisha maandishi kuwa sauti inaweza kutoa matokeo karibu na sauti ya binadamu. Lakini bado kuna tatizo muhimu: Sauti inayozalishwa mara nyingi huwa inaeleweka, lakini inaweza kushindwa kushika kikamilifu mabadiliko hafifu ya hisia, mabadiliko ya mkazo, na mdundo unaolingana na mienendo ya uso katika usemi halisi wa binadamu.
Makala hii iliyoandaliwa na Jingping Fang na wenzake inakaribia tatizo hili kutoka mahali tofauti. Watafiti wanapendekeza kutumia event camera yaani kamera ya matukio ya neuromorphic badala ya picha za kamera za kawaida za RGB. Kamera hizi, badala ya kuchukua fremu thabiti kama kamera za kawaida za video, hurekodi mabadiliko ya mwangaza katika picha kwa usahihi wa mikrosekunde.
Kulingana na watafiti, sifa hii inaweza kutoa faida katika kushika mienendo yenye kasi sana na midogo ya midomo, taya, na misuli ya uso. Mikromienendo hii inaweza kuhusiana na hisia, mkazo, na mdundo katika usemi wa binadamu.
Makala inapendekeza mfumo uitwao EventSpeech. Mfumo huu unalenga kuzalisha usemi wa asili zaidi, uliosawazishwa zaidi, na wenye hisia zaidi kwa kutumia maandishi, taarifa za hisia, sifa za sauti, na data ya event camera. Zaidi ya hayo, watafiti pia wanaunda seti mpya ya data iitwayo EVT-SPK kwa ajili ya uwanja huu.
Uzalishaji wa usemi kutoka maandishi, yaani mifumo ya TTS, hubadilisha maandishi yaliyoandikwa kuwa sauti. Leo mifumo hii inaweza kuzalisha usemi unaoeleweka sana. Lakini “usemi unaoeleweka” na “usemi wenye hisia, ulio hai, na kama wa binadamu” si kitu kimoja.
Katika usemi halisi wa binadamu hakuna maneno tu. Toni ya sauti, pumzi, mkazo, tempo, mienendo ya midomo, kufunguka na kufunga kwa taya, mabadiliko madogo katika misuli ya uso, na microexpressions pia huathiri asili ya usemi.
Mifumo ya uzalishaji wa usemi inayosaidiwa na video hutumia picha za uso kwa sababu hiyo. Lakini kamera za kawaida zina kikomo muhimu: Video hutengenezwa na idadi fulani ya fremu kwa sekunde. Kwa mfano, kamera ya 30 FPS hutengeneza fremu moja takriban kila milisekunde 33. Ndani ya muda huo, mitetemeko ya haraka ya midomo, mienendo ya ghafla ya taya, au microexpressions inaweza kufifia.
Makala inaita tatizo hili Temporal Granularity Mismatch. Tukirahisisha kwa Kiswahili:
Kutolingana kwa undani wa muda.
Yaani, wakati mawimbi ya sauti yanabadilika kwa kasi sana na endelevu, picha ya kamera ya kawaida inaweza kushindwa kushika mabadiliko hayo kwa azimio la kutosha la muda. Matokeo yake, modeli ya akili bandia pia inaweza kukosa ishara hafifu kutoka mienendo ya uso na kuzalisha usemi “wa wastani” zaidi, wenye uhai mdogo.
Mbinu inapendekeza nini?
Watafiti wanapendekeza mfumo mpya wa uzalishaji wa usemi uitwao EventSpeech ili kutatua tatizo hili.
Wazo kuu la mfumo huu ni hili:
Badala ya picha za kamera za kawaida, kushika mienendo midogo sana na yenye kasi inayotokea usoni wakati wa kuongea kwa event camera. Hivyo mfumo unaweza kusoma kwa usahihi zaidi mabadiliko ya haraka katika mienendo ya midomo, taya, kichwa, na usemi wa uso.
Event camera ni nini?
Kamera ya kawaida hurekodi picha nzima katika kila fremu. Event camera, kwa upande mwingine, huguswa tu pale kuna mabadiliko katika picha. Kwa mfano, ikiwa kuna mabadiliko madogo ya mwangaza kwenye ukingo wa midomo, taya, au uso, hurekodi hilo kama tukio. Matukio haya yanaweza kuhifadhiwa kwa usahihi wa juu sana wa muda.
Kwa sababu hiyo, event camera inaweza kutoa faida hasa katika mienendo ya haraka na hali ngumu kama mwangaza mdogo. Inategemea kidogo ukungu wa mwendo katika kamera ya kawaida.
Mfumo wa EventSpeech kwa ujumla unajumuisha sehemu zifuatazo:
1. Event Encoder
Huchakata data ya event inayotoka mienendo ya uso. Hujaribu kutenganisha sifa kama mienendo ya midomo, vitendo vya uso, mkao wa kichwa, mdundo wa usemi, na prosody ya kuona.
2. Multi-Scale Audio Encoder
Huchakata muundo wa sauti katika mizani tofauti. Hapa lengo ni kuhifadhi mtiririko wa jumla wa usemi na pia undani mdogo wa masafa. Katika makala, muundo uitwao HWC yaani Hierarchical Wavelet Contextualizer unatumika.
3. Cross-Modal Alignment Module
Hulinganisha mienendo ya kuona na sifa za sauti. Kwa urahisi, hujaribu kuhakikisha kwamba wakati mienendo ya midomo inatokea, sauti pia hutokea kwa wakati unaofaa.
4. Text Processing Backbone
Hupokea maandishi, taarifa za hisia, na mtindo wa sauti. Hivyo mfumo hubaki kutegemea si mienendo ya kuona tu, bali pia maandishi yatakayosemwa na hisia inayotakiwa.
5. Flow Matching Decoder
Katika hatua ya mwisho, mel-spectrogram hutolewa kutoka taarifa hizi na, kwa msaada wa vocoder, hubadilishwa kuwa mawimbi ya usemi.
Wazo kuu katika makala ni hili:
Uzalishaji wa usemi si kusoma maandishi tu. Mienendo ya kimwili ya uso pia inaweza kusaidia sauti kutoka kwa asili na yenye hisia. Event camera inaweza kushika mienendo hiyo kwa undani zaidi kuliko video ya kawaida.
Fomula zinasema nini?
Fomula katika makala zinaeleza jinsi mfumo unavyounganisha vyanzo tofauti vya taarifa na jinsi unavyojifunza uoanifu wa sauti–picha. Kwa msomaji tunaweza kurahisisha na kutaja mawazo makuu mawili.
Fomula ya kwanza: Kuunganisha sifa za sauti
Fomula ya kwanza katika makala inaleta pamoja sifa za ndani na za jumla za sauti.
Alama kuu hapa zinaweza kufikiriwa hivi:
- Fa: Uwakilishaji wa mwisho wa acoustic uliotengenezwa na modeli
- Hτ: Taarifa inayowakilisha mabadiliko ya muda mfupi, ya ndani ya sauti
- Hω: Taarifa inayowakilisha muundo wa jumla zaidi, wa spectral wa sauti
- α: Utaratibu wa lango unaojifunza ni kiasi gani modeli itapea uzito kila aina ya taarifa hizi mbili
- etmb: Taarifa kuhusu timbre ya mzungumzaji au utambulisho wa sauti
- Wf: Tabaka la mabadiliko linalojifunza linalounganisha taarifa hizi
Ujumbe kuu wa fomula hii ni huu:
Wakati modeli inazalisha usemi, haangalii toni ya jumla ya sauti tu. Inatumia pamoja undani wa muda mfupi na timbre ya jumla. Hivyo lengo ni usemi kusikika ukieleweka na pia ukiwa wa asili.
Fomula ya pili: Kulainisha sauti na mienendo ya kuona
Hasara ya InfoNCE katika makala inalenga kukaribisha jozi sahihi za sauti–picha na kuondoa ulinganifu usio sahihi.
Kwa urahisi tunaweza kufikiria hivi:
- Mienendo ya uso ya mtu na sauti yake inayohusiana naye inapaswa kuoana.
- Sauti ya mtu mwingine au sauti ya wakati usio sahihi haipaswi kuzingatiwa kuoana na mienendo hiyo ya kuona.
- Modeli, kwa kujifunza ulinganifu sahihi, inajaribu kujenga uhusiano thabiti zaidi kati ya mienendo ya midomo, hisia, na sauti.
Ujumbe kuu wa fomula hii ni huu:
Modeli haisemi tu “badilisha maandishi kuwa sauti”; pia inajifunza swali: “je, mienendo hii ya uso na sauti hii kweli zinaoana?”
Ikiwa kuna grafu / jedwali / mchoro, ujumbe kuu ni nini?
Picha na jedwali katika makala zinaeleza usanifu wa mfumo na kwa nini event camera inatumika.
Mchoro wa kwanza katika makala:
Picha ya mfumo katika ukurasa wa kwanza inaonyesha kwamba EventSpeech, wakati wa mafunzo, hujifunza kutoka sauti na data ya event; katika hatua ya inference, inaweza kuzalisha usemi kwa maandishi au, ikiwa ipo, kwa taarifa ya event ya kuona. Ujumbe kuu ni huu: Mfumo unajaribu kuhusisha taarifa hafifu ya muda kutoka mienendo ya uso na mdundo wa asili wa usemi.
Mchoro wa usanifu kuu:
Mchoro mkubwa wa usanifu katika makala unaonyesha sehemu za Event Encoder, Audio Encoder, moduli ya ulinganifu, na Flow Matching Decoder. Ujumbe kuu wa umbo ni huu: Kazi hii si modeli rahisi moja ya TTS; inapendekeza mfumo wa multimodal unaounganisha mienendo ya kuona, maandishi, hisia, timbre ya mzungumzaji, na sifa za sauti.
Mchoro wa ulinganifu:
Mchoro wa ulinganifu wa sauti–picha katika makala unaeleza kwamba sifa za kuona na za acoustic hudhibitiana kupitia utaratibu wa mutual attention. Yaani modeli haiendi kwa mwelekeo mmoja tu kutoka picha kwenda sauti; inaratibu pamoja uwakilishaji wa sauti na picha.
Grafu ya seti ya data ya EVT-SPK:
Picha ya seti ya data katika makala inaonyesha sehemu mbili. Sehemu ya synthetic ina takriban klipu 36,000 na data ya saa 38. Sehemu iliyorekodiwa kwa vifaa halisi ina takriban klipu 2,800 na data ya saa 4. Rekodi halisi zilichukuliwa kwa event camera ya DAVIS346 na kifaa cha kurekodi sauti cha ubora wa juu. Ujumbe kuu ni huu: Watafiti hawakutegemea simulation pekee; walikusanya pia data halisi ya sensor.
Jedwali la matokeo:
Jedwali kuu la ulinganisho katika makala linaonyesha kwamba EventSpeech limetoa matokeo bora kuliko mbinu nyingine katika vipimo vingi. Haswa katika sehemu ya EVT-SPK-Real inayotumia data halisi ya event camera, EventSpeech hutoa matokeo thabiti katika metriki kama MCD, F0-RMSE, WER, na tathmini ya binadamu.
Ulinganisho wa mel-spectrogram:
Picha ya rangi ya mel-spectrogram katika makala inalinganisha muundo wa muda–masafa wa sauti inayozalishwa na mbinu tofauti. Ujumbe kuu ni huu: EventSpeech, hasa katika maeneo ya mabadiliko ya hisia na mawimbi hafifu ya prosodic, inaweza kuzalisha mifumo iliyo karibu zaidi na sauti halisi.
Jedwali za ablation:
Jedwali mwishoni mwa makala zinaonyesha kwamba taarifa ya event camera inaweza kutoa faida ikilinganishwa na kamera ya RGB yenye FPS ya juu. Katika toleo la RGB la 25, 60, na 120 FPS utendaji unaboreshwa, lakini mbinu inayotegemea event inafikia metriki bora. Matokeo haya yanaunga mkono dai la watafiti kwamba “azimio la muda la kamera ya kawaida linaweza kukosa mienendo hafifu ya usemi.”
Majjaribio yamefanywaje?
Watafiti kwanza wanaunda benchmark mpya iitwayo EVT-SPK. Benchmark hii ina sehemu mbili:
EVT-SPK-Synth
Inajumuisha data ya synthetic ya event. Inatumia seti za data za usemi wenye hisia kama RAVDESS na MEAD. Sehemu hii ina takriban klipu 36,000 na data ya saa 38.
EVT-SPK-Real
Inajumuisha data iliyokusanywa kwa vifaa halisi vya event camera. Event camera ya DAVIS346 na kifaa cha kurekodi sauti cha H3-VR vilitumika. Katika rekodi kuna waigizaji 15, hisia 7, na takriban saa 4 za rekodi halisi. Watafiti pia wanajumuisha kwa makusudi hali ngumu kama mwangaza mdogo na mienendo ya haraka ya uso.
Mfumo unafundishwa kwa modeli ya EventSpeech yenye vigezo milioni 113. Katika mafunzo, GPU za NVIDIA A100 zilitumika. Katika hatua ya inference, inatajwa kwamba klipu za sauti za sekunde 8 zilitolewa na mfumo unafanya kazi kwa kasi sana.
Kwa ulinganisho, mbinu za aina tofauti zilitumika:
- Mifumo ya uzalishaji wa usemi kutoka maandishi
- Mifumo ya uzalishaji wa usemi inayosaidiwa na video
- Mifumo ya dubbing na cloning ya sauti ya kuona
- Mbinu zinazotoa ishara inayofanana na event kutoka video ya RGB
- Toleo la EventSpeech linalotumia maandishi pekee
Metriki za tathmini pia zimechaguliwa kwa njia ya vipimo vingi:
- MCD: Hupima tofauti ya spectral ya sauti. Chini ni bora.
- LSE-D / LSE-C: Hupima usawazishaji wa midomo–sauti.
- F0-RMSE: Hupima kosa la masafa ya msingi. Ni muhimu kwa pitch ya usemi na mkazo.
- KL: Hutumika kupima ni kiasi gani usambazaji wa hisia–prosody umehifadhiwa.
- WER: Hupima ni kiasi gani usemi uliozalishwa unaeleweka kwa usahihi kutoka upande wa maandishi.
- CMOS / SMOS: Alama za ubora wa mtazamo na ufanano wa mzungumzaji kwa msingi wa tathmini ya binadamu.
Matokeo yanaonyesha nini?
Kulingana na matokeo ya makala, EventSpeech inaonyesha utendaji thabiti katika vipimo vingi katika seti ya data ya synthetic na ile halisi.
Katika seti ya data ya synthetic EventSpeech inapata MCD ya chini zaidi, usawazishaji bora wa sauti–picha, usahihi bora wa pitch, na kiwango cha chini cha makosa ya maneno ikilinganishwa na mbinu nyingine. Hii inaonyesha kwamba mfumo hauishii kusoma maandishi tu; pia unaweza kuakisi katika usemi taarifa inayotoka mienendo ya uso.
Katika data halisi ya event camera matokeo yanavutia zaidi. EventSpeech inashusha thamani ya MCD hadi 3.18 kwenye EVT-SPK-Real na pia hutoa matokeo thabiti katika thamani ya F0-RMSE. Hii inaonyesha kwamba data halisi ya sensor inaweza kutoa faida kwa asili ya usemi na uoanifu wa midomo–sauti.
Makala pia inajaribu toleo la EventSpeech linalotumia maandishi pekee. Toleo hili pia linatoa matokeo thabiti, lakini modeli kamili inayoongezewa data ya event inaonyesha utendaji bora. Tofauti hii ni ishara muhimu kwamba taarifa ya neuromorphic ya event kweli inachangia.
Katika ulinganisho wa kamera yenye FPS ya juu pia kuna matokeo yanayovutia. Matoleo ya kamera ya RGB ya 25 FPS, 60 FPS, na 120 FPS yanaboresha utendaji, lakini mfumo unaotegemea event unatoa matokeo bora. Watafiti wanahusisha hili na ukweli kwamba kamera za kawaida bado zinategemea mantiki ya exposure na fremu; kamera za event, kwa upande mwingine, hushika mabadiliko ya mwendo kwa njia endelevu na hafifu zaidi.
Kwa nini hii ni muhimu?
Kazi hii inapendekeza mtazamo mpya katika uzalishaji wa usemi. Hadi sasa, mifumo mingi imezingatia maandishi, sauti, au fremu za kawaida za video. EventSpeech, kwa upande mwingine, inaweka mbele wazo kwamba “usemi ni mienendo ya kimwili.”
Binadamu anapoongea, hasemi maneno tu. Midomo, taya, misuli ya uso, na microexpressions huathiri mdundo na hisia za usemi. Ikiwa mienendo hii inaweza kupimwa kwa usahihi zaidi, akili bandia inaweza kuzalisha sauti za asili zaidi na zenye hisia zaidi.
Teknolojia hii inaweza kuwa na thamani ya utafiti katika nyanja zifuatazo siku zijazo:
- Uzalishaji wa asili zaidi wa usemi kutoka maandishi
- Mifumo ya dubbing ya video
- Avatar zinazoongea
- Uzalishaji wa sauti wenye uhamishaji thabiti zaidi wa hisia
- Ulinganifu thabiti zaidi wa kuona–sauti katika mwangaza mdogo au mienendo ya haraka ya uso
- Teknolojia saidizi za mawasiliano
Lakini wakati huo huo ni uwanja unaohitaji tahadhari. Kwa sababu sauti ya binadamu na mienendo ya uso ni vipengele vya utambulisho wa kibinafsi. Ikiwa mifumo kama hii itatumiwa vibaya, hatari kama sauti bandia, dubbing bila ruhusa, au kuiga utambulisho zinaweza kutokea.
Mambo yanayopaswa kuzingatiwa
Ingawa makala hii inatoa matokeo yanayovutia, ina baadhi ya mipaka.
Kwanza, kazi inaonekana kama preprint ya arXiv. Hali ya uchapishaji wa mwisho uliopitiwa na wenza inapaswa kuthibitishwa kando.
Pili, seti ya data halisi ya event camera bado iko katika kipimo kidogo. Katika makala, seti ya data halisi ina takriban klipu 2,800 na rekodi ya saa 4. Ingawa hii ni mwanzo muhimu, data kubwa zaidi inahitajika kwa lugha tofauti, lafudhi, makundi ya umri, aina za uso, hali za mwangaza, na mazingira ya kurekodi.
Tatu, baadhi ya sehemu za mfumo zinategemea data ya synthetic ya event. Ingawa data ya synthetic ni muhimu, inaweza kutokuakisi kikamilifu kelele ya sensor halisi, mabadiliko ya mwangaza, na sifa za kifaa.
Nne, vifaa vya event camera si kifaa ambacho kila mtu anaweza kukipata kwa urahisi. Kwa sababu hiyo, gharama ya vifaa na usanidi wa vitendo ni suala muhimu kwa matumizi mapana ya mbinu.
Tano, uzalishaji wa usemi ni uwanja nyeti kutoka upande wa maadili na usalama. Ikiwa sauti ya watu halisi, mienendo ya uso, au sifa za utambulisho zinatumiwa, idhini ya wazi, usalama wa data, na taratibu za kuzuia matumizi mabaya zinahitajika.
Hitimisho
Kazi ya EventSpeech inapendekeza mbinu mpya katika uzalishaji wa usemi kwa akili bandia inayopita zaidi ya picha za kamera za kawaida. Watafiti wanadai kwamba data ya event camera inaweza kushika mabadiliko madogo yenye kasi katika mienendo ya midomo na uso kwa usahihi zaidi, na kwamba hii inaweza kuchangia uzalishaji wa usemi wa asili zaidi, uliosawazishwa zaidi, na wenye hisia zaidi.
Majjaribio katika makala yanaonyesha kwamba EventSpeech limetoa matokeo thabiti katika data ya synthetic na data halisi ya event camera. Haswa katika hali ngumu kama ukungu wa mwendo, mwangaza mdogo, na articulation ya haraka, mbinu inayotegemea event inaonekana kuwa na faida.
Kutoka mtazamo wa Verianla, ujumbe kuu wa makala hii ni huu:
Mifumo ya baadaye ya uzalishaji wa usemi inaweza kutokutosheka na kusoma maandishi tu. Ili kuiga vizuri zaidi usemi wa binadamu, inaweza kutumia pia athari ndogo sana na za haraka za kimwili za mienendo ya uso. Lakini maendeleo haya yanapaswa kufikiriwa pamoja na matumizi ya kimaadili na jukumu la usalama wa utambulisho.
Kumbuka ya chanzo na mbinu
Maudhui haya yameandaliwa kwa njia asilia katika muundo wa uhariri wa Verianla kwa kutumia kazi ya kitaaluma “Can We Hear from Events? Generating Speech from Event Camera” iliyoandaliwa na Jingping Fang, Lin Chen, Chenyang Xu, Tong Zhao, Weidong Cai, na Xiaoming Chen.
Andiko hili si tafsiri neno kwa neno; mbinu, usanifu wa mfumo, seti ya data, jedwali, grafu, na matokeo katika makala yamerahisishwa na kuandikwa upya kwa wasomaji wa Kiswahili. Maudhui yana lengo la taarifa na elimu. Katika nyanja kama uzalishaji wa sauti ya binadamu, dubbing, kuiga mzungumzaji, data ya biometric, au uzalishaji wa midia kwa msingi wa akili bandia, mahitaji ya kimaadili, kisheria, na usalama yanapaswa kuzingatiwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *