

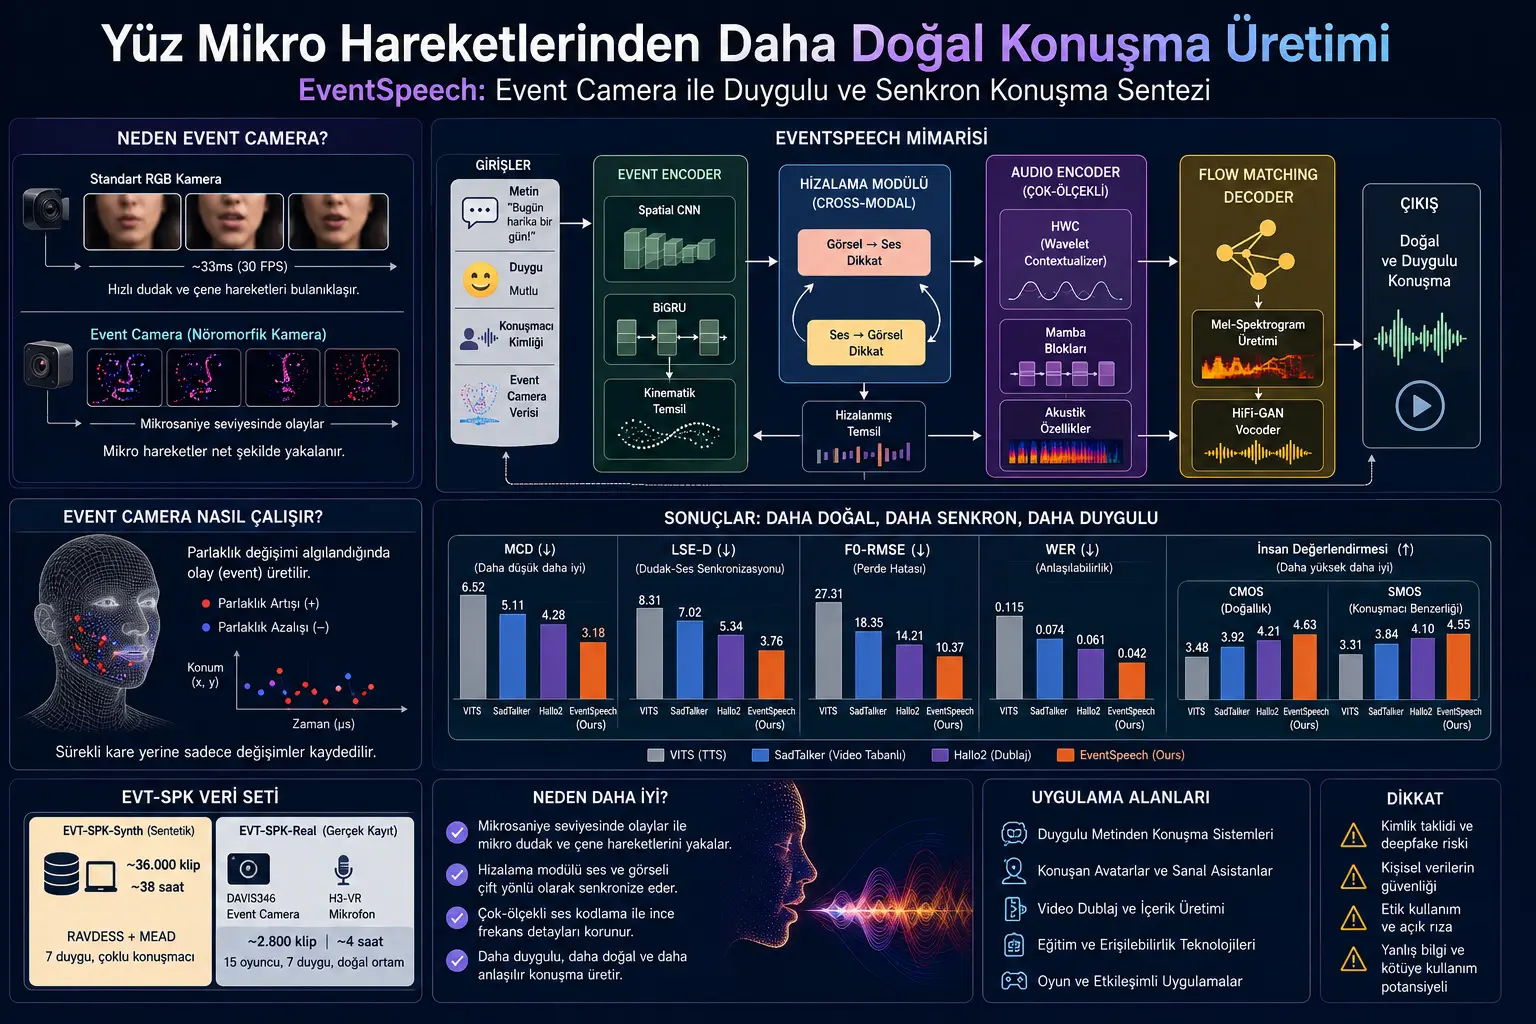
Sun'iy intellekt yordamida nutq hosil qilish endi ancha rivojlangan. Matnni ovozga aylantira oladigan tizimlar inson ovoziga yaqin natijalar chiqarishi mumkin. Lekin hali muhim muammo bor: Hosila qilingan ovoz ko'pincha tushunarli bo'lsa-da, haqiqiy inson nutqidagi nozik hissiyot o'tishlarini, urg'u o'zgarishlarini va yuz harakatlari bilan uyg'un ritmni to'liq ushlay olmasligi mumkin.
Jingping Fang va hamkasblari tayyorlagan ushbu maqola bu muammoga boshqa tomondan yondashadi. Tadqiqotchilar standart RGB kamera tasvirlari o'rniga event camera ya'ni neyromorfik voqea kamerasi ishlatishni taklif qiladi. Bu kameralar klassik video kameralar kabi qat'iy kadrlar olish o'rniga, tasvirdagi yorug'lik o'zgarishlarini mikrosoniya aniqlikda qayd etadi.
Tadqiqotchilarga ko'ra bu xususiyat lab, jag' va yuz mushaklaridagi juda tez va mayda harakatlarni tutib olishda ustunlik berishi mumkin. Bu mikroharakatlar inson nutqidagi hissiyot, urg'u va ritm bilan bog'liq bo'lishi mumkin.
Maqola EventSpeech nomli tizimni taklif qiladi. Bu tizim matn, hissiyot ma'lumoti, ovoz xususiyatlari va event camera ma'lumotlaridan foydalanib yanada tabiiy, yanada sinkron va yanada hissiyotli nutq hosil qilishni maqsad qiladi. Bundan tashqari tadqiqotchilar bu soha uchun EVT-SPK nomli yangi ma'lumotlar to'plamini ham yaratadi.
Matndan nutq hosil qilish, ya'ni TTS tizimlari, yozma matnni ovozga aylantiradi. Bugungi kunda bu tizimlar ancha tushunarli nutqlar chiqara oladi. Ammo “tushunarli nutq” bilan “hissiyotli, jonli va odamdek nutq” bir xil narsa emas.
Haqiqiy inson nutqida faqat so'zlar emas. Ovoz toni, nafas, urg'u, tempo, lab harakatlari, jag'ning ochilib-yopilishi, yuz mushaklaridagi mayda o'zgarishlar va mikroifodalar ham nutqning tabiiyligiga ta'sir qiladi.
Video qo'llab-quvvatlangan nutq hosil qilish tizimlari shuning uchun yuz tasvirlaridan foydalanadi. Lekin standart kameralarning muhim chegarasi bor: Video soniyada ma'lum sondagi kadrlardan iborat. Masalan, 30 FPS kamera taxminan har 33 millisoniyada bir kadr chiqaradi. Bu vaqt ichida tez lab titrashlari, to'satdan jag' harakatlari yoki mikroifodalar xiralashishi mumkin.
Maqola bu muammoga Temporal Granularity Mismatch deb nom beradi. O'zbekcha soddalashtirsak:
Vaqtiy tafsilot nomuvofiqligi.
Ya'ni ovoz to'lqini juda tez va uzluksiz o'zgarayotganida, standart kamera tasviri bu o'zgarishlarni yetarli nozik vaqtiy ajratish bilan tutib ololmasligi mumkin. Natijada sun'iy intellekt modeli ham yuz harakatlaridan keladigan nozik ishoralarni o'tkazib yuborishi va yanada “o'rtacha”, kamroq jonli nutq hosil qilishi mumkin.
Usul nima taklif qiladi?
Tadqiqotchilar bu muammoni hal qilish uchun EventSpeech nomli yangi nutq hosil qilish tizimini taklif qiladi.
Bu tizimning asosiy g'oyasi quyidagicha:
Standart kamera tasvirlari o'rniga, nutq paytida yuzda paydo bo'ladigan juda mayda va tez harakatlarni event camera bilan tutib olish. Shunday qilib tizim lab, jag', bosh harakati va yuz ifodasidagi tez o'zgarishlarni aniqroq o'qishi mumkin.
Event camera nima?
Klassik kamera har bir kadrda butun tasvirni yozib oladi. Event camera esa faqat tasvirda o'zgarish bo'lganda reaksiya beradi. Masalan, lab chetida, jag'da yoki yuzda mayda yorug'lik o'zgarishi bo'lsa, buni voqea sifatida qayd etadi. Bu voqealar juda yuqori vaqtiy aniqlik bilan saqlanishi mumkin.
Shu sababli event camera, ayniqsa tez harakatlarda va past yorug'lik kabi qiyin sharoitlarda ustunlik berishi mumkin. Standart kameradagi harakat xiralashishiga kamroq bog'liq.
EventSpeech tizimi umumiy holda quyidagi qismlarni o'z ichiga oladi:
1. Event Encoder
Yuz harakatlaridan keladigan event ma'lumotlarini qayta ishlaydi. Lab harakati, yuz aksiyalari, bosh pozasi, nutq ritmi va vizual prozodiya kabi xususiyatlarni ajratishga intiladi.
2. Multi-Scale Audio Encoder
Ovozning turli masshtablardagi tuzilishini qayta ishlaydi. Bu yerda maqsad ham umumiy nutq oqimini, ham mayda chastota tafsilotlarini saqlab qolishdir. Maqolada HWC ya'ni Hierarchical Wavelet Contextualizer nomli tuzilma ishlatiladi.
3. Cross-Modal Alignment Module
Vizual harakatlar bilan ovoz xususiyatlarini qatorlashtiradi. Oddiy qilib aytganda, lab harakati qachon bo'lsa, ovozning ham shunga mos vaqtda paydo bo'lishini ta'minlashga intiladi.
4. Text Processing Backbone
Matn, hissiyot ma'lumoti va ovoz uslubi kabi ma'lumotlarni oladi. Shunday qilib tizim nafaqat vizual harakatga, balki aytiladigan matnga va kerakli hissiyotga ham bog'liq qoladi.
5. Flow Matching Decoder
Oxirgi bosqichda bu ma'lumotlardan mel-spektrogram hosil qilinadi va vocoder yordamida nutq to'lqiniga aylantiriladi.
Maqoladagi asosiy g'oya quyidagicha:
Nutq hosil qilish faqat matnni o'qish emas. Yuzdagi jismoniy harakatlar ham ovozning tabiiy va hissiyotli chiqishiga yordam berishi mumkin. Event camera bu harakatlarni standart videodan nozikroq tutib olishi mumkin.
Formulalar nima haqida?
Maqoladagi formulalar tizimning turli axborot manbalarini qanday birlashtirishini va ovoz–tasvir uyg'unligini qanday o'rganishini tushuntiradi. O'quvchi uchun soddalashtirib ikkita asosiy g'oyani aytishimiz mumkin.
Birinchi formula: Ovoz xususiyatlarini birlashtirish
Maqoladagi birinchi formula ovozning mahalliy va umumiy xususiyatlarini bir joyga keltiradi.
Bu yerdagi asosiy belgilar quyidagicha tushunilishi mumkin:
- Fa: Model yaratgan yakuniy akustik representation
- Hτ: Ovozning qisqa muddatli, mahalliy o'zgarishlarini ifodalovchi axborot
- Hω: Ovozning yanada umumiy, spektral tuzilishini ifodalovchi axborot
- α: Modelning bu ikki axborot turiga qancha og'irlik berishini o'rganadigan eshik mexanizmi
- etmb: So'zlovchi tembri yoki ovoz identifikatori haqidagi axborot
- Wf: Bu ma'lumotlarni birlashtiruvchi o'rganiladigan o'zgartirish qatlami
Bu formulaning asosiy xabari quyidagicha:
Model nutqni hosil qilayotganda faqat umumiy ovoz toniga qaramaydi. Ham qisqa muddatli tafsilotlarni, ham umumiy tembrni birgalikda ishlatadi. Shunday qilib nutqning ham tushunarli, ham tabiiy eshitilishi maqsad qilinadi.
Ikkinchi formula: Ovoz va vizual harakatning qatorlashuvi
Maqoladagi InfoNCE yo'qotishi to'g'ri ovoz–tasvir juftlarini bir-biriga yaqinlashtirishni, noto'g'ri moslashuvlarni esa uzoqlashtirishni maqsad qiladi.
Oddiy qilib quyidagicha o'ylashimiz mumkin:
- Bir kishining yuz harakati bilan unga tegishli ovoz bir-biri bilan uyg'un bo'lishi kerak.
- Boshqa kishining ovozi yoki noto'g'ri vaqtdagi ovoz bu vizual harakat bilan uyg'un hisoblanmasligi kerak.
- Model to'g'ri moslashuvlarni o'rganib, lab harakati, hissiyot va ovoz o'rtasida kuchliroq bog'lanish o'rnatishga intiladi.
Bu formulaning asosiy xabari quyidagicha:
Model faqat “matnni ovozga aylantir” demaydi; “bu yuzdagi harakat va bu ovoz bir-biriga haqiqatan mos keladimi?” degan savolni ham o'rganadi.
Grafik / Jadval / Sxema bo'lsa asosiy xabar nima?
Maqoladagi tasvirlar va jadvallar tizimning ham arxitekturasini, ham nima uchun event camera ishlatilganini tushuntiradi.
Maqoladagi birinchi sxema:
Birinchi sahifadagi tizim tasviri EventSpeechning o'qitish paytida ham ovoz, ham event ma'lumotlaridan o'rganishini; xulosa chiqarish bosqichida esa matn bilan yoki mavjud bo'lsa vizual event axboroti bilan nutq hosil qila olishini ko'rsatadi. Asosiy xabar quyidagicha: Tizim yuz harakatlaridan keladigan nozik vaqtiy axborotni nutqning tabiiy ritmi bilan bog'lashga intiladi.
Asosiy arxitektura sxemasi:
Maqoladagi katta arxitektura sxemasi Event Encoder, Audio Encoder, qatorlash moduli va Flow Matching Decoder qismlarini ko'rsatadi. Shaklning asosiy xabari quyidagicha: Bu ish bitta oddiy TTS modeli emas; vizual harakat, matn, hissiyot, so'zlovchi tembri va ovoz xususiyatlarini birlashtiruvchi ko'p modalli tizimni taklif qiladi.
Qatorlash sxemasi:
Maqoladagi ovoz–tasvir qatorlash sxemasi vizual va akustik xususiyatlarning o'zaro e'tibor mexanizmi bilan bir-birini nazorat qilishini tushuntiradi. Ya'ni model faqat tasvirdan ovozga bir tomonlama o'tmaydi; ovoz va tasvir representationlarini birgalikda tartibga soladi.
EVT-SPK ma'lumotlar to'plami grafigi:
Maqoladagi ma'lumotlar to'plami tasviri ikki bo'limni ko'rsatadi. Sintetik qism taxminan 36 ming klip va 38 soatlik ma'lumotni o'z ichiga oladi. Haqiqiy apparat bilan yozib olingan qism esa taxminan 2.8 ming klip va 4 soatlik ma'lumotni o'z ichiga oladi. Haqiqiy yozuvlar DAVIS346 event camera va yuqori sifatli ovoz yozish qurilmasi bilan olingan. Asosiy xabar quyidagicha: Tadqiqotchilar faqat simulyatsiyaga ishonmagan, haqiqiy sensor ma'lumotini ham to'plagan.
Natija jadvali:
Maqoladagi asosiy taqqoslash jadvali EventSpeechning ko'plab o'lchovlarda boshqa usullardan yaxshiroq natija berganini ko'rsatadi. Ayniqsa haqiqiy event camera ma'lumoti ishlatilgan EVT-SPK-Real bo'limida EventSpeech; MCD, F0-RMSE, WER va inson baholashi kabi metrikalarida kuchli natijalar beradi.
Mel-spektrogram taqqoslash:
Maqoladagi rangli mel-spektrogram tasviri turli usullar hosil qilgan ovozning vaqt–chastota tuzilishini taqqoslaydi. Asosiy xabar quyidagicha: EventSpeech, ayniqsa hissiyot o'tishlari va nozik prozodik tebranishlar kabi joylarda haqiqiy ovozga yaqinroq naqshlar chiqara oladi.
Ablasya jadvallari:
Maqola oxiridagi jadvallar event camera axborotining yuqori FPS RGB kameraga nisbatan ustunlik berishi mumkinligini ko'rsatadi. 25, 60 va 120 FPS RGB variantlarida samaradorlik yaxshilansa-da, event asosidagi usul yaxshiroq metrikalarga erishadi. Bu natija tadqiqotchilarning “standart kamera vaqtiy ajratishi nutqning nozik harakatlarini o'tkazib yuborishi mumkin” degan da'vosini qo'llab-quvvatlaydi.
Tajribalar qanday o'tkazilgan?
Tadqiqotchilar avval EVT-SPK nomli yangi benchmark yaratadi. Bu benchmark ikki bo'limdan iborat:
EVT-SPK-Synth
Sintetik event ma'lumotlarini o'z ichiga oladi. RAVDESS va MEAD kabi hissiyotli nutq ma'lumotlar to'plamlaridan foydalaniladi. Bu bo'lim taxminan 36 ming klip va 38 soatlik ma'lumotni o'z ichiga oladi.
EVT-SPK-Real
Haqiqiy event camera apparati bilan to'plangan ma'lumotni o'z ichiga oladi. DAVIS346 event camera va H3-VR ovoz yozish qurilmasi ishlatilgan. Yozuvlarda 15 aktyor, 7 hissiyot va taxminan 4 soatlik haqiqiy yozuv bor. Tadqiqotchilar past yorug'lik va tez yuz harakati kabi qiyin sharoitlarni ham ataylab kiritadi.
Tizim 113 million parametrli EventSpeech modeli bilan o'qitiladi. O'qitishda NVIDIA A100 GPU'lar ishlatilgan. Xulosa chiqarish bosqichida 8 soniyalik ovoz kliplari hosil qilingani va tizimning ancha tez ishlashi qayd etilgan.
Taqqoslash uchun turli xil usullar ishlatilgan:
- Matndan nutq hosil qilish tizimlari
- Video qo'llab-quvvatlangan nutq hosil qilish tizimlari
- Dublaj va vizual ovoz klonlash tizimlari
- RGB videodan eventga o'xshash signal chiqaruvchi usullar
- EventSpeechning faqat matn ishlatadigan versiyasi
Baholash metrikalari ham ko'p o'lchovli tanlangan:
- MCD: Ovozning spektral farqini o'lchaydi. Past bo'lishi yaxshiroq.
- LSE-D / LSE-C: Lab–ovoz sinkronizatsiyasini o'lchaydi.
- F0-RMSE: Asosiy chastota xatosini o'lchaydi. Nutq perdesi va urg'u jihatidan muhim.
- KL: Hissiyot–prozodiya taqsimotining qanchalik saqlanganini o'lchash uchun ishlatiladi.
- WER: Hosila qilingan nutqning matn jihatidan qanchalik to'g'ri tushunilishini o'lchaydi.
- CMOS / SMOS: Inson baholashiga asoslangan idrok sifat va so'zlovchi o'xshashligi ballaridir.
Natijalar nima ko'rsatmoqda?
Maqola natijalariga ko'ra EventSpeech ham sintetik, ham haqiqiy ma'lumotlar to'plamida ko'plab o'lchovlarda kuchli samaradorlik ko'rsatadi.
Sintetik ma'lumotlar to'plamida EventSpeech boshqa usullarga nisbatan pastroq MCD, yaxshiroq ovoz–tasvir sinkronizatsiyasi, yaxshiroq perde aniqligi va pastroq so'z xato ulushini qo'lga kiritadi. Bu tizimning faqat matnni o'qish bilan cheklanmay, yuz harakatlaridan keladigan axborotni ham nutqqa aks ettira olishini ko'rsatadi.
Haqiqiy event camera ma'lumotida natijalar yanada e'tiborga loyiq. EventSpeech EVT-SPK-Real ustida MCD qiymatini 3.18 gacha tushiradi va F0-RMSE qiymatida ham kuchli natija beradi. Bu haqiqiy sensor ma'lumotining nutq tabiiyligi va lab–ovoz uyg'unligi jihatidan foyda berishi mumkinligini ko'rsatadi.
Maqola bundan tashqari EventSpeechning faqat matn ishlatadigan versiyasini ham sinaydi. Bu versiya ham kuchli natijalar bersa-da, event ma'lumoti qo'shilgan to'liq model yaxshiroq samaradorlik ko'rsatadi. Bu farq neyromorfik event axborotining haqiqatan hissa qo'shganini ko'rsatuvchi muhim belgi.
Yuqori FPS kamera taqqoslashida ham e'tiborga loyiq natija bor. RGB kameraning 25 FPS, 60 FPS va 120 FPS versiyalari samaradorlikni oshirsa-da, event asosidagi tizim yaxshiroq natija beradi. Tadqiqotchilar buni klassik kameralarning hali ham ekspozitsiya va kadr mantiqiga bog'liqligiga; event kameralarning esa harakat o'zgarishlarini yanada uzluksiz va nozik tutib olishiga bog'laydi.
Bu nima uchun muhim?
Bu ish nutq hosil qilishda yangi nuqtai nazarni taklif qiladi. Shu kungacha ko'plab tizimlar matnga, ovozga yoki standart video kadrlarga e'tibor qaratgan. EventSpeech esa “nutq jismoniy harakatdir” g'oyasini oldinga suradi.
Inson gapirganda faqat so'zlarni aytmaydi. Lablar, jag', yuz mushaklari va mikroifodalar nutqning ritmi va hissiyotiga ta'sir qiladi. Agar bu harakatlar aniqroq o'lchansa, sun'iy intellekt yanada tabiiy va yanada hissiyotli ovozlar hosil qilishi mumkin.
Bu texnologiya kelajakda quyidagi sohalarda tadqiqot qiymatiga ega bo'lishi mumkin:
- Yanada tabiiy matndan nutq hosil qilish
- Video dublaj tizimlari
- Gapiruvchi avatarlar
- Hissiyot uzatishi kuchliroq ovoz hosil qilish
- Past yorug'likda yoki tez yuz harakatlarida mustahkamroq vizual–ovoz qatorlashuvi
- Yordamchi aloqa texnologiyalari
Ammo shu bilan birga ehtiyotkor bo'lish kerak bo'lgan soha. Chunki inson ovozi va yuz harakatlari shaxsiy identifikator elementlaridir. Bunday tizimlar suiiste'mol qilinsa soxta ovoz, ruxsatsiz dublaj yoki identifikatorni taqlid qilish kabi xavflar paydo bo'lishi mumkin.
E'tibor berish kerak bo'lgan jihatlar
Bu maqola ta'sirli natijalar taqdim etsa-da, ba'zi cheklovlarni o'z ichiga oladi.
Birinchidan, ish arXiv preprint sifatida ko'rinadi. Yakuniy taqrizdan o'tgan nashr holati alohida tekshirilishi kerak.
Ikkinchidan, haqiqiy event camera ma'lumotlar to'plami hali cheklangan miqyosda. Maqolada haqiqiy ma'lumotlar to'plami taxminan 2.8 ming klip va 4 soatlik yozuvni o'z ichiga oladi. Bu muhim boshlanish bo'lsa-da, turli tillar, aksentlar, yosh guruhlari, yuz turlari, yorug'lik sharoitlari va yozuv muhitlari uchun kattaroq ma'lumot kerak.
Uchinchidan, tizimning ba'zi qismlari sintetik event ma'lumotlariga tayanadi. Sintetik ma'lumotlar foydali bo'lsa-da, haqiqiy sensor shovqini, yorug'lik o'zgarishi va qurilma xususiyatlarini to'liq aks ettirmasligi mumkin.
To'rtinchidan, event camera apparati har kim osonlikcha ololadigan qurilma emas. Shu sababli usulning keng qo'llanilishi uchun apparat narxi va amaliy o'rnatish muhim masala.
Beshinchidan, nutq hosil qilish etika va xavfsizlik jihatidan nozik sohadir. Haqiqiy odamlarning ovozi, yuz harakati yoki identifikator xususiyatlari ishlatilayotgan bo'lsa, ochiq rozilik, ma'lumot xavfsizligi va suiiste'molning oldini olish mexanizmlari kerak.
Xulosa
EventSpeech ishi sun'iy intellekt yordamida nutq hosil qilishda standart kamera tasvirlaridan tashqariga chiqadigan yangi yondashuvni taklif qiladi. Tadqiqotchilar event camera ma'lumotlarining lab va yuz harakatlaridagi tez mikroo'zgarishlarni aniqroq tutib olishi mumkinligini va buning yanada tabiiy, yanada sinkron, yanada hissiyotli nutq hosil qilishga hissa qo'shishi mumkinligini himoya qiladi.
Maqoladagi tajribalar EventSpeechning ham sintetik, ham haqiqiy event camera ma'lumotlarida kuchli natijalar berganini ko'rsatadi. Ayniqsa harakat xiralashishi, past yorug'lik va tez artikulyatsiya kabi qiyin sharoitlarda event asosidagi yondashuvning foydali bo'lishi mumkinligi ko'rinadi.
Verianla nuqtai nazaridan ushbu maqolaning asosiy xabari quyidagicha:
Kelajakdagi nutq hosil qilish tizimlari faqat matnni o'qish bilan kifoyalanmasligi mumkin. Inson nutqini yaxshiroq taqlid qilish uchun yuz harakatlarining juda mayda va tez jismoniy izlarini ham ishlatishi mumkin. Ammo bu taraqqiyot etik foydalanish va identifikator xavfsizligi mas'uliyati bilan birgalikda o'ylanishi kerak.
Manba va usul eslatmasi
Bu kontent Jingping Fang, Lin Chen, Chenyang Xu, Tong Zhao, Weidong Cai va Xiaoming Chen tomonidan tayyorlangan “Can We Hear from Events? Generating Speech from Event Camera” nomli akademik ishdan foydalanib Verianla tahririy formatida o'ziga xos tarzda tayyorlangan.
Bu yozuv so'zma-so'z tarjima emas; maqoladagi usul, tizim arxitekturasi, ma'lumotlar to'plami, jadvallar, grafklar va natijalar soddalashtirilib o'zbek o'quvchilari uchun qayta yozilgan. Kontent axborot va ta'lim maqsadini ko'zlaydi. Inson ovozi hosil qilish, dublaj, so'zlovchini taqlid qilish, biometrik ma'lumot yoki sun'iy intellekt asosidagi media hosil qilish kabi sohalarda etik, huquqiy va xavfsizlik talablari hisobga olinishi kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan