

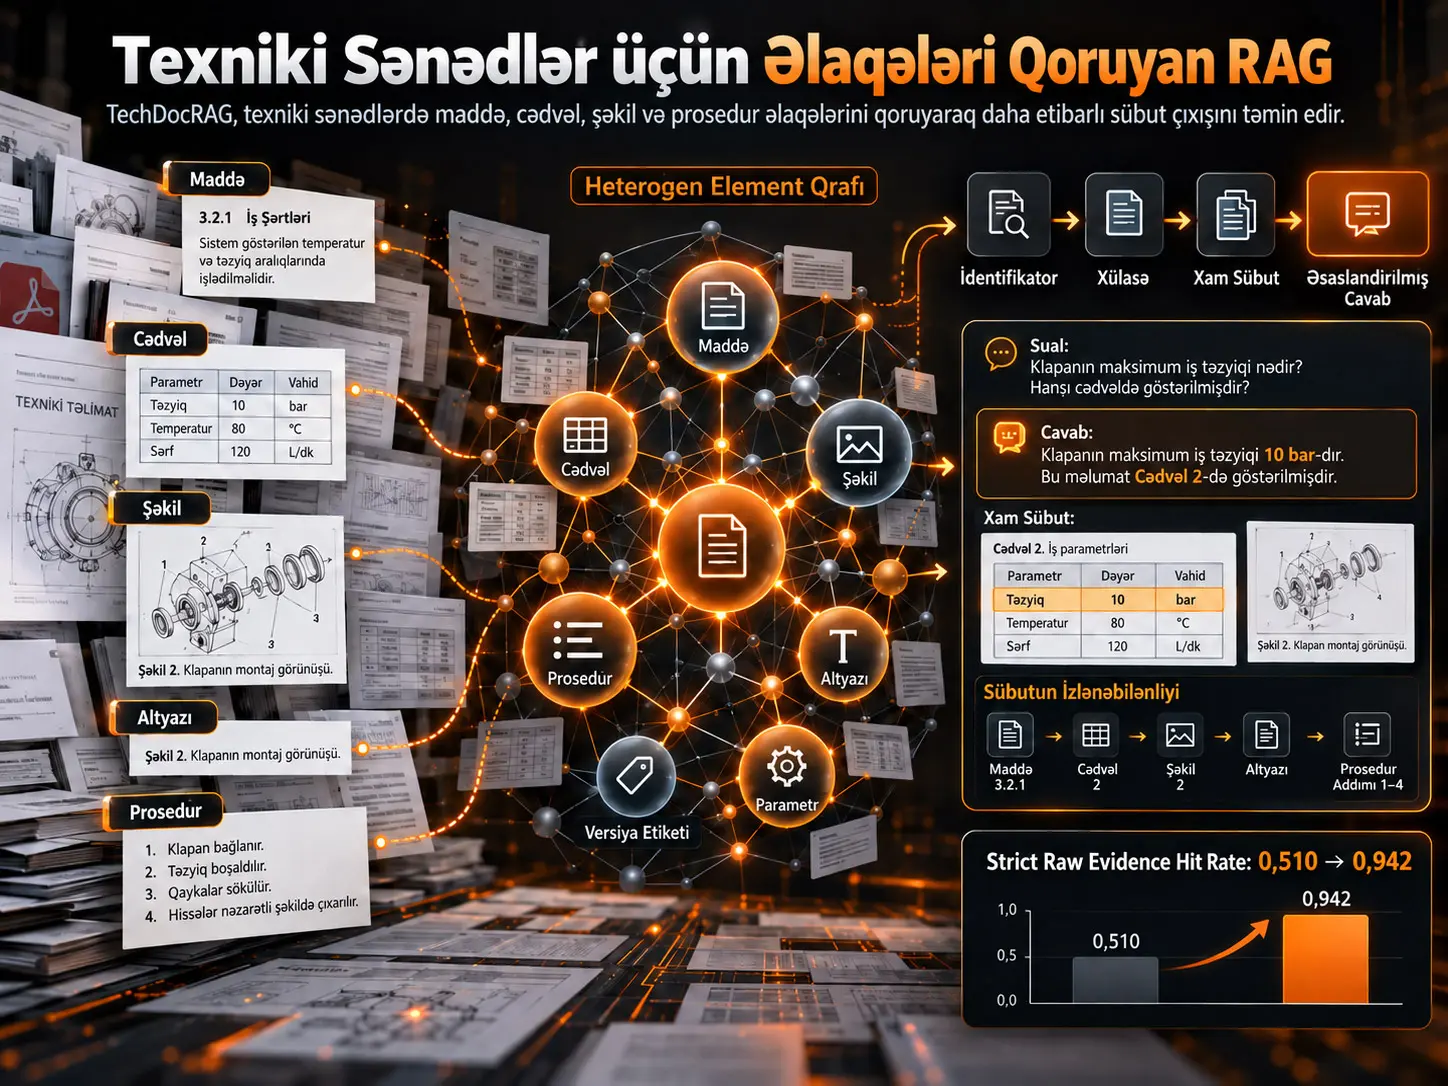
TechDocRAG, texniki sənədləri müstəqil mətn fraqmentlərindən ibarət düz kolleksiya kimi deyil; maddələr, paraqraflar, cədvəllər, şəkillər, alt yazılar, bölmələr və prosedur addımları arasındakı əlaqələri qoruyan heterogen element qrafı kimi təmsil edən retrieval-augmented generation (RAG) çərçivəsidir. Sistem hər sənəd elementini üç uyğunlaşdırılmış görünüşlə indeksləşdirir: texniki identifikatorlar, semantik xülasə və xam sübut. Sorğu zamanı əvvəlcə texniki identifikatorlar üzərindən namizəd elementlər tapılır, daha sonra sorğunun niyyətinə uyğun olaraq əlaqəli elementlərə qraf üzərindən genişlənmə aparılır, semantik xülasələr yenidən sıralanır və son mərhələdə bir-biri ilə əlaqəli xam sübut obyektləri eyni kontekst paketi daxilində generativ modelə göndərilir.
Tədqiqat TechDocRAG-i MPMQA, DesignQA, MMLongBench-Doc və LongDocURL olmaqla dörd benchmark üzərində, balanslaşdırılmış 7500-dən çox sual-cavab cütü ilə qiymətləndirmişdir. Eyni cavab generatorunun və müqayisə edilə bilən kontekst büdcələrinin istifadə olunduğu təcrübələrdə TechDocRAG; MPMQA-da 68,5, DesignQA-da 62,2, MMLongBench-Doc-da 58,4 və LongDocURL-də 55,2 bal əldə etmişdir. Dörd benchmark üzrə orta göstəricidə ən güclü flat yanaşma olan Hybrid Dense+BM25 ilə müqayisədə 20,3 bal, ən güclü non-flat yanaşma olan VisRAG ilə müqayisədə isə 9,3 bal daha yüksək nəticə bildirilmişdir.
Sübutun izlənə bilməsi baxımından fərq daha da aydındır. Exact identifier uyğunluğundan istifadə edən ən sərt Raw Evidence Hit Rate (REHR) qiymətləndirməsində Hybrid RAG 0,510 olduğu halda TechDocRAG 0,942-yə çatmışdır. Ablasiya təcrübələri identifier-aware recall çıxarıldıqda xam sübuta çıxışın, əlaqə kənarları çıxarıldıqda sübut əlaqəliliyinin, raw bundling aradan qaldırıldıqda isə yaradılan iddiaların xam sübutla dəstəklənməsinin nəzərəçarpacaq dərəcədə zərər gördüyünü göstərir.
Bununla yanaşı, sistem texniki sənədlərin ayrışdırılma keyfiyyətindən asılıdır. Xüsusilə maddə nömrəsi, parametr adı, şəkil və ya cədvəl etiketi kimi texniki identifikatorların ciddi şəkildə pozulması ilk retrieval mərhələsini sıradan çıxarır. Buna görə nəticələr “qrafdan istifadə edən hər RAG daha yaxşıdır” kimi deyil; texniki sənədlərdə düzgün sübuta çatmaq üçün sənəddaxili struktur və istinad əlaqələrinin qorunmasının vacib olduğuna dair eksperimental sübut kimi şərh edilməlidir.
Texniki sənəd RAG-i niyə adi mətn RAG-indən fərqlənir?
Texniki spesifikasiyalar, istifadə təlimatları, texniki xidmət sənədləri və mühəndislik standartları adətən vahid, fasiləsiz narrativ mətn deyil. Bir tələbin tərifi Bölmə 4.2-də, hədd qiyməti Cədvəl 7-də, bağlantı sxemi Şəkil 3-də və xüsusi hal xəbərdarlığı növbəti prosedur addımında ola bilər.
Buna görə yalnız semantik baxımdan oxşar paraqrafı tapmaq düzgün cavabı yaratmaq üçün kifayət etməyə bilər. Sistem düzgün maddəni tapsa belə, maddənin istinad etdiyi cədvəli, şəkli və ya qonşu prosedur addımını gətirə bilməzsə sübut zənciri natamam qalır.
TechDocRAG-in əsas problemi məhz budur: əlaqəli mətni tapmaqla cavabı dəstəkləyən tam və əlaqəli sübutu tapmaq eyni vəzifə deyil.
TechDocRAG Standart RAG-dən Necə Fərqlənir?
Standart chunk əsaslı RAG sənədi əsasən sabit uzunluqlu və ya semantik mətn fraqmentlərinə bölür və bu fraqmentləri müstəqil retrieval vahidləri kimi emal edir. TechDocRAG isə maddə, cədvəl, şəkil, caption, prosedur addımı və versiya məlumatı kimi orijinal sənəd obyektlərini qoruyur; onların arasındakı table_ref, figure_ref, caption_of, step_next, version_of və bənzər əlaqələri qraf kənarları kimi saxlayır. Beləliklə retrieval təkcə “hansı məzmun oxşardır?” sualına deyil, “bu sübut hansı digər sübutlarla birlikdə oxunmalıdır?” sualına da cavab verir.
Sənəd heterogen element qrafına çevrilir
Bir texniki sənəd \(d\), tədqiqatda aşağıdakı qrafla təmsil olunur:
\[ G_d=(V_d,E_d) \]
Burada \(V_d\) sənəddəki element düyünlərini; \(E_d\) isə bu elementlər arasındakı əlaqələri təmsil edir.
Hər düyün:
\[ v=(\tau_v,r_v,k_v,s_v,m_v) \]
formasında müəyyən edilir.
- \(\tau_v\): Elementin növü; məsələn, maddə, paraqraf, cədvəl, şəkil, caption və ya prosedur addımı.
- \(r_v\): Xam sənəd obyekti.
- \(k_v\): Texniki identifikatorlar və açar sözlər.
- \(s_v\): Semantik xülasə.
- \(m_v\): Səhifə indeksi, bounding box, bölmə yolu, sənəd növü, versiya və normative label kimi metadata.
Bu struktur düz chunking zamanı itə biləcək sənəd kimliyini qoruyur.
Qraf kənarları hansı əlaqələri təmsil edir?
| Əlaqə | Mənası |
|---|---|
| contains | Bölmənin və ya üst elementin alt elementləri ehtiva etməsi |
| precedes | Yerli oxunuş zamanı bir elementin digərindən əvvəl gəlməsi |
| same_section | Eyni bölmə və ya alt bölmə daxilində yerləşmə |
| step_next | Prosedur addımlarının ardıcıl bağlantısı |
| clause_ref | Bir maddənin başqa bir maddəyə açıq istinadı |
| table_ref | Mətndən cədvələ edilən istinad |
| figure_ref | Mətndən şəklə edilən istinad |
| caption_of | Şəkil və ya cədvəllə caption arasındakı bağlantı |
| same_identifier | Eyni texniki identifikatorun müxtəlif elementlərdə təkrar istifadəsi |
| version_of / supersedes | Sənədin müxtəlif versiyaları arasındakı əlaqə |
Retrieval hədəfi yalnız “ən uyğun fraqment” deyil
Tədqiqat retrieval problemini əlaqəli sübut altqrafını tapma problemi kimi müəyyən edir:
\[ H_q^*=\arg\max_{H\subseteq G} \left[ Rel(q,H)+\lambda Conn(H)+\gamma Valid(q,H)-\mu Cost(H) \right] \]
Bu məqsəd funksiyasında:
- \(Rel(q,H)\), sorğu ilə sübut altqrafı arasındakı leksik və semantik uyğunluğu;
- \(Conn(H)\), sübut düyünlərinin əlaqəliliyini və bütövlüyünü;
- \(Valid(q,H)\), sənəd versiyası və ya sənəd növü kimi metadata uyğunluğunu;
- \(Cost(H)\), retrieval və kontekst yaratma xərcini
təmsil edir.
\(\lambda\), \(\gamma\) və \(\mu\) isə bu komponentlərin məqsəd funksiyasındakı çəkiləridir. Riyazi məqsəd yalnız ən oxşar düyünləri toplamaq deyil, kifayət qədər əlaqəli və metadata baxımından etibarlı sübut altqrafı yaratmaqdır.
Seçilmiş altqraf daha sonra cavab generatoruna ötürülür:
\[ (y_q,\Pi_q)=f_\theta(q,H_q^*) \]
Burada \(y_q\) yaradılan cavabı, \(\Pi_q\) isə yaradılan iddialardan xam sübut düyünlərinə uzanan provenance bağlantılarını təmsil edir.
Üçlü “Identifier–Summary–Raw” Strukturu Nəyə Xidmət Edir?
TechDocRAG hər sənəd elementini eyni kimliyə bağlanmış üç retrieval görünüşündə saxlayır: identifier görünüşü dəqiq texniki ankrajları tapmaq, summary görünüşü sorğu ilə semantik uyğunluğu qiymətləndirmək, raw evidence görünüşü isə son cavabın həqiqətən əsaslandığı orijinal mətn, cədvəl, şəkil və ya proseduru generativ modelə ötürmək üçün istifadə olunur. Bu ayrım semantik baxımdan faydalı, lakin mənbə ilə birbaşa izlənə bilməyən xülasələrin xam sübutun yerini tutmasının qarşısını alır.
Identifier və xülasə necə yaradılır?
Hər düyün üçün texniki identifier dəsti və semantik xülasə:
\[ k_v=ExtractId(r_v,m_v), \qquad s_v=Summarize(r_v,N(v)) \]
kimi müəyyən edilir.
\(N(v)\), düyünün yerli əlaqə qonşuluğudur. Xülasə yalnız elementin öz xam məzmunundan deyil, onu mənalandıran yaxın sənəd kontekstindən də istifadə edə bilər.
Hər düyünün uyğunlaşdırılmış təmsili:
\[ \phi(v)=\{k_v,s_v,r_v,m_v\} \]
şəklindədir.
Korpus səviyyəsində verilənlər bazası isə:
\[ D=(I_{id},I_{sum},R,G) \]
kimi müəyyən edilir.
- \(I_{id}\): Texniki identifier indeksi.
- \(I_{sum}\): Semantik xülasə indeksi.
- \(R\): Xam sübut deposu.
- \(G\): Əlaqə qrafı.
Identifier indeksi niyə kritikdir?
Texniki sənədlərdə “Section 4.2”, “Table 7”, “parameter Z”, “error E105”, bir API əmri və ya versiya etiketi semantik baxımdan adi sözdən çox daha güclü ankraj ola bilər.
Buna görə TechDocRAG ilk retrieval qatında texniki identifikatorlara xüsusi çəki verir. Ablasiya təcrübəsində identifier-aware recall çıxarıldıqda REHR@10 dəyəri tam modeldəki 0,94-dən 0,65-ə düşür. Bu, sistemin mühüm performans mənbələrindən birinin düzgün texniki ankrajı erkən mərhələdə tapmaq olduğunu göstərir.
Sorğu əvvəlcə təhlil edilir
Hər sorğu üç komponentə ayrılır:
\[ (k_q,e_q,z_q)=Analyze(q) \]
- \(k_q\): Sorğudakı texniki identifier və açar sözlər.
- \(e_q\): Semantik sorğu təmsili.
- \(z_q\): Sorğu niyyəti.
Mənbədə istifadə olunan niyyət növlərinə tərif/tələb axtarışı, prosedur və ya troubleshooting, mətn-cədvəl mühakiməsi, mətn-şəkil grounding, cross-reference həlli və versiyaya həssas sorğular daxildir.
Eyni retrieval siyasəti hər sual üçün istifadə olunmur
| Sorğu növü | Önə çıxan əlaqələr | Maksimum hop | Əsas hədəf |
|---|---|---|---|
| Tərif / tələb | contains, same_identifier, clause_ref | 1-2 | Maddə və ya paraqraf |
| Prosedur / troubleshooting | step_next, contains, same_section | 2 | Prosedur addımları |
| Mətn-cədvəl | table_ref, caption_of, same_identifier | 2 | Cədvəl sətri / başlıq yolu |
| Mətn-şəkil | figure_ref, caption_of, same_section | 2 | Şəkil-caption cütü |
| Cross-reference | clause_ref, table_ref, figure_ref | 2 | İstinad verilən element |
| Versiyaya həssas sorğu | version_of, supersedes, same_identifier | 1 | Aktiv reviziya düyünləri |
Bu siyasətin məntiqi belədir: “Bir parametr nədir?” sualı ilə “Sensor Y necə yenidən kalibrə edilir?” sualının ehtiyac duyduğu sənəd əlaqələri eyni deyil.
TechDocRAG Bir Sorğunu Addım-Addım Necə Emal Edir?
Onlayn retrieval zənciri identifier-aware recall ilə başlayır, sorğu niyyətinə uyğun qraf genişlənməsi ilə davam edir, genişləndirilmiş namizədlər semantik xülasə sahəsində yenidən sıralanır, seçilmiş düyünlər xam sübut obyektlərinə həll edilir və əlaqəli sübutlar kontekst büdcəsi altında vahid paketə çevrilir. Son cavab yalnız bu paket əsasında yaradılır və iddialar provenance bağlantıları ilə xam sübuta bağlanır.
1. Identifier-aware recall
İlk namizəd dəsti mənbədə aşağıdakı formada müəyyən edilir:
\[ C_{id}= TopK_{v\in V} \left[ \lambda_1 BM25(q,k_v) +\lambda_2 IdMatch(k_q,k_v) +\lambda_3 MetaMatch(q,m_v) \right] \]
BM25 leksik uyğunluğu, IdMatch texniki identifier uyğunluğunu, MetaMatch isə sorğu ilə metadata uyğunluğunu qiymətləndirir.
2. Əlaqə qrafında genişlənmə
İlk namizədlərin sorğu niyyətinə uyğun qonşuları əlavə edilir:
\[ C_{id}^{e}=C_{id}\cup Expand(C_{id},\Omega(z_q)) \]
\(\Omega(z_q)\), müvafiq sorğu niyyəti üçün hansı əlaqə tiplərinin izlənəcəyini müəyyən edən siyasətdir.
3. Summary-level reranking
Genişləndirilmiş elementlər semantik xülasə sahəsində yenidən sıralanır:
\[ C_{sum}=TopL_{v\in C_{id}^{e}} \left[ \alpha \cos(e_q,e_v) +\beta RelScore(v,C_{id}) +\gamma TypePrior(z_q,\tau_v) \right] \]
Buradakı əsas fikir ilk qatın exact technical anchors üçün yüksək recall təmin etməsi; ikinci qatın isə bu namizədləri sorğunun həqiqi semantik məqsədi baxımından daraltmasıdır.
4. Xam sübutun paketlənməsi
Yenidən sıralanan düyünlər xam sübuta çevrilir:
\[ C_{raw}=\bigcup_{v\in C_{sum}}Bundle(v) \]
Bir Bundle, tək bir mətn fraqmentindən daha çoxunu ehtiva edə bilər. Məsələn, bir maddə + onun istinad etdiyi cədvəl; yaxud şəkil kəsimi + caption + şəklə istinad edən paraqraf eyni sübut paketi daxilində saxlanıla bilər.
5. Kontekst büdcəsi
Xam sübutlar kontekst büdcəsi \(B\) altında paketlənir:
\[ E_q=Pack(C_{raw},B) \]
Təcrübə protokolunda kontekst büdcəsi 2048 mətn tokeni və multimodal üsullar üçün 10 vizual region kimi normallaşdırılmışdır.
6. Grounded generation və provenance
Son cavab:
\[ (\hat{y}_q,\Pi_q)=g_\theta(q,E_q) \]
ilə yaradılır.
İddia səviyyəsində provenance isə:
\[ \Pi_q=\{(c_i,U_i)\}_{i=1}^{M}, \qquad U_i\subseteq C_{raw} \]
şəklində müəyyən edilir. Burada hər \(c_i\) yaradılan bir iddia, \(U_i\) isə bu iddianı dəstəkləyən xam sübut obyektləridir.
PDF-in Şəkil 1-i nəyi izah edir?
Mənbədəki Şəkil 1 arxitekturanı iki əsas hissəyə ayırır. Offline index construction tərəfində texniki sənədlər parse və canonicalize edilir, heterogen element qrafı yaradılır və identifier index, summary index, raw store ilə relation store uyğunlaşdırılır. Online query-time tərəfində istifadəçi sorğusu təhlil edilir, identifier-aware recall aparılır, əlaqə genişlənməsi və summary reranking tətbiq edilir, xam sübut paketi yaradılır və provenance daxil olan cavab istehsal edilir.
PDF-in Şəkil 2-si nə əlavə edir?
Şəkil 2 xüsusilə onlayn qərar axınına fokuslanır. Sorğunun identifier və niyyət komponentlərinə ayrılmasının hansı relation policy-nin seçiləcəyini müəyyən etdiyini, retrieval-dan sonra əlaqəli qonşuların götürüldüyünü və generativ modelə müstəqil fraqmentlər əvəzinə əlaqəli xam sübut paketlərinin göndərildiyini göstərir.
Əlaqələri Qorumaq Həqiqətən Performansı Artırdımı?
Mənbə təcrübələrində TechDocRAG dörd benchmark-ın hamısında müqayisə olunan sistemlərdən daha yüksək end-to-end bal vermişdir. Ən böyük fərq yalnız sadə maddə axtarışlarında deyil; prosedur, mətn-cədvəl, cross-reference və versiyaya həssas suallarda ortaya çıxmışdır. Bu nümunə tədqiqatın əsas hipotezi ilə uyğundur: struktur əlaqələrinin ən böyük dəyəri cavabın bir neçə əlaqəli sənəd obyektinə əsaslandığı sorğularda üzə çıxır.
Dörd benchmark
- MPMQA: Məhsul təlimatlarında multimodal sual-cavab; PM209 korpusu 209 təlimat və 22.021 insan tərəfindən etiketlənmiş sual-cavab cütünü ehtiva edir.
- DesignQA: Formula SAE qaydaları, CAD təsvirləri və mühəndislik çertyojları üzərində grounded anlayış.
- MMLongBench-Doc: 130 uzun PDF üzərində 1062 ekspert etiketli sual; orta sənəd uzunluğu 49,4 səhifə.
- LongDocURL: 33.000-dən çox səhifəni əhatə edən 2325 sual-cavab cütü; anlama, mühakimə və yerləşdirmə tapşırıqları.
Nəzarətli qiymətləndirmə bu dörd benchmark-dan seçilmiş balanslaşdırılmış 7500-dən çox sual-cavab cütündən istifadə etmişdir.
Müqayisə edilən RAG üsulları
TechDocRAG; Dense Chunk RAG, Hybrid Dense+BM25, Self-RAG, CRAG, RAPTOR, GraphRAG, LightRAG, HippoRAG 2 və VisRAG ilə müqayisə edilmişdir.
Ədalətli müqayisə üçün bütün üsullarda mümkün qədər eyni cavab generatorundan istifadə edilmişdir: Gemini-3.1-Flash-Lite-Preview. Xarici veb çıxışı söndürülmüş, CRAG yalnız korpusdaxili retrieval ilə məhdudlaşdırılmış və kontekst büdcələri normallaşdırılmışdır.
TechDocRAG tətbiq detalları
| Komponent | Konfiqurasiya |
|---|---|
| Sənəd parser | Layout segmentation, figure-caption alignment və typed element extraction istifadə edən OCR əsaslı multimodal parser |
| Identifier canonicalization | Maddə ID-ləri, cədvəl/şəkil etiketləri, parametr adları və versiya etiketləri üçün qayda əsaslı normallaşdırma; sorğu zamanı fuzzy matching |
| Identifier index | Normallaşdırılmış identifier, maddə nömrəsi, etiket və sahə açar sözləri üzərində BM25 |
| Summary vector index | all-MiniLM-L6-v2 |
| Query analyzer | TinyLlama-1.1B-Chat-v1.0; batch size 16 |
| Answer generator | Gemini-3.1-Flash-Lite-Preview |
| Relation extraction | Açıq cross-reference parsing + layout heuristics |
| Retrieval | Top-10 identifier recall, 2-hop graph expansion, top-5 summary reranking |
| Context budget | 2048 mətn tokeni + 10 visual region |
| Aparat təminatı | Single-GPU inference |
Tədqiqatın Metodu və Nəticələri
End-to-end nəticələr
| Üsul | MPMQA | DesignQA | MMLong | LongDoc |
|---|---|---|---|---|
| Dense Chunk RAG | 44,8 | 40,5 | 33,2 | 31,4 |
| Hybrid Dense+BM25 | 48,2 | 44,1 | 36,5 | 34,2 |
| Self-RAG | 51,8 | 47,5 | 39,8 | 37,5 |
| CRAG | 52,4 | 48,8 | 40,5 | 38,2 |
| RAPTOR | 50,5 | 46,2 | 41,4 | 38,8 |
| GraphRAG | 54,8 | 50,5 | 44,8 | 42,4 |
| LightRAG | 55,6 | 51,2 | 46,1 | 43,8 |
| HippoRAG 2 | 56,5 | 52,8 | 47,5 | 45,2 |
| VisRAG | 54,2 | 57,5 | 48,8 | 46,5 |
| TechDocRAG | 68,5 | 62,2 | 58,4 | 55,2 |
Mənbə dörd benchmark üzrə ortalamada Hybrid Dense+BM25 ilə müqayisədə 20,3 bal və VisRAG ilə müqayisədə 9,3 bal fərq bildirir. Bunlar benchmark ballarının mütləq bal fərqləridir; faiz dəyişikliyi deyil.
Raw Evidence Hit Rate niyə vacibdir?
Raw Evidence Hit Rate (REHR), sistemin həqiqi qızıl-standart xam sübut düyünlərindən ən az birini retrieval nəticəsi daxilində tutub-tutmadığını ölçür:
\[ REHR@K= \frac{1}{|Q|} \sum_{q\in Q} \mathbf{1} \left[ V_q^*\cap\hat{V}_q^{(K)}\neq\varnothing \right] \]
Exact identifier uyğunluğu tələb edən L0 səviyyəsində nəticələr belədir:
| Üsul | Strict REHR |
|---|---|
| Dense | 0,452 |
| Hybrid | 0,510 |
| TechDocRAG | 0,942 |
Meyar 1-hop, 2-hop, 3-hop və 4-hop qonşuluğa yumşaldıldıqda TechDocRAG REHR müvafiq olaraq 0,965, 0,984, 0,992 və 1,000 dəyərlərinə çatmışdır.
Grounding metrikləri
Tədqiqat klassik Recall@10 və Mean Reciprocal Rank ilə yanaşı texniki sənəd əlaqələrini qiymətləndirmək üçün xüsusi metriklər müəyyən edir.
Summary-to-Raw Trace Accuracy (SRTA), gətirilən xülasə düyününün düzgün xam sübuta izlənib-izlənə bilmədiyini ölçür.
Evidence Connectivity Recall (ECR):
\[ ECR= \frac{1}{|Q|} \sum_{q\in Q} \frac{|\hat{E}_q\cap E_q^*|}{|E_q^*|} \]
ilə retrieval zamanı zəruri relation edge-lərin nə qədərinin geri qaytarıldığını ölçür.
Version Consistency Score (VCS), yaradılan iddiaların sorğu ilə əlaqəli düzgün sənəd versiyasına əsaslanma nisbətini qiymətləndirir.
Procedure Order Accuracy (POA), prosedur suallarında addımların düzgün ardıcıllığının qorunmasını ölçür.
Claim Support Rate (CSR), yaradılan iddiaların ən azı bir xam sübut paketi tərəfindən dəstəklənmə nisbətini ölçür.
| Üsul | Recall@10 | MRR | REHR@10 | SRTA | ECR | CSR |
|---|---|---|---|---|---|---|
| Hybrid Dense+BM25 | 45,8 | 0,31 | 0,510 | 0,485 | 0,425 | 0,512 |
| HippoRAG 2 | 58,5 | 0,45 | 0,721 | 0,685 | 0,652 | 0,704 |
| VisRAG | 54,2 | 0,40 | 0,654 | 0,611 | 0,582 | 0,625 |
| TechDocRAG | 69,2 | 0,56 | 0,942 | 0,914 | 0,852 | 0,942 |
Sorğu növünə görə performans
TechDocRAG-in üstünlüyü sadə clause və ya parameter sorğularında daha məhdud, lakin sənəd əlaqələrinin qorunmasını tələb edən sorğularda xeyli böyükdür.
| Sorğu növü | Hybrid Chunk RAG | TechDocRAG |
|---|---|---|
| Clause | 52,1 | 65,8 |
| Parameter | 48,4 | 64,2 |
| Procedure | 35,2 | 62,1 |
| Text–Table | 31,4 | 60,5 |
| Text–Figure | 28,5 | 58,4 |
| Cross-Reference | 25,1 | 57,2 |
| Version | 22,4 | 54,1 |
| Macro Average | 34,7 | 60,3 |
Ablasiya təcrübələri nə göstərir?
| Variant | Main Score | REHR@10 | ECR | CSR | VCS | POA |
|---|---|---|---|---|---|---|
| Tam model | 62,5 | 0,94 | 0,85 | 0,82 | 0,78 | 0,75 |
| Relation edge yoxdur | 51,2 | 0,88 | 0,42 | 0,65 | 0,74 | 0,48 |
| Identifier recall yoxdur | 54,8 | 0,65 | 0,72 | 0,75 | 0,68 | 0,65 |
| Summary routing yoxdur | 56,4 | 0,91 | 0,81 | 0,78 | 0,72 | 0,70 |
| Raw bundling yoxdur | 58,2 | 0,92 | 0,83 | 0,45 | 0,75 | 0,72 |
| Intent-aware expansion yoxdur | 55,6 | 0,90 | 0,58 | 0,72 | 0,74 | 0,61 |
| Version metadata yoxdur | 59,4 | 0,93 | 0,84 | 0,81 | 0,32 | 0,74 |
Bu cədvəl sistem komponentlərinin fərqli funksiyalara malik olduğunu göstərir. Relation edge-lərin çıxarılması ECR-ni 0,85-dən 0,42-yə salır. Identifier recall-un çıxarılması REHR-ni 0,94-dən 0,65-ə endirir. Raw bundling çıxarıldıqda CSR 0,82-dən 0,45-ə düşür. Version metadata çıxarıldıqda isə VCS 0,78-dən 0,32-yə geriləyir.
Beləliklə, sistemin qazancı tək bir komponentdən gəlmir; exact anchor tapma, struktur bağlantı, semantik yenidən sıralama, xam sübut paketləmə və versiya metadata-sı müxtəlif xəta növlərini hədəfləyir.
Performans daha böyük hesablama büdcəsindənmi gəlir?
Mənbədəki profilləmə bunu yeganə izah kimi dəstəkləmir.
| Üsul | Offline indexing | İndeks ölçüsü | Orta sorğu gecikməsi | Peak GPU yaddaşı |
|---|---|---|---|---|
| Dense Chunk RAG | 2,5 s | 2,0 MB | 5,2 ms | ~150 MB |
| Hybrid Dense+BM25 | 3,8 s | 3,5 MB | 7,8 ms | ~180 MB |
| HippoRAG 2 | 12,4 s | 8,2 MB | 45,6 ms | ~450 MB |
| TechDocRAG | 6,36 s | 2,28 MB | 8,3 ms | 314,4 MB |
TechDocRAG-in offline indeks qurulması Hybrid RAG-dən daha bahalıdır; çünki qraf və üçlü təmsil yaradılır. Buna qarşılıq orta query latency 8,3 ms ilə Hybrid-in 7,8 ms dəyərinə yaxındır və HippoRAG 2-nin 45,6 ms dəyərindən nəzərəçarpacaq dərəcədə aşağıdır.
Identifier korlanmasına qarşı dayanıqlılıq
Tədqiqatın robustness təcrübəsində OCR-a bənzər korlanmalar maddə nömrələrinə, parametr adlarına və cədvəl/şəkil etiketlərinə yeridilmişdir.
| Korlanma / itki nisbəti | REHR: identifier corruption | ECR: relation dropout |
|---|---|---|
| %0 | 1,0000 | 0,9875 |
| %5 | 1,0000 | 0,9825 |
| %10 | 1,0000 | 0,9725 |
| %20 | 0,0700 | 0,9525 |
| %30 | Bildirilməyib | 0,9310 |
Nəticə asimmetrikdir. Relation edge-lərin bir hissəsinin itməsi sistem performansını tədricən azaldarkən texniki identifier-lərin ciddi şəkildə korlanması daha kəskin xəta yaradır. Bu nəticə sistemin qraf əlaqələri baxımından müəyyən dərəcədə redundanslı olduğunu, lakin ilkin retrieval ankrajının düzgün parse edilməsindən güclü şəkildə asılı qaldığını göstərir.
Tədqiqatın məhdudiyyətləri
- TechDocRAG sənəd parser keyfiyyətindən asılıdır.
- Cədvəl extraction, caption alignment və clause numbering xətaları relation graph-ını poza bilər.
- Açıq cross-reference-lar örtülü istinadlardan daha etibarlı emal olunur.
- Standartdan kənar layout və insan üçün anlaşılan, lakin maşın üçün örtülü formal ipucları problem yarada bilər.
- Müxtəlif sənəd versiyalarında eyni identifier fərqli şərtlərlə yenidən istifadə oluna bilər.
- Relation-aware grounding metrikləri əl ilə sübut annotasiyası tələb edir.
- Performans nəticələri müəyyən benchmark-lar, retrieval konfiqurasiyaları və ortaq cavab generatoru altında əldə edilmişdir.
- Mənbənin əsas nəticə cədvəllərində təkrarlı təcrübə variasiyası, etibar intervalı və ya klassik əhəmiyyətlilik testi bildirilmir; buna görə bal fərqləri statistik əhəmiyyətlilik kimi genişləndirilməməlidir.
Praktik xəta azaltma tövsiyələri
Müəlliflər aşağı keyfiyyətli OCR səhifələrinin confidence-based filtering ilə işarələnməsini, problemli bölgələrin seçici şəkildə yenidən parse edilməsini və maddə ID-si, cədvəl etiketi, şəkil etiketi və versiya tag-ləri üçün rule-based yoxlamadan istifadə edilməsini tövsiyə edirlər.
Daha bahalı vision/OCR əməliyyatlarının bütün səhifələrə tətbiqi əvəzinə aşağı etibarlı bölgələrə yönəldilməsi də xərc baxımından tövsiyə olunur. Etibar hələ də aşağıdırsa sistem page-level və ya region-level retrieval-a geri dönə və provenance-ı qeyri-müəyyən kimi işarələyə bilər.
Tədqiqat nə deyir?
Texniki sənədlərdə RAG uğuru yalnız daha çox mətn fraqmentini retrieval etməklə izah edilə bilməz. Bir maddənin istinad etdiyi cədvəl, bir şəklin caption-ı, prosedur addımlarının ardıcıllığı və ya sənədin düzgün versiyası kimi əlaqələrin qorunması; answer grounding və evidence traceability baxımından mühüm performans artımı təmin edə bilər.
Tədqiqat nə demir?
TechDocRAG-in bütün RAG tapşırıqlarında mütləq ən yaxşı üsul olduğu göstərilməmişdir. Nəticələr ümumi veb QA, sərbəst formalı məlumat axtarışı və ya əlaqəsiz mətn kolleksiyalarına birbaşa ümumiləşdirilə bilməz. Həmçinin sistem qüsursuz OCR və ya parsing problemini həll etmir; əksinə, ağır identifier korlanmasında performansının kəskin şəkildə düşdüyü birbaşa təcrübə ilə göstərilmişdir.
Mənbə və Metod Qeydi
Orijinal tədqiqat: TechDocRAG: Relation-Preserving Retrieval-Augmented Generation (RAG) for Technical Documents
Müəlliflər: Seungjoon Lee; Myungryul Choi.
Məsul müəllif: Myungryul Choi.
Qurumlar: Department of EECI Engineering, Hanyang University; Division of Electrical Engineering, Hanyang University, Seoul, Republic of Korea.
Jurnal: AI.
Nəşriyyat: MDPI.
Biblioqrafik qeyd: AI 2026, 7(5), 161.
DOI: 10.3390/ai7050161
Mənbə növü: Tədqiqat məqaləsi.
Nəşr prosesi: Alınıb 15 Mart 2026; yenidən işlənib 21 Aprel 2026; qəbul edilib 27 Aprel 2026; dərc edilib 6 May 2026.
Lisenziya: Creative Commons Attribution (CC BY).
Maliyyələşdirmə: Tədqiqat xarici maliyyələşdirmə almamışdır.
Məlumatların əlçatanlığı: MPMQA, DesignQA, MMLongBench-Doc və LongDocURL adlı açıq benchmark məlumat dəstlərindən istifadə edilmişdir. Yeni böyükmiqyaslı benchmark yaradılmamışdır. Törəmə annotasiyalar, promptlar və tətbiq detalları ilk müəllifdən tələb oluna bilər.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşması bildirmirlər.
Müəllif töhfələri: Seungjoon Lee konseptuallaşdırma, metodologiya, proqram təminatı, doğrulama, formal analiz, araşdırma, resurslar, məlumatların kurasiyası, ilkin qaralama və vizuallaşdırmanı həyata keçirmişdir. Seungjoon Lee və Myungryul Choi nəzərdən keçirmə və redaktəni paylaşmış; Myungryul Choi superviziya və layihə idarəçiliyinə cavabdeh olmuşdur.
Müqayisə üsulu: Flat retrieval, adaptive/corrective RAG, hierarchical RAG, graph RAG, memory-oriented RAG və multimodal retrieval üsulları müqayisə edilmişdir. Mümkün qədər eyni cavab generatoru və ekvivalent sübut büdcəsi istifadə edilmişdir. CRAG xarici veb çıxışı olmadan corpus-only rejimdə qiymətləndirilmişdir.
Əsas metodoloji məhdudiyyət: Hesabatda benchmark balları ilə bağlı klassik statistik əhəmiyyətlilik testləri, confidence interval və ya run-to-run variasiya bildirilməmişdir. Buna görə performans cədvəlləri tədqiqat protokolu altında müşahidə edilmiş müqayisəli benchmark nəticələri kimi nəzərdən keçirilməlidir.
Verianla məzmun metodu: Bu Azərbaycan dilində mətn mənbə məqalənin cümlə-cümlə tərcüməsi deyil. Problem tərifi, heterogen element qrafı, identifier-summary-raw arxitekturası, riyazi retrieval formulyasiyası, query intent siyasətləri, benchmark quruluşu, evaluation metrikləri, ablasiyalar, resurs xərci, robustness təcrübələri və metodoloji məhdudiyyətlər qorunaraq müstəqil Azərbaycan dilində elmi izah yaradılmışdır. Mənbədə olmayan performans, statistika və ya sistem xüsusiyyəti əlavə edilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib