

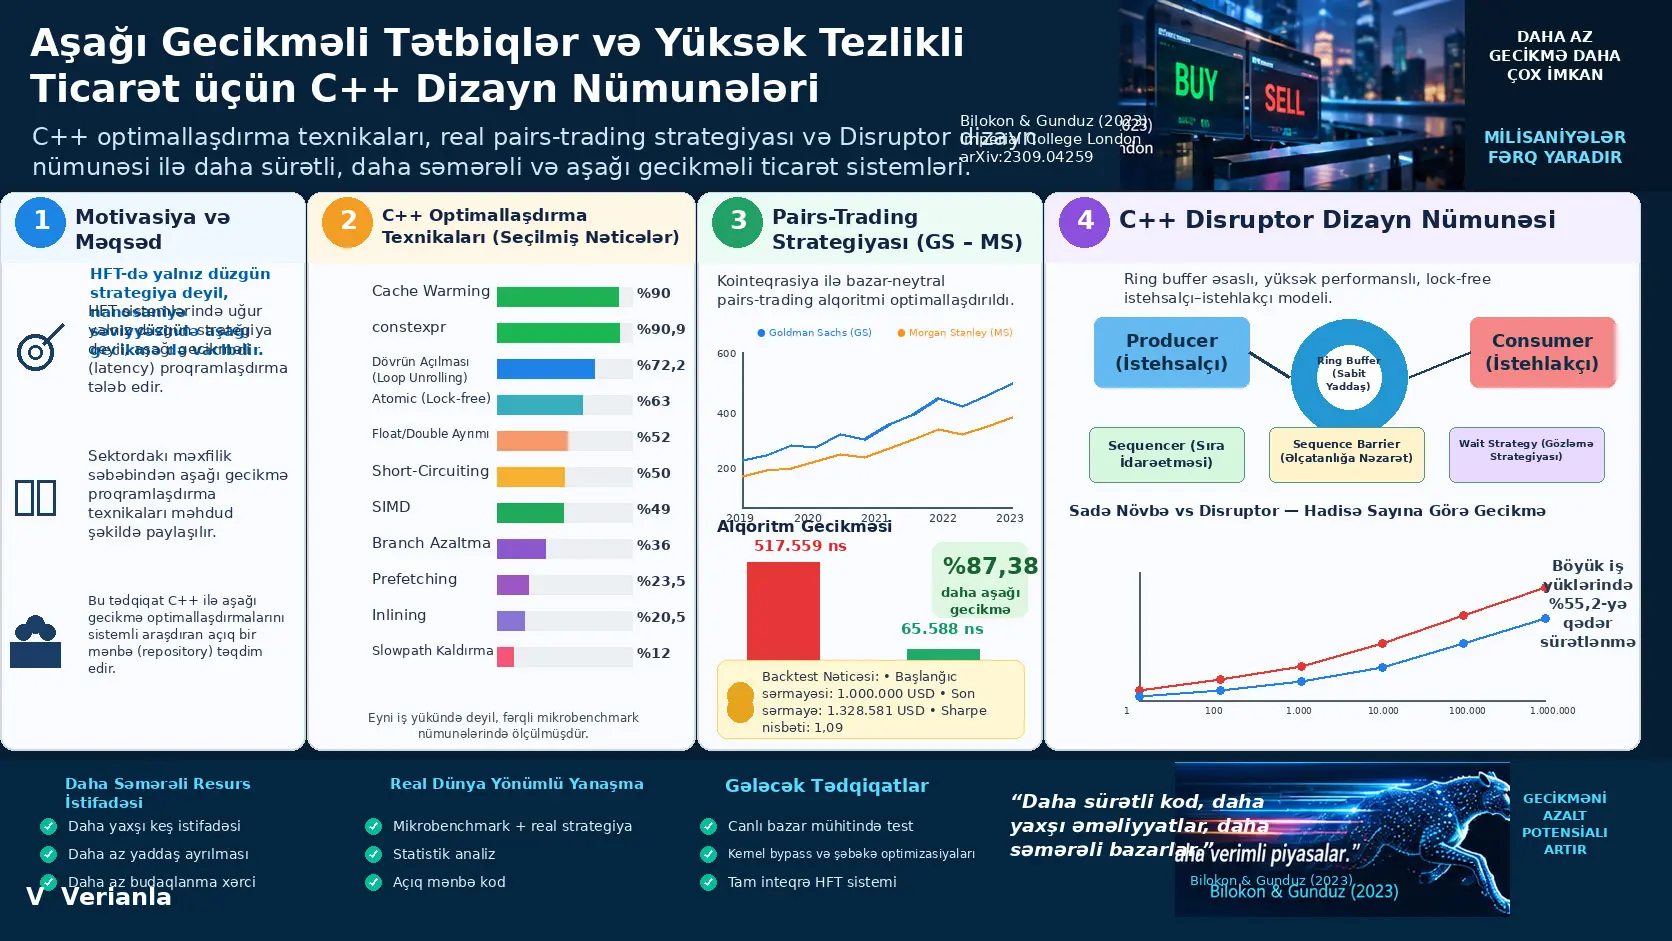
Aşağı gecikməli C++ optimallaşdırması, proqramın yalnız orta icra müddətini deyil, gecikmənin dəyişkənliyini də azaltmaq məqsədilə yaddaşa çıxış, keş istifadəsi, kompilyasiya vaxtı hesablamaları, budaqlanma, verilənlərin yerləşdirilməsi, paralel icra və thread-lərarası kommunikasiya kimi CPU səviyyəli xərcləri sistemli şəkildə tənzimləyən performans mühəndisliyi yanaşmasıdır. Paul Bilokon və Burak Gunduzun işi bu yanaşmanı üç qatda araşdırır: çoxsaylı C++ optimallaşdırma texnikalarını ayrı-ayrılıqda benchmark edən Low-Latency Programming Repository, bu texnikaların tətbiq edildiyi bazar-neytral pairs-trading backtest alqoritmi və producer–consumer kommunikasiyası üçün C++ ilə həyata keçirilmiş LMAX Disruptor strukturu.
Mənbədə izolyasiya edilmiş mikrobenchmarklarda ən yüksək bildirilən sürət artımları cache warming və constexpr üçün təxminən %90, loop unrolling üçün %72,24, atomic əsaslı lock-free sayğac üçün təxminən %63, float/double tiplərinin qarışdırılmamasının sınaqdan keçirildiyi nümunədə mənbə müəlliflərinin ifadəsi ilə təxminən %52, short-circuiting üçün təxminən %50 və SIMD massiv toplaması üçün təxminən %49-dur. Bunun əvəzində inlining %20,5, prefetching %23,5, compile-time dispatch təxminən %26, branch reduction %36, slowpath removal %12 və müvafiq signed/unsigned müqayisəsi təxminən %12,15 yaxşılaşma göstərmişdir. Bu faizlər bir-birindən fərqli mikrobenchmarklara aiddir; onlar bir tətbiqdə toplanaraq ümumi sürətlənmə faizi kimi şərh edilə bilməz.
Pairs-trading tətbiqində SIMD/AVX2, loop unrolling, sabit ölçülü massiv istifadəsi və inlining birləşdirildikdə, 10 benchmark qaçışına əsaslanan qiymətləndirmədə orta gecikmə təxminən 517.559 ns-dən 65.588 ns-yə düşmüş və mənbə bunu %87,38 gecikmə yaxşılaşması kimi bildirmişdir. Standart sapma da 4.233 ns-dən 400 ns-yə enmişdir. Lakin bu test tarixi verilənlərlə işləyən backtest kodu üzərindədir; canlı bazar məlumat axını, network latency, birja bağlantısı və real Order Management System davranışı bu nəticəyə daxil deyil.
İşin üçüncü qatında C++ Disruptor mutex və condition variable istifadə edən standart queue ilə müqayisə edilmişdir. Event sayı artdıqca Disruptor-un ölçülmüş üstünlüyü ümumilikdə böyümüş; mənbə Cədvəl 4-də 10 event üçün %11,9, 1.000 event üçün %48,8, 10.000 event üçün %55,2 və 1.000.000 event üçün %38,7 sürətlənmə bildirmişdir. Ayrı bir 20-qaçışlı 1.000-event təcrübəsində Simple Queue üçün 931.255 ns, Disruptor üçün 74.908 ns orta gecikmə verilmiş və fərqin t-statistikası 22,596, p-dəyəri isə \(1.243\times10^{-23}\) kimi bildirilmişdir. Mütləq müddətlər əvvəlki benchmark seriyasından fərqli olduğuna görə bu iki verilənlər dəsti eyni ölçmə sırası kimi birləşdirilməməlidir.
Tədqiqat hansı problemi həll etməyə çalışır?
Yüksək tezlikli ticarət sistemlərində proqram təminatının yalnız düzgün qərar verməsi kifayət deyil; qərarın hansı gecikmə ilə verildiyi və bu gecikmənin qaçışdan qaçışa nə qədər dəyişdiyi də kritik olur. Buna görə tədqiqat C++ kodunda kiçik görünən optimallaşdırmaların CPU səviyyəsində real ölçmələrlə sınaqdan keçirilməsinə fokuslanır.
Müəlliflərin əsas motivasiyası HFT sənayesində aşağı gecikmə mühəndisliyinin mühüm hissəsinin rəqabət və məxfilik səbəbindən açıq akademik ədəbiyyatda ətraflı şəkildə olmamasıdır. Bu boşluğu azaltmaq üçün yaradılmış Low-Latency Programming Repository texnikaları sadəcə adlandıran siyahı deyil, benchmark kodu və ölçmələri olan tətbiqi arxiv kimi hazırlanmışdır.
Cache Warming Aşağı Gecikməli C++-da Niyə Vacibdir?
Cache warming, performans baxımından kritik verilənlərin və ya təlimatların həqiqətən lazım olmamışdan əvvəl CPU keşinə daxil edilərək hazır saxlanmasıdır. HFT-dəki “hot path” nadir işləsə belə işə düşəndə çox sürətli olmalı olduğuna görə, tədqiqat icra mühərrikinin əlaqəli verilən və kodunun əvvəlcədən işlədilməsi və ya oxunması ilə cache daxilində saxlanmasının yaddaşa çıxış gecikməsini azalda biləcəyini göstərir.
Mənbə iki fərqli Google Benchmark ssenarisi yaratmışdır. BM_CacheCold böyük verilənlər dəstinə təsadüfi çıxış edərək zəif spatial locality yaradır, BM_CacheWarm isə verilənlərə əvvəlcədən və benchmark zamanı ardıcıl şəkildə çıxış edir.
| Metrik | BM_CacheCold | BM_CacheWarm |
|---|---|---|
| Müddət | 267.685.006 ns | 25.635.035 ns |
| Instruction | 4.931.929.489 | 12.013.354.366 |
| Cache reference | 146.264.562 | 61.306.992 |
| Cache miss / cache reference | %73,964 | %71,559 |
Müəlliflər müddət fərqini təxminən %90 sürət yaxşılaşması kimi şərh edirlər. Maraqlıdır ki, cache-miss nisbəti %73,964-dən yalnız %71,559-a düşsə də ümumi cache reference sayı əhəmiyyətli dərəcədə azalmışdır. Bu nəticə cache optimallaşdırmasının yalnız “miss faizinə” baxmaqla şərh edilə bilməyəcəyini göstərir; çıxış nümunəsi, ümumi memory traffic və eyni müddət ərzində görülən işin miqdarı da vacibdir.
Compile-time dispatch
Runtime dispatch işləyəcək funksiyanın proqram icra olunarkən seçilməsinə əsaslanır, compile-time dispatch isə bu qərarı kompilyasiya mərhələsində verir. Mənbə benchmarkında iki runtime-dispatch nümunəsi 2,60 ns və 2,15 ns ölçüldüyü halda, compile-time qarşılıqları hər iki halda 1,92 ns olmuşdur. Tədqiqatın ümumi qiymətləndirməsi bu texnikaya təxminən %26 sürət yaxşılaşması aid edir.
Constexpr
constexpr, uyğun ifadələrin runtime əvəzinə kompilyasiya zamanı qiymətləndirilməsinə imkan verir. Tədqiqatda faktorial 10 hesabının constexpr versiyası təxminən 0,245 ns, runtime recursive versiyası isə 2,69 ns ölçülmüş və mənbə təxminən %90,88 sürət fərqi bildirmişdir.
Müəlliflər bu nəticəni ümumi “constexpr həmişə %90 sürətləndirir” qaydası kimi təqdim etmirlər. Müasir compiler-lər constexpr olmayan kodu da optimallaşdıra bilər. Təcrübədəki fərq bu xüsusi kod və compiler davranışı altında yaranmışdır.
Inlining
Inlining funksiya çağırışı əvəzinə funksiya gövdəsinin çağırış mövqeyinə yerləşdirilməsini hədəfləyir. always_inline istifadə olunan test təxminən 1,90 ns, normal funksiya təxminən 2,39 ns davam etmiş və mənbə təxminən %20,5 yaxşılaşma bildirmişdir. Bununla belə həddən artıq inlining executable ölçüsünü artıra və instruction cache davranışını pisləşdirə bilər.
Loop unrolling
Loop unrolling dövr idarəetməsinin təkrar sayını azaltmaq üçün bir iterasiyada birdən çox əməliyyatı açıq şəkildə yerinə yetirir. Mənbədəki testdə standart dövr 4.539 ns, dörd addımlı unrolled dövr 1.260 ns davam etmiş və %72,24 yaxşılaşma bildirilmişdir.
Bu texnika da limitsiz şəkildə miqyaslanmır. Daha böyük binary, instruction cache təzyiqi və memory-bound iş yükləri qazancı azalda bilər.
Short-circuiting
Short-circuiting Boolean ifadəsinin nəticəsi müəyyənləşən kimi artıq lazım olmayan hesablamaların aparılmamasıdır. Mənbədə 8 ilə 8.192 iterasiya arasındakı müxtəlif testlərdə short-circuit versiya təxminən normal versiyanın yarısı qədər müddətdə işləmiş; yaxşılaşmalar %49,53 ilə %52,83 arasında bildirilmişdir.
Slowpath removal
Slowpath removal xəta emalı, loglama və ya nadir vəziyyət kodlarını davamlı işləyən hot path-dən kənara çıxarır. Mənbədə hot path-in %90, slow path-in %10 işlədiyi benchmarkda birbaşa daxil edilmiş slowpath kodu 28.074 ns, ayrıca HandleError funksiyasına daşınmış versiya 24.755 ns davam etmiş və təxminən %12 yaxşılaşma müşahidə edilmişdir.
Branch reduction
Branch reduction eyni hot path daxilində ardıcıl çoxlu xəta yoxlaması etmək əvəzinə xəta vəziyyətlərini, məsələn, bit maskası içində birləşdirərək branch sayını azaltmağı hədəfləyir. Mənbə təcrübəsində klassik struktur 7,35 ns, azaldılmış branch strukturu 4,68 ns davam etmiş və təxminən %36 yaxşılaşma bildirilmişdir.
Prefetching
__builtin_prefetch istifadə olunan böyük vektor toplama testində prefetch istifadə edilməyən versiya 8.235.924 ns, prefetch istifadə olunan versiya 6.301.400 ns davam etmişdir. Mənbə bunu təxminən %23,5 performans qazancı kimi bildirir. Qazanc verilənlərə çıxışın proqnozlaşdırıla bilməsinə, verilən ölçüsünə və prosessor arxitekturasına bağlıdır.
Signed və unsigned integer müqayisəsi
Mənbənin xüsusi testində signed integer istifadə olunan funksiya 0,282 ns, unsigned versiya 0,321 ns ölçülmüş və signed versiya üçün təxminən %12,15 sürət üstünlüyü hesablanmışdır. Bunun səbəbi nümunədə compiler-in unsigned overflow halını qorumaq üçün əlavə assembly təlimatları yaratmasıdır.
Bu nəticə “signed həmişə unsigned-dan sürətlidir” kimi ümumiləşdirilə bilməz. Mənbənin özü müəyyən dövr və overflow semantikasına malik mikrobenchmark ölçür.
Float və double tiplərinin qarışdırılması
Bir float dəyərini 1.23 kimi standart olaraq double olan literal ilə emal etmək float → double → float çevrilmələri yarada bilər. Mənbədə mixed versiya 21,6 ns, yalnız float istifadə edən 1.23f versiyası 14,2 ns ölçülmüş və müəlliflər unmixed versiyanı təxminən %52 daha sürətli kimi ifadə etmişlər.
SIMD
Single Instruction, Multiple Data (SIMD), bir CPU təlimatı ilə birdən çox verilən elementində paralel əməliyyat aparmağa imkan verir. SSE2 istifadə edən array-addition testində klassik versiya 21.447 ns, SIMD versiyası 10.929 ns davam etmiş; əməliyyat müddətində təxminən %49 azalma bildirilmişdir.
Lock-free proqramlaşdırma
Tədqiqat atomik əməliyyatları mutex əsaslı sinxronizasiya ilə müqayisə etmişdir. 10.000 increment üçün atomic versiya təxminən 65.369 ns, mutex versiyası 175.904 ns davam etmiş və mənbə atomik yanaşma üçün təxminən %63 performans yaxşılaşması bildirmişdir.
Lock-free proqramlaşdırma kilid istifadə etməməsinə baxmayaraq “pulsuz” deyil. Atomics, CAS, memory ordering və cache-coherence xərcləri davam edir; həmçinin düzgün lock-free dizaynın tətbiqi mutex əsaslı koddan daha mürəkkəb ola bilər.
Kernel bypass
Kernel bypass tədqiqat çərçivəsində benchmark edilməmişdir. Texnika şəbəkə paketlərinin kernel networking stack-dən keçirilməsi əvəzinə istifadəçi məkanının NIC ilə daha birbaşa əlaqə qurmasını hədəfləyir. Mənbə OpenOnload, VMA və DPDK kimi texnologiyaları nümunə göstərir, lakin onların performansını tədqiqatın öz təcrübəsi kimi təqdim etmir.
LMAX Disruptor Niyə Ənənəvi Növbədən Fərqlənir?
LMAX Disruptor, producer və consumer-lar arasında əvvəlcədən ayrılmış ring buffer, davamlı artan sequence nömrələri və seçilə bilən wait strategy istifadə edərək verilən ötürülməsini idarə edən aşağı gecikməli mesajlaşma arxitekturasıdır. Ənənəvi mutex/condition-variable queue yanaşmasından əsas fərqi runtime memory allocation və lock contention xərclərini mümkün qədər azaldaraq producer ilə consumer-in ortaq verilənlərə daha proqnozlaşdırılan yaddaş quruluşu üzərindən çıxış etməsini təmin etməsidir.
Ring buffer
Ring buffer sabit ölçülü, dairəvi şəkildə yenidən istifadə olunan verilən strukturudur. Yaddaş başlanğıcda ayrıldığı üçün hər event-də yeni allocation/deallocation aparmaq lazım deyil. Bu həm yaddaş istifadəsini daha proqnozlaşdırılan edir, həm də cache locality baxımından üstünlük verə bilər.
Sequencer
Sequencer hansı ring-buffer slotlarının producer tərəfindən yazıla və consumer tərəfindən oxuna biləcəyini sequence nömrələri ilə izləyir. Producer event-i yazdıqdan sonra müvafiq sequence-i yayımlayır; consumer öz irəliləyiş nöqtəsini sequence üzərindən izləyir.
Sequence Barrier və Wait Strategy
Sequence Barrier consumer-in bir event-in təhlükəsiz şəkildə oxuna biləcəyini müəyyən etməsinə imkan verir. Verilən hələ mövcud deyilsə Wait Strategy işə düşür. Busy-spin ən aşağı latency-ni hədəfləyə bilər, lakin yüksək CPU sərf edir; sleeping daha az CPU istifadə edərkən daha yüksək latency yarada bilər.
Tədqiqat benchmarklarında istifadə olunan wait strategy yield wait-dir. Busy-spin, sleeping və ya digər strategiyalarla sistemli müqayisə aparılmamışdır. Buna görə Disruptor latency dəyərləri bütün mümkün konfiqurasiyalar üçün ümumi nəticə deyil.
Tədqiqatın Metodu və Nəticələri
Birinci təcrübə qatı: Low-Latency Programming Repository
Müəlliflər optimallaşdırmaları compile-time features, optimisation techniques, data handling, concurrency və system programming başlıqları altında toplamışlar. Google Benchmark əsas zamanlama aləti; Linux perf isə xüsusən cache-reference və cache-miss analizi üçün istifadə edilmişdir.
| Texnika | Mənbədə bildirilən təxmini yaxşılaşma | Əsas mexanizm |
|---|---|---|
| Cache warming | %90 | Verilən/təlimatı əvvəlcədən cache-ə gətirmək |
| Constexpr | %90,88 | Hesabı runtime-dan compile-time-a daşımaq |
| Loop unrolling | %72,24 | Dövr idarəetmə yükünü azaltmaq |
| Atomic / lock-free sayğac | %63 | Mutex və context-switch xərcini azaltmaq |
| Float/double qarışdırmamaq | Mənbə ifadəsi ilə %52 | Implicit conversion-ları aradan qaldırmaq |
| Short-circuiting | Təxminən %50 | Lazımsız Boolean hesablamalarını işlətməmək |
| SIMD array addition | Təxminən %49 | Bir təlimatla birdən çox verilən elementi işləmək |
| Branch reduction | %36 | Hot path daxilində branch sayını azaltmaq |
| Compile-time dispatch | Təxminən %26 | Runtime dispatch qərarını aradan qaldırmaq |
| Prefetching | %23,5 | Veriləni istifadə olunmadan əvvəl cache-ə istəmək |
| Inlining | %20,5 | Funksiya çağırış yükünü azaltmaq |
| Signed vs unsigned nümunəsi | %12,15 | Xüsusi benchmarkda daha az assembly təlimatı |
| Slowpath removal | %12 | Nadir kodu instruction hot path-dən ayırmaq |
Bu cədvəl “ən yaxşı optimallaşdırma hansıdır?” sıralaması kimi şərh edilməməlidir. Hər sətir fərqli əməliyyat, verilən ölçüsü, compiler davranışı və benchmark quruluşuna malikdir. Məsələn, 90% cache-warming nəticəsi böyük memory-access benchmarkından, 90,88% constexpr nəticəsi isə faktorial 10 nümunəsindən gəlir.
İkinci təcrübə qatı: pairs trading
Tədqiqat optimallaşdırmaları daha real tətbiqdə görmək üçün Goldman Sachs Group Inc. (GS) və Morgan Stanley (MS) səhmlərinin beş illik gündəlik adjusted-close verilənləri üzərində statistical-arbitrage pairs-trading backtestindən istifadə etmişdir.
Cointegration Pairs Trading Strategiyasında Nə Deməkdir?
Cointegration, ayrı-ayrılıqda non-stationary olan iki zaman sırasının müəyyən xətti kombinasiyasının stationary olması halıdır. Bu tədqiqatda GS və MS adjusted-close sıralarının Engle–Granger iki mərhələli üsulla sınaqdan keçirilməsi, qiymət sıraları arasında araşdırılan beş illik dövrdə uzunmüddətli tarazlıq əlaqəsi olduğuna dair statistik sübut yaratmaq üçün istifadə edilmişdir.
Mənbənin konseptual təqdimatında iki sıra:
şəklində götürülür. Əgər:
kombinasiyası stationary olarsa, \(Y_t\) və \(X_t\) cointegrated kimi qiymətləndirilir. Buradakı \(\gamma\), iki sıra arasındakı uzunmüddətli xətti əlaqəni təmsil edir.
GS–MS üçün Engle–Granger testində mənbə p≈0,0149 və t≈−3,7684 bildirir. \(0,05\) significance səviyyəsində no-cointegration null hipotezi rədd edilmişdir. Bu nəticə cointegration üçün statistik sübut verir; əlaqənin gələcəkdə dəyişməyəcəyini və ya trading strategiyasının zəmanətli gəlirli olacağını sübut etmir.
Z-score ilə siqnal yaradılması
Alqoritm spread-in rolling mean və standard deviation dəyərlərindən istifadə edərək cari spread-i standartlaşdırır:
Burada \(Z\) z-score, \(X\) cari spread, \(\mu\) rolling spread ortalaması və \(\sigma\) rolling spread standard deviation dəyəridir.
Mənbə strategiyasında:
- \(Z>1.0\): GS nisbi olaraq bahalı qəbul edilir; GS short, MS long siqnalı yaradılır.
- \(Z<-1.0\): GS nisbi olaraq ucuz qəbul edilir; GS long, MS short siqnalı yaradılır.
- \(|Z|<0.8\): spread-in ortalamaya qayıtdığı fərziyyəsi ilə açıq mövqe bağlanır.
- Digər bölgələrdə yeni ticarət siqnalı yaradılmır.
Backtest maliyyə nəticəsi
Mənbə backtestində portfel 1.000.000 ABŞ dolları ilə başlayır və 1.328.581 ABŞ dolları ilə başa çatır. Bildirilən Sharpe ratio 1,09-dur.
\(R_p\) portfel gəliri, \(R_f\) risksiz gəlir və \(\sigma_p\) portfel excess-return standard deviation dəyəridir.
Tədqiqatın öz ifadəsinə görə trading alqoritminin maliyyə uğurunun hərtərəfli qiymətləndirilməsi araşdırmanın əsas məqsədi deyil. Bu nəticə tarixi verilən backtestinə aiddir və transaction cost, real execution quality, order-book dynamics, slippage, network delay və canlı bazar anomaliyalarının hamısını təmsil etmir.
Pairs-trading alqoritmində CPU optimallaşdırmaları
Alqoritmin rolling spread mean və standard-deviation hesablanmasında AVX2 istifadə edilmişdir. 256-bit __m256d register daxilində dörd double eyni anda işlənərək spread cəmi və kvadratlar cəmi paralel hesablanmışdır. Bu quruluş eyni zamanda dörd elementlik addımlarla loop unrolling həyata keçirir.
Mənbənin bu tətbiq üçün qeyd etdiyi mühüm məhdudiyyət window size-ın dördün misli olması tələbinin olmasıdır. Bu, istifadə olunan AVX2 dizaynından qaynaqlanır.
İkinci mühüm dəyişiklik dynamic container əvəzinə sabit ölçülü array və rolling index istifadə edilməsidir. Yeni spread gəldikdə ən köhnə element eyni array daxilindəki mövqedə dəyişdirilir; beləliklə təkrarlanan dynamic memory allocation ehtiyacı azaldılır.
Mean və standard-deviation hesablama funksiyalarına inlining də tətbiq edilmişdir.
| Struktur | Latency | Mənbədə bildirilən yaxşılaşma |
|---|---|---|
| Inlining | 406.709 ns | %21,41 |
| SIMD + loop unrolling | 355.618 ns | %31,28 |
| Fixed array | 266.146 ns | %48,58 |
| Combined | 65.580 ns | %87,33 |
Daha sonrakı 10-qaçışlı evaluation bölməsində mənbə optimallaşdırılmamış alqoritm üçün orta 517.559 ns və standard deviation 4.233 ns; optimallaşdırılmış alqoritm üçün orta 65.588 ns və standard deviation 400 ns verir. Buna görə bildirilən latency azalması %87,38-dir.
Əvvəlki metod bölməsində baseline üçün 519.772 ns ifadəsi də mövcuddur. Mənbə iki baseline rəqəmi arasındakı kiçik fərqi açıq şəkildə izah etmədiyinə görə dəyərlər bir rəqəmə məcburi birləşdirilməmişdir.
Instruction sayı və cache-miss davranışı
| Texnika | Instruction | Cache misses / cache references |
|---|---|---|
| Optimallaşdırmasız | 6,01 milyard | %16,001 |
| Combined | 3,27 milyard | %33,879 |
| Fixed array | 8,27 milyard | %19,089 |
| Inlining | 9,07 milyard | %19,151 |
| SIMD + loop unrolling | 8,35 milyard | %16,829 |
Bu cədvəl mühüm nəticəni görünən edir: daha aşağı cache-miss faizi və ya daha az instruction sayı təkbaşına daha sürətli proqram demək deyil. Combined versiya ən yüksək cache-miss faizinə malik olsa da ən aşağı latency-ni yaratmışdır. CPU performansı instruction-level parallelism, memory layout, branch behavior, compiler optimallaşdırmaları və verilən çıxışı nümunəsinin birlikdə yaratdığı nəticədir.
Statistik test
Pairs-trading benchmarklarında hər struktur 10 dəfə işlədilmiş və optimallaşdırılmış/optimallaşdırılmamış latency ölçmələrinə paired t-test tətbiq edilmişdir. Mənbə çox böyük t-statistikaları və çox kiçik p-dəyərləri bildirir və ölçülmüş latency fərqinin yalnız təsadüfi variasiya ilə izah edilməsinin aşağı ehtimallı olduğunu qeyd edir.
Bununla belə mənbə yalnız 10 verilən nöqtəsindən istifadənin məhdudiyyət olduğunu açıq şəkildə qəbul edir və daha çox ölçmənin dəqiqliyi artıracağını bildirir.
Gəlirlilik şərhi hansı həddə qalmalıdır?
Mənbə daha aşağı latency-nin qısaömürlü bazar imkanlarına daha erkən reaksiya vermək potensialına görə maliyyə baxımından faydalı ola biləcəyini ədəbiyyatla əlaqələndirir. Həmçinin başqa bir tədqiqatda bildirilmiş latency ilə mənfi order-book dəyişikliyinə məruz qalma əlaqəsindən istifadə edərək %87,32 sürət artımını təxminən %78,59 daha aşağı exposure ilə uyğunlaşdıran hesablama aparır.
Bu %78,59 dəyəri tədqiqatın canlı bazarda birbaşa ölçdüyü nəticə deyil. Başqa tədqiqatdakı reqressiya əlaqəsi ilə bu tədqiqatın backtest latency qazancının xətti şəkildə birləşdirildiyi mənbə-törəməli proyeksiyadır. Real HFT sistemində eyni exposure azalmasının yarandığı göstərilməmişdir.
Üçüncü təcrübə qatı: C++ Disruptor
C++ Disruptor implementasiyası producer, ring buffer, sequencer, event processor, sequence barrier, event və wait strategy komponentlərindən yaradılmışdır. HFT kontekstində event order obyekti ola bilər; mənbə benchmarkında sadə string event istifadə edilmişdir.
Müqayisə modeli iki thread-dən ibarətdir. Disruptor versiyasında producer veriləni ring buffer-a yayımlayır və consumer ayrıca thread-də sequence nömrələrinə görə emal edir. Simple Queue versiyasında isə std::queue<std::string>, std::mutex və std::condition_variable istifadə olunur.
| Event | Simple Queue | Disruptor | Mənbədə bildirilən sürətlənmə |
|---|---|---|---|
| 10 | 20.646 ns | 18.182 ns | %11,9 |
| 100 | 99.458 ns | 64.686 ns | %35,0 |
| 1.000 | 881.092 ns | 451.251 ns | %48,8 |
| 10.000 | 9.735.102 ns | 4.361.096 ns | %55,2 |
| 100.000 | 90.088.609 ns | 52.562.872 ns | %41,7 |
| 1.000.000 | 884.871.405 ns | 543.171.556 ns | %38,7 |
Mənbə event sayı böyüdükcə iki struktur arasındakı mütləq zaman fərqinin artdığını bildirir. 10 event-də orta fərq 2.464 ns, 1.000.000 event-də 341.699.849 ns kimi bildirilmişdir.
Disruptor-un cache davranışı
10 və 100 event kimi kiçik iş yüklərində Disruptor-un cache-miss nisbəti Simple Queue-dan bir qədər yüksək olmuşdur. 1.000–1.000.000 event aralığında isə əlaqə tərsinə dönmüş və Disruptor daha aşağı cache-miss nisbətləri göstərmişdir. Bu hal ring buffer-ın böyük event axınlarında daha səmərəli memory-access davranışı təmin edə bildiyinə işarə edir.
10-event testində Disruptor təxminən 586.000 daha az instruction işləmişdir. Mənbə bunu lock contention-ın azaldılması, əvvəlcədən ayrılmış ring-buffer yaddaşı və daha proqnozlaşdırılan producer–consumer kommunikasiyası ilə əlaqələndirir.
Disruptor-un Statistik Performans Testi Nə Göstərir?
Mənbənin ayrıca 20-qaçışlı və 1.000-event testində Simple Queue üçün orta latency 931.255 ns, standard deviation 453.766 ns; Disruptor üçün orta latency 74.908 ns və standard deviation 53.600 ns ölçülmüşdür. T-test nəticəsi \(t=22.596\) və \(p=1.243\times10^{-23}\) kimi bildirildiyinə görə bu təcrübə dəsti daxilində iki strukturun ölçülmüş orta latency fərqi statistik baxımdan güclüdür.
Bu nəticə Cədvəl 4-dəki 1.000-event dəyərlərindən fərqli mütləq müddətlər ehtiva edir. Mənbə bunları fərqli benchmark qiymətləndirmələri kimi verir, lakin fərqin konfiqurasiya və ya ölçmə mənbəyini ətraflı izah etmir. Buna görə 451.251 ns ilə 74.908 ns tək bir “doğru” Disruptor latency dəyərinə endirilməməlidir.
Disruptor qiymətləndirməsinin məhdudiyyətləri
Benchmark əsasən inter-thread communication sürətinə fokuslanmışdır. Memory consumption və CPU load hərtərəfli müqayisə edilməmişdir. Həmçinin yalnız yield wait strategy istifadə olunmuş; busy-spin, sleep və digər wait strategy-lər sistemli şəkildə sınaqdan keçirilməmişdir. Buna görə ölçülmüş nəticələr Disruptor-un bütün konfiqurasiyalarını təmsil etmir.
Low-Latency Repository istifadəçi qiymətləndirməsi
Repository dörd universitetdən ümumilikdə 17 iştirakçı tərəfindən araşdırılmışdır: Imperial College London, University College London, King's College London və University of Oxford. İştirakçıların 11-i kompüter elmləri; altısı riyaziyyat, fizika və ya mühəndislik sahələrindəndir.
| Kateqoriya | Orta | Ən aşağı | Ən yüksək |
|---|---|---|---|
| Comprehensiveness | 8,3 | 6,5 | 9,1 |
| Clarity | 8,7 | 7,8 | 8,9 |
Bu qiymətləndirmə proqram təminatı performansının sübutu deyil, repository-nin təhsil baxımından istifadəliliyinə dair kiçik istifadəçi nümunəsidir.
Tədqiqatın dəstəklədiyi nəticələr
Mənbə araşdırılan benchmark mühitlərində C++ səviyyəli verilənlərin yerləşdirilməsi, cache istifadəsi, compile-time hesablama, branch azaltma, SIMD, atomics və allocation strategiyalarının latency üzərində ölçülə bilən təsirlər yarada bildiyini göstərir. Birdən çox optimallaşdırmanın birlikdə istifadə edildiyi pairs-trading benchmarkı, ayrı-ayrı optimallaşdırmalardan daha böyük ümumi latency azalması yaratmışdır. C++ Disruptor implementasiyası isə sınaqdan keçirilən producer–consumer iş yüklərində mutex/condition-variable queue-dan daha sürətli ölçülmüşdür.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr
Tədqiqat benchmarkdakı faiz qazancının başqa CPU, compiler, əməliyyat sistemi və ya verilən strukturunda eynilə təkrarlanacağını göstərmir. Cache warming-in hər iş yükündə %90, constexpr-in hər hesablamada %90 və ya SIMD-in hər alqoritmdə %49 sürət verəcəyi nəticəsi çıxarıla bilməz. Eyni şəkildə backtest latency azalması canlı trading gəlirliliyinə birbaşa bərabərləşdirilə bilməz və Disruptor benchmarkı tam real OMS-in ucdan-uca latency-sini ölçmür.
Gələcək iş təklifləri
Mənbə üç əsas istiqamət təklif edir. Birincisi repository-nin variadic templates, kernel bypass və networking optimallaşdırmaları kimi yeni texnikalarla genişləndirilməsidir. İkincisi pairs-trading alqoritminin canlı market-data feed üzərində sınaqdan keçirilməsidir. Üçüncüsü isə Disruptor ilə trading alqoritminin birləşdirilərək order obyektlərinin ring buffer üzərindən ötürüldüyü daha əhatəli trading-system benchmarkının yaradılmasıdır.
Mənbə və Metod Qeydi
Tam orijinal başlıq: C++ design patterns for low-latency applications including high-frequency trading
Müəlliflər: Paul Bilokon; Burak Gunduz.
Affiliasiyalar: Paul Bilokon — Departments of Computing and Mathematics, Imperial College London; Burak Gunduz — Department of Computing, Imperial College London.
Mənbə növü: Preprint.
Manuscript üzərində yazılan tarix: 11 sentyabr 2023.
arXiv ilk versiya tarixi: 8 sentyabr 2023.
arXiv: 2309.04259v1 [cs.PF].
DOI: 10.48550/arXiv.2309.04259.
Platforma: arXiv / CoRR.
Resenziya statusu: Təsdiqlənmiş biblioqrafik qeydlərdə iş preprint / informal publication kimi görünür; resenziyalı jurnal versiyası təsdiqlənməyib.
Proqram artefaktı: Mənbə Low-Latency Programming Repository, pairs-trading kodu və Disruptor implementasiyasını 0burak/imperial_hft deposunda təqdim etdiyini bildirir.
Lisenziya: Yüklənmiş PDF daxilində açıq məzmun lisenziyası aşkar edilmədiyindən konkret Creative Commons və ya oxşar lisenziya təyin edilməmişdir.
Maliyyələşdirmə: Yüklənmiş preprintdə ayrıca maliyyələşdirmə bəyanatı aşkar edilməmişdir.
Maraqların toqquşması: Yüklənmiş preprintdə ayrıca maraqların toqquşması bəyanatı aşkar edilməmişdir.
CRediT / müəllif töhfələri: Ayrıca CRediT bəyanatı bildirilməyib.
Əsas metod alətləri: Google Benchmark ilə zaman ölçməsi; Linux perf ilə cache davranışı; C++ aşağı gecikmə mikrobenchmarkları; GS–MS adjusted-close verilənləri ilə Engle–Granger cointegration testi və pairs-trading backtesti; AVX2/SIMD optimallaşdırması; C++ ring-buffer/Disruptor müqayisəsi; paired t-test.
Əsas məhdudiyyətlər: Benchmarkların mühüm hissəsi CPU və proqram səviyyəsindədir. Tam istehsal HFT şəbəkəsi, co-location, exchange order flow, hardware timestamping və canlı market-data şərtləri birlikdə ölçülməmişdir. Pairs-trading alqoritmi tarixi verilən backtestidir. AVX2 optimallaşdırması dəstəkləyən hardware-a və tədqiqatdakı implementasiyada dördün misli window size-a ehtiyac duyur. Disruptor təcrübəsində memory consumption və CPU load hərtərəfli qiymətləndirilməmiş; alternativ wait strategy-lər müqayisə edilməmişdir.
Mənbədaxili rəqəm bütövlüyü qeydi: Pairs-trading baseline müddəti metod bölməsində 519.772 ns, sonrakı evaluation bölməsində 517.559,10 ns kimi keçir. Həmçinin 1.000-event Disruptor dəyərləri Cədvəl 4 və sonrakı 20-qaçışlı statistik test arasında fərqlidir. Verianla bu dəyərlərdən birini səssizcə düzəltməmiş və ya digərinin yerinə qoymamışdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib