

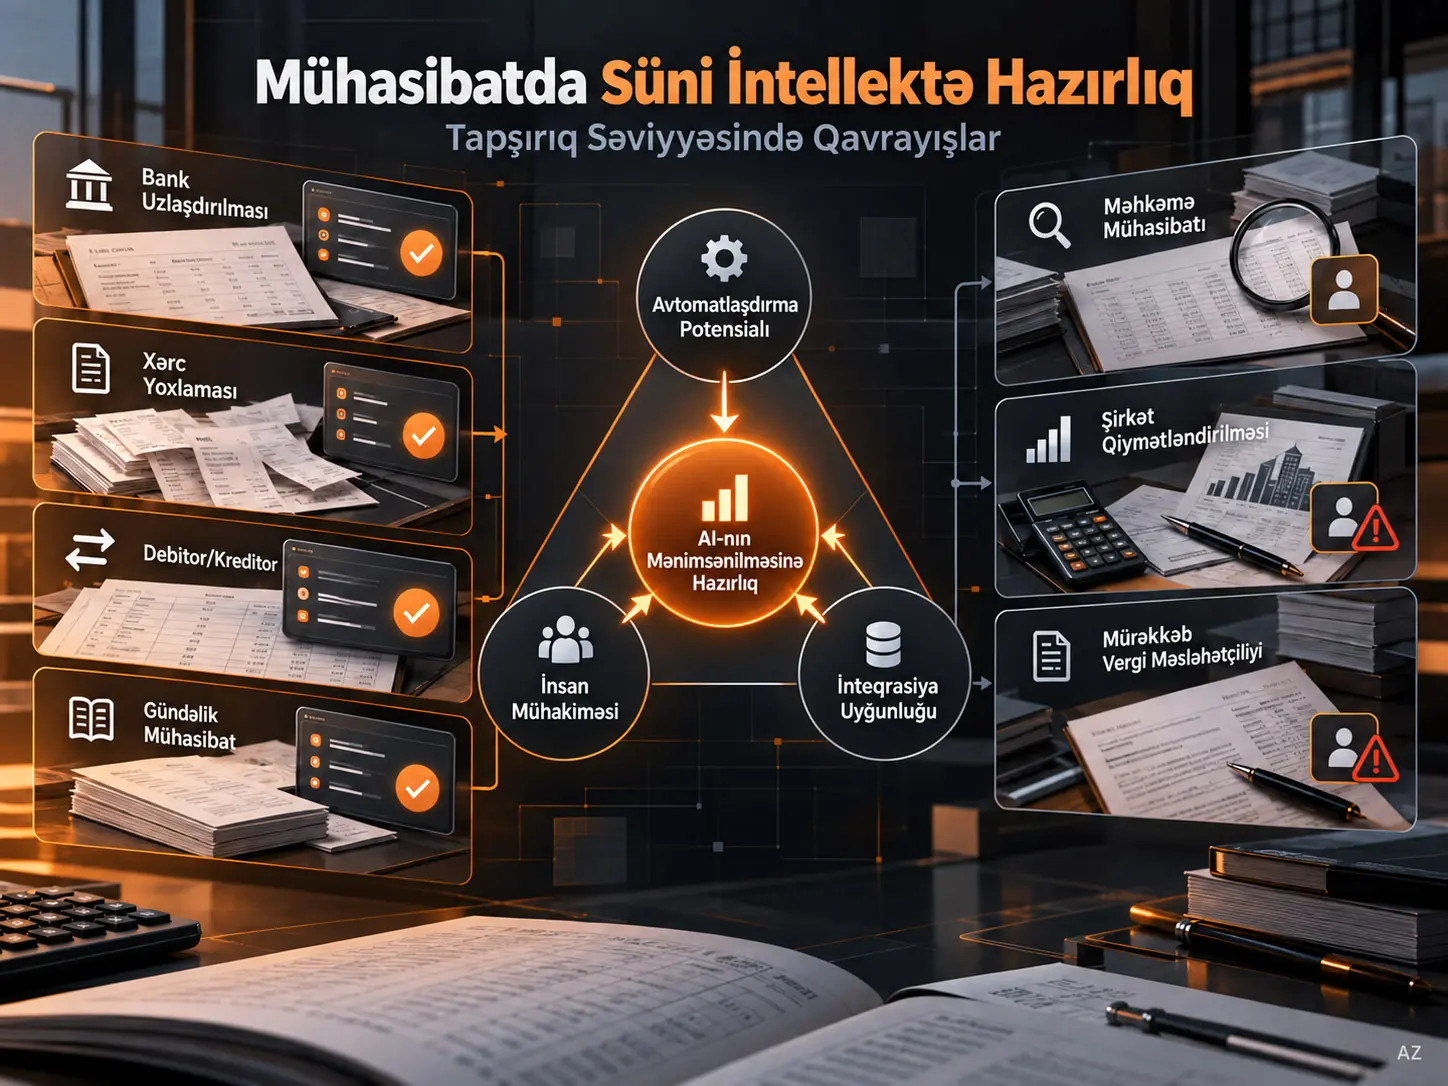
Tapşırıq səviyyəsində süni intellektin mənimsənilməsinə hazırlıq (Adoption Readiness, AR), mühasibat mütəxəssisinin müəyyən işi yerinə yetirərkən AI dəstəyi mövcud olsaydı, bu dəstəkdən istifadə etməyə nə dərəcədə istəkli olacağını ifadə edən 1–5 ballıq davranış niyyəti ölçüsüdür. Wil Martensin tədqiqatı Tayvandakı 24 mühasibat mütəxəssisinin 24 təmsilçi mühasibat tapşırığını qiymətləndirməsi nəticəsində yaranan 576 tapşırıq səviyyəli müşahidə əsasında bu hazırlığın hansı tapşırıq xüsusiyyətləri ilə əlaqəli olduğunu araşdırır. Əsas ordered logistic regression nəticələrində avtomatlaşdırma potensialı və mövcud iş axınına inteqrasiya asanlığı daha yüksək AI istifadəsinə hazırlıqla müsbət əlaqəli olduğu halda, GPT sistemləri ilə daha çox əvvəlki təmas daha aşağı hazırlıqla əlaqəlidir. İnsan mühakiməsinə tələbatın əmsalı mənfi istiqamətdədir, lakin mənbə mətndə p = 0,160 kimi bildirildiyinə görə statistik baxımdan qəti əlaqə deyil.
Tədqiqatın əsas təklifi ondan ibarətdir ki, mühasibatda AI-nın mənimsənilməsi yalnız texnologiyanın nə qədər güclü və ya səmərəli olması ilə izah edilə bilməz. Tapşırığın audit edilə bilməsi, nəticənin mənbəyinin izlənə bilməsi, reviewer sign-off mexanizminin mövcudluğu və AI nəticəsinin mövcud nəzarət prosesinə müdafiə oluna bilən şəkildə yerləşdirilməsi də mənimsəməyə hazırlıqla əlaqəlidir. Müəllif bu quruluşu task-governance fit, yəni tapşırıqla idarəetmə infrastrukturunun uyğunluğu çərçivəsində müzakirə edir.
Lakin tədqiqat faktiki AI istifadəsini, xəta dərəcəsini, xərc qənaətini və ya iş performansını ölçmür. İştirakçılar kiçik, məqsədli seçilmiş expert paneldir və nəticə dəyişəni faktiki istifadə davranışı deyil, bildirilmiş istifadə istəyidir. Buna görə nəticələr nəzəriyyə inkişaf etdirən və hipotez yaradan əlaqələr kimi şərh edilməli, ümumi mühasiblər əhalisi üçün qəti və ya səbəb-nəticə nəticələri kimi görülməməlidir.
Tədqiqatın əsas problemi
Süni intellekt sistemlərinin mühasibat işlərində texniki cəhətdən istifadə edilə bilməsi mühasiblərin bu sistemlərə eyni dərəcədə etibar edəcəyi demək deyil. Bank uzlaşdırılması, xərc yoxlaması və ya debitor-kreditor hesablarının işlənməsi kimi rutin tapşırıqlarla məhkəmə mühasibatı, şirkət qiymətləndirilməsi və ya mürəkkəb audit qiymətləndirmələri eyni peşə məsuliyyəti səviyyəsinə malik deyil.
Bu səbəbdən tədqiqat analiz vahidini “istifadəçi”dən “tapşırıq”a keçirir. Peşəkarın AI-ya ümumən müsbət və ya mənfi münasibətini ölçmək əvəzinə bu suala yönəlir: Eyni peşəkar müxtəlif mühasibat tapşırıqlarında AI istifadəsinə niyə fərqli dərəcədə hazır ola bilər?
Technology Acceptance Model (TAM), Unified Theory of Acceptance and Use of Technology (UTAUT) və Diffusion of Innovation kimi formalaşmış yanaşmalar adətən istifadə asanlığına, faydaya, sosial təsirə və ya fərdi texnoloji hazırlığa diqqət yetirir. Tədqiqatın ədəbiyyat boşluğu iddiası budur ki, bu modellər yüksək hesabatlılıq tələb edən peşələrdə tapşırığa xas audit edilə bilmə, izlənə bilmə və reviewer approval strukturlarını kifayət qədər əhatə etmir.
Tapşırıq–idarəetmə uyğunluğu nədir?
Tapşırıq–idarəetmə uyğunluğu AI sisteminin müəyyən peşə tapşırığına yalnız texniki olaraq tətbiq edilə bilməsini deyil, həm də nəticəsinin izlənə, yoxlana və mövcud təsdiq/nəzərdən keçirmə prosesləri daxilində peşəkar baxımdan müdafiə edilə bilməsini ifadə edir. Bu tədqiqatda xüsusilə Integration Feasibility dəyişəni audit trail, traceability, reviewer sign-off və approval workflow kimi mövcud nəzarət mexanizmlərinin AI istifadəsini nə dərəcədə dəstəklədiyini təmsil edir.
Bu fərq vacibdir. Texniki baxımdan asan AI tətbiqi, nəticəni kimin yoxlayacağı və ya xətaya görə kimin məsul olacağı qeyri-müəyyəndirsə, aşağı inteqrasiya tətbiqolunmasına malik ola bilər. Əksinə, məhkəmə mühasibatı kimi məzmunca mürəkkəb tapşırıq güclü audit trail və nəzərdən keçirmə mexanizmləri sayəsində AI-nın köməkçi rolunu daha nəzarətli şəkildə yerləşdirə bilər.
Beş əsas qavrayış dəyişəni
| Dəyişən | Azərbaycanca izah | Ölçmə | Modeldəki rolu |
|---|---|---|---|
| GPT Exposure | GPT sinifli alətlərlə əvvəlki peşə tanışlığı | 1–5 Likert | Nəzarət dəyişəni |
| Automation Potential (AP) | Tapşırıq komponentlərinin AI tərəfindən əvəz edilə bilməsi | %0–100, analizdə beş qrupa çevrilib | Əsas izahlı dəyişən |
| Human Judgment Necessity (HJ) | Diskresiya, etik şərh və peşəkar mühakimə tələbi | 1–5 Likert | Əsas izahlı dəyişən |
| Task Complexity (TC) | Tapşırığın bilik sahəsinin genişliyi və kontekstual mürəkkəbliyi | 1–10, analizdə 1–5-ə miqyaslandırılıb | Kontekstual dəyişən |
| Integration Feasibility (IC) | AI-nın mövcud nəzərdən keçirmə və nəzarət prosesinə yerləşdirilə bilməsi | 1–5 inteqrasiya xərci; əks kodlanıb | Əsas izahlı dəyişən |
| Adoption Readiness (AR) | Müəyyən tapşırıqda AI yardımından istifadə istəyi | 1–5 ordinal şkala | Asılı dəyişən |
Adoption Readiness necə soruşuldu?
İştirakçılara mahiyyətcə bu davranış niyyəti sualı verilib: mövcud rollarında müvafiq tapşırıq üçün AI yardımı təmin edilsəydi, ondan istifadə etməyə nə qədər istəkli olardılar? Cavab 1 = strongly unwilling ilə 5 = strongly willing arasında ölçülüb.
Bu ölçmə faktiki davranışı deyil, istifadə niyyətini təmsil edir. İştirakçının AR = 5 cavabı verməsi onun AI sistemini real işdə istifadə etdiyini və ya sistemin etibarlı nəticə verdiyini göstərmir.
Üç əsas hipotez
H1: Daha yüksək Automation Potential daha yüksək Adoption Readiness ilə əlaqəlidir.
H2: Daha yüksək Human Judgment Necessity daha aşağı Adoption Readiness ilə əlaqəlidir.
H3: Daha yüksək Integration Feasibility daha yüksək Adoption Readiness ilə əlaqəlidir.
Task Complexity əsas modeldən çıxarılıb; çünki mənbədə HJ ilə yüksək kollinearlıq göstərdiyi bildirilir. Əsas izah və modelləşdirmə bölməsində bu əsas r = 0,74 kimi verildiyi halda, dərc edilmiş Spearman Table 3-də HJ–TC əmsalı 0,65-dir. Bu iki mənbə dəyəri ayrı kontekstlərdə bildirilməlidir.
Tədqiqatda kimlər iştirak edib?
| Xüsusiyyət | Bölgü |
|---|---|
| CPA | 8 nəfər |
| İdarəetmə | 8 nəfər |
| Mühasibat əməkdaşı | 4 nəfər |
| Mühasibat müəllimi | 4 nəfər |
| 0–5 il təcrübə | 4 nəfər |
| 6–20 il təcrübə | 16 nəfər |
| 20+ il təcrübə | 4 nəfər |
| İzləmə müsahibəsi | 20 nəfər |
İştirakçılar maliyyə və bankçılıq, texnologiya, qonaqpərvərlik və mühasibat təhsili sahələrindən gəlib. Seçmə məqsədli və referral-based üsullarla aparılıb; məqsəd statistik əhali təmsilçiliyi deyil, peşə rolları və təcrübə müxtəlifliyini təmin etməkdir.
Niyə Tayvan seçilib?
Tədqiqat Tayvanı qabaqcıl texnoloji imkanlarla güclü peşə hesabatlılığı quruluşunun eyni vaxtda mövcud olduğu critical case kimi istifadə edir. Mühasiblərin fərdi sign-off və hüquqi məsuliyyət daşıdığı mühitdə AI-nın yalnız səmərəlilik deyil, izlənə bilmə və peşəkar müdafiə oluna bilmə baxımından da qiymətləndirilməsi gözlənilir.
Buna görə ölkə konteksti tədqiqat dizaynının bir hissəsidir; lakin nəticələri başqa ölkələrə avtomatik köçürmək mümkün deyil.
Tapşırıqlara dair qavrayışlar bir-biri ilə necə əlaqəlidir?
Spearman korrelyasiya analizində GPT Exposure ilə Automation Potential arasında 0,60 müsbət əlaqə bildirilib. Automation Potential Human Judgment Necessity ilə −0,29, Task Complexity ilə −0,33 və Integration Feasibility ilə −0,36 korrelyasiya göstərib. HJ ilə TC arasındakı Spearman korrelyasiyası 0,65, HJ ilə IC arasındakı korrelyasiya 0,57, TC ilə IC arasındakı korrelyasiya 0,50-dir.
| Dəyişən cütü | Spearman korrelyasiyası |
|---|---|
| GPT Exposure – AP | 0,60*** |
| AP – HJ | −0,29*** |
| AP – TC | −0,33*** |
| AP – IC | −0,36*** |
| HJ – TC | 0,65*** |
| HJ – IC | 0,57*** |
| TC – IC | 0,50*** |
*** p < 0,001.
Bu nümunə rutin və əvəz edilə bilən tapşırıqlarla yüksək mühakimə/mürəkkəblik tələb edən tapşırıqların qavrayış baxımından fərqləndiyini göstərir; lakin korrelyasiyalar səbəb istiqamətini göstərmir.
Mühasiblər AI-dan hansı tapşırıqlarda istifadə etməyə daha hazır görünür?
Tədqiqatın əsas nəticəsi budur ki, AI-nın tapşırığın daha böyük hissəsini avtomatlaşdıra bildiyi və mövcud audit/nəzərdən keçirmə axınına daha asan yerləşdirilə bildiyi tapşırıqlarda bildirilən AI istifadəsi istəyi daha yüksəkdir. Əksinə, intensiv insan mühakiməsi tələb edən tapşırıqlarda hazırlıq əmsalı mənfi istiqamətdədir, lakin statistik baxımdan qəti deyil; buna görə tədqiqat “insan mühakiməsi artdıqca AI rədd edilir” şəklində qəti nəticəni dəstəkləmir.
Məsələn, rutin mühasibat yeniləmələri, işçi xərclərinin yoxlanması və payable/receivable əməliyyatları yüksək avtomatlaşdırma potensiallı tapşırıqlar sırasında görüldüyü halda, forensic accounting və business valuation yüksək tapşırıq mürəkkəbliyi və yüksək insan mühakiməsi tələbi göstərir.
Appendix B-də ən yüksək Task Complexity ortalamaları forensic accounting üçün 4,50 və business valuation üçün 4,17-dir. Ən yüksək Human Judgment Need dəyərləri müvafiq olaraq 4,00 və 3,67-dir. Automation Potential baxımından managing cash flow, examining expenses və payables & receivables tapşırıqlarının hər biri 4,00 ortalamaya çatır.
Tədqiqatın Metodu və Nəticələri
Əsas statistik model
Asılı dəyişən Adoption Readiness 1–5 sıralı şkalada olduğuna görə əsas model ordered logistic regression-dır. Analiz vahidi 576 task-level rating-dir. Eyni iştirakçı 24 tapşırığı qiymətləndirdiyi üçün müşahidələr bir-birindən tam müstəqil deyil; əsas modeldə standart xətalar respondent səviyyəsində cluster-robust üsulla hesablanıb. Əlavə möhkəmlik spesifikasiyalarında respondent random intercept istifadə olunub.
| Dəyişən | β | Odds Ratio | Standart xəta | Mənbənin şərhi |
|---|---|---|---|---|
| GPT Exposure | −0,340 | 0,712 | 0,074 | p < 0,001; mənfi əlaqə |
| Automation Potential | +0,476 | 1,610 | 0,086 | p < 0,001; müsbət əlaqə |
| Human Judgment Necessity | −0,135 | 0,873 | 0,096 | Əsas mətndə p = 0,160; əhəmiyyətli deyil |
| Integration Feasibility | +0,411 | 1,509 | 0,091 | p < 0,001; müsbət əlaqə |
Modeldə 576 müşahidə var. Log-likelihood −899,61, AIC 1815, BIC 1850, McFadden R² 0,026 və Nagelkerke R² 0,084 kimi bildirilib. Aşağı pseudo-R² dəyərləri müəllif tərəfindən tədqiqatın kəşfiyyat xarakteri və AI mənimsəmə qərarlarının çoxamilli olması ilə uyğun hesab edilir.
Mənbədaxili işarələmə xəbərdarlığı: Table 5-in HJ sətrində bir ulduz çap edilməsinə baxmayaraq, eyni bölmədə p = 0,160 olduğu və əlaqənin conventional significance threshold-a çatmadığı bir neçə dəfə açıq yazılıb. Buna görə H2 statistik baxımdan təsdiqlənmiş kimi təqdim edilməməlidir.
Odds ratio nəticələri nə deməkdir?
Ordered logit modelində odds ratio, digər dəyişənlər sabit saxlanıldıqda izahlı dəyişəndəki artımın daha yüksək Adoption Readiness kateqoriyalarında yer alma odds-u ilə əlaqəsini göstərir. AP üçün OR = 1,610 və IC üçün OR = 1,509 daha yüksək readiness istiqamətində əlaqəni, GPT Exposure üçün OR = 0,712 isə daha aşağı readiness istiqamətində əlaqəni göstərir; bunlar səbəb təsirləri deyil.
Automation Potential təsirinin ölçüsü
Mənbə yalnız əmsal verməyib, dəyişənlər Q25-dən Q75-ə keçirildikdə modelin proqnozlaşdırdığı AR kateqoriyası ehtimallarını da hesablayıb.
| Dəyişən | P(AR=1), aşağı | P(AR=1), yüksək | P(AR=5), aşağı | P(AR=5), yüksək |
|---|---|---|---|---|
| Automation Potential | 0,364 | 0,181 | 0,098 | 0,219 |
| Integration Feasibility | 0,306 | 0,162 | 0,123 | 0,242 |
| GPT Exposure | 0,174 | 0,294 | 0,227 | 0,129 |
| Human Judgment Necessity | 0,207 | 0,256 | 0,191 | 0,153 |
Automation Potential Q25-dən Q75-ə yüksəldikdə model P(AR=1)-i 0,364-dən 0,181-ə endirir, P(AR=5)-i isə 0,098-dən 0,219-a qaldırır. Integration Feasibility üçün P(AR=5) 0,123-dən 0,242-yə yüksəlir. Bu ehtimallar model əsaslı proqnozlardır; faktiki istifadə nisbətləri deyil.
GPT təcrübəsi niyə daha aşağı hazırlıqla əlaqəli ola bilər?
GPT Exposure əmsalı mənfi və statistik baxımdan əhəmiyyətlidir. Müəllif bunu experience-skepticism effect kimi şərh edir: böyük dil modelləri ilə daha çox praktiki təcrübə istifadəçilərin model məhdudiyyətlərini, yoxlama ehtiyacını və xətaları daha real görməsinə səbəb ola bilər.
Lakin bu tədqiqat həmin mexanizmi birbaşa sınaqdan keçirmir. “Daha çox GPT təcrübəsi qəti şəkildə skeptisizmə səbəb olur” nəticəsi çıxarıla bilməz. Mənfi əmsal mənbə məlumatlarında müşahidə edilən əlaqədir; experience-skepticism isə müəllifin bu əlaqə ilə uyğun nəzəri şərhidir.
İnsan mühakiməsi nəticəsi niyə ehtiyatla oxunmalıdır?
Human Judgment Necessity əmsalı gözlənilən istiqamətdə mənfidir, lakin mənbə p = 0,160 bildirir. Buna görə H2 üçün yalnız istiqamətli, lakin nəticəsiz/inconclusive dəstək var.
Müəllif iki mümkün məhdudiyyəti müzakirə edir: təsir bu kiçik nümunədə həqiqətən zəif ola bilər və ya HJ-nin Task Complexity ilə yüksək korrelyasiyası müstəqil əmsalın həssaslığını azaltmış ola bilər. Bundan əlavə, tapşırıq növü, staj və ya mühakimənin xarakteri kimi ölçülməmiş moderatorlar da rol oynaya bilər.
20 izləmə müsahibəsi hansı məqsədlə istifadə olunub?
İzləmə müsahibələri əsas statistik nəticələri əvəz etmək üçün deyil, əmsalların peşə kontekstini mənalandırmaq üçün istifadə olunub. Müsahibələr Mandarin dilində yazılıb verbatim transcribe edilib, müəyyən bölmədə back-translation tətbiq olunub və qalan məzmun ikidilli nəzərdən keçirmə ilə yoxlanılıb.
Back-translation yalnız hədəflənmiş transcript alt çoxluğunun %29-una tətbiq olunub. Müəllif bunu açıq şəkildə dizayn məhdudiyyəti kimi qəbul edir. Tam thematic analysis bu məqalənin əsas nəticəsi deyil; companion qualitative study daxilində bildirildiyi qeyd olunur.
Üç tapşırıq profili
Ward linkage istifadə edən hierarchical clustering GPT Exposure, AP, HJ, TC və IC-nin standartlaşdırılmış dəyərləri üzərindən üç klaster yaradıb. Səhifə 11-dəki dendrogram üçlü həlli, dərhal altındakı kernel density qrafikləri isə klasterlərin dəyişən profillərindəki fərqi göstərir.
| Klaster | Əsas profil | Nümunə tapşırıqlar | Mənbədə təklif olunan AI yanaşması |
|---|---|---|---|
| Cluster 1 — Judgment-first | Yüksək HJ və TC; orta-yüksək IC | Forensic accounting, business valuation, audit leadership | Copilot tipli yardım + məcburi insan sign-off |
| Cluster 2 — Automation-oriented | Yüksək AP və GPT Exposure; aşağı HJ | Xərc yoxlaması, gündəlik mühasibat işləri, payable/receivable | AI mənimsənilməsi üçün ən birbaşa başlanğıc sahəsi |
| Cluster 3 — Intermediate | AP, HJ və IC baxımından orta səviyyə | Bank uzlaşdırılması, tənzimləyici uyğunluq, maliyyə proqnozu | Qərar şirkət idarəetməsindən və peşə təcrübəsindən daha çox asılıdır |
Bu klasterləşdirmə təsviridir. Üç profil təbii və ya universal mühasibat tapşırığı sinifləri kimi sübut edilməyib.
Möhkəmlik yoxlamaları
Tədqiqatçı AP faizlərinin yenidən qruplaşdırılması, GPT Exposure-un ordinal kimi işlənməsi və TC/IC şkalalarının yenidən kodlanması kimi alternativ ölçmə seçimlərini sınaqdan keçirib və əmsalların əhəmiyyətli dərəcədə dəyişmədiyini bildirib.
Ordered logit və OLS spesifikasiyaları eyni ümumi istiqaməti verib; HC3 standart xətaları və nonparametric bootstrap confidence intervals oxşar statistik nəticələrlə yekunlaşıb.
Leave-one-respondent-out analizində əmsallar gözlənilən nümunə səs-küyü daxilində sabit qalıb. Şirkət ölçüsü ilə bağlı multivariate nümunələr 9999 permutation istifadə edən permutation MANOVA ilə ayrıca sınaqdan keçirilib. Üç klasterin quruluşu k-means və alternativ distance metrics ilə keyfiyyət baxımından qorunub.
Ölçmə diaqnostikaları
| Ölçmə | Dəyər |
|---|---|
| Cronbach's α | 0,441 |
| %95 etibar intervalı | [0,282; 0,573] |
| KMO | 0,643 |
| Bartlett χ²(10) | 274,219; p < 0,001 |
| Factor 1 eigenvalue | 2,006 |
| İzah olunan dispersiya | 0,401 |
Müəllif aşağı Cronbach α dəyərini klassik mənada şkalanın uğursuzluğu kimi şərh etmir; çünki AP, HJ, TC, IC və GPT Exposure eyni latent anlayışın bir-birini təkrarlayan reflective göstəriciləri kimi deyil, müxtəlif tapşırıq xüsusiyyətlərini təmsil edən formative göstəricilər kimi hazırlanıb.
Birfaktorlu analizdə GPT Exposure loading-i 0,117, AP 0,474, HJ −0,813, TC −0,780 və IC −0,706-dır. İşarələr dəyişənlərin kodlaşdırılma istiqamətlərini əks etdirir.
Necessary Condition Analysis
Kəşfiyyat xarakterli Necessary Condition Analysis-də CE-FDH estimator və permutation tests istifadə olunub. Məqsəd Adoption Readiness üçün tək dəyişənin zəruri hədd və ya bottleneck olub-olmadığını sınaqdan keçirməkdir.
Heç bir amil ənənəvi əhəmiyyətlilik səviyyələrində sıfırdan fərqli necessity threshold-a çatmayıb. Buna görə mənbə nəticələri “yüksək IC olmadan AI heç vaxt mənimsənilə bilməz” və ya “GPT təcrübəsi zəruri şərtdir” kimi sərt hədd iddialarını dəstəkləmir.
Tədqiqatın dəstəklədiyi nəticələr
- Daha yüksək Automation Potential daha yüksək AI Adoption Readiness ilə müsbət əlaqəlidir.
- Daha yüksək Integration Feasibility daha yüksək Adoption Readiness ilə müsbət əlaqəlidir.
- Daha yüksək GPT Exposure daha aşağı Adoption Readiness ilə əlaqəlidir.
- Human Judgment Necessity mənfi istiqamətdədir, lakin p = 0,160 olduğuna görə statistik baxımdan qəti deyil.
- Task-level governance compatibility AI mənimsəmə istəyini başa düşməkdə yalnız səmərəlilik məntiqinə əlavə izah dəyəri verir.
- Tapşırıqlar judgment-first, automation-oriented və intermediate olmaqla üç təsviri profilə ayrıla bilər.
- Rutin və aşağı mühakimə tələb edən tapşırıqlar AI istifadəsi üçün daha açıq başlanğıc sahələri kimi görünür.
Tədqiqatın dəstəkləmədiyi nəticələr
- AI-nın mühasiblərin iş performansını artırdığı sınaqdan keçirilməyib.
- AI-nın xəta dərəcəsini və ya xərcləri azaltdığı ölçülməyib.
- İştirakçıların faktiki AI istifadə davranışı müşahidə edilməyib.
- 24 nəfərlik panel bütün Tayvan mühasiblərini və ya qlobal mühasibat peşəsini təmsil etmir.
- GPT təcrübəsinin səbəb olaraq skeptisizmə gətirdiyi sübut edilməyib.
- İnsan mühakiməsinə tələbatın AI mənimsənilməsini qəti şəkildə azaltdığı statistik baxımdan göstərilməyib.
- Üç cluster universal mühasibat tapşırığı kateqoriyaları deyil.
- Tənzimləmə və hesabatlılıq strukturları fərqli ölkələrdə eyni əlaqələrin yaranacağına zəmanət vermir.
Məhdudiyyətlər
Ən mühüm məhdudiyyət 24 nəfərlik purposive expert-panel dizaynıdır. Cəmi 576 tapşırıq səviyyəli müşahidə yüksək görünsə də, bunlar yalnız 24 nəfərin təkrarlanan qiymətləndirmələridir. Buna görə 576 müşahidəni 576 müstəqil peşəkar kimi şərh etmək yanlış olar.
Nəticə dəyişəni faktiki istifadə deyil, self-reported behavioral intention-dır. Bir maddəli AR ölçməsi technology acceptance ədəbiyyatında istifadə oluna bilən proxy olsa da, strukturun emosional, idrak və davranış ölçülərini ayrıca ölçmür.
Məlumatlar kəsik və qavrayış xarakterlidir; səbəb istiqaməti müəyyən edilə bilməz. Daha yüksək inteqrasiya tətbiqolunması AI hazırlığını artıra bilər və ya AI-ya daha açıq iştirakçılar müəyyən tapşırıqların inteqrasiyasını daha asan qavraya bilər.
Müsahibələr kontekstual izah verir, lakin tam keyfiyyət analizi bu məqalədə bildirilməyib. Bundan əlavə, yalnız transcriptlərin %29-unda back-translation tətbiqi linqvistik doğrulamanın əhatəsini məhdudlaşdırır.
Müəllif gələcəkdə geniş confirmatory surveys, longitudinal dizaynlar, fərqli accountability regimes arasında müqayisələr və GPT Exposure ilə aşağı readiness əlaqəsinin experience-based skepticism, yoxsa cohort/keçid təsiri olduğunu ayıra bilən tədqiqatlar təklif edir.
Mənbə və Metod Qeydi
Orijinal başlıq: Task-Level Perceptions of AI Readiness Among Accounting Professionals
Müəllif: Wil Martens.
Qurum: College of Management, National Sun Yat-sen University, Kaohsiung 80424, Taiwan.
Jurnal: Accounting and Auditing.
Nəşriyyat: MDPI, Basel, Switzerland.
Biblioqrafik qeyd: 2026, Volume 2, Issue 2, Article 7.
DOI: 10.3390/accountaudit2020007
Nəşr tarixi: 8 may 2026.
Redaksiya tarixləri: Received 21 January 2026; Revised 1 April 2026; Accepted 20 April 2026.
Mənbə növü: Rəyçi qiymətləndirməsindən keçmiş kəşfiyyat xarakterli task-survey / expert-panel tədqiqatı; strukturlaşdırılmış tapşırıq səviyyəli qavrayış ölçmələri dəstəkləyici qısa müsahibələrlə birlikdə istifadə olunub.
Lisenziya: Creative Commons Attribution (CC BY).
Nümunə: 24 accounting professional × 24 tapşırıq = 576 tapşırıq səviyyəli qiymətləndirmə; 20 nəfərlə izləmə müsahibəsi.
Əsas nəticə dəyişəni: Adoption Readiness (AR), 1–5 ordinal behavioral-intention ölçməsi.
Əsas izahlı dəyişənlər: Automation Potential (AP), Human Judgment Necessity (HJ), Integration Feasibility (IC); GPT Exposure nəzarət dəyişənidir. Task Complexity (TC) kollinearlıq səbəbindən əsas modeldən çıxarılıb, təsviri və cluster analizlərində saxlanılıb.
Əsas statistik metod: Ordered logistic regression; respondent səviyyəsində cluster-robust standard errors. Robustness analizlərində random-intercept strukturları, OLS, HC3 standard errors, nonparametric bootstrap, leave-one-respondent-out, permutation MANOVA və alternativ cluster metodları istifadə olunub.
Klasterləşdirmə: Standartlaşdırılmış GPT, AP, HJ, TC və IC dəyərlərində Ward linkage istifadə edən hierarchical clustering; üç cluster həlli.
Əlavə kəşfiyyat metodu: CE-FDH estimator və permutation tests istifadə edən Necessary Condition Analysis.
Maliyyələşdirmə: Xarici maliyyələşdirmə yoxdur.
Etika: Anonim sorğu məlumatları və könüllü müsahibələri əhatə edən minimal-risk tədqiqat kimi müəyyən edilib və tətbiq olunan milli və institusional qaydalar çərçivəsində formal etik şura yoxlamasının tələb olunmadığı bildirilib.
Məlumatlandırılmış razılıq: Bütün iştirakçılardan alınıb.
Məlumatların əlçatanlığı: Məlumatlar etik və məxfilik məhdudiyyətləri səbəbindən ictimaiyyətə açıq deyil; əsaslandırılmış sorğu əsasında corresponding author vasitəsilə əlçatan ola bilər.
Maraqların toqquşması: Müəllif maraqların toqquşmasının olmadığını bəyan edib.
Mənbədaxili statistik qeyd: Table 5-də Human Judgment Necessity üçün ulduz işarəsi çap edilməsinə baxmayaraq, əsas mətn və cədvəl qeydi p = 0,160 olduğunu və conventional significance threshold-a çatılmadığını bildirir. Verianla şərhində açıq p dəyəri və müəllifin mətnli şərhi qorunub.
Əsas şərh sərhədi: Nəticələr kiçik və məqsədli seçilmiş expert panel daxilində tapşırıq səviyyəli qavrayış əlaqələridir. Səbəb təsiri, faktiki istifadə, sistem performansı və ya əhali səviyyəsində mənimsəmə nisbəti kimi şərh edilməməlidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib