

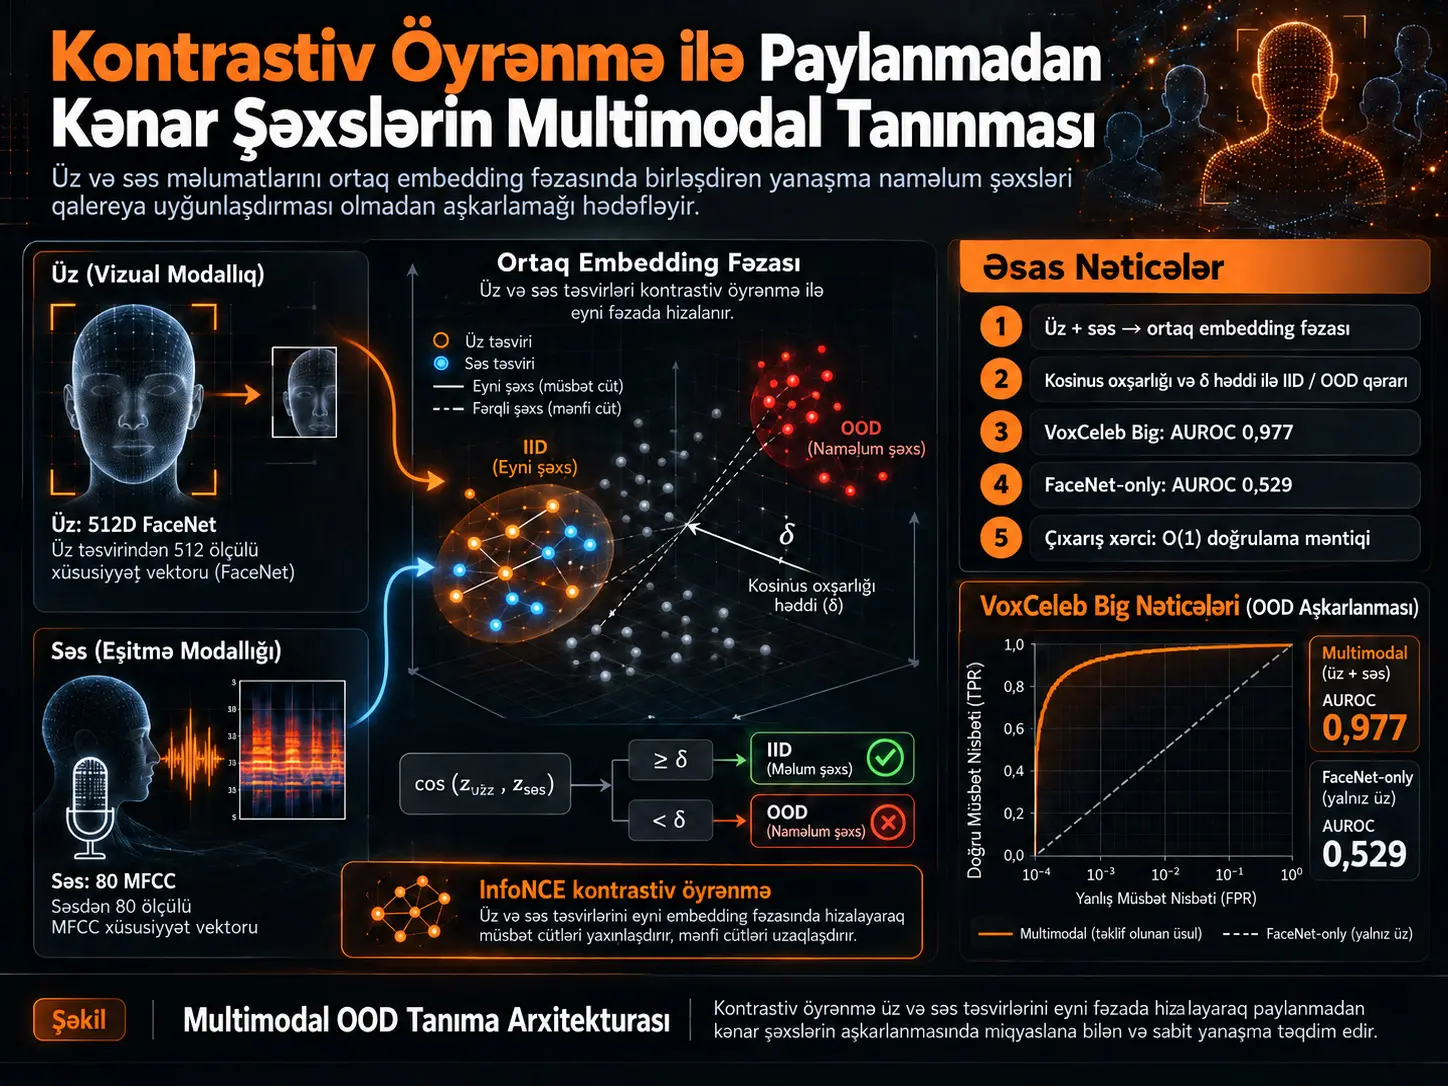
Paylanmadan kənar şəxs (out-of-distribution, OOD), şəxsin tanınması sisteminin təlim zamanı öyrəndiyi kimlik paylanmasından kənarda qalan, əvvəllər görülməmiş şəxsi ifadə edir. Ənənəvi qapalı çoxluqlu tanıma sistemlərinə belə bir nümunə daxil olduqda, model naməlum şəxsi mövcud siniflərdən birinə məcburi şəkildə aid edə bilər. Sergio Garcia, Francisco Gomez-Donoso və Miguel Cazorla tərəfindən hazırlanmış üsul bu problemi yalnız üz və ya yalnız səs vasitəsilə həll etmək əvəzinə, iki biometrik modallığın bir-biri ilə nə dərəcədə uyğun olduğunu ölçür.
Model üz təsvirindən FaceNet vasitəsilə 512 ölçülü xüsusiyyət vektoru, səs yazısından isə 80 Mel-Frequency Cepstral Coefficient (MFCC) xüsusiyyəti çıxarır. İki ayrı neyron şəbəkəsi qolu bu təsvirləri 1200 ölçülü ortaq embedding fəzasına proyeksiya edir. Təlim zamanı InfoNCE əsaslı kontrastiv itki eyni şəxsə aid üz-səs cütlərini bir-birinə yaxınlaşdırarkən, fərqli şəxslərə aid cütləri bir-birindən uzaqlaşdırır.
Çıxarış zamanı kimlik qalereyasında ən yaxın şəxs axtarılmır. Bunun əvəzinə üz embedding-i ilə səs embedding-i arasındakı kosinus oxşarlığı ölçülür. Dəyər müəyyən edilmiş həddin \(\delta\) altındadırsa, cüt OOD, həddin üzərindədirsə, paylanma daxili kimi təsnif edilir.
Custom, LombardGrid və VoxCeleb əsaslı təcrübələrdə üsul, xüsusilə kimliklərin sayı artdıqda, FaceNet-only müqayisəsinə nisbətən daha sabit nəticələr vermişdir. VoxCeleb Big təcrübəsində multimodal üsulun AUROC dəyəri 0,977, FaceNet-only müqayisəsinin dəyəri isə 0,529 olmuşdur. Bununla belə, nəticələr bütün multimodal şəxs tanıma üsullarına qarşı əhatəli state-of-the-art müqayisə deyil və modelin real dünyada genişmiqyaslı etik və əməliyyat yoxlanışı gələcək iş kimi saxlanılmışdır.
Paylanmadan kənar şəxs problemi nədir?
Neyron şəbəkəsi yalnız təlim zamanı gördüyü siniflər arasından seçim edəcək şəkildə hazırlanıbsa, əvvəllər heç qarşılaşmadığı kimliyi də məlum siniflərdən birinə aid edə bilər. Modelin yüksək əminlik yaratması həmin şəxsin həqiqətən tanındığı mənasına gəlməyə bilər.
Bu problem xüsusilə şəxs tanıma sistemlərində vacibdir. Sistemin “bu şəxs təlimdə gördüyüm şəxslərdən biri deyil” deyə bilməsi, yalnız düzgün təsnifat apara bilməsindən fərqli bir qabiliyyətdir.
Məqalə bu problemi üz və səs olmaqla iki ayrı biometrik modallıqdan birlikdə istifadə edərək nəzərdən keçirir.
Üz və Səs Birlikdə OOD Aşkarlanmasını Necə Təmin Edir?
Təklif olunan sistemin əsas fərziyyəsi eyni şəxsə aid üz və səs təsvirlərinin kontrastiv təlimdən sonra ortaq latent fəzada bir-biri ilə uyğunlaşdırıla bilməsidir. Model “şəxsin kimliyini qalereyada tapmağa” çalışmaq əvəzinə, üz və səsin öyrənilmiş təsvir fəzasında eyni kimliyə aid olacaq qədər uyğun olub-olmadığını soruşur.
Üz tərəfi: FaceNet
Üz təsvirləri təklif olunan kontrastiv şəbəkəyə birbaşa xam piksel kimi verilmir. Əvvəlcə FaceNet tərəfindən işlənir və hər təsvir üçün 512 ölçülü üz embedding-i yaradılır.
Bu təsvir üzün fərqləndirici xüsusiyyətlərini kompakt metrik fəzada kodlaşdırmaq üçün istifadə olunur. Sonra 512 ölçülü vektor təklif olunan multimodal şəbəkənin üz qoluna ötürülür.
Səs tərəfi: MFCC
Səs məlumatları üçün Mel-Frequency Cepstral Coefficients istifadə edilmişdir. Hər səs parçasından 80 MFCC xüsusiyyəti çıxarılmışdır.
MFCC çıxarılmasından əvvəl səs amplitudası 0,03 hədəf dəyərinə xətti gain normalization ilə normallaşdırılmışdır. Müəlliflər bunun RMS və ya peak normalization olmadığını xüsusi vurğulayırlar. Məqsəd yazının səs səviyyəsindəki fərqlərin spektral xüsusiyyətlərdə lazımsız dəyişkənlik yaratmasını azaltmaqdır.
İki modallıq ortaq fəzada birləşir
Üz və səs qolları oxşar çoxqatlı strukturlardan istifadə edir. Hər iki qolun sonunda təsvir 1200 ölçülü ortaq embedding fəzasına proyeksiya edilir.
| Qol | Giriş | Aralıq qatlar | Çıxış |
|---|---|---|---|
| Üz | 512D FaceNet embedding | 1024 → 512 → 256 | 1200D embedding |
| Səs | 80 MFCC xüsusiyyəti | 1024 → 512 → 256 | 1200D embedding |
Hər aralıq blokda Linear, BatchNorm1d, ReLU və Dropout komponentləri mövcuddur. Mənbədə model üçün ümumilikdə 2.544.480 təlim edilə bilən parametr bildirilmişdir.
Kontrastiv Öyrənmə Burada Nəyi Öyrənir?
Kontrastiv öyrənmə eyni şəxsə aid üz-səs cütlərini embedding fəzasında bir-birinə yaxınlaşdırarkən, fərqli şəxslərin cütlərini bir-birindən uzaqlaşdırmağı hədəfləyir. Beləliklə, sistem sinif etiketini əzbərləmək əvəzinə, iki fərqli modallıq arasındakı kimlik uyğunluğunu öyrənməyə çalışır.
Müsbət və mənfi cütlər
Eyni şəxsə aid üz \(f_i\) ilə səs \(a_i\) müsbət cüt yaradır.
Fərqli şəxslərə aid üz \(f_i\) ilə səs \(a_j\), \(i \neq j\) olduqda mənfi cüt yaradır.
Mənbə 40 üz və 40 səs nümunəsi olan bir şəxs üçün 1600 müsbət uyğunlaşma kombinasiyasının yarana biləcəyini göstərir. Nümunə olaraq, 50 nəfərlik vəziyyətdə ümumilikdə 80.000 müsbət cüt və 3.920.000 mümkün mənfi cüt hesablanır. Bu bölmə metodoloji kombinasiya nümunəsidir; istifadə olunan bütün məlumat dəstlərinin həqiqətən 50 nəfərdən ibarət olduğu mənasına gəlmir.
InfoNCE itkisi
Təlimdə istifadə olunan kontrastiv itki:
\[ L_{\text{contrastive}} = -\frac{1}{N} \sum_{i=1}^{N} \log \frac{ \exp(sim(z_{f_i},z_{a_i})/\tau) }{ \sum_{j=1}^{N} \exp(sim(z_{f_i},z_{a_j})/\tau) } \]
şəklindədir.
Burada \(z_f\) üz embedding-ini, \(z_a\) səs embedding-ini, \(N\) batch ölçüsünü və \(\tau\) temperatur parametrini ifadə edir.
Oxşarlıq ölçüsü kosinus oxşarlığıdır:
\[ sim(z_f,z_a) = \frac{z_f \cdot z_a} {\|z_f\|\|z_a\|} \]
Təlim parametrlərinə 50 epoch, siniflərin sayına bərabər batch size, 0,0005 learning rate və \(\tau=0,05\) temperatur dəyəri daxildir.
Sistem Naməlum Şəxs Barədə Qərarı Necə Verir?
Çıxarış zamanı üz-səs cütünün iki embedding-i yaradılır və onlar arasındakı kosinus oxşarlığı hesablanır. Mənbədə OOD qərarı belə müəyyən edilir:
\[ OOD(z_f,z_a)= \begin{cases} 1, & sim(z_f,z_a)<\delta \\ 0, & \text{aksi halde} \end{cases} \]
\(\delta\) qərar həddidir.
Mənbədə başlanğıc həddi təlimdəki müsbət cütlərin orta oxşarlığının yarısından istifadə etməklə empirik şəkildə yaradılmışdır. Lakin müəlliflər bu dəyəri optimallaşdırılmış sabit model parametri kimi təqdim etmirlər. Təcrübələrdə geniş threshold diapazonu yoxlanılaraq üsulun müxtəlif iş nöqtələrindəki həssaslığı ayrıca araşdırılmışdır.
Vacib nüans: “görülməmiş şəxs” həmişə aşağı oxşarlıq yaratmır
Bu məqam üsulu anlamaq baxımından kritikdir. Model əvvəllər görmədiyi şəxsin üzünü və səsini də ortaq embedding fəzasında yaxşı uyğunlaşdıra bilər.
Buna görə də sistemin OOD mexanizmi “bu kimliyi əvvəllər əzbərləmişəmmi?” sualına əsaslanmır. Ölçülən şey üz və səs arasındakı cross-modal consistency-dir.
Təlimdən əvvəl və sonrakı oxşarlıq paylanması
Mənbənin 9. səhifəsindəki Şəkil 2 kontrastiv təlimdən əvvəl üz və səs təsvirlərinin bütün məlumat dəstlərində təxminən sıfır ətrafında toplandığını göstərir. Başqa sözlə, FaceNet üz xüsusiyyətləri ilə MFCC səs xüsusiyyətləri təbii şəkildə eyni koordinat fəzasında hizalanmır.
Eyni səhifədəki Şəkil 3 və Şəkil 4-də isə təlimdən sonra LombardGrid müsbət üz-səs cütlərinin kosinus oxşarlıqlarının həm təlim, həm də test dəstində 1-ə yaxınlaşdığı görünür. Bu dəyişiklik kontrastiv modelin iki fərqli modallıq arasında ortaq təsvir öyrəndiyinin birbaşa vizual göstəricisidir.
Tədqiqatın Üsulu və Nəticələri
İstifadə olunan məlumat dəstləri
Tədqiqat üç əsas məlumat mənbəyindən istifadə edir: tədqiqatçıların yaratdığı custom məlumat dəsti, VoxCeleb1 və Lombard Grid.
Custom məlumat dəsti
Xüsusi məlumat dəsti 15 fərqli şəxsdən üz və səs məlumatlarını ehtiva edir. Mənbələr həm YouTube kimi ictimaiyyətə açıq platformalardakı videoları, həm də razılıq verən şəxslərin real vaxt yazılarını əhatə edir.
Hər şəxsin 3-10 arasında səs klipi var və səslərin orta uzunluğu 4-8 saniyədir. Təlim məlumatlarına augmentation tətbiq edilərək hər şəxs üçün 40 üz kadrı və 40 səs nümunəsinə çatdırılmışdır. Test üçün hər şəxsə üç üz kadrı və üç səs nümunəsi ayrılmış; test yazılarının təlimdə istifadə olunan yazılardan fərqli mənbələrdən gəlməsinə diqqət yetirilmişdir.
VoxCeleb1
VoxCeleb1 ümumilikdə 1251 şəxsə aid 100.000-dən çox səs klipini ehtiva edən genişmiqyaslı danışan məlumat dəstidir. Yazılar fon səs-küyü, aksent və mikrofon şəraiti baxımından müxtəliflik göstərir.
Bu tədqiqatda test videoları təlim videolarından ayrı saxlanılmışdır. Təlim üçün hər şəxsə hədəf olaraq 20 üz kadrı və 20 səs nümunəsi müəyyən edilmiş, augmentation-dan sonra 40 üz və 40 səs nümunəsinə çatdırılmışdır.
Lombard Grid
Lombard Grid 54 danışanı və hər şəxs üçün 1000-dən çox səs klipini ehtiva edir. Səslərlə sinxron video yazılarının olması onu üz-səs uyğunlaşdırması üçün əlverişli edir.
Bu tədqiqatda hər şəxs üçün təlimə 20 üz və 20 səs, testə isə fərqli yazılardan 5 üz və 5 səs seçilmişdir. Nəzarət olunan məlumat strukturu səbəbindən augmentation tətbiq edilməmişdir.
Custom məlumat dəstinin nəticələri
Custom məlumat dəstində həm multimodal üsul, həm də FaceNet-only baseline IID və OOD nümunələrini yüksək müvəffəqiyyətlə ayırmışdır. ROC analizində:
| Üsul | AUROC |
|---|---|
| Multimodal | 0,9928 |
| FaceNet-only | 0,9828 |
Fərq çox böyük deyil; lakin threshold qrafikləri multimodal üsulun qərar həddinə münasibətdə daha sabit sahə yaratdığını göstərir.
LombardGrid nəticələri
Nəzarət olunan LombardGrid məlumat dəstində hər iki üsul AUROC=1 dəyərinə çatmışdır. Buna görə yalnız ROC əyrisinə əsasən multimodal üsulun üstün olduğunu söyləmək olmaz.
Mənbənin vurğuladığı fərq multimodal üsulun yüksək IID/OOD performansını daha geniş threshold diapazonunda qorumasıdır. Başqa sözlə, eyni zirvə performansına çatsalar da, hədd seçiminə həssaslıqları eyni deyil.
VoxCeleb Mini
VoxCeleb Mini təcrübəsində multimodal sistem AUROC=0,974, FaceNet-only üsul isə AUROC=0,971 əldə etmişdir. ROC baxımından üsullar bir-birinə yaxındır.
Lakin OOD aşkarlama hədəfi yüksəldikcə IID dəqiqliyinin qorunması baxımından multimodal sistem daha sabit qalmışdır.
| OOD aşkarlanması | Multimodal IID | FaceNet IID |
|---|---|---|
| %90,0 | %95,0 | %93,0 |
| %91,8 | %95,0 | %88,5 |
| %93,5 | %92,5 | %85,0 |
| %95,2 | %90,0 | %85,0 |
| %97,0 | %87,5 | %66,7 |
VoxCeleb Big: miqyas böyüdükdə nə baş verir?
Məqalədə ən aydın fərqlənmə VoxCeleb Big təcrübəsində görünür.
Multimodal üsulun AUROC dəyəri 0,977, FaceNet-only müqayisəsinin dəyəri isə 0,529-dur. İkincisi təsadüfi ayırmaya yaxın ROC performansını ifadə edir.
| OOD aşkarlanması | Multimodal IID | FaceNet IID |
|---|---|---|
| %90,0 | %94,6 | %18,7 |
| %91,8 | %94,3 | %17,8 |
| %93,5 | %93,8 | %16,8 |
| %95,2 | %92,7 | %14,7 |
| %97,0 | %86,2 | %11,7 |
Müəlliflərin izahı FaceNet-only sisteminin iş prinsipi ilə əlaqəlidir. Bu baseline sorğu embedding-ini geniş qeydiyyatlı kimlik qalereyası ilə müqayisə edir. Qalereya böyüdükcə siniflərarası oxşarlıq paylanmaları üst-üstə düşməyə başlayır və məlum-naməlum ayrımında istifadə olunan hədd daha kövrək olur.
Multimodal üsul isə bütün qeydiyyatlı kimliklərlə 1:N müqayisə aparmaq əvəzinə, verilmiş üz və səsin öz aralarındakı uyğunluğu ölçür.
Hesablama mürəkkəbliyi
Mənbə təklif olunan üsulun çıxarış zamanı yalnız:
- bir üz embedding-i,
- bir səs embedding-i,
- bir kosinus oxşarlığı hesablaması
tələb etdiyini bildirir.
Buna görə hər doğrulama üzrə əməliyyat xərci qalereya ölçüsündən asılı olmayaraq O(1) kimi ifadə edilmişdir. Bunun əksinə, klassik 1:N qalereya əsaslı şəxs tanımada sorğu bütün qeydiyyatlı kimliklərlə müqayisə edildiyi üçün hesablama miqdarı qalereyanın ölçüsü ilə artır.
Bu mürəkkəblik iddiası tədqiqatda müəyyən edilmiş doğrulama proseduruna aiddir; real sistemdə kamera, səsin ilkin emalı, FaceNet feature extraction və ya avadanlıq gecikməsinin hamısının O(1) və sabit müddətli olduğu mənasına gəlmir.
Tədqiqatın mühüm məhdudiyyətləri
- Əsas eksperimental müqayisə yalnız FaceNet-only unimodal baseline ilə aparılmışdır.
- Digər multimodal state-of-the-art üsullarla tam eksperimental müqayisə aparılmamışdır.
- Sadə feature concatenation kimi alternativ multimodal fusion baseline-ları əsas müqayisəyə daxil edilməmişdir.
- Hər modallığın müstəqil töhfəsini kəmiyyət baxımından ayıran təfərrüatlı ablasiya təhlili hələ aparılmamışdır.
- OOD qərar həddi empirik iş nöqtəsidir; vahid universal optimal hədd kimi təqdim edilmir.
- Custom məlumat dəsti yalnız 15 şəxsdən ibarətdir.
- Real dünya şəraitində daha genişmiqyaslı yoxlama gələcək iş kimi saxlanılmışdır.
- Etika, məxfilik və real sistem istifadəsinə dair genişmiqyaslı qiymətləndirmə tamamlanmamışdır.
Gələcək işlər
Müəlliflər sistemə yeriş tərzi və dərinlik məlumatları kimi əlavə modallıqlar daxil etməyi, zaman modelləşdirməsindən istifadə etməyi, self-supervised və few-shot öyrənmə üsullarını araşdırmağı və məlumat tələbatını azaltmağı planlaşdırırlar.
Bundan əlavə, daha geniş real dünya validasiyası, etik qiymətləndirmələr və hər modallığın nəticəyə töhfəsini ölçən daha dərin ablasiya təcrübələri gələcək tədqiqat mövzuları arasındadır.
Tədqiqat nə deyir?
Üz və səs təsvirlərinin kontrastiv şəkildə eyni embedding fəzasında hizalanması, xüsusilə kimlik qalereyası böyüdükdə, cross-modal consistency vasitəsilə IID/OOD ayrımının daha sabit aparılmasını təmin edə bilər. Tədqiqatdakı ən güclü eksperimental sübut VoxCeleb Big nəticələrindən gəlir.
Tədqiqat nə demir?
Sistemin əvvəllər görülməmiş bütün şəxsləri qüsursuz aşkarladığı nəticəsinə gəlmək olmaz. Üsulun bütün multimodal biometrik sistemlərdən üstün olduğu göstərilməmişdir. Bu tədqiqat təkbaşına üz-səs biometrikasının təhlükəsizlik, müşahidə və ya kimliyin doğrulanması tətbiqlərində istifadəyə hazır olduğunu da sübut etmir.
Mənbə və Metod Qeydi
Orijinal tədqiqat: Multimodal Recognition of Out-of-Distribution Individuals Using Contrastive Learning
Müəlliflər: Sergio Garcia; Francisco Gomez-Donoso; Miguel Cazorla.
Məsul müəllif: Miguel Cazorla.
Müəssisə: University Institute for Computer Research, University of Alicante, Alicante, Spain.
Jurnal: AI.
Nəşriyyat: MDPI.
Biblioqrafik qeyd: AI 2026, 7, 162.
DOI: 10.3390/ai7050162
Məqalənin növü: Eksperimental süni intellekt / multimodal şəxs tanıma tədqiqatı.
Nəşr prosesi: 31 Yanvar 2026-da daxil olmuş; 6 Aprel 2026-da yenidən işlənmiş; 24 Aprel 2026-da qəbul edilmiş; 6 May 2026-da dərc olunmuşdur.
Lisenziya: Creative Commons Attribution (CC BY).
Maliyyələşdirmə: Tədqiqat PID2022-138453OB-I00 qrantı çərçivəsində MICIU/AEI/10.13039/501100011033 və “ERDF A way of making Europe” tərəfindən dəstəklənmişdir.
Etika: Tədqiqat Helsinki Bəyannaməsinə uyğun aparılmış və University of Alicante Ethics Committee tərəfindən UA-2023-07-31 protokol kodu ilə İyul 2023-də təsdiqlənmişdir.
Məlumatlandırılmış razılıq: Tədqiqata daxil edilmiş şəxslərdən məlumatlandırılmış razılıq alınmışdır.
Məlumatların əlçatanlığı: Nəticələri dəstəkləyən xam məlumatların müəlliflər tərəfindən sorğu əsasında təqdim ediləcəyi bildirilmişdir.
Maraqların toqquşması: Müəlliflər maraqların toqquşmasını bildirmirlər.
Metodoloji nüvə: FaceNet-dən çıxarılan 512 ölçülü üz embedding-ləri ilə 80 MFCC səs xüsusiyyəti iki ayrı neyron şəbəkəsi qolu vasitəsilə 1200 ölçülü ortaq embedding fəzasına proyeksiya edilmişdir. InfoNCE kontrastiv itkisi ilə eyni şəxsə aid üz-səs cütləri yaxınlaşdırılmış, fərqli şəxslərin cütləri uzaqlaşdırılmışdır. OOD qərarı üz və səs embedding-ləri arasındakı kosinus oxşarlığına əsasən empirik threshold vasitəsilə verilmişdir.
Əsas şərh həddi: Tədqiqat geniş state-of-the-art multimodal baseline müqayisəsi aparmır. Nəticələrin mühüm hissəsi FaceNet-only baseline ilə nəzarət olunan müqayisəyə əsaslanır və daha geniş ablation, real dünya miqyasında sınaq və etik qiymətləndirmə gələcək iş kimi saxlanılır.
Verianla məzmun metodu: Bu Azərbaycan dilindəki mətn mənbə PDF-in cümlə-cümlə tərcüməsi deyil. Tədqiqatın məlumat dəstləri, üz və səs təsvirləri, şəbəkə arxitekturası, kontrastiv itki, OOD hədd mexanizmi, təlim protokolu, ROC/AUROC nəticələri, miqyas təhlili, hesablama yanaşması, etik bəyanatlar və metodoloji məhdudiyyətləri qorunaraq müstəqil Azərbaycan dilində elmi mətn yaradılmışdır. Mənbədə olmayan performans, şəxs sayı, klinik/təhlükəsizlik nəticəsi və ya tətbiq uğuru əlavə edilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib