

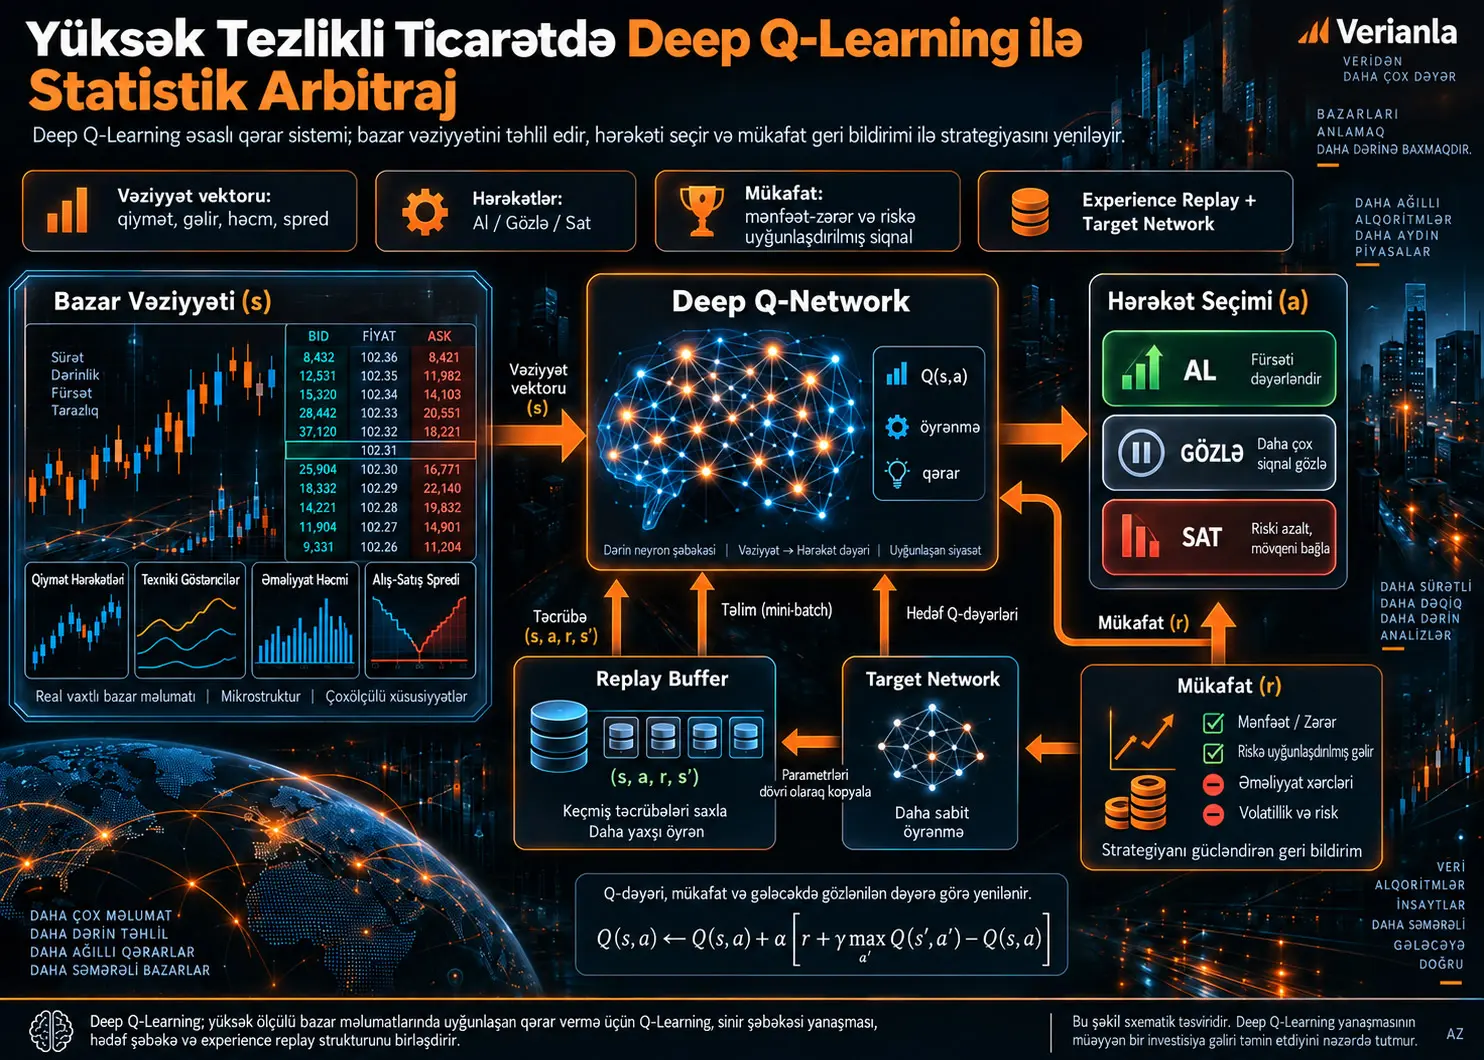
Deep Q-Learning, möhkəmləndirici öyrənmə agentinin müəyyən bazar vəziyyətində müxtəlif hərəkətlərin gözlənilən uzunmüddətli dəyərlərini dərin neyron şəbəkəsi ilə təqribi hesabladığı model-free qərar öyrənmə yanaşmasıdır. Nəzərdən keçirilən tədqiqat bu yanaşmanın yüksək tezlikli ticarətdə (High-Frequency Trading, HFT) statistik arbitraj üçün necə istifadə oluna biləcəyini Q-Learning yeniləməsi, neyron şəbəkəsi əsaslı Q-funksiyası, hədəf şəbəkə, experience replay və vəziyyət-hərəkət-mükafat dizaynı vasitəsilə izah edir. Mənbə Deep Q-Learning-in dəyişən bazar şərtlərinə uyğunlaşa biləcəyini irəli sürür; lakin PDF-nin əsas mətni bu iddianı təsdiqləyəcək ətraflı backtest məlumatları və ya kəmiyyət performans nəticələri təqdim etmir.
Təklif olunan HFT çərçivəsində bazar vəziyyəti son qiymət hərəkətləri, gəlirlər, texniki göstəricilər, ticarət həcmi və bid-ask spread kimi dəyişənlərdən ibarət ola bilər. Agent bu vəziyyətə əsasən almaq, mövqeyi saxlamaq və ya satmaq kimi hərəkətlər arasından seçim edir. Reallaşmış mənfəət/zərər və ya riskə uyğunlaşdırılmış performans mükafat siqnalına çevrilir; Q-şəbəkəsi daha sonra baş vermiş təcrübələrdən öyrənərək gələcək qərarlarını yeniləyir.
Tədqiqatın ən öyrədici cəhəti HFT problemini birdəfəlik qiymət proqnozu kimi deyil, ardıcıl qərarvermə problemi kimi nəzərdən keçirməsidir. Bununla belə, bir metodun konseptual baxımdan uyğun olması onun real bazarda iqtisadi üstünlük yaratdığını öz-özlüyündə göstərmir. Gecikmə, əmr kitabı dinamikası, əməliyyat haqları, slippage, bazar təsiri, real vaxt hesablama xərci və rejim dəyişiklikləri kimi HFT üçün kritik amillərin mənbədə empirik olaraq kəmiyyətləşdirilməməsi mühüm məhdudiyyətdir.
Yüksək tezlikli ticarət niyə ardıcıl qərarvermə problemidir?
Yüksək tezlikli ticarət sistemləri yalnız “növbəti qiymət yuxarı qalxacaq, yoxsa aşağı enəcək?” sualına cavab vermir. Ticarət agenti mövcud bazar vəziyyətini müşahidə edir, bir hərəkət seçir, bazarın növbəti vəziyyətə keçidini və əməliyyatın maliyyə nəticəsini görür, sonra yeni qərar verir. Buna görə ticarət prosesi zaman ərzində bir-biri ilə əlaqəli qərarlardan ibarət ardıcıllıqdır.
Bu quruluş möhkəmləndirici öyrənmənin əsas problem tərifi ilə uyğundur. Agent mühitdən bir vəziyyət \(s\) müşahidə edir, bir hərəkət \(a\) tətbiq edir, bir mükafat \(r\) alır və yeni vəziyyətə \(s'\) keçir. Öyrənmənin məqsədi yalnız cari əməliyyatdan əldə edilən gəliri deyil, gələcəkdə yarana biləcək mükafatları da nəzərə alan siyasət hazırlamaqdır.
Deep Q-Learning nədir?
Deep Q-Learning klassik Q-Learning-dəki vəziyyət-hərəkət dəyər funksiyasını böyük cədvəldə saxlamaq əvəzinə dərin neyron şəbəkəsi ilə təqribi hesablayan möhkəmləndirici öyrənmə metodudur; beləliklə qiymət, gəlir, həcm və bazar mikrostrukturu kimi çoxölçülü girişlərin yaratdığı geniş vəziyyət fəzalarında müxtəlif hərəkətlərin gözlənilən dəyərləri təxmin edilə bilər.
Klassik tabular Q-Learning-də hər vəziyyət-hərəkət cütü üçün ayrıca dəyər saxlanıla bilər. Lakin maliyyə bazarındakı vəziyyət çoxsaylı qiymət müşahidələri, gəlirlər, hərəkətli ortalamalar, volatillik göstəriciləri, həcm və bid-ask spread kimi dəyişənlərdən ibarət olduqda mümkün vəziyyətlərin sayı son dərəcə artır. Deep Q-Learning bu miqyas problemini neyron şəbəkəsi əsaslı funksiya aproksimasiyası ilə həll edir.
Q-Learning yeniləməsi
Mənbədə əsas Q-Learning yeniləməsi belə verilir:
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+\gamma\max_{a'}Q(s',a')-Q(s,a) \right] \]
Bu tənlikdə \(Q(s,a)\), \(s\) vəziyyətində \(a\) hərəkətinin gözlənilən ümumi dəyərini təmsil edir. \(r\), hərəkətdən sonra müşahidə olunan ani mükafatdır. \(s'\), əməliyyatdan sonra yaranan yeni vəziyyətdir. \(\max_{a'}Q(s',a')\), yeni vəziyyətdə mövcud hərəkətlər arasında ən yüksək təxmin edilən gələcək dəyəri göstərir.
\(\alpha\) öyrənmə sürətidir və yeni müşahidənin mövcud Q-dəyərini nə dərəcədə dəyişdirəcəyini müəyyən edir. \(\gamma\) diskont əmsalıdır; dəyər 1-ə yaxınlaşdıqca gələcək mükafatlara verilən çəki artır, 0-a yaxınlaşdıqca yaxın dövr mükafatı daha üstün olur.
Tənlikdə kvadrat mötərizə daxilindəki fərq mövcud Q təxmini ilə müşahidə olunan mükafat və gələcəyə dair təxminin yaratdığı hədəf arasındakı xətadır. Öyrənmə prosesi bu xətadan istifadə edərək dəyər təxminlərini təkrar-təkrar düzəldir.
Neyron şəbəkəsi Q-dəyərini necə təqrib edir?
Deep Q-Learning-də Q-dəyərləri ayrı-ayrı xanalardan ibarət cədvəldə saxlanmır. Mənbə aşağıdakı ümumi yanaşmanı verir:
\[ Q(s,a;\theta)=f(s;\theta) \]
\(\theta\) neyron şəbəkəsinin öyrənilən parametrlərini; \(s\), bazarı təmsil edən giriş vəziyyətini; \(f\), neyron şəbəkəsinin həyata keçirdiyi funksiya çevrilməsini ifadə edir. Şəbəkənin çıxışı istifadə oluna bilən hərəkətlər üçün təxmin edilən Q-dəyərlərindən ibarət vektordur.
Məsələn, hərəkət fəzası almaq, gözləmək və satmaq kimi müəyyən edilibsə, şəbəkə eyni bazar vəziyyətində bu üç hərəkət üçün üç fərqli dəyər təxmini yarada bilər. Qərar siyasəti bu təxminlərdən istifadə edərək hərəkət seçir.
Hədəf şəbəkə niyə istifadə olunur?
Deep Q-Learning-də öyrənilən şəbəkə həm cari təxmini, həm də öz öyrənmə hədəfini davamlı olaraq eyni anda dəyişərsə, təlim qeyri-sabit ola bilər. Mənbə bu problemi azaltmaq üçün periodik yenilənən ayrıca target network istifadə edilməsi yanaşmasını izah edir.
İtki funksiyası mənbədə belə verilir:
\[ L(\theta)= E\left[ \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
Burada \(\theta\) cari Q-şəbəkəsinin, \(\theta^-\) isə hədəf şəbəkənin parametrləridir. \(Q(s,a;\theta)\) cari şəbəkənin təxminidir; \(r+\gamma\max Q(s',a';\theta^-)\) isə təlimin hədəfini təşkil edir. Kvadrat fərqin gözlənilən dəyəri azaldılaraq cari şəbəkənin hədəf Q-dəyərlərinə yaxınlaşdırılması nəzərdə tutulur.
Hədəf şəbəkənin hər addımda əsas şəbəkə ilə eyni vaxtda dəyişdirilməməsi öyrənmə hədəfinin qısa müddətlər ərzində daha sabit qalmasını təmin edir. Mənbə bunu Q-Learning təlimində salınım və yayınma riskini azaldan mexanizmlərdən biri kimi təqdim edir.
Experience Replay niyə istifadə olunur?
Experience replay agentin ardıcıl bazar müşahidələrini birbaşa eyni sırada öyrənməsi əvəzinə \((s,a,r,s')\) təcrübələrini replay buffer daxilində saxlayıb təlim zamanı bu yaddaşdan təsadüfi mini-batch-lər seçməsini təmin etməklə ardıcıl nümunələr arasındakı güclü korrelyasiyanı azaltmağı və keçmiş təcrübələrin yenidən istifadəsini məqsəd qoyur.
Maliyyə zaman sıralarında bir-birini izləyən müşahidələr çox vaxt yüksək dərəcədə əlaqəlidir. Neyron şəbəkəsinin yalnız son bir neçə ardıcıl müşahidə ilə öyrədilməsi öyrənmənin dar bazar rejimindən həddindən artıq asılı olmasına səbəb ola bilər. Replay buffer müxtəlif dövrlərdən nümunələri eyni təlim qrupunda birləşdirərək nümunə müxtəlifliyini artırır.
Mənbə mini-batch yeniləməsini konseptual olaraq belə ifadə edir:
\[ \Delta\theta = E_{(s,a,r,s')\sim U(D)} \left[ \nabla_\theta \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
\(D\) replay buffer-i, \(U(D)\) bu yaddaşdan uniform nümunə götürməni, \(\Delta\theta\) isə şəbəkə parametrlərinin təlim zamanı dəyişməsini ifadə edir.
HFT üçün vəziyyət vektoru
Mənbənin təklif etdiyi HFT vəziyyət tərifi üç əsas informasiya qrupuna əsaslanır: son qiymət hərəkətləri və gəlirlər, texniki göstəricilər və bazar mikrostrukturu dəyişənləri. Ümumi vəziyyət vektoru belə göstərilir:
\[ s=[p_1,p_2,\ldots,p_n,i_1,i_2,\ldots,i_m,v,b] \]
Burada \(p\) qiymət hərəkətlərini, \(i\) texniki göstəriciləri, \(v\) ticarət həcmini və \(b\) bid-ask spread-i təmsil edir. Mənbə texniki göstərici nümunələri kimi hərəkətli ortalamaları, Bollinger Bands və Relative Strength Index-i (RSI) qeyd edir.
Bu ifadə dəqiq məlumat sxemi deyil. Məqalə neçə qiymət gecikməsinin istifadə ediləcəyini, hansı göstəricilərin seçiləcəyini, məlumatın hansı zaman rezolyusiyasında nümunələnəcəyini və ya girişlərin necə normallaşdırılacağını bildirmir.
Hərəkət fəzası
Mənbə üç əsas hərəkət müəyyən edir:
- Buy: qiymətin yüksəlməsi gözləntisi ilə aktiv almaq.
- Hold: yeni əməliyyat açmadan mövcud mövqeyi saxlamaq.
- Sell: mövqeyi azaltmaq və ya bağlamaq.
Real HFT sistemində əmr növü, qiymət səviyyəsi, miqdar, ləğv qərarı və növbə mövqeyi kimi daha detallı hərəkətlər tələb oluna bilər. Lakin mənbə bu daha geniş execution səviyyəsini modelləşdirmir.
Mükafat funksiyası
Məqalə əməliyyat mənfəətini və ya zərərini əsas mükafat komponenti kimi nəzərdən keçirir və yalnız xalis mənfəətin yüksək risk götürən siyasətləri təşviq edə biləcəyinə diqqət çəkir. Riskə uyğunlaşdırılmış mükafat konseptual olaraq:
\[ r = \frac{\text{Beklenen Getiri}} {\text{Getirilerin Standart Sapması}} \]
şəklində təqdim olunur. Bu nisbət Sharpe tipli riskə uyğunlaşdırılmış performans ideyasına yaxındır. Lakin mənbə real təlim təcrübəsində bu mükafatın hansı zaman pəncərəsində, hansı risksiz gəlir fərziyyəsi ilə və ya hansı miqyaslama üsulu ilə hesablandığını bildirmir.
Statistik arbitrajla əlaqə
Statistik arbitraj əlaqəli maliyyə alətləri və ya qiymət prosesləri arasındakı müvəqqəti nisbi yayınmaların statistik üsullarla müəyyən edilməsi və onların normallaşacağı gözləntisi əsasında əməliyyat yaradılmasına əsaslanır. Deep Q-Learning perspektivində agent yalnız sabit giriş-çıxış həddindən istifadə etmək əvəzinə bazar vəziyyətindən və keçmiş mükafatlardan öyrənərək hərəkət siyasətini uyğunlaşdırmağa çalışır.
Bu uyğunlaşma qabiliyyəti nəzəri olaraq rejim dəyişikliklərinə reaksiya vermək üstünlüyü yarada bilər. Bununla belə, maliyyə bazarlarının non-stationary olması keçmişdə öyrənilmiş Q-dəyərlərinin gələcəkdə etibarlı qalacağına zəmanət vermir. Yeni bazar rejimləri replay buffer-dəki köhnə təcrübələrlə ziddiyyət təşkil edə bilər və mükafat paylanması zamanla dəyişə bilər.
Tədqiqatın Metodu və Nəticələri
Mənbədə müəyyən edilən metodoloji komponentlər
| Komponent | Mənbədə müəyyən edilən rol | Mənbədə çatışmayan tətbiq detalı |
|---|---|---|
| Vəziyyət \(s\) | Qiymət, gəlir, texniki göstərici, həcm və bid-ask spread kimi bazar məlumatlarını təmsil edir. | Zaman rezolyusiyası, pəncərə ölçüsü, normallaşdırma və dəqiq xüsusiyyət dəsti verilməyib. |
| Hərəkət \(a\) | Buy, Hold və Sell qərarları. | Əmr miqdarı, limit/market əmr fərqi və execution detalları verilməyib. |
| Mükafat \(r\) | Mənfəət/zərər və ya riskə uyğunlaşdırılmış gəlir. | Real tətbiqdə istifadə olunan dəqiq mükafat funksiyası və parametrləri verilməyib. |
| Q-Learning | Bellman əsaslı dəyər yeniləməsi ilə uzunmüddətli mükafatı öyrənir. | \(\alpha\) və \(\gamma\) üçün real təcrübə dəyərləri bildirilməyib. |
| Q-network | Yüksək ölçülü vəziyyətdən hərəkət Q-dəyərlərini təxmin edir. | Layların sayı, neyronların sayı, aktivləşdirmə funksiyaları və optimizer verilməyib. |
| Target network | Öyrənmə hədəfini daha sabit saxlamaq üçün ayrıca Q-təxmini təmin edir. | Yeniləmə tezliyi açıqlanmayıb. |
| Replay buffer | Keçmiş təcrübələri saxlayır və təsadüfi mini-batch təliminə imkan verir. | Buffer tutumu, batch size və sampling detalları bildirilməyib. |
| İtki funksiyası | Cari Q təxmini ilə hədəf Q arasındakı kvadrat fərqi azaldır. | Təlim müddəti, convergence meyarı və öyrənmə əyriləri verilməyib. |
Məqalə Deep Q-Learning-in HFT-də daha gəlirli olduğunu sübut edirmi?
Xeyr; mənbənin xülasəsində simulyasiya və backtestlərin adaptasiya, gəlirlilik və riskə uyğunlaşdırılmış gəlirlər baxımından müsbət nəticələr verdiyi irəli sürülsə də, məqalənin əsas mətnində bu iddianı müstəqil qiymətləndirməyə imkan verən məlumat dəsti, backtest dövrü, benchmark, PnL, Sharpe nisbəti, drawdown, əməliyyat xərci və ya statistik əhəmiyyət nəticələri bildirilmir.
Bu fərq tədqiqatın şərhində mərkəzi əhəmiyyət daşıyır. Mənbə Deep Q-Learning-in HFT statistik arbitrajına necə uyğunlaşdırıla biləcəyini izah edir və metodun potensial üstünlüklərini müzakirə edir. Lakin mövcud PDF metodun müəyyən bazar məlumatlarında müəyyən benchmark-ı kəmiyyət baxımından üstələdiyini göstərəcək təkrar istehsal oluna bilən empirik sübut təqdim etmir.
Xülasə ilə əsas mətn arasındakı sübut fərqi
Xülasə “extensive simulations and backtests” ifadəsindən istifadə edir və gəlirlilik metrikləri ilə riskə uyğunlaşdırılmış gəlirlərdə yaxşılaşma olduğunu bildirir. Buna qarşılıq mənbənin əsas mətnində ayrıca məlumat, təcrübə, nəticə və ya backtest bölməsi yoxdur. Rəqəmsal gəlir sırası, performans cədvəli və ya model müqayisəsi verilməyib.
Buna görə Verianla baxımından təhlükəsiz elmi ifadə belədir: tədqiqat Deep Q-Learning-i HFT statistik arbitrajı üçün konseptual olaraq əsaslandırır və tətbiq oluna bilən arxitektura təklif edir; lakin bu PDF-nin təqdim etdiyi sübut səviyyəsi metodun real iqtisadi üstünlüyünü kəmiyyət baxımından təsdiqləmək üçün kifayət deyil.
Təkrar istehsal oluna bilmə baxımından çatışmazlıqlar
- İstifadə olunan maliyyə bazarı və ya aktivlər məcmusu göstərilməyib.
- Tick, trade və ya limit-order-book məlumat mənbəyi verilməyib.
- Train, validation və test dövrləri bildirilməyib.
- Out-of-sample qiymətləndirmə protokolu verilməyib.
- Q-network arxitekturası göstərilməyib.
- Learning rate, discount factor, batch size və replay-buffer tutumu verilməyib.
- Epsilon-greedy və ya başqa exploration siyasətinin parametrləri göstərilməyib.
- Target network yeniləmə tezliyi verilməyib.
- Əməliyyat komissiyaları, bid-ask xərci, slippage və market impact modelləşdirilməyib.
- Latency və ya ticarət infrastrukturu xərci bildirilməyib.
- Müqayisə benchmark-ları verilməyib.
- Sharpe ratio, maximum drawdown, turnover və ya PnL sırası bildirilməyib.
Tədqiqatın dəstəklədiyi nəticə
Mənbə Deep Q-Learning-in yüksək ölçülü bazar vəziyyətlərini neyron şəbəkəsi ilə təmsil etmək, hərəkət dəyərlərini Q-Learning prinsipi ilə yeniləmək, replay buffer vasitəsilə keçmiş təcrübələrdən yenidən öyrənmək və target network ilə təlim hədəfini sabitləşdirmək üçün məntiqi HFT çərçivəsi təqdim etdiyini dəstəkləyir.
Tədqiqatın dəstəkləmədiyi nəticə
Mənbə bu arxitekturanın müəyyən birja, aktiv, ticarət dövrü və ya real vaxt HFT infrastrukturunda statistik olaraq üstün gəlir verdiyini, əməliyyat xərclərindən sonra gəlirli qaldığını və ya klassik statistik arbitraj üsullarından daha yaxşı olduğunu kəmiyyət baxımından göstərmir.
Mənbə və Metod Qeydi
Özgün tədqiqat: Harnessing Deep Q-Learning for Enhanced Statistical Arbitrage in High-Frequency Trading: A Comprehensive Exploration.
Müəllif: Soumyadip Sarkar.
Mənbə: arXiv:2311.10718v1, q-fin.TR.
Tarix: 13 sentyabr 2023.
Daimi identifikator: 10.48550/ARXIV.2311.10718.
Mənbə növü: arXiv preprint; mənbədə resenziyalı jurnal/konfrans nəşri haqqında məlumat verilmir.
İnstitusional afiliyasiya: Mənbə PDF-də müəllif üçün institusional afiliyasiya göstərilməyib, yalnız əlaqə e-poçt ünvanı verilib.
Lisenziya: Araşdırılan PDF və biblioqrafik qeydlərdə müəyyən açıq lisenziya təsdiqlənmədiyindən Verianla mətni mənbənin ifadəsini yenidən yayımlamaq əvəzinə elmi anlayışları müstəqil öyrədici quruluşda izah edir.
Məlumat əlçatanlığı: Mənbə müəyyən məlumat dəsti və ya məlumat deposu göstərmir.
Maliyyələşdirmə və maraqlar toqquşması: PDF-də açıq maliyyələşdirmə və ya maraqlar toqquşması bəyanatı yoxdur.
Əsas metodoloji məhdudiyyət: Mənbədə Deep Q-Learning-in riyazi və konseptual komponentləri izah edilsə də, empirik tətbiqin yenidən qurulması üçün tələb olunan məlumat, hiperparametrlər, təlim quruluşu və performans nəticələri təqdim edilməyib.
Maliyyə şərhi sərhədi: Bu Verianla məzmunu ticarət strategiyası təklifi və ya investisiya tövsiyəsi deyil; mənbə tədqiqatın metodoloji quruluşunu və sübut sərhədlərini izah edən elmi tədris mətnidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib