

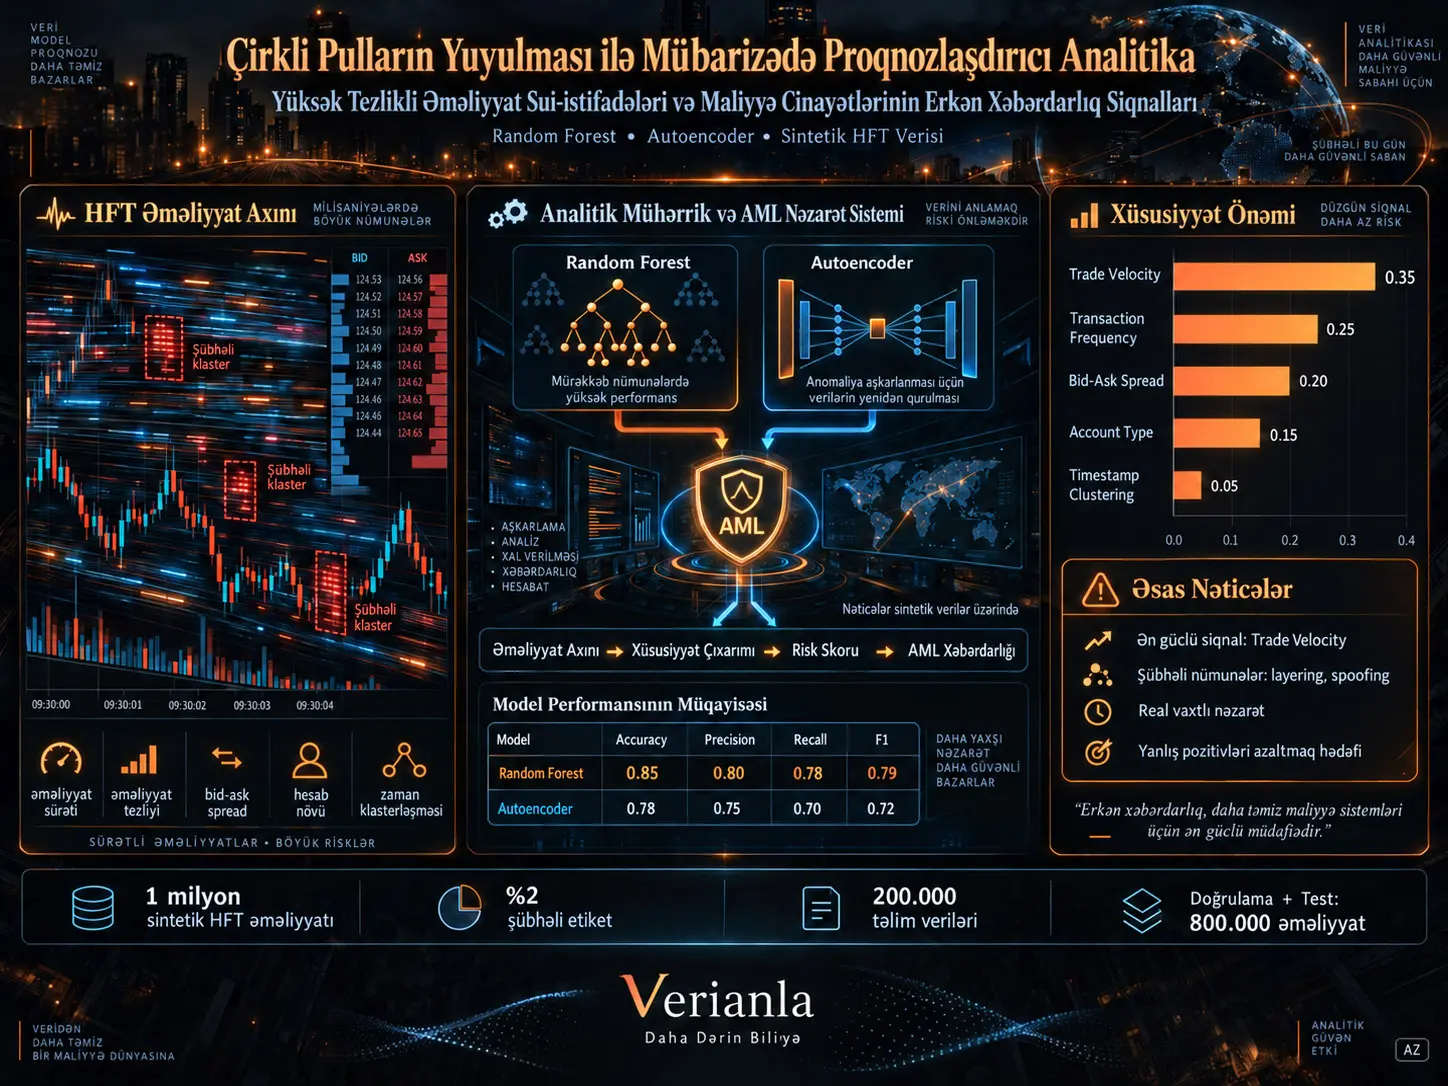
Bu tədqiqat yüksək tezlikli ticarət (HFT) mühitlərində yarana biləcək şübhəli əməliyyat nümunələrini proqnozlaşdırıcı analitika və maşın öyrənməsi istifadə etməklə aşkarlamağa yönəlmiş anti-money laundering (AML) çərçivəsi təklif edir. Random forest kimi nəzarətli öyrənmə üsulları ilə autoencoder əsaslı anomaliya aşkarlanmasının müqayisə edildiyi tədqiqatda; əməliyyat sürəti, əməliyyat tezliyi, bid-ask spread, hesab tipi və zaman möhürü üzrə qruplaşma kimi xüsusiyyətlər maliyyə cinayəti baxımından erkən xəbərdarlıq siqnalları kimi modelləşdirilir.
Tədqiqatda istifadə olunan məlumatlar real birja araşdırma qeydlərindən ibarət deyil. Tədqiqatçı, Yanvar 2017–Dekabr 2018 dövrünü təmsil edəcək şəkildə 1 milyon əməliyyatdan ibarət hipotetik, lakin realistik hesab edilən sintetik qlobal səhm HFT məlumat dəsti yaratmışdır. Əməliyyatların %2'si layering və ya spoofing bənzəri nümunələrə əsasən şübhəli kimi etiketlənmiş, 200.000 əməliyyat təlim üçün istifadə edilmiş, qalan 800.000 əməliyyat doğrulama və test dəstlərinə bərabər şəkildə bölünmüşdür.
Mənbədə random forest modeli %85 accuracy, %80 precision, %78 recall və %79 F1-score əldə edərkən autoencoder modeli müvafiq olaraq %78, %75, %70 və %72 göstəricilərinə çatır. Random forest modelində ən yüksək dəyişən əhəmiyyəti 0,35 ilə trade velocity, yəni saniyə başına əməliyyat intensivliyinə verilmişdir.
Bu performans rəqəmlərinin real AML əməliyyatında təsdiqləndiyi nəticəsinə gəlmək olmaz. Sintetik məlumat real bazarlardakı çatışmayan məlumatlar, yanlış etiketlər, fərqli bazar rejimləri, əmr ləğvləri, venue fragmentation və cinayət davranışının qəsdən dəyişdirilməsi kimi problemləri tam şəkildə təmsil etməyə bilər. Tədqiqat da bu məhdudiyyəti açıq şəkildə qəbul edir.
Yüksək tezlikli ticarət AML baxımından niyə araşdırılır?
Yüksək tezlikli ticarət çox qısa zaman intervallarında avtomatik şəkildə böyük miqdarda əmr və əməliyyat yarada bilər. Bu sürət və həcm ənənəvi sabit həddli AML sistemləri üçün mühüm məlumat emalı problemi yaradır. Normal HFT strategiyası belə saniyələr və ya millisaniyələr ərzində minlərlə mesaj yarada bildiyi üçün yalnız əməliyyat sayına əsaslanan sadə qaydalar çoxlu sayda yanlış xəbərdarlıq yarada bilər.
Tədqiqatın əsas yanaşması sabit AML qaydaları əvəzinə məlumat daxilindəki çoxdəyişənli nümunələri öyrənən modellərdən istifadə etməkdir. Beləliklə, tək bir “əməliyyat sayı həddi” əvəzinə əməliyyat intensivliyi, tezlik, spread davranışı, hesab növü və zaman üzrə qruplaşma birlikdə qiymətləndirilir.
Proqnozlaşdırıcı Analitika Ənənəvi AML Qaydalarından Necə Fərqlənir?
Qayda əsaslı AML sistemləri əvvəlcədən müəyyən edilmiş hədlər və ssenarilər üzrə xəbərdarlıq yaradırsa, proqnozlaşdırıcı analitika keçmişdə və ya sintetik şəkildə etiketlənmiş nümunələrdən statistik əlaqələri öyrənir. Nəzarətli model məlum şübhəli nümunələri təsnif etməyə çalışarkən nəzarətsiz model əvvəllər etiketlənməmiş qeyri-adi davranışları anomaliya kimi işarələyə bilər.
Tədqiqat buna görə iki fərqli yanaşmanı müqayisə edir:
| Model | Öyrənmə növü | Tədqiqatdakı rolu |
|---|---|---|
| Random Forest | Nəzarətli öyrənmə | Etiketlənmiş normal və şübhəli əməliyyatların təsnifləndirilməsi |
| Autoencoder | Nəzarətsiz / anomaliya əsaslı yanaşma | Normal nümunədən yayınmaların aşkarlanması |
Random forest məlum və etiketlənmiş nümunələrdə daha yüksək performans göstərir. Autoencoder isə daha aşağı ümumi performansa baxmayaraq, əvvəllər müəyyən edilməmiş anomaliyaların aşkarlana biləcəyi tamamlayıcı mexanizm kimi müzakirə olunur.
Sintetik məlumat necə yaradılır?
Mənbə qlobal səhm bazarını təmsil edən 1 milyon HFT əməliyyatı yaradır. Məlumat strukturu NASDAQ-a bənzər açıq bazar məlumatlarından, SEC tənzimləyici hesabatlarından və FATF tipologiyalarından ilhamlanaraq hazırlanmışdır. Müxtəliflik təmin etmək məqsədilə Monte Carlo əsaslı sintetik məlumat yaradılmasından bəhs edilir.
Hər əməliyyatda istifadə olunan əsas dəyişənlər bunlardır:
- əməliyyat həcmi,
- əməliyyat tezliyi,
- bid-ask spread,
- hesab tipi,
- timestamp,
- törədilmiş trade velocity,
- zaman qruplaşması ilə əlaqəli göstəricilər.
Mənbədə əməliyyatların təxminən %2'sinin layering və ya spoofing bənzəri şübhəli nümunələr daşıyacaq şəkildə etiketləndiyi bildirilir.
Sintetik Məlumat Niyə Mühüm Məhdudiyyətdir?
Sintetik məlumat model hazırlamaq və nəzarətli müqayisələr aparmaq üçün faydalıdır; lakin real bazarlardakı davranışların bütün mürəkkəbliyini ehtiva etmir. Real HFT məlumatlarında çatışmayan qeydlər, venue routing, market-maker davranışları, əmr ləğvləri, fərqli likvidlik rejimləri, xəbər hadisələri, hesablararası əlaqələr və yanlış və ya natamam AML etiketləri ola bilər.
Buna görə tədqiqatdakı %85 accuracy dəyəri real maliyyə institutunun canlı AML sistemində gözlənilən performans kimi istifadə edilməməlidir. Bu rəqəm tədqiqatçının qurduğu sintetik məlumat və etiketləmə çərçivəsi daxilində random forest modelinin test performansıdır.
Nümunələmə və məlumatın bölünməsi
Tədqiqatda təlim üçün stratified sampling istifadə olunur. Ümumi 1 milyon əməliyyatdan 200.000 əməliyyat modelin təlimi üçün seçilir. Təbəqələşdirmə hesab növünə və əməliyyat həcminə görə aparılır.
Qalan 800.000 əməliyyat bərabər şəkildə iki hissəyə bölünərək:
- 400.000 doğrulama müşahidəsi,
- 400.000 test müşahidəsi
kimi istifadə olunur.
Tədqiqatçı təkrarlana bilmə üçün random seed dəyərinin 42 olaraq sabitləndiyini bildirir.
İstifadə olunan hesablama alətləri
Nəzarətli modellər üçün scikit-learn, autoencoder tətbiqi üçün TensorFlow və böyük həcmli məlumat emalı üçün Apache Spark istifadə edildiyi bildirilir. Model performansı accuracy, precision, recall və F1-score üzrə qiymətləndirilir.
Bu alətlərin istifadə olunması təkbaşına modelin real vaxt istehsal mühitinə hazır olduğunu göstərmir. Real vaxt HFT nəzarəti gecikmə, throughput, məlumat bütövlüyü, model drift'i və izah ediləbilənlik kimi əlavə tələblər daşıyır.
Tədqiqatın Metodu və Nəticələri
Random forest və autoencoder performansı
| Model | Accuracy | Precision | Recall | F1-Score |
|---|---|---|---|---|
| Random Forest | 0,85 | 0,80 | 0,78 | 0,79 |
| Autoencoder | 0,78 | 0,75 | 0,70 | 0,72 |
Mənbənin Cədvəl 1 nəticələrində random forest bütün dörd performans ölçüsündə autoencoder-dan üstündür. Accuracy fərqi 7 faiz bəndi, recall fərqi 8 faiz bəndi və F1 fərqi 7 faiz bəndidir.
Burada accuracy təkbaşına kifayət edən qiymətləndirmə ölçüsü deyil. Məlumat dəstinin yalnız %2'sinin şübhəli kimi etiketləndiyi bildirilir; buna görə ciddi sinif balanssızlığının olduğu AML problemində precision, recall, F1 və sinif üzrə xəta bölgüsü xüsusilə vacibdir.
AML Modelində Ən Mühüm Erkən Xəbərdarlıq Göstəriciləri Hansılardır?
Random forest modelinin mənbədə bildirilən feature importance dəyərləri aşağıdakılardır:
| Xüsusiyyət | Importance |
|---|---|
| Trade Velocity | 0,35 |
| Transaction Frequency | 0,25 |
| Bid-Ask Spread | 0,20 |
| Account Type | 0,15 |
| Timestamp Clustering | 0,05 |
Modelin ən güclü xüsusiyyəti trade velocity kimi bildirilmişdir. Bu dəyişən müəyyən zaman vahidində baş verən əməliyyat intensivliyini təmsil edir. Ardınca transaction frequency və bid-ask spread gəlir.
Feature importance dəyəri dəyişənin təkbaşına cinayətin səbəbi olduğunu və ya müəyyən əməliyyat sürətinin avtomatik olaraq şübhəli sayılmalı olduğunu göstərmir. Random forest əhəmiyyət ölçüləri model daxilində proqnoza töhfəni göstərir və dəyişənlər arasında korrelyasiya olduqda iqtisadi şərhlər ehtiyatla aparılmalıdır.
Model təlimi boyunca dəqiqlik
Mənbənin Figure 1 qrafikində random forest modelinin accuracy dəyəri beş təlim iterasiyasında təxminən %75-dən %85-ə yüksəlir. Autoencoder isə təxminən %70-dən %78-ə qalxır.
Bu vizual random forest modelinin verilən sintetik ssenaridə daha sürətli və daha yüksək performans səviyyəsinə çatdığını göstərir. Bununla belə, “training iteration” anlayışının alqoritmik olaraq necə qurulduğu mənbədə ətraflı izah edilmir; buna görə qrafik klassik epoch-based learning curve ilə tam eyniləşdirilməməlidir.
Yanlış pozitivlər barədə nə bildirilir?
Nəticələr bölməsində təklif olunan yanaşmanın ənənəvi rule-based sistemlərlə müqayisədə yanlış pozitivləri %25 azaltdığı bildirilir. Lakin bu nəticə üçün ayrıca cədvəl, confusion matrix və ya birbaşa eksperimental müqayisə mənbədə göstərilmir.
Buna görə %25 rəqəmi tədqiqatın nəticə bölməsində müəllif bəyanı kimi təqdim oluna bilər; müstəqil şəkildə yenidən hesablanmış və ya ətraflı eksperimental cədvəllə təsdiqlənmiş nəticə kimi təqdim edilməməlidir.
Real vaxtda aşkarlama müddəti
Mənbə nəticə bölməsində detection delay-in %40 azaldıla bildiyini də bildirir. Lakin eyni paraqraf bu nəticəni Wang və həmkarlarının əvvəlki nəticələri ilə əlaqələndirir və hazırkı tədqiqatda bunun üçün müstəqil gecikmə benchmark cədvəli təqdim edilmir.
Buna görə %40 gecikmə azalması dəyəri də hazırkı sintetik eksperimentin birbaşa ölçülmüş əsas nəticələrindən biri kimi qiymətləndirilməməlidir.
Layering və Spoofing Çirkli Pulların Yuyulması ilə Eyni Şeydirmi?
Xeyr. Layering və spoofing adətən əmr kitabçasına yanıltıcı əmrlərlə təsir göstərilməsi və ya bazar iştirakçılarının yanlış qiymət/likvidlik siqnalları ilə istiqamətləndirilməsi ilə əlaqəli bazar manipulyasiyası davranışlarıdır. Çirkli pulların yuyulması isə cinayət gəlirinin mənbəyini və sahibliyini gizlətmə prosesidir.
Mənbə bu davranışları daha geniş “financial crime” və AML erkən xəbərdarlıq çərçivəsində birlikdə nəzərdən keçirir. Lakin spoofing və ya layering xəbərdarlığı təkbaşına money laundering sübutu deyil. AML sistemində bu cür davranışlar yalnız hesablararası fond axını, beneficial ownership, müştəri profili və digər əməliyyat kontekstləri ilə birlikdə qiymətləndirilməlidir.
Nəzarətli və nəzarətsiz modellər birlikdə istifadə oluna bilərmi?
Tədqiqatın müzakirə bölməsində hibrid sistem təklif olunur. Random forest keçmişdə etiketlənmiş məlum nümunələrdə yüksək təsnifat performansı təmin edə bildiyi halda autoencoder əvvəllər görünməmiş anormal davranışları aşkarlamaq üçün istifadə oluna bilər.
Təklif olunan ümumi arxitektura belə təsəvvür edilə bilər:
Canlı əməliyyat axını → xüsusiyyət çıxarılması → anomaliya skanı → supervised risk balı → AML analitiki tərəfindən baxış
Lakin mənbə bu hibrid sistemi eksperimental olaraq qurub ayrıca performans metrikləri ilə sınaqdan keçirmir. Buna görə hibrid yanaşma tədqiqatın gələcəyə yönəlik təklifidir.
İzah ediləbilənlik problemi
AML qərarlarının tənzimləyicilər və uyğunluq komandaları tərəfindən izah edilə bilən olması lazımdır. Random forest kimi modellər sadə hədd əsaslı qaydalarla müqayisədə daha mürəkkəb qərar əlaqələri yarada bilər.
Mənbə gələcəkdə SHAP kimi izah edilə bilən süni intellekt üsullarının istifadə olunmasını təklif edir. Beləliklə, bir xəbərdarlığın hansı əməliyyat xüsusiyyətlərindən nə dərəcədə təsirləndiyi analitiklərə göstərilə bilər.
Tədqiqatın dəstəklədiyi nəticələr
- Sintetik HFT məlumat dəstində random forest, autoencoder-dan daha yüksək accuracy, precision, recall və F1-score əldə etmişdir.
- Random forest accuracy dəyəri 0,85 kimi bildirilmişdir.
- Trade velocity, random forest modelində 0,35 ilə ən yüksək feature importance dəyərinə malikdir.
- Transaction frequency və bid-ask spread növbəti ən mühüm dəyişənlərdir.
- Nəzarətsiz anomaliya aşkarlanması etiketlənməmiş nümunələr üçün tamamlayıcı yanaşma kimi müzakirə olunur.
- Real vaxt AML nəzarətində böyük məlumat infrastrukturu və yüksək sürətli xüsusiyyət çıxarılmasının vacib olduğu müdafiə edilir.
Tədqiqatın dəstəkləmədiyi nəticələr
- %85 accuracy real dünya HFT AML sistemlərində təsdiqlənmiş uğur göstəricisi deyil.
- Tədqiqat real bir milyon birja əməliyyatından istifadə etmir; məlumat sintetikdir.
- Hər yüksək trade velocity dəyəri çirkli pulların yuyulması göstəricisi deyil.
- Layering və ya spoofing aşkarlanması təkbaşına çirkli pulların yuyulmasının aşkarlanması demək deyil.
- Mənbədə real canlı-birja latency benchmark-ı təqdim edilmir.
- %25 false-positive azalması və %40 detection-delay azalması ətraflı eksperimental cədvəllə müstəqil şəkildə göstərilmir.
- Nəticələr kripto, törəmə, FX və ya başqa bazarlara birbaşa ümumiləşdirilə bilməz; məlumat dizaynı səhm HFT mühitinə yönəlib.
Metodoloji məhdudiyyətlər
Birinci məhdudiyyət: Məlumat sintetikdir. Sintetik əməliyyatlar tədqiqatçının fərziyyələrini əks etdirdiyi üçün model eyni fərziyyələri öyrənə bilər və real bazarda performans azala bilər.
İkinci məhdudiyyət: Şübhəli etiketlərin keçmiş AML araşdırmalarından ilhamlanaraq yaradıldığı qəbul edilsə də real etiketlənmiş araşdırma məlumatlarından istifadə olunmur.
Üçüncü məhdudiyyət: Məlumat dəstindəki yalnız %2-lik şübhəli sinif ciddi class imbalance yaradır. Buna baxmayaraq mənbə ROC-AUC, PR-AUC, confusion matrix və ya class-weight təsirlərini bildirmir.
Dördüncü məhdudiyyət: HFT ilə bazar manipulyasiyası və money laundering anlayışları bəzi bölmələrdə bir-birinə olduqca yaxın şəkildə işlədilir. Bu davranışlar hüquqi və əməliyyat AML baxımından fərqli araşdırma növləri tələb edə bilər.
Beşinci məhdudiyyət: Real vaxt tətbiqinin hesablama infrastrukturu Apache Spark üzərindən müzakirə edilsə də end-to-end gecikmə, throughput və peak-load testi təqdim edilmir.
Altıncı məhdudiyyət: Mənbələr siyahısındakı bəzi qeydlərin ədəbiyyat bölməsindəki istinadlarla tam uyğun gəlməməsi və bəzi biblioqrafik qeydlərin tarix/mövzu baxımından diqqət tələb etməsi, məqalədəki xarici ədəbiyyat iddialarının ayrıca yoxlanmasını zəruri edir.
Mənbə və Metod Qeydi
Orijinal başlıq: Predictive Analytics in Anti-Money Laundering for Detecting High-Frequency Trading Abuses and Identifying Early Warning Signs of Financial Crime
Müəllif: Bharat Bhanushali.
PDF-dəki afiliyasiya: BNP Paribas, Vice President, Jersey City, New Jersey, USA.
Nəşr: International Journal of Research in Electronics and Computer Engineering (IJRECE).
Cild / Say: Vol. 7, Issue 1.
Dövr: January–March 2019.
ISSN: 2393-9028 (Print), 2348-2281 (Online).
Səhifələr: 1273–1279.
Tədqiqat növü: Sintetik məlumat üzərində maşın öyrənməsinə əsaslanan AML/HFT metod tədqiqatı.
Məlumat: 1 milyon sintetik HFT əməliyyatı; Yanvar 2017–Dekabr 2018 dövrünü təmsil edəcək şəkildə yaradılmışdır.
Şübhəli əməliyyat nisbəti: %2.
Təlim: 200.000 əməliyyat.
Doğrulama: Təxminən 400.000 əməliyyat.
Test: Təxminən 400.000 əməliyyat.
Əsas modellər: Random forest və autoencoder.
Proqramlaşdırma / hesablama: scikit-learn, TensorFlow və Apache Spark.
Random seed: 42.
Əsas performans: Random forest accuracy 0,85; precision 0,80; recall 0,78; F1 0,79. Autoencoder accuracy 0,78; precision 0,75; recall 0,70; F1 0,72.
Ən mühüm feature: Trade Velocity — 0,35 importance.
Məlumat əlçatanlığı: Məqalə kod və sintetik məlumat şablonlarının tələb əsasında təqdim edilə biləcəyini bildirir.
Müəllif hüququ / lisenziya: Araşdırılan PDF-də açıq Creative Commons və ya başqa təkrar istifadə lisenziyası göstərilmir. Buna görə mənbə cədvəl və qrafiklərinin birbaşa təkrar istifadəsində icazə olduğu fərz edilməməlidir.
Əsas şərh həddi: Nəticələr sintetik məlumat üzərində əldə edilmişdir və real bazar AML effektivliyi kimi ümumiləşdirilməməlidir.
Biblioqrafik keyfiyyət qeydi: Mənbələr siyahısında ədəbiyyat bölməsindəki bəzi istinadlarla uyğun gəlməyən və ya mövzu/tarix baxımından ayrıca yoxlanması lazım olan qeydlər vardır. Buna görə Verianla mətni xarici istinadların düzgünlüyünü təsdiqləmir, yalnız PDF-in öz metod və nəticələrini təqdim edir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib