

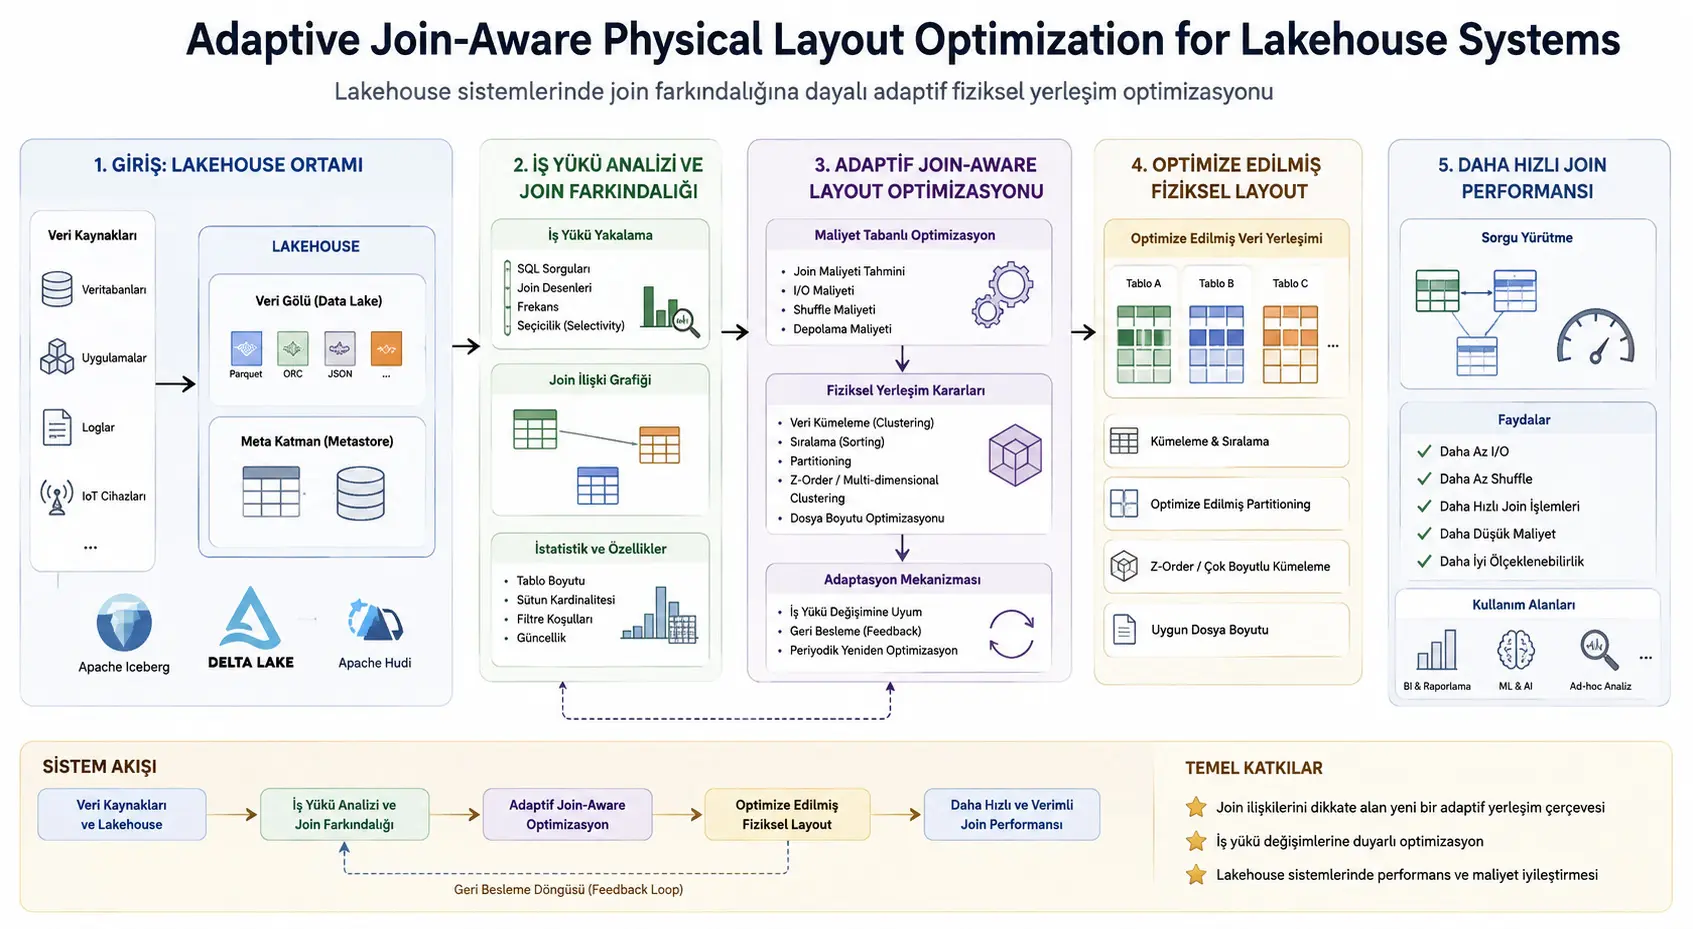
Bu tədqiqat açıq mənbəli Delta Lake üzərində cədvəllərin hansı sütunlara görə fiziki olaraq klasterləşdiriləcəyini sorğu tarixçəsindən avtomatik seçən AJLO adlı sistem təklif edir. AJLO müəyyən zaman aralığında işlədilən sorğuları təhlil edərək cədvəllər arasındakı birləşdirmə əlaqələrindən çəkili qraf qurur; hər əlaqəni sorğu tezliyini, məlumat həcmini və icra xərcini birlikdə qiymətləndirən Birləşdirmə Əhəmiyyət Balı ilə sıralayır. Sonra məhdud yenidən yazma büdcəsi daxilində tez-tez birlikdə istifadə olunan cədvəllər üçün uyğun Liquid Clustering açarları seçir.
TPC-H Miqyas Faktoru 1 üzərində aparılan təcrübələrdə AJLO bütün sorğuların ortalamasında sorğu başına skan edilən məlumat miqdarını 46 MB səviyyəsinə endirib. Heç bir əməliyyat tətbiq edilməmiş Delta Lake düzənində bu göstərici 51 MB, tarix kimi cədvələ məxsus filtr sütunlarında statik klasterləşdirilmiş düzəndə isə 117 MB olaraq bildirilib. Birləşdirmə ağırlıqlı Q01–Q07 sorğularında AJLO statik filtr sütunu klasterləşdirməsinə nisbətən skan edilən bayt miqdarını yüzde 86,7 azaldıb. Orta sorğu gecikməsi AJLO-da 0,6 saniyə, statik klasterləşdirmədə 1,0 saniyə və düzənlənməmiş ilkin quruluşda 1,2 saniyədir.
AJLO-nun əsas üstünlüyü hər cədvəli müstəqil şəkildə düzənləmək əvəzinə eyni birləşdirmə açarından istifadə edən cədvəlləri birlikdə qiymətləndirməsidir. Bununla belə sistem Spark məlumat mübadiləsi və ya shuffle əməliyyatını aradan qaldırmır. Qazanc birləşdirmə başlamazdan əvvəl minimum–maksimum fayl statistikaları sayəsində daha çox faylın ötürülməsi və mübadilə mərhələsinə daha az məlumatın çatmasından yaranır. Yanaşma xüsusilə iki böyük cədvəlin Sort-Merge Join ilə birləşdirildiyi sorğulara yönəlib; kiçik cədvəlin bütünlüklə yayımlandığı Broadcast Hash Join əməliyyatlarında eyni fiziki yerləşim faydası gözlənilmir.
Türkiyə baxımından: AJLO yanaşması açıq mənbəli Apache Spark və Delta Lake istifadə edən Türkiyədəki bankçılıq, telekommunikasiya, e-ticarət, logistika, dövlət analitikası və böyük məlumat platformalarında fiziki cədvəl yerləşiminin avtomatik qiymətləndirilməsi üçün araşdırıla bilər. Lakin tədqiqat təxminən 1 GB həcmində TPC-H məlumatını tək noutbukda araşdırıb. Türkiyədəki istehsal mühitlərinə köçürülməzdən əvvəl terabayt və ya petabayt miqyaslı paylanmış klasterlərdə, qurumun real sorğu tarixçəsi ilə, yenidən yazma xərcləri və eyni vaxtlı məlumat yükləmə prosesləri daxil edilməklə doğrulanmalıdır. Tədqiqatdan müəyyən türk qurumunun yüzde 86,7 daha az məlumat skan edəcəyi və ya sorğularının yüzde 40 sürətlənəcəyi nəticəsi birbaşa çıxarıla bilməz.
Lakehouse sistemlərində fiziki yerləşim problemi nədir?
Lakehouse arxitekturası məlumat göllərinin aşağı xərcli və açıq fayl quruluşunu məlumat anbarlarının əməliyyat etibarlılığı və sorğu imkanları ilə birləşdirməyi hədəfləyir. Delta Lake bu quruluşda əsasən Parquet fayllarından istifadə edir və hər fayl üçün sütunların minimum və maksimum dəyərləri kimi statistikaları saxlayır. Sorğudakı şərt müəyyən faylın dəyər aralığı ilə kəsişmirsə Spark həmin faylı oxumadan ötürə bilər. Bu mexanizm file skipping, yəni fayl ötürmə adlanır.
Liquid Clustering oxşar açar dəyərlərinə malik sətirləri Hilbert əyrisinin lokallığından istifadə edərək yaxın fayllarda toplamağa çalışır. Məsələn, sifariş cədvəli sifariş tarixinə görə klasterləşdirilərsə müəyyən tarix aralığını istəyən sorğular çox sayda faylı ötürə bilər. Lakin eyni cədvəl sifariş nömrəsinə görə filtr olunub başqa cədvəllə sifariş nömrəsi üzərindən birləşdirildikdə tarix düzəni fayda verməyə bilər; eyni sifariş açarı aralığı demək olar ki, bütün tarix fayllarına yayılmış ola bilər.
Buna görə “ən çox filtr olunan sütunu seç” yanaşması birləşdirmə ağırlıqlı analitik iş yüklərində səhv fiziki yerləşim yarada bilər. Üstəlik düzgün sütun zamanla dəyişə bilər. Bu gün sifariş tarixi sorğuları üstünlük təşkil etdiyi halda növbəti dövrdə sifariş–mövqe və ya müştəri–sifariş birləşdirmələri dominant ola bilər.
Tədqiqatın qiymətləndirdiyi açıq mənbəli Delta Lake düzənində dəyişən sorğu nümunələrinə görə Liquid Clustering açarlarını avtomatik və cədvəllərarası koordinasiyalı şəkildə seçən mexanizmin olmadığı qəbul edilir. AJLO bu boşluğu sorğu tarixçəsindən öyrənilən birləşdirmə qrafı ilə doldurmağı hədəfləyir.
Birləşdirmə açarına görə ortaq klasterləşdirmə niyə vacibdir?
Bir sorğu orders və lineitem cədvəllərini orderkey üzərindən birləşdirir və eyni açarda seçici interval şərti tətbiq edirsə, hər iki cədvəlin bu açara görə klasterləşdirilməsi hər iki tərəfdə fayl ötürməni mümkün edə bilər. Yalnız bir cədvəlin və ya hər iki cədvəlin əlaqəsiz tarix sütunlarına görə klasterləşdirilməsi eyni faydanı vermir.
Tədqiqat əlaqəni “skan baxımından hizalanmış” saymaq üçün iki cədvəlin fiziki yerləşiminin eyni birləşdirmə sütununu dəstəkləməsini şərt qoyur. Hər cədvəlin yerləşimi aşağıdakı strategiya vektoru ilə göstərilir:
\[ \lambda(t)=\langle P_t,C_t\rangle \]
- \(P_t\), cədvəlin qovluq əsaslı bölmə sütunu və ya boş dəyərdir.
- \(C_t\), Liquid Clustering sütun çoxluğu və ya boş dəyərdir.
Delta Lake-də PARTITIONED BY ilə CLUSTER BY eyni cədvəldə eyni vaxtda istifadə olunan iki müstəqil yerləşim forması deyil. Planlaşdırıcı buna görə mövcud yerləşimi dəyişdirmə xərcini də nəzərə almalıdır.
AJLO arxitekturası hansı komponentlərdən ibarətdir?
Tədqiqatın 6. səhifəsindəki Şəkil 1 sistemi davamlı geribildirim dövründə işləyən altı əsas komponentlə göstərir:
- Query Log Collector – QLC: SparkListener vasitəsilə tamamlanmış sorğuların SQL mətnini, məntiqi planını, icra statistikalarını və zaman damğasını toplayır. Standart sürüşən pəncərə yeddi gündür.
- Join Graph Builder – JGB: Sorğu mətnini birbaşa təhlil etmək əvəzinə Spark-ın həll edilmiş məntiqi planından bərabərlik əsaslı birləşdirmə əlaqələrini çıxarır.
- Relationship Importance Estimator – RIE: Hər birləşdirmə kənarı üçün tezlik, məlumat həcmi və xərc ölçülərini normallaşdıraraq Birləşdirmə Əhəmiyyət Balını hesablayır.
- Multi-Table Layout Planner – MTLP: Büdcə daxilində ən yüksək gözlənilən xalis faydanı verən ortaq klasterləşdirmə və ya bölmə namizədlərini seçir.
- Adaptive Reorganization Engine – ARE: Seçilən planı Delta Lake DDL əmrlərinə və
OPTIMIZEəməliyyatlarına çevirir. - Cost-Based Optimization Layer – CBOL: Yenidən düzənləmədən sonra
ANALYZE TABLEişlədərək fayl statistikalarını yeniləyir və nəticələri geribildirim dövrünə qaytarır.
Bu komponentlərə əlavə olaraq İş Yükü Sürüşməsi Detektoru birləşdirmə əlaqələrinin nisbi əhəmiyyətində kifayət qədər dəyişmə yarananda planlaşdırıcını yenidən işə salır. Sürüşmə həddən aşağı qalarsa mövcud plan saxlanılır.
Birləşdirmə qrafı necə yaradılır?
Hər cədvəl qrafda düyün, iki cədvəl arasındakı birləşdirmə əlaqəsi isə kənar kimi göstərilir. Bir kənar üçün üç əsas dəyər hesablanır:
- F(i,j): Sürüşən zaman pəncərəsində bu birləşdirməni ehtiva edən sorğuların sayı.
- D(i,j): Müvafiq sorğularda iki cədvəlin sətir saylarının hasilinin orta qiyməti.
- C(i,j): Bu birləşdirməni ehtiva edən sorğuların orta icra xərci.
Sorğu planlarından sütun mənşəyini çıxarmaq yalnız SQL daxilində adları axtarmaqdan daha mürəkkəbdir. Spark-ın həll edilmiş planında sütunlar birbaşa customer_id kimi adlardan çox exprId identifikatorları ilə göstərilə bilər. Bu identifikatorları orijinal cədvəl və sütunlara geri bağlamaq üçün Project, Alias, Filter və Subquery düyünləri boyunca mənşə zənciri izlənir.
Birləşdirmə Əhəmiyyət Balı necə hesablanır?
AJLO normallaşdırılmış tezliyi, məlumat həcmini və icra xərcini vurur:
\[ JIS(i,j)=\widehat{F}(i,j)\times\widehat{D}(i,j)\times\widehat{C}(i,j) \]
Məlumat həcmi dəyərləri geniş aralığa yayıla bildiyi üçün \(D\), normallaşdırmadan əvvəl loqarifmik miqyaslanır:
\[ \widehat{D}(i,j)= \frac{\log_{10}(D(i,j)+1)-\log_{10}(D_{\min}+1)} {\log_{10}(D_{\max}+1)-\log_{10}(D_{\min}+1)+\varepsilon} \]
Tezlik və xərc üçün standart minimum–maksimum normallaşdırma tətbiq edilir:
\[ \widehat{X}(i,j)= \frac{X(i,j)-X_{\min}} {X_{\max}-X_{\min}+\varepsilon}, \qquad X\in\{F,C\} \]
Vurma quruluşu üç ölçüdən hər hansı biri sıfıra yaxınlaşdıqda ümumi balın da sıfıra yaxınlaşmasını təmin edir. Beləliklə çox tez işlədilən, lakin kiçik və ucuz ölçü cədvəli birləşdirməsi yalnız tezliyi yüksək olduğuna görə yenidən yazma büdcəsinin böyük hissəsini ala bilmir.
Tədqiqatdakı nümunə müqayisədə tezliyi yüksək, lakin cədvəlləri kiçik və sürətli əlaqənin vurma balı 0,002 olduğu halda bütün ölçülərdə balanslı əlaqənin balı 0,125-dir. Toplama formulu eyni nümunələrə müvafiq olaraq 0,333 və 0,500 verərək ucuz əlaqənin əhəmiyyətini nisbətən çox şişirdir.
JIS birbaşa bayt qənaəti deyil. O, vahidsiz prioritet sıralama siqnalıdır. İqtisadi optimallaşdırma məqsədi ayrıca təxmini skan azalması, yenidən yazma xərci və saxlama xərci üzərindən hesablanır.
Çox Cədvəlli Yerləşim Koordinasiyası problemi necə müəyyən edilir?
Tədqiqat fiziki yerləşim qərarını Multi-Table Layout Coordination adlanan büdcə məhdudiyyətli xalis cari dəyər problemi kimi formullaşdırır:
\[ \operatorname{NPV}(L)= \sum_{(i,j)\in E} \operatorname{ScanReduction}(i,j,L) \left( \frac{1-(1+r)^{-H}}{r} \right) -\operatorname{RewriteCost}(L) -\operatorname{StorageCost}(L) \]
Məhdudiyyətlər:
\[ \operatorname{RewriteCost}(L)\leq B \]
\[ \operatorname{StorageCost}(L)\leq S \]
- \(L\), seçilmiş çox cədvəlli fiziki yerləşim planıdır.
- \(H\), planlaşdırma üfüqüdür.
- \(r\), pəncərə başına diskont dərəcəsidir.
- \(B\), yenidən yazma büdcəsidir.
- \(S\), saxlama büdcəsidir.
Tədqiqatda xərc və fayda terminləri baytla ifadə olunur. Tədqiqatçı problemin Maksimum Çəkili Əhatə problemindən reduksiya yolu ilə NP-çətin olduğunu müdafiə edir. Buna görə bütün mümkün cədvəl və açar kombinasiyalarını istehsal miqyasında tam araşdırmaq əvəzinə acgöz yanaşma istifadə olunur.
Dinamik acgöz planlaşdırıcı necə işləyir?
Planlaşdırıcı hər birləşdirmə kənarı üçün mövcud plan altında ən yüksək xalis cari dəyəri verən namizədi prioritet növbəsinə yerləşdirir. Ən yüksək namizəd seçildikdən sonra yenidən yazma xərci qalan büdcəyə uyğundursa plan tətbiq edilir.
Bir cədvəl üçün qərar verildikdə həmin cədvələ bağlı digər kənarların prioritetləri yenidən hesablanır. Bu addım vacibdir. Məsələn, A cədvəli B ilə order_id üzərində klasterləşdirildikdən sonra A–C əlaqəsinin customer_id təklifi artıq A cədvəlinin yenidən başdan yazılmasını tələb edə bilər. Köhnə xərc ilə hesablanmış prioritet saxlanılarsa planlaşdırıcı eyni cədvəli ardıcıl şəkildə ziddiyyətli açarlara daşıya bilər.
Tədqiqatda ən pis hal mürəkkəbliyi sıx ulduz sxemi üçün təxminən:
\[ O(|E|^2\cdot|C|\cdot\log|E|) \]
kimi verilir. Düyün dərəcəsinin aşağı olduğu tipik seyrək sxemlərdə isə:
\[ O(|E|\cdot|C|\cdot\log|E|) \]
səviyyəsinə yaxınlaşır.
Yenidən düzənləmə əməliyyatı necə tətbiq olunur?
Liquid Clustering açarı dəyişdiriləndə tövsiyə olunan əməliyyat ardıcıllığı belədir:
ALTER TABLE tablo CLUSTER BY (sutun);
OPTIMIZE tablo;
ANALYZE TABLE tablo;
Liquid Clustering ilə qovluq əsaslı bölmələmə arasında keçid ediləcəksə əvvəl mövcud klasterləşdirmə çıxarılmalı, sonra yeni fiziki düzən təyin edilməli və cədvəl yenidən yazılmalıdır.
Tədqiqat OPTIMIZE əməliyyatlarının eyni vaxtlı ETL yazıcıları ilə toqquşa biləcəyini vurğulayır. Delta əməliyyat jurnalındakı optimist eyni vaxtlılıq nəzarəti ConcurrentAppendException və ya ConcurrentDeleteReadException yarada bilər. AJLO bu halda artan gözləmə müddəti ilə yenidən cəhd, ən son cədvəl görüntüsünü oxuma və planı yenidən qiymətləndirmə yanaşmasını təklif edir.
Yenidən klasterləşdirmədən sonra statistikaların yenilənməməsi yeni faylların köhnə sütun statistikaları ilə qiymətləndirilməsinə səbəb ola bilər. Buna görə ANALYZE TABLE fayl ötürmə mexanizminin yeni açardan istifadə edə bilməsi üçün sistem dövrünün məcburi hissəsi kimi qəbul edilir.
AJLO hansı sorğu növlərində təsirli olmağı hədəfləyir?
Sistem iki böyük cədvəlin Sort-Merge Join ilə birləşdirildiyi sorğulara fokuslanır. Bu sorğularda hər iki cədvəldən oxunan sətirlər mübadilə mərhələsinə daxil olmazdan əvvəl fiziki fayllardan skan edilir. Uyğun açara görə klasterləşdirmə daha az faylın oxunmasını təmin edə bilər.
AJLO Spark-ın ClusteredDistribution tələbini ödəmədiyi üçün shuffle əməliyyatını aradan qaldırmır. Catalyst yenə Exchange düyünü əlavə edir. Yaxşılaşma Exchange-ə daxil olan məlumat miqdarının azalmasıdır.
Adaptive Query Execution mübadilə mərhələlərindən sonra real statistikaya görə icra planını dəyişdirə bilər. Lakin AQE işə düşəndə mənbə fayllar artıq oxunmuş olur. AJLO və AQE buna görə eyni xərci hədəfləmir:
- AJLO saxlama qatından mənbə oxuma xərcini azaltmağı hədəfləyir.
- AQE iş zamanı planı və mübadilə mərhələlərini uyğunlaşdırmağı hədəfləyir.
Bir sorğu iş zamanı Broadcast Hash Join-a çevrilərsə kiçik tərəf bütünlüklə yayımlanır və ortaq klasterləşdirmə eyni fayl skan faydasını verməyə bilər. Tədqiqat optimallaşdırma əhatəsini buna görə Sort-Merge Join sahəsində qalan əlaqələrlə məhdudlaşdırıb.
İş yükü sürüşməsi necə müəyyən edilir?
Ardıcıl iki zaman pəncərəsindəki birləşdirmə qrafları arasındakı dəyişmə kənarların JIS dəyərlərinin normallaşdırılmış fərqlərinin ortası ilə ölçülür:
\[ \operatorname{Drift}(G_k,G_{k+1})= \frac{1}{|E_k\cup E_{k+1}|} \sum_{(i,j)\in E_k\cup E_{k+1}} \frac{ |JIS_k(i,j)-JIS_{k+1}(i,j)| }{ \max(JIS_k(i,j),JIS_{k+1}(i,j),\varepsilon) } \]
Standart hədd \(\delta=0{,}10\)-dur. Hədd aşılarsa plan yenidən qiymətləndirilir. Yeni dövrdə ilk dəfə ortaya çıxan birləşdirmə əlaqələrinə birbaşa yüksək yenidən qiymətləndirmə prioriteti verilir.
Təcrübə mühiti necə hazırlanıb?
Bütün təcrübələr Apple M1 prosessorlu və 8 GB birləşdirilmiş yaddaşa malik tək noutbukda aparılıb. İstifadə olunan əsas konfiqurasiya belədir:
- Apache Spark 4.0.0, yerli
local[8]iş rejimi - Delta Lake 3.2.0
- PySpark 4.0.0
- 6 GB sürücü yaddaşı
- 50 shuffle bölməsi
- Adaptive Query Execution aktiv
- Broadcast həddi 10 MB
- Hədəf Delta fayl ölçüsü 2 MB
TPC-H Miqyas Faktoru 1 məlumatları xüsusi Python generatoru ilə hazırlanıb. Orders, lineitem, customer, supplier, part, partsupp, nation və region olmaqla səkkiz cədvəl istifadə olunub. Hər konfiqurasiya beş dəfə işlədilib və median dəyərlər bildirilib.
Hədəf fayl ölçüsünün 2 MB seçilməsi təcrübə dizaynında mühüm detaldır. Standart 128 MB istifadə ediləndə Miqyas Faktoru 1 cədvəllərində yalnız bir və ya iki fayl yaranır və fayl ötürmə nisbəti mənalı şəkildə ölçülə bilmir. İki meqabaytlıq fayllar xeyli çox fayl yaradaraq açar seçiminin təsirini görünən edib. Lakin bu seçim təcrübə mühitini istehsal sistemlərində tipik fayl ölçülərindən uzaqlaşdırır.
Hansı əsas düzənlər müqayisə edilib?
| Düzən | İzah |
|---|---|
| B0 | Heç bir fiziki yerləşim optimallaşdırması tətbiq edilməmiş xam Delta Lake cədvəlləri |
| B2 | Hər cədvəl üçün tarix kimi tez-tez filtr olunan sütunlarda bir dəfə qurulmuş və dəyişdirilməmiş statik Liquid Clustering |
| AJLO | Sorğu tarixçəsindəki dominant birləşdirmə əlaqələrinə görə cədvəllər arasında koordinasiyalı açar seçimi |
Hive tipli qovluq bölmələməsi müqayisədən çıxarılıb. Tədqiqatın məqsədi Liquid Clustering ilə ənənəvi Hive bölmələməsini yenidən müqayisə etmək deyil, eyni Liquid Clustering infrastrukturu daxilində seçilən sütunun təsirini ölçməkdir.
Skan edilən məlumat miqdarında nə tapılıb?
Şəkil 2-də bütün sorğular üzrə hesablanan orta skan miqdarları belədir:
| Fiziki düzən | Sorğu başına orta skan edilən məlumat |
|---|---|
| B0 – optimallaşdırma yoxdur | 51 MB |
| B2 – filtr sütunlarında statik klasterləşdirmə | 117 MB |
| AJLO – birləşdirmə həssas klasterləşdirmə | 46 MB |
B2-nin düzənlənməmiş B0-dan daha çox məlumat skan etməsi diqqətəlayiqdir. orders cədvəlinin o_orderdate, lineitem cədvəlinin isə l_shipdate üzərində klasterləşdirilməsi tarix şərtlərinə kömək edir; lakin orderkey intervalından istifadə edən birləşdirmə sorğularında açar dəyərləri tarix fayllarına yayıldığı üçün demək olar ki, bütün fayllar uyğun görünür. Statik düzən ilkin məlumatdakı təbii lokallığı da pozaraq bəzi sorğularda skanı artırıb.
AJLO-nun JIS sıralamasında lineitem ↔ orders əlaqəsi 1,000 bal ilə birinci, customer ↔ orders əlaqəsi 0,404 bal ilə ikinci yerdədir. Sistem bu dominant əlaqələri ortaq açarlarda klasterləşdirib.
Yüzdə 86,7 azalma bütün sorğuların ortalaması deyil. Bu dəyər birləşdirmə ağırlıqlı Q01–Q07 sorğularında AJLO-nun B2-yə nisbətən skan etdiyi baytların azalmasını ifadə edir. Yalnız tarix filtri istifadə edən Q08–Q10 sorğularında isə B2 üstünlük təşkil edir. AJLO bu giriş nümunələrini xüsusi optimallaşdırmayıb.
Sorğu gecikməsi necə dəyişib?
Şəkil 5-dəki ətraflı nəticələrə görə:
| Düzən | Orta sorğu gecikməsi |
|---|---|
| B0 | 1,2 saniyə |
| B2 | 1,0 saniyə |
| AJLO | 0,6 saniyə |
AJLO statik filtr sütunu klasterləşdirməsinə nisbətən orta gecikməni yüzde 40 azaldıb. Tədqiqatçı bu qazancı fərqli sorğu icra alqoritminə deyil, məlumat mübadiləsindən əvvəl daha az fayl və sətir oxunmasına bağlayır.
Tədqiqatın giriş hissəsindəki bir cümlədə 0,5 və 0,6 saniyəlik fərqli dəyərlər var. Bununla belə xülasə, nəticə mətni və Şəkil 5 ardıcıl olaraq AJLO üçün 0,6, B2 üçün 1,0 saniyə bildirdiyinə görə bu dəyərlər əsas götürülməlidir.
Fayl ötürmə nisbətində nə tapılıb?
RQ2 çərçivəsində bildirilən orta fayl ötürmə nisbətləri belədir:
| Düzən | Orta fayl ötürmə nisbəti |
|---|---|
| B0 | %14,9 |
| B2 | %14,5 |
| AJLO | %54,4 |
Statik tarix sütunu klasterləşdirməsinin yüzde 14,5 ilə düzənlənməmiş cədvəlin yüzde 14,9 dəyərinə yaxın qalması birləşdirmə ağırlıqlı sorğular üçün səhv açar seçiminin fayl ötürməyə demək olar ki, heç töhfə vermədiyini göstərir.
AJLO planlaşdırma modelində ortaq Liquid Clustering üçün yüzde 30 skan azalma əmsalı istifadə olunub. Təcrübədə Q01–Q07 sorğularının ölçülmüş fayl ötürmə nisbətləri yüzde 76–79 arasında olub. Model bu kiçik məlumat düzənində təxminən 2,5 dəfə konservativ qalıb. Eyni fərqin böyük fayl və məlumat miqyasında davam edib-etməyəcəyi bilinmir.
İş yükü sürüşməsi təcrübəsi nə göstərib?
Üç fərqli iş yükü rejimində sorğu şablonlarının tezlikləri dəyişdirilib, lakin istifadə olunan birləşdirmə sütunları dəyişdirilməyib. W3 pəncərəsində sürüşmə balı 0,249, W4-də isə 0,107 hesablanıb və hər ikisi 0,10 həddini aşıb. Sistem bu nöqtələrdə yenidən qiymətləndirməni düzgün şəkildə işə salıb.
W5-də 0,069 və W6-da 0,091 dəyərləri həddən aşağı qalıb, yenidən optimallaşdırma başlanmayıb. Lakin bütün pəncərələrdə real yenidən yazma xərci sıfırdır. Bunun səbəbi dəyişən elementin birləşdirmə sütunları deyil, mövcud əlaqələrin tezlikləri olmasıdır. Yenidən qiymətləndirmə mövcud fiziki düzənin hələ də kifayət etdiyinə qərar verib.
Beləliklə təcrübə sürüşmə detektorunun hədd davranışını göstərir; yeni birləşdirmə sütunu ortaya çıxdıqda cədvəlin həqiqətən yenidən klasterləşdirilməsini və bunun xərcini qiymətləndirmir. Tədqiqatçı bunu gələcək işlər üçün əsas çatışmazlıqlardan biri kimi qəbul edir.
Acgöz planlaşdırıcı optimal həllə nə qədər yaxınlaşıb?
Beş ilə səkkiz cədvəl, altı ilə on iki kənar və ümumi yenidən yazma xərcinin yüzde 20–50 hissəsi arasında büdcə ehtiva edən doqquz sintetik qraf konfiqurasiyası yaradılıb. Acgöz həllin dəqiq kobud qüvvə optimumuna nisbəti hesablanıb.
- Doqquz konfiqurasiyanın altısında acgöz həll optimumla eyni nəticəni verib.
- Doqquz konfiqurasiyanın səkkizi \(1-1/e\approx0{,}632\) həddini qarşılayıb və ya aşıb.
- Bütün konfiqurasiyaların orta yaxınlaşma nisbəti 0,913-dür.
- C6 konfiqurasiyası 0,570 nisbətində qalıb.
C6-da sərt büdcə alqoritmin erkən mərhələdə yerli olaraq cəlbedici kənarı seçməsinə və daha yüksək ümumi fayda verəcək sonrakı kombinasiyaya çata bilməməsinə səbəb olub. Bu nəticə nəzəri \(1-1/e\) həddinin yalnız submodulluq və azalan marjinal gəlir şərtləri təmin olunduqda keçərli olduğunu xatırladır. Tədqiqatın tam yerləşim problemində bu şərtlər hər konfiqurasiyada zəmanətli deyil.
Tədqiqatın güclü tərəfləri hansılardır?
- Açıq mənbəli lakehouse stekinə məxsus və aydın şəkildə müəyyən edilmiş fiziki dizayn problemi araşdırılıb.
- Cədvəllər müstəqil deyil, birləşdirmə qrafı üzərindən koordinasiyalı qiymətləndirilib.
- Riyazi məqsəd funksiyası, büdcə məhdudiyyətləri və alqoritmlər açıq şəkildə təqdim olunub.
- Fayl skan miqdarı, sorğu gecikməsi, fayl ötürmə nisbəti, sürüşmə aşkarlanması və yaxınlaşma keyfiyyəti ayrı təcrübələrlə araşdırılıb.
- Sistemin Spark shuffle əməliyyatını aradan qaldırmadığı açıq bildirilib.
- Təcrübə konfiqurasiyaları, kod, məlumat generatoru və nəticə skriptləri üçün yenidən istehsal məlumatları verilib.
- Mənfi nəticə xarakterli C6 uğursuzluğu və istehsal miqyası ilə bağlı qeyri-müəyyənlik gizlədilməyib.
Tədqiqatın əsas məhdudiyyətləri hansılardır?
- Təcrübələr tək Apple M1 noutbukda və yerli Spark rejimində aparılıb.
- TPC-H Miqyas Faktoru 1 təxminən 1 GB həcmindədir və məlumat yaddaşa sığır.
- İstehsal mühitindəki şəbəkə, paylanmış saxlama, icraçılararası məlumat ötürülməsi və düyün nasazlıqları araşdırılmayıb.
- İki meqabaytlıq hədəf fayl ölçüsü fayl ötürmə təsirini görünən etmək üçün eksperimental olaraq kiçildilib.
- Xüsusi Python TPC-H generatoru rəsmi
dbgenpaylanmasından kiçik fərqlər ehtiva edə bilər. - Yüzdə 86,7 skan azalması yalnız birləşdirmə ağırlıqlı yeddi sorğu və B2 müqayisəsi üçün keçərlidir.
- Filtr ağırlıqlı sorğularda statik tarix klasterləşdirməsi AJLO-dan daha yaxşı nəticə verə bilib.
- Sürüşmə təcrübəsində yeni birləşdirmə sütunları olmadığından real fiziki yenidən klasterləşdirmə baş verməyib.
- OPTIMIZE əməliyyatlarının terabayt və ya petabayt miqyaslı real xərci ölçülməyib.
- Saxlama və yenidən yazma xərclərinin bayt əsaslı təxminləri istehsal hesabları və ya əməliyyat kəsilməsi riski ilə doğrulanmayıb.
- Greedy planlaşdırıcı bir konfiqurasiyada nəzəri həddən aşağı qalıb.
- Tədqiqat resenziyadan keçməyib.
Tədqiqat hansı nəticələri dəstəkləyir?
- Eyni kiçik TPC-H mühitində Liquid Clustering açarının seçimi fayl ötürmə və skan edilən məlumatda böyük fərq yaradıb.
- Birləşdirmə açarına görə koordinasiyalı klasterləşdirmə Q01–Q07 sorğularında tarix sütununa görə statik klasterləşdirmədən daha az məlumat skan edib.
- Səhv sütuna görə klasterləşdirilmiş fiziki düzən bəzi iş yüklərində düzənlənməmiş cədvəldən daha pis nəticə verə bilib.
- Vurma əsaslı JIS tədqiqatdakı nümunələrdə yüksək tezlikli, lakin aşağı xərcli əlaqələri arxa plana keçirə bilib.
- Sürüşmə meyarı sınaqdan keçirilən sorğu tezliyi keçidlərində hədd aşımını müəyyən edə bilib.
- Acgöz planlaşdırıcı doqquz kiçik sintetik qrafda orta 0,913 optimal nisbət təmin edib.
Tədqiqat hansı nəticələri sübut etmir?
- AJLO-nun bütün açıq mənbəli Delta Lake qurulumlarında daha sürətli olacağını sübut etmir.
- Yüzdə 86,7 skan azalmasının terabayt və ya petabayt miqyasda qorunacağını göstərmir.
- AJLO-nun shuffle əməliyyatını və ya Sort-Merge Join mübadiləsini aradan qaldırdığını göstərmir.
- Broadcast Hash Join istifadə edən sorğuların eyni ölçüdə fayda görəcəyini göstərmir.
- Filtr ağırlıqlı sorğularla birləşdirmə ağırlıqlı sorğuları eyni vaxtda ən yaxşı şəkildə optimallaşdırdığını göstərmir.
- İş yükünə yeni birləşdirmə sütunları əlavə ediləndə yenidən klasterləşdirmənin uğurla və aşağı xərclə tamamlanacağını göstərmir.
- Acgöz planlaşdırıcının bütün qraf və büdcə şərtlərində \(1-1/e\) həddini təmin edəcəyini sübut etmir.
- İstehsal sistemində əldə olunacaq pul qənaətini və ya xidmət səviyyəsi yaxşılaşmasını ölçmür.
Tədqiqatın Metodu və Nəticələri
Metod xülasəsi
| Metod komponenti | Tədqiqatda tətbiq olunan yanaşma |
|---|---|
| Tədqiqat növü | Alqoritmik sistem dizaynı, kiçik miqyaslı TPC-H təcrübəsi və sintetik qraf qiymətləndirməsi |
| Sistem adı | AJLO – Adaptive Join-aware Layout Optimizer |
| Hədəf platforma | Açıq mənbəli Apache Spark və Delta Lake |
| Əsas məlumat quruluşu | Sorğu tarixçəsindən yaradılan çəkili cədvəl birləşdirmə qrafı |
| Əhəmiyyət balı | Normallaşdırılmış sorğu tezliyi × loq miqyaslı məlumat həcmi × icra xərci |
| Optimallaşdırma məqsədi | Yenidən yazma və saxlama büdcəsi altında gözlənilən skan azalmasının xalis cari dəyərini yüksəltmək |
| Planlaşdırıcı | Prioritetləri hər qərardan sonra yenilənən dinamik acgöz alqoritm |
| Uyğunlaşma | JIS paylanmasındakı dəyişiklik üçün sürüşmə meyarı; standart hədd 0,10 |
| Təcrübə məlumatı | TPC-H Miqyas Faktoru 1; səkkiz cədvəl; xüsusi Python məlumat generatoru |
| Təcrübə sorğuları | On sorğu; beş təkrar; median nəticələr |
| Avadanlıq | Apple M1 noutbuk, 8 GB birləşdirilmiş yaddaş |
| Proqram | Spark 4.0.0, Delta Lake 3.2.0, PySpark 4.0.0 |
Əsas performans nəticələri
| Meyar | B0 | B2 | AJLO |
|---|---|---|---|
| Orta skan edilən məlumat | 51 MB | 117 MB | 46 MB |
| Orta sorğu gecikməsi | 1,2 saniyə | 1,0 saniyə | 0,6 saniyə |
| Orta fayl ötürmə nisbəti | %14,9 | %14,5 | %54,4 |
Sorğu növünə görə nəticələrin ayrılması
| Sorğu qrupu | Üstün düzən | Tədqiqatdakı müşahidə |
|---|---|---|
| Q01–Q07, birləşdirmə ağırlıqlı | AJLO | B2-yə nisbətən skan edilən baytlarda %86,7 azalma; fayl ötürmə təxminən %76–79 |
| Q08–Q10, filtr ağırlıqlı | B2 | Tarix sütunu sorğu şərti ilə birbaşa uyğunlaşdığı üçün statik filtr klasterləşdirməsi daha az məlumat skan edə bilib |
Sürüşmə aşkarlanması nəticələri
| Pəncərə | Sürüşmə balı | Hədd vəziyyəti | Fiziki yenidən yazma |
|---|---|---|---|
| W3 | 0,249 | 0,10-dan yuxarı; yenidən qiymətləndirmə | Yoxdur |
| W4 | 0,107 | 0,10-dan yuxarı; yenidən qiymətləndirmə | Yoxdur |
| W5 | 0,069 | Həddən aşağı | Yoxdur |
| W6 | 0,091 | Həddən aşağı | Yoxdur |
Acgöz planlaşdırıcı nəticələri
| Ölçmə | Nəticə |
|---|---|
| Sintetik konfiqurasiya sayı | 9 |
| Optimumla tam uyğun gələn konfiqurasiya | 6 |
| 0,632 nəzəri həddini qarşılayan və ya aşan | 8 |
| Orta yaxınlaşma nisbəti | 0,913 |
| Ən aşağı nisbət | C6 konfiqurasiyasında 0,570 |
Şəkillərin əsas mesajları
- Şəkil 1: Sorğu jurnalından başlayan, planlaşdırma, tətbiq, statistika yeniləmə və sürüşmə aşkarlama dövrünə qədər uzanan altı komponentli AJLO arxitekturasını göstərir.
- Şəkil 2: Statik filtr sütunu klasterləşdirməsinin orta 117 MB ilə həm B0, həm də AJLO-dan daha çox məlumat skan etdiyini göstərir.
- Şəkil 3:
lineitem–ordersəlaqəsinin 1,000 JIS ilə iş yükünə dominant olduğunu göstərir. - Şəkil 4: Birləşdirmə ağırlıqlı sorğuların AJLO tərəfində, filtr ağırlıqlı sorğuların B2 tərəfində üstünlük verdiyini ayırır.
- Şəkil 5: Ətraflı gecikmə dəyərlərini B0 üçün 1,2, B2 üçün 1,0 və AJLO üçün 0,6 saniyə kimi göstərir.
- Şəkil 6: AJLO-nun yüzde 54,4 fayl ötürmə nisbətini B0 və B2-nin təxminən yüzde 14–15 dəyərləri ilə müqayisə edir.
- Şəkil 7: Yüzdə 30 planlaşdırma təxmininin Q01–Q07-də ölçülən yüzde 76–79 nisbətlərinə görə konservativ qaldığını göstərir.
- Şəkil 8: W3 və W4 pəncərələrində sürüşmə həddinin aşıldığını göstərir.
- Şəkil 9: Yenidən qiymətləndirmələrə baxmayaraq sınaqdan keçirilən rejimlərdə fiziki yenidən yazma xərcinin sıfır qaldığını göstərir.
- Şəkil 10: Doqquz konfiqurasiyadan yalnız C6-nın 0,632 həddindən aşağı qaldığını göstərir.
- Şəkil 11: Acgöz və dəqiq optimal xalis cari dəyərləri müqayisə edir, ən böyük mütləq fərqi C6-da göstərir.
Mənbə və Metod Qeydi
Tədqiqatın tam orijinal adı: Adaptive Join-Aware Physical Layout Optimization for Lakehouse Systems
Müəllif: Nishank Mahore.
Müəllif sıralaması: Tədqiqat tək müəlliflidir.
Bərabər töhfə məlumatı: Başqa müəllif və ya bərabər töhfə bildirişi yoxdur.
Məsul müəllif: Nishank Mahore.
Əlaqə ünvanı: nishankmahore@gmail.com
Qurum əlaqəsi: Independent Researcher, Pune, India. Tədqiqatda universitet, tədqiqat mərkəzi və ya şirkət qurum əlaqəsi verilməyib.
Nəşr platforması: SSRN.
Rəsmi mənbə keçidi:SSRN tədqiqat qeydi
Nəşr ili: 2026.
Jurnal: Resenziyalı jurnal adı və ya jurnal qəbul məlumatı yoxdur.
Nəşriyyat: Son resenziyalı nəşr üçün nəşriyyat məlumatı yoxdur.
Mənbə növü: Alqoritmik sistem dizaynı və eksperimental kompüter sistemləri qiymətləndirməsi; preprint.
Resenziya statusu: Tədqiqat resenziyadan keçməyib.
Tətbiq və təcrübə kodları:AJLO GitHub deposu
Məlumatlara çıxış: Xam TPC-H məlumatları ayrıca saxlanılmayıb. Tədqiqatda məlumatların tpch_generator.py adlı xüsusi generatorla deterministik şəkildə yenidən yaradıla bildiyi bildirilir.
Müəllif töhfəsi: Nishank Mahore konseptuallaşdırma, metod, proqram, doğrulama, formal analiz, tədqiqat, məlumatların təşkili, vizuallaşdırma, ilk layihə, baxış və redaktə rollarının hamısını yerinə yetirib.
Maliyyələşdirmə: Tədqiqat üçün dövlət, kommersiya və ya qeyri-kommersiya qurumundan xüsusi maliyyələşdirmə alınmadığı bildirilib.
Maraqlar toqquşması: Müəllif maliyyə və ya şəxsi maraqlar toqquşması bildirməyib.
Generativ süni intellekt bəyanı: Generativ süni intellekt alətlərinin yalnız müəllifin orijinal mətnini redaktə etmək, qısaltmaq və daha aydın etmək üçün istifadə olunduğu; tədqiqat dizaynı, tətbiq, eksperimental məlumatlar və texniki nəticələrin süni intellekt tərəfindən yaradılmadığı bildirilib.
Bu Azərbaycan dilində izah yalnız yüklənmiş tədqiqatın mətni, riyazi ifadələri, alqoritmləri, cədvəlləri, təcrübə nəticələri və Şəkil 1–11-dəki vizual tapıntılar əsasında hazırlanıb. Xarici mənbələr elmi nəticə əlavə etmək üçün istifadə olunmayıb; yalnız tədqiqatın biblioqrafik kimliyi və rəsmi qeydlərinin doğrulanmasında qiymətləndirilib.
Tədqiqatdakı 0,6 saniyəlik gecikmə, yüzde 54,4 fayl ötürmə və yüzde 86,7 skan azalması nəticələri təxminən 1 GB həcmində TPC-H Miqyas Faktoru 1 məlumatı, iki meqabaytlıq eksperimental hədəf fayl ölçüsü və tək kompüterli yerli Spark mühitinə aiddir. Bu dəyərlər istehsal miqyası üçün performans zəmanəti kimi şərh edilməməlidir.
Müəllifin “əvvəllər dərc edilmiş heç bir sistemin açıq mənbəli Delta Lake üçün birləşdirmə həssas Liquid Clustering açar seçimini avtomatlaşdırmadığı” yönündə yenilik iddiası tədqiqatın öz ədəbiyyat icmalına əsaslanır. Bu məqalədə müstəqil və tam prioritet araşdırması aparılmayıb.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib