

Doğal dil işleme projelerinde çoğu zaman dikkat model mimarisine, büyük dil modellerine veya yeni algoritmalara yönelir. Oysa başarılı bir yapay zekâ sisteminin temelinde çoğu zaman daha sıkıcı ama daha belirleyici bir iş vardır: kaliteli etiketlenmiş veri üretmek. Named Entity Recognition, yani adlandırılmış varlık tanıma, metin içindeki kişi, kurum, yer, ilaç, teknik parça, hukuki kavram veya alan özelindeki önemli ifadeleri bulup sınıflandırmayı amaçlar.
Bu çalışma, NER veri seti hazırlamanın pratik zorluklarına odaklanıyor. Bir araştırmacı veya alan uzmanı, metindeki her tokenı etiketlemek zorundadır. Bir varlık metinde yüzlerce kez tekrar edebilir. Mouse ile seçilen ifade, modelin kullandığı token sınırlarıyla tam örtüşmeyebilir. Varlık olmayan her tokenın da “O”, yani Outside etiketi alması gerekir. Bu küçük görünen işler, büyük veri setlerinde haftalar veya aylar süren yorucu bir iş akışına dönüşebilir.
AutoLabel-NER bu soruna hafif, çevrimdışı ve açık kaynak bir masaüstü çözüm öneriyor. Araç, veriyi kullanıcının bilgisayarından dışarı çıkarmaz; sunucu, bulut hesabı veya ücretli lisans gerektirmez. Etiketleme sırasında aynı varlığı belgenin tamamına otomatik yayabilir, seçilen metni token sınırlarına hizalayabilir, kalan tüm tokenları tek tıkla Outside etiketiyle tamamlayabilir ve sonucu BIO, JSON, XLSX ve CSV formatlarında dışa aktarabilir.
Problem Ne?
Modern doğal dil işleme, büyük ölçüde denetimli öğrenmeye dayanır. Denetimli öğrenme ise doğru ve tutarlı etiketlenmiş veriye ihtiyaç duyar. Bir modelin hangi varlıkları tanıyacağını, hangi kavramları ayıracağını ve hangi örneklerden genelleme yapacağını çoğu zaman veri setinin kalitesi belirler. Bu nedenle veri hazırlama, model eğitiminden önce gelen kritik adımdır.
NER görevinde etiketleme daha da zahmetlidir. Çünkü yalnızca cümleye genel bir etiket vermek yetmez; metindeki her tokenın rolü belirlenmelidir. Bir varlık ifadesinin ilk tokenı “B”, devam eden tokenları “I”, varlık dışı tokenlar ise “O” etiketi alır. Bu yapı BIO tagging olarak bilinir.
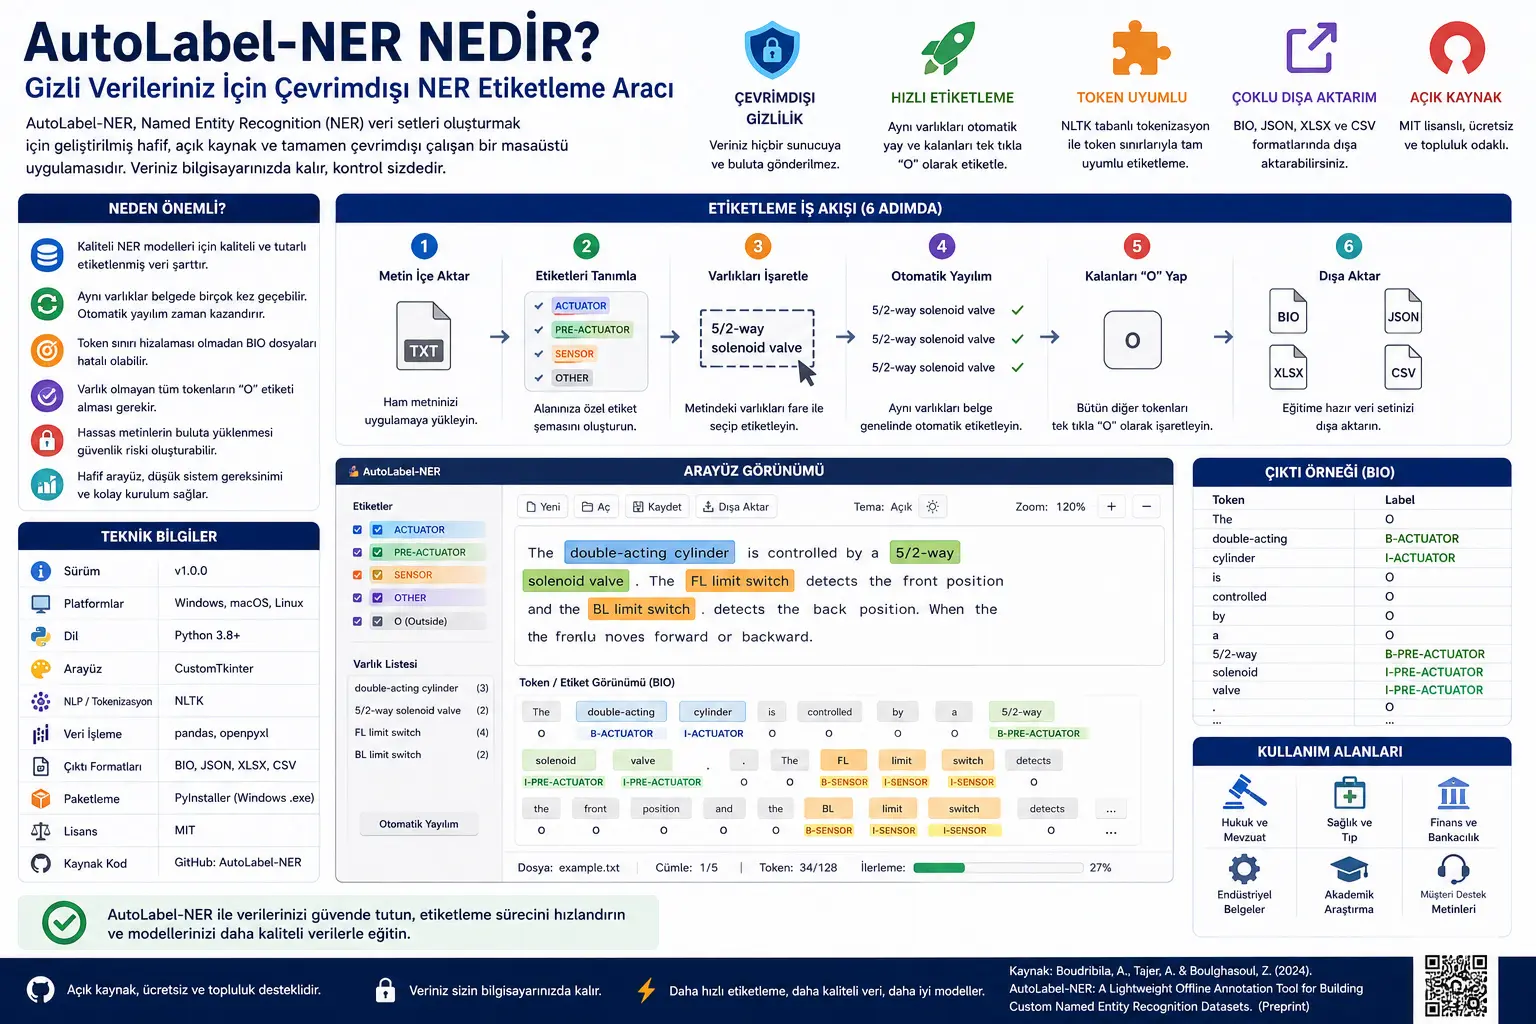
Örneğin teknik bir metinde “double-acting cylinder” ifadesi bir aktüatör olabilir. Bu durumda “double-acting” B-ACTUATOR, “cylinder” I-ACTUATOR gibi işaretlenir. Aynı metinde “5/2-way solenoid valve” bir pre-actuator, “FL limit switch” ise sensör olabilir. Geri kalan kelimelerin tamamı da O etiketi almalıdır. Bu işlem elle yapıldığında hem yavaşlar hem de hata üretmeye açık hale gelir.
Çalışmanın vurguladığı üç temel sorun vardır. Birincisi tekrar sorunudur. Aynı varlık aynı belgede birçok kez geçebilir ve her seferinde aynı etiketin verilmesi gerekir. İkincisi hizalama sorunudur. Kullanıcının mouse ile seçtiği metin parçası, modelin kullandığı token sınırlarıyla tam örtüşmezse geçersiz veya bozuk BIO dizileri oluşabilir. Üçüncüsü Outside etiketi sorunudur. Varlık olmayan tokenlar da etiketlenmelidir; fakat bu işlem çoğu araçta otomatik ve güvenli biçimde tamamlanmaz.
Mevcut araçlar bu sorunların hepsini aynı anda çözmeyebilir. Bulut tabanlı araçlar modern arayüz sunsa da gizli verinin dış servise yüklenmesini gerektirebilir. Web tabanlı güçlü araçlar kurulum ve sunucu yönetimi isteyebilir. Ticari araçlar ücretli lisansla sınırlı olabilir. Basit spreadsheet veya notebook çözümleri ise görselleştirme, tutarlılık ve BIO uyumu açısından riskli olabilir.
Yöntem Ne Öneriyor?
AutoLabel-NER, NER veri seti üretimini tek bilgisayar üzerinde çalışan, kurulumu hafif ve gizlilik dostu bir masaüstü uygulamasıyla çözmeyi önerir. Araç dört katmanlı bir mimari üzerine kuruludur: sunum katmanı, dilsel işleme katmanı, etiketleme motoru ve kalıcılık/dışa aktarma katmanı.
Sunum katmanı, kullanıcının etiketleme yaptığı grafik arayüzdür. CustomTkinter ile hazırlanmıştır. Arayüzde metin alanı, etiket butonları, varlık listesi, durum çubuğu, ilerleme göstergesi, tema ve zoom seçenekleri bulunur. Kullanıcı etiketleri kendi alanına göre tanımlayabilir; örneğin hukukta “MAHKEME”, “KANUN”, “TARAFLAR”; sağlıkta “İLAÇ”, “HASTALIK”, “TEDAVİ”; endüstride “SENSÖR”, “AKTÜATÖR”, “BİLEŞEN” gibi özel etiketler oluşturabilir.
Dilsel işleme katmanı, NLTK tabanlı cümle ve kelime tokenizasyonu kullanır. En kritik işlevlerden biri, ekranda seçilen metin aralığını kaynak metindeki token sınırlarına bağlamaktır. Bu hizalama olmazsa kullanıcı doğru kelimeyi seçtiğini düşünse bile dışa aktarılan BIO dosyası model eğitimi için hatalı hale gelebilir.
Etiketleme motoru, aracın üretkenlik merkezidir. Seçilen varlıkların çakışmasını önler, yanlışlıkla seçilen boşlukları temizler, aynı varlık tekrarlarını belge genelinde otomatik etiketler, kalan tokenları tek işlemle Outside olarak tamamlar ve geri al/yeniden yap geçmişini yönetir. Bu yapı, hem hız hem tutarlılık sağlamayı hedefler.
Kalıcılık ve dışa aktarma katmanı, projenin tüm durumunu yerel bir JSON dosyasında saklar. Kaynak metin, etiket şeması, renkler ve işaretlenmiş spanlar aynı proje dosyasında tutulur. Etiketleme tamamlandığında araç BIO, JSON, XLSX ve CSV formatlarında çıktı üretir. BIO çıktısı Hugging Face Transformers, spaCy ve Flair gibi yaygın NER eğitim kütüphaneleriyle doğrudan uyumludur.
Formüller Ne Anlatıyor?
Çalışmada klasik anlamda matematiksel model formülü bulunmamaktadır. Bu makale bir yazılım aracı ve iş akışı çalışmasıdır. Ancak NER etiketleme mantığı, BIO şeması ve veri seti üretim süreci sade gösterimlerle açıklanabilir.
NER görevi genel olarak şöyle düşünülebilir:
BIO etiketleme şeması üç temel durumdan oluşur:
Burada \(B\), bir varlık ifadesinin başlangıcını; \(I\), aynı varlığın devamını; \(O\), herhangi bir varlığa ait olmayan tokenı temsil eder.
Çok kelimeli bir varlık ifadesi için yapı şu şekilde gösterilebilir:
Burada \(X\), etiket sınıfını temsil eder. Örneğin \(X=\text{ACTUATOR}\) ise ilk token \(B\text{-ACTUATOR}\), sonraki tokenlar \(I\text{-ACTUATOR}\) etiketi alır.
AutoLabel-NER’in otomatik tekrar yayılım mantığı sade biçimde şöyle özetlenebilir:
Kalan tokenların tamamlanması ise şu şekilde düşünülebilir:
Bu ifadeler çalışmada birebir matematiksel formül olarak sunulmaz; AutoLabel-NER’in veri etiketleme mantığını Verianla okuyucusu için sadeleştiren editoryal gösterimlerdir.
Grafik, Tablo ve Şema Ana Mesajı
Kod metadatası tablosu, AutoLabel-NER’in pratik bir araştırma yazılımı olarak konumlandığını gösterir. Araç v1.0.0 sürümünde sunulmuştur; GitHub üzerinden paylaşılır, MIT lisansı taşır, Python 3.8 ve üzeriyle çalışır, CustomTkinter, NLTK, pandas, openpyxl ve PyInstaller kullanır. Windows için bağımsız çalıştırılabilir dosya sağlanması, teknik olmayan kullanıcıların da aracı açıp kullanabilmesini kolaylaştırır.
Karşılaştırma tablosunun ana mesajı, AutoLabel-NER’in mevcut araçlar arasındaki boşluğu hedeflediğidir. Doccano ve Label Studio gibi araçlar güçlü arayüz sunabilir; BRAT ve INCEpTION gibi araçlar akademik etiketleme için etkilidir; Prodigy gibi ticari araçlar iyi tasarlanmıştır. Ancak AutoLabel-NER’in iddiası, tam çevrimdışı çalışma, sunucu gerektirmeme, yerel veri saklama, NLTK tabanlı tokenizasyon, otomatik etiket yayılımı, boşluk temizleme, tek tıkla Outside etiketi tamamlama ve native BIO dışa aktarma özelliklerini tek hafif masaüstü araçta birleştirmesidir.
Dört katmanlı mimari şeması, aracın iş akışını net biçimde gösterir. Ham metin önce kullanıcı arayüzüne gelir. Ardından NLTK tabanlı dilsel işleme katmanı cümle, kelime ve karakter aralığı eşlemesini yapar. Etiketleme motoru, auto-tagging, Outside tamamlama, çakışma kontrolü ve geri al/yeniden yap işlemlerini yürütür. Son katman ise veriyi JSON, XLSX, CSV ve BIO formatlarında dışa aktarır.
Altı adımlı iş akışı şeması, bir kullanıcının ham metinden eğitim verisine nasıl geçtiğini gösterir: metin içe aktarılır, etiketler tanımlanır, varlıklar elle işaretlenir, aynı etiketler benzer örneklere yayılır, kalan tokenlar O olarak işaretlenir ve veri seti dışa aktarılır. Bu akışın önemli tarafı, manuel karar gerektiren aşamalarla otomatik üretkenlik aşamalarını birlikte kullanmasıdır.
Arayüz görseli, uygulamanın teknik bir backend’den ibaret olmadığını; etiket butonları, renkli vurgular, varlık listesi ve ilerleme göstergesiyle gerçek kullanıcı iş akışını hedeflediğini gösterir. BIO çıktı görseli ise aracın yalnızca görsel etiketleme yapmadığını, model eğitimine doğrudan girebilecek token düzeyinde çıktı ürettiğini gösterir.
Deneyler Nasıl Yapılmış?
Çalışma klasik bir makine öğrenmesi deneyi sunmaz; daha çok yazılım aracı tanıtımı, iş akışı gösterimi ve kullanım etkisi değerlendirmesi yapar. Bu nedenle model doğruluğu karşılaştırmasından çok, aracın NER veri seti üretim sürecindeki pratik katkısı anlatılır.
Önce kısa bir teknik şartname cümlesi üzerinden örnek etiketleme yapılır. Cümlede “double-acting cylinder”, “5/2-way solenoid valve”, “FL limit switch” ve “BL limit switch” gibi alan özelindeki ifadeler etiketlenir. Amaç, aktüatör, pre-actuator ve sensör gibi teknik varlıkların nasıl işaretleneceğini göstermektir.
Kullanıcı metni içe aktarır, etiketleri tanımlar, ilk varlık örneklerini seçer ve uygun etiketleri atar. Auto-tagging özelliği açıldığında aynı varlık tekrarları belge içinde otomatik olarak etiketlenir. Ardından “Label Rest as O” işlemi, etiketlenmemiş tüm tokenları Outside etiketiyle tamamlar. Son aşamada araç BIO, JSON, XLSX ve CSV çıktıları üretir.
Çalışma ayrıca daha büyük ölçekli bir kullanım örneğinden söz eder. AutoLabel-NER, endüstriyel gereksinim şartnamelerinden oluşan alan özelinde bir NER korpusu üretmek için kullanılmıştır. Bu korpus birkaç bin şartname, on binlerce cümle ve yüz binlerce token içermektedir. Paylaşılan doğrulama alt kümesinde güçlü inter-annotator agreement raporlandığı, yani farklı etiketleyicilerin büyük ölçüde tutarlı etiketler üretebildiği belirtilir.
Bu veri setinden üretilen BIO çıktısının ara dönüştürme gerekmeden transformer tabanlı NER modellerini fine-tune etmek için kullanıldığı ve en iyi modelin elde tutulan test setinde 0.9721 F1 skoruna ulaştığı aktarılır. Bu sonuç, aracın yalnızca arayüz kolaylığı sağlamadığını; model eğitimine uygun, tutarlı ve kullanılabilir veri üretimine katkı verdiğini gösterir.
Sonuçlar Ne Gösteriyor?
İlk sonuç, NER projelerinde veri etiketlemenin model mimarisinden daha az önemli olmadığıdır. Doğru token sınırları, tutarlı BIO dizileri ve eksiksiz O etiketleri olmadan en güçlü transformer modeli bile hatalı veya tutarsız veriyle eğitilebilir.
İkinci sonuç, çevrimdışı çalışmanın bazı alanlarda kritik değer taşıdığıdır. Klinik notlar, hukuki belgeler, şirket içi raporlar, finansal dokümanlar veya endüstriyel şartnameler gibi metinler kamu bulutuna yüklenemeyebilir. AutoLabel-NER, bu tür durumlarda veriyi yerel bilgisayarda tutarak araştırma yapılmasını kolaylaştırır.
Üçüncü sonuç, otomatik etiket yayılımının tekrar yükünü ciddi biçimde azaltabileceğidir. Aynı varlık belgenin birçok yerinde geçiyorsa, tek tek elle işaretlemek hem zaman kaybı hem tutarsızlık riski yaratır. Exact-string label propagation bu tekrarları büyük ölçüde azaltır.
Dördüncü sonuç, token hizalamasının görünmez ama kritik bir kalite meselesi olduğudur. Kullanıcı arayüzünde doğru görünen seçim, modelin tokenizasyonuyla uyumlu değilse BIO dosyası bozulabilir. AutoLabel-NER’in NLTK tokenizasyonu ve karakter aralığı hizalaması bu riski azaltmayı hedefler.
Beşinci sonuç, standart dışa aktarımın araştırma akışını hızlandırdığıdır. BIO, JSON, XLSX ve CSV çıktılarının tek araçtan alınması; Hugging Face Transformers, spaCy ve Flair gibi kütüphanelere geçişi kolaylaştırır. Böylece araştırmacıların veri dönüştürme scriptleri yazarken yapabileceği sessiz hatalar azalabilir.
Bu Neden Önemli?
Bu çalışma, yapay zekâ projelerinde sık unutulan bir noktayı görünür kılıyor: Veri etiketleme altyapısı güçlü değilse, model başarısı da kırılgan hale gelir. Özellikle özel alanlarda, hazır veri seti çoğu zaman yoktur. Tıbbi, hukuki, finansal veya endüstriyel metinlerde model eğitmek isteyen araştırmacılar, çoğu kez kendi veri setini oluşturmak zorundadır.
AutoLabel-NER gibi araçların önemi burada ortaya çıkar. Araç, büyük bir model önermez; ancak modelin öğrenebileceği temiz veriyi üretmeyi kolaylaştırır. Bu, veri merkezli yapay zekâ yaklaşımı açısından önemlidir. Çünkü model performansını yalnızca mimariyle değil, veri kalitesiyle de iyileştirmek gerekir.
Gizlilik boyutu da kritiktir. Bir sağlık kurumu hasta notlarını, bir şirket teknik belgelerini, bir hukuk ekibi dava dosyalarını veya bir finans kurumu raporlarını dış bulut servisine yükleyemeyebilir. Çevrimdışı ve yerel çalışan bir etiketleme aracı, bu alanlarda araştırma ve model geliştirme için pratik bir kapı açar.
Çalışmanın mühendislik değeri de küçümsenmemelidir. İyi araştırma yazılımı yalnızca karmaşık algoritma üretmek değildir; bazen doğru yerde doğru küçük otomasyonları sunmaktır. Tek tıkla O etiketi tamamlama, boşluk temizleme, token sınırı hizalama ve aynı varlığı yayma gibi özellikler, büyük veri etiketleme projelerinde ciddi zaman ve kalite farkı yaratabilir.
Dikkat Noktaları
İlk dikkat noktası, çalışmanın preprint olmasıdır. Hakem değerlendirmesinden geçmediği için yazılımın iddiaları, kapsamı ve değerlendirme sonuçları ileride değişebilir. Bu nedenle çalışma, umut verici bir araştırma yazılımı tanıtımı olarak okunmalıdır.
İkinci dikkat noktası, aracın otomatik etiketleme stratejisinin exact-string eşleşmeye dayanmasıdır. Aynı kelime dizisini yakalamak tekrarları hızlandırır; fakat bağlama göre farklı anlam taşıyan eşleşmelerde kullanıcı kontrolü gerekir. Her otomatik yayılım doğru kabul edilmemelidir.
Üçüncü dikkat noktası, NER etiketleme kalitesinin yalnızca araçla belirlenmemesidir. Etiket yönergesi, etiketleyici eğitimi, alan uzmanlığı, uyuşmazlık çözümü ve kalite kontrol protokolü hâlâ gereklidir. Araç iyi olabilir; fakat kötü tanımlanmış etiket şeması yine tutarsız veri üretebilir.
Dördüncü dikkat noktası, NLTK tokenizasyonunun her dil ve alan için ideal olmayabileceğidir. İngilizce teknik metinlerde iyi sonuç verebilir; ancak Türkçe, Arapça, karma kodlu metinler, tıbbi kısaltmalar veya özel semboller içeren alanlarda tokenizasyon ayrıca test edilmelidir.
Beşinci dikkat noktası, çevrimdışı çalışmanın gizlilik açısından değerli olsa da tek başına tam güvenlik anlamına gelmemesidir. Yerel bilgisayarda dosya izinleri, disk şifreleme, yedekleme, erişim kontrolü ve proje dosyalarının güvenli paylaşımı ayrıca düşünülmelidir.
Sonuç
Bu çalışma, doğal dil işleme projelerinde veri hazırlamanın ne kadar merkezi olduğunu hatırlatıyor. AutoLabel-NER, özel alanlarda NER veri seti oluşturmak isteyen araştırmacılar için çevrimdışı, açık kaynak ve hafif bir masaüstü araç öneriyor.
Aracın güçlü tarafı, üç pratik sorunu aynı iş akışı içinde çözmeye çalışmasıdır: tekrar eden varlıkların yeniden yeniden etiketlenmesi, kullanıcı seçimi ile token sınırları arasındaki uyumsuzluk ve varlık dışı tokenların O etiketiyle tamamlanması. Bunlara BIO, JSON, XLSX ve CSV dışa aktarma desteği eklenince, ham metinden model eğitimine geçiş daha düzenli hale gelir.
Verianla açısından çalışmanın ana mesajı şudur: Yapay zekâda başarı yalnızca büyük modellerden gelmez. Özellikle özel alanlarda güvenilir veri seti üretmek, model geliştirme kadar stratejik bir iştir. AutoLabel-NER, bu “veri işi”ni daha hızlı, daha güvenli ve daha tekrarlanabilir hale getirmeyi hedefleyen pratik bir araştırma aracıdır.
Kaynak ve Yöntem Notu
Bu içerik, Abderrahmane Boudribila, Abdelouahed Tajer ve Zakaria Boulghasoul tarafından hazırlanan “AutoLabel-NER: A Lightweight Offline Annotation Tool for Building Custom Named Entity Recognition Datasets” başlıklı preprint çalışmaya dayalı olarak hazırlanmıştır. Çalışma; çevrimdışı NER veri etiketleme, BIO tagging, NLTK tabanlı token hizalama, otomatik etiket yayılımı, Outside etiketi tamamlama, yerel proje saklama ve standart veri dışa aktarma özelliklerine sahip AutoLabel-NER aracını tanıtmaktadır.
Bu içerik birebir çeviri değildir; çalışmanın ana fikri Verianla yayın çizgisine uygun biçimde sadeleştirilmiş ve özgün Türkçe editoryal makaleye dönüştürülmüştür.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir