

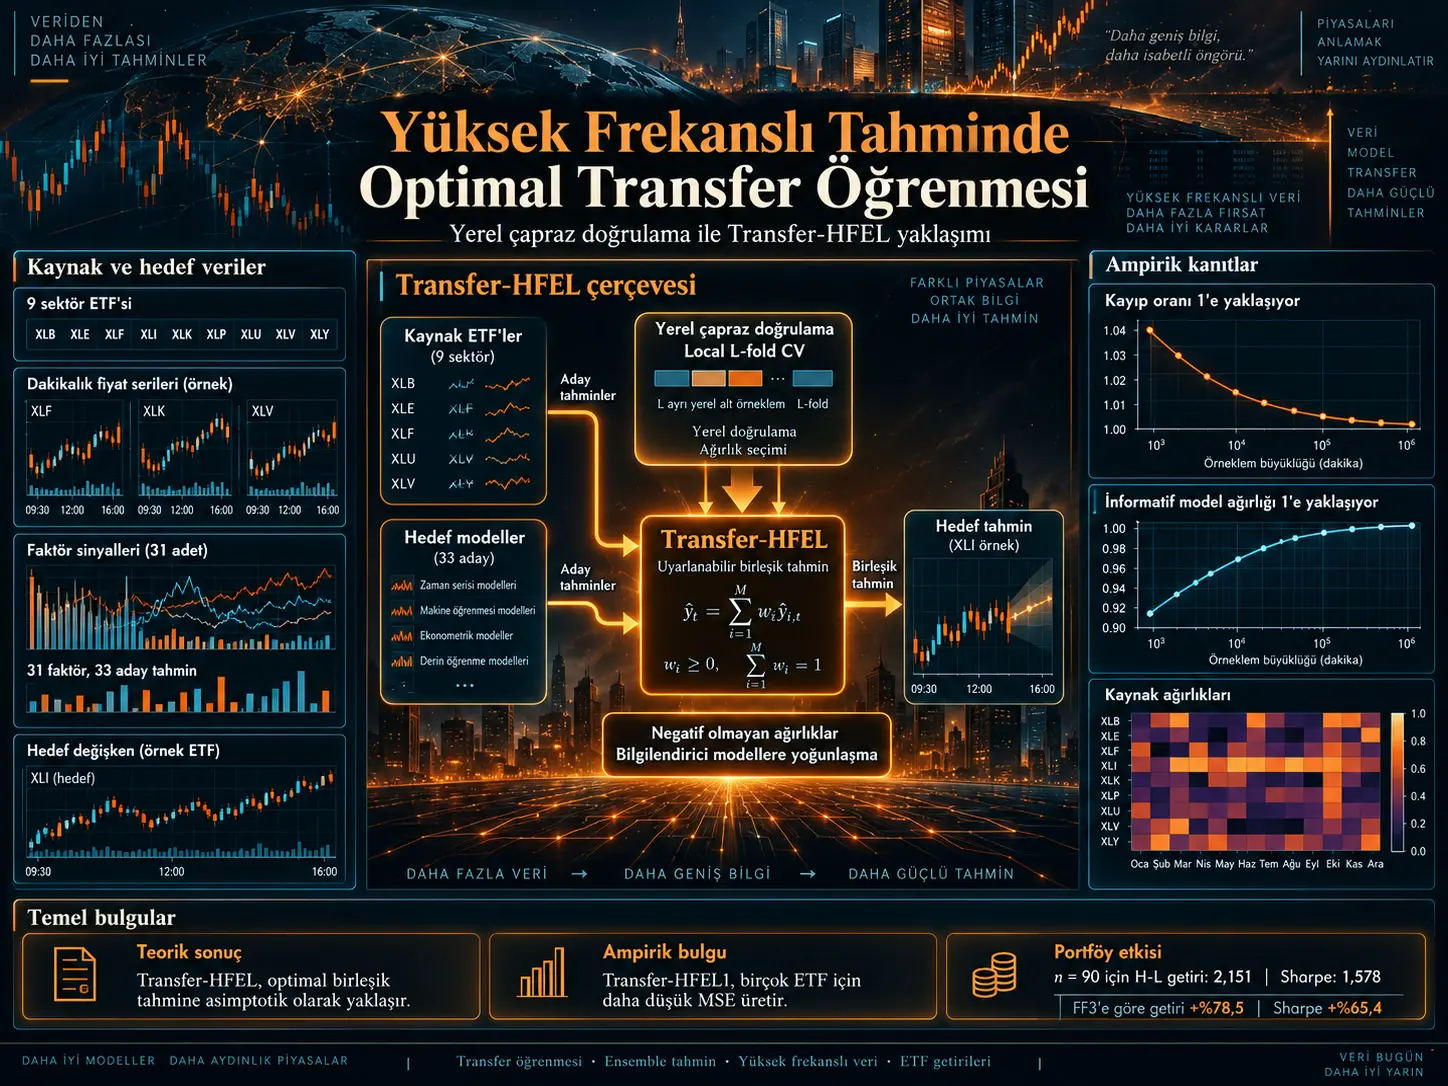
Yüksek Frekanslı Ensemble Öğrenme yoluyla Transfer Öğrenmesi (Transfer Learning through High-Frequency Ensemble Learning; Transfer-HFEL), hedef varlıktan ve heterojen kaynak varlıklardan üretilen birden fazla yüksek frekanslı tahmini, yerel L-katlı çapraz doğrulamayla seçilen negatif olmayan ve toplamı bire eşit ağırlıklar altında birleştiren transfer öğrenmesi ve ensemble tahmin çerçevesidir. Çalışma, kaynak ve hedef popülasyonların farklı veri üretim süreçlerine, farklı bilgi kümelerine ve yanlış belirlenmiş modellere sahip olabileceği bir state-space yapı kurmaktadır. Teorik olarak Transfer-HFEL'in bütün aday modeller yanlış belirlenmiş olsa bile erişilemez optimal ensemble'ın tahmin kaybına asimptotik olarak yaklaşabildiği; doğru ve bilgilendirici modeller mevcut olduğunda ise ağırlığın bu modellere yoğunlaştığı gösterilmektedir. Dokuz sektör ETF'sinin 2015 yılı dakika frekanslı getirileri üzerinde yapılan uygulamada yöntem, simple averaging, FULL, Fama–French üç faktör ve Fama–French beş faktör artı momentum gibi karşılaştırmalara göre birçok durumda daha düşük tahmin hatası üretmektedir. Çalışmanın kendi portföy deneyinde Transfer-HFEL1'in \(n=90\) durumundaki yıllıklandırılmış H–L getirisi, FF3 benchmark'ını yaklaşık %78,5; Sharpe oranı ise yaklaşık %65,4 aşmaktadır. Bu sonuçlar belirtilen örneklem ve portföy tasarımına özgüdür; gelecekteki piyasa performansı garantisi değildir.
Çalışmanın daha sıra dışı bulgusu, ortak sistematik parametreleri doğrudan başka varlıklardan transfer eden yapıdan ziyade, kaynak varlıklarda kullanılan açıklayıcı değişkenlere ortogonal kalan ve klasik faktör diliyle idiosyncratic bileşene benzeyen bilginin transfer edilmesinin daha güçlü tahmin kazanımları sağlamasıdır. Yazarlar bu sonucu klasik anlamda “idiosyncratic risk priminin varlığı” şeklinde yorumlamaz. Olası açıklamalar arasında model misspecification, hızlı değişen risk primleri, eksik common factors ve order-flow imbalance, bid–ask bounce, asynchronous trading ve ETF arbitrage gibi mikro-yapı sürtünmeleri bulunmaktadır.
Problem: Neden tek bir yüksek frekanslı tahmin modelini seçmek yeterli olmayabilir?
Yüksek frekanslı finansal veride aynı hedef değişken için çok sayıda makul tahmin modeli kurulabilir. Modeller farklı predictor kümelerini kullanabilir, başka varlıklardan bilgi taşıyabilir, farklı econometric yaklaşımlara dayanabilir veya hedef ve kaynak popülasyonlar arasında gerçek cross-sectional heterogeneity bulunabilir. Bu durumda araştırmacının karşı karşıya olduğu sorun yalnız “hangi model en iyidir?” değildir. Asıl sorun, her modelin taşıdığı yararlı bilginin hangi ağırlıklarla bir araya getirileceğidir.
Standart model averaging yöntemlerinin önemli bölümü tek bir popülasyonun düşük frekanslı verisi için geliştirilmiştir. Transfer-HFEL ise heterojen popülasyonlardan gelen tahminleri aynı ensemble içinde birleştirmeyi amaçlar ve parametrelerin sabit olmak zorunda olmadığı yüksek frekanslı state-space yapısına izin verir.
Hedef ve kaynak popülasyonların genel veri üretim süreci
Hedef veri:
\[ \{Y^{(0)},V^{(0)}\}_{0\leq t\leq T} \]
ve \(m=1,\ldots,M\) için kaynak veriler:
\[ \{Y^{(m)},V^{(m)}\}_{0\leq t\leq T} \]
olarak tanımlanmaktadır.
m-inci popülasyonun yüksek frekanslı increment'i:
\[ \Delta_i^nY^{(m)} = g^{(m)} \left( V_{t_{n,i}}^{(m)}, \theta_{t_{n,i}}^{(m)} \right) + Z_{n,i}^{(m)} + R_{n,i}^{(m)} \]
şeklindedir.
Burada \(g^{(m)}(\cdot)\) gözlenen veya latent feature'larla parametreleri bir araya getiren genel fonksiyonu; \(\theta^{(m)}\) zaman içinde değişebilen parametre vektörünü; \(Z^{(m)}\) martingale tipi hata bileşenini; \(R^{(m)}\) ise daha küçük mertebeli residual/discretization bileşenini temsil eder.
State-space feature yapısı:
\[ V_{t_{n,i}}^{(m)} = \int V^{(m)} \left( \zeta_{t_{n,i}}, \epsilon_{t_{n,i}} \right) F_\epsilon(d\epsilon) \]
biçiminde verilmiştir. \(\zeta_t\) latent süreç, \(\epsilon_t\) geçici i.i.d. shock ve \(V^{(m)}(\cdot)\) gözlenen feature'ı latent durumdan oluşturan, bilinmek zorunda olmayan dönüşümdür.
Bu genel form yalnız return regression için kullanılmaz. Çalışmanın çerçevesi trading volume, bid–ask spread, duration, turnover ve başka yüksek frekanslı değişkenlere de uygulanabilecek şekilde kurulmuştur.
High-frequency regression özel durumu
Çalışmanın ilk örneğinde predictor increment'i genel bir Itô semimartingale'dir:
\[ V_{t_{n,i}}^{(m)}=\Delta_i^nX^{(m)} \]
ve model hem continuous hem jump bileşenlerine izin verir:
\[ \Delta_i^nY^{(m)} = \left(\beta_{t_{n,i-1}}^{(m)}\right)^\top \Delta_i^nX^{(m)\circ} + \left(\ddot{\beta}_{t_{n,i-1}}^{(m)}\right)^\top \sum_{t_{n,i-1}\leq s\leq t_{n,i}} \Delta X_s^{(m)} + \Delta_i^nZ^{(m)} + R_{n,i}^{(m)} \]
Burada continuous regressors ile jump regressors için farklı coefficient bileşenleri bulunmaktadır. \(R_{n,i}^{(m)}\), discrete sampling nedeniyle oluşan approximation/discretization hatasını taşır.
General feature özel durumu
İkinci örnekte model lagged returns, trading volume, bid–ask spread, turnover ve transaction-return autocovariance gibi doğrudan gözlenen fakat gürültülü feature'larla çalışabilir:
\[ \Delta_i^nY^{(m)} = g^{(m)} \left( V_{t_{n,i}}^{(m)}, \theta_{t_{n,i}}^{(m)} \right) + Z_{n,i}^{(m)} \]
Bu yapı Transfer-HFEL'in yalnız klasik doğrusal factor regression'a bağlı olmadığını göstermektedir.
Transfer-HFEL Nedir?
Transfer-HFEL, hedef popülasyondan üretilen alternatif tahminlerle heterojen kaynak popülasyonlardan transfer edilen tahminleri tek bir convex ensemble içinde birleştirir ve bunların ağırlıklarını yüksek frekanslı zaman bağımlılığını dikkate alan yerel L-katlı çapraz doğrulama ölçütüyle seçer.
Aday tahminler nasıl oluşturuluyor?
Çalışmada toplam \(M+K\) tahmin vardır. Bunların:
- \(M\) tanesi kaynak domain'lerden gelir,
- \(K\) tanesi hedef domain'in farklı predictor modellerinden gelir.
m-inci aday tahmin genel biçimde:
\[ \Delta_i^n\widehat{Y}^{(0)}_m \]
ile gösterilir.
Kaynak modellerde önce kaynak veri üzerinde parametre tahmini yapılabilir ve elde edilen bilgi target domain tahminine aktarılabilir. Target modellerde ise farklı predictor alt kümeleri kullanılarak model-selection uncertainty ensemble içine dahil edilir.
Ensemble ağırlıkları
Ağırlık vektörü:
\[ w\in\mathcal W \]
ve:
\[ \mathcal W= \left\{ w\in[0,1]^{M+K}: \sum_{m=0}^{M+K-1}w^{(m)}=1 \right\} \]
olarak kısıtlanır.
Dolayısıyla her ağırlık negatife düşemez ve bütün ağırlıkların toplamı birdir.
Birleştirilmiş forecast:
\[ \Delta_i^n\widehat{Y}^{(0)}(w) = \sum_{m=0}^{M+K-1} w^{(m)} \Delta_i^n\widehat{Y}^{(0)}_m \]
şeklindedir.
Bu constraint'ler, modelin bir kaynak sinyali ters işaretli sınırsız hedge gibi kullanmasını engeller. Yöntem bunun yerine yararlı bilgi taşıyan kaynaklara pozitif ağırlık dağıtmaya çalışır.
Transfer-HFEL1: idiosyncratic/orthogonal bileşen transferi
Çalışmanın ampirik uygulamasındaki ilk transfer biçimi, kaynak varlığın kendi regressors'larıyla açıklanamayan bileşenini hedef tahmine taşıyan yapıdır:
\[ h= \Delta_i^nY^{(m)} - \left( \widehat{\beta}_{t_{n,i}}^{(m)} \right)^\top \Delta_i^nX^{(m)} \,1_{\{ \|\Delta_i^nX^{(m)}\| \leq u_n^{(m)} \}} \]
Bu bileşen, kaynak regression'ının conditioning variables'ına ortogonal kalan bilgi olarak yorumlanır. Makale bunu klasik asset-pricing terminolojisindeki diversifiable veya idiosyncratic risk bileşenine benzetmektedir.
Transfer-HFEL2: parameter transfer
İkinci yaklaşım kaynakta tahmin edilen parametreleri hedef varlığın predictor'larına uygular:
\[ h= \left( \widehat{\beta}_{t_{n,i}}^{(m)} \right)^\top \Delta_i^nX^{(0)} \,1_{\{ \|\Delta_i^nX^{(0)}\| \leq u_n^{(0)} \}} \]
Bu yapı ortak veya systematic bilgiyi parametre üzerinden transfer etmeyi temsil etmektedir.
İki yaklaşım arasındaki fark kritiktir: Transfer-HFEL1, kaynak varlığın target predictors tarafından doğrudan temsil edilmeyen residual/cross-sectional bilgisini taşırken Transfer-HFEL2 daha çok ortak coefficient yapısının target'a uygulanmasına dayanır.
Yerel L-Katlı Çapraz Doğrulama Neden Gerekli?
Yerel L-katlı çapraz doğrulama, yüksek frekanslı veride random veya bütün örneklemi kapsayan global fold'ların zaman bağımlılığını ve değişen covariance yapısını bozabilmesi nedeniyle doğrulamayı kısa ve birbirine yakın zaman blokları içinde gerçekleştirir; böylece fold'ların yaklaşık aynı yerel veri üretim sürecinden gelmesi amaçlanır.
Standart cross-validation problemi
Düşük frekanslı makine öğrenmesinde gözlemleri rastgele train ve validation gruplarına ayırmak çoğu zaman kabul edilebilir. Fakat high-frequency returns:
- serial dependence,
- volatility clustering,
- time-varying covariance,
- microstructure noise,
- asynchronous observation
gibi yapılar taşıyabilir.
Rastgele bölme, yakın zamanlı bağımlı gözlemleri birbirinden ayırabilir ve validation setinin gelecekte gerçekten karşılaşılacak koşulları temsil etmesini zorlaştırabilir. Çok uzun global folds ise değişen piyasa rejimlerini aynı DGP kabul etme riskini artırır.
Local L-fold yapısı
Yöntem önce \([0,T]\) aralığını \(H_n\) yerel zaman bloğuna ayırır. Her bloktaki zaman genişliği asimptotik olarak küçülürken blok başına observation sayısı \(k_n\) oranında büyür.
Her yerel blok daha sonra \(L\) fold'a bölünür.
j-inci blok ve p-inci fold için model, aynı bloktaki p-inci fold hariç tutularak tahmin edilir. Validation error yalnız o yerel fold üzerinde hesaplanır.
Cross-validation criterion:
\[ CV(w) = \sum_{j=1}^{H_n} \sum_{p=1}^{L} \sum_i \left( \Delta_i^n\widetilde{Y}^{(0)}_{[j,-p]}(w) - \Delta_i^nY^{(0)}_{[j,p]} \right)^2 \]
şeklindedir.
\(\Delta_i^n\widetilde{Y}^{(0)}_{[j,-p]}(w)\), p-inci validation fold'u çıkarılarak elde edilen target-side forecast'ların ağırlıklı birleşimidir.
Önemli teknik ayrıntı, local L-fold işleminin target data üzerinde uygulanmasıdır. Source-domain parameter estimates, target'ın p-inci fold'u çıkarıldığı için yeniden hesaplanmaz; çünkü bu fold source data'nın bir parçası değildir.
Yerelliğin istatistiksel amacı
Local windows, fold'ların aynı kısa dönemli covariance rejimine daha yakın olmasını sağlar. Çalışmanın yaklaşımı, yüksek frekanslı piyasada uzun dönem boyunca global stationarity varsaymak yerine kısa dönem conditional stationarity'den yararlanmaktadır.
Asimptotik Optimalite Ne Anlama Geliyor?
Transfer-HFEL'in asimptotik optimalitesi, örneklem yoğunlaştıkça local cross-validation ile seçilen ağırlıkların oluşturduğu ensemble'ın quadratic prediction loss'unun, gerçek veri üretim süreci bilinseydi seçilebilecek infeasible optimal ağırlıkların loss'una oranının olasılıkta 1'e yakınsaması anlamına gelir.
Prediction loss
Çalışma tahmin performansını:
\[ L(w) = \sum_{i=k_n+1}^{n} \left( \Delta_i^n\widehat Y^{(0)}(w) - \Delta_i^n\mu^{(0)} \right)^2 \]
ile ölçmektedir.
Buradaki \(\Delta_i^n\mu^{(0)}\), target DGP'nin öngörülebilir/predictable bileşenidir.
Theorem 1: infeasible minimum loss için alt sınır
Bütün candidate models misspecified olduğunda çalışma belirli regularity conditions altında infeasible minimum loss'un dejenere şekilde sıfıra gitmesini önleyen pozitif bir alt sınır elde eder. Bu teknik sonuç sonraki asymptotic-optimality ispatının kurulmasına yardımcı olur.
Theorem 2: optimality
Temel sonuç:
\[ \frac{ L(\widehat w) }{ \inf_{w\in\mathcal W}L(w) } \xrightarrow{p}1 \]
şeklindedir.
Başka bir ifadeyle candidate modellerin tamamı farklı derecelerde yanlış olsa bile local-CV ağırlıklı ensemble, asimptotik olarak mevcut candidate set içindeki en iyi erişilemez kombinasyonun riskine yaklaşır.
Bu, “Transfer-HFEL gerçek DGP'yi kesin olarak bulur” anlamına gelmez. Optimalite candidate forecast ailesi içindeki quadratic-loss benchmark'ına göredir.
Theorem 3: informative modellerin ağırlığı
Target model doğru belirlenmiş ve target ile aynı pseudo-true parameter bilgisini paylaşan informative models kümesi \(\mathcal D\) olsun.
Bu modellere verilen toplam ağırlık:
\[ \tau= \sum_{m\in\mathcal D}w^{(m)} \]
ve tahmini:
\[ \widehat\tau= \sum_{m\in\mathcal D}\widehat w^{(m)} \]
ise çalışma:
\[ \widehat\tau\xrightarrow{p}1 \]
sonucunu elde eder.
Yani örneklem büyüdükçe toplam ensemble ağırlığı informative modellere yoğunlaşmaktadır. Çok farklı veya yararsız kaynakların ağırlığı asimptotik olarak sıfıra yaklaşabilir.
Tek doğru model özel durumu
Bu sonucun doğal sonucu, yalnız bir model doğruysa yöntemin asimptotik olarak o modele tüm ağırlığı vermeye yaklaşmasıdır. Böylece transfer learning'in potansiyel negative-transfer riski ağırlık seçimi aracılığıyla sınırlandırılmaya çalışılır.
Theorem 4: parameter consistency
En büyük target model doğru belirlendiğinde shared-parameter estimator için kaynak:
\[ \left\| \widehat\beta_t(\widehat w) - \beta^{(0)}_{t-\Delta_n} \right\| = O_p \left( k_n^{1/2}\Delta_n^{1/2} + k_n^{-1/2} \right) \]
oranını vermektedir.
Çalışmanın kullandığı small-window scheme altında:
\[ k_n\asymp\Delta_n^{-\varsigma}, \qquad \varsigma<\frac12 \]
ve baskın hata terimi:
\[ O_p(k_n^{-1/2}) \]
haline gelir.
Bu teorik sonuçların sınırı
Asimptotik sonuçların tamamı çalışmada verilen regularity conditions altında geçerlidir. Bir finansal uygulamada “teorem var, dolayısıyla yöntem her piyasa rejiminde daha iyi tahmin eder” sonucu çıkarılamaz. Finite-sample davranış ayrıca simülasyon ve gerçek veri uygulamasıyla sınanmaktadır.
Çalışmanın Yöntemi ve Bulguları
Monte Carlo tasarımı
Çalışma önce finite-sample davranışını iki veri üretim süreci üzerinden inceler.
DGP1 — tamamen transfer edilebilir yapı:
\[ dY_t^{(m)} = \left( \beta_t^{(m)}+\delta_m \right)^\top dX_t^{(m)} + Z_t^{(m)} \]
DGP2 — kısmen transfer edilebilir yapı:
\[ dY_t^{(m)} = \left( \beta_t^{(m)}+\delta_m \right)^\top dX_t^{(m)} + \left( \alpha_t^{(m)} \right)^\top dU_t^{(m)} + Z_t^{(m)} \]
DGP2'de \(\beta_t^{(m)}\) popülasyonlar arasında transfer edilebilirken \(\alpha_t^{(m)}\) model-specific bilgi taşımaktadır.
Predictor ve residual süreçleri continuous diffusion ve jump bileşenlerini birlikte içermektedir. Volatility süreçleri Cox–Ingersoll–Ross tipi dynamics ile, jump sizes ise double-exponential dağılımla modellenmiştir.
| Öğe | Kaynakta kullanılan değer/yapı |
|---|---|
| Temel predictor boyutu | d = 40 |
| Kaynak model sayısı M | 3, 5, 7 |
| Sample size n | 3600, 8800, 12300, 17600, 21100 |
| Sampling yapısı | 1 dakikalık frekans |
| Kaynak-target parameter shift | \(\delta_m=0.1(m-1)(-1)^m\) |
| Predictor jump intensity | \(\lambda_X^J=7\) |
| DGP2 U jump intensity | \(\lambda_U^J=6\) |
| Residual jump intensity | \(\lambda_Z^J=14\) |
Kaynakta bulunan simülasyon tanımı tutarsızlığı
Simülasyon senaryolarının numaralandırılmasında kaynak metnin kendi içinde bir tutarsızlığı vardır. İlk tanımda Scenario 1 target modelin correctly specified, Scenario 2 target modelin misspecified olduğu yazılmaktadır. Daha sonraki sonuç paragrafında ise bu iki scenario numarası ters biçimde kullanılmaktadır. Şekil başlıkları koşulu doğrudan “model misspecification” ve “target model correctly specified” diye verdiğinden Verianla anlatımında bilimsel koşul esas alınmış, scenario numarası kesinleştirilmemiştir.
Ayrıca ana metinde misspecified target'ın 40 predictor'ın son üç bileşenini çıkararak 37 boyuta indirildiği belirtilirken, simülasyon parametre tablosunun notunda misspecified durumda son beş bileşenin çıkarıldığı yazmaktadır. Kaynak bu farkı açıklamamaktadır.
Şekil 1: oracle loss'a yakınsama
Kaynağın 26. sayfasındaki Şekil 1, model misspecification altında:
\[ \frac{ L(\widehat w) }{ \inf_w L(w) } \]
oranını sample size'a karşı göstermektedir.
DGP1 ve DGP2 ile \(M=3,5,7\) konfigürasyonlarının tamamında oran örneklem büyüdükçe 1'e doğru yaklaşmaktadır. Kaynağın verdiği örnekte DGP2 ve \(M=5\) için oran \(n=3600\)'de yaklaşık 1,020 iken \(n=21100\)'de 1,001'in altına inmektedir.
Bu desen Theorem 2'deki asymptotic optimality sonucuyla uyumludur.
Şekil 2: informative model ağırlıkları
27. sayfadaki Şekil 2, target model correctly specified olduğunda informative modellere verilen toplam ağırlığı göstermektedir.
Bütün simülasyon konfigürasyonlarında ağırlık örneklem büyüdükçe 1'e yaklaşmaktadır. Kaynağın örneğinde DGP2, \(M=3\) durumunda informative-weight toplamı \(n=8800\)'de 0,95'i aşmakta ve daha büyük örneklemlerde 1'e yaklaşmaktadır.
Bu bulgu Theorem 3'ün finite-sample karşılığı olarak yorumlanmaktadır.
Gerçek veri: dokuz sektör ETF'si
Empirik çalışma Ocak–Aralık 2015 arasında dokuz ABD sektör ETF'sinin dakika düzeyindeki log getirilerini kullanmaktadır.
| Kod | Sektör |
|---|---|
| XLB | Materials |
| XLE | Energy |
| XLF | Financials |
| XLI | Industrials |
| XLK | Technology |
| XLP | Consumer Staples |
| XLU | Utilities |
| XLV | Healthcare |
| XLY | Consumer Discretionary |
Her ETF target seçildiğinde kalan sekiz ETF source domain görevi görmektedir.
31 predictor/factor
Model toplam 31 exogenous factor kullanır. Bunların 25'i çalışmanın factor-zoo kümesinden, altısı ise Fama–French five-factor-plus-momentum yapısından gelir.
Faktörler temel olarak:
- Size,
- Profitability,
- Low Risk,
- Leverage
kategorilerine ayrılmıştır.
Kaynak tabloda short interest, cash-flow-to-price variance, pension funding status, operating profitability, R&D capital-to-assets, Altman Z-score, market beta, downside beta, return volatility, turnover ve zero-trade ölçümleri gibi değişkenler bulunmaktadır.
Faktörler return frekansıyla uyumlu hale getirmek için log dönüşümü ve differencing işleminden geçirilmektedir.
33 aday tahmin nasıl oluşuyor?
Her target ETF için candidate set:
- 1 adet bütün 31 faktörü kullanan target FULL model,
- 8 adet source-ETF modeli,
- 24 adet target-domain subset model
olmak üzere toplam:
33 tahmin
içerir.
24 subset model:
- 12 single-factor,
- 4 three-factor,
- 4 five-factor,
- 4 ten-factor
modelden oluşur.
Karşılaştırılan yöntemler
Ampirik uygulama:
- Transfer-HFEL1,
- Transfer-HFEL2,
- SA1,
- SA2,
- FULL,
- Fama–French üç faktör (FF3),
- Fama–French five-factor plus momentum (FF5P1)
yöntemlerini karşılaştırmaktadır.
SA1 ve SA2 ilgili Transfer-HFEL candidate setlerinin equal-weight sürümleridir. Böylece optimal ağırlık seçiminin değeri, kullanılan modellerin yalnız çeşitlendirilmesinden ayrılmaya çalışılır.
Eksik veri deneyi
Covariates missing completely at random varsayımı altında:
\[ p\in\{0,\ 25\%,\ 45\%,\ 65\%\} \]
missing oranları kullanılmıştır.
Farklı target domain'ler farklı observation kayıplarına sahip olacak şekilde asynchronous missing pattern oluşturulur. Parameter estimation için complete-case analysis kullanılır.
Transfer-HFEL tahmin doğruluğu
Kaynak sonuçlarına göre Transfer-HFEL yöntemleri aynı candidate setlerini kullanan simple averaging yöntemlerini çok sayıda ETF ve missing-rate durumunda geride bırakmaktadır.
Missing data yokken Transfer-HFEL1'in SA1'e göre MSE iyileştirmeleri kaynak metinde yaklaşık:
%15,9–%49,2
aralığında verilmektedir.
Transfer-HFEL2'nin SA2'ye göre kazançları ise:
%10,0–%15,7
aralığındadır.
Kaynak ayrıca %45 missing-rate durumunda simple averaging'e karşı bazı hedeflerde yaklaşık %52'ye varan iyileşme bildirir.
Seçilmiş MSE sonuçları
| Missing | Target | Transfer-HFEL1 | SA1 | Transfer-HFEL2 | FULL | FF3 |
|---|---|---|---|---|---|---|
| 0% | XLB | 0.820 | 1.347 | 1.364 | 1.162 | 1.458 |
| 0% | XLI | 0.479 | 0.914 | 0.963 | 0.861 | 1.110 |
| 0% | XLY | 0.517 | 1.017 | 1.052 | 0.941 | 1.204 |
| 45% | XLI | 0.220 | 0.447 | 0.435 | 0.713 | 0.566 |
| 45% | XLY | 0.239 | 0.499 | 0.472 | 0.772 | 0.616 |
| 65% | XLB | 0.556 | 0.951 | 0.897 | 1.405 | 1.079 |
| 65% | XLK | 0.444 | 0.865 | 0.823 | 1.295 | 1.008 |
| 65% | XLY | 0.344 | 0.726 | 0.685 | 1.111 | 0.885 |
Tablodaki absolute MSE seviyelerini farklı missing-rate satırları arasında basitçe “eksik veri arttıkça MSE düştü/yükseldi” şeklinde yorumlamak yerine, kaynak çalışmanın yaptığı gibi aynı missing-rate içindeki yöntem karşılaştırmalarına odaklanmak gerekir.
İdiosyncratic Bilgi Transferi Neden Common-Parameter Transferinden Daha Başarılı Olabilir?
Çalışmanın ETF uygulamasında Transfer-HFEL1, source varlıkların factor regressors'a ortogonal kalan bileşenlerinden cross-sectional bilgi taşırken Transfer-HFEL2 esas olarak ortak parameter bilgisini target'a aktarır; Transfer-HFEL1'in daha düşük MSE üretmesi, bu residual bileşenin model misspecification, zamanla değişen risk primleri veya market-microstructure etkileri nedeniyle tahmin için yararlı bilgi içerebileceğini düşündürmektedir.
Tablo 4'teki doğrudan karşılaştırma
Kaynak Tablo 4'ün “Gain (%)” sütunu Transfer-HFEL1'in Transfer-HFEL2'ye göre MSE avantajını göstermektedir. Örnek olarak:
- XLB, missing %0: %39,9,
- XLI, missing %0: %50,3,
- XLY, missing %0: %50,8,
- XLK, missing %45: %46,5,
- XLY, missing %65: %49,8.
Bu karşılaştırmalar idiosyncratic-component transferinin çalışmanın uygulamasında parameter-transfer sürümünden daha güçlü olduğunu göstermektedir.
Weight heatmap'leri ne gösteriyor?
Kaynağın 28. sayfasındaki Şekil 3 Transfer-HFEL1, 29. sayfasındaki Şekil 4 Transfer-HFEL2 ağırlıklarını target ETF ve aya göre göstermektedir.
Ağırlıklar source ETF'ler arasında eşit değildir; target'a ve aya bağlı olarak önemli ölçüde değişmektedir. Örneğin XLE target olduğunda XLB'ye verilen ağırlığın birçok ayda belirgin biçimde yüksek olduğu görülür. Kaynak, XLE tahmininde XLB ağırlığının on iki ayın dokuzunda 0,4'ün üzerinde olduğunu belirtmektedir.
Ocak 2015 örneğinde XLE target iken:
Transfer-HFEL1 → XLB ağırlığı 0,76
Transfer-HFEL2 → XLB ağırlığı 0,33
olarak raporlanmaktadır.
Her iki yöntem aynı source ETF'yi en yüksek ağırlıkla seçerken ağırlığın magnitude'u ciddi biçimde farklıdır.
Yazarların ekonomik açıklaması
Enerji exploration ve extraction faaliyetleri malzeme girdilerine bağımlıdır; enerji ve materials sektörleri arasında upstream–downstream bağlantıları bulunabilir. Bu nedenle XLB kaynak bilgisinin XLE getirileri için leading information taşıması ekonomik olarak makul görülebilir.
Ancak çalışma bu örneği nedensel bir üretim zinciri testi olarak kurmamaktadır. Weight pattern ile ekonomik sektör ilişkisi arasında yorum yapılmaktadır.
Bu bulgu klasik asset pricing'e gerçekten aykırı mı?
İlk bakışta idiosyncratic bileşenin tahmin açısından daha yararlı olması, diversified idiosyncratic risk'in risk primi taşımaması gerektiği şeklindeki standart asset-pricing yaklaşımıyla gerilimli görünebilir.
Kaynak üç açıklama üzerinde durmaktadır.
1. Model misspecification
31 faktörün önemli bölümü low-frequency characteristics kökenlidir. High-frequency return dynamics için önemli bazı common factors modele hiç girmemiş olabilir. Bu durumda regression residual'ında görülen “idiosyncratic” bilgi aslında omitted systematic information taşıyabilir.
2. Time-varying risk premia
Historically estimated factor loadings risk exposure'ı gösterebilir fakat o riskin anlık compensation değerinin nasıl değiştiğini tam olarak göstermez. High-frequency return dynamics çok hızlı değişen risk premia tarafından etkileniyorsa cross-sectional residual bileşenler bu dinamiğin bir bölümünü taşıyabilir.
3. Market microstructure
Order-flow imbalance, bid–ask bounce, asynchronous trading ve ETF arbitrage pressures düşük frekanslı karakteristiklere ortogonal fakat cross-sectionally correlated geçici fiyat hareketleri oluşturabilir. Factor regression bunları “idiosyncratic” olarak sınıflandırsa da kısa ufuklu tahmin için yararlı olabilirler.
Çalışma bu üç açıklamadan hangisinin baskın olduğunu ayrı bir identification tasarımıyla göstermemektedir. Bunlar ampirik bulgunun olası mekanizmalarıdır.
Missing data altında source information
Kaynak, target covariates eksildiğinde source data'nın göreli değerinin arttığını göstermektedir. Örneğin XLB için FULL modele karşı Transfer-HFEL1 MSE iyileştirmesi missing oranı %25–%65 arasında yaklaşık %59,4–%60,4 aralığında raporlanır. Aynı target için FF3'e karşı iyileşme yaklaşık %47,3–%48,5'tir.
Bu sonuç, target domain'in observation sayısı düştüğünde yakın veya ilişkili source domain'lerden bilgi taşımanın tahmin hatasını azaltabileceği şeklinde yorumlanmaktadır.
Ekonomik performans deneyi
Çalışmanın ikinci ampirik katmanı sektör ETF'lerinden tekil hisse getirilerine geçer. Toplam 80 hisse sırayla target asset olarak seçilir. Target hissenin kendi sektör ETF'si source setinden çıkarılır ve kalan sekiz sektör ETF'si source dataset olarak kullanılır.
Her estimation window içinde stock-return predictions hesaplanır ve hisseler tahminlerine göre 10 decile portfolio'ya ayrılır.
Low en düşük öngörülen getirili decile, High en yüksek öngörülen getirili decile'dır.
Long-short sonuç:
\[ H-L = R_{\mathrm{High}} - R_{\mathrm{Low}} \]
olarak hesaplanır.
Kaynak Tablo 5'te:
- \(k_n=30\),
- \(L=5\),
- missing rate = %70,
- forecast horizon için \(n=40\) ve \(n=90\)
ayarları verilmiştir.
n = 40 portföy sonuçları
| Yöntem | Annualized return, H–L (\(\times10^{-2}\)) | Annualized Sharpe |
|---|---|---|
| Transfer-HFEL1 | 1.586 | 1.566 |
| SA1 | 0.858 | 0.919 |
| Transfer-HFEL2 | 1.421 | 1.409 |
| SA2 | 1.411 | 1.504 |
| FF3 | 1.035 | 1.132 |
| FF5P1 | 1.248 | 1.333 |
n = 90 portföy sonuçları
| Yöntem | Annualized return, H–L (\(\times10^{-2}\)) | Annualized Sharpe |
|---|---|---|
| Transfer-HFEL1 | 2.151 | 1.578 |
| SA1 | 1.154 | 0.883 |
| Transfer-HFEL2 | 2.085 | 1.531 |
| SA2 | 1.939 | 1.478 |
| FF3 | 1.205 | 0.954 |
| FF5P1 | 1.662 | 1.282 |
n=90 durumunda kaynak:
\[ \frac{2.151-1.205}{1.205} \approx 78.5\% \]
annualized-return improvement ve:
\[ \frac{1.578-0.954}{0.954} \approx65.4\% \]
Sharpe improvement raporlamaktadır.
Bu yüzde karşılaştırmaları FF3 benchmark'ına göredir. Tablo return satırlarının ölçeğini \(10^{-2}\) olarak verdiği için Verianla metninde 2,151 rakamı doğrudan “%215,1 getiri” gibi yeniden yorumlanmamıştır.
Bu portföy sonucu ne anlama geliyor?
Sonuç, çalışmanın belirlediği sample, prediction horizon, missingness tasarımı, stock sorting ve long-short portfolio yöntemi altında Transfer-HFEL1 tahminlerinin daha güçlü cross-sectional ranking bilgisi taşıdığını göstermektedir.
Sonuç şunları tek başına göstermez:
- işlem maliyetlerinden sonra aynı performansın korunacağını,
- slippage ve market impact'in önemsiz olduğunu,
- 2015 dışındaki piyasa dönemlerinde aynı sonucu,
- başka asset class'larda aynı performansı,
- gelecekteki Sharpe oranının 1,578 olacağını.
Kaynak tabloda transaction-cost veya live-execution katmanı raporlanmamaktadır. Bu nedenle ekonomik performans, çalışmanın oluşturduğu portfolio-return deneyi bağlamında yorumlanmalıdır.
Çalışmanın desteklediği sonuçlar
- Heterojen kaynak ve hedef forecast'ları local-CV tabanlı ensemble içinde birleştiren Transfer-HFEL teorik olarak tanımlanabilir.
- Belirtilen regularity conditions altında candidate modeller misspecified olduğunda Transfer-HFEL asymptotically optimal loss'a yaklaşır.
- Informative modeller mevcut olduğunda toplam ağırlık asimptotik olarak bu modellere yoğunlaşır.
- Monte Carlo sonuçları teorik convergence desenlerini finite sample'da desteklemektedir.
- 2015 dokuz-sector-ETF uygulamasında Transfer-HFEL birçok karşılaştırmada simple averaging ve factor benchmarks'a göre daha düşük MSE üretmektedir.
- Target data eksildiğinde source-domain bilgisinin göreli yararı bazı hedeflerde belirgin biçimde artmaktadır.
- İncelenen uygulamada idiosyncratic-component transferi parameter transferinden daha yüksek forecast gains sağlamaktadır.
- 80-stock portfolio deneyinde Transfer-HFEL1, verilen tasarım altında FF3 ve diğer benchmark'lara göre daha yüksek H–L return ve Sharpe değerleri üretmiştir.
Çalışmanın desteklemediği sonuçlar
- Transfer-HFEL'in bütün finansal piyasalarda ve bütün dönemlerde en iyi forecast yöntemi olduğu gösterilmemiştir.
- Idiosyncratic risk'in klasik asset-pricing anlamında sistematik olarak fiyatlandığı kanıtlanmamıştır.
- Transfer-HFEL1'in başarısının kesin mekanizması model misspecification, time-varying risk premium veya microstructure arasında ayrıştırılmamıştır.
- Portföy sonuçları live trading execution veya net transaction-cost performansı değildir.
- Asimptotik optimalite finite sample'da hatasız tahmin anlamına gelmez.
- Informative source'ların ekonomik nedenselliği weight heatmap'lerinden tek başına çıkarılamaz.
- Eksik veri sonuçları missing-not-at-random veya arbitrary missingness yapıları için doğrudan kanıt oluşturmaz; ampirik deney MCAR düzeni kullanmaktadır.
Uygulama alanları ve gelecek çalışma
Kaynak Transfer-HFEL'in high-frequency return prediction dışında:
- new-product pricing,
- portfolio optimization,
- factor selection,
- yetersiz geçmiş verisi bulunan yeni finansal ürünlerin tahmini
gibi alanlara genişletilebileceğini belirtmektedir.
Yeni listelenen equities, novel derivatives veya emerging cryptocurrency pairs gibi varlıklarda target history kısa olabilirken ilişkili varlıklar daha uzun veri geçmişi sağlayabilir. Ayrıca asynchronous trading ve irregular observations source-target örneklem boyutlarını farklı etkileyebilir. Yazarlar bu sorunların Transfer-HFEL'in gelecekte genişletilebileceği alanlar olduğunu belirtmektedir; mevcut çalışma bu uzantıları gerçekleştirmemektedir.
Kaynak ve Yöntem Notu
Özgün çalışma:Optimal Transfer Learning for High-Frequency Prediction by Local Cross-validation.
Yazarlar: Dachuan Chen; Jia Li; Yuying Sun; Yue Tang.
Corresponding author: Yuying Sun.
Kurumlar: Dachuan Chen ve Jia Li — School of Economics, Singapore Management University. Yuying Sun ve Yue Tang — State Key Laboratory of Mathematical Sciences, Academy of Mathematics and Systems Science, Chinese Academy of Sciences; School of Economics and Management, University of Chinese Academy of Sciences.
Platform: SSRN.
SSRN DOI: 10.2139/ssrn.7189238.
Bibliyografik tarih: SSRN kaydında Date Written 27 Temmuz 2026; Posted 6 Ağustos 2026.
Kaynak türü: Çalışma makalesi/preprint. İncelenen bibliyografik kayıtta hakemli bir dergi yayını doğrulanmamıştır.
Lisans/telif durumu: SSRN kaydı açık bir Creative Commons yeniden kullanım lisansı vermemekte ve yeniden kullanım için izin gerektiğini belirtmektedir. Bu nedenle Verianla metni kaynak çalışmanın cümle, paragraf, şekil veya özgün tablo sunumunu kopyalamaz. Bilimsel olgular, yöntem, matematik ve sonuçlar bağımsız eğitimsel yapıda aktarılmıştır.
Finansman: Dachuan Chen için Singapore Ministry of Education Tier 1 Grant No. 24-SOE-SMU-042 ve National Natural Science Foundation of China Grant No. 12571515; Jia Li için Singapore Ministry of Education Tier 2 Grant T2EP40124-0021; Yuying Sun için Beijing Natural Science Foundation Grant JQ25030 ve NSFC Grant Nos. 72322016 ve 72073126 kaynakta belirtilmiştir.
Empirik veri: Ana ETF uygulaması Ocak–Aralık 2015 arasındaki dokuz sektör ETF'sinin minute-level log returns verisini kullanmaktadır. 31 exogenous factor ve target başına 33 candidate forecast oluşturulmaktadır.
Simülasyon: DGP1 ve DGP2, diffusion, CIR-type variance dynamics ve jump bileşenleri içeren high-frequency regression süreçleridir. Source model sayısı \(M=3,5,7\), sample size \(n=3600,8800,12300,17600,21100\) değerleriyle incelenmiştir.
Temel teorik sonuç: Belirtilen regularity conditions altında Transfer-HFEL'in quadratic prediction loss'u candidate set içindeki infeasible optimal combination loss'una asimptotik olarak yaklaşmaktadır. Correctly specified/informative modeller bulunduğunda ağırlıklar bu modellere yoğunlaşır.
Temel empirik sonuç: İncelenen ETF uygulamasında Transfer-HFEL1 çoğu karşılaştırmada daha düşük MSE göstermekte; idiosyncratic/orthogonal source information transferi parameter transferinden daha başarılı görünmektedir.
Ekonomik sonuç sınırı: Kaynak portfolio returns ve Sharpe ratios raporlamaktadır ancak bu bölüm live execution, market impact ve ayrıntılı transaction-cost backtest'i olarak tasarlanmamıştır. Dolayısıyla sonuçlar belirlenen araştırma portföyünün performans ölçüleridir.
Kaynak-içi tutarsızlıklar: Simülasyonda Scenario 1/Scenario 2'nin correctly specified ve misspecified durumlara atanışı sonuç paragrafında ilk tanıma göre ters kullanılmaktadır. Ayrıca misspecified target'ın üç predictor mı yoksa beş predictor mı çıkardığı konusunda ana metin ile Table 1 notu uyuşmamaktadır. Bu noktalar sessizce düzeltilmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir