

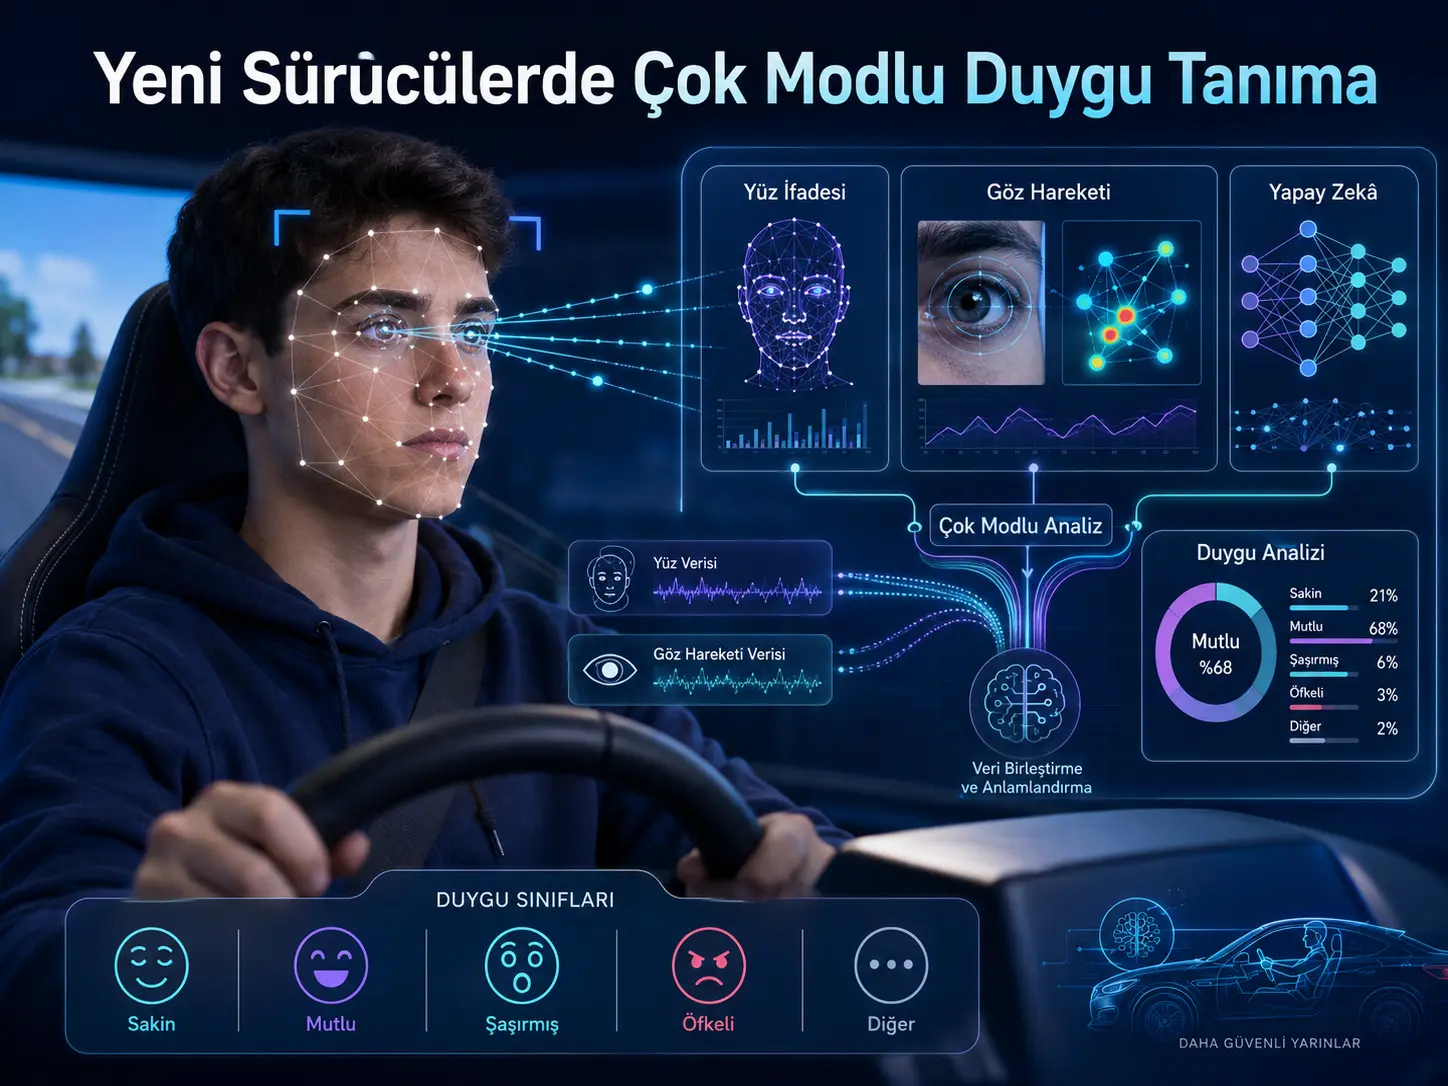
Bu araştırma, sürüş deneyimi sınırlı yeni sürücülerin duygusal durumunu yalnız yüz ifadesinden veya yalnız göz hareketinden tahmin etmek yerine iki bilgi kaynağını birlikte kullanan çok modlu bir derin öğrenme modeli geliştirmektedir. Model, yüz görüntülerini ViT-B/16 ile işlerken göz izleme zaman serilerini Bi-LSTM ve Transformer encoder birleşimiyle analiz etmekte; iki özellik grubu daha sonra Gated Weighted Fusion (GWF) adlı öğrenilebilir bir ağırlıklandırma mekanizmasıyla birleştirilerek çok katmanlı algılayıcıya aktarılmaktadır. Çıkış sınıfları sakin, mutlu, şaşırmış, öfkeli ve diğer olmak üzere beş kategoridir.
Çalışmada önce 387 kişinin katıldığı bir anketle 17 farklı sürüş veya çevresel sesin hangi duygularla ilişkili olduğu araştırılmıştır. Ardından 18–25 yaş aralığındaki yeni sürücülerle laboratuvar ortamında statik sürüş görüntüleri ve dinamik sürüş videoları kullanılmış; yüz görüntüleri ve 100 Hz göz izleme verileri eş zamanlı toplanmıştır. Başlangıçta 34 katılımcı alınmış, deney verimliliği %90'ın altında kalan katılımcılar dışlandıktan sonra etkili örneklem 32 kişi olarak bildirilmiştir.
Model için 30.000 göz hareketi örneği ve 30.000 yüz ifadesi örneği kullanılmış; beş duygu sınıfının her biri için 6000 örnek bulunduğu belirtilmiştir. Veriler katılımcı bazında beş alt kümeye ayrılmış ve her turda dört küme eğitim, bir küme doğrulama için kullanılarak subject-level beş katlı çapraz doğrulama uygulanmıştır. Eğitim 30 epoch, batch size 32, başlangıç learning rate 10−3, Adam optimizer ve cross-entropy loss ile gerçekleştirilmiştir.
Kaynağın temel raporlanan sonucuna göre yalnız yüz görüntüsüyle doğruluk %71,18, yalnız göz hareketiyle %95,10 ve iki modalitenin birlikte kullanıldığı GWF tabanlı modelde %98,72'dir. Basit feature concatenation yaklaşımı %95,45 accuracy verirken GWF kullanımı %98,72 olarak raporlanmıştır. Bununla birlikte çalışmanın multimodal confusion matrix'i ile %98,72 sonucu arasında önemli bir sayısal uyumsuzluk bulunmaktadır ve bu nedenle ana başarı değeri kaynak tarafından raporlanan sonuç olarak okunmalıdır; bağımsız biçimde yeniden üretilmiş doğruluk değildir.
Model yalnız araştırmacıların kendi yeni-sürücü veri setinde değil, AFFEC, SEED-IV ve AffectNet adlı üç genel duygu veri setinde de değerlendirilmiştir. Önerilen yapı bu veri setlerinde sırasıyla %91,95, %90,44 ve %89,67 accuracy raporlamıştır. Ancak çalışmanın kendisi de bu üç veri setinin yeni sürücülere veya gerçek sürüşe özgü olmadığını açıkça belirtmektedir. Bu testler modelin genel feature extraction ve fusion kabiliyetine ilişkin destek sağlar; gerçek trafikte yeni sürücünün duygusunu aynı doğrulukla tanıdığını göstermez.
Türkiye açısından yorum: Araştırma Türkiye'de gerçekleştirilmemiştir ve Türkiye'deki sürücü adaylarından veri toplamamıştır. Yaş, kültürel arka plan, sürüş eğitimi, trafik alışkanlıkları, yüz ifadesi davranışı ve kullanılan duygusal uyaranların etkisi toplumlar arasında değişebileceğinden, bildirilen doğruluk oranları Türkiye'deki sürücü adaylarına doğrudan aktarılamaz. Türkiye'de uygulanacak bir sistemin yerel katılımcılarla, gerçek araç koşullarında, farklı aydınlatma ve yol ortamlarında ve araç içi donanım üzerinde ayrıca doğrulanması gerekir.
Araştırmanın temel problemi nedir?
Çalışma, sürüş sırasında duygusal durumun izlenmesinde iki temel sınırlamayı hedeflemektedir. Birincisi, önceki araştırmaların önemli bölümünün deneyimli veya genel sürücü gruplarına odaklanmasıdır. Araştırmacılar sürüş deneyimi az olan kişilerin bilişsel yük ve beklenmedik olaylar karşısında farklı duygusal tepkiler verebileceğini savunmaktadır.
İkinci problem ise tek bir veri modalitesinin duyguyu eksiksiz temsil etmekte zorlanabilmesidir. Yüz ifadeleri dışarıdan doğrudan gözlenebilir ancak düşük yoğunluklu duygularda belirgin olmayabilir veya kişinin bilinçli davranışından etkilenebilir. Göz hareketleri ise dikkat dağılımı, pupil davranışı, gaze ve zaman içindeki değişimleri yansıtabilir; fakat tek başına farklı duygular arasında yeterince ayrıştırıcı olmayabilir.
Çalışmanın çözümü, yüz görüntülerinin mekânsal özelliklerini göz hareketlerinin zamansal özellikleriyle birleştirmektir.
Model hangi dört ana bölümden oluşuyor?
Yeni sürücüde çok modlu duygu tanıma zinciri
| Aşama | Girdi / işlem | Temel model | Kaynak |
|---|---|---|---|
| 1. Yüz görüntüsü | 224 × 224 × 3 yüz görüntüsü, patch'lere ayrılarak global görsel özellik çıkarılır. | ViT-B/16 | Bölüm 3.2 / Şekil 1 |
| 2. Göz hareketi | 500 × 17 boyutlu zaman serisinde ileri ve geri zamansal bağımlılıklar işlenir. | Bi-LSTM | Bölüm 3.3 / Şekil 1 |
| 3. Uzun menzilli ilişki | Göz hareketi dizisinin daha uzak zaman noktaları arasındaki ilişkiler modellenir. | Transformer encoder | Bölüm 3.3 |
| 4. Adaptif füzyon | Yüz ve göz hareketi özelliklerinin katkısı öğrenilebilir gating ile ağırlıklandırılır. | GWF | Bölüm 3.4 |
| 5. Sınıflandırma | Birleşik özellikten beş duygu sınıfının olasılıkları üretilir. | MLP + Softmax | Bölüm 3.5 |
Çalışmanın Şekil 1 ve yöntem bölümüne dayanarak hazırlanmış açıklayıcı süreç gösterimidir. Kaynakta bulunmayan yeni bir model aşaması eklenmemiştir.
ViT-B/16 yüz görüntüsünü nasıl işliyor?
Modelin yüz koluna 224 × 224 piksel boyutundaki görüntüler verilmektedir. ViT-B/16 görüntüyü 16 × 16 piksel büyüklüğünde patch'lere ayırır. Patch sayısı:
\[ N= \frac{H}{P} \times \frac{W}{P} \]
ile hesaplanmaktadır. Çalışmada \(P=16\)'dır. 224 × 224 görüntü için bu yapı görüntünün küçük parçalara ayrılıp Transformer'a bir token dizisi olarak sunulmasını sağlar.
Her patch doğrusal dönüşümle 768 boyutlu feature space'e aktarılır:
\[ z_i=W_{\mathrm{patch}}p_i+b_{\mathrm{patch}} \]
Patch'lerin görüntüdeki konumlarının kaybolmaması için position embedding eklenir:
\[ z'_i=z_i+E_{\mathrm{pos},i} \]
Ayrıca sınıflandırma için özel bir classification token dizinin başına eklenmektedir.
ViT'in self-attention çekirdeği:
\[ Attention(Q,K,V) = softmax\left( \frac{QK^T}{\sqrt{d_k}} \right)V \]
biçiminde tanımlanmıştır. Böylece model yalnız komşu piksel bölgelerini değil, yüzün birbirinden uzaktaki bölgeleri arasındaki ilişkileri de temsil etmeyi amaçlamaktadır.
Yöntem metni son classification token çıktısını 768 boyutlu \(f_{\mathrm{image}}\) vektörü olarak tanımlamaktadır.
Göz hareketi kolunda neden Bi-LSTM ve Transformer birlikte?
Göz hareketi girdisi kaynak Şekil 1'de 500 × 17 boyutunda gösterilmektedir. Göz izleyici 100 Hz örnekleme hızına sahiptir ve veri 5 saniyelik pencerelere ayrılmıştır. Bu nedenle 5 saniyelik bir pencerenin yaklaşık 500 zaman noktası içermesi model giriş boyutuyla tutarlıdır.
Bi-LSTM'nin görevi diziyi hem ileri hem geri yönde işleyerek zaman içindeki yerel ve geçmiş/gelecek bağlamını temsil etmektir. Her yön için 128 hidden unit kullanılmakta ve iki yön birleştirildiğinde 256 boyutlu çıktı elde edilmektedir.
Ardından Transformer encoder, dizide birbirinden daha uzak zaman noktaları arasındaki bağımlılıkları self-attention ile modellemektedir. Kaynakta Transformer katmanı için:
- 8 attention head,
- 256 model dimension,
- 512 feed-forward dimension,
- 0,1 dropout,
- 2 Transformer encoder katmanı
belirtilmiştir.
Gated Weighted Fusion ne yapıyor?
Kaynakta GWF'nin amacı iki modaliteyi yalnız yan yana eklemek yerine, hangi özelliğin mevcut örnekte daha yararlı olduğunu öğrenilebilir biçimde belirlemektir.
İki özellik:
\[ f_1,f_2\in R^{C\times1} \]
olarak tanımlanır ve önce:
\[ f_{\mathrm{cat}}=[f_1;f_2] \]
şeklinde birleştirilir. Daha sonra gating weight:
\[ g= \sigma(W_gf_{\mathrm{cat}}+b_g) \]
ile hesaplanır. \(g\) değerleri 0 ile 1 arasındadır.
Kaynağın son fusion denklemi:
\[ f_{\mathrm{fused}} = g\odot f_1 + (1-g)\odot f_2 \]
şeklindedir. Bu yapı bir modalitenin bazı feature kanallarını güçlendirirken diğerini baskılayabilecek öğrenilebilir bir ağırlıklandırma mekanizmasıdır.
Mimari boyut notu: Burada kaynak içinde açıklanmamış bir boyut farkı vardır. ViT bölümü yüz özelliğini 768 boyutlu tanımlarken Şekil 1 GWF'ye giren yüz kolunu 256×1 göstermektedir. Ayrıca yukarıdaki weighted-sum formülü \(C\)-boyutlu çıktı üretirken Şekil 1 GWF çıkışını 512×1 olarak etiketlemektedir. Kaynak bu dönüşümlerin ara katmanlarını açıklamamaktadır.
Sınıflandırıcı ne üretiyor?
Füzyondan çıkan özellik MLP tabanlı classifier'a aktarılmaktadır. Son katmanda Softmax kullanılarak beş kategori için olasılık oluşturulur:
\[ \hat{y}_k= \frac{\exp(z_k^{(L)})} {\sum_{i=1}^{C}\exp(z_i^{(L)})} \]
Sınıf eşlemesi kaynak Şekil 1'de:
| Sınıf | Duygu |
|---|---|
| 0 | Sakin |
| 1 | Mutlu |
| 2 | Şaşırmış |
| 3 | Öfkeli |
| 4 | Diğer |
Duygu uyaranları nasıl seçildi?
Araştırmacılar doğrudan laboratuvar deneyine geçmek yerine önce hangi sürüş ve çevresel seslerin yeni sürücülerde hangi duygularla ilişkilendirildiğini araştırmıştır. Ankete toplam 387 kişi katılmıştır; bunların 197'si erkek ve 190'ı kadındır.
Ankette 17 ses kullanılmıştır. Bunlar arasında telefon zil sesi, yağmur, ambulans sireni, araç çarpışması, kavga, korku ortamı, rahatlatıcı müzik, yüksek sesli müzik, köpek havlaması, araç hızlanması, fren sesi, korna ve gürültü gibi örnekler bulunmaktadır.
Ses ile duygu kategorisi arasındaki ilişki için chi-square testi uygulanmıştır:
\[ \chi^2= \sum_{i,j} \frac{(O_{ij}-E_{ij})^2}{E_{ij}} \]
Kaynakta:
\(\chi^2=1310,791\), p<0,001
sonucu bildirilmiştir. Araştırmacılar ses türleri ile duygu dağılımlarının anlamlı biçimde ilişkili olduğunu değerlendirmiştir.
Correspondence analysis'te iki boyutun kümülatif açıklama oranının %80'i geçtiği belirtilmektedir. Çalışmanın yorumuna göre sürekli korna, kavga ve köpek havlaması anger bölgesine; ani çarpışma benzeri sesler ise surprise bölgesine daha yakın kümelenmiştir.
Bu anket sonuçları daha sonraki sürüş simülasyonu için “sahne + ses” stimulus kombinasyonlarının seçilmesinde kullanılmıştır. Anket sonucu gerçek sürüşte nesnel duygu değişiminin doğrudan kanıtı değildir; deneysel uyaran seçiminin ön aşamasıdır.
Statik ve dinamik sürüş deneyleri nasıl düzenlendi?
Statik bölümde 60 kentsel sürüş fotoğrafı kullanılmıştır. Görselden önce sürüş senaryosuna ilişkin prompt 3 saniye, ardından görüntü 10 saniye gösterilmiştir. Manevralar arasında dönüş, şerit değiştirme, yayadan kaçınma, trafik tıkanıklığı ve sollamak için hızlanma bulunmaktadır.
Her grup 12 fotoğraftan oluşmuş ve toplam beş grup hazırlanmıştır. Kaynak her grubun yaklaşık 2 dakika 35 saniye sürdüğünü, ancak toplam statik deneyin yaklaşık 30 dakika olduğunu yazmaktadır.
Süre tutarsızlığı: Beş adet 2 dakika 35 saniyelik grup yaklaşık 12 dakika 55 saniyedir. 12 × (3+10 saniye) hesabı da grup başına yaklaşık 2 dakika 36 saniye verir. Kaynakta 30 dakikalık toplam süreyi açıklayan ilave bekleme veya mola süresi belirtilmemiştir.
Dinamik bölümde 60 kentsel sürüş videosu kullanılmıştır. Videolar başlangıç sürüş eğitimi videolarından alınmıştır ve doğrusal sürüş, dönel kavşak ile kavşakta bekleme gibi davranışları içermektedir.
Her video iki dakika sürmüş; 10 video bir grup, toplam altı grup oluşturmuştur. Gruplar arasında beş dakika mola verilmiş ve her grup öncesinde dokuz noktalı eye-tracker kalibrasyonu yapılmıştır. Toplam dinamik deney süresi yaklaşık 2 saat 30 dakika olarak belirtilmiştir.
Deney düzeneğinde hangi cihazlar var?
Laboratuvar düzeninde simüle direksiyon, debriyaj, fren, sinyal kontrolü, göz izleyici, human-factor ekipmanı, dizüstü bilgisayar, kamera ve kulaklık bulunmaktadır.
Göz hareketi için aSee Pro F100 kullanılmış ve örnekleme hızı 100 Hz olarak belirtilmiştir. aSee Studio yazılımı katılımcı bilgileri, pupil verisi, gaze noktaları, saccade ve blink gibi parametrelerin toplanmasında kullanılmıştır.
Kaynak Şekil 5'te deney ortamını doğrudan göstermektedir: sürüş simülasyon görüntüsü monitörde gösterilirken kamera ve aSee Pro göz izleme sistemi katılımcının karşısında, direksiyon simülatörü ise masa önünde konumlandırılmıştır. Bu düzen gerçek araç kabini değil laboratuvar tabanlı sürüş simülasyonudur.
Katılımcılar kimlerdi?
Deneye yaşları 18–25 arasında değişen 34 kişi alınmış ve ortalama yaş 22 olarak bildirilmiştir. Katılımcılar ehliyet alma aşamasında veya bir yıldan az sürüş deneyimine sahip kişilerden seçilmiştir.
Deney verimliliği %90'ın altında kalan katılımcılar çıkarılmış ve sonuçta 32 kişilik etkili örneklem kalmıştır.
Çalışmada katılımcıların göz izleme ölçümünü etkileyebilecek koşullar için de kriterler tanımlanmıştır. Kaynak kontakt lens kullanılmamasını ve gözlük kullananlarda reçetenin “500 diopters” değerini aşmamasını yazmaktadır. Bu sayı kaynakta bulunduğu biçimiyle aktarılmakta; muhtemel birim veya çeviri problemi sessizce düzeltilmemektedir.
Katılımcılar bilgilendirilmiş onam vermiş ve çalışma Baoji University of Arts and Sciences etik kurulu tarafından onaylanmıştır.
Göz hareketi verileri nasıl hazırlanmış?
Kaynak, her katılımcının başlangıç eye-movement veri setinde 79.070 zaman noktası bulunduğunu belirtmektedir. Veriler 5 saniyelik zaman pencerelerine ayrılmıştır.
100 Hz örnekleme nedeniyle bir 5 saniyelik pencere yaklaşık 500 zaman noktasına karşılık gelir; model girişinin 500×17 olarak tanımlanması bu yapı ile uyumludur.
Kaynak metinde bu slicing işleminin “79.070 rows'tan yaklaşık 500 rows'a” indirdiği biçiminde bir ifade de bulunmaktadır. Bunun her 5 saniyelik pencerenin yaklaşık 500 satır içermesi anlamına geldiği model girişinden anlaşılabilse de metin toplam veri miktarı açısından açık değildir.
Yüz görüntüleri nasıl hazırlandı?
Yüz videoları ErgoLAB facial-expression analysis yazılımına verilmiş, facial feature noktaları ve karşılık gelen emotion label'ları elde edilmiştir. Ardından videolar frame-by-frame görüntü dizilerine dönüştürülmüştür.
Görüntüler 1920×1080 çözünürlükten 224×224 piksele yeniden boyutlandırılmış ve piksel değerleri [0,1] aralığına normalize edilmiştir.
Kaynak, yazılımın ürettiği emotion label'ların ardından manuel classification yapıldığını belirtmektedir. Ancak eye-movement pencereleri ile facial frame'lerin nihai ortak ground-truth etiketinin senkronizasyon ayrıntıları yöntem bölümünde sınırlı açıklanmıştır.
Model hangi veriyle eğitildi?
| Veri türü | Örnek sayısı |
|---|---|
| Göz hareketi örnekleri | 30.000 |
| Yüz ifadesi örnekleri | 30.000 |
| Her duygu kategorisi | 6000 |
Örnekler subject bazında beş alt kümeye ayrılmıştır. Her turda dört alt küme eğitim, kalan alt küme validation için kullanılmış ve bütün alt kümeler bir kez validation olduğunda süreç tamamlanmıştır.
Eğitim parametreleri
| Parametre | Değer |
|---|---|
| Epoch | 30 |
| Batch size | 32 |
| Initial learning rate | 10−3 |
| Optimizer | Adam |
| Loss | Cross-entropy |
| Validation | Subject-level 5-fold cross-validation |
Yalnız yüz, yalnız göz ve multimodal sonuçlar nasıl değişiyor?
| Modalite | Kaynakta raporlanan accuracy |
|---|---|
| Yüz görüntüsü | %71,18 |
| Göz hareketi | %95,10 |
| Multimodal | %98,72 |
Sonuçların kaynağın kendi yorumuna göre en önemli mesajı, göz hareketi verisinin yüz ifadesine kıyasla bu deney grubunda çok daha ayrıştırıcı olması ve iki modalitenin birleştirilmesinin daha yüksek raporlanan doğruluk sağlamasıdır.
Bu sonuç, yüz ifadesinin genel olarak duygu tanıma için zayıf olduğu anlamına gelmez. Sonuç yalnız bu veri seti, bu katılımcı grubu, bu uyaranlar ve bu model düzeni için geçerlidir.
GWF basit concatenation'dan daha iyi mi?
| Fusion yöntemi | Accuracy (%) |
|---|---|
| Feature Concatenation | 95,45 |
| GWF Fusion | 98,72 |
İki değer arasındaki mutlak fark 3,27 yüzde puanıdır. Kaynak bu sonucu “accuracy'de %3,27 improvement” şeklinde ifade etmektedir.
Karışıklık matrisleri neden önemli?
Yalnız facial-image modelinin Şekil 10 confusion matrix'inde ana köşegen toplamı 3257, toplam örnek sayısı 4576'dır:
\[ Accuracy= \frac{3257}{4576} = 0,71176 \approx71,18\% \]
Bu değer Şekil 8'de bildirilen facial-image accuracy ile tam olarak uyuşmaktadır.
Facial modelde Class 0 yani calm kategorisinin özellikle Class 4 “other” ve Class 3 “angry” ile karıştırıldığı görülmektedir. Kaynak bunu sakin duygudaki yüz değişimlerinin daha ince olmasıyla yorumlamaktadır.
Ancak multimodal Şekil 11 yeniden hesaplandığında:
| Ölçüm | Değer |
|---|---|
| Toplam confusion-matrix örneği | 4576 |
| Ana köşegen / doğru sınıflandırma | 4304 |
| Matristen yeniden hesaplanan accuracy | ≈ %94,06 |
| Şekil 8 ve Tablo 3'te raporlanan multimodal accuracy | %98,72 |
Bilimsel raporlama uyarısı: Kaynak Şekil 11'in farklı bir fold, alt küme veya deney parçasına ait olduğunu belirtmemektedir. Buna rağmen confusion matrix'ten yeniden elde edilen %94,06 ile ana tabloda verilen %98,72 uyuşmamaktadır. Verianla bu iki sonuçtan hangisinin doğru olduğunu seçmez; tutarsızlığı açık biçimde korur.
Eye-movement modelindeki Bi-LSTM ve Transformer katkısı nedir?
Yalnız göz hareketi verisiyle yapılan ablasyonda:
| Model | Accuracy (%) |
|---|---|
| Bi-LSTM | 87,50 |
| Transformer | 94,23 |
| Bi-LSTM + Transformer | 95,10 |
Multimodal deneyde ise eye branch bileşenlerinin etkisi:
| Eye branch | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Kaynak bu sonuçları Bi-LSTM'nin zaman içindeki yönlü bağımlılıkları, Transformer'ın ise daha uzun menzilli ilişkileri temsil etmesinin birbirini tamamladığı şeklinde yorumlamaktadır.
Üç genel veri setindeki sonuçlar ne gösteriyor?
Araştırmacılar modelin yalnız kendi deney verisindeki başarısına bağlı kalmamak için AFFEC, SEED-IV ve AffectNet üzerinde ek karşılaştırmalar yapmıştır.
| Veri seti | Modalite | Önerilen model Accuracy | Macro-F1 |
|---|---|---|---|
| AFFEC | Göz + yüz | 91,95 ± 0,87% | 91,36 ± 0,92% |
| SEED-IV | Yalnız göz hareketi | 90,44 ± 0,75% | 89,81 ± 0,80% |
| AffectNet | Yalnız yüz | 89,67 ± 0,69% | 89,02 ± 0,73% |
Kaynak, önerilen modelin her üç veri setindeki baseline'lara göre p<0,05 düzeyinde istatistiksel olarak anlamlı üstünlük gösterdiğini bildirmektedir.
Ancak bu bölümün yorum sınırı özellikle önemlidir: AFFEC, SEED-IV ve AffectNet yeni sürücüler için oluşturulmuş sürüş veri setleri değildir. Çalışma da bunu açıkça vurgulamaktadır. Bu sonuçlar model mimarisinin genel duygu tanıma yeteneğini destekler; gerçek sürüş koşullarındaki performansını doğrulamaz.
Diğer duygu tanıma yöntemleriyle nasıl karşılaştırılmış?
| Sinyaller | Yöntem | Kaynakta verilen accuracy |
|---|---|---|
| Göz + ses + görüntü | FE-CNN | 81,90% |
| Göz + PPG | FECNN + LSTM | 84,68% |
| Yüz + rPPG + göz | Dual-path Transformer | 86,98% |
| EEG + göz | MFFNN | 87,32% |
| EEG | LSTM | 90,72% |
| EEG + ECG + göz | 1D-Inception + Self-Attention + LSTM | 91,38% |
| EEG | CNN-LSTM | 93,97% |
| EEG + yüz + fizyolojik sinyaller | GNN | 91,25% |
| Göz + yüz | Bu çalışma | 98,72% |
Bu tablo farklı araştırmaların farklı veri setleri, sınıf sayıları, örneklemleri ve deney protokollerini içerdiğinden doğrudan bir yarışma tablosu olarak okunmamalıdır. Kaynak bu değerleri literatür karşılaştırması olarak sunmaktadır; aynı benchmark üzerinde kontrollü head-to-head deney değildir.
Model gerçek zamanlı mı?
Kaynak multimodal model için batch başına ortalama processing time değerini:
29,42 ± 0,08 ms
olarak vermektedir.
Hybrid inference modunda örnek başına:
0,9230 ± 0,0014 ms
raporlanmıştır.
Araştırmacılar bu değeri araç içi insan–makine etkileşimi için kullandıkları 100–200 ms referans gecikmenin altında olduğu gerekçesiyle gerçek zamanlılık açısından yeterli olarak yorumlamaktadır.
Ancak bu süre gerçek araç üzerinde, üretim tipi embedded ECU'da veya araç içi kamera/eye-tracker pipeline'ının tamamı üzerinde ölçülen uçtan uca latency değildir. Çalışma, gerçek sürüş ortamında deployment yapılmadığını açıkça belirtmektedir.
Çalışmanın desteklediği sonuçlar
- Yüz görüntüsü ve eye-tracking verisini birlikte kullanan hibrit bir duygu tanıma mimarisi uygulanmıştır.
- ViT-B/16, Bi-LSTM, Transformer encoder, GWF ve MLP tek bir multimodal pipeline içinde kullanılmıştır.
- Kaynağın ana tablolarında multimodal model için %98,72 accuracy raporlanmıştır.
- Kaynak modalite ablasyonunda eye-movement verisinin facial-image verisinden daha yüksek accuracy ürettiğini göstermektedir.
- GWF, kaynakta basit feature concatenation'dan daha yüksek accuracy ile raporlanmıştır.
- Bi-LSTM + Transformer eye branch'i, yalnız Bi-LSTM veya yalnız Transformer kullanılan ablasyonlardan daha yüksek performans göstermiştir.
- Model AFFEC, SEED-IV ve AffectNet genel duygu veri setlerinde karşılaştırılan baseline'ların üzerinde raporlanmıştır.
- Model inference süresi laboratuvar hesaplama ortamında milisaniye düzeyinde ölçülmüştür.
Çalışmanın desteklemediği, test etmediği veya kanıtlamadığı sonuçlar
- Model gerçek trafikte veya gerçek araç sürüşünde test edilmemiştir.
- %98,72 accuracy'nin Türkiye'deki veya farklı yaş grubundaki yeni sürücülere aktarılabileceği gösterilmemiştir.
- Duygu tanımanın trafik kazalarını fiilen azalttığı bu çalışmada deneysel olarak ölçülmemiştir.
- Model araç içi kamera, güneş ışığı, gece sürüşü, yüz örtülmesi, yoğun baş hareketi ve gerçek yol titreşimi altında doğrulanmamıştır.
- Gerçek embedded araç platformunda güç tüketimi, RAM, model boyutu ve uçtan uca latency ölçümü sunulmamıştır.
- Üç haricî veri setindeki başarı yeni sürücüye özgü gerçek sürüş doğrulaması değildir.
- Çalışmanın confusion matrix'i ana raporlanan %98,72 doğruluk değerini bağımsız olarak doğrulamamaktadır.
- Modelin duygu sınıfları kişinin gerçek psikolojik durumunun klinik veya kesin ölçümü olarak yorumlanamaz.
Çalışmanın Yöntemi ve Bulguları
Araştırma tasarımının temel bileşenleri
| Bileşen | Kaynakta verilen bilgi |
|---|---|
| Anket örneklemi | 387 kişi |
| Anket erkek/kadın | 197 / 190 |
| Ses uyaranı | 17 tür |
| Başlangıç deney katılımcısı | 34 |
| Etkili katılımcı | 32 |
| Yaş | 18–25; ortalama 22 |
| Sürüş deneyimi | Ehliyet adayı veya <1 yıl deneyim |
| Eye tracker | aSee Pro F100 |
| Eye-tracking sampling rate | 100 Hz |
| Eye window | 5 s / yaklaşık 500 zaman noktası |
| Eye model girdisi | 500 × 17 |
| Facial-image girdisi | 224 × 224 × 3 |
| Duygu sınıfı | 5 |
Model mimarisinin temel parametreleri
| Modül | Temel yapı |
|---|---|
| Yüz feature extraction | ViT-B/16; 16×16 patch; 768-boyut classification token |
| Bi-LSTM | 128 hidden unit/yön; birleşik 256-boyut çıktı |
| Transformer encoder | 8 head, d-model 256, FFN 512, dropout 0,1, 2 katman |
| Fusion | Gated Weighted Fusion |
| Classifier | MLP + Softmax |
Ana multimodal deney sonucu
| Eye feature modeli | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Karışıklık matrisi kalite kontrolü
| Kaynak sonucu | Raporlanan / yeniden hesaplanan | Durum |
|---|---|---|
| Facial-image accuracy | Şekil 8: %71,18 / Şekil 10 matrisinden: %71,18 | Uyumlu |
| Multimodal accuracy | Şekil 8 ve Tablo 3: %98,72 / Şekil 11 matrisinden: ≈%94,06 | Uyumsuz |
Bu kontrol Verianla tarafından kaynak Şekil 10 ve Şekil 11 hücreleri üzerinden yeniden hesaplanmıştır. Kaynağın yerine yeni deney sonucu üretmez; yalnız yayımlanmış hücrelerin aritmetik tutarlılığını kontrol eder.
Genel veri setlerinde sonuçlar
| Dataset | Önerilen model Accuracy ± Std | Macro-F1 ± Std | Kaynak istatistiksel notu |
|---|---|---|---|
| AFFEC | 91,95 ± 0,87% | 91,36 ± 0,92% | p<0,05 vs. tüm baseline'lar |
| SEED-IV | 90,44 ± 0,75% | 89,81 ± 0,80% | p<0,05 vs. tüm baseline'lar |
| AffectNet | 89,67 ± 0,69% | 89,02 ± 0,73% | p<0,05 vs. tüm baseline'lar |
Gerçek zamanlılık sonucu
| Ölçüm | Değer |
|---|---|
| Batch başına processing time | 29,42 ± 0,08 ms |
| Hybrid inference mode, örnek başına | 0,9230 ± 0,0014 ms |
Bu performans değerleri model hesaplamasına aittir. Gerçek araç üzerindeki kamera acquisition, eye-tracking acquisition, preprocessing, işletim sistemi gecikmesi, sensör senkronizasyonu ve uyarı üretiminin tamamını kapsayan gerçek uçtan uca araç içi gecikme ölçümü değildir.
Araştırmanın temel sınırlılıkları
- Etkili sürücü örneklemi yalnız 32 kişidir.
- Katılımcılar yalnız 18–25 yaş grubundadır.
- Kültürel çeşitlilik sınırlıdır.
- Duygular laboratuvarda görsel ve işitsel stimulus ile oluşturulmuştur.
- Beklenmedik gerçek yol olayları test edilmemiştir.
- Gerçek araç sürüşü kullanılmamıştır.
- Doğal araç içi ışık değişimi, head movement ve facial occlusion kapsamlı biçimde doğrulanmamıştır.
- Gerçek embedded deployment yapılmamıştır.
- Multimodal confusion matrix ile ana accuracy sonucu arasında açıklanmamış sayısal uyuşmazlık vardır.
- GWF'nin feature boyutları yöntem denklemleri ile mimari çizim arasında tam olarak açıklanmamıştır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Hybrid Deep Neural Network-Based Modeling of Multimodal Emotion Recognition for Novice Drivers
Yazarlar ve sıraları: Jianzhuo Li; Ye Yu; Zhao Dai; Panyu Dai.
Sorumlu yazar: Jianzhuo Li.
Eş birinci/eş katkı: Kaynakta belirtilmemiştir.
Kurum: School of Computer Science, Baoji University of Arts and Sciences, Baoji 721016, China.
Dergi: Future Internet
Yayınevi: MDPI, Basel, Switzerland
Cilt / sayı / makale: 18 / 4 / 221
Alınma tarihi: 27 Şubat 2026
Revizyon tarihi: 17 Nisan 2026
Kabul tarihi: 18 Nisan 2026
Yayın tarihi: 21 Nisan 2026
DOI: 10.3390/fi18040221
Resmî yayın bağlantısı:https://doi.org/10.3390/fi18040221
Kaynak türü: Hakemli araştırma makalesi; laboratuvar tabanlı simüle sürüş deneyi, eye-tracking/facial-image veri analizi ve derin öğrenme modelleme çalışması.
Hakemlik durumu: Hakemli dergide yayımlanmış çalışmadır.
Lisans: Creative Commons Attribution (CC BY).
Sürüm: İncelenen dosya v2 olarak adlandırılmıştır. Yayıncının sürüm notu, çalışma için güncellenmiş bir version of record bulunduğunu göstermektedir. Güncellemenin kapsamı kaynakta incelenen makalenin bilimsel içeriğinin dışına çıkılarak tahmin edilmemiştir.
Etik onay: Çalışma Helsinki Bildirgesi'ne uygun olarak yürütüldüğünü bildirmekte ve Baoji University of Arts and Sciences Institutional Review Board onay numarasını BJWL-2025-ETH-048, onay tarihini 7 Ocak 2025 olarak vermektedir.
Bilgilendirilmiş onam: Kaynak, bütün katılımcıların araştırmanın amacı ve prosedürü hakkında bilgilendirildiğini ve bilimsel araştırma için veri kullanımını kabul eden informed-consent form imzaladığını bildirmektedir.
Finansman: Araştırma dış finansman almamıştır.
Veri erişilebilirliği: Kullanılan veri setlerinin makul talep üzerine sorumlu yazardan temin edilebileceği belirtilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bulunmadığını beyan etmektedir.
Yazar katkıları: Kaynak beyanına göre kavramsallaştırma Ye Yu; metodoloji Ye Yu, Zhao Dai ve Panyu Dai; yazılım Ye Yu ve Panyu Dai; doğrulama, formal analiz, araştırma ve veri kürasyonu Ye Yu; özgün taslak Ye Yu; gözden geçirme/düzenleme Jianzhuo Li; görselleştirme Ye Yu; denetim ve proje yönetimi Jianzhuo Li tarafından yürütülmüştür.
Kaynak içi sayısal tutarsızlık 1 — confusion matrix: Facial-image confusion matrix'in hücrelerinden yeniden hesaplanan accuracy %71,18 olup Şekil 8 ile eşleşmektedir. Multimodal confusion matrix'te ise 4576 örneğin 4304'ü ana köşegendedir ve yeniden hesaplanan accuracy yaklaşık %94,06'dır. Bu değer, Şekil 8 ve Tablo 3'teki %98,72 ile uyuşmamaktadır. Kaynak farklı bir değerlendirme kümesi veya fold açıklamamaktadır.
Kaynak içi mimari tutarsızlık 2 — feature boyutları: ViT yöntemi classification-token çıktısını 768 boyutlu tanımlarken Şekil 1 yüz kolunun GWF girişini 256×1 göstermektedir. GWF Eşitlik (19) C-boyutlu iki girdiden C-boyutlu weighted-sum üretirken Şekil 1 çıkışı 512×1 olarak göstermektedir. Ara dönüşüm açık biçimde tanımlanmamıştır.
Kaynak içi süre tutarsızlığı 3: Statik sürüş deneyinin beş grubunun her biri yaklaşık 2 dakika 35 saniye olarak tanımlanmıştır; bu yaklaşık 12 dakika 55 saniyedir. 12 görüntü × 13 saniyelik stimulus yapısı da yaklaşık aynı süreyi verir. Kaynak buna rağmen toplam statik deney süresini yaklaşık 30 dakika olarak bildirmektedir ve farkın nedeni açıklanmamaktadır.
Kaynak içi birim notu 4: Katılımcı seçim kriterinde gözlük reçetesi için kaynakta “500 diopters” ifadesi bulunmaktadır. Olası birim/çeviri hatası kaynak dışından varsayılarak düzeltilmemiştir.
GWF performans ifadesi: Kaynak feature concatenation için %95,45 ve GWF için %98,72 accuracy bildirmekte ve artışı %3,27 olarak adlandırmaktadır. İki raporlanan accuracy arasındaki mutlak fark 3,27 yüzde puanıdır.
Ground-truth/etiketleme notu: Facial expression videoları ErgoLAB yazılımıyla analiz edilip emotion label üretilmiş ve ardından manuel sınıflandırma yapılmıştır. Eye-movement örneklerinin beş kategoriyle etiketlendiği belirtilmekle birlikte iki modalitenin nihai ortak ground-truth etiketinin oluşturulma ve senkronizasyon prosedürü kaynakta ayrıntılı olarak açıklanmamıştır.
Genellenebilirlik sınırı: AFFEC, SEED-IV ve AffectNet üzerindeki doğrulamalar genel duygu tanıma görevleridir. Kaynak özellikle bu veri setlerinin novice-driver veya driving-specific olmadığını belirtmektedir. Dolayısıyla bu sonuçlar gerçek sürüş koşullarına doğrudan validasyon olarak kullanılmamıştır.
Gerçek zamanlılık sınırı: 29,42 ms/batch ve 0,9230 ms/sample değerleri model processing ölçümleridir. Araştırmada gerçek araç içi embedded system deployment veya gerçek sürüş koşullarındaki end-to-end latency ölçümü gerçekleştirilmemiştir.
Bu Verianla açıklamasındaki yöntem, veri setleri, denklemler, sınıflandırma sonuçları, tablolar, şekil yorumları ve sınırlılıklar incelenen bilimsel çalışmaya dayanmaktadır. Bibliyografik dış doğrulama yalnız DOI, dergi, yayınevi, hakemlik ve yayın sürümü gibi kaynak kimliği unsurlarının teyidi için kullanılmış; dış kaynaklardan yeni duygu tanıma sonucu veya yeni performans değeri eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir