

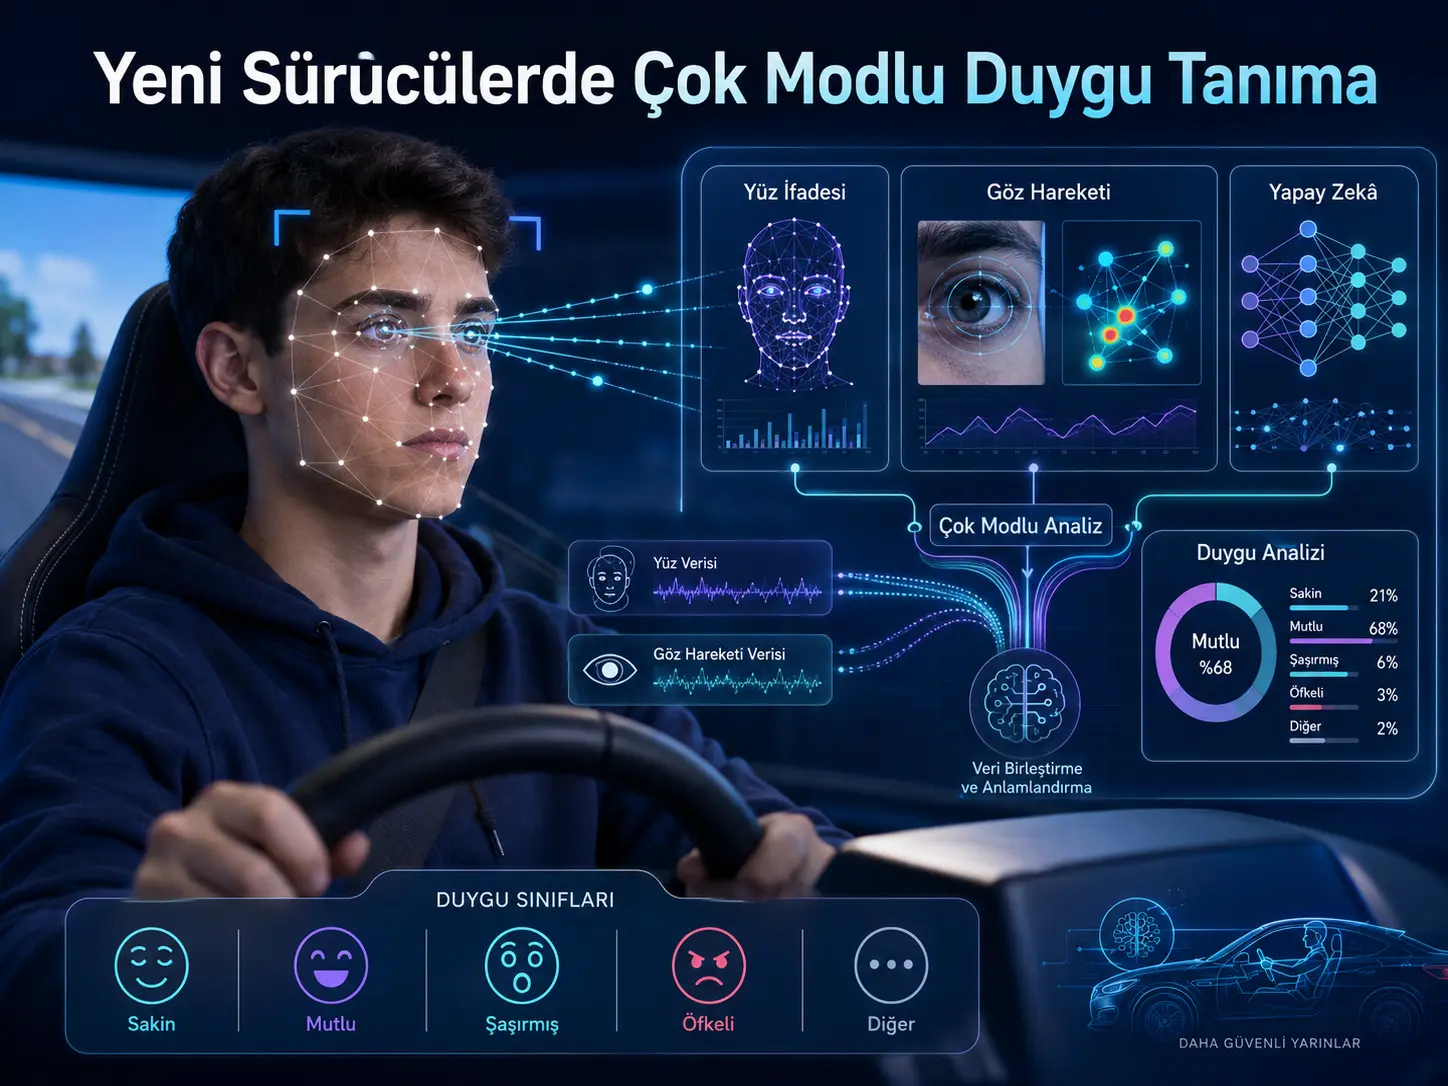
Бул изилдөө айдоо тажрыйбасы чектелүү жаңы айдоочулардын эмоциялык абалын жүздүн мимикасынан гана же көз кыймылынан гана божомолдоонун ордуна эки маалымат булагын бирге колдонгон көп модалдуу терең үйрөнүү моделин иштеп чыгат. Модель жүз сүрөттөрүн ViT-B/16 менен иштетип, көздү байкоо убакыт катарларын Bi-LSTM жана Transformer encoder айкалышы менен талдайт; андан кийин эки өзгөчөлүк тобу Gated Weighted Fusion (GWF) деп аталган үйрөнүлүүчү салмактоо механизми аркылуу бириктирилип, көп катмарлуу перцептронго берилет. Чыгыш класстары тынч, бактылуу, таң калган, ачууланган жана башка болуп беш категориядан турат.
Изилдөөдө алгач 387 адам катышкан сурамжылоо аркылуу 17 ар башка айдоо же айлана-чөйрө үнүнүн кайсы эмоциялар менен байланыштуу экени изилденген. Андан соң 18–25 жаштагы жаңы айдоочулар менен лаборатория шартында статикалык айдоо сүрөттөрү жана динамикалык айдоо видеолору колдонулуп, жүз сүрөттөрү менен 100 Hz көздү байкоо маалыматтары бир убакта чогултулган. Башында 34 катышуучу алынган, эксперименттик натыйжалуулугу %90'дан төмөн болгон катышуучулар чыгарылгандан кийин натыйжалуу тандалма 32 адам деп билдирилген.
Модель үчүн 30.000 көз кыймылы үлгүсү жана 30.000 жүз мимикасы үлгүсү колдонулган; беш эмоция классынын ар бири үчүн 6000 үлгү бар экени айтылган. Маалыматтар катышуучу деңгээлинде беш кичи топко бөлүнүп, ар бир айлампада төрт топ окутууга, бир топ текшерүүгө колдонулуп subject-level беш катмарлуу кайчылаш текшерүү жүргүзүлгөн. Окутуу 30 epoch, batch size 32, баштапкы learning rate 10−3, Adam optimizer жана cross-entropy loss менен жүргүзүлгөн.
Булактын негизги билдирилген жыйынтыгына ылайык, жүз сүрөтү гана менен тактык %71,18, көз кыймылы гана менен %95,10 жана эки модалдуулук бирге колдонулган GWF негизиндеги моделде %98,72. Жөнөкөй feature concatenation ыкмасы %95,45 accuracy берсе, GWF колдонуу %98,72 деп билдирилген. Бирок изилдөөнүн multimodal confusion matrix'и менен %98,72 жыйынтыгынын ортосунда маанилүү сандык шайкешсиздик бар, ошондуктан негизги ийгилик көрсөткүчү булак билдирген натыйжа катары окулушу керек; бул өз алдынча кайра чыгарылган тактык эмес.
Модель изилдөөчүлөрдүн өз жаңы-айдоочу маалымат топтомунда гана эмес, AFFEC, SEED-IV жана AffectNet деп аталган үч жалпы эмоция маалымат топтомунда да бааланган. Сунушталган түзүлүш бул маалымат топтомдорунда тиешелүүлүгүнө жараша %91,95, %90,44 жана %89,67 accuracy билдирген. Бирок изилдөөнүн өзү да бул үч маалымат топтому жаңы айдоочуларга же реалдуу айдоого арналбаганын ачык белгилейт. Бул тесттер моделдин жалпы feature extraction жана fusion жөндөмүн колдойт; реалдуу жол кыймылында жаңы айдоочунун эмоциясын ошол эле тактыкта тааный турганын көрсөтпөйт.
Түркия жагынан чечмелөө: Изилдөө Түркияда жүргүзүлгөн эмес жана Түркиядагы айдоочу талапкерлерден маалымат чогулткан эмес. Жаш курак, маданий фон, айдоо окутуусу, жол кыймылы адаттары, жүз мимикасынын жүрүм-туруму жана колдонулган эмоциялык стимулдардын таасири коомдор арасында айырмаланышы мүмкүн болгондуктан, билдирилген тактык көрсөткүчтөрүн Түркиядагы айдоочу талапкерлерге түз көчүрүүгө болбойт. Түркияда колдонулуучу система жергиликтүү катышуучулар менен, реалдуу унаа шартында, ар башка жарыктандыруу жана жол чөйрөлөрүндө жана унаа ичиндеги жабдууда өзүнчө текшерилиши керек.
Изилдөөнүн негизги көйгөйү эмне?
Изилдөө айдоо маалында эмоциялык абалды көзөмөлдөөнүн эки негизги чектөөсүн бутага алат. Биринчиси — мурдагы изилдөөлөрдүн олуттуу бөлүгү тажрыйбалуу же жалпы айдоочу топторуна көңүл бурган. Изилдөөчүлөр айдоо тажрыйбасы аз адамдар когнитивдик жүк жана күтүүсүз окуяларга башкача эмоциялык жооп бериши мүмкүн деп эсептешет.
Экинчи көйгөй — бир гана маалымат модалдуулугу эмоцияны толук чагылдырууда жетишсиз болушу мүмкүн. Жүз мимикасы сырттан түз байкалат, бирок интенсивдүүлүгү төмөн эмоцияларда даана көрүнбөшү мүмкүн же адамдын аң-сезимдүү жүрүм-турумунан таасир алышы мүмкүн. Көз кыймылы көңүлдүн бөлүштүрүлүшүн, pupil жүрүм-турумун, gaze жана убакыт ичиндеги өзгөрүүлөрдү чагылдырат; бирок жалгыз өзү ар башка эмоцияларды жетиштүү ажырата албашы мүмкүн.
Изилдөөнүн чечими — жүз сүрөттөрүнүн мейкиндиктик өзгөчөлүктөрүн көз кыймылынын убакыттык өзгөчөлүктөрү менен бириктирүү.
Модель кайсы төрт негизги бөлүктөн турат?
Жаңы айдоочуда көп модалдуу эмоция таануу чынжыры
| Этап | Киргизүү / иштетүү | Негизги модель | Булак |
|---|---|---|---|
| 1. Жүз сүрөтү | 224 × 224 × 3 жүз сүрөтү patch'терге бөлүнүп, глобалдык визуалдык өзгөчөлүк чыгарылат. | ViT-B/16 | Бөлүм 3.2 / Сүрөт 1 |
| 2. Көз кыймылы | 500 × 17 өлчөмүндөгү убакыт катарында алдыга жана артка убакыттык көз карандылыктар иштетилет. | Bi-LSTM | Бөлүм 3.3 / Сүрөт 1 |
| 3. Узак аралыктагы байланыш | Көз кыймылы катарындагы алысыраак убакыт чекиттеринин ортосундагы мамилелер моделделет. | Transformer encoder | Бөлүм 3.3 |
| 4. Адаптивдүү бириктирүү | Жүз жана көз кыймылы өзгөчөлүктөрүнүн салымы үйрөнүлүүчү gating менен салмакталат. | GWF | Бөлүм 3.4 |
| 5. Классификация | Бириккен өзгөчөлүктөн беш эмоция классынын ыктымалдуулуктары чыгарылат. | MLP + Softmax | Бөлүм 3.5 |
Изилдөөнүн Сүрөт 1 жана ыкма бөлүмүнө негизделип даярдалган түшүндүрмө процесс көрүнүшү. Булакта жок жаңы модель баскычы кошулган эмес.
ViT-B/16 жүз сүрөтүн кантип иштетет?
Моделдин жүз бутагына 224 × 224 пиксел өлчөмүндөгү сүрөттөр берилет. ViT-B/16 сүрөттү 16 × 16 пиксел өлчөмүндөгү patch'терге бөлөт. Patch саны:
\[ N= \frac{H}{P} \times \frac{W}{P} \]
менен эсептелет. Изилдөөдө \(P=16\). 224 × 224 сүрөт үчүн бул түзүлүш сүрөттү майда бөлүктөргө бөлүп, Transformer'га token катары берүүгө шарт түзөт.
Ар бир patch сызыктуу өзгөртүү менен 768 өлчөмдүү feature space'ке өткөрүлөт:
\[ z_i=W_{\mathrm{patch}}p_i+b_{\mathrm{patch}} \]
Patch'тердин сүрөттөгү жайгашуусу жоголбошу үчүн position embedding кошулат:
\[ z'_i=z_i+E_{\mathrm{pos},i} \]
Мындан тышкары классификация үчүн атайын classification token катардын башына кошулат.
ViTтин self-attention өзөгү:
\[ Attention(Q,K,V) = softmax\left( \frac{QK^T}{\sqrt{d_k}} \right)V \]
түрүндө аныкталган. Ушундайча модель кошуна пиксел аймактарын гана эмес, жүздүн бири-биринен алыс аймактарынын ортосундагы мамилелерди да чагылдырууну көздөйт.
Ыкма тексти акыркы classification token чыгышын 768 өлчөмдүү \(f_{\mathrm{image}}\) вектору катары аныктайт.
Эмне үчүн көз кыймылы бутагында Bi-LSTM жана Transformer бирге колдонулат?
Көз кыймылынын киргизүүсү булак Сүрөт 1’де 500 × 17 өлчөмүндө көрсөтүлгөн. Көз трекеринин үлгүлөө жыштыгы 100 Hz жана маалымат 5 секунддук терезелерге бөлүнгөн. Ошондуктан 5 секунддук бир терезеде болжол менен 500 убакыт чекити болушу моделдин киргизүү өлчөмүнө шайкеш келет.
Bi-LSTMнин милдети катарды алдыга да, артка да иштетип, убакыт ичиндеги жергиликтүү жана өткөн/келечек контекстин чагылдыруу. Ар бир багыт үчүн 128 hidden unit колдонулат жана эки багыт бириккенде 256 өлчөмдүү чыгыш алынат.
Андан соң Transformer encoder катардагы бири-биринен алысыраак убакыт чекиттеринин көз карандылыктарын self-attention аркылуу моделдейт. Булакта Transformer катмары үчүн:
- 8 attention head,
- 256 model dimension,
- 512 feed-forward dimension,
- 0,1 dropout,
- 2 Transformer encoder катмары
көрсөтүлгөн.
Gated Weighted Fusion эмне кылат?
Булакта GWFнин максаты эки модалдуулукту жөн гана жанаша кошуунун ордуна, учурдагы үлгүдө кайсы өзгөчөлүк пайдалуураак экенин үйрөнүлүүчү жол менен аныктоо.
Эки өзгөчөлүк:
\[ f_1,f_2\in R^{C\times1} \]
деп аныкталып, адегенде:
\[ f_{\mathrm{cat}}=[f_1;f_2] \]
түрүндө бириктирилет. Андан соң gating weight:
\[ g= \sigma(W_gf_{\mathrm{cat}}+b_g) \]
менен эсептелет. \(g\) маанилери 0 менен 1’дин арасында.
Булактын акыркы fusion теңдемеси:
\[ f_{\mathrm{fused}} = g\odot f_1 + (1-g)\odot f_2 \]
түрүндө. Бул түзүлүш бир модалдуулуктун айрым feature каналдарын күчөтүп, экинчисин басаңдата алган үйрөнүлүүчү салмактоо механизми.
Архитектуралык өлчөм эскертүүсү: Бул жерде булакта түшүндүрүлбөгөн өлчөм айырмасы бар. ViT бөлүмү жүз өзгөчөлүгүн 768 өлчөмдүү деп аныктаса, Сүрөт 1 GWFге кирген жүз бутагын 256×1 деп көрсөтөт. Мындан тышкары жогорудагы weighted-sum формуласы \(C\)-өлчөмдүү чыгыш чыгарса, Сүрөт 1 GWF чыгышын 512×1 деп белгилейт. Булак бул өзгөртүүлөрдүн аралык катмарларын түшүндүрбөйт.
Классификатор эмне чыгарат?
Бириктирүүдөн чыккан өзгөчөлүк MLP негизиндеги classifier'га берилет. Акыркы катмарда Softmax колдонулуп, беш категория үчүн ыктымалдуулук чыгарылат:
\[ \hat{y}_k= \frac{\exp(z_k^{(L)})} {\sum_{i=1}^{C}\exp(z_i^{(L)})} \]
Класс дал келүүсү булак Сүрөт 1’де:
| Класс | Эмоция |
|---|---|
| 0 | Тынч |
| 1 | Бактылуу |
| 2 | Таң калган |
| 3 | Ачууланган |
| 4 | Башка |
Эмоциялык стимулдар кантип тандалган?
Изилдөөчүлөр түз эле лабораториялык экспериментке өтпөстөн, адегенде кайсы айдоо жана айлана-чөйрө үндөрү жаңы айдоочуларда кайсы эмоциялар менен байланыштуу экенин изилдешкен. Сурамжылоого жалпы 387 адам катышкан; алардын 197'си эркек жана 190'ы аял.
Сурамжылоодо 17 үн колдонулган. Алардын арасында телефон коңгуроосу, жамгыр, тез жардам сиренасы, унаа кагылышы, мушташ, коркунучтуу чөйрө, тынчтандыруучу музыка, катуу музыка, иттин үргөнү, унаанын ылдамдашы, тормоз үнү, сигнал жана ызы-чуу сыяктуу мисалдар бар.
Үн менен эмоция категориясынын ортосундагы байланыш үчүн chi-square тести колдонулган:
\[ \chi^2= \sum_{i,j} \frac{(O_{ij}-E_{ij})^2}{E_{ij}} \]
Булакта:
\(\chi^2=1310,791\), p<0,001
жыйынтыгы билдирилген. Изилдөөчүлөр үн түрлөрү менен эмоция бөлүштүрүлүшү маанилүү түрдө байланыштуу деп баалашкан.
Correspondence analysis'те эки өлчөмдүн кумулятивдүү түшүндүрүү үлүшү %80'ден ашканы көрсөтүлгөн. Изилдөөнүн чечмелөөсүнө ылайык, үзгүлтүксүз сигнал, мушташ жана иттин үргөнү anger аймагына; күтүүсүз кагылышка окшош үндөр болсо surprise аймагына жакыныраак топтолгон.
Бул сурамжылоо жыйынтыктары кийинки айдоо симуляциясы үчүн “сахна + үн” stimulus айкалыштарын тандоодо колдонулган. Сурамжылоо жыйынтыгы реалдуу айдоодо объективдүү эмоция өзгөрүүсүнүн түз далили эмес; эксперименттик стимул тандоонун алдын ала баскычы.
Статикалык жана динамикалык айдоо эксперименттери кантип уюштурулган?
Статикалык бөлүмдө 60 шаардык айдоо сүрөтү колдонулган. Сүрөттөн мурда айдоо сценарийине байланыштуу prompt 3 секунд, андан соң сүрөт 10 секунд көрсөтүлгөн. Маневрлердин арасында бурулуш, тилке алмаштыруу, жөө жүргүнчүдөн качуу, жол тыгыны жана озуп өтүү үчүн ылдамдануу бар.
Ар бир топ 12 сүрөттөн туруп, жалпы беш топ даярдалган. Булак ар бир топ болжол менен 2 мүнөт 35 секунд созулганын, бирок жалпы статикалык эксперимент болжол менен 30 мүнөт болгонун жазат.
Убакыт шайкешсиздиги: Беш даана 2 мүнөт 35 секунддук топ болжол менен 12 мүнөт 55 секунд болот. 12 × (3+10 секунд) эсеби да бир топко болжол менен 2 мүнөт 36 секунд берет. Булакта 30 мүнөттүк жалпы убакытты түшүндүргөн кошумча күтүү же тыныгуу убактысы көрсөтүлгөн эмес.
Динамикалык бөлүмдө 60 шаардык айдоо видеосу колдонулган. Видеолор баштапкы айдоо окутуу видеолорунан алынган жана түз айдоо, айланма жол түйүнү менен кесилиште күтүү сыяктуу жүрүм-турумдарды камтыйт.
Ар бир видео эки мүнөт созулган; 10 видео бир топ, жалпы алты топ түзүлгөн. Топтордун ортосунда беш мүнөт тыныгуу берилип, ар бир топтун алдында тогуз чекиттүү eye-tracker калибрлөөсү жүргүзүлгөн. Жалпы динамикалык эксперимент убактысы болжол менен 2 саат 30 мүнөт деп көрсөтүлгөн.
Эксперименттик түзүлүштө кайсы аппараттар бар?
Лабораториялык түзүлүштө симуляцияланган рул, муфта, тормоз, сигнал башкаруусу, көз трекери, human-factor жабдуусу, ноутбук, камера жана кулакчын бар.
Көз кыймылы үчүн aSee Pro F100 колдонулуп, үлгүлөө жыштыгы 100 Hz деп көрсөтүлгөн. aSee Studio программасы катышуучу маалыматын, pupil маалыматтарын, gaze чекиттерин, saccade жана blink сыяктуу параметрлерди чогултууда колдонулган.
Булак Сүрөт 5’те эксперимент чөйрөсүн түз көрсөтөт: айдоо симуляциясынын сүрөтү монитордо көрсөтүлүп жатканда камера жана aSee Pro көздү байкоо системасы катышуучунун алдында, рул симулятору болсо үстөлдүн алдында жайгашкан. Бул түзүлүш реалдуу унаа кабинасы эмес, лаборатория негизиндеги айдоо симуляциясы.
Катышуучулар кимдер болгон?
Экспериментке жашы 18–25 аралыгындагы 34 адам алынган жана орточо жаш 22 деп билдирилген. Катышуучулар айдоочулук күбөлүк алуу баскычында же бир жылдан аз айдоо тажрыйбасы бар адамдардан тандалган.
Эксперименттик натыйжалуулугу %90'дан төмөн болгон катышуучулар чыгарылып, жыйынтыгында 32 адамдык натыйжалуу тандалма калган.
Изилдөөдө катышуучулардын көздү байкоо өлчөөлөрүнө таасир этиши мүмкүн болгон шарттар үчүн да критерийлер белгиленген. Булак контакт линза колдонбоону жана көз айнек колдонгондордо рецепт “500 diopters” маанисинен ашпоосун жазат. Бул сан булакта кандай берилсе ошондой өткөрүлөт; мүмкүн болгон бирдик же котормо көйгөйү үнсүз оңдолбойт.
Катышуучулар маалымдалган макулдук берген жана изилдөө Baoji University of Arts and Sciences этика комитети тарабынан жактырылган.
Көз кыймылы маалыматтары кантип даярдалган?
Булак ар бир катышуучунун баштапкы eye-movement маалымат топтомунда 79.070 убакыт чекити болгонун билдирет. Маалыматтар 5 секунддук убакыт терезелерине бөлүнгөн.
100 Hz үлгүлөөдө 5 секунддук бир терезе болжол менен 500 убакыт чекитине туура келет; моделдин киргизүүсү 500×17 деп аныкталышы ушул түзүлүшкө шайкеш келет.
Булак текстинде бул slicing операциясы “79.070 rows'tan болжол менен 500 rows'a” түшүргөнү тууралуу сөз да бар. Мунун ар бир 5 секунддук терезе болжол менен 500 сап камтый турганын моделдин киргизүүсүнөн түшүнүүгө болот, бирок текст жалпы маалымат көлөмү жагынан ачык эмес.
Жүз сүрөттөрү кантип даярдалган?
Жүз видеолору ErgoLAB facial-expression analysis программасына берилип, facial feature чекиттери жана тиешелүү emotion label'дар алынган. Андан кийин видеолор frame-by-frame сүрөт катарларына айландырылган.
Сүрөттөр 1920×1080 чечилиштен 224×224 пикселге кайра өлчөмдөлүп, пиксел маанилери [0,1] диапазонуна нормалдаштырылган.
Булак программа чыгарган emotion label'дардан кийин кол менен classification жүргүзүлгөнүн билдирет. Бирок eye-movement терезелери менен facial frame'дердин акыркы жалпы ground-truth белгисин синхрондоштуруу деталдары ыкма бөлүмүндө чектелүү түшүндүрүлгөн.
Модель кайсы маалымат менен үйрөтүлгөн?
| Маалымат түрү | Үлгү саны |
|---|---|
| Көз кыймылы үлгүлөрү | 30.000 |
| Жүз мимикасы үлгүлөрү | 30.000 |
| Ар бир эмоция категориясы | 6000 |
Үлгүлөр subject деңгээлинде беш кичи топко бөлүнгөн. Ар бир айлампада төрт кичи топ окутууга, калган кичи топ validation үчүн колдонулуп, бардык кичи топтор бир жолу validation болгондо процесс аяктаган.
Окутуу параметрлери
| Параметр | Маани |
|---|---|
| Epoch | 30 |
| Batch size | 32 |
| Initial learning rate | 10−3 |
| Optimizer | Adam |
| Loss | Cross-entropy |
| Validation | Subject-level 5-fold cross-validation |
Жүз гана, көз гана жана multimodal жыйынтыктар кантип өзгөрөт?
| Модалдуулук | Булакта билдирилген accuracy |
|---|---|
| Жүз сүрөтү | %71,18 |
| Көз кыймылы | %95,10 |
| Multimodal | %98,72 |
Булактын өз чечмелөөсү боюнча жыйынтыктардын эң маанилүү билдирүүсү — бул эксперименттик топто көз кыймылы маалыматы жүз мимикасына караганда кыйла ажыратуучу болгон жана эки модалдуулукту бириктирүү жогору билдирилген тактык берген.
Бул жыйынтык жүз мимикасы жалпысынан эмоция таануу үчүн алсыз дегенди билдирбейт. Натыйжа ушул маалымат топтому, ушул катышуучу тобу, ушул стимулдар жана ушул модель түзүлүшү үчүн гана жарактуу.
GWF жөнөкөй concatenation'дан жакшыбы?
| Fusion ыкмасы | Accuracy (%) |
|---|---|
| Feature Concatenation | 95,45 |
| GWF Fusion | 98,72 |
Эки маанинин абсолюттук айырмасы 3,27 пайыздык пункт. Булак бул жыйынтыкты “accuracy'de %3,27 improvement” деп сүрөттөйт.
Confusion matrix'тер эмне үчүн маанилүү?
Жүз сүрөтү гана моделинин Сүрөт 10 confusion matrix'индеги негизги диагоналдын суммасы 3257, жалпы үлгү саны 4576:
\[ Accuracy= \frac{3257}{4576} = 0,71176 \approx71,18\% \]
Бул маани Сүрөт 8’де билдирилген facial-image accuracy менен толук шайкеш келет.
Facial моделде Class 0, башкача айтканда calm категориясы айрыкча Class 4 “other” жана Class 3 “angry” менен чаташканы көрүнөт. Булак муну тынч эмоциядагы жүз өзгөрүүлөрүнүн майда болушу менен чечмелейт.
Бирок multimodal Сүрөт 11 кайра эсептелгенде:
| Өлчөм | Маани |
|---|---|
| Жалпы confusion-matrix үлгүсү | 4576 |
| Негизги диагональ / туура классификация | 4304 |
| Матрицадан кайра эсептелген accuracy | ≈ %94,06 |
| Сүрөт 8 жана Таблица 3’тө билдирилген multimodal accuracy | %98,72 |
Илимий отчет берүү эскертүүсү: Булак Сүрөт 11 башка fold, кичи топ же эксперимент бөлүгүнө тиешелүү экенин билдирбейт. Ошого карабастан confusion matrix'тен кайра алынган %94,06 менен негизги таблицадагы %98,72 шайкеш келбейт. Verianla бул эки жыйынтыктын кайсынысы туура экенин тандабайт; шайкешсиздикти ачык сактайт.
Eye-movement моделиндеги Bi-LSTM жана Transformer салымы кандай?
Көз кыймылы маалыматы гана менен жүргүзүлгөн абляцияда:
| Модель | Accuracy (%) |
|---|---|
| Bi-LSTM | 87,50 |
| Transformer | 94,23 |
| Bi-LSTM + Transformer | 95,10 |
Multimodal экспериментте болсо eye branch компоненттеринин таасири:
| Eye branch | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Булак бул жыйынтыктарды Bi-LSTM убакыт ичиндеги багыттуу көз карандылыктарды, Transformer болсо узагыраак аралыктагы мамилелерди чагылдыруусу бири-бирин толуктайт деп чечмелейт.
Үч жалпы маалымат топтомундагы жыйынтыктар эмнени көрсөтөт?
Изилдөөчүлөр модель өз эксперименттик маалыматындагы ийгиликке гана көз каранды болбошу үчүн AFFEC, SEED-IV жана AffectNet боюнча кошумча салыштырууларды жүргүзүшкөн.
| Маалымат топтому | Модалдуулук | Сунушталган модель Accuracy | Macro-F1 |
|---|---|---|---|
| AFFEC | Көз + жүз | 91,95 ± 0,87% | 91,36 ± 0,92% |
| SEED-IV | Көз кыймылы гана | 90,44 ± 0,75% | 89,81 ± 0,80% |
| AffectNet | Жүз гана | 89,67 ± 0,69% | 89,02 ± 0,73% |
Булак сунушталган модель үч маалымат топтомунда тең baseline'дарга салыштырмалуу p<0,05 деңгээлинде статистикалык маанилүү артыкчылык көрсөткөнүн билдирет.
Бирок бул бөлүмдү чечмелөөнүн чеги өзгөчө маанилүү: AFFEC, SEED-IV жана AffectNet жаңы айдоочулар үчүн түзүлгөн айдоо маалымат топтомдору эмес. Изилдөө муну ачык баса белгилейт. Бул жыйынтыктар модель архитектурасынын жалпы эмоция таануу жөндөмүн колдойт; реалдуу айдоо шартындагы өндүрүмдүүлүгүн текшербейт.
Башка эмоция таануу ыкмалары менен кантип салыштырылган?
| Сигналдар | Ыкма | Булакта берилген accuracy |
|---|---|---|
| Көз + үн + сүрөт | FE-CNN | 81,90% |
| Көз + PPG | FECNN + LSTM | 84,68% |
| Жүз + rPPG + көз | Dual-path Transformer | 86,98% |
| EEG + көз | MFFNN | 87,32% |
| EEG | LSTM | 90,72% |
| EEG + ECG + көз | 1D-Inception + Self-Attention + LSTM | 91,38% |
| EEG | CNN-LSTM | 93,97% |
| EEG + жүз + физиологиялык сигналдар | GNN | 91,25% |
| Көз + жүз | Бул изилдөө | 98,72% |
Бул таблица ар башка изилдөөлөрдүн ар башка маалымат топтомдорун, класс сандарын, тандалмаларын жана эксперимент протоколдорун камтыгандыктан түз жарыш таблицасы катары окулбашы керек. Булак бул маанилерди адабият салыштыруусу катары берет; бир эле benchmark боюнча көзөмөлдөнгөн head-to-head эксперимент эмес.
Модель реалдуу убакыттабы?
Булак multimodal модель үчүн batch башына орточо processing time маанисин:
29,42 ± 0,08 ms
деп берет.
Hybrid inference режиминде үлгү башына:
0,9230 ± 0,0014 ms
билдирилген.
Изилдөөчүлөр бул маанини унаа ичиндеги адам–машина өз ара аракеттенүүсү үчүн колдонгон 100–200 ms референстик кечигүүдөн төмөн болгондуктан реалдуу убакыт үчүн жетиштүү деп чечмелешет.
Бирок бул убакыт реалдуу унаада, өндүрүш тибиндеги embedded ECUда же унаа ичиндеги камера/eye-tracker pipeline'ынын бүтүндөй агымында өлчөнгөн end-to-end latency эмес. Изилдөө реалдуу айдоо чөйрөсүндө deployment жүргүзүлбөгөнүн ачык белгилейт.
Изилдөө колдогон жыйынтыктар
- Жүз сүрөтү менен eye-tracking маалыматтарын бирге колдонгон гибрид эмоция таануу архитектурасы ишке ашырылган.
- ViT-B/16, Bi-LSTM, Transformer encoder, GWF жана MLP бир multimodal pipeline ичинде колдонулган.
- Булактын негизги таблицаларында multimodal модель үчүн %98,72 accuracy билдирилген.
- Булак модалдуулук абляциясында eye-movement маалыматы facial-image маалыматынан жогорку accuracy бергенин көрсөтөт.
- GWF булакта жөнөкөй feature concatenation'га караганда жогорку accuracy менен билдирилген.
- Bi-LSTM + Transformer eye branch'и Bi-LSTM гана же Transformer гана колдонулган абляциялардан жогорку көрсөткүч берген.
- Модель AFFEC, SEED-IV жана AffectNet жалпы эмоция маалымат топтомдорунда салыштырылган baseline'дардан жогору билдирилген.
- Моделдин inference убактысы лабораториялык эсептөө чөйрөсүндө миллисекунд деңгээлинде өлчөнгөн.
Изилдөө колдобогон, сынабаган же далилдебеген жыйынтыктар
- Модель реалдуу жол кыймылында же реалдуу унаа айдоодо сыналган эмес.
- %98,72 accuracy'ни Түркиядагы же башка жаш топтогу жаңы айдоочуларга көчүрүүгө болору көрсөтүлгөн эмес.
- Эмоция таануу жол кырсыктарын иш жүзүндө азайтары бул изилдөөдө эксперименттик өлчөнгөн эмес.
- Модель унаа ичиндеги камера, күн нуру, түнкү айдоо, жүздүн жабылышы, интенсивдүү баш кыймылы жана реалдуу жол термелүүсүндө текшерилген эмес.
- Реалдуу embedded унаа платформасында энергия сарптоосу, RAM, модель көлөмү жана end-to-end latency өлчөөсү берилген эмес.
- Үч тышкы маалымат топтомундагы ийгилик жаңы айдоочуга арналган реалдуу айдоо текшерүүсү эмес.
- Изилдөөнүн confusion matrix'и негизги билдирилген %98,72 тактык маанисин өз алдынча ырастабайт.
- Моделдин эмоция класстары адамдын реалдуу психологиялык абалынын клиникалык же так өлчөөсү катары чечмеленбеши керек.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Изилдөө дизайнынын негизги компоненттери
| Компонент | Булакта берилген маалымат |
|---|---|
| Сурамжылоо тандалмасы | 387 адам |
| Сурамжылоо эркек/аял | 197 / 190 |
| Үн стимулу | 17 түр |
| Баштапкы эксперимент катышуучусу | 34 |
| Натыйжалуу катышуучу | 32 |
| Жаш | 18–25; орточо 22 |
| Айдоо тажрыйбасы | Күбөлүк талапкери же <1 жыл тажрыйба |
| Eye tracker | aSee Pro F100 |
| Eye-tracking sampling rate | 100 Hz |
| Eye window | 5 s / болжол менен 500 убакыт чекити |
| Eye model киргизүүсү | 500 × 17 |
| Facial-image киргизүүсү | 224 × 224 × 3 |
| Эмоция классы | 5 |
Модель архитектурасынын негизги параметрлери
| Модуль | Негизги түзүлүш |
|---|---|
| Жүз feature extraction | ViT-B/16; 16×16 patch; 768-өлчөмдүү classification token |
| Bi-LSTM | 128 hidden unit/багыт; бириккен 256-өлчөмдүү чыгыш |
| Transformer encoder | 8 head, d-model 256, FFN 512, dropout 0,1, 2 катмар |
| Fusion | Gated Weighted Fusion |
| Classifier | MLP + Softmax |
Негизги multimodal эксперимент жыйынтыгы
| Eye feature модели | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Confusion matrix сапат текшерүүсү
| Булак жыйынтыгы | Билдирилген / кайра эсептелген | Абалы |
|---|---|---|
| Facial-image accuracy | Сүрөт 8: %71,18 / Сүрөт 10 матрицасынан: %71,18 | Шайкеш |
| Multimodal accuracy | Сүрөт 8 жана Таблица 3: %98,72 / Сүрөт 11 матрицасынан: ≈%94,06 | Шайкеш эмес |
Бул текшерүү Verianla тарабынан булак Сүрөт 10 жана Сүрөт 11 уячалары боюнча кайра эсептелген. Булактын ордуна жаңы эксперимент жыйынтыгын чыгарбайт; жарыяланган уячалардын арифметикалык шайкештигин гана текшерет.
Жалпы маалымат топтомдорундагы жыйынтыктар
| Dataset | Сунушталган модель Accuracy ± Std | Macro-F1 ± Std | Булак статистикалык эскертүүсү |
|---|---|---|---|
| AFFEC | 91,95 ± 0,87% | 91,36 ± 0,92% | p<0,05 vs. бардык baseline'дар |
| SEED-IV | 90,44 ± 0,75% | 89,81 ± 0,80% | p<0,05 vs. бардык baseline'дар |
| AffectNet | 89,67 ± 0,69% | 89,02 ± 0,73% | p<0,05 vs. бардык baseline'дар |
Реалдуу убакыт жыйынтыгы
| Өлчөө | Маани |
|---|---|
| Batch башына processing time | 29,42 ± 0,08 ms |
| Hybrid inference mode, үлгү башына | 0,9230 ± 0,0014 ms |
Бул өндүрүмдүүлүк маанилери моделдин эсептөөсүнө тиешелүү. Реалдуу унаадагы камера acquisition, eye-tracking acquisition, preprocessing, операциялык система кечигүүсү, сенсор синхрондоштуруу жана эскертүү чыгаруунун баарын камтыган реалдуу end-to-end унаа ичиндеги кечигүү өлчөөсү эмес.
Изилдөөнүн негизги чектөөлөрү
- Натыйжалуу айдоочу тандалмасы 32 адам гана.
- Катышуучулар 18–25 жаш тобунда гана.
- Маданий ар түрдүүлүк чектелүү.
- Эмоциялар лабораторияда визуалдык жана аудио stimulus аркылуу пайда кылынган.
- Күтүүсүз реалдуу жол окуялары сыналган эмес.
- Реалдуу унаа айдоосу колдонулган эмес.
- Табигый унаа ичиндеги жарык өзгөрүүсү, head movement жана facial occlusion кеңири текшерилген эмес.
- Реалдуу embedded deployment жүргүзүлгөн эмес.
- Multimodal confusion matrix менен негизги accuracy жыйынтыгынын ортосунда түшүндүрүлбөгөн сандык шайкешсиздик бар.
- GWFнин feature өлчөмдөрү ыкма теңдемелери менен архитектуралык сүрөттүн ортосунда толук түшүндүрүлгөн эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Толук оригинал изилдөө аталышы: Hybrid Deep Neural Network-Based Modeling of Multimodal Emotion Recognition for Novice Drivers
Авторлор жана ирети: Jianzhuo Li; Ye Yu; Zhao Dai; Panyu Dai.
Жооптуу автор: Jianzhuo Li.
Тең биринчи/тең салым: Булакта көрсөтүлгөн эмес.
Мекеме: School of Computer Science, Baoji University of Arts and Sciences, Baoji 721016, China.
Журнал: Future Internet
Басмакана: MDPI, Basel, Switzerland
Том / саны / макала: 18 / 4 / 221
Алынган күнү: 27 Февраль 2026
Кайра каралган күнү: 17 Апрель 2026
Кабыл алынган күнү: 18 Апрель 2026
Жарыяланган күнү: 21 Апрель 2026
DOI: 10.3390/fi18040221
Расмий жарыя шилтемеси:https://doi.org/10.3390/fi18040221
Булактын түрү: Рецензияланган изилдөө макаласы; лаборатория негизиндеги симуляцияланган айдоо эксперименти, eye-tracking/facial-image маалымат талдоосу жана терең үйрөнүү моделдөө иши.
Рецензия абалы: Рецензияланган журналда жарыяланган изилдөө.
Лицензия: Creative Commons Attribution (CC BY).
Версия: Каралган файл v2 деп аталган. Басмакананын версия эскертүүсү изилдөө үчүн жаңыртылган version of record бар экенин көрсөтөт. Жаңыртуунун көлөмү каралган макаланын илимий мазмунунан тышкары божомолдонгон эмес.
Этикалык жактыруу: Изилдөө Хельсинки декларациясына ылайык жүргүзүлгөнүн билдирет жана Baoji University of Arts and Sciences Institutional Review Board жактыруу номерин BJWL-2025-ETH-048, жактыруу күнүн 7 Январь 2025 деп берет.
Маалымдалган макулдук: Булак бардык катышуучулар изилдөөнүн максаты жана процедурасы тууралуу маалымдалганын жана илимий изилдөө үчүн маалымат колдонууга макул болгон informed-consent form'го кол койгонун билдирет.
Каржылоо: Изилдөө тышкы каржылоо алган эмес.
Маалымат жеткиликтүүлүгү: Колдонулган маалымат топтомдорун негиздүү суроо боюнча жооптуу автордон алууга болору көрсөтүлгөн.
Кызыкчылыктар кагылышы: Авторлор кызыкчылыктар кагылышы жок экенин билдирген.
Автор салымдары: Булак билдирүүсүнө ылайык концептуалдаштыруу Ye Yu; методология Ye Yu, Zhao Dai жана Panyu Dai; программалык камсыздоо Ye Yu жана Panyu Dai; текшерүү, формалдык талдоо, изилдөө жана маалымат курациясы Ye Yu; алгачкы долбоор Ye Yu; карап чыгуу/редакциялоо Jianzhuo Li; визуалдаштыруу Ye Yu; көзөмөл жана долбоор башкаруу Jianzhuo Li тарабынан жүргүзүлгөн.
Булак ичиндеги сандык шайкешсиздик 1 — confusion matrix: Facial-image confusion matrix уячаларынан кайра эсептелген accuracy %71,18 болуп, Сүрөт 8 менен шайкеш келет. Multimodal confusion matrix'те болсо 4576 үлгүнүн 4304'ү негизги диагоналда жана кайра эсептелген accuracy болжол менен %94,06. Бул маани Сүрөт 8 жана Таблица 3’төгү %98,72 менен шайкеш келбейт. Булак башка баалоо топтомун же fold'ду түшүндүрбөйт.
Булак ичиндеги архитектуралык шайкешсиздик 2 — feature өлчөмдөрү: ViT ыкмасы classification-token чыгышын 768 өлчөмдүү деп аныктаса, Сүрөт 1 жүз бутагынын GWF киргизүүсүн 256×1 деп көрсөтөт. GWF Теңдеме (19) C-өлчөмдүү эки киргизүүдөн C-өлчөмдүү weighted-sum чыгарса, Сүрөт 1 чыгышты 512×1 деп көрсөтөт. Аралык өзгөртүү ачык аныкталган эмес.
Булак ичиндеги убакыт шайкешсиздиги 3: Статикалык айдоо экспериментинин беш тобунун ар бири болжол менен 2 мүнөт 35 секунд деп аныкталган; бул болжол менен 12 мүнөт 55 секунд. 12 сүрөт × 13 секунддук stimulus түзүлүшү да болжол менен ошол эле убакытты берет. Булак ошого карабастан жалпы статикалык эксперимент убактысын болжол менен 30 мүнөт деп билдирет жана айырманын себебин түшүндүрбөйт.
Булак ичиндеги бирдик эскертүүсү 4: Катышуучуларды тандоо критерийинде көз айнек рецепти үчүн булакта “500 diopters” деген сөз бар. Мүмкүн болгон бирдик/котормо катасы булактан тышкаркы божомол менен оңдолгон эмес.
GWF өндүрүмдүүлүк билдирүүсү: Булак feature concatenation үчүн %95,45 жана GWF үчүн %98,72 accuracy билдирип, өсүштү %3,27 деп атайт. Эки билдирилген accuracy маанисинин абсолюттук айырмасы 3,27 пайыздык пункт.
Ground-truth/этикеттөө эскертүүсү: Facial expression видеолору ErgoLAB программасы менен талданып emotion label чыгарылган жана андан кийин кол менен классификация жүргүзүлгөн. Eye-movement үлгүлөрү беш категория менен белгиленгени айтылганы менен эки модалдуулуктун акыркы жалпы ground-truth белгисин түзүү жана синхрондоштуруу процедурасы булакта кеңири түшүндүрүлгөн эмес.
Жалпылоо чеги: AFFEC, SEED-IV жана AffectNet боюнча текшерүүлөр жалпы эмоция таануу тапшырмалары. Булак бул маалымат топтомдору novice-driver же driving-specific эмес экенин өзгөчө белгилейт. Ошондуктан бул жыйынтыктар реалдуу айдоо шарттарына түз текшерүү катары колдонулган эмес.
Реалдуу убакыт чеги: 29,42 ms/batch жана 0,9230 ms/sample маанилери моделдин processing өлчөөлөрү. Изилдөөдө реалдуу унаа ичиндеги embedded system deployment же реалдуу айдоо шартындагы end-to-end latency өлчөөсү жүргүзүлгөн эмес.
Бул Verianla түшүндүрмөсүндөгү ыкма, маалымат топтомдору, теңдемелер, классификация жыйынтыктары, таблицалар, сүрөт чечмелөөлөрү жана чектөөлөр каралган илимий изилдөөгө негизделген. Библиографиялык тышкы текшерүү DOI, журнал, басмакана, рецензия жана жарыя версиясы сыяктуу булак идентификация элементтерин ырастоо үчүн гана колдонулган; тышкы булактардан жаңы эмоция таануу жыйынтыгы же жаңы өндүрүмдүүлүк мааниси кошулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген