

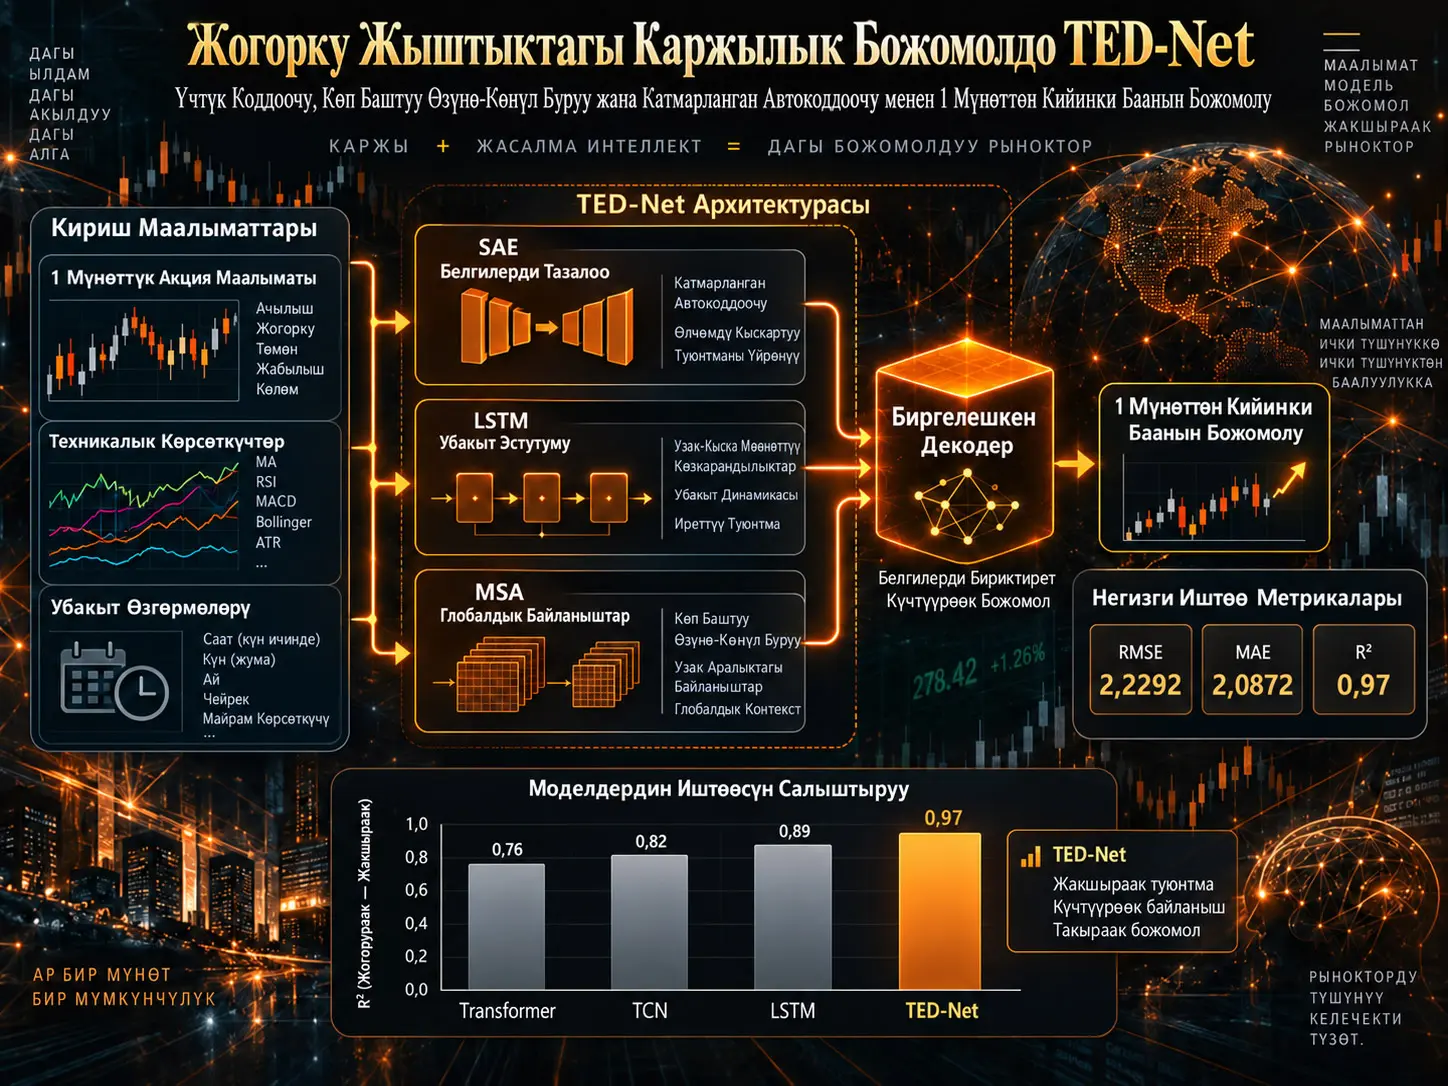
Финансылык убакыт катарлары сызыктуу эмес түзүлүшү, өзгөрмө статистикалык касиеттери, жогорку ызы-чуусу жана узак мөөнөттүү көз карандылыктары себептүү божомол моделдери үчүн татаал маалымат булагы болуп саналат. Бул изилдөө ушул көйгөйлөрдү бир моделдин ичинде кароо максатында TED-Net (Triple Encoder-Decoder Network) аттуу гибриддик терең үйрөнүү архитектурасын сунуштайт. TED-Net үч өзүнчө коддоо механизмин бириктирет: Stacked Autoencoder (SAE) белгилерди тазалап, төмөн өлчөмдүү өкүлчүлүк түзөт; LSTM-Seq2Seq убакыттагы кыска жана узак мөөнөттүү көз карандылыктарды үйрөнөт; Multi-Head Self-Attention (MSA) болсо ар кандай убакыт чекиттери менен өкүлчүлүктүн субмейкиндиктеринин ортосундагы глобалдык байланыштарды кармоого аракет кылат. Бул үч маалымат булагы gated fusion жана attention колдонгон collaborative decoder аркылуу бириктирилип, кийинки баанын божомолу алынат.
Эксперименттерде ар түрдүү секторлордон жана рыноктук баалоодогу 15 A-share акциясы үчүн ар бирине 24.000 даана бир мүнөттүк байкоо колдонулган; алгачкы %80 окутууга, акыркы %20 validation маалыматына бөлүнгөн. Негизги божомол тапшырмасында мурунку 30 мүнөттүк маалымат менен кийинки мүнөттүн жабылуу баасы божомолдонот. Булакта TED-Net Transformer, TCN жана LSTM-Seq2Seq менен салыштырууларда акциялар боюнча орточо таблицалардын көпчүлүгүндө же баарында жогорураак отчеттолгон тактык көрсөткөнү айтылат. CATL боюнча өзүнчө экспериментте TED-Net үчүн RMSE 2,2292, MAE 2,0872 жана R² 0,97 отчеттолгон.
Ошол эле учурда изилдөөдөгү “high-frequency trading” деген түшүнүк этият чечмелениши керек. Колдонулган маалымат бир мүнөттүк убакыт катарлары болуп, модель чыныгы буйрутмалар китебинин билдирүүлөрүндө же микро-секунддук execution агымында иштебейт. Мындан тышкары, изилдөө соода стратегиясын эмес, баа божомолун текшерет; P&L, transaction cost, slippage, Sharpe ratio же жандуу буйрутма аткаруу жыйынтыктары берилген эмес.
| Компонент | Негизги милдети |
|---|---|
| Stacked Autoencoder — SAE | Белгилердеги ызы-чууну азайтып, кыйла компакттуу өкүлчүлүк түзүү |
| LSTM-Seq2Seq | Кыска жана узак мөөнөттүү убакыттык көз карандылыктарды моделдөө |
| Multi-Head Self-Attention — MSA | Ар түрдүү убакыт чекиттеринин ортосундагы глобалдык байланыштарды кармоо |
| Dynamic Window Attention | Узун ырааттуулуктарда attention эсептөө аймагын чектөө |
| Collaborative Decoder | Үч encoder-дан келген маалыматты адаптивдүү түрдө бириктирүү |
| Чыгыш | Кийинки мүнөттүн баа божомолу |
TED-Net кайсы үч көйгөйдү чечүүгө аракет кылат?
Булак изилдөө жогорку жыштыктагы финансылык божомолдоону үч негизги көйгөй аркылуу аныктайт.
Белги көйгөйү: Финансылык көрсөткүчтөр бири-бири менен жогорку корреляцияда болушу жана олуттуу көлөмдө ызы-чуу камтышы мүмкүн. Өтө көп окшош же аз маалымат алып жүргөн өзгөрмөлөр моделди окутууну кыйындатышы мүмкүн.
Убакыттык көйгөй: Узун ырааттуулуктарда өткөн маалымат убакыт өткөн сайын жоголушу мүмкүн. LSTM классикалык RNN-дерге салыштырмалуу бул көйгөйдү азайтса да, өтө узун ырааттуулуктарда бардык тарыхый маалыматты бирдей деңгээлде сактоодо дагы эле кыйналышы мүмкүн.
Корреляция көйгөйү: Бир ырааттуу модель жакын убакыттык байланыштарды үйрөнө алганы менен, ырааттуулуктун ар башка бөлүктөрүнүн ортосундагы глобалдык байланыштарды толук эмес көрсөтүшү мүмкүн.
TED-Net бул үч көйгөйгө тиешелүүлүгүнө жараша SAE, LSTM жана MSA менен жооп берүүгө аракет кылат.
Үчтүк коддоо архитектурасы кантип иштейт?
Булактагы жалпы үйрөнүү агымы:
Белгилерди тазалоо → Убакыттык моделдөө → Глобалдык корреляцияны чыгаруу → Биргелешкен decoding → Божомол
түрүндө жыйынтыкталат.
SAE биринчи этапта финансылык көрсөткүчтөрдү кыйла компакттуу latent өкүлчүлүккө айлантат. Бул чыгыш LSTM тарабынан убакыт ырааттуулугу катары иштетилет. MSA ырааттуулуктагы ар башка убакыт чекиттеринин өз ара байланыштарын attention салмактары аркылуу эсептейт. Decoder андан кийин бул үч өкүлчүлүктү бир божомол чыгаруу үчүн бириктирет.
Stacked Autoencoder эмне үчүн колдонулат?
Autoencoder киргизүүнү төмөн өлчөмдүү latent өкүлчүлүккө коддоп, андан кийин кайра калыбына келтирүүгө аракет кылган нейрон тармагы. Модель маанилүү үлгүлөрдү гана сактоо менен киргизүүнү кайра түзүүнү үйрөнгөндө, ызы-чуунун жана керексиз өзгөрмөлөрдүн таасири азайтылышы мүмкүн.
Булакта encoding катмарлары:
\[ h^{(l)} = \sigma \left( W^{(l)}h^{(l-1)}+b^{(l)} \right) \]
түрүндө берилет.
TED-Net-те SAE өз алдынча алдын ала иштетүү куралы гана эмес, үчтүк encoder түзүлүшүнүн биринчи компоненти.
LSTM кандай маалыматты алып жүрөт?
LSTM эс тутум уясы, input gate, forget gate жана output gate аркылуу өткөн маалыматтын кайсынысы сакталары же унутулары үйрөнүлөт.
Булак негизги LSTM жаңыртуусун:
\[ i_t=\sigma(W_{xi}x_t+W_{hi}h_{t-1}+W_{ci}c_{t-1}+b) \]
\[ f_t=\sigma(W_{xf}x_t+W_{hf}h_{t-1}+W_{cf}c_{t-1}+b) \]
\[ c_t=f_tc_{t-1}+i_t\tanh(W_{xc}x_t+W_{hc}h_{t-1}+b) \]
\[ o_t=\sigma(W_{xo}x_t+W_{ho}h_{t-1}+W_{co}c_t+b) \]
\[ h_t=o_t\tanh(c_t) \]
менен аныктайт.
Seq2Seq түзүлүшүндө encoder өткөн ырааттуулукту иштетет, decoder болсо encoder-дан алынган өкүлчүлүктүн жардамы менен келечектеги максаттуу ырааттуулукту же маанини чыгарат.
Multi-Head Self-Attention эмне үчүн кошулган?
LSTM ырааттуу иштегендиктен эки алыс убакыт чекитинин ортосундагы байланыш көптөгөн аралык абалдар аркылуу өтөт. Self-attention болсо бир убакыт чекити башка убакыт чекиттерине түздөн-түз канчалык көңүл бурушу керек экенин эсептей алат.
Булак:
\[ Q=W_QX+b_Q,\qquad K=W_KX+b_K,\qquad V=W_VX+b_V \]
өзгөртүүлөрүн колдонот.
Андан кийин attention салмактары:
\[ \alpha_t= Softmax \left( \frac{Q_tK_t^T}{\sqrt{d_h}} \right) \]
менен эсептелет.
Dynamic Window Self-Attention деген эмне?
Толук self-attention узун ырааттуулуктарда бардык убакыт чекиттеринин бири-бири менен салыштырылышын талап кылгандыктан, эсептөө чыгымы тез өсүшү мүмкүн.
TED-Net ошондуктан ар бир \(t\) чекити үчүн белгилүү бир \(S_t\) терезесиндеги key жана value векторлорун гана колдонууну сунуштайт.
Бул ыкманын максаты:
- attention чыгымын азайтуу,
- жакын жана тиешелүү убакыт чекиттерине көңүл буруу,
- узун финансылык ырааттуулуктарда эсептөө жүгүн чектөө болуп саналат.
Булак терезенин узундугу динамикалык түрдө кантип тандаларын көрсөткөн алгоритмди же оптималдаштыруу эрежесин кеңири бербейт; негизги математикалык түзүлүш — терезенин ичинде self-attention эсептөө.
Модель чындап эле микро-секунддук HFT маалыматын колдонобу?
Жок. Булак кириш бөлүмүндө HFTнин микро-секунд деңгээлиндеги табияты жөнүндө айтса да, эксперименттик маалымат бир мүнөттүк жыштыкта.
Негизги тапшырма:
акыркы 30 мүнөттүк маалымат → кийинки 1 мүнөттүн жабылуу баасы
түрүндө.
Ошондуктан изилдөө order-book HFT же төмөн кечигүүдөгү execution изилдөөсү катары эмес, жогорку чечилишке ээ финансылык убакыт катарларын божомолдоо контекстинде бааланууга тийиш.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Маалымат түзүлүшү
Изилдөөдө ар түрдүү секторлордон жана рыноктук баалоодогу 15 A-share акциясы тандалган.
Ар бир акция үчүн:
- 24.000 даана бир мүнөттүк байкоо,
- %80 окутуу,
- %20 validation,
- 30 мүнөттүк кыска мөөнөттүү sequence,
- 120 мүнөттүк узак мөөнөттүү sequence
аныкталган.
Булак ошол эле бөлүмдө модель мурунку 30 мүнөттү колдонуп кийинки бир мүнөттүн жабылуу баасын божомолдой турганын белгилейт. 120 мүнөттүк узак мөөнөттүү ырааттуулуктун модель ичинде так кандай колдонулары азыраак түшүндүрүлгөн.
Белгилер
Алгачкы маалымат түзүлүшүндө 15 indicator бар экени айтылат. PCAдан кийин булак жети көрсөткүчтү отчеттойт:
- MACD,
- TRIX,
- VR,
- OBV,
- ROC,
- MTM,
- PSY.
Аларга 0,78, 0,69, 0,76, 0,68, 0,75, 0,72 жана 0,67 маанилери байланыштырылган. Бирок булак бул маанилер PCA loading-би, variance салымыбы же башка feature score-бу — аны түшүндүрбөйт.
Негизги окутуу параметрлери
| Параметр | Маани |
|---|---|
| LSTM катмары | 3 |
| Hidden unit | 128 |
| Learning rate | 0,007 |
| Dropout | 0,03 негизги эксперимент; 0,1 салыштырма эксперимент |
| Optimizer | Adam |
| Batch size | 100 |
| Sequence length | 30 |
| Loss | MSE + L2 regularization |
Салыштырма экспериментте Transformer үчүн \(d_m=128\), сегиз attention head жана алты encoder/decoder layer; TCN үчүн kernel size 3, dilation base 2, алты residual block жана 64 filter берилген.
Ablation эксперименттери
| Модель | AUC | Precision | Recall | MF1 |
|---|---|---|---|---|
| LSTM-Seq2Seq | 0,83 | 0,95 | 0,80 | 0,87 |
| + SAE | 0,88 | 0,96 | 0,85 | 0,91 |
| TED-Net: SAE + MSA | 0,92 | 0,98 | 0,89 | 0,94 |
Таблица SAE жана MSA кошулган сайын отчеттолгон метрикалар өскөнүн көрсөтөт.
Бирок моделдин негизги тапшырмасы баа регрессиясы болгонуна карабастан, бул таблицада классификация метрикалары колдонулган. Божомол баасы “rising / non-rising” белгисине кантип айландырылганы, decision threshold же класстардын бөлүштүрүлүшү булакта түшүндүрүлгөн эмес. Ошондуктан бул ablation таблицасын толук кайра өндүрүү мүмкүн эмес.
Он беш акцияны салыштыруу
Булак Table 3тө Transformer, TCN, LSTM-Seq2Seq жана TED-Net үчүн 15 акция боюнча “prediction accuracy” пайыздарын берет.
| Акция | Transformer | TCN | LSTM-Seq2Seq | TED-Net |
|---|---|---|---|---|
| ZTE | %87,73 | %86,04 | %87,18 | %89,12 |
| Gansu Consulting | %95,37 | %95,14 | %95,08 | %96,21 |
| East Money | %96,79 | %96,63 | %96,91 | %97,82 |
| BYD | %91,96 | %92,28 | %92,15 | %93,67 |
| Shanxi Coking | %71,13 | %68,28 | %72,79 | %75,06 |
TED-Net Table 3тө келтирилген 15 орточо саптын баарында эң жогорку маанини көрсөтөт.
Ошол эле учурда булак “prediction accuracy” көрсөткүчүнүн математикалык аныктамасын бербегендиктен, бул пайыздарды классикалык classification accuracy катары чечмелөө коопсуз эмес.
CATL экспериментинин маалымат топтому
CATL үчүн өзүнчө экспериментте:
- 8-июль 2025 – 13-март 2026,
- 39.604 даана бир мүнөттүк observation,
- %80 training,
- %20 validation
колдонулган.
Булак Figure 5те оптималдуу окутуу мөөнөтүн болжол менен 40 epoch деп белгилеп, loss болжол менен 0,00575 деңгээлинде туруктуу болгонун билдирет.
CATL жыйынтыктары
| Модель | RMSE | MAE | R² |
|---|---|---|---|
| LSTM | 3,4521 | 2,8910 | 0,92 |
| TCN | 3,2145 | 2,7234 | 0,93 |
| Transformer | 3,0876 | 2,6012 | 0,94 |
| TED-Net | 2,2292 | 2,0872 | 0,97 |
Бул таблица TED-Net булак экспериментинде эң төмөн RMSE жана MAE, ошондой эле эң жогорку R² маанисин бергенин көрсөтөт.
Булакта көрсөтүлгөн %42 RMSE төмөндөшүн кайра өндүрүүгө болобу?
Жыйынтык бөлүмүндө TED-Net baseline-га салыштырмалуу RMSEни %42,0 азайткан деп айтылат. Бирок CATL Table 4 маанилери колдонулганда:
- LSTM → TED-Net: болжол менен %35,4 азайуу,
- TCN → TED-Net: болжол менен %30,7 азайуу,
- Transformer → TED-Net: болжол менен %27,8 азайуу
алынат.
Булак %42 көрсөткүчүн кайсы башка эксперименттен же baseline-дан эсептегенин түшүндүрбөйт. Ошондуктан Verianla бул катышты тастыкталган CATL жыйынтыгы катары колдонбойт.
Бул изилдөө кирешелүү HFT стратегиясын көрсөтөбү?
Жок. Модель кийинки мүнөттүн баасын божомолдойт.
Изилдөөдө:
- сатып алуу/сатуу чечим эрежеси,
- позициянын өлчөмү,
- bid-ask spread,
- commission,
- slippage,
- queue position,
- network latency,
- ишке ашкан соода P&L-и,
- Sharpe ratio,
- maximum drawdown
боюнча trading backtest жүргүзүлбөйт.
Демек, төмөн RMSE же жогорку R² түздөн-түз экономикалык жактан кирешелүү соода стратегиясына барабар эмес.
Изилдөөнүн күчтүү жактары
- SAE, LSTM жана MSAны бир архитектурада так ролдор менен бириктириши.
- Ар түрдүү өкүлчүлүк түрлөрүн collaborative decoder аркылуу интеграциялашы.
- Он беш ар башка акцияда салыштыруу жүргүзүшү.
- SAE жана MSA үчүн ablation жыйынтыктарын бериши.
- CATL боюнча RMSE, MAE жана R² сыяктуу так регрессия метрикаларын отчеттошу.
- Transformer жана TCN сыяктуу күчтүү убакыт катар моделдерин benchmark катары колдонушу.
Негизги чектөөлөр
- Изилдөө азырынча рецензиядан өтө элек v1 preprint.
- Бир мүнөттүк маалымат классикалык микро-секунддук HFT аныктамасы менен бирдей эмес.
- “Million-level” маалымат жөнүндөгү доомат көрсөтүлгөн observation санына туура келбейт.
- Regression жана classification баалоо методологиялары аралашып кеткен.
- Table 3 accuracy метрикасынын аныктамасы берилген эмес.
- Ар башка эксперименттерде киргизүү өлчөмү 10 жана 8 болуп өзгөрөт.
- 30 жана 120 мүнөттүк эки sequence түзүлүшүнүн бирге колдонулушу жетиштүү түшүндүрүлгөн эмес.
- PCA жыйынтыгында берилген коэффициенттердин мааниси так эмес.
- RMSEнин %42 төмөндөшү CATL таблицасы менен түздөн-түз ырасталбайт.
- “1,5 yuan average error” деген сөз айкашы MAE 2,0872 менен дал келбейт.
- Trading profitability же execution backtest жок.
- Булак текстинде редакциялык placeholder-лар дагы эле бар.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: A Triple Encoder-Decoder Network with Multi-Head Self-Attention and Stacked Autoencoder for High-Frequency Trading Prediction
Авторлор: Zhuxi Zhang; Yan Zhang; Haolin Yuan; Min Zhu; Zihan Zhao.
Мекемелер: China Institute of Finance, University of International Business and Economics, Beijing; Digital Technology Research and Development Center, Beijing Research Institute of Ansteel Co., Ltd., Beijing.
Булактын түрү: Preprint / Article.
Платформа: Preprints.org.
Версия: Version 1.
Тапшырылган: 10-сентябрь 2026.
Жарыяланган: 14-сентябрь 2026.
DOI: 10.20944/preprints202609.0978.v1.
Рецензия статусу: Рецензиядан өтө элек. Булак жана Preprints.org жазуусу ачык түрдө “Not peer-reviewed” деген белгини камтыйт.
Лицензия: Creative Commons Attribution 4.0 International — CC BY 4.0.
Негизги ыкма: Stacked Autoencoder + LSTM-Seq2Seq + Multi-Head Self-Attention + Dynamic Window Attention + collaborative decoder.
Негизги тапшырма: Бир мүнөттүк финансылык маалыматтан кийинки мүнөттүн акция баасын регрессия аркылуу божомолдоо.
Негизги эксперимент: 15 A-share акциясы × 24.000 даана бир мүнөттүк байкоо; %80 training жана %20 validation.
CATL эксперимент топтому: 8-июль 2025–13-март 2026 аралыгында 39.604 даана бир мүнөттүк байкоо.
CATL негизги жыйынтыгы: TED-Net RMSE 2,2292; MAE 2,0872; R² 0,97.
Каржылоо: National Major Science and Technology Project of Intelligent Manufacturing Systems and Robots; grant 2025ZD1607900.
Маалыматка жеткиликтүүлүк: Авторлор маалыматты corresponding author-дан суроо боюнча алууга болорун билдиришет.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышы жок экенин билдиришет.
Draft-status эскертүүсү: Author Contributions бөлүмүндөгү редакциялык бекитүү жазуусу жана Reference 22деги жетишпеген автор placeholder-ы preprint версиясында калган.
Методологиялык эскертүү: Ablation бөлүмүндөгү classification метрикалары менен негизги regression тапшырмасынын ортосундагы өзгөртүү түшүндүрүлгөн эмес. Table 3 prediction-accuracy метрикасынын аныктамасы да берилген эмес.
HFT терминологиясы боюнча эскертүү: Изилдөө микро-секунддук execution же tick-level limit-order-book HFTни текшербейт; эксперименттер бир мүнөттүк убакыт катарларында жүргүзүлгөн.
Экономикалык чечмелөөнүн чеги: Божомол тактыгы же R², transaction cost жана execution жүрүм-турумун камтыган соода стратегиясынын жыйынтыктары жок болсо, түздөн-түз кирешелүүлүк көрсөткүчү болуп эсептелбейт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген