

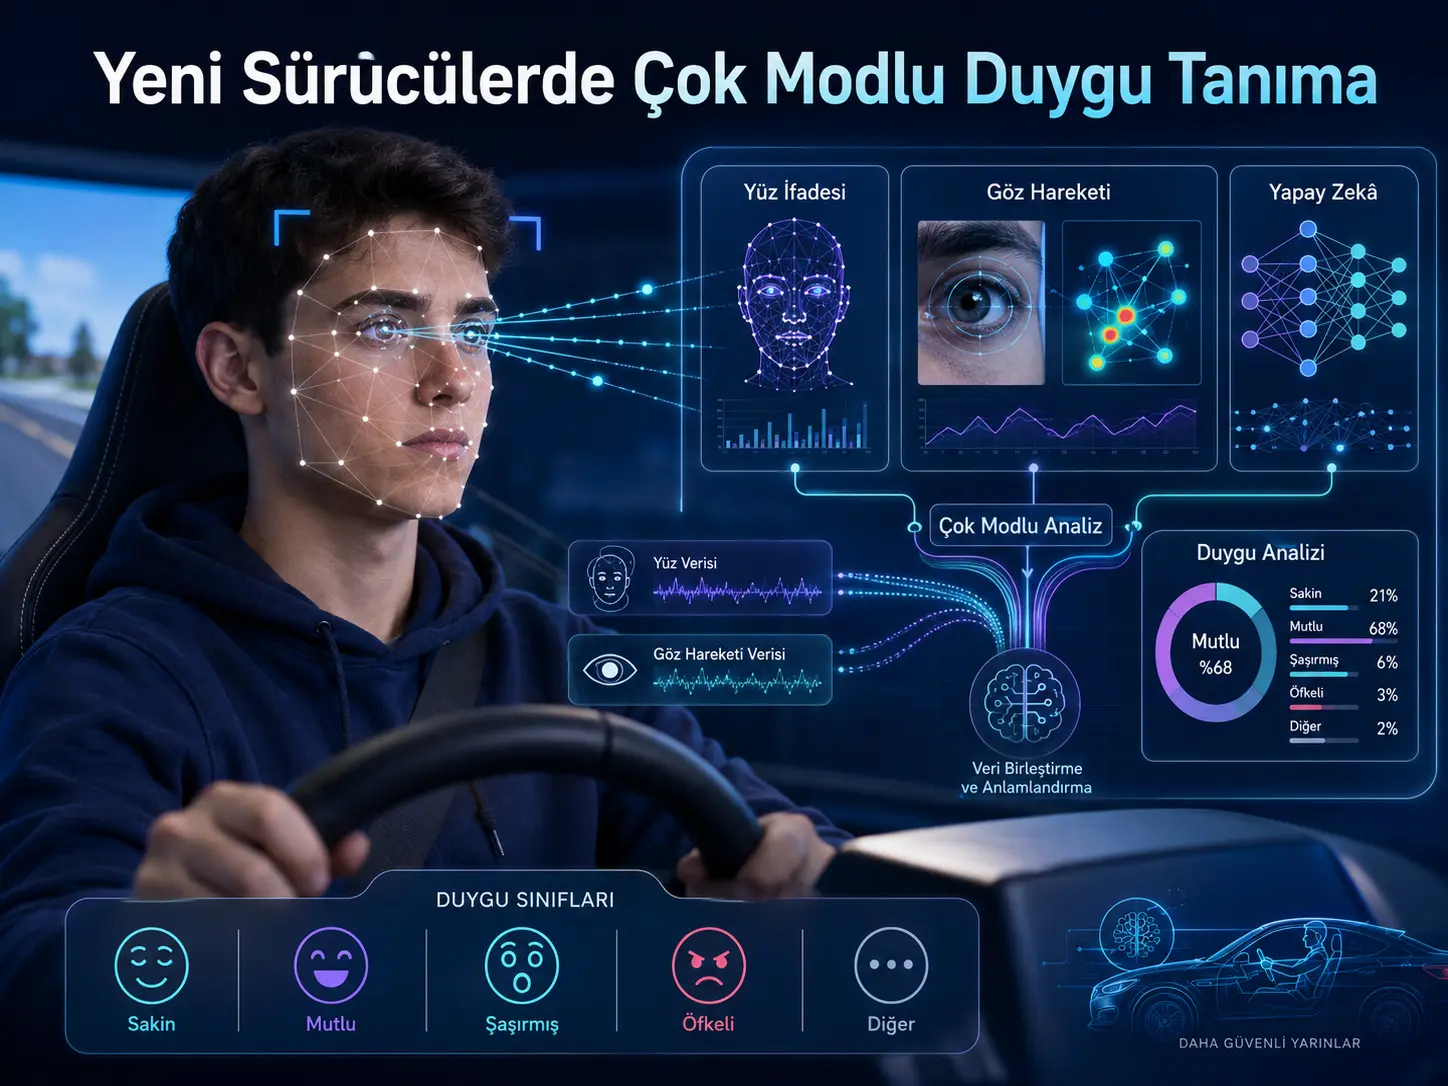
Ushbu tadqiqot haydash tajribasi cheklangan yangi haydovchilarning hissiy holatini faqat yuz ifodasi yoki faqat ko‘z harakatidan baholash o‘rniga, ikki axborot manbasini birgalikda qo‘llaydigan multimodal chuqur o‘rganish modelini ishlab chiqadi. Model yuz tasvirlarini ViT-B/16 orqali qayta ishlaydi, ko‘z kuzatuvi vaqt qatorlarini esa Bi-LSTM va Transformer encoder birikmasi bilan tahlil qiladi; so‘ngra ikki xususiyat guruhi Gated Weighted Fusion (GWF) deb ataluvchi o‘rganiladigan vaznlash mexanizmi orqali birlashtirilib, ko‘p qatlamli perceptronga uzatiladi. Chiqish sinflari besh toifadan iborat: xotirjam, xursand, hayratlangan, jahldor va boshqa.
Tadqiqotda avval 387 kishi qatnashgan so‘rovnoma yordamida 17 xil haydash yoki atrof-muhit tovushining qaysi hissiyotlar bilan bog‘liqligi o‘rganilgan. Keyin 18–25 yoshdagi yangi haydovchilar bilan laboratoriya sharoitida statik haydash tasvirlari va dinamik haydash videolari qo‘llanilgan; yuz tasvirlari hamda 100 Hz ko‘z kuzatuvi ma’lumotlari bir vaqtda yig‘ilgan. Dastlab 34 ishtirokchi jalb qilingan, tajriba samaradorligi %90 dan past bo‘lganlar chiqarib tashlangach, samarali namunaviy guruh 32 kishi deb bildirilgan.
Model uchun 30.000 ta ko‘z harakati namunasi va 30.000 ta yuz ifodasi namunasi ishlatilgan; besh hissiyot sinfining har biri uchun 6000 tadan namuna borligi ko‘rsatilgan. Ma’lumotlar ishtirokchi darajasida besh kichik to‘plamga ajratilgan va har aylanishda to‘rtta to‘plam o‘qitish, bittasi validatsiya uchun ishlatilib, subject-level besh karra cross-validation qo‘llangan. O‘qitish 30 epoch, batch size 32, boshlang‘ich learning rate 10−3, Adam optimizer va cross-entropy loss bilan bajarilgan.
Manbada bildirilgan asosiy natijaga ko‘ra, faqat yuz tasviri bilan aniqlik %71,18, faqat ko‘z harakati bilan %95,10 va ikki modalitet birga ishlatilgan GWF asosidagi modelda %98,72 bo‘lgan. Oddiy feature concatenation yondashuvi %95,45 accuracy bergan, GWF qo‘llanganda esa %98,72 natija bildirilgan. Biroq tadqiqotdagi multimodal confusion matrix bilan %98,72 natijasi o‘rtasida muhim sonli nomuvofiqlik mavjud; shu sababli asosiy muvaffaqiyat ko‘rsatkichi manba tomonidan bildirilgan natija sifatida o‘qilishi kerak, mustaqil ravishda qayta ishlab chiqarilgan aniqlik sifatida emas.
Model tadqiqotchilarning o‘z yangi-haydovchi ma’lumotlar to‘plamida emas, balki AFFEC, SEED-IV va AffectNet nomli uchta umumiy hissiyot ma’lumotlar to‘plamida ham baholangan. Taklif etilgan tuzilma ushbu ma’lumotlar to‘plamlarida mos ravishda %91,95, %90,44 va %89,67 accuracy ko‘rsatkichini bildirgan. Biroq tadqiqotning o‘zi ham bu uch ma’lumotlar to‘plami yangi haydovchilarga yoki haqiqiy haydashga xos emasligini ochiq aytadi. Ushbu testlar modelning umumiy feature extraction va fusion qobiliyatiga dalil beradi; ular haqiqiy tirbandlikda yangi haydovchining hissiyotini ayni aniqlik bilan tanishini ko‘rsatmaydi.
Turkiya nuqtayi nazaridan izoh: Tadqiqot Turkiyada o‘tkazilmagan va Turkiyadagi haydovchilikka nomzodlardan ma’lumot yig‘ilmagan. Yosh, madaniy fon, haydovchilik ta’limi, yo‘l harakati odatlari, yuz ifodasi xulqi va qo‘llangan hissiy stimullarning ta’siri jamiyatlar o‘rtasida farq qilishi mumkinligi sababli, bildirilgan aniqlik ko‘rsatkichlarini Turkiyadagi haydovchilikka nomzodlarga to‘g‘ridan-to‘g‘ri ko‘chirib bo‘lmaydi. Turkiyada qo‘llanadigan tizim mahalliy ishtirokchilar bilan, haqiqiy avtomobil sharoitida, turli yoritish va yo‘l muhitlarida hamda avtomobil ichki uskunasida alohida tasdiqlanishi kerak.
Tadqiqotning asosiy muammosi nima?
Tadqiqot haydash vaqtida hissiy holatni kuzatishda ikki asosiy cheklovni nishonga oladi. Birinchisi, avvalgi tadqiqotlarning katta qismi tajribali yoki umumiy haydovchi guruhlariga qaratilganidir. Tadqiqotchilar haydash tajribasi kam bo‘lgan shaxslar kognitiv yuklama va kutilmagan hodisalarga nisbatan turli hissiy reaksiyalar berishi mumkinligini ta’kidlaydi.
Ikkinchi muammo esa bitta ma’lumot modaliteti hissiyotni to‘liq ifodalashda qiynalishi mumkinligidir. Yuz ifodalari tashqaridan bevosita kuzatiladi, ammo past intensivlikdagi hissiyotlarda yaqqol bo‘lmasligi yoki shaxsning ongli xatti-harakatidan ta’sirlanishi mumkin. Ko‘z harakatlari esa diqqat taqsimoti, pupil xulqi, gaze va vaqt davomidagi o‘zgarishlarni aks ettirishi mumkin; biroq yolg‘iz o‘zi turli hissiyotlarni yetarlicha ajrata olmasligi mumkin.
Tadqiqotning yechimi yuz tasvirlarining fazoviy xususiyatlarini ko‘z harakatlarining vaqt xususiyatlari bilan birlashtirishdir.
Model qaysi to‘rtta asosiy qismdan iborat?
Yangi haydovchida multimodal hissiyotni aniqlash zanjiri
| Bosqich | Kirish / jarayon | Asosiy model | Manba |
|---|---|---|---|
| 1. Yuz tasviri | 224 × 224 × 3 yuz tasviri patch’larga ajratilib, global vizual xususiyat olinadi. | ViT-B/16 | 3.2-bo‘lim / 1-rasm |
| 2. Ko‘z harakati | 500 × 17 o‘lchamli vaqt qatorida oldinga va orqaga yo‘nalgan vaqt bog‘liqliklari qayta ishlanadi. | Bi-LSTM | 3.3-bo‘lim / 1-rasm |
| 3. Uzoq masofali bog‘liqlik | Ko‘z harakati ketma-ketligidagi uzoqroq vaqt nuqtalari orasidagi munosabatlar modellashtiriladi. | Transformer encoder | 3.3-bo‘lim |
| 4. Adaptiv fusion | Yuz va ko‘z harakati xususiyatlarining hissasi o‘rganiladigan gating orqali vaznlanadi. | GWF | 3.4-bo‘lim |
| 5. Klassifikatsiya | Birlashtirilgan xususiyatdan besh hissiyot sinfi ehtimollari hosil qilinadi. | MLP + Softmax | 3.5-bo‘lim |
Tadqiqotning 1-rasmi va usul bo‘limiga asoslangan tushuntiruvchi jarayon ko‘rinishidir. Manbada mavjud bo‘lmagan yangi model bosqichi qo‘shilmagan.
ViT-B/16 yuz tasvirini qanday qayta ishlaydi?
Modelning yuz tarmog‘iga 224 × 224 piksel o‘lchamdagi tasvirlar beriladi. ViT-B/16 tasvirni 16 × 16 piksel o‘lchamdagi patch’larga ajratadi. Patch soni:
\[ N= \frac{H}{P} \times \frac{W}{P} \]
formula bilan hisoblanadi. Tadqiqotda \(P=16\). 224 × 224 tasvir uchun bu tuzilma tasvirni kichik qismlarga ajratib, Transformer’ga tokenlar ketma-ketligi sifatida taqdim etadi.
Har bir patch chiziqli transformatsiya orqali 768 o‘lchamli feature space’ga o‘tkaziladi:
\[ z_i=W_{\mathrm{patch}}p_i+b_{\mathrm{patch}} \]
Patch’larning tasvirdagi joylashuvi yo‘qolmasligi uchun position embedding qo‘shiladi:
\[ z'_i=z_i+E_{\mathrm{pos},i} \]
Bundan tashqari, klassifikatsiya uchun maxsus classification token ketma-ketlik boshiga qo‘shiladi.
ViT’ning self-attention yadrosi:
\[ Attention(Q,K,V) = softmax\left( \frac{QK^T}{\sqrt{d_k}} \right)V \]
ko‘rinishida ta’riflangan. Shu tariqa model faqat qo‘shni piksel hududlarini emas, yuzning bir-biridan uzoq qismlari orasidagi munosabatlarni ham ifodalashni maqsad qiladi.
Usul matni oxirgi classification token chiqishini 768 o‘lchamli \(f_{\mathrm{image}}\) vektor sifatida belgilaydi.
Ko‘z harakati tarmog‘ida nega Bi-LSTM va Transformer birgalikda ishlatiladi?
Ko‘z harakati kirishi manbaning 1-rasmida 500 × 17 o‘lchamda ko‘rsatilgan. Ko‘z kuzatuvchi 100 Hz namuna olish tezligiga ega va ma’lumotlar 5 soniyalik oynalarga ajratilgan. Shu sababli 5 soniyalik oyna taxminan 500 vaqt nuqtasini o‘z ichiga olishi model kirish o‘lchami bilan mos keladi.
Bi-LSTM vazifasi ketma-ketlikni ham oldinga, ham orqaga yo‘nalishda qayta ishlab, vaqt ichidagi mahalliy va o‘tgan/kelajak kontekstini ifodalashdir. Har bir yo‘nalish uchun 128 hidden unit ishlatiladi va ikki yo‘nalish birlashtirilganda 256 o‘lchamli chiqish hosil bo‘ladi.
Keyin Transformer encoder self-attention yordamida ketma-ketlikdagi bir-biridan uzoqroq vaqt nuqtalari orasidagi bog‘liqliklarni modellashtiradi. Manbada Transformer qatlami uchun:
- 8 attention head,
- 256 model dimension,
- 512 feed-forward dimension,
- 0,1 dropout,
- 2 Transformer encoder qatlami
ko‘rsatilgan.
Gated Weighted Fusion nima qiladi?
Manbaga ko‘ra GWF’ning maqsadi ikki modalitetni shunchaki yonma-yon qo‘shish o‘rniga, joriy namunada qaysi xususiyat foydaliroq ekanini o‘rganiladigan tarzda aniqlashdir.
Ikki xususiyat:
\[ f_1,f_2\in R^{C\times1} \]
sifatida aniqlanadi va avval:
\[ f_{\mathrm{cat}}=[f_1;f_2] \]
ko‘rinishida birlashtiriladi. Keyin gating weight:
\[ g= \sigma(W_gf_{\mathrm{cat}}+b_g) \]
bilan hisoblanadi. \(g\) qiymatlari 0 va 1 oralig‘idadir.
Manbadagi yakuniy fusion tenglamasi:
\[ f_{\mathrm{fused}} = g\odot f_1 + (1-g)\odot f_2 \]
ko‘rinishida. Bu tuzilma bir modalitetning ayrim feature kanallarini kuchaytirib, boshqasini susaytirishi mumkin bo‘lgan o‘rganiladigan vaznlash mexanizmidir.
Arxitektura o‘lchami bo‘yicha izoh: Bu yerda manba ichida izohlanmagan o‘lcham farqi mavjud. ViT bo‘limi yuz xususiyatini 768 o‘lchamli deb ta’riflagan bo‘lsa, 1-rasm GWF’ga kiruvchi yuz tarmog‘ini 256×1 sifatida ko‘rsatadi. Bundan tashqari, yuqoridagi weighted-sum formulasi \(C\)-o‘lchamli chiqish hosil qilsa-da, 1-rasm GWF chiqishini 512×1 deb belgilaydi. Manba bu o‘tishlarning oraliq qatlamlarini tushuntirmaydi.
Klassifikator nima ishlab chiqaradi?
Fusion’dan chiqqan xususiyat MLP asosidagi classifier’ga uzatiladi. Oxirgi qatlamda Softmax yordamida besh toifa uchun ehtimollar hosil qilinadi:
\[ \hat{y}_k= \frac{\exp(z_k^{(L)})} {\sum_{i=1}^{C}\exp(z_i^{(L)})} \]
Sinf mosligi manbaning 1-rasmida:
| Sinf | Hissiyot |
|---|---|
| 0 | Xotirjam |
| 1 | Xursand |
| 2 | Hayratlangan |
| 3 | Jahldor |
| 4 | Boshqa |
Hissiy stimullar qanday tanlangan?
Tadqiqotchilar to‘g‘ridan-to‘g‘ri laboratoriya tajribasiga o‘tish o‘rniga, avval qaysi haydash va atrof-muhit tovushlari yangi haydovchilarda qaysi hissiyotlar bilan bog‘lanishini o‘rgangan. So‘rovnomada jami 387 kishi qatnashgan; shulardan 197 nafari erkak va 190 nafari ayol.
So‘rovnomada 17 tovush ishlatilgan. Ular orasida telefon qo‘ng‘irog‘i, yomg‘ir, tez yordam sirenasi, avtomobil to‘qnashuvi, janjal, qo‘rquv muhiti, tinchlantiruvchi musiqa, baland musiqa, it hurishi, avtomobil tezlashishi, tormoz ovozi, signal va shovqin kabi misollar bor.
Tovush bilan hissiyot toifasi o‘rtasidagi bog‘liqlik uchun chi-square testi qo‘llangan:
\[ \chi^2= \sum_{i,j} \frac{(O_{ij}-E_{ij})^2}{E_{ij}} \]
Manbada:
\(\chi^2=1310,791\), p<0,001
natijasi bildirilgan. Tadqiqotchilar tovush turlari bilan hissiyot taqsimotlari sezilarli darajada bog‘liq, degan xulosaga kelgan.
Correspondence analysis’da ikki o‘lchamning kumulyativ tushuntirish ulushi %80 dan oshgani ko‘rsatilgan. Tadqiqot talqiniga ko‘ra, uzluksiz signal, janjal va it hurishi anger hududiga; to‘satdan to‘qnashuvga o‘xshash tovushlar esa surprise hududiga yaqinroq guruhlangan.
Ushbu so‘rov natijalari keyingi haydash simulyatsiyasi uchun “sahna + tovush” stimulus kombinatsiyalarini tanlashda ishlatilgan. So‘rov natijasi haqiqiy haydashda obyektiv hissiy o‘zgarishning bevosita dalili emas; u tajriba stimulini tanlashning dastlabki bosqichidir.
Statik va dinamik haydash tajribalari qanday tashkil etilgan?
Statik bo‘limda 60 ta shahar haydash fotosurati ishlatilgan. Tasvirdan oldin haydash ssenariysiga oid prompt 3 soniya, keyin tasvir 10 soniya ko‘rsatilgan. Manevrlar orasida burilish, qatordan o‘tish, piyodadan qochish, tirbandlik va quvib o‘tish uchun tezlashish mavjud.
Har bir guruh 12 ta fotosuratdan iborat bo‘lgan va jami besh guruh tayyorlangan. Manba har bir guruh taxminan 2 daqiqa 35 soniya davom etganini, ammo umumiy statik tajriba taxminan 30 daqiqa bo‘lganini yozadi.
Vaqt nomuvofiqligi: Beshta 2 daqiqa 35 soniyalik guruh taxminan 12 daqiqa 55 soniyani tashkil etadi. 12 × (3+10 soniya) hisob-kitobi ham har guruh uchun taxminan 2 daqiqa 36 soniya beradi. Manbada 30 daqiqalik umumiy vaqtni tushuntiradigan qo‘shimcha kutish yoki tanaffus vaqti ko‘rsatilmagan.
Dinamik bo‘limda 60 ta shahar haydash videosi ishlatilgan. Videolar boshlang‘ich haydovchilik ta’limi videolaridan olingan bo‘lib, to‘g‘ri yo‘nalishda haydash, aylanma yo‘l va chorrahada kutish kabi xatti-harakatlarni o‘z ichiga olgan.
Har bir video ikki daqiqa davom etgan; 10 ta video bir guruh, jami oltita guruh tashkil etgan. Guruhlar orasida besh daqiqa tanaffus berilgan va har bir guruh oldidan to‘qqiz nuqtali eye-tracker kalibratsiyasi bajarilgan. Umumiy dinamik tajriba vaqti taxminan 2 soat 30 daqiqa deb ko‘rsatilgan.
Tajriba qurilmasida qanday uskunalar bor?
Laboratoriya qurilmasida simulyatsiya qilingan rul, debriyaj, tormoz, burilish signalini boshqarish, ko‘z kuzatuvchi, human-factor uskunasi, noutbuk, kamera va quloqchin mavjud.
Ko‘z harakati uchun aSee Pro F100 ishlatilgan va namuna olish tezligi 100 Hz deb ko‘rsatilgan. aSee Studio dasturi ishtirokchi ma’lumotlari, pupil ma’lumoti, gaze nuqtalari, saccade va blink kabi parametrlarni yig‘ishda qo‘llangan.
Manbaning 5-rasmida tajriba muhiti bevosita ko‘rsatiladi: haydash simulyatsiyasi tasviri monitorda namoyish etilayotganda kamera va aSee Pro ko‘z kuzatuv tizimi ishtirokchining qarshisida, rul simulyatori esa stol oldida joylashgan. Bu tuzilma haqiqiy avtomobil kabinasi emas, laboratoriya asosidagi haydash simulyatsiyasidir.
Ishtirokchilar kimlar edi?
Tajribaga 18–25 yoshdagi 34 kishi jalb qilingan va o‘rtacha yosh 22 deb bildirilgan. Ishtirokchilar haydovchilik guvohnomasini olish bosqichida bo‘lgan yoki bir yildan kam haydash tajribasiga ega shaxslardan tanlangan.
Tajriba samaradorligi %90 dan past bo‘lgan ishtirokchilar chiqarilgan va yakunda 32 kishilik samarali namuna qolgan.
Tadqiqotda ishtirokchilarning ko‘z kuzatuvi o‘lchoviga ta’sir qilishi mumkin bo‘lgan holatlar uchun ham mezonlar belgilangan. Manba kontakt linzalardan foydalanmaslikni va ko‘zoynak taqadiganlarda retsept “500 diopters” qiymatidan oshmasligini yozadi. Bu raqam manbada qanday berilgan bo‘lsa, shunday uzatiladi; ehtimoliy birlik yoki tarjima muammosi jim tarzda tuzatilmaydi.
Ishtirokchilar xabardor qilingan rozilik bergan va tadqiqot Baoji University of Arts and Sciences etika qo‘mitasi tomonidan tasdiqlangan.
Ko‘z harakati ma’lumotlari qanday tayyorlangan?
Manbada har bir ishtirokchining boshlang‘ich eye-movement ma’lumotlar to‘plamida 79.070 ta vaqt nuqtasi bo‘lgani ko‘rsatiladi. Ma’lumotlar 5 soniyalik vaqt oynalariga ajratilgan.
100 Hz namuna olish sababli 5 soniyalik oyna taxminan 500 vaqt nuqtasiga teng; model kirishining 500×17 deb belgilanishi ushbu tuzilma bilan mos keladi.
Manba matnida slicing jarayoni “79.070 rows’dan taxminan 500 rows’gacha” kamaytirgani haqida ham ifoda bor. Bu har 5 soniyalik oynaning taxminan 500 qatorni o‘z ichiga olishini anglatishi model kirishidan tushunilsa-da, umumiy ma’lumot miqdori nuqtayi nazaridan matn aniq emas.
Yuz tasvirlari qanday tayyorlangan?
Yuz videolari ErgoLAB facial-expression analysis dasturiga berilgan, facial feature nuqtalari va mos emotion label’lar olingan. So‘ng videolar frame-by-frame tasvir ketma-ketligiga aylantirilgan.
Tasvirlar 1920×1080 o‘lchamdan 224×224 pikselga qayta o‘lchamlangan va piksel qiymatlari [0,1] oralig‘iga normallashtirilgan.
Manbada dastur ishlab chiqargan emotion label’lardan so‘ng qo‘lda classification bajarilgani aytiladi. Biroq eye-movement oynalari bilan facial frame’larning yakuniy umumiy ground-truth yorlig‘ini sinxronlashtirish tafsilotlari usul bo‘limida cheklangan darajada tushuntirilgan.
Model qaysi ma’lumot bilan o‘qitilgan?
| Ma’lumot turi | Namuna soni |
|---|---|
| Ko‘z harakati namunalari | 30.000 |
| Yuz ifodasi namunalari | 30.000 |
| Har bir hissiyot toifasi | 6000 |
Namunalar subject bo‘yicha besh kichik to‘plamga ajratilgan. Har aylanishda to‘rtta kichik to‘plam o‘qitish, qolgan kichik to‘plam validation uchun ishlatilgan va barcha kichik to‘plamlar bir marta validation bo‘lgach jarayon yakunlangan.
O‘qitish parametrlari
| Parametr | Qiymat |
|---|---|
| Epoch | 30 |
| Batch size | 32 |
| Initial learning rate | 10−3 |
| Optimizer | Adam |
| Loss | Cross-entropy |
| Validation | Subject-level 5-fold cross-validation |
Faqat yuz, faqat ko‘z va multimodal natijalar qanday o‘zgaradi?
| Modalitet | Manbada bildirilgan accuracy |
|---|---|
| Yuz tasviri | %71,18 |
| Ko‘z harakati | %95,10 |
| Multimodal | %98,72 |
Manbaning o‘z talqiniga ko‘ra natijalarning eng muhim xabari shuki, bu tajriba guruhida ko‘z harakati ma’lumoti yuz ifodasiga qaraganda ancha ajratuvchi bo‘lgan va ikki modalitetning birlashtirilishi yuqoriroq bildirilgan aniqlikni ta’minlagan.
Bu natija yuz ifodasi umuman hissiyotni aniqlash uchun zaif degani emas. Natija faqat ushbu ma’lumotlar to‘plami, ushbu ishtirokchi guruhi, ushbu stimullar va ushbu model tuzilmasi uchun amal qiladi.
GWF oddiy concatenation’dan yaxshiroqmi?
| Fusion usuli | Accuracy (%) |
|---|---|
| Feature Concatenation | 95,45 |
| GWF Fusion | 98,72 |
Ikki qiymat orasidagi mutlaq farq 3,27 foiz punktidir. Manba bu natijani “accuracy’da %3,27 improvement” deb ifodalaydi.
Confusion matrix’lar nega muhim?
Faqat facial-image modelining 10-rasmdagi confusion matrix’ida asosiy diagonal yig‘indisi 3257, jami namuna soni 4576:
\[ Accuracy= \frac{3257}{4576} = 0,71176 \approx71,18\% \]
Bu qiymat 8-rasmda bildirilgan facial-image accuracy bilan to‘liq mos keladi.
Facial modelda Class 0, ya’ni calm toifasi ayniqsa Class 4 “other” va Class 3 “angry” bilan adashtirilgani ko‘rinadi. Manba buni xotirjam hissiyotdagi yuz o‘zgarishlarining nozikroq bo‘lishi bilan izohlaydi.
Biroq multimodal 11-rasm qayta hisoblanganda:
| O‘lchov | Qiymat |
|---|---|
| Jami confusion-matrix namunasi | 4576 |
| Asosiy diagonal / to‘g‘ri klassifikatsiya | 4304 |
| Matritsadan qayta hisoblangan accuracy | ≈ %94,06 |
| 8-rasm va 3-jadvalda bildirilgan multimodal accuracy | %98,72 |
Ilmiy hisobot ogohlantirishi: Manba 11-rasm boshqa fold, kichik to‘plam yoki tajriba qismiga tegishli ekanini aytmaydi. Shunga qaramay, confusion matrix’dan qayta olingan %94,06 bilan asosiy jadvaldagi %98,72 mos kelmaydi. Verianla bu ikki natijadan qaysi biri to‘g‘ri ekanini tanlamaydi; nomuvofiqlikni ochiq saqlaydi.
Eye-movement modelida Bi-LSTM va Transformer hissasi qanday?
Faqat ko‘z harakati ma’lumoti bilan bajarilgan ablatsiyada:
| Model | Accuracy (%) |
|---|---|
| Bi-LSTM | 87,50 |
| Transformer | 94,23 |
| Bi-LSTM + Transformer | 95,10 |
Multimodal tajribada esa eye branch tarkibiy qismlarining ta’siri:
| Eye branch | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Manba bu natijalarni Bi-LSTM vaqt ichidagi yo‘nalishli bog‘liqliklarni, Transformer esa uzoqroq masofadagi munosabatlarni ifodalashi bir-birini to‘ldiradi, deb talqin qiladi.
Uchta umumiy ma’lumotlar to‘plamidagi natijalar nimani ko‘rsatadi?
Tadqiqotchilar model faqat o‘z tajriba ma’lumotlaridagi muvaffaqiyatga bog‘lanib qolmasligi uchun AFFEC, SEED-IV va AffectNet’da qo‘shimcha taqqoslashlar qilgan.
| Ma’lumotlar to‘plami | Modalitet | Taklif etilgan model Accuracy | Macro-F1 |
|---|---|---|---|
| AFFEC | Ko‘z + yuz | 91,95 ± 0,87% | 91,36 ± 0,92% |
| SEED-IV | Faqat ko‘z harakati | 90,44 ± 0,75% | 89,81 ± 0,80% |
| AffectNet | Faqat yuz | 89,67 ± 0,69% | 89,02 ± 0,73% |
Manba taklif etilgan model barcha uch ma’lumotlar to‘plamidagi baseline’larga nisbatan p<0,05 darajasida statistik jihatdan sezilarli ustunlik ko‘rsatganini bildiradi.
Biroq ushbu bo‘limning talqin chegarasi ayniqsa muhim: AFFEC, SEED-IV va AffectNet yangi haydovchilar uchun yaratilgan haydash ma’lumotlar to‘plami emas. Tadqiqot buni ochiq ta’kidlaydi. Ushbu natijalar model arxitekturasining umumiy hissiyotni aniqlash qobiliyatini qo‘llab-quvvatlaydi; haqiqiy haydash sharoitidagi ishlashini tasdiqlamaydi.
Boshqa hissiyotni aniqlash usullari bilan qanday taqqoslangan?
| Signallar | Usul | Manbada berilgan accuracy |
|---|---|---|
| Ko‘z + tovush + tasvir | FE-CNN | 81,90% |
| Ko‘z + PPG | FECNN + LSTM | 84,68% |
| Yuz + rPPG + ko‘z | Dual-path Transformer | 86,98% |
| EEG + ko‘z | MFFNN | 87,32% |
| EEG | LSTM | 90,72% |
| EEG + ECG + ko‘z | 1D-Inception + Self-Attention + LSTM | 91,38% |
| EEG | CNN-LSTM | 93,97% |
| EEG + yuz + fiziologik signallar | GNN | 91,25% |
| Ko‘z + yuz | Ushbu tadqiqot | 98,72% |
Bu jadval turli tadqiqotlarning turli ma’lumotlar to‘plami, sinf soni, namunasi va tajriba protokollarini o‘z ichiga olgani sababli bevosita musobaqa jadvali sifatida o‘qilmasligi kerak. Manba bu qiymatlarni adabiyotlar taqqoslovi sifatida taqdim etadi; ular bir xil benchmark’da boshma-bosh nazoratli tajriba emas.
Model real vaqt rejimida ishlaydimi?
Manba multimodal model uchun batch boshiga o‘rtacha processing time qiymatini:
29,42 ± 0,08 ms
deb beradi.
Hybrid inference rejimida har namuna uchun:
0,9230 ± 0,0014 ms
bildirilgan.
Tadqiqotchilar bu qiymatni avtomobil ichidagi inson–mashina o‘zaro ta’siri uchun qo‘llagan 100–200 ms referens kechikishdan past bo‘lgani uchun real vaqt nuqtayi nazaridan yetarli, deb talqin qiladi.
Biroq bu vaqt haqiqiy avtomobilda, ishlab chiqarish tipidagi embedded ECU’da yoki avtomobil ichidagi kamera/eye-tracker pipeline’ining to‘liq zanjirida o‘lchangan end-to-end latency emas. Tadqiqot haqiqiy haydash muhitida deployment bajarilmaganini ochiq aytadi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- Yuz tasviri va eye-tracking ma’lumotini birga ishlatadigan gibrid hissiyotni aniqlash arxitekturasi amalga oshirilgan.
- ViT-B/16, Bi-LSTM, Transformer encoder, GWF va MLP bitta multimodal pipeline’da qo‘llangan.
- Manbaning asosiy jadvallarida multimodal model uchun %98,72 accuracy bildirilgan.
- Manba modalitet ablatsiyasida eye-movement ma’lumoti facial-image ma’lumotidan yuqoriroq accuracy berganini ko‘rsatadi.
- GWF manbada oddiy feature concatenation’dan yuqoriroq accuracy bilan bildirilgan.
- Bi-LSTM + Transformer eye branch’i faqat Bi-LSTM yoki faqat Transformer ishlatilgan ablatsiyalardan yuqori natija ko‘rsatgan.
- Model AFFEC, SEED-IV va AffectNet umumiy hissiyot ma’lumotlar to‘plamlarida taqqoslangan baseline’lardan yuqori natija bilan bildirilgan.
- Model inference vaqti laboratoriya hisoblash muhitida millisekund darajasida o‘lchangan.
Tadqiqot qo‘llab-quvvatlamaydigan, sinamagan yoki isbotlamagan natijalar
- Model haqiqiy tirbandlikda yoki haqiqiy avtomobil haydashida sinovdan o‘tkazilmagan.
- %98,72 accuracy’ni Turkiyadagi yoki boshqa yosh guruhidagi yangi haydovchilarga ko‘chirish mumkinligi ko‘rsatilmagan.
- Hissiyotni aniqlash yo‘l-transport hodisalarini amalda kamaytirishi ushbu tadqiqotda eksperimental tarzda o‘lchanmagan.
- Model avtomobil ichki kamerasi, quyosh nuri, tungi haydash, yuzning berkilishi, kuchli bosh harakati va haqiqiy yo‘l tebranishida tasdiqlanmagan.
- Haqiqiy embedded avtomobil platformasida energiya sarfi, RAM, model hajmi va end-to-end latency o‘lchovi keltirilmagan.
- Uchta tashqi ma’lumotlar to‘plamidagi muvaffaqiyat yangi haydovchiga xos haqiqiy haydash validatsiyasi emas.
- Tadqiqotning confusion matrix’i asosiy bildirilgan %98,72 aniqlik qiymatini mustaqil ravishda tasdiqlamaydi.
- Model hissiyot sinflari shaxsning haqiqiy psixologik holatini klinik yoki mutlaq o‘lchash sifatida talqin qilinmaydi.
Tadqiqotning usuli va natijalari
Tadqiqot dizaynining asosiy tarkibiy qismlari
| Tarkibiy qism | Manbada berilgan ma’lumot |
|---|---|
| So‘rovnoma namunasi | 387 kishi |
| So‘rovnoma erkak/ayol | 197 / 190 |
| Tovush stimuli | 17 tur |
| Dastlabki tajriba ishtirokchisi | 34 |
| Samarali ishtirokchi | 32 |
| Yosh | 18–25; o‘rtacha 22 |
| Haydash tajribasi | Guvohnoma nomzodi yoki <1 yil tajriba |
| Eye tracker | aSee Pro F100 |
| Eye-tracking sampling rate | 100 Hz |
| Eye window | 5 s / taxminan 500 vaqt nuqtasi |
| Eye model kirishi | 500 × 17 |
| Facial-image kirishi | 224 × 224 × 3 |
| Hissiyot sinfi | 5 |
Model arxitekturasining asosiy parametrlari
| Modul | Asosiy tuzilma |
|---|---|
| Yuz feature extraction | ViT-B/16; 16×16 patch; 768-o‘lcham classification token |
| Bi-LSTM | 128 hidden unit/yo‘nalish; birlashtirilgan 256-o‘lcham chiqish |
| Transformer encoder | 8 head, d-model 256, FFN 512, dropout 0,1, 2 qatlam |
| Fusion | Gated Weighted Fusion |
| Classifier | MLP + Softmax |
Asosiy multimodal tajriba natijasi
| Eye feature modeli | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Confusion matrix sifat nazorati
| Manba natijasi | Bildirilgan / qayta hisoblangan | Holat |
|---|---|---|
| Facial-image accuracy | 8-rasm: %71,18 / 10-rasm matritsasidan: %71,18 | Mos |
| Multimodal accuracy | 8-rasm va 3-jadval: %98,72 / 11-rasm matritsasidan: ≈%94,06 | Nomuvofiq |
Bu nazorat Verianla tomonidan manbaning 10-rasm va 11-rasm kataklari asosida qayta hisoblangan. U manba o‘rniga yangi tajriba natijasi ishlab chiqarmaydi; faqat e’lon qilingan kataklarning arifmetik izchilligini tekshiradi.
Umumiy ma’lumotlar to‘plamlaridagi natijalar
| Dataset | Taklif etilgan model Accuracy ± Std | Macro-F1 ± Std | Manbaning statistik izohi |
|---|---|---|---|
| AFFEC | 91,95 ± 0,87% | 91,36 ± 0,92% | p<0,05 vs. barcha baseline’lar |
| SEED-IV | 90,44 ± 0,75% | 89,81 ± 0,80% | p<0,05 vs. barcha baseline’lar |
| AffectNet | 89,67 ± 0,69% | 89,02 ± 0,73% | p<0,05 vs. barcha baseline’lar |
Real vaqt natijasi
| O‘lchov | Qiymat |
|---|---|
| Batch boshiga processing time | 29,42 ± 0,08 ms |
| Hybrid inference mode, har namuna uchun | 0,9230 ± 0,0014 ms |
Ushbu ishlash qiymatlari model hisoblashiga tegishli. U haqiqiy avtomobildagi kamera acquisition, eye-tracking acquisition, preprocessing, operatsion tizim kechikishi, sensor sinxronizatsiyasi va ogohlantirish hosil qilishning barchasini qamrab oladigan haqiqiy end-to-end avtomobil ichki kechikish o‘lchovi emas.
Tadqiqotning asosiy cheklovlari
- Samarali haydovchi namunasi atigi 32 kishidan iborat.
- Ishtirokchilar faqat 18–25 yosh guruhida.
- Madaniy xilma-xillik cheklangan.
- Hissiyotlar laboratoriyada vizual va audio stimulus yordamida hosil qilingan.
- Kutilmagan haqiqiy yo‘l hodisalari sinovdan o‘tkazilmagan.
- Haqiqiy avtomobil haydashidan foydalanilmagan.
- Tabiiy avtomobil ichki yorug‘lik o‘zgarishi, head movement va facial occlusion keng qamrovda tasdiqlanmagan.
- Haqiqiy embedded deployment bajarilmagan.
- Multimodal confusion matrix bilan asosiy accuracy natijasi o‘rtasida izohlanmagan sonli nomuvofiqlik mavjud.
- GWF feature o‘lchamlari usul tenglamalari bilan arxitektura chizmasi o‘rtasida to‘liq izohlanmagan.
Manba va usul haqida izoh
To‘liq asl tadqiqot nomi: Hybrid Deep Neural Network-Based Modeling of Multimodal Emotion Recognition for Novice Drivers
Mualliflar va tartibi: Jianzhuo Li; Ye Yu; Zhao Dai; Panyu Dai.
Mas’ul muallif: Jianzhuo Li.
Hammualliflikdagi birinchi muallif/teng hissa: Manbada ko‘rsatilmagan.
Muassasa: School of Computer Science, Baoji University of Arts and Sciences, Baoji 721016, China.
Jurnal: Future Internet
Nashriyot: MDPI, Basel, Switzerland
Jild / son / maqola: 18 / 4 / 221
Qabul qilingan sana: 27 Fevral 2026
Reviziya sanasi: 17 Aprel 2026
Qabul qilingan sana: 18 Aprel 2026
Nashr sanasi: 21 Aprel 2026
DOI: 10.3390/fi18040221
Rasmiy nashr havolasi:https://doi.org/10.3390/fi18040221
Manba turi: Taqrizdan o‘tgan tadqiqot maqolasi; laboratoriya asosidagi simulyatsiyalangan haydash tajribasi, eye-tracking/facial-image ma’lumotlarini tahlil qilish va chuqur o‘rganish modellashtirish tadqiqoti.
Taqriz holati: Taqrizdan o‘tgan ilmiy jurnalda e’lon qilingan tadqiqot.
Litsenziya: Creative Commons Attribution (CC BY).
Versiya: Ko‘rib chiqilgan fayl v2 deb nomlangan. Nashriyot versiyasi haqidagi izoh ushbu tadqiqot uchun yangilangan version of record mavjudligini ko‘rsatadi. Yangilanish doirasi ko‘rib chiqilgan maqolaning ilmiy mazmunidan tashqariga chiqib taxmin qilinmagan.
Etik tasdiq: Tadqiqot Helsinki deklaratsiyasiga muvofiq olib borilgani bildiriladi va Baoji University of Arts and Sciences Institutional Review Board tasdiq raqami BJWL-2025-ETH-048, tasdiq sanasi 7 Yanvar 2025 deb beriladi.
Xabardor qilingan rozilik: Manba barcha ishtirokchilar tadqiqot maqsadi va protsedurasi haqida xabardor qilingani va ilmiy tadqiqot uchun ma’lumotlardan foydalanishga rozilik bildirgan informed-consent form’ni imzolaganini bildiradi.
Moliyalashtirish: Tadqiqot tashqi moliyalashtirish olmagan.
Ma’lumotlarga kirish: Ishlatilgan ma’lumotlar to‘plamlarini oqilona so‘rov asosida mas’ul muallifdan olish mumkinligi ko‘rsatilgan.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvi yo‘qligini bildirgan.
Muallif hissalari: Manba bayonotiga ko‘ra konsepsiya Ye Yu; metodologiya Ye Yu, Zhao Dai va Panyu Dai; dasturiy ta’minot Ye Yu va Panyu Dai; validatsiya, formal tahlil, tadqiqot va ma’lumotlarni kuratsiya qilish Ye Yu; dastlabki qo‘lyozma Ye Yu; ko‘rib chiqish/tahrirlash Jianzhuo Li; vizualizatsiya Ye Yu; nazorat va loyiha boshqaruvi Jianzhuo Li tomonidan bajarilgan.
Manba ichidagi sonli nomuvofiqlik 1 — confusion matrix: Facial-image confusion matrix kataklaridan qayta hisoblangan accuracy %71,18 bo‘lib, 8-rasm bilan mos keladi. Multimodal confusion matrix’da esa 4576 namunadan 4304 tasi asosiy diagonalda va qayta hisoblangan accuracy taxminan %94,06. Bu qiymat 8-rasm va 3-jadvaldagi %98,72 bilan mos kelmaydi. Manba boshqa baholash to‘plami yoki fold’ni tushuntirmaydi.
Manba ichidagi arxitektura nomuvofiqligi 2 — feature o‘lchamlari: ViT usuli classification-token chiqishini 768 o‘lchamli deb ta’riflasa, 1-rasm yuz tarmog‘ining GWF kirishini 256×1 qilib ko‘rsatadi. GWF tenglama (19) C-o‘lchamli ikki kirishdan C-o‘lchamli weighted-sum hosil qilsa, 1-rasm chiqishni 512×1 deb ko‘rsatadi. Oraliq transformatsiya aniq ta’riflanmagan.
Manba ichidagi vaqt nomuvofiqligi 3: Statik haydash tajribasining besh guruhi har biri taxminan 2 daqiqa 35 soniya deb ta’riflangan; bu taxminan 12 daqiqa 55 soniya. 12 tasvir × 13 soniyalik stimulus tuzilmasi ham taxminan shu vaqtni beradi. Shunga qaramay, manba umumiy statik tajriba vaqtini taxminan 30 daqiqa deb bildiradi va farq sababi tushuntirilmagan.
Manba ichidagi birlik izohi 4: Ishtirokchi tanlash mezonida ko‘zoynak retsepti uchun manbada “500 diopters” iborasi mavjud. Ehtimoliy birlik/tarjima xatosi tashqi manbadan taxmin qilinib tuzatilmagan.
GWF ishlash ifodasi: Manba feature concatenation uchun %95,45 va GWF uchun %98,72 accuracy bildirib, o‘sishni %3,27 deb ataydi. Ikki bildirilgan accuracy o‘rtasidagi mutlaq farq 3,27 foiz punktidir.
Ground-truth/yorliqlash izohi: Facial expression videolari ErgoLAB dasturi bilan tahlil qilinib emotion label yaratilgan va keyin qo‘lda klassifikatsiya qilingan. Eye-movement namunalari besh toifa bilan yorliqlangani aytiladi, biroq ikki modalitetning yakuniy umumiy ground-truth yorlig‘ini yaratish va sinxronlashtirish protsedurasi manbada batafsil tushuntirilmagan.
Umumlashtirish chegarasi: AFFEC, SEED-IV va AffectNet’dagi validatsiyalar umumiy hissiyotni aniqlash vazifalaridir. Manba ayniqsa ushbu ma’lumotlar to‘plami novice-driver yoki driving-specific emasligini ta’kidlaydi. Shu sababli bu natijalar haqiqiy haydash sharoitlariga to‘g‘ridan-to‘g‘ri validatsiya sifatida ishlatilmagan.
Real vaqt chegarasi: 29,42 ms/batch va 0,9230 ms/sample qiymatlari model processing o‘lchovlaridir. Tadqiqotda haqiqiy avtomobil ichidagi embedded system deployment yoki haqiqiy haydash sharoitlaridagi end-to-end latency o‘lchovi bajarilmagan.
Ushbu Verianla izohidagi usul, ma’lumotlar to‘plami, tenglamalar, klassifikatsiya natijalari, jadvallar, rasm talqinlari va cheklovlar ko‘rib chiqilgan ilmiy tadqiqotga asoslanadi. Bibliografik tashqi tekshiruv faqat DOI, jurnal, nashriyot, taqriz holati va nashr versiyasi kabi manba identifikatsiyasi elementlarini tasdiqlash uchun ishlatilgan; tashqi manbalardan yangi hissiyotni aniqlash natijasi yoki yangi ishlash qiymati qo‘shilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan