

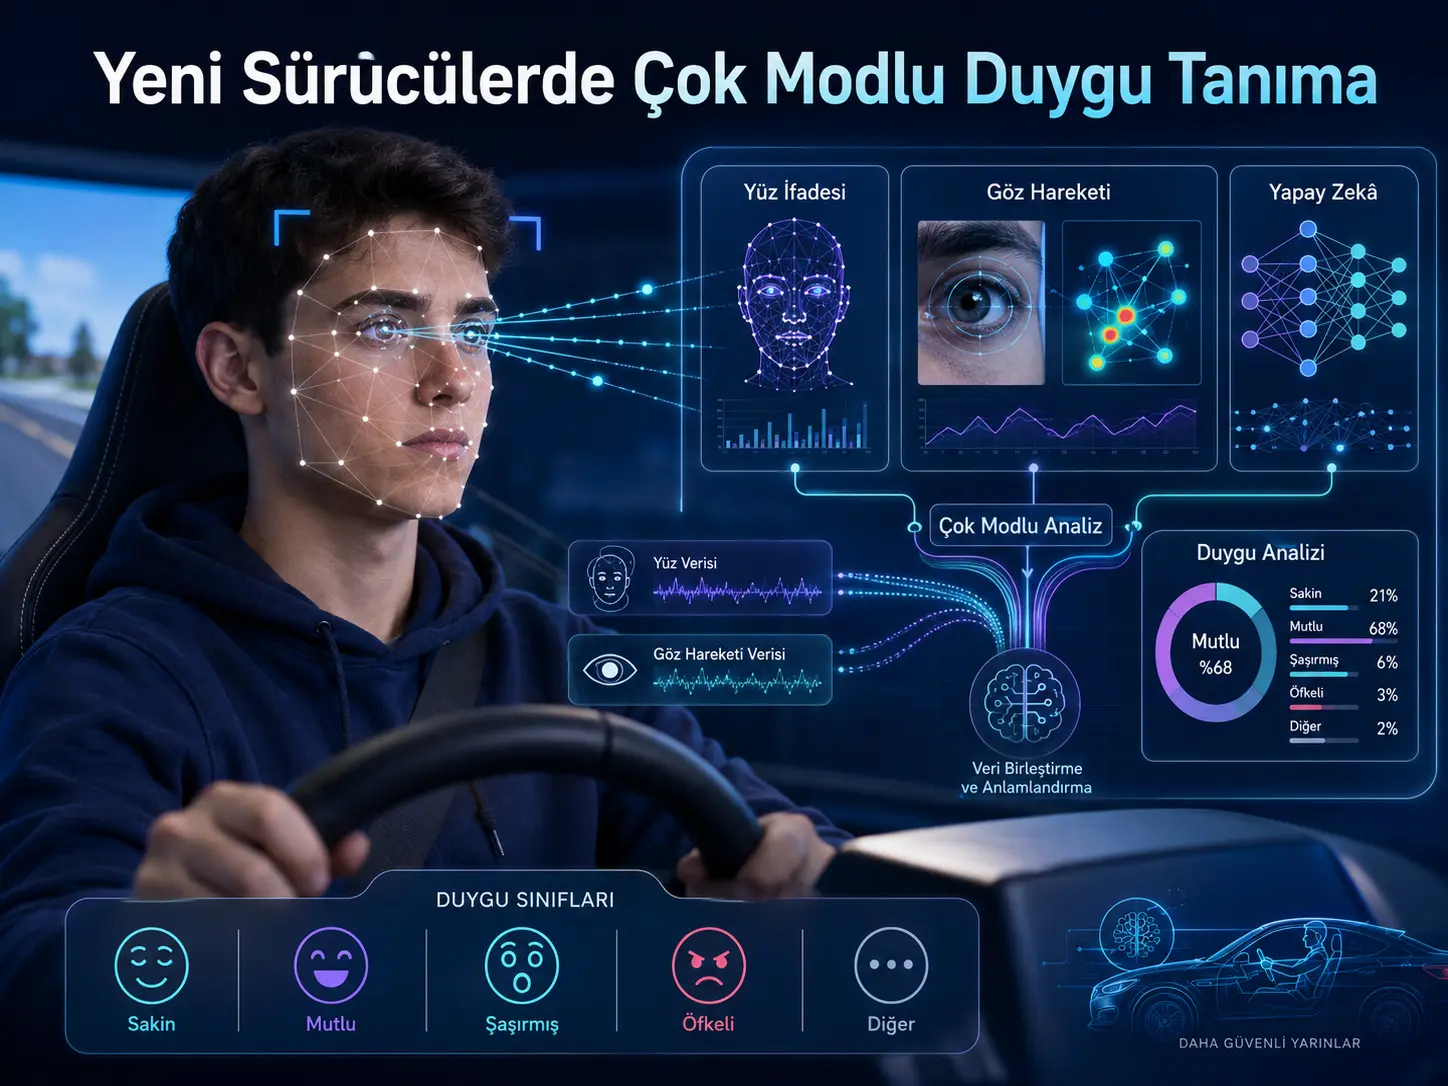
Bu tədqiqat sürücülük təcrübəsi məhdud olan yeni sürücülərin emosional vəziyyətini yalnız üz ifadəsindən və ya yalnız göz hərəkətindən təxmin etmək əvəzinə iki informasiya mənbəyini birlikdə istifadə edən çoxmodallı dərin öyrənmə modeli hazırlayır. Model üz görüntülərini ViT-B/16 ilə işləyərkən göz izləmə zaman sıralarını Bi-LSTM və Transformer encoder birləşməsi ilə təhlil edir; iki xüsusiyyət qrupu daha sonra Gated Weighted Fusion (GWF) adlı öyrənilə bilən çəkiləndirmə mexanizmi ilə birləşdirilərək çoxqatlı perseptrona ötürülür. Çıxış sinifləri sakit, xoşbəxt, təəccüblənmiş, qəzəbli və digər olmaqla beş kateqoriyadır.
Tədqiqatda əvvəlcə 387 nəfərin iştirak etdiyi sorğu ilə 17 fərqli sürücülük və ya ətraf mühit səsinin hansı emosiyalarla əlaqəli olduğu araşdırılmışdır. Daha sonra 18–25 yaş aralığındakı yeni sürücülərlə laboratoriya şəraitində statik sürücülük görüntüləri və dinamik sürücülük videoları istifadə edilmiş; üz görüntüləri və 100 Hz göz izləmə məlumatları eyni vaxtda toplanmışdır. Başlanğıcda 34 iştirakçı cəlb edilmiş, eksperiment səmərəliliyi %90'ın altında qalan iştirakçılar çıxarıldıqdan sonra effektiv nümunə 32 nəfər olaraq bildirilmişdir.
Model üçün 30.000 göz hərəkəti nümunəsi və 30.000 üz ifadəsi nümunəsi istifadə edilmiş; beş emosiya sinfinin hər biri üçün 6000 nümunə olduğu göstərilmişdir. Məlumatlar iştirakçı əsasında beş alt çoxluğa bölünmüş və hər dövrdə dörd çoxluq təlim, bir çoxluq doğrulama üçün istifadə edilərək subject-level beşqat çarpaz doğrulama tətbiq edilmişdir. Təlim 30 epoch, batch size 32, başlanğıc learning rate 10−3, Adam optimizer və cross-entropy loss ilə həyata keçirilmişdir.
Mənbənin əsas bildirilən nəticəsinə görə yalnız üz görüntüsü ilə dəqiqlik %71,18, yalnız göz hərəkəti ilə %95,10 və iki modalitenin birlikdə istifadə edildiyi GWF əsaslı modeldə %98,72'dir. Sadə feature concatenation yanaşması %95,45 accuracy verdiyi halda GWF istifadəsi %98,72 olaraq bildirilmişdir. Bununla belə tədqiqatın multimodal confusion matrix'i ilə %98,72 nəticəsi arasında mühüm sayısal uyğunsuzluq vardır və buna görə əsas uğur göstəricisi mənbə tərəfindən bildirilmiş nəticə kimi oxunmalıdır; müstəqil şəkildə yenidən istehsal edilmiş dəqiqlik deyil.
Model yalnız tədqiqatçıların öz yeni-sürücü məlumat dəstində deyil, AFFEC, SEED-IV və AffectNet adlı üç ümumi emosiya məlumat dəstində də qiymətləndirilmişdir. Təklif olunan quruluş bu məlumat dəstlərində müvafiq olaraq %91,95, %90,44 və %89,67 accuracy bildirmişdir. Lakin tədqiqatın özü də bu üç məlumat dəstinin yeni sürücülərə və ya real sürücülüyə xas olmadığını açıq şəkildə bildirir. Bu testlər modelin ümumi feature extraction və fusion qabiliyyətinə dair dəstək verir; real nəqliyyatda yeni sürücünün emosiyasını eyni dəqiqliklə tanıdığını göstərmir.
Türkiyə baxımından şərh: Tədqiqat Türkiyədə həyata keçirilməmiş və Türkiyədəki sürücü namizədlərindən məlumat toplamamışdır. Yaş, mədəni fon, sürücülük təhsili, nəqliyyat vərdişləri, üz ifadəsi davranışı və istifadə olunan emosional stimulların təsiri cəmiyyətlər arasında dəyişə bildiyi üçün bildirilən dəqiqlik nisbətləri Türkiyədəki sürücü namizədlərinə birbaşa köçürülə bilməz. Türkiyədə tətbiq olunacaq sistem yerli iştirakçılarla, real avtomobil şəraitində, fərqli işıqlandırma və yol mühitlərində və avtomobildaxili avadanlıq üzərində ayrıca doğrulanmalıdır.
Tədqiqatın əsas problemi nədir?
Tədqiqat sürücülük zamanı emosional vəziyyətin izlənməsində iki əsas məhdudiyyəti hədəfləyir. Birincisi, əvvəlki tədqiqatların mühüm hissəsinin təcrübəli və ya ümumi sürücü qruplarına fokuslanmasıdır. Tədqiqatçılar sürücülük təcrübəsi az olan şəxslərin koqnitiv yük və gözlənilməz hadisələr qarşısında fərqli emosional reaksiyalar verə biləcəyini irəli sürürlər.
İkinci problem isə tək bir məlumat modalitesinin emosiyanı tam təmsil etməkdə çətinlik çəkə bilməsidir. Üz ifadələri xaricdən birbaşa müşahidə oluna bilər, lakin aşağı intensivlikli emosiyalarda aydın görünməyə bilər və ya şəxsin şüurlu davranışından təsirlənə bilər. Göz hərəkətləri isə diqqətin paylanmasını, pupil davranışını, gaze və zaman içində dəyişiklikləri əks etdirə bilər; lakin təkbaşına fərqli emosiyalar arasında kifayət qədər ayırdedici olmaya bilər.
Tədqiqatın həlli üz görüntülərinin məkan xüsusiyyətlərini göz hərəkətlərinin zaman xüsusiyyətləri ilə birləşdirməkdir.
Model hansı dörd əsas hissədən ibarətdir?
Yeni sürücüdə çoxmodallı emosiya tanıma zənciri
| Mərhələ | Giriş / əməliyyat | Əsas model | Mənbə |
|---|---|---|---|
| 1. Üz görüntüsü | 224 × 224 × 3 üz görüntüsü patch'lərə bölünərək qlobal vizual xüsusiyyət çıxarılır. | ViT-B/16 | Bölmə 3.2 / Şəkil 1 |
| 2. Göz hərəkəti | 500 × 17 ölçülü zaman sıralarında irəli və geri zaman asılılıqları işlənir. | Bi-LSTM | Bölmə 3.3 / Şəkil 1 |
| 3. Uzaq məsafəli əlaqə | Göz hərəkəti ardıcıllığının daha uzaq zaman nöqtələri arasındakı əlaqələr modelləşdirilir. | Transformer encoder | Bölmə 3.3 |
| 4. Adaptiv füzyon | Üz və göz hərəkəti xüsusiyyətlərinin töhfəsi öyrənilə bilən gating ilə çəkiləndirilir. | GWF | Bölmə 3.4 |
| 5. Təsnifat | Birləşdirilmiş xüsusiyyətdən beş emosiya sinfinin ehtimalları yaradılır. | MLP + Softmax | Bölmə 3.5 |
Tədqiqatın Şəkil 1 və metod bölməsinə əsaslanaraq hazırlanmış izahlı proses təqdimatıdır. Mənbədə olmayan yeni model mərhələsi əlavə edilməmişdir.
ViT-B/16 üz görüntüsünü necə işləyir?
Modelin üz qoluna 224 × 224 piksel ölçülü görüntülər verilir. ViT-B/16 görüntünü 16 × 16 piksel ölçülü patch'lərə bölür. Patch sayı:
\[ N= \frac{H}{P} \times \frac{W}{P} \]
ilə hesablanır. Tədqiqatda \(P=16\)'dır. 224 × 224 görüntü üçün bu quruluş görüntünün kiçik hissələrə bölünüb Transformer'a token ardıcıllığı kimi təqdim olunmasını təmin edir.
Hər patch xətti çevirmə ilə 768 ölçülü feature space'ə ötürülür:
\[ z_i=W_{\mathrm{patch}}p_i+b_{\mathrm{patch}} \]
Patch'lərin görüntüdəki mövqelərinin itirilməməsi üçün position embedding əlavə olunur:
\[ z'_i=z_i+E_{\mathrm{pos},i} \]
Bundan əlavə təsnifat üçün xüsusi classification token ardıcıllığın əvvəlinə əlavə edilir.
ViT-in self-attention nüvəsi:
\[ Attention(Q,K,V) = softmax\left( \frac{QK^T}{\sqrt{d_k}} \right)V \]
şəklində müəyyən edilmişdir. Beləliklə model yalnız qonşu piksel bölgələrini deyil, üzün bir-birindən uzaq bölgələri arasındakı əlaqələri də təmsil etməyi hədəfləyir.
Metod mətni son classification token çıxışını 768 ölçülü \(f_{\mathrm{image}}\) vektoru kimi müəyyən edir.
Göz hərəkəti qolunda Bi-LSTM və Transformer niyə birlikdədir?
Göz hərəkəti girişi mənbənin Şəkil 1-ində 500 × 17 ölçüdə göstərilir. Göz izləyicinin 100 Hz nümunələmə tezliyi vardır və məlumat 5 saniyəlik pəncərələrə bölünmüşdür. Buna görə 5 saniyəlik bir pəncərənin təxminən 500 zaman nöqtəsi ehtiva etməsi model giriş ölçüsü ilə uyğundur.
Bi-LSTM-nin vəzifəsi ardıcıllığı həm irəli, həm də geri istiqamətdə işləyərək zaman daxilində lokal və keçmiş/gələcək konteksti təmsil etməkdir. Hər istiqamət üçün 128 hidden unit istifadə olunur və iki istiqamət birləşdirildikdə 256 ölçülü çıxış əldə edilir.
Daha sonra Transformer encoder ardıcıllıqda bir-birindən daha uzaq zaman nöqtələri arasındakı asılılıqları self-attention ilə modelləşdirir. Mənbədə Transformer qatı üçün:
- 8 attention head,
- 256 model dimension,
- 512 feed-forward dimension,
- 0,1 dropout,
- 2 Transformer encoder qatı
göstərilmişdir.
Gated Weighted Fusion nə edir?
Mənbədə GWF-nin məqsədi iki modaliteni sadəcə yanaşı əlavə etmək əvəzinə, hansı xüsusiyyətin mövcud nümunədə daha faydalı olduğunu öyrənilə bilən şəkildə müəyyən etməkdir.
İki xüsusiyyət:
\[ f_1,f_2\in R^{C\times1} \]
kimi müəyyən edilir və əvvəlcə:
\[ f_{\mathrm{cat}}=[f_1;f_2] \]
şəklində birləşdirilir. Daha sonra gating weight:
\[ g= \sigma(W_gf_{\mathrm{cat}}+b_g) \]
ilə hesablanır. \(g\) dəyərləri 0 ilə 1 arasındadır.
Mənbənin son fusion tənliyi:
\[ f_{\mathrm{fused}} = g\odot f_1 + (1-g)\odot f_2 \]
şəklindədir. Bu quruluş bir modalitenin bəzi feature kanallarını gücləndirərkən digərini zəiflədə bilən öyrənilə bilən çəkiləndirmə mexanizmidir.
Memarlıq ölçüsü qeydi: Burada mənbədə izah olunmayan ölçü fərqi vardır. ViT bölməsi üz xüsusiyyətini 768 ölçülü müəyyən etdiyi halda Şəkil 1 GWF-yə daxil olan üz qolunu 256×1 göstərir. Bundan əlavə yuxarıdakı weighted-sum formulu \(C\)-ölçülü çıxış yaratdığı halda Şəkil 1 GWF çıxışını 512×1 olaraq etiketləyir. Mənbə bu çevirmələrin ara qatlarını izah etmir.
Təsnifatçı nə yaradır?
Füzyondan çıxan xüsusiyyət MLP əsaslı classifier'a ötürülür. Son qatda Softmax istifadə edilərək beş kateqoriya üçün ehtimal yaradılır:
\[ \hat{y}_k= \frac{\exp(z_k^{(L)})} {\sum_{i=1}^{C}\exp(z_i^{(L)})} \]
Sinif uyğunluğu mənbə Şəkil 1-də:
| Sinif | Emosiya |
|---|---|
| 0 | Sakit |
| 1 | Xoşbəxt |
| 2 | Təəccüblənmiş |
| 3 | Qəzəbli |
| 4 | Digər |
Emosiya stimulları necə seçildi?
Tədqiqatçılar birbaşa laboratoriya eksperimentinə keçmək əvəzinə əvvəlcə hansı sürücülük və ətraf mühit səslərinin yeni sürücülərdə hansı emosiyalarla əlaqəli olduğunu araşdırmışdır. Sorğuda ümumilikdə 387 nəfər iştirak etmişdir; bunların 197'si kişi və 190'ı qadındır.
Sorğuda 17 səs istifadə edilmişdir. Bunlar arasında telefon zəngi, yağış, təcili yardım sirenası, avtomobil toqquşması, dava, qorxu mühiti, rahatladıcı musiqi, yüksək səsli musiqi, it hürməsi, avtomobilin sürətlənməsi, əyləc səsi, siqnal və səs-küy kimi nümunələr vardır.
Səs ilə emosiya kateqoriyası arasındakı əlaqə üçün chi-square testi tətbiq edilmişdir:
\[ \chi^2= \sum_{i,j} \frac{(O_{ij}-E_{ij})^2}{E_{ij}} \]
Mənbədə:
\(\chi^2=1310,791\), p<0,001
nəticəsi bildirilmişdir. Tədqiqatçılar səs növləri ilə emosiya paylanmalarının mənalı şəkildə əlaqəli olduğunu qiymətləndirmişdir.
Correspondence analysis-də iki ölçünün kumulyativ izah nisbətinin %80'i keçdiyi göstərilir. Tədqiqatın şərhinə görə davamlı siqnal, dava və it hürməsi anger bölgəsinə; qəfil toqquşmaya bənzər səslər isə surprise bölgəsinə daha yaxın qruplaşmışdır.
Bu sorğu nəticələri sonrakı sürücülük simulyasiyası üçün “səhnə + səs” stimulus kombinasiyalarının seçilməsində istifadə edilmişdir. Sorğu nəticəsi real sürücülükdə obyektiv emosiya dəyişikliyinin birbaşa sübutu deyil; eksperimental stimul seçiminin ilkin mərhələsidir.
Statik və dinamik sürücülük təcrübələri necə təşkil edildi?
Statik bölmədə 60 şəhər sürücülük fotoşəkli istifadə edilmişdir. Görüntüdən əvvəl sürücülük ssenarisinə dair prompt 3 saniyə, ardından görüntü 10 saniyə göstərilmişdir. Manevrlər arasında dönmə, zolaq dəyişmə, piyadadan yayınma, tıxac və ötmə üçün sürətlənmə vardır.
Hər qrup 12 fotoşəkildən ibarət olmuş və ümumilikdə beş qrup hazırlanmışdır. Mənbə hər qrupun təxminən 2 dəqiqə 35 saniyə davam etdiyini, lakin ümumi statik eksperimentin təxminən 30 dəqiqə olduğunu yazır.
Müddət uyğunsuzluğu: Beş ədəd 2 dəqiqə 35 saniyəlik qrup təxminən 12 dəqiqə 55 saniyədir. 12 × (3+10 saniyə) hesabı da qrup başına təxminən 2 dəqiqə 36 saniyə verir. Mənbədə 30 dəqiqəlik ümumi müddəti izah edən əlavə gözləmə və ya fasilə müddəti göstərilməmişdir.
Dinamik bölmədə 60 şəhər sürücülük videosu istifadə edilmişdir. Videolar başlanğıc sürücülük təlim videolarından götürülmüşdür və düz xətt üzrə sürmə, dairəvi yol qovşağı ilə yolayrıcında gözləmə kimi davranışları ehtiva edir.
Hər video iki dəqiqə davam etmiş; 10 video bir qrup, ümumilikdə altı qrup yaradılmışdır. Qruplar arasında beş dəqiqə fasilə verilmiş və hər qrupdan əvvəl doqquz nöqtəli eye-tracker kalibrləməsi aparılmışdır. Ümumi dinamik eksperiment müddəti təxminən 2 saat 30 dəqiqə olaraq göstərilmişdir.
Eksperiment qurğusunda hansı cihazlar var?
Laboratoriya qurğusunda simulyasiya edilmiş sükan, mufta, əyləc, siqnal idarəetməsi, göz izləyici, human-factor avadanlığı, noutbuk, kamera və qulaqlıq vardır.
Göz hərəkəti üçün aSee Pro F100 istifadə edilmiş və nümunələmə tezliyi 100 Hz olaraq göstərilmişdir. aSee Studio proqramı iştirakçı məlumatları, pupil məlumatı, gaze nöqtələri, saccade və blink kimi parametrlərin toplanmasında istifadə edilmişdir.
Mənbənin Şəkil 5-ində eksperiment mühiti birbaşa göstərilir: sürücülük simulyasiya görüntüsü monitorda nümayiş etdirilərkən kamera və aSee Pro göz izləmə sistemi iştirakçının qarşısında, sükan simulyatoru isə masanın önündə yerləşdirilmişdir. Bu quruluş real avtomobil kabini deyil, laboratoriya əsaslı sürücülük simulyasiyasıdır.
İştirakçılar kimlər idi?
Eksperimentə yaşları 18–25 arasında dəyişən 34 nəfər daxil edilmiş və orta yaş 22 olaraq bildirilmişdir. İştirakçılar sürücülük vəsiqəsi alma mərhələsində olan və ya bir ildən az sürücülük təcrübəsinə sahib şəxslərdən seçilmişdir.
Eksperiment səmərəliliyi %90'ın altında qalan iştirakçılar çıxarılmış və nəticədə 32 nəfərlik effektiv nümunə qalmışdır.
Tədqiqatda iştirakçıların göz izləmə ölçməsinə təsir edə biləcək şərtlər üçün də meyarlar müəyyən edilmişdir. Mənbə kontakt linzadan istifadə edilməməsini və eynək istifadə edənlərdə reseptin “500 diopters” dəyərini aşmamasını yazır. Bu rəqəm mənbədə olduğu kimi ötürülür; mümkün vahid və ya tərcümə problemi səssizcə düzəldilmir.
İştirakçılar məlumatlandırılmış razılıq vermiş və tədqiqat Baoji University of Arts and Sciences etik komitəsi tərəfindən təsdiqlənmişdir.
Göz hərəkəti məlumatları necə hazırlanmışdır?
Mənbə hər iştirakçının ilkin eye-movement məlumat dəstində 79.070 zaman nöqtəsi olduğunu bildirir. Məlumatlar 5 saniyəlik zaman pəncərələrinə bölünmüşdür.
100 Hz nümunələmə səbəbindən bir 5 saniyəlik pəncərə təxminən 500 zaman nöqtəsinə uyğun gəlir; model girişinin 500×17 olaraq müəyyən edilməsi bu quruluşla uyğundur.
Mənbə mətnində bu slicing əməliyyatının “79.070 rows'tan təxminən 500 rows'a” endirdiyi formasında ifadə də vardır. Bunun hər 5 saniyəlik pəncərənin təxminən 500 sətir ehtiva etməsi mənasına gəldiyi model girişindən anlaşılsa da, mətn ümumi məlumat miqdarı baxımından aydın deyil.
Üz görüntüləri necə hazırlanmışdır?
Üz videoları ErgoLAB facial-expression analysis proqramına verilmiş, facial feature nöqtələri və uyğun emotion label'ları əldə edilmişdir. Daha sonra videolar frame-by-frame görüntü ardıcıllıqlarına çevrilmişdir.
Görüntülər 1920×1080 təsvir ölçüsündən 224×224 pikselə yenidən ölçüləndirilmiş və piksel dəyərləri [0,1] aralığına normallaşdırılmışdır.
Mənbə proqramın yaratdığı emotion label'lardan sonra manual classification aparıldığını bildirir. Lakin eye-movement pəncərələri ilə facial frame'lərin son ortaq ground-truth etiketinin sinxronlaşdırılması təfərrüatları metod bölməsində məhdud izah edilmişdir.
Model hansı məlumatla öyrədildi?
| Məlumat növü | Nümunə sayı |
|---|---|
| Göz hərəkəti nümunələri | 30.000 |
| Üz ifadəsi nümunələri | 30.000 |
| Hər emosiya kateqoriyası | 6000 |
Nümunələr subject əsasında beş alt çoxluğa bölünmüşdür. Hər dövrdə dörd alt çoxluq təlim, qalan alt çoxluq validation üçün istifadə edilmiş və bütün alt çoxluqlar bir dəfə validation olduqda proses tamamlanmışdır.
Təlim parametrləri
| Parametr | Dəyər |
|---|---|
| Epoch | 30 |
| Batch size | 32 |
| Initial learning rate | 10−3 |
| Optimizer | Adam |
| Loss | Cross-entropy |
| Validation | Subject-level 5-fold cross-validation |
Yalnız üz, yalnız göz və multimodal nəticələr necə dəyişir?
| Modalite | Mənbədə bildirilən accuracy |
|---|---|
| Üz görüntüsü | %71,18 |
| Göz hərəkəti | %95,10 |
| Multimodal | %98,72 |
Nəticələrin mənbənin öz şərhinə görə ən mühüm mesajı göz hərəkəti məlumatının üz ifadəsi ilə müqayisədə bu eksperiment qrupunda daha çox ayırdedici olması və iki modalitenin birləşdirilməsinin daha yüksək bildirilən dəqiqlik təmin etməsidir.
Bu nəticə üz ifadəsinin ümumilikdə emosiya tanıma üçün zəif olduğu demək deyil. Nəticə yalnız bu məlumat dəsti, bu iştirakçı qrupu, bu stimullar və bu model quruluşu üçün keçərlidir.
GWF sadə concatenation'dan daha yaxşıdırmı?
| Fusion üsulu | Accuracy (%) |
|---|---|
| Feature Concatenation | 95,45 |
| GWF Fusion | 98,72 |
İki dəyər arasındakı mütləq fərq 3,27 faiz bəndidir. Mənbə bu nəticəni “accuracy'de %3,27 improvement” şəklində ifadə edir.
Confusion matrix'lər niyə vacibdir?
Yalnız facial-image modelinin Şəkil 10 confusion matrix'ində əsas diaqonalın cəmi 3257, ümumi nümunə sayı 4576'dır:
\[ Accuracy= \frac{3257}{4576} = 0,71176 \approx71,18\% \]
Bu dəyər Şəkil 8-də bildirilən facial-image accuracy ilə tam uyğun gəlir.
Facial modeldə Class 0, yəni calm kateqoriyasının xüsusilə Class 4 “other” və Class 3 “angry” ilə qarışdırıldığı görünür. Mənbə bunu sakit emosiyada üz dəyişikliklərinin daha incə olması ilə şərh edir.
Lakin multimodal Şəkil 11 yenidən hesablandıqda:
| Ölçmə | Dəyər |
|---|---|
| Ümumi confusion-matrix nümunəsi | 4576 |
| Əsas diaqonal / doğru təsnifat | 4304 |
| Matrisdən yenidən hesablanan accuracy | ≈ %94,06 |
| Şəkil 8 və Cədvəl 3-də bildirilən multimodal accuracy | %98,72 |
Elmi hesabat xəbərdarlığı: Mənbə Şəkil 11-in fərqli fold, alt çoxluq və ya eksperiment hissəsinə aid olduğunu bildirmir. Buna baxmayaraq confusion matrix-dən yenidən əldə edilən %94,06 ilə əsas cədvəldə verilən %98,72 uyğun gəlmir. Verianla bu iki nəticədən hansının doğru olduğunu seçmir; uyğunsuzluğu açıq şəkildə saxlayır.
Eye-movement modelində Bi-LSTM və Transformer töhfəsi nədir?
Yalnız göz hərəkəti məlumatı ilə aparılan ablasiyada:
| Model | Accuracy (%) |
|---|---|
| Bi-LSTM | 87,50 |
| Transformer | 94,23 |
| Bi-LSTM + Transformer | 95,10 |
Multimodal eksperimentdə isə eye branch komponentlərinin təsiri:
| Eye branch | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Mənbə bu nəticələri Bi-LSTM-nin zaman daxilində istiqamətli asılılıqları, Transformer'ın isə daha uzaq məsafəli əlaqələri təmsil etməsinin bir-birini tamamlaması kimi şərh edir.
Üç ümumi məlumat dəstindəki nəticələr nə göstərir?
Tədqiqatçılar modelin yalnız öz eksperiment məlumatındakı uğurundan asılı qalmamaq üçün AFFEC, SEED-IV və AffectNet üzərində əlavə müqayisələr aparmışdır.
| Məlumat dəsti | Modalite | Təklif olunan model Accuracy | Macro-F1 |
|---|---|---|---|
| AFFEC | Göz + üz | 91,95 ± 0,87% | 91,36 ± 0,92% |
| SEED-IV | Yalnız göz hərəkəti | 90,44 ± 0,75% | 89,81 ± 0,80% |
| AffectNet | Yalnız üz | 89,67 ± 0,69% | 89,02 ± 0,73% |
Mənbə təklif olunan modelin hər üç məlumat dəstindəki baseline'larla müqayisədə p<0,05 səviyyəsində statistik olaraq əhəmiyyətli üstünlük göstərdiyini bildirir.
Lakin bu bölmənin şərh sərhədi xüsusilə vacibdir: AFFEC, SEED-IV və AffectNet yeni sürücülər üçün hazırlanmış sürücülük məlumat dəstləri deyil. Tədqiqat da bunu açıq şəkildə vurğulayır. Bu nəticələr model memarlığının ümumi emosiya tanıma qabiliyyətini dəstəkləyir; real sürücülük şəraitindəki performansını doğrulamır.
Digər emosiya tanıma üsulları ilə necə müqayisə edilmişdir?
| Siqnallar | Üsul | Mənbədə verilən accuracy |
|---|---|---|
| Göz + səs + görüntü | FE-CNN | 81,90% |
| Göz + PPG | FECNN + LSTM | 84,68% |
| Üz + rPPG + göz | Dual-path Transformer | 86,98% |
| EEG + göz | MFFNN | 87,32% |
| EEG | LSTM | 90,72% |
| EEG + ECG + göz | 1D-Inception + Self-Attention + LSTM | 91,38% |
| EEG | CNN-LSTM | 93,97% |
| EEG + üz + fizioloji siqnallar | GNN | 91,25% |
| Göz + üz | Bu tədqiqat | 98,72% |
Bu cədvəl fərqli tədqiqatların fərqli məlumat dəstləri, sinif sayları, nümunələri və eksperiment protokollarını ehtiva etdiyi üçün birbaşa yarış cədvəli kimi oxunmamalıdır. Mənbə bu dəyərləri ədəbiyyat müqayisəsi kimi təqdim edir; eyni benchmark üzərində nəzarətli head-to-head eksperiment deyil.
Model real vaxtlıdırmı?
Mənbə multimodal model üçün batch başına orta processing time dəyərini:
29,42 ± 0,08 ms
kimi verir.
Hybrid inference modunda nümunə başına:
0,9230 ± 0,0014 ms
bildirilmişdir.
Tədqiqatçılar bu dəyəri avtomobildaxili insan–maşın qarşılıqlı əlaqəsi üçün istifadə etdikləri 100–200 ms referens gecikmədən aşağı olması səbəbilə real vaxtlılıq baxımından kifayət hesab edirlər.
Lakin bu müddət real avtomobildə, istehsal tipli embedded ECU-da və ya avtomobildaxili kamera/eye-tracker pipeline'ının tamamında ölçülmüş end-to-end latency deyil. Tədqiqat real sürücülük mühitində deployment edilmədiyini açıq şəkildə bildirir.
Tədqiqatın dəstəklədiyi nəticələr
- Üz görüntüsü və eye-tracking məlumatını birlikdə istifadə edən hibrid emosiya tanıma memarlığı tətbiq edilmişdir.
- ViT-B/16, Bi-LSTM, Transformer encoder, GWF və MLP tək bir multimodal pipeline daxilində istifadə edilmişdir.
- Mənbənin əsas cədvəllərində multimodal model üçün %98,72 accuracy bildirilmişdir.
- Mənbə modalite ablasiyasında eye-movement məlumatının facial-image məlumatından daha yüksək accuracy yaratdığını göstərir.
- GWF mənbədə sadə feature concatenation'dan daha yüksək accuracy ilə bildirilmişdir.
- Bi-LSTM + Transformer eye branch'i yalnız Bi-LSTM və ya yalnız Transformer istifadə olunan ablasiyalardan daha yüksək performans göstərmişdir.
- Model AFFEC, SEED-IV və AffectNet ümumi emosiya məlumat dəstlərində müqayisə olunan baseline'ların üzərində bildirilmişdir.
- Model inference müddəti laboratoriya hesablama mühitində millisaniyə səviyyəsində ölçülmüşdür.
Tədqiqatın dəstəkləmədiyi, sınaqdan keçirmədiyi və ya sübut etmədiyi nəticələr
- Model real nəqliyyatda və ya real avtomobil sürücülüyündə sınaqdan keçirilməmişdir.
- %98,72 accuracy'nin Türkiyədəki və ya fərqli yaş qrupundakı yeni sürücülərə köçürülə biləcəyi göstərilməmişdir.
- Emosiya tanımanın yol-nəqliyyat qəzalarını faktiki olaraq azaltdığı bu tədqiqatda eksperimental şəkildə ölçülməmişdir.
- Model avtomobildaxili kamera, günəş işığı, gecə sürücülüyü, üzün örtülməsi, intensiv baş hərəkəti və real yol vibrasiyası altında doğrulanmamışdır.
- Real embedded avtomobil platformasında enerji sərfi, RAM, model ölçüsü və end-to-end latency ölçümü təqdim edilməmişdir.
- Üç xarici məlumat dəstindəki uğur yeni sürücüyə xas real sürücülük doğrulaması deyil.
- Tədqiqatın confusion matrix'i əsas bildirilən %98,72 dəqiqlik dəyərini müstəqil şəkildə doğrulamır.
- Modelin emosiya sinifləri şəxsin real psixoloji vəziyyətinin klinik və ya dəqiq ölçümü kimi şərh edilə bilməz.
Tədqiqatın Metodu və Nəticələri
Tədqiqat dizaynının əsas komponentləri
| Komponent | Mənbədə verilən məlumat |
|---|---|
| Sorğu nümunəsi | 387 nəfər |
| Sorğu kişi/qadın | 197 / 190 |
| Səs stimulu | 17 növ |
| İlkin eksperiment iştirakçısı | 34 |
| Effektiv iştirakçı | 32 |
| Yaş | 18–25; orta 22 |
| Sürücülük təcrübəsi | Vəsiqə namizədi və ya <1 il təcrübə |
| Eye tracker | aSee Pro F100 |
| Eye-tracking sampling rate | 100 Hz |
| Eye window | 5 s / təxminən 500 zaman nöqtəsi |
| Eye model girişi | 500 × 17 |
| Facial-image girişi | 224 × 224 × 3 |
| Emosiya sinfi | 5 |
Model memarlığının əsas parametrləri
| Modul | Əsas quruluş |
|---|---|
| Üz feature extraction | ViT-B/16; 16×16 patch; 768-ölçülü classification token |
| Bi-LSTM | 128 hidden unit/istiqamət; birləşdirilmiş 256-ölçülü çıxış |
| Transformer encoder | 8 head, d-model 256, FFN 512, dropout 0,1, 2 qat |
| Fusion | Gated Weighted Fusion |
| Classifier | MLP + Softmax |
Əsas multimodal eksperiment nəticəsi
| Eye feature modeli | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Confusion matrix keyfiyyət nəzarəti
| Mənbə nəticəsi | Bildirilən / yenidən hesablanan | Vəziyyət |
|---|---|---|
| Facial-image accuracy | Şəkil 8: %71,18 / Şəkil 10 matrisindən: %71,18 | Uyğundur |
| Multimodal accuracy | Şəkil 8 və Cədvəl 3: %98,72 / Şəkil 11 matrisindən: ≈%94,06 | Uyğun deyil |
Bu nəzarət Verianla tərəfindən mənbənin Şəkil 10 və Şəkil 11 hüceyrələri üzərindən yenidən hesablanmışdır. Mənbənin yerinə yeni eksperiment nəticəsi yaratmır; yalnız dərc edilmiş hüceyrələrin arifmetik tutarlılığını yoxlayır.
Ümumi məlumat dəstlərində nəticələr
| Dataset | Təklif olunan model Accuracy ± Std | Macro-F1 ± Std | Mənbə statistik qeydi |
|---|---|---|---|
| AFFEC | 91,95 ± 0,87% | 91,36 ± 0,92% | p<0,05 vs. bütün baseline'lar |
| SEED-IV | 90,44 ± 0,75% | 89,81 ± 0,80% | p<0,05 vs. bütün baseline'lar |
| AffectNet | 89,67 ± 0,69% | 89,02 ± 0,73% | p<0,05 vs. bütün baseline'lar |
Real vaxtlılıq nəticəsi
| Ölçmə | Dəyər |
|---|---|
| Batch başına processing time | 29,42 ± 0,08 ms |
| Hybrid inference mode, nümunə başına | 0,9230 ± 0,0014 ms |
Bu performans dəyərləri model hesablamasına aiddir. Real avtomobildə kamera acquisition, eye-tracking acquisition, preprocessing, əməliyyat sistemi gecikməsi, sensor sinxronizasiyası və xəbərdarlıq yaradılmasının hamısını əhatə edən real end-to-end avtomobildaxili gecikmə ölçümü deyil.
Tədqiqatın əsas məhdudiyyətləri
- Effektiv sürücü nümunəsi yalnız 32 nəfərdir.
- İştirakçılar yalnız 18–25 yaş qrupundadır.
- Mədəni müxtəliflik məhduddur.
- Emosiyalar laboratoriyada vizual və eşitmə stimulusları ilə yaradılmışdır.
- Gözlənilməz real yol hadisələri sınaqdan keçirilməmişdir.
- Real avtomobil sürücülüyü istifadə edilməmişdir.
- Təbii avtomobildaxili işıq dəyişməsi, head movement və facial occlusion geniş şəkildə doğrulanmamışdır.
- Real embedded deployment aparılmamışdır.
- Multimodal confusion matrix ilə əsas accuracy nəticəsi arasında izah olunmayan sayısal uyğunsuzluq vardır.
- GWF-nin feature ölçüləri metod tənlikləri ilə memarlıq təsviri arasında tam açıqlanmamışdır.
Mənbə və Metod Qeydi
Tam orijinal tədqiqat adı: Hybrid Deep Neural Network-Based Modeling of Multimodal Emotion Recognition for Novice Drivers
Müəlliflər və sıraları: Jianzhuo Li; Ye Yu; Zhao Dai; Panyu Dai.
Məsul müəllif: Jianzhuo Li.
Bərabər birinci/bərabər töhfə: Mənbədə göstərilməmişdir.
Qurum: School of Computer Science, Baoji University of Arts and Sciences, Baoji 721016, China.
Jurnal: Future Internet
Nəşriyyat: MDPI, Basel, Switzerland
Cild / sayı / məqalə: 18 / 4 / 221
Qəbul üçün daxilolma tarixi: 27 Fevral 2026
Reviziya tarixi: 17 Aprel 2026
Qəbul tarixi: 18 Aprel 2026
Nəşr tarixi: 21 Aprel 2026
DOI: 10.3390/fi18040221
Rəsmi nəşr keçidi:https://doi.org/10.3390/fi18040221
Mənbə növü: Rəyli tədqiqat məqaləsi; laboratoriya əsaslı simulyasiya edilmiş sürücülük eksperimenti, eye-tracking/facial-image məlumat analizi və dərin öyrənmə modelləşdirmə işi.
Rəy statusu: Rəyli jurnalda dərc olunmuş tədqiqatdır.
Lisenziya: Creative Commons Attribution (CC BY).
Versiya: Araşdırılan fayl v2 olaraq adlandırılmışdır. Nəşriyyatçının versiya qeydi tədqiqat üçün yenilənmiş version of record olduğunu göstərir. Yenilənmənin əhatəsi mənbədə araşdırılan məqalənin elmi məzmunundan kənara çıxılaraq təxmin edilməmişdir.
Etik təsdiq: Tədqiqat Helsinki Bəyannaməsinə uyğun aparıldığını bildirir və Baoji University of Arts and Sciences Institutional Review Board təsdiq nömrəsini BJWL-2025-ETH-048, təsdiq tarixini 7 Yanvar 2025 olaraq verir.
Məlumatlandırılmış razılıq: Mənbə bütün iştirakçıların tədqiqatın məqsədi və proseduru haqqında məlumatlandırıldığını və elmi tədqiqat üçün məlumat istifadəsini qəbul edən informed-consent formunu imzaladığını bildirir.
Maliyyələşdirmə: Tədqiqat xarici maliyyələşdirmə almamışdır.
Məlumat əlçatanlığı: İstifadə olunan məlumat dəstlərinin əsaslandırılmış sorğu əsasında məsul müəllifdən əldə edilə biləcəyi göstərilmişdir.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşması olmadığını bəyan etmişdir.
Müəllif töhfələri: Mənbə bəyanına görə konseptuallaşdırma Ye Yu; metodologiya Ye Yu, Zhao Dai və Panyu Dai; proqram təminatı Ye Yu və Panyu Dai; doğrulama, formal analiz, araşdırma və məlumat kurasiyası Ye Yu; ilkin layihə Ye Yu; nəzərdən keçirmə/redaktə Jianzhuo Li; vizuallaşdırma Ye Yu; nəzarət və layihə idarəetməsi Jianzhuo Li tərəfindən həyata keçirilmişdir.
Mənbədaxili sayısal uyğunsuzluq 1 — confusion matrix: Facial-image confusion matrix hüceyrələrindən yenidən hesablanan accuracy %71,18 olub Şəkil 8 ilə uyğun gəlir. Multimodal confusion matrix-də isə 4576 nümunənin 4304'ü əsas diaqonaldadır və yenidən hesablanan accuracy təxminən %94,06'dır. Bu dəyər Şəkil 8 və Cədvəl 3-dəki %98,72 ilə uyğun gəlmir. Mənbə fərqli qiymətləndirmə çoxluğu və ya fold açıqlamır.
Mənbədaxili memarlıq uyğunsuzluğu 2 — feature ölçüləri: ViT metodu classification-token çıxışını 768 ölçülü müəyyən etdiyi halda Şəkil 1 üz qolunun GWF girişini 256×1 göstərir. GWF Tənlik (19) C-ölçülü iki girişdən C-ölçülü weighted-sum yaratdığı halda Şəkil 1 çıxışı 512×1 kimi göstərir. Ara çevirmə açıq şəkildə müəyyən edilməmişdir.
Mənbədaxili müddət uyğunsuzluğu 3: Statik sürücülük eksperimentinin beş qrupunun hər biri təxminən 2 dəqiqə 35 saniyə olaraq müəyyən edilmişdir; bu təxminən 12 dəqiqə 55 saniyədir. 12 görüntü × 13 saniyəlik stimulus quruluşu da təxminən eyni müddəti verir. Mənbə buna baxmayaraq ümumi statik eksperiment müddətini təxminən 30 dəqiqə olaraq bildirir və fərqin səbəbini izah etmir.
Mənbədaxili vahid qeydi 4: İştirakçı seçim meyarında eynək resepti üçün mənbədə “500 diopters” ifadəsi vardır. Mümkün vahid/tərcümə xətası mənbədən kənar fərziyyə ilə düzəldilməmişdir.
GWF performans ifadəsi: Mənbə feature concatenation üçün %95,45 və GWF üçün %98,72 accuracy bildirir və artımı %3,27 adlandırır. İki bildirilən accuracy arasındakı mütləq fərq 3,27 faiz bəndidir.
Ground-truth/etiketləmə qeydi: Facial expression videoları ErgoLAB proqramı ilə analiz edilərək emotion label yaradılmış və sonra manual təsnifat aparılmışdır. Eye-movement nümunələrinin beş kateqoriya ilə etiketləndiyi bildirilsə də, iki modalitenin son ortaq ground-truth etiketinin yaradılma və sinxronizasiya proseduru mənbədə ətraflı açıqlanmamışdır.
Ümumiləşdirilə bilmə sərhədi: AFFEC, SEED-IV və AffectNet üzərində doğrulamalar ümumi emosiya tanıma tapşırıqlarıdır. Mənbə xüsusilə bu məlumat dəstlərinin novice-driver və ya driving-specific olmadığını bildirir. Buna görə bu nəticələr real sürücülük şəraitinə birbaşa doğrulama kimi istifadə edilməmişdir.
Real vaxtlılıq sərhədi: 29,42 ms/batch və 0,9230 ms/sample dəyərləri model processing ölçmələridir. Tədqiqatda real avtomobildaxili embedded system deployment və ya real sürücülük şəraitində end-to-end latency ölçümü həyata keçirilməmişdir.
Bu Verianla izahındakı metod, məlumat dəstləri, tənliklər, təsnifat nəticələri, cədvəllər, şəkil şərhləri və məhdudiyyətlər araşdırılan elmi tədqiqata əsaslanır. Biblioqrafik xarici doğrulama yalnız DOI, jurnal, nəşriyyat, rəy və nəşr versiyası kimi mənbə kimliyi elementlərinin təsdiqi üçün istifadə edilmiş; xarici mənbələrdən yeni emosiya tanıma nəticəsi və ya yeni performans dəyəri əlavə edilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib