

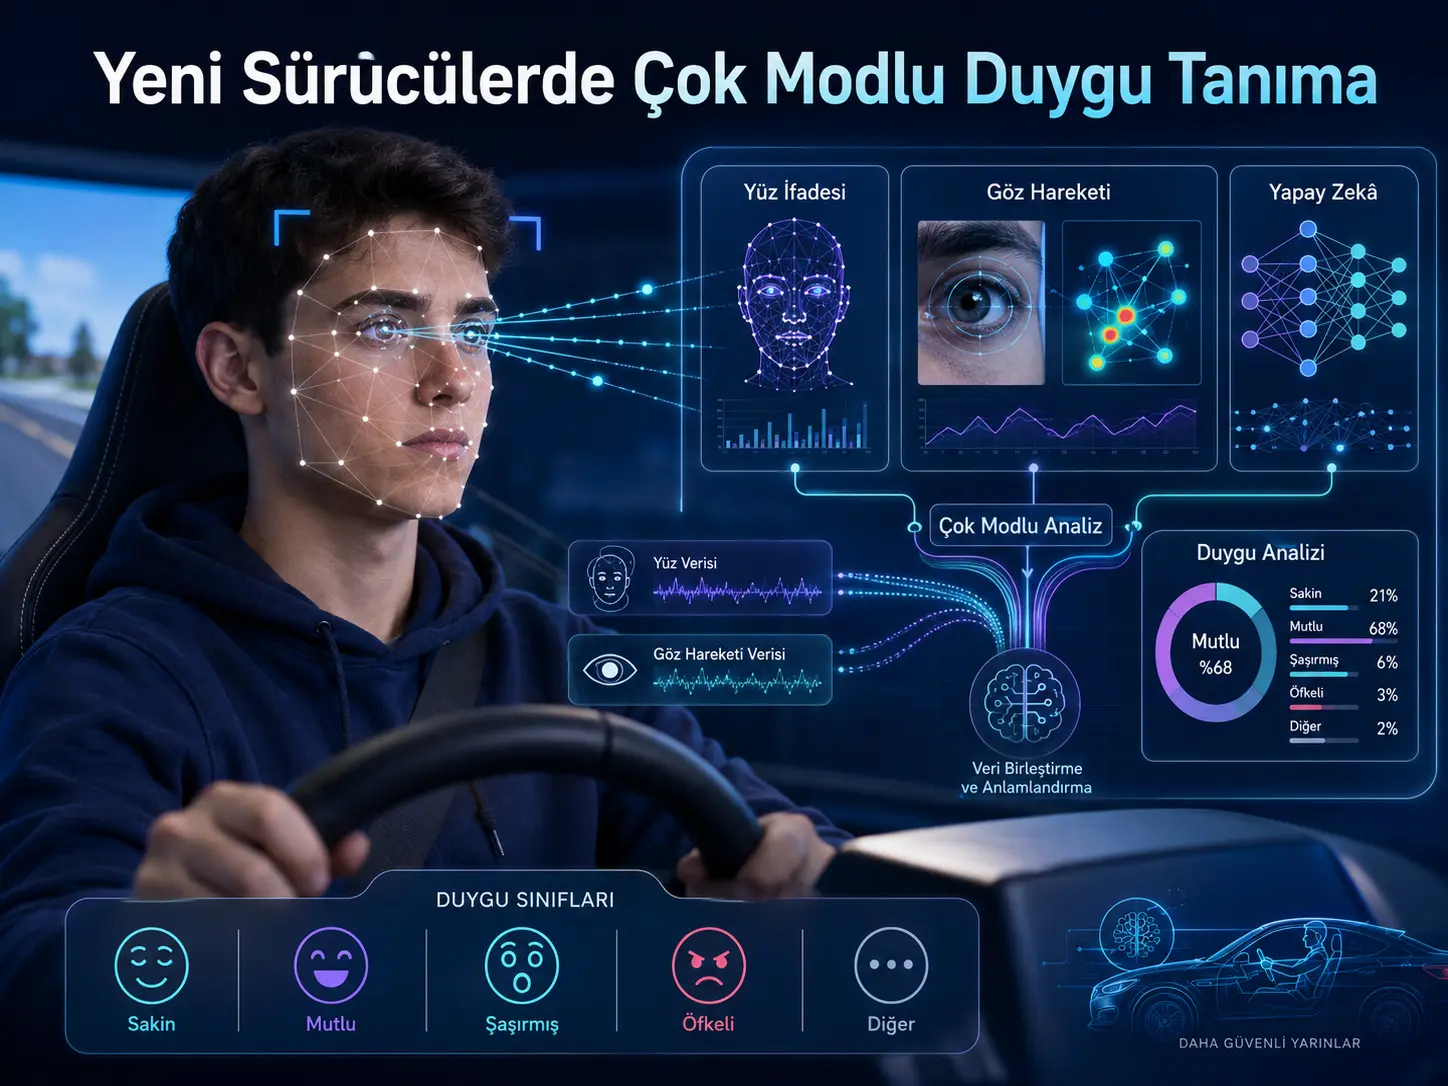
Utafiti huu unatengeneza modeli ya ujifunzaji wa kina ya namna nyingi inayotumia vyanzo viwili vya taarifa kwa pamoja badala ya kukadiria hali ya kihisia ya madereva wapya wenye uzoefu mdogo wa kuendesha gari kwa kutumia tu sura ya uso au tu mienendo ya macho. Modeli huchakata picha za uso kwa ViT-B/16, huku ikichanganua mfululizo wa muda wa ufuatiliaji wa macho kwa mchanganyiko wa Bi-LSTM na Transformer encoder; makundi haya mawili ya vipengele kisha huunganishwa kwa utaratibu wa uzani unaoweza kujifunza unaoitwa Gated Weighted Fusion (GWF) na kupelekwa kwenye perceptron yenye tabaka nyingi. Madarasa ya matokeo ni matano: mtulivu, mwenye furaha, aliyeshangaa, mwenye hasira na mengine.
Kwanza, utafiti ulitumia dodoso la watu 387 kuchunguza ni hisia zipi zinazohusishwa na sauti 17 tofauti za kuendesha gari au mazingira. Kisha, madereva wapya wenye umri wa 18–25 walifanyiwa majaribio katika mazingira ya maabara kwa kutumia picha tuli za kuendesha gari na video za kuendesha gari zenye mwendo; picha za uso na data za ufuatiliaji wa macho za 100 Hz zilikusanywa kwa wakati mmoja. Washiriki 34 waliingizwa mwanzoni, na baada ya wale ambao ufanisi wao wa jaribio ulikuwa chini ya %90 kuondolewa, sampuli yenye ufanisi iliripotiwa kuwa watu 32.
Kwa modeli, sampuli 30.000 za mienendo ya macho na sampuli 30.000 za sura za uso zilitumiwa; ilielezwa kuwa kulikuwa na sampuli 6000 kwa kila moja ya madarasa matano ya hisia. Data ziligawanywa katika vikundi vidogo vitano kwa kiwango cha mshiriki, na katika kila mzunguko vikundi vinne vilitumika kwa mafunzo na kimoja kwa validation, hivyo subject-level five-fold cross-validation ikatumika. Mafunzo yalifanywa kwa 30 epoch, batch size 32, initial learning rate 10−3, Adam optimizer na cross-entropy loss.
Kulingana na matokeo makuu yaliyoripotiwa na chanzo, accuracy ilikuwa %71,18 kwa picha za uso pekee, %95,10 kwa mienendo ya macho pekee na %98,72 kwa modeli ya GWF inayotumia modaliti zote mbili kwa pamoja. Mbinu rahisi ya feature concatenation ilitoa accuracy ya %95,45, huku matumizi ya GWF yakiripotiwa kuwa %98,72. Hata hivyo, kuna kutokulingana muhimu kwa namba kati ya multimodal confusion matrix ya utafiti na matokeo ya %98,72; kwa hiyo thamani kuu ya mafanikio inapaswa kusomwa kama matokeo yaliyoripotiwa na chanzo, si accuracy iliyozalishwa upya kwa kujitegemea.
Modeli haikutathminiwa tu kwenye seti ya data ya madereva wapya iliyokusanywa na watafiti wenyewe, bali pia kwenye seti tatu za jumla za hisia zinazoitwa AFFEC, SEED-IV na AffectNet. Muundo uliopendekezwa uliripoti accuracy ya %91,95, %90,44 na %89,67 kwa seti hizo kwa mtiririko huo. Hata hivyo, utafiti wenyewe unaeleza wazi kuwa seti hizi tatu hazijaundwa mahususi kwa madereva wapya au kuendesha gari halisi. Majaribio haya yanaunga mkono uwezo wa jumla wa model katika feature extraction na fusion; hayaonyeshi kuwa inatambua hisia za dereva mpya kwa usahihi huo huo katika trafiki halisi.
Kwa mtazamo wa Uturuki: Utafiti haukufanywa nchini Uturuki na haukukusanya data kutoka kwa wanafunzi au waombaji wa leseni ya udereva nchini humo. Kwa kuwa umri, mazingira ya kitamaduni, mafunzo ya udereva, tabia za trafiki, mienendo ya sura ya uso na athari za vichocheo vya kihisia vinavyotumika vinaweza kutofautiana kati ya jamii, viwango vya accuracy vilivyoripotiwa haviwezi kuhamishwa moja kwa moja kwa waombaji wa udereva nchini Uturuki. Mfumo utakaotumika Uturuki unahitaji kuthibitishwa tofauti kwa washiriki wa eneo hilo, katika mazingira halisi ya gari, katika hali tofauti za mwanga na barabara, na kwenye vifaa vya ndani ya gari.
Tatizo kuu la utafiti ni nini?
Utafiti unalenga mapungufu mawili makuu katika ufuatiliaji wa hali ya kihisia wakati wa kuendesha gari. Kwanza, sehemu kubwa ya tafiti za awali imejikita kwa madereva wenye uzoefu au makundi ya madereva kwa ujumla. Watafiti wanahoji kuwa watu wenye uzoefu mdogo wa udereva wanaweza kutoa miitikio tofauti ya kihisia wanapokabiliwa na mzigo wa kiakili na matukio yasiyotarajiwa.
Tatizo la pili ni kwamba modaliti moja ya data inaweza kuwa na ugumu wa kuwakilisha hisia kikamilifu. Sura za uso zinaweza kuonekana moja kwa moja kutoka nje, lakini zinaweza kutokuwa dhahiri katika hisia zenye nguvu ndogo au kuathiriwa na tabia ya makusudi ya mtu. Mienendo ya macho inaweza kuakisi usambazaji wa umakini, tabia ya pupil, gaze na mabadiliko kwa muda; hata hivyo, peke yake inaweza kutotosha kutofautisha hisia tofauti.
Suluhisho la utafiti ni kuunganisha vipengele vya anga vya picha za uso na vipengele vya muda vya mienendo ya macho.
Modeli ina sehemu gani nne kuu?
Mlolongo wa utambuzi wa hisia wa namna nyingi kwa dereva mpya
| Hatua | Ingizo / mchakato | Modeli kuu | Chanzo |
|---|---|---|---|
| 1. Picha ya uso | Picha ya uso ya 224 × 224 × 3 hugawanywa katika patch na vipengele vya jumla vya kuona hutolewa. | ViT-B/16 | Sehemu 3.2 / Kielelezo 1 |
| 2. Mienendo ya macho | Katika mfululizo wa muda wa 500 × 17, utegemezi wa muda wa mbele na nyuma huchakatwa. | Bi-LSTM | Sehemu 3.3 / Kielelezo 1 |
| 3. Uhusiano wa masafa marefu | Mahusiano kati ya nukta za muda zilizo mbali zaidi katika mfululizo wa mienendo ya macho huigwa. | Transformer encoder | Sehemu 3.3 |
| 4. Fusion inayobadilika | Mchango wa vipengele vya uso na mienendo ya macho hupimwa kwa gating inayoweza kujifunza. | GWF | Sehemu 3.4 |
| 5. Uainishaji | Uwezekano wa madarasa matano ya hisia hutolewa kutoka kwa kipengele kilichounganishwa. | MLP + Softmax | Sehemu 3.5 |
Huu ni uwasilishaji wa mchakato wa maelezo uliotayarishwa kwa kuzingatia Kielelezo 1 na sehemu ya mbinu ya utafiti. Hakuna hatua mpya ya modeli ambayo haipo katika chanzo iliyoongezwa.
ViT-B/16 huchakataje picha ya uso?
Picha za ukubwa wa 224 × 224 pixels huingizwa kwenye tawi la uso la modeli. ViT-B/16 hugawanya picha katika patch za 16 × 16 pixels. Idadi ya patch huhesabiwa kwa:
\[ N= \frac{H}{P} \times \frac{W}{P} \]
Katika utafiti \(P=16\). Kwa picha ya 224 × 224, muundo huu huwezesha picha kugawanywa katika vipande vidogo na kuwasilishwa kwa Transformer kama mlolongo wa token.
Kila patch huhamishwa kwa linear transformation kwenda kwenye feature space yenye vipimo 768:
\[ z_i=W_{\mathrm{patch}}p_i+b_{\mathrm{patch}} \]
Position embedding huongezwa ili nafasi za patch ndani ya picha zisipotee:
\[ z'_i=z_i+E_{\mathrm{pos},i} \]
Pia, classification token maalum huongezwa mwanzoni mwa mlolongo kwa ajili ya uainishaji.
Kiini cha self-attention cha ViT kinafafanuliwa kama:
\[ Attention(Q,K,V) = softmax\left( \frac{QK^T}{\sqrt{d_k}} \right)V \]
Kwa njia hii modeli inalenga kuwakilisha si tu maeneo ya pixel yaliyo karibu, bali pia mahusiano kati ya maeneo ya uso yaliyo mbali.
Sehemu ya mbinu inafafanua matokeo ya mwisho ya classification token kama vekta ya \(f_{\mathrm{image}}\) yenye vipimo 768.
Kwa nini Bi-LSTM na Transformer zinatumika pamoja katika tawi la mienendo ya macho?
Ingizo la mienendo ya macho linaonyeshwa katika Kielelezo 1 cha chanzo kama 500 × 17. Eye tracker ina sampling rate ya 100 Hz na data zimegawanywa katika madirisha ya sekunde 5. Kwa hiyo, dirisha la sekunde 5 kuwa na takribani nukta 500 za muda linaendana na ukubwa wa ingizo la modeli.
Kazi ya Bi-LSTM ni kuchakata mlolongo kwa mwelekeo wa mbele na nyuma ili kuwakilisha muktadha wa karibu na wa zamani/ujao katika muda. Hidden unit 128 hutumiwa kwa kila mwelekeo, na mwelekeo miwili inapounganishwa hutokea matokeo ya vipimo 256.
Kisha Transformer encoder huiga utegemezi kati ya nukta za muda zilizo mbali zaidi katika mlolongo kwa self-attention. Chanzo kinataja kwa tabaka la Transformer:
- 8 attention head,
- 256 model dimension,
- 512 feed-forward dimension,
- 0,1 dropout,
- 2 Transformer encoder layers
.
Gated Weighted Fusion hufanya nini?
Kulingana na chanzo, lengo la GWF ni kubaini kwa namna inayoweza kujifunza ni kipengele kipi kinafaa zaidi kwa sampuli ya sasa, badala ya kuweka modaliti mbili pamoja tu bila uzani unaobadilika.
Vipengele viwili vinafafanuliwa kama:
\[ f_1,f_2\in R^{C\times1} \]
na kwanza huunganishwa kama:
\[ f_{\mathrm{cat}}=[f_1;f_2] \]
Kisha gating weight huhesabiwa kwa:
\[ g= \sigma(W_gf_{\mathrm{cat}}+b_g) \]
Thamani za \(g\) ziko kati ya 0 na 1.
Mlinganyo wa mwisho wa fusion katika chanzo ni:
\[ f_{\mathrm{fused}} = g\odot f_1 + (1-g)\odot f_2 \]
Muundo huu ni utaratibu wa uzani unaoweza kujifunza ambao unaweza kuimarisha baadhi ya feature channels za modaliti moja huku ukipunguza nyingine.
Dokezo la vipimo vya usanifu: Hapa kuna tofauti ya vipimo ndani ya chanzo ambayo haijaelezwa. Sehemu ya ViT inafafanua kipengele cha uso kuwa cha vipimo 768, ilhali Kielelezo 1 kinaonyesha tawi la uso linaloingia GWF kama 256×1. Pia, mlinganyo wa weighted-sum hapo juu hutoa matokeo ya vipimo \(C\), lakini Kielelezo 1 kinaweka lebo ya matokeo ya GWF kuwa 512×1. Chanzo hakielezi tabaka za kati za mabadiliko haya.
Classifier hutoa nini?
Kipengele kinachotoka kwenye fusion hupelekwa kwenye classifier ya MLP. Katika tabaka la mwisho, Softmax hutumika kutoa uwezekano kwa madarasa matano:
\[ \hat{y}_k= \frac{\exp(z_k^{(L)})} {\sum_{i=1}^{C}\exp(z_i^{(L)})} \]
Ulinganifu wa madarasa katika Kielelezo 1 cha chanzo ni:
| Darasa | Hisia |
|---|---|
| 0 | Mtulivu |
| 1 | Mwenye furaha |
| 2 | Aliyeshangaa |
| 3 | Mwenye hasira |
| 4 | Nyingine |
Vichocheo vya hisia vilichaguliwaje?
Badala ya kuanza moja kwa moja na jaribio la maabara, watafiti walichunguza kwanza ni sauti gani za kuendesha gari na mazingira zinazohusishwa na hisia gani kwa madereva wapya. Jumla ya watu 387 walishiriki kwenye dodoso; 197 walikuwa wanaume na 190 wanawake.
Sauti 17 zilitumiwa katika dodoso. Mifano ni mlio wa simu, mvua, siren ya ambulansi, mgongano wa magari, ugomvi, mazingira ya kutisha, muziki wa kutuliza, muziki wenye sauti kubwa, mbwa kubweka, gari kuongeza mwendo, sauti ya breki, honi na kelele.
Chi-square test ilitumika kuchunguza uhusiano kati ya sauti na kategoria ya hisia:
\[ \chi^2= \sum_{i,j} \frac{(O_{ij}-E_{ij})^2}{E_{ij}} \]
Chanzo kiliripoti:
\(\chi^2=1310,791\), p<0,001
Watafiti walitathmini kuwa aina za sauti zilihusishwa kwa kiasi cha maana na usambazaji wa hisia.
Katika correspondence analysis, ilielezwa kuwa kiwango cha jumla cha maelezo cha vipimo viwili kilizidi %80. Kwa tafsiri ya utafiti, honi inayoendelea, ugomvi na mbwa kubweka zilikusanyika karibu na eneo la anger, huku sauti za ghafla kama mgongano zikikusanyika karibu na eneo la surprise.
Matokeo haya ya dodoso yalitumiwa kuchagua mchanganyiko wa stimulus wa “scene + sound” kwa ajili ya simulizi ya baadaye ya kuendesha gari. Matokeo ya dodoso si ushahidi wa moja kwa moja wa mabadiliko ya hisia katika kuendesha gari halisi; ni hatua ya awali ya kuchagua vichocheo vya majaribio.
Majaribio ya kuendesha gari ya tuli na ya video yalipangwaje?
Katika sehemu ya tuli, picha 60 za kuendesha gari mijini zilitumiwa. Kabla ya picha, prompt ya hali ya udereva ilionyeshwa kwa sekunde 3, kisha picha ikaonyeshwa kwa sekunde 10. Maneva yalijumuisha kugeuka, kubadilisha njia, kumkwepa mtembea kwa miguu, msongamano wa magari na kuongeza kasi ili kupita.
Kila kundi lilikuwa na picha 12 na jumla ya makundi matano yaliandaliwa. Chanzo kinasema kila kundi lilidumu takribani dakika 2 na sekunde 35, lakini jaribio lote la tuli lilidumu takribani dakika 30.
Kutokulingana kwa muda: Makundi matano ya dakika 2 na sekunde 35 ni takribani dakika 12 na sekunde 55. Hesabu ya 12 × (sekunde 3+10) pia hutoa takribani dakika 2 na sekunde 36 kwa kila kundi. Chanzo hakijaeleza muda wa ziada wa kusubiri au mapumziko unaoweza kueleza jumla ya dakika 30.
Katika sehemu ya video, video 60 za kuendesha gari mijini zilitumiwa. Video zilitokana na video za mafunzo ya awali ya udereva na zilijumuisha kuendesha moja kwa moja, mzunguko na kusubiri katika makutano.
Kila video ilidumu dakika mbili; video 10 ziliunda kundi moja na jumla ya makundi sita. Mapumziko ya dakika tano yalitolewa kati ya makundi na nine-point eye-tracker calibration ilifanywa kabla ya kila kundi. Muda wote wa jaribio la video uliripotiwa kuwa takribani saa 2 na dakika 30.
Ni vifaa gani vilivyokuwa katika mpangilio wa jaribio?
Mpangilio wa maabara ulijumuisha usukani wa kuiga, clutch, breki, udhibiti wa signal, eye tracker, vifaa vya human-factor, laptop, kamera na headphones.
aSee Pro F100 ilitumika kwa mienendo ya macho na sampling rate ilielezwa kuwa 100 Hz. Programu ya aSee Studio ilitumika kukusanya taarifa za washiriki, pupil data, gaze points, saccade na blink.
Kielelezo 5 cha chanzo kinaonyesha mazingira ya jaribio moja kwa moja: picha ya simulizi ya kuendesha gari ikiwa kwenye monitor, kamera na mfumo wa aSee Pro wa ufuatiliaji wa macho vikiwa mbele ya mshiriki, huku simulator ya usukani ikiwa mbele ya meza. Huu si mfumo wa cabin halisi ya gari bali ni simulizi ya kuendesha gari ya maabara.
Washiriki walikuwa akina nani?
Watu 34 wenye umri wa 18–25 waliingizwa katika jaribio na wastani wa umri uliripotiwa kuwa 22. Washiriki walichaguliwa miongoni mwa walio katika hatua ya kupata leseni ya udereva au wenye uzoefu wa kuendesha gari wa chini ya mwaka mmoja.
Washiriki ambao ufanisi wa jaribio ulikuwa chini ya %90 waliondolewa na hatimaye sampuli yenye ufanisi ya watu 32 ilibaki.
Utafiti pia uliweka vigezo kwa hali zinazoweza kuathiri vipimo vya ufuatiliaji wa macho. Chanzo kinasema contact lens hazikutakiwa kutumika na kwa watumiaji wa miwani prescription haikupaswa kuzidi “500 diopters”. Namba hii imehifadhiwa kama ilivyo katika chanzo; tatizo linalowezekana la kitengo au tafsiri halijasahihishwa kimya kimya.
Washiriki walitoa informed consent na utafiti uliidhinishwa na kamati ya maadili ya Baoji University of Arts and Sciences.
Data za mienendo ya macho ziliandaliwaje?
Chanzo kinaeleza kuwa seti ya awali ya eye-movement ya kila mshiriki ilikuwa na nukta 79.070 za muda. Data ziligawanywa katika madirisha ya muda ya sekunde 5.
Kwa sababu sampling rate ilikuwa 100 Hz, dirisha la sekunde 5 lina takribani nukta 500 za muda; hivyo ingizo la modeli la 500×17 linaendana na muundo huu.
Chanzo pia kina kauli kwamba slicing ilipunguza data “kutoka 79.070 rows hadi takribani 500 rows”. Ingawa kutokana na ingizo la modeli inaweza kueleweka kuwa kila dirisha la sekunde 5 lina takribani rows 500, maandishi hayako wazi kuhusu kiasi cha jumla cha data.
Picha za uso ziliandaliwaje?
Video za uso ziliingizwa kwenye programu ya ErgoLAB facial-expression analysis, na facial feature points pamoja na emotion labels zinazolingana zilipatikana. Kisha video ziligeuzwa kuwa mfululizo wa picha frame-by-frame.
Picha zilibadilishwa kutoka resolution ya 1920×1080 hadi 224×224 pixels na thamani za pixel zikanormalishwa katika safu ya [0,1].
Chanzo kinaeleza kuwa baada ya emotion labels zilizotolewa na programu, manual classification ilifanywa. Hata hivyo, maelezo ya usawazishaji wa ground-truth label ya mwisho ya pamoja kati ya eye-movement windows na facial frames yameelezwa kwa kiwango kidogo katika sehemu ya mbinu.
Modeli ilifunzwa kwa data gani?
| Aina ya data | Idadi ya sampuli |
|---|---|
| Sampuli za mienendo ya macho | 30.000 |
| Sampuli za sura ya uso | 30.000 |
| Kila kategoria ya hisia | 6000 |
Sampuli ziligawanywa katika vikundi vidogo vitano kwa subject. Katika kila mzunguko vikundi vidogo vinne vilitumika kwa mafunzo na kilichobaki kwa validation; mchakato ulikamilika baada ya kila kikundi kutumika mara moja kama validation.
Vigezo vya mafunzo
| Kigezo | Thamani |
|---|---|
| Epoch | 30 |
| Batch size | 32 |
| Initial learning rate | 10−3 |
| Optimizer | Adam |
| Loss | Cross-entropy |
| Validation | Subject-level 5-fold cross-validation |
Matokeo hubadilikaje kwa uso pekee, macho pekee na multimodal?
| Modaliti | Accuracy iliyoripotiwa katika chanzo |
|---|---|
| Picha ya uso | %71,18 |
| Mienendo ya macho | %95,10 |
| Multimodal | %98,72 |
Kulingana na tafsiri ya chanzo yenyewe, ujumbe muhimu zaidi ni kwamba katika kundi hili la majaribio data za mienendo ya macho zilikuwa na uwezo mkubwa zaidi wa kutenganisha madarasa kuliko sura za uso, na kuunganisha modaliti zote mbili kulitoa accuracy ya juu zaidi iliyoripotiwa.
Hii haimaanishi kwamba sura za uso kwa ujumla ni dhaifu kwa utambuzi wa hisia. Matokeo haya yanatumika tu kwa seti hii ya data, kundi hili la washiriki, vichocheo hivi na mpangilio huu wa modeli.
Je, GWF ni bora kuliko concatenation rahisi?
| Mbinu ya Fusion | Accuracy (%) |
|---|---|
| Feature Concatenation | 95,45 |
| GWF Fusion | 98,72 |
Tofauti kamili kati ya thamani hizi mbili ni asilimia-pointi 3,27. Chanzo kinataja matokeo haya kama “%3,27 improvement katika accuracy”.
Kwa nini confusion matrices ni muhimu?
Katika confusion matrix ya Kielelezo 10 ya modeli ya facial-image pekee, jumla ya diagonal kuu ni 3257 na jumla ya sampuli ni 4576:
\[ Accuracy= \frac{3257}{4576} = 0,71176 \approx71,18\% \]
Thamani hii inalingana kabisa na facial-image accuracy iliyoripotiwa katika Kielelezo 8.
Katika modeli ya facial, Class 0 yaani calm inaonekana kuchanganywa hasa na Class 4 “other” na Class 3 “angry”. Chanzo kinafafanua hili kwa kusema kwamba mabadiliko ya uso katika hali ya utulivu yanaweza kuwa madogo zaidi.
Hata hivyo, Kielelezo 11 cha multimodal kinapohesabiwa upya:
| Kipimo | Thamani |
|---|---|
| Jumla ya sampuli za confusion-matrix | 4576 |
| Diagonal kuu / uainishaji sahihi | 4304 |
| Accuracy iliyohesabiwa upya kutoka matrix | ≈ %94,06 |
| Multimodal accuracy iliyoripotiwa katika Kielelezo 8 na Jedwali 3 | %98,72 |
Onyo la uripoti wa kisayansi: Chanzo hakisemi kuwa Kielelezo 11 kinahusu fold tofauti, subset tofauti au sehemu tofauti ya jaribio. Hata hivyo, %94,06 inayopatikana tena kutoka confusion matrix hailingani na %98,72 katika jedwali kuu. Verianla haichagui lipi kati ya matokeo haya mawili ni sahihi; inaweka kutokulingana huku wazi.
Mchango wa Bi-LSTM na Transformer katika modeli ya eye-movement ni upi?
Katika ablation kwa kutumia data za mienendo ya macho pekee:
| Modeli | Accuracy (%) |
|---|---|
| Bi-LSTM | 87,50 |
| Transformer | 94,23 |
| Bi-LSTM + Transformer | 95,10 |
Katika jaribio la multimodal, athari za vipengele vya eye branch ni:
| Eye branch | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Chanzo kinatafsiri matokeo haya kuwa Bi-LSTM huwakilisha utegemezi wa mwelekeo wa muda huku Transformer ikiwakilisha mahusiano ya masafa marefu zaidi, na hivyo vipengele hivi vinakamilishana.
Matokeo katika seti tatu za jumla yanaonyesha nini?
Ili kutotegemea tu mafanikio kwenye data yao wenyewe, watafiti walifanya ulinganisho wa ziada kwenye AFFEC, SEED-IV na AffectNet.
| Seti ya data | Modaliti | Accuracy ya modeli iliyopendekezwa | Macro-F1 |
|---|---|---|---|
| AFFEC | Macho + uso | 91,95 ± 0,87% | 91,36 ± 0,92% |
| SEED-IV | Mienendo ya macho pekee | 90,44 ± 0,75% | 89,81 ± 0,80% |
| AffectNet | Uso pekee | 89,67 ± 0,69% | 89,02 ± 0,73% |
Chanzo kinaripoti kwamba modeli iliyopendekezwa ilionyesha ubora wenye maana ya takwimu katika kiwango cha p<0,05 dhidi ya baseline zote zilizolinganishwa katika seti zote tatu.
Hata hivyo, mpaka wa tafsiri wa sehemu hii ni muhimu sana: AFFEC, SEED-IV na AffectNet si seti za data za kuendesha gari zilizoundwa kwa madereva wapya. Utafiti unasisitiza hili wazi. Matokeo haya yanaunga mkono uwezo wa jumla wa usanifu wa modeli katika utambuzi wa hisia; hayathibitishi utendaji wake katika mazingira halisi ya kuendesha gari.
Ililinganishwaje na mbinu nyingine za utambuzi wa hisia?
| Ishara | Mbinu | Accuracy iliyotolewa katika chanzo |
|---|---|---|
| Macho + sauti + picha | FE-CNN | 81,90% |
| Macho + PPG | FECNN + LSTM | 84,68% |
| Uso + rPPG + macho | Dual-path Transformer | 86,98% |
| EEG + macho | MFFNN | 87,32% |
| EEG | LSTM | 90,72% |
| EEG + ECG + macho | 1D-Inception + Self-Attention + LSTM | 91,38% |
| EEG | CNN-LSTM | 93,97% |
| EEG + uso + ishara za kisaikolojia | GNN | 91,25% |
| Macho + uso | Utafiti huu | 98,72% |
Kwa kuwa jedwali hili linajumuisha tafiti tofauti zenye seti za data, idadi za madarasa, sampuli na itifaki za majaribio tofauti, halipaswi kusomwa kama jedwali la mashindano ya moja kwa moja. Chanzo kinawasilisha thamani hizi kama ulinganisho wa fasihi; si jaribio la head-to-head linalodhibitiwa kwenye benchmark moja.
Je, modeli ni ya wakati halisi?
Chanzo kinatoa wastani wa processing time kwa kila batch kwa modeli ya multimodal kama:
29,42 ± 0,08 ms
imetolewa.
Katika hybrid inference mode, kwa kila sampuli:
0,9230 ± 0,0014 ms
imeripotiwa.
Watafiti wanatafsiri thamani hii kuwa ya kutosha kwa wakati halisi kwa sababu iko chini ya rejea ya latency ya 100–200 ms wanayotumia kwa mwingiliano wa binadamu–mashine ndani ya gari.
Hata hivyo, muda huu si end-to-end latency iliyopimwa katika gari halisi, kwenye embedded ECU ya uzalishaji au kwenye pipeline kamili ya kamera/eye-tracker ya ndani ya gari. Utafiti unaeleza wazi kuwa deployment katika mazingira halisi ya kuendesha gari haikufanywa.
Matokeo yanayoungwa mkono na utafiti
- Usanifu mseto wa utambuzi wa hisia unaotumia picha za uso na eye-tracking data kwa pamoja umetengenezwa.
- ViT-B/16, Bi-LSTM, Transformer encoder, GWF na MLP zimetumika katika multimodal pipeline moja.
- Katika majedwali makuu ya chanzo, accuracy ya %98,72 imeripotiwa kwa modeli ya multimodal.
- Katika modality ablation, chanzo kinaonyesha eye-movement data ilitoa accuracy ya juu kuliko facial-image data.
- GWF imeripotiwa katika chanzo kuwa na accuracy ya juu kuliko feature concatenation rahisi.
- Eye branch ya Bi-LSTM + Transformer ilionyesha utendaji wa juu kuliko ablation zilizotumia Bi-LSTM pekee au Transformer pekee.
- Modeli iliripotiwa juu ya baseline zilizolinganishwa katika seti za jumla za hisia AFFEC, SEED-IV na AffectNet.
- Muda wa inference wa modeli ulipimwa katika kiwango cha millisecond katika mazingira ya kompyuta ya maabara.
Matokeo ambayo utafiti hauungi mkono, haujajaribu au haujathibitisha
- Modeli haijajaribiwa katika trafiki halisi au kuendesha gari halisi.
- Haijaonyeshwa kuwa accuracy ya %98,72 inaweza kuhamishwa kwa madereva wapya nchini Uturuki au kwa makundi mengine ya umri.
- Utafiti huu haukupima kwa majaribio kama utambuzi wa hisia unapunguza ajali za trafiki kwa vitendo.
- Modeli haijathibitishwa chini ya kamera ya ndani ya gari, mwanga wa jua, kuendesha usiku, kufunikwa kwa uso, mwendo mkubwa wa kichwa na mtikisiko wa barabara halisi.
- Hakuna vipimo vya matumizi ya nguvu, RAM, ukubwa wa modeli na end-to-end latency kwenye jukwaa halisi la embedded la gari.
- Mafanikio kwenye seti tatu za data za nje si uthibitisho wa kuendesha gari halisi unaolenga madereva wapya.
- Confusion matrix ya utafiti haithibitishi kwa kujitegemea accuracy kuu iliyoripotiwa ya %98,72.
- Madarasa ya hisia ya modeli hayawezi kutafsiriwa kama kipimo cha kliniki au cha uhakika cha hali halisi ya kisaikolojia ya mtu.
Mbinu na Matokeo ya Utafiti
Vipengele vya msingi vya muundo wa utafiti
| Kipengele | Taarifa iliyotolewa katika chanzo |
|---|---|
| Sampuli ya dodoso | Watu 387 |
| Wanaume/wanawake kwenye dodoso | 197 / 190 |
| Kichocheo cha sauti | Aina 17 |
| Washiriki wa awali wa jaribio | 34 |
| Washiriki wenye ufanisi | 32 |
| Umri | 18–25; wastani 22 |
| Uzoefu wa udereva | Mgombea leseni au uzoefu wa <1 mwaka |
| Eye tracker | aSee Pro F100 |
| Eye-tracking sampling rate | 100 Hz |
| Eye window | 5 s / takribani nukta 500 za muda |
| Ingizo la eye model | 500 × 17 |
| Ingizo la facial-image | 224 × 224 × 3 |
| Madarasa ya hisia | 5 |
Vigezo vya msingi vya usanifu wa modeli
| Moduli | Muundo mkuu |
|---|---|
| Face feature extraction | ViT-B/16; 16×16 patch; classification token ya vipimo 768 |
| Bi-LSTM | 128 hidden unit/kila mwelekeo; matokeo ya pamoja ya vipimo 256 |
| Transformer encoder | 8 head, d-model 256, FFN 512, dropout 0,1, tabaka 2 |
| Fusion | Gated Weighted Fusion |
| Classifier | MLP + Softmax |
Matokeo makuu ya jaribio la multimodal
| Eye feature model | Accuracy | F1 | Precision | Recall |
|---|---|---|---|---|
| Bi-LSTM + Transformer | 98,72% | 98,71% | 98,72% | 98,72% |
| Transformer | 94,84% | 94,83% | 94,85% | 94,84% |
| Bi-LSTM | 94,67% | 94,66% | 94,66% | 94,67% |
Udhibiti wa ubora wa confusion matrix
| Matokeo ya chanzo | Yaliyoripotiwa / yaliyohesabiwa upya | Hali |
|---|---|---|
| Facial-image accuracy | Kielelezo 8: %71,18 / kutoka matrix ya Kielelezo 10: %71,18 | Yanalingana |
| Multimodal accuracy | Kielelezo 8 na Jedwali 3: %98,72 / kutoka matrix ya Kielelezo 11: ≈%94,06 | Hayalingani |
Udhibiti huu umehesabiwa upya na Verianla kwa kutumia seli za Kielelezo 10 na Kielelezo 11 cha chanzo. Hautoi matokeo mapya ya jaribio badala ya chanzo; unakagua tu uthabiti wa kihesabu wa seli zilizochapishwa.
Matokeo katika seti za data za jumla
| Dataset | Accuracy ± Std ya modeli iliyopendekezwa | Macro-F1 ± Std | Dokezo la takwimu la chanzo |
|---|---|---|---|
| AFFEC | 91,95 ± 0,87% | 91,36 ± 0,92% | p<0,05 vs. baseline zote |
| SEED-IV | 90,44 ± 0,75% | 89,81 ± 0,80% | p<0,05 vs. baseline zote |
| AffectNet | 89,67 ± 0,69% | 89,02 ± 0,73% | p<0,05 vs. baseline zote |
Matokeo ya wakati halisi
| Kipimo | Thamani |
|---|---|
| Processing time kwa batch | 29,42 ± 0,08 ms |
| Hybrid inference mode, kwa sampuli | 0,9230 ± 0,0014 ms |
Thamani hizi za utendaji zinahusu hesabu za modeli. Si kipimo cha kweli cha end-to-end latency ndani ya gari kinachojumuisha camera acquisition, eye-tracking acquisition, preprocessing, latency ya mfumo wa uendeshaji, usawazishaji wa sensa na uzalishaji wa tahadhari.
Mapungufu makuu ya utafiti
- Sampuli yenye ufanisi ya madereva ni watu 32 tu.
- Washiriki wako katika kundi la umri wa 18–25 pekee.
- Utofauti wa kitamaduni ni mdogo.
- Hisia ziliibuliwa katika maabara kwa visual na auditory stimulus.
- Matukio halisi yasiyotarajiwa ya barabarani hayakujaribiwa.
- Kuendesha gari halisi hakukutumiwa.
- Mabadiliko ya kawaida ya mwanga ndani ya gari, head movement na facial occlusion hayakuthibitishwa kwa upana.
- Embedded deployment halisi haikufanywa.
- Kuna kutokulingana kwa namba kusikoelezwa kati ya multimodal confusion matrix na matokeo makuu ya accuracy.
- Vipimo vya feature vya GWF havijaelezwa kikamilifu kati ya milinganyo ya mbinu na mchoro wa usanifu.
Maelezo ya Chanzo na Mbinu
Jina kamili la awali la utafiti: Hybrid Deep Neural Network-Based Modeling of Multimodal Emotion Recognition for Novice Drivers
Waandishi na mpangilio wao: Jianzhuo Li; Ye Yu; Zhao Dai; Panyu Dai.
Mwandishi wa mawasiliano: Jianzhuo Li.
Mwandishi wa kwanza wa pamoja/mchango sawa: Haijaelezwa katika chanzo.
Taasisi: School of Computer Science, Baoji University of Arts and Sciences, Baoji 721016, China.
Jarida: Future Internet
Mchapishaji: MDPI, Basel, Switzerland
Juzuu / toleo / makala: 18 / 4 / 221
Tarehe ya kupokelewa: 27 Februari 2026
Tarehe ya marekebisho: 17 Aprili 2026
Tarehe ya kukubaliwa: 18 Aprili 2026
Tarehe ya kuchapishwa: 21 Aprili 2026
DOI: 10.3390/fi18040221
Kiungo rasmi cha chapisho:https://doi.org/10.3390/fi18040221
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wenzao; jaribio la maabara la kuendesha gari kwa simulizi, uchanganuzi wa data ya eye-tracking/facial-image na modeli ya ujifunzaji wa kina.
Hali ya mapitio: Utafiti umechapishwa katika jarida la kisayansi lililopitiwa na wenzao.
Leseni: Creative Commons Attribution (CC BY).
Toleo: Faili iliyochunguzwa imeitwa v2. Dokezo la toleo la mchapishaji linaonyesha kuwa kuna updated version of record ya utafiti. Upeo wa sasisho haujakisiwa nje ya maudhui ya kisayansi ya makala iliyochunguzwa.
Idhini ya maadili: Utafiti unaripoti kuwa uliendeshwa kwa mujibu wa Azimio la Helsinki na unatoa namba ya idhini ya Baoji University of Arts and Sciences Institutional Review Board kuwa BJWL-2025-ETH-048, na tarehe ya idhini 7 Januari 2025.
Ridhaa iliyoarifiwa: Chanzo kinaripoti kuwa washiriki wote walielezwa lengo na taratibu za utafiti na walitia saini informed-consent form inayokubali matumizi ya data kwa utafiti wa kisayansi.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Imeelezwa kuwa seti za data zilizotumiwa zinaweza kupatikana kutoka kwa mwandishi wa mawasiliano kwa ombi linalofaa.
Mgongano wa maslahi: Waandishi wametangaza kuwa hakuna mgongano wa maslahi.
Michango ya waandishi: Kulingana na tamko la chanzo, conceptualization Ye Yu; methodology Ye Yu, Zhao Dai na Panyu Dai; software Ye Yu na Panyu Dai; validation, formal analysis, investigation na data curation Ye Yu; rasimu ya awali Ye Yu; review/editing Jianzhuo Li; visualization Ye Yu; supervision na project administration Jianzhuo Li.
Kutokulingana kwa namba ndani ya chanzo 1 — confusion matrix: Accuracy iliyohesabiwa upya kutoka seli za facial-image confusion matrix ni %71,18 na inalingana na Kielelezo 8. Katika multimodal confusion matrix, sampuli 4304 kati ya 4576 ziko kwenye diagonal kuu na accuracy iliyohesabiwa upya ni takribani %94,06. Thamani hii hailingani na %98,72 katika Kielelezo 8 na Jedwali 3. Chanzo hakielezi seti tofauti ya tathmini au fold tofauti.
Kutokulingana kwa usanifu ndani ya chanzo 2 — vipimo vya feature: Mbinu ya ViT inafafanua matokeo ya classification-token kuwa ya vipimo 768, huku Kielelezo 1 kikionyesha ingizo la tawi la uso kwa GWF kama 256×1. GWF Equation (19) huzalisha weighted-sum ya vipimo C kutoka kwenye ingizo mbili za vipimo C, lakini Kielelezo 1 kinaonyesha matokeo ya 512×1. Mabadiliko ya kati hayajaelezwa wazi.
Kutokulingana kwa muda ndani ya chanzo 3: Makundi matano ya jaribio la tuli yameelezwa kuwa kila moja lilidumu takribani dakika 2 na sekunde 35; hii ni takribani dakika 12 na sekunde 55. Muundo wa stimulus wa picha 12 × sekunde 13 pia hutoa muda unaokaribiana. Hata hivyo, chanzo kinaripoti muda wote wa jaribio la tuli kuwa takribani dakika 30 na sababu ya tofauti haijaelezwa.
Dokezo la kitengo ndani ya chanzo 4: Katika kigezo cha uteuzi wa washiriki, chanzo kina kauli “500 diopters” kwa prescription ya miwani. Hitilafu inayowezekana ya kitengo/tafsiri haijasahihishwa kwa kudhani taarifa kutoka nje ya chanzo.
Kauli ya utendaji wa GWF: Chanzo kinaripoti accuracy ya %95,45 kwa feature concatenation na %98,72 kwa GWF, na kinaita ongezeko hilo %3,27. Tofauti kamili kati ya accuracy mbili zilizoripotiwa ni asilimia-pointi 3,27.
Dokezo la ground-truth/labeling: Video za facial expression zilichanganuliwa kwa programu ya ErgoLAB, emotion labels zikatolewa na kisha manual classification ikafanywa. Ingawa imetajwa kuwa eye-movement samples zilipewa lebo za makundi matano, utaratibu wa kuunda na kusawazisha ground-truth label ya mwisho ya pamoja ya modaliti mbili haujaelezwa kwa undani katika chanzo.
Mpaka wa ujanibishaji: Validation kwenye AFFEC, SEED-IV na AffectNet ni kazi za jumla za utambuzi wa hisia. Chanzo kinasisitiza kwamba seti hizi si novice-driver au driving-specific. Kwa hiyo, matokeo haya hayakutumiwa kama uthibitisho wa moja kwa moja kwa mazingira halisi ya kuendesha gari.
Mpaka wa wakati halisi: Thamani za 29,42 ms/batch na 0,9230 ms/sample ni vipimo vya model processing. Utafiti haukufanya embedded system deployment halisi ndani ya gari wala kupima end-to-end latency katika mazingira halisi ya kuendesha gari.
Mbinu, seti za data, milinganyo, matokeo ya uainishaji, majedwali, tafsiri za vielelezo na mapungufu katika maelezo haya ya Verianla yanategemea utafiti wa kisayansi uliokaguliwa. Uthibitishaji wa bibliografia kutoka nje ulitumiwa tu kuthibitisha vipengele vya utambulisho wa chanzo kama DOI, jarida, mchapishaji, hali ya mapitio na toleo la chapisho; hakuna matokeo mapya ya utambuzi wa hisia au thamani mpya ya utendaji iliyoongezwa kutoka vyanzo vya nje.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *