

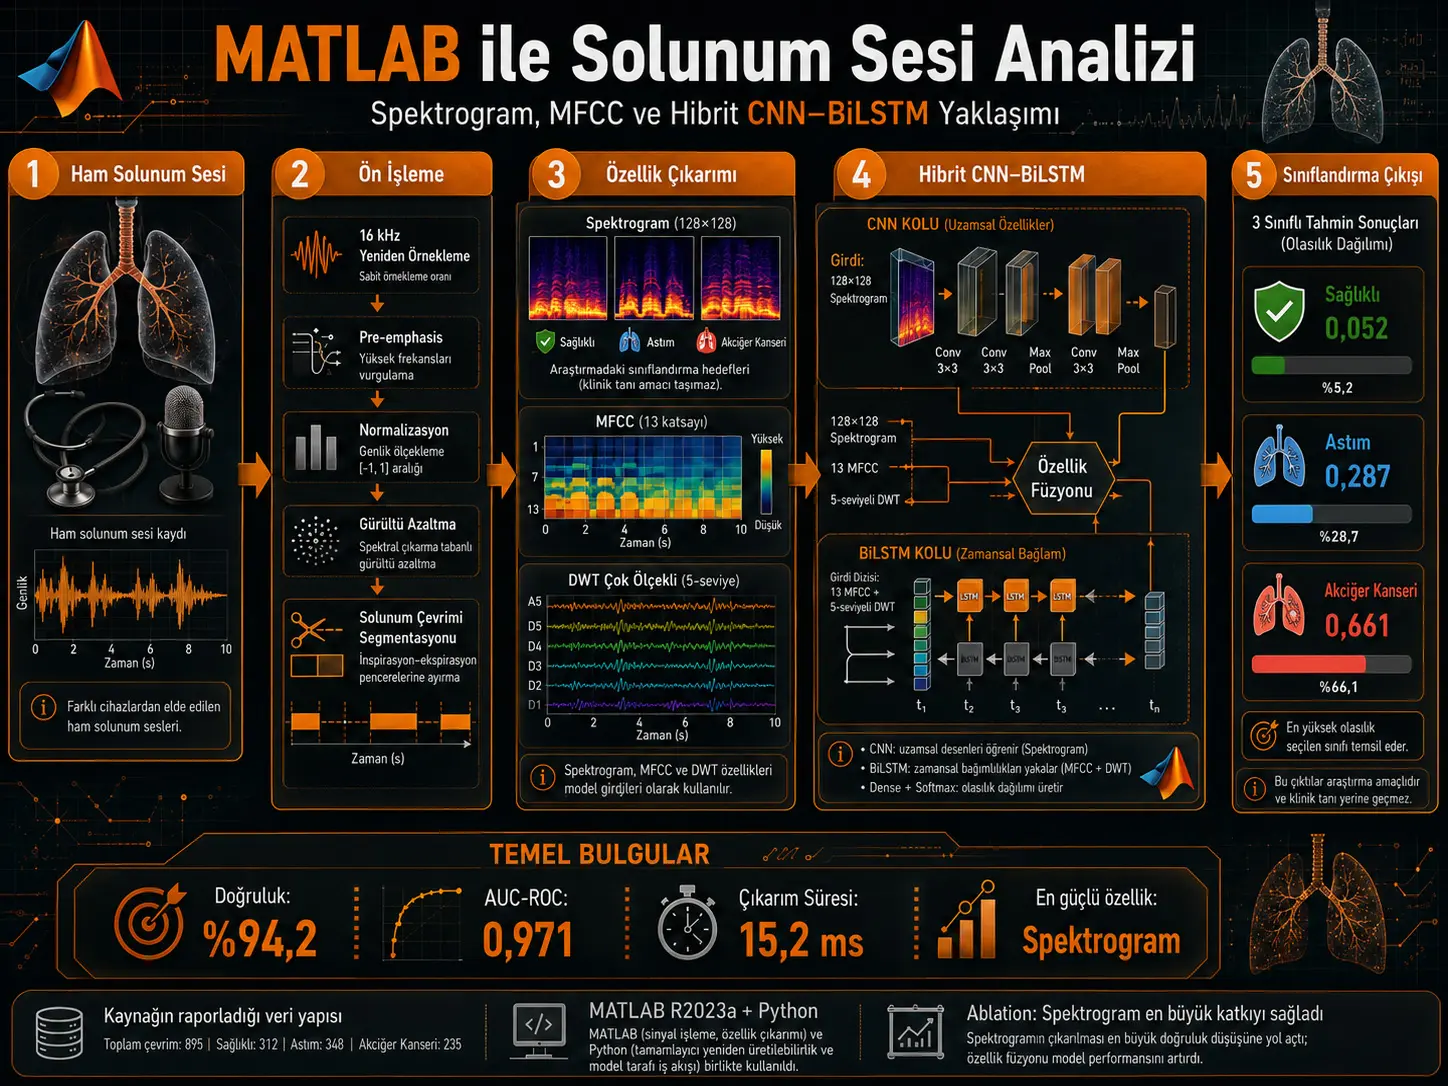
Tadqiqot nafas olish tovushlarini vaqt–chastota tasvirlariga aylantirib, ularni CNN–BiLSTM modeli yordamida uch sinfga ajratishni maqsad qilgan ikki platformali biotibbiy signalni qayta ishlash ish oqimini tavsiflaydi. MATLAB xom nafas olish tovushini qayta namunalash, filtrlash, normallashtirish, spektrogramma/MFCC/DWT asosidagi xususiyatlarni ajratib olish va natijalarni tasdiqlash uchun qo‘llanilgan ikkita asosiy hisoblash platformasidan biridir. Ikkinchi platforma Python hisoblanadi.
Manba uchta maqsadli yorliqni Healthy, Asthma va Lung Cancer deb belgilaydi. Biroq bu uch sinfli tasnif, ayniqsa “Lung Cancer” sinfi yuqorida qayd etilgan ma’lumot manbasini tasdiqlash muammosi sababli klinik tashxis muvaffaqiyati sifatida talqin qilinmasligi kerak. Ushbu Verianla maqolasi tadqiqotni avvalo MATLAB asosidagi nafas olish tovushlarini qayta ishlash va CNN–LSTM arxitekturasi nuqtayi nazaridan ko‘rib chiqadi.
Qisqa Xulosa
Manba tadqiqot ICBHI 2017 Respiratory Sound Database bazasidan tanlanganini bildirgan 895 ta nafas olish sikli ustida spektrogramma, Mel-Frequency Cepstral Coefficients (MFCC), Discrete Wavelet Transform (DWT) va vaqt-soha xususiyatlaridan foydalanuvchi gibrid CNN–BiLSTM tasniflagichini taklif etadi. Tovushlar avval 16 kHz ga qayta namunalab olinadi, pre-emphasis qo‘llanadi, z-score normallashtirish va spectral-subtraction shovqinni kamaytirish bajariladi, so‘ng nafas olish sikllari energy-envelope va zero-crossing-rate chegaralari yordamida segmentlarga ajratiladi. CNN tarmog‘i 128×128 kulrang darajali spektrogrammalardan fazoviy xususiyatlarni ajratar ekan, BiLSTM tarmog‘i MFCC asosidagi vaqt ketma-ketligini qayta ishlaydi. Manbaga ko‘ra birlashtirilgan model test to‘plamida %94,2 accuracy, %93,9 precision, %93,5 recall, %93,6 F1-score va 0,971 AUC-ROC natijalarini bergan. Ablation natijasida spektrogrammani olib tashlash accuracy ni 8,5 foiz punktga pasaytirib, eng katta yo‘qotishga sabab bo‘lgan. Model uchun bildirilgan inference vaqti 15,2 ms/model kirishi darajasida. Biroq tadqiqotdagi o‘pka saratoni yorliqlari ICBHI 2017 ning tasdiqlanishi mumkin bo‘lgan diagnostik tuzilmasiga mos kelmagani sababli bu ko‘rsatkichlar tasdiqlangan klinik o‘pka-saratoni diagnostika mezonlari sifatida qabul qilinmasligi kerak.
Nafas olish tovushidan kasallik tasnifi qanday qilib MATLAB muammosiga aylanadi?
O‘pka tovushi yozuvi kompyuterga kiritilganda model hali “astma” yoki boshqa klinik ma’noni ko‘rmaydi. MATLAB nuqtayi nazaridan boshlang‘ich nuqta faqat vaqt bo‘yicha o‘zgaruvchi sonli amplituda namunalaridir. Shuning uchun tadqiqotning hisoblash zanjiri avvalo xom tovushni standart namunalash tuzilmasiga keltiradi, keyin shovqinni kamaytiradi va vaqt–chastota xususiyatlarini ajratib oladi. Chuqur o‘rganish modeli faqat shu bosqichlardan keyin ishga tushadi.
Manbaning 2-sahifadagi 1-rasmi bu zanjirni beshta asosiy blok bilan ko‘rsatadi: Raw Audio Input → Signal Preprocessing → Feature Extraction → CNN-LSTM Model → Classification Output. Ma’lumotlarni ko‘paytirish faqat trening vaqtida qo‘llanadigan ixtiyoriy bosqich sifatida ko‘rsatilgan.
Ma’lumotlar to‘plami manbaga ko‘ra qanday bo‘lingan?
Manba ICBHI 2017 dagi 920 ta yozuvdan sifat filtri qo‘llanganidan so‘ng 895 ta nafas olish siklidan foydalanganini bildiradi. Manba keltirgan jadval quyidagicha:
| Manba sinf yorlig‘i | Nafas olish sikli | Ulush (%) | Training | Validation | Test |
|---|---|---|---|---|---|
| Healthy | 312 | 34,8 | 218 | 47 | 47 |
| Asthma | 348 | 38,9 | 244 | 52 | 52 |
| Lung Cancer | 235 | 26,3 | 165 | 35 | 35 |
| Jami | 895 | 100 | 627 | 134 | 134 |
Ushbu jadval manba maqolaning o‘z eksperimental dizaynini to‘g‘ri aks ettiradi. Biroq ayniqsa 235 ta Lung Cancer sikli ICBHI ma’lumotlar to‘plamidan qanday olingani tushuntirilmagan va tashqi ma’lumotlar to‘plami tekshiruvi bilan mos kelmaydi. Shu sababli keyingi barcha ishlash ko‘rsatkichlari jadvallari “manba xabar qilgan tasnif” sifatida o‘qilishi kerak.
3-sahifadagi uchta spektrogramma nimani anglatadi?
Manba 2-rasmda bir xil STFT tasvirlash formatida Healthy, Asthma va Lung Cancer deb yorliqlangan uchta misolni ko‘rsatadi. Healthy namunasi past energiyali va bir tekisroq, Asthma namunasi ayniqsa 500–2500 Hz oralig‘ida gorizontal/uzluksiz yuqori energiya diapazonlariga ega, Lung Cancer deb yorliqlangan namuna esa tartibsiz yuqori chastotali qisqa energiya portlashlari ko‘rinishida talqin qilingan.
Bu tasvirlar CNN tarmog‘i nima sababdan qo‘llanmoqchi bo‘lganini tushuntiradi: CNN faqat umumiy energiyaga qaramaydi; spektrogrammadagi mahalliy shakl, diapazon, chekka va vaqt–chastota teksturalarini o‘rganishga intiladi. Biroq ma’lumot yorlig‘i muammosi hal qilinmasdan turib, vizual naqshlarning o‘pka saratoniga xos klinik biomarker ekanini ilgari surib bo‘lmaydi.
MATLAB preprocessing zanjiri
Manba preprocessing jarayonini beshta ketma-ket bosqichga ajratadi. Birinchi bosqich barcha yozuvlarni 16 kHz namunalash chastotasiga keltirishdir. Shu tariqa turli original sampling rate ga ega yozuvlar bir xil vaqt o‘qida qayta ishlanishi mumkin. Ikkinchi bosqichda koeffitsiyenti \(\alpha=0.97\) deb berilgan first-order pre-emphasis qo‘llanadi. Uchinchi bosqichda z-score amplitude normalisation, to‘rtinchi bosqichda spectral-subtraction noise reduction va oxirgi bosqichda energy-envelope bilan zero-crossing-rate thresholding asosidagi respiratory-cycle segmentation bajariladi.
Manba bu amallar MATLAB R2023a da Audio Toolbox va Signal Processing Toolbox yordamida, parallel tekshirish maqsadida esa Python da ham bajarilganini bildiradi. Muhim manba yaxlitligi muammosi shundaki, preprocessing tenglamalariga Eq. 1, Eq. 9 va Eq. 10 shaklida havolalar berilgan bo‘lsa-da, ushbu tenglamalar yuklangan PDF da ko‘rinmaydi. Shu sababli Verianla bu yerda yetishmayotgan formulalarni umumiy bilim asosida to‘ldirmaydi.
Spektrogramma nima uchun 128×128 pikselga aylantiriladi?
Manba CNN kirishini 128×128×1 grayscale spectrogram deb belgilaydi. Bu yerda dastlabki ikki son tasvirning vaqt–chastota tekisligidagi o‘lchamini, oxirgi son esa bitta kulrang darajali kanalni ifodalaydi.
CNN uchun qat’iy kirish o‘lchami muhim. Turli nafas olish sikllarining davomiyligi o‘zgarsa ham, modelning convolution qatlamlariga bir xil geometrik o‘lchamdagi ma’lumot berilishi kerak. Manba ushbu standartlashtirishning aniq resize usulini tushuntirmaydi; faqat yakuniy spektrogramma o‘lchamini beradi.
MFCC nima va manbada nechta koeffitsiyent ishlatilgan?
Manba feature-extraction tasvirida har bir nafas olish namunasi uchun 13 MFCC coefficient olinganini ko‘rsatadi. MFCC lar tovushning spektral qobig‘ini yanada siqilgan ko‘rinishda ifodalash uchun ishlatiladi.
Tadqiqot arxitekturasi nuqtayi nazaridan spektrogramma va MFCC bir xil ma’lumotni bir xil shaklda ifodalamaydi. Spektrogramma CNN ga ikki o‘lchamli tasvir beradi, MFCC ketma-ketligi esa BiLSTM tarmog‘iga vaqt ketma-ketligi sifatida uzatiladi. Shu tariqa biri fazoviy vaqt–chastota tuzilmasini, ikkinchisi ketma-ket akustik dinamikani o‘rganishga intiladi.
DWT nima uchun alohida ishlatilgan?
Manba DWT uchun Daubechies-4 (db4) wavelet va 5 level decomposition ishlatilganini bildiradi. Wavelet tahlili qisqa muddatli o‘tkinchi hodisalarni turli masshtablarda ifodalash imkonini beradi. Tadqiqot ayniqsa crackle ga o‘xshash qisqa muddatli o‘tkinchi axborot wavelet yordamida qo‘shimcha tarzda ushlanishi mumkinligini taxmin qiladi.
Ablation natijalari ushbu xususiyatlar guruhini olib tashlash accuracy ni %94,2 dan %91,8 gacha tushirganini, ya’ni manba tajribasida 2,4 foiz punktlik hissa bilan bog‘langanini ko‘rsatadi.
4-sahifadagi xususiyatlar tarkibi
Manbaning 6-rasmidagi doiraviy diagramma xususiyatlar tarkibini vizual ravishda taxminan to‘rt guruhga ajratadi: spektrogramma, MFCC, DWT statistics va time-domain xususiyatlari. Xuddi shu rasm o‘ng tomonda 36-dimensional numerical feature vector ni ko‘rsatadi.
Biroq ayni sahifadagi arxitektura matni BiLSTM “MFCC sequence” ni qayta ishlashini aytadi. DWT va time-domain o‘zgaruvchilari 36 o‘lchamli vektor orqali BiLSTM ga beriladimi, alohida dense qatlamga kiradimi yoki MFCC sequence ga qanday qo‘shiladimi — bu ochiq ko‘rsatilmagan. Ushbu yetishmovchilik tadqiqotni MATLAB muhitida aynan qayta ishlab chiqmoqchi bo‘lgan kishi uchun muhimdir.
CNN tarmog‘i qanday qurilgan?
CNN tarmog‘i uchta convolutional block ni o‘z ichiga oladi. Manba filtrlar sonini mos ravishda 32, 64 va 128 deb beradi. Har bir blokda batch normalisation, 2×2 max-pooling va \(p=0.25\) dropout ishlatiladi.
Ushbu tarmoq oxirida:
\[ f_{\mathrm{CNN}}\in\mathbb{R}^{128} \]
o‘lchamli ifoda olinishi va CNN tarmog‘i taxminan 1,2 million parametr o‘z ichiga olishi bildiriladi.
Convolution filtrlari butun spektrogrammani bir yo‘la yodlash o‘rniga kichik hududlar ustida qayta ishlatiladigan filtrlar bilan ishlaydi. Chuqurroq qatlamlarga o‘tilganda oddiy mahalliy energiya naqshlaridan murakkabroq vaqt–chastota naqshlariga tomon ifoda shakllantirish maqsad qilinadi.
BiLSTM tarmog‘i qanday ishlaydi?
Manbaga ko‘ra BiLSTM tarmog‘ida ikkita bidirectional LSTM layer mavjud. Birinchisi 128 unit, ikkinchisi 64 unit ni o‘z ichiga oladi.
Tarmoq oxirida:
\[ f_{\mathrm{LSTM}}\in\mathbb{R}^{128} \]
o‘lchamli ifoda hosil qilinadi va bu tarmoq taxminan 0,8 million parametr ga ega ekani xabar qilinadi.
“Bidirectional” atamasining ahamiyati shundaki, MFCC vaqt qadami faqat undan oldingi namunalar bilan emas, balki trening paytida ketma-ketlikning keyingi qismidagi kontekst bilan birga ifodalanishi mumkin. Shu tariqa nafas olish siklining vaqt bo‘yicha rivojlanishi CNN ning spektrogramma naqshlarini to‘ldiruvchi ikkinchi axborot kanaliga aylanadi.
Ikki model qanday birlashtiriladi?
Manba ochiq ko‘rsatgan fusion amali:
\[ f_{\mathrm{fused}} ================== [f_{\mathrm{CNN}};f_{\mathrm{LSTM}}] \in\mathbb{R}^{256} \]
ko‘rinishidadir.
128 o‘lchamli CNN va 128 o‘lchamli BiLSTM chiqishi ketma-ket birlashtirilib, 256 o‘lchamli feature-fusion vektori olinadi. Shundan so‘ng manba:
Dense(128) → Dropout(0.5) → Dense(3) → Softmax
zanjirini belgilaydi.
Oxirgi Dense(3) qatlamidagi uchta chiqish manba Healthy, Asthma va Lung Cancer deb belgilagan uchta sinfni ifodalaydi.
Model nima uchun taxminan 2,1 million parametrga ega?
Manba hisoblash jadvalida butun CNN–LSTM tizimi taxminan 2,1 million trainable parameter bilan xabar qilingan. CNN tarmog‘i taxminan 1,2 million, BiLSTM tarmog‘i taxminan 0,8 million deb berilgani sababli qolgan parametrlar fusion dan keyingi dense tasniflash qismini ham o‘z ichiga oladi.
Class imbalance qanday hisobga olingan?
Manba sinflar o‘rtasidagi namuna sonlari teng bo‘lmagani sababli multi-class cross-entropy loss ichida class weights dan foydalanadi:
\[ w_c= \frac{N}{C,N_c} \]
Bu yerda \(N\) umumiy namuna sonini, \(C\) sinflar sonini va \(N_c\) tegishli sinfga mansub namuna sonini ifodalaydi. Shu tariqa kam namunali sinflardagi xatolarning loss funksiyasidagi og‘irligini oshirish maqsad qilinadi.
Trening parametrlari
| Trening parametri | Manba qiymati |
|---|---|
| Optimiser | Adam |
| Learning rate | 0,001 |
| \(\beta_1\) | 0,9 |
| \(\beta_2\) | 0,999 |
| Batch size | 32 |
| Maksimal epoch | 100 |
| Early-stopping patience | 15 |
| Cross-validation | 5-fold stratified |
| Time stretching | ×0,9–1,1 |
| Pitch shifting | ±2 semitone |
| Gaussian noise | \(\sigma=0.005\) |
Data augmentation faqat training tomoniga qo‘llanadi. Bu farq muhim: test ma’lumotlariga augmentation qo‘llanishi ishlash ko‘rsatkichini o‘lchash mazmunini o‘zgartirishi mumkin edi.
Early stopping nima uchun kerak?
Manbada maksimal trening 100 epoch deb belgilangan bo‘lsa-da, validation loss minimal qiymatiga taxminan 45-epoch atrofida yetgan va eng yaxshi model shu nuqtada checkpoint qilingan. Early stopping taxminan 60-epoch atrofida ishga tushgan.
Manba xabar qilgan training loss boshida 1,098 bo‘lgan va 0,142 gacha tushgan; minimal validation loss esa 0,186 bo‘lgan. Mualliflar train va validation egri chiziqlari orasidagi tor farqni jiddiy overfitting kuzatilmagani sifatida talqin qiladilar.
Beshta turli modelning taqqoslanishi
Manbaning o‘z tajribalari doirasida gibrid model barcha bir tarmoqli baseline modellardan yuqoriroq natija beradi. CNN va BiLSTM ning birlashishi manbada faqat spektrogramma yoki faqat MFCC dan foydalanishga nisbatan yuqoriroq ko‘rsatkich bilan bog‘langan.
Accuracy nima uchun yolg‘iz o‘zi yetarli emas?
Accuracy barcha to‘g‘ri qarorlarning ulushidir; biroq sinflar muvozanatsiz bo‘lsa, u yolg‘iz o‘zi chalg‘itishi mumkin. Shu sababli manba precision, recall, F1-score, specificity, ROC-AUC va confusion matrix ni ham xabar qiladi.
Bu yondashuv MATLAB va sun’iy intellektni o‘rganish nuqtayi nazaridan juda qimmatli. Ayniqsa sog‘liqni saqlash tasniflarida model faqat “nechta namunani to‘g‘ri topgani” emas, balki ma’lum sinfdagi haqiqiy holatlarni qanchalik ulushda aniqlay olgani ham muhim.
Manbaning sinf bo‘yicha natijalari
| Manba yorlig‘i | Precision (%) | Recall (%) | F1 (%) | Specificity (%) | Test namunasi |
|---|---|---|---|---|---|
| Healthy | 95,7 | 96,2 | 95,9 | 97,8 | 47 |
| Asthma | 92,8 | 94,1 | 93,4 | 96,2 | 52 |
| Lung Cancer | 93,1 | 89,2 | 91,1 | 97,5 | 35 |
| Macro average | 93,9 | 93,2 | 93,5 | 97,2 | 134 |
Manba eng past recall qiymati %89,2 bilan Lung Cancer yorlig‘ida ekanini; buni sinf muvozanatsizligi va Asthma bilan 500–2500 Hz hududidagi o‘xshash wheeze akustikasi bilan bog‘laydi. Bu izoh manba mualliflarining talqinidir; ma’lumot yorliqlarining klinik kelib chiqishi tasdiqlanmagani sababli u mustaqil klinik xulosa sifatida qabul qilinmasligi kerak.
Confusion matrix ning haqiqiy sonlari
6-sahifadagi 5-rasm 134 namunali test to‘plami uchun xom sonlarni aniq ko‘rsatadi:
| Haqiqiy \ Bashorat | Healthy | Asthma | Lung Cancer |
|---|---|---|---|
| Healthy | 45 | 2 | 0 |
| Asthma | 2 | 48 | 1 |
| Lung Cancer | 0 | 4 | 33 |
Manbaning o‘z talqinida eng katta yagona off-diagonal xato to‘rtta Lung Cancer namunasining Asthma deb tasniflanishidir.
ROC tahlili
| Manba yorlig‘i | One-vs-rest AUC |
|---|---|
| Healthy | 0,978 |
| Asthma | 0,969 |
| Lung Cancer | 0,965 |
Manba barcha ROC egri chiziqlari tasodifiy tasniflagichning 0,5 AUC chizig‘idan yuqorida joylashganini bildiradi. Besh qatlamli cross-validation uchun %95 confidence interval soyali sohalari 7-rasmda ko‘rsatilgan.
Ablation study nima?
Ablation tadqiqotida modelning bir komponenti yoki xususiyatlar guruhi navbatma-navbat olib tashlanadi va natija qanchalik pasayishi kuzatiladi. Shu tariqa model qaysi axborot kanaliga ko‘proq bog‘liqligi aniqlanishga harakat qilinadi.
Manbaning eng aniq modellashtirish natijasi shu: spektrogramma olib tashlanganda ko‘rsatkich eng keskin pasayadi. Shunga qaramay, faqat spektrogramma modeli %91,1 darajasida qolsa, barcha xususiyatlarning birlashuvi %94,2 ga yetadi. Mualliflar buni turli xususiyat modalitetlari bir-birini to‘ldiruvchi axborot tashishi bilan izohlaydilar.
BiLSTM hissasi qanday o‘lchangan?
Manba CNN-only baseline ning %88,6 aniqligini gibrid tizimning %94,2 natijasi bilan taqqoslaydi; shuningdek frequency-sensitivity bo‘limida BiLSTM temporal component CNN-only tuzilishga nisbatan 3,1 foiz punktlik hissa berganini bildiradi. Bu ikki bayonot to‘g‘ridan-to‘g‘ri bir xil arifmetik farq emas; manbada turli kontekstlarda xabar qilingan va bu yerda bir-biriga aylantirilmaydi.
Qaysi chastota sohasi ko‘proq ajratuvchan?
Manba frequency-band sensitivity tahlilida ajratuvchi axborotning:
| Chastota oralig‘i | Manba xabar qilgan hissa | Manba talqini |
|---|---|---|
| 0–500 Hz | %23 | Normal breath |
| 500–2500 Hz | %45 | Wheeze patterns |
| 2500–8000 Hz | %32 | Crackles / high-frequency information |
tarqalishini bildiradi. Biroq bu %23/%45/%32 qiymatlari qaysi matematik sensitivity hisobidan olingani maqolada batafsil aniqlanmagan.
Hisoblash ko‘rsatkichlari
| Model | Parametr (M) | Training (daq) | Inference (ms) | Xotira (MB) |
|---|---|---|---|---|
| SVM + MFCC | — | 12,3 | 2,1 | 45 |
| Random Forest | — | 18,7 | 5,4 | 128 |
| CNN | 1,2 | 142,5 | 8,3 | 156 |
| BiLSTM | 0,8 | 98,4 | 12,7 | 98 |
| CNN–LSTM | 2,1 | 215,8 | 15,2 | 234 |
Ushbu jadval mashinali o‘rganishdagi muhim haqiqatni ko‘rsatadi: manbada eng yuqori accuracy ni bergan model bir vaqtning o‘zida eng uzun training vaqtiga va eng katta xotira sarfiga ega. Murakkabroq model har bir mezonda avtomatik ravishda “yaxshiroq” emas; aniqlik va hisoblash xarajati o‘rtasida dizayn kompromissi mavjud.
15,2 ms nimani anglatadi?
Manba CNN–LSTM uchun 15,2 ms inference vaqtini xabar qiladi va buni 400 ms oynali streaming audio uchun 25 ms talabidan qisqaroq bo‘lgani sababli real-vaqt foydalanishiga mos deb talqin qiladi.
Bu yerda e’tibor berish kerak bo‘lgan narsa ifoda birligidir. Jadvalda “Inference (ms)” yozilgan bo‘lsa, matnda “15.2 ms/sample” deyiladi. Agar “sample” bu yerda bitta 16 kHz audio sample ni anglatsa, bu talqin to‘g‘ri bo‘lmas edi. Manba kontekstiga ko‘ra nazarda tutilgani bir model namunasi / tahlil oynasi bo‘lishi ehtimolroq; biroq maqola buni ochiq aniqlamaydi.
Statistik ahamiyatlilik testi
Manba besh qatlamli cross-validation natijalari ustida paired t-test qo‘llaganini bildiradi:
| Taqqoslash | t | p |
|---|---|---|
| CNN–LSTM vs CNN | 3,42 | 0,026 |
| CNN–LSTM vs BiLSTM | 4,18 | 0,013 |
| CNN–LSTM vs Random Forest | 6,73 | 0,002 |
Uchala taqqoslashda ham manba \(p<0.05\) natijasiga keladi. Biroq faqat beshta fold ustida t-test qo‘llash kichik namunali statistik taqqoslash hisoblanadi; ishlash ko‘rsatkichi haqidagi da’voning ma’lumot yorlig‘i va subject leakage kabi asosiy ma’lumot muammolarini o‘zi hal qilmaydi.
Adabiyotda yuqoriroq accuracy mavjud bo‘lsa, nega manba %94,2 ni muhim deb biladi?
Maqola o‘z usulini mutlaq accuracy rekordi deb da’vo qilmaydi. Manba 6-jadvalda Zhang va hamkasblarining 2024-yildagi dual-channel CNN-LSTM usuli %99,01 accuracy xabar qilganini ochiq tan oladi.
Mualliflarning o‘z hissasi haqidagi da’vosi ko‘proq uch jihatga qaratilgan: uch sinfli disease classification, MATLAB/Python ikki platformali qayta ishlab bo‘lishi va inference latency / memory footprint kabi hisoblash profilining xabar qilinishi.
Biroq birinchi hissadagi “lung cancer” sinfining ma’lumot kelib chiqishi tasdiqlanmagani sababli bu hissa Verianla tomonidan isbotlangan klinik yangilik sifatida qabul qilinmaydi.
MATLAB nuqtayi nazaridan ushbu tadqiqotdan nimani o‘rganish mumkin?
Tadqiqotning eng foydali tomoni bitta chuqur o‘rganish tarmog‘i emas, balki boshidan oxirigacha muhandislik zanjiridir. MATLAB o‘rganayotgan kishi bu yerda quyidagi bog‘liqlikni ko‘rishi kerak: xom signal standartlashtirilmasdan modelni o‘qitib bo‘lmaydi; spektrogramma va MFCC kabi ifodalar turli axborotni tashiydi; CNN va LSTM turli ma’lumot geometriyalarini qayta ishlaydi; sinf muvozanatsizligi loss dizayniga ta’sir qiladi; augmentation faqat treningda qo‘llanishi kerak; training accuracy o‘zi yetarli emas; validation, test, confusion matrix, ROC, ablation va cross-validation turli savollarga javob beradi; bundan tashqari model xotirasi va inference vaqti ham real tizim dizaynining bir qismidir.
Shu sababli MATLAB dagi biotibbiy sun’iy intellekt loyihasi “signalni spectrogram ga aylantirib neural network ga berishdan” ancha kengdir. Ma’lumot kelib chiqishi va bemor yorliqlarining to‘g‘riligi hatto kodning o‘zidan oldin turadi. Ushbu tadqiqot aynan shu nuqtada juda o‘rgatuvchi qarshi misolni ham taqdim etadi: hisoblash zanjiri qanchalik rivojlangan bo‘lmasin, maqsadli yorliqlarning manbasi tasdiqlanmasa, model ko‘rsatkichlarining klinik ma’nosi zaiflashadi.
Tadqiqot Usuli va Natijalari
Manbaning tadqiqot savollari
Maqola to‘rtta tadqiqot savolini belgilaydi. Birinchi savol spektrogramma xususiyatlari nafas olish tovushi sinflarini klinik jihatdan mazmunli sensitivity bilan ajrata oladimi. Ikkinchi savol gibrid CNN–LSTM arxitekturasi bir-model baseline lardan ustun keladimi. Uchinchi savol qaysi feature modality accuracy ga eng katta hissa qo‘shadi. To‘rtinchi savol tizim real-vaqt foydalanishiga yetarli hisoblash ko‘rsatkichiga egami.
Ma’lumot tayyorlash
Manba 920 ta ICBHI yozuvidan sifat filtri so‘ng 895 respiratory cycle dan foydalanganini bildiradi. Ularning %70 i training, %15 i validation va %15 i test uchun ajratilgan. Sonlar mos ravishda 627, 134 va 134.
Bu yerda yana bir bor ta’kidlash kerakki, split “stratified” deb ko‘rsatilgan bo‘lsa-da, patient-independent deb belgilanmagan. Bitta bemorga tegishli turli sikllar mustaqil ma’lumot namunalari kabi turli bo‘limlarga tushgan yoki tushmagani noma’lum.
Preprocessing
| Tartib | Manba amali | Manba parametri |
|---|---|---|
| 1 | Resampling | 16 kHz |
| 2 | Pre-emphasis | \(\alpha=0.97\) |
| 3 | Amplitude normalisation | z-score |
| 4 | Noise reduction | spectral subtraction |
| 5 | Respiratory cycle segmentation | energy envelope + ZCR thresholding |
Feature extraction
Manbada bevosita tasdiqlanishi mumkin bo‘lgan asosiy kirishlar 128×128 spektrogramma, 13 MFCC koeffitsiyenti, db4 wavelet bilan besh darajali DWT va time-domain xususiyatlaridir. 6-rasm shuningdek 36 o‘lchamli numerical feature vector ni ko‘rsatadi.
Model arxitekturasi
| Qatlam / bo‘lim | Manba tuzilmasi |
|---|---|
| CNN input | 128×128×1 spektrogramma |
| Convolution block 1 | 32 filtr + batch norm + 2×2 max-pool + dropout 0,25 |
| Convolution block 2 | 64 filtr + batch norm + 2×2 max-pool + dropout 0,25 |
| Convolution block 3 | 128 filtr + batch norm + 2×2 max-pool + dropout 0,25 |
| CNN embedding | 128 o‘lcham |
| BiLSTM layer 1 | 128 unit |
| BiLSTM layer 2 | 64 unit |
| BiLSTM embedding | 128 o‘lcham |
| Fusion | 256 o‘lcham |
| Dense | 128 |
| Dropout | 0,5 |
| Output | Dense(3) + softmax |
Asosiy ishlash natijasi
Manbaning yakuniy gibrid modeli %94,2 accuracy va 0,971 AUC-ROC beradi. Yakka CNN %88,6, yakka BiLSTM esa %90,5 accuracy darajasida qoladi. Demak, manba ma’lumotlari ichida fusion modeli ikki yakka tarmoqli modelga qaraganda yuqoriroq natija ko‘rsatadi.
Xususiyat hissasi natijasi
Ablation tadqiqotidagi eng katta pasayish spektrogramma olib tashlanganda sodir bo‘ladi: %94,2 → %85,7. MFCC olib tashlanganda %89,3, wavelet olib tashlanganda %91,8 va time-domain olib tashlanganda %93,5 olinadi.
Bu manbaning RQ3 savoliga bergan javobidir: o‘z tajribasida eng ajratuvchan yagona modalitet spektrogramma.
Hisoblash xarajati natijasi
Gibrid tizim 2,1 million parametr, 215,8 daqiqalik training, 15,2 ms inference va 234 MB memory footprint bilan sinovdan o‘tkazilgan modellarning eng xarajatlisi hisoblanadi. Bunga qaramay, eng yuqori accuracy ni ham aynan shu tizim beradi.
Manbaning o‘z cheklovlari
Mualliflar 895 siklli ma’lumotlar to‘plami klinik miqyos uchun kichikligini, Lung Cancer sinfi %26,3 ulush bilan kam ifodalanganini, mustaqil tashqi kohort validation bajarilmaganini, cancer stage yoki asthma severity kabi quyi sinflar ko‘rib chiqilmaganini, interpretability yondashuvi formal SHAP/LIME o‘rniga frequency-band sensitivity bilan cheklanganini va adabiyotdagi %99,01 natijali Zhang tadqiqoti bilan taqqoslash turli augmentation strategiyalaridan ta’sirlanishini tan oladilar.
Verianla manbaga qo‘shgan asosiy tasdiqlash chegarasi
Manbaning o‘z limitation bo‘limiga qo‘shimcha ravishda Verianla nuqtayi nazaridan eng muhim muammo ma’lumot yorliqlarining kelib chiqishidir. Rasmiy ICBHI qaydi 920 tovush fayli, 126 kishi va 6.898 respiratory cycle ni bildiradi hamda sikllar mutaxassislar tomonidan normal, crackle, wheeze yoki crackle+wheeze sifatida belgilanganini aniq ko‘rsatadi. ICBHI dan kasallik darajasida foydalanishni tushuntiruvchi nashrlar ma’lumotlar to‘plamidagi tashxislarni COPD, Healthy, Bronchiectasis, Bronchiolitis, URTI, Pneumonia, Asthma va LRTI shaklida ko‘rsatadi; ular orasida lung cancer yo‘q.
Shu sababli manbadagi “235 Lung Cancer respiratory cycles” ifodasini qayta ishlab bo‘ladigan ma’lumot moslashtirishi bo‘lmasdan qabul qilib bo‘lmaydi. Agar manbaning MATLAB kodi, bemor identifikatorlari ro‘yxati yoki 235 sikl qaysi tashxis metadata sidan hosil qilingani e’lon qilinsa, bu masala alohida qayta baholanishi mumkin.
Xulosa
MATLAB va chuqur o‘rganish nuqtayi nazaridan tadqiqot; audio preprocessing, spektrogramma, MFCC, wavelet, CNN, BiLSTM, feature fusion, class weighting, augmentation, early stopping, cross-validation, confusion matrix, ROC, ablation va inference profiling tushunchalarini bitta tadqiqot zanjirida qanday birlashtirish mumkinligini ko‘rsatadigan boy misoldir.
Ilmiy tashxis nuqtayi nazaridan esa ayni tadqiqot muhim bir tamoyilni eslatadi: modelning %94,2 aniqlik berishi maqsadli sinflar to‘g‘ri belgilanganini isbotlamaydi. Sun’iy intellekt faqat unga berilgan yorliqlarni o‘rganadi. Yorliqlarning klinik manbasi tasdiqlanmasa, yaxshiroq neural network arxitekturasi bu asosiy muammoni hal qila olmaydi. Shu sababli Verianla nuqtayi nazaridan ushbu tadqiqotdan eng to‘g‘ri foydalanish “MATLAB bilan nafas olish tovushi tasnifining texnik ish oqimini o‘rgatish”dir; hozirgi holatda uni “nafas olish tovushidan o‘pka saratonini %94,2 aniqlik bilan tashxislaydigan tasdiqlangan tizim” sifatida taqdim etish emas.
Manba va Usul Haqida Izoh
To‘liq asl tadqiqot nomi: Spectrogram-Based Detection of Lung Cancer and Asthma Using Deep Learning and MATLAB: A Hybrid CNN-LSTM Approach
Mualliflar: Mridul Vats; Pooja Sabherwal; Monika Agrawal.
Mualliflar tartibi: Manbadagi tartib aynan saqlangan.
Muassasalar: Manba PDF Mridul Vats va Pooja Sabherwal uchun The NorthCap University, Department of Electronics and Communication Engineering; Monika Agrawal uchun IIT Delhi, Centre for Applied Research in Electronics (CARE) ma’lumotini beradi.
Aloqa muallifi: SSRN qayd sahifasida Mridul Vats Contact Author sifatida ko‘rsatilgan.
Manba turi: Chuqur o‘rganish va biotibbiy signalni qayta ishlash preprinti.
Maqsadli jurnal: Manba PDF da Biomedical Signal Processing and Control ga yuborilgan manuscript sifatida ko‘rinadi. Bu ifoda nashrga qabul qilinganini anglatmaydi.
Peer-review holati: Ushbu tadqiqot hakamlik tekshiruvidan o‘tmagan preprintdir; natijalar ushbu nashr bosqichi inobatga olingan holda baholanishi kerak.
Platforma: SSRN.
DOI: 10.2139/ssrn.6689273.
SSRN sanasi: 1 May 2026.
MATLAB: MATLAB R2023a, Audio Toolbox, Signal Processing Toolbox.
Python tomoni: librosa, scipy, PyWavelets.
Manba kodiga kirish: Maqola MATLAB va Python implementation script larini corresponding author dan oqilona so‘rov asosida olish mumkinligini bildiradi; yuklangan versiyada ochiq doimiy kod repozitoriysi berilmagan.
Moliyalashtirish: No external funding.
Manfaatlar to‘qnashuvi: Manba competing financial or personal interests mavjud emasligini bildiradi.
Ma’lumotga kirish: Manba ICBHI 2017 Respiratory Sound Database dan foydalanadi. Rasmiy ICBHI qaydi ma’lumotlar to‘plamini 920 yozuv, 126 kishi va 6.898 respiratory cycle sifatida belgilaydi.
Jiddiy ma’lumot-yorliq ogohlantirishi: Manba 312 Healthy, 348 Asthma va 235 Lung Cancer siklidan foydalanganini da’vo qiladi. Tashqi bibliografik tekshiruvda ICBHI tashxis sinflari ichida o‘pka saratoni topilmagan. ICBHI ni kasallik darajasida ishlatgan nashrlarda COPD, healthy, bronchiectasis, bronchiolitis, URTI, pneumonia, asthma va LRTI sinflari xabar qilinadi. Manba maqola 235 lung-cancer yorlig‘i qayerdan kelganini tushuntirmaydi.
Bemor asosidagi split ogohlantirishi: Manba %70/%15/%15 stratified split va 5-fold stratified cross-validation ni bildiradi, biroq subject-independent partition aniq ko‘rsatilmagan. Shu sababli bir bemorning turli nafas olish sikllari trening va test to‘plamlari o‘rtasida taqsimlangan yoki taqsimlanmagani tasdiqlanmaydi.
Arxitektura qayta ishlab bo‘lishi haqida ogohlantirish: DWT va time-domain features ablation tahlilida model komponenti sifatida ko‘rinsa-da, arxitektura izohida yakuniy fusion aniq ravishda faqat CNN spectrogram embedding va BiLSTM MFCC embedding o‘rtasida ko‘rsatilgan. Bu xususiyatlarning haqiqiy network ulanishi to‘liq aniqlanmagan.
Tenglama yetishmovchiligi: Manba Eq. 1–15 oralig‘idagi turli tenglamalarga havola qiladi, ammo yuklangan PDF da ularning muhim qismi ko‘rinmaydi. Yetishmayotgan ifodalar Verianla tomonidan tashqi bilimdan qayta yaratilmagan.
Klinik foydalanish chegarasi: Ushbu tadqiqot klinik tashxis testi, prospektiv bemor tadqiqoti yoki mustaqil shifoxona tekshiruvi emas. External validation bajarilmagan. Ma’lumot yorliqlash muammosi hal qilinmasdan “lung-cancer detection” ko‘rsatkichining klinik haqiqiyligi ko‘rsatilgan deb hisoblab bo‘lmaydi.
Ilmiy mazmun manbasi: MATLAB/Python preprocessing, CNN–BiLSTM arxitekturasi, barcha model parametrlari, dataset jadvali, model natijalari, confusion matrix, ROC, ablation, trening dinamikasi, inference/xotira qiymatlari va manba mualliflarining talqinlari yuklangan 10 sahifalik maqolaga asoslangan. Tashqi manba tadqiqoti faqat bibliografik identifikatsiya va ICBHI ma’lumot tuzilmasining mustaqil tekshiruvi uchun ishlatilgan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan