

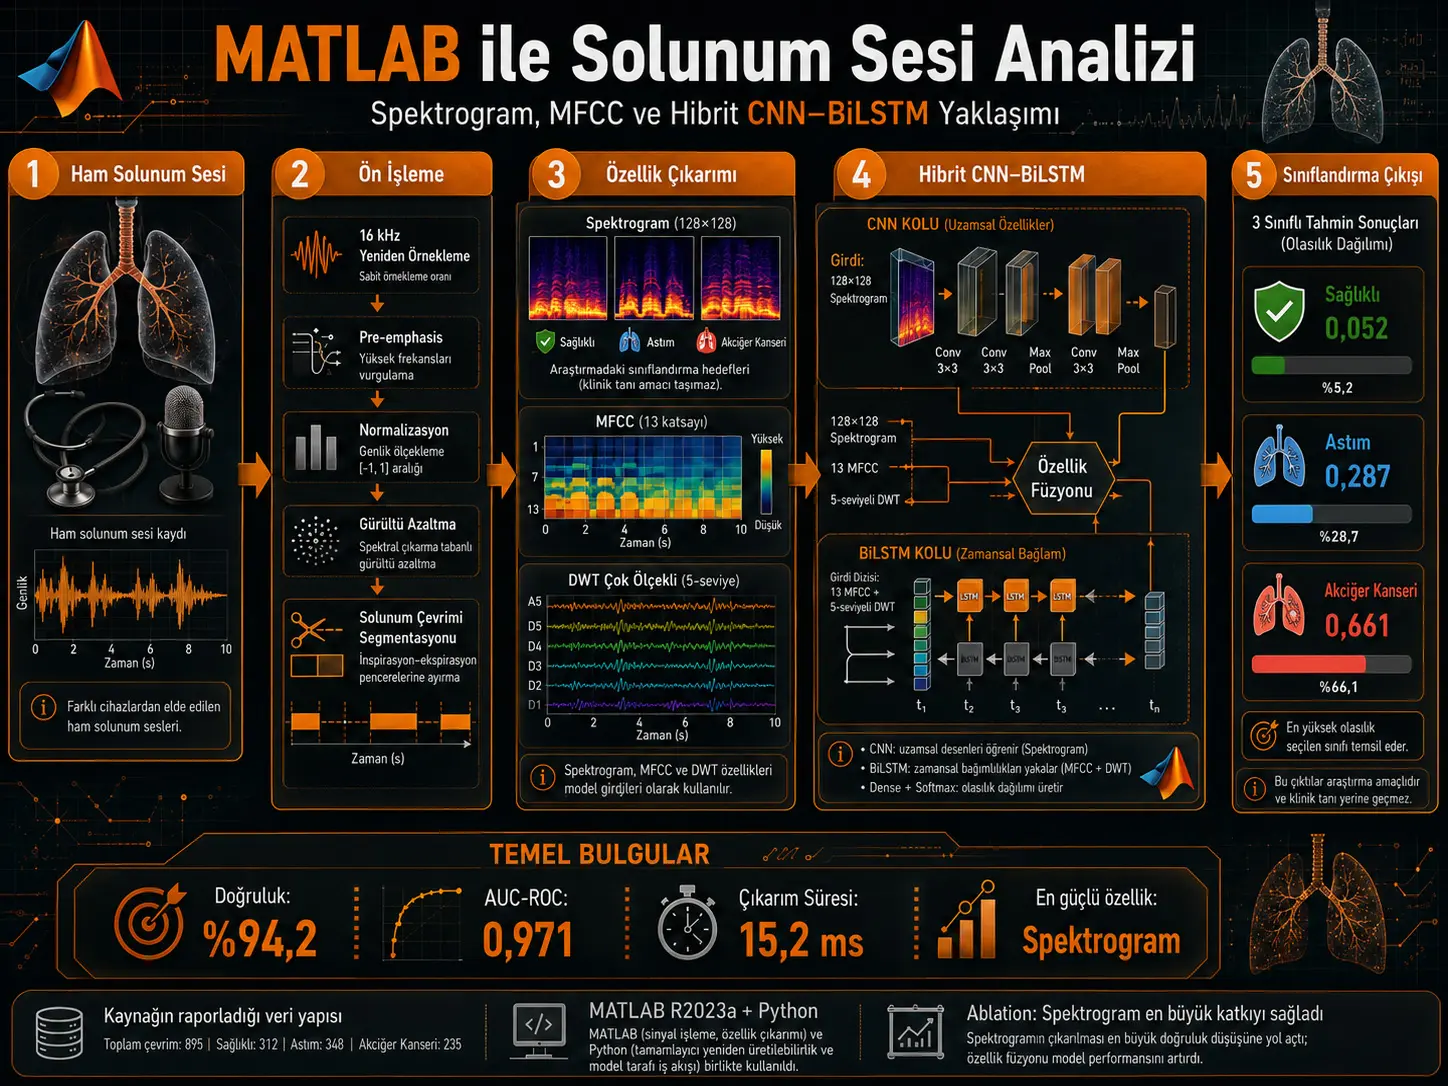
Tədqiqat tənəffüs səslərini zaman–tezlik təsvirlərinə çevirərək onları CNN–BiLSTM modeli ilə üç sinfə ayırmağı hədəfləyən ikili platformalı biotibbi siqnal emalı iş axınını təsvir edir. MATLAB xam tənəffüs səsinin yenidən nümunələnməsi, filtrlənməsi, normallaşdırılması, spektroqram/MFCC/DWT əsaslı xüsusiyyətlərin çıxarılması və nəticələrin doğrulanması üçün istifadə olunan iki əsas hesablama platformasından biridir. İkinci platforma Python-dur.
Mənbə üç hədəf etiketi Healthy, Asthma və Lung Cancer kimi müəyyənləşdirir. Lakin bu üçlü təsnifatın, xüsusilə “Lung Cancer” sinfinin yuxarıda qeyd olunan məlumat mənbəyinin doğrulanması problemi səbəbindən klinik diaqnostika uğuru kimi şərh edilməsi düzgün deyil. Bu Verianla məqaləsi tədqiqatı ilk növbədə MATLAB əsaslı tənəffüs səsinin emalı və CNN–LSTM arxitekturası baxımından araşdırır.
Qısa Xülasə
Mənbə tədqiqat ICBHI 2017 Respiratory Sound Database-dən seçildiyini bildirdiyi 895 tənəffüs dövrü üzərində spektroqram, Mel-Frequency Cepstral Coefficients (MFCC), Discrete Wavelet Transform (DWT) və zaman-sahəsi xüsusiyyətlərindən istifadə edən hibrid CNN–BiLSTM təsnifatçısı təklif edir. Səslər əvvəlcə 16 kHz-ə yenidən nümunələnir, pre-emphasis tətbiq olunur, z-score normallaşdırılması və spectral-subtraction səs-küyün azaldılması həyata keçirilir, daha sonra tənəffüs dövrləri energy-envelope və zero-crossing-rate hədləri ilə seqmentlərə ayrılır. CNN qolu 128×128 boz səviyyəli spektroqramlardan məkan xüsusiyyətləri çıxararkən, BiLSTM qolu MFCC əsaslı zaman ardıcıllığını emal edir. Mənbəyə görə birləşdirilmiş model test dəstində %94,2 accuracy, %93,9 precision, %93,5 recall, %93,6 F1-score və 0,971 AUC-ROC əldə etmişdir. Ablation nəticəsində spektroqramın çıxarılması accuracy-ni 8,5 faiz bəndi azaldaraq ən böyük itkiyə səbəb olmuşdur. Modelin bildirilən inference müddəti 15,2 ms/model girişi səviyyəsindədir. Bununla belə, tədqiqatdakı ağciyər xərçəngi etiketlərinin ICBHI 2017-nin doğrulana bilən diaqnostik quruluşu ilə uyğun gəlməməsi səbəbindən bu performans göstəriciləri doğrulanmış klinik ağciyər-xərçəngi diaqnostika meyarları kimi qəbul edilməməlidir.
Tənəffüs səsindən xəstəlik təsnifatı necə MATLAB probleminə çevrilir?
Ağciyər səsi qeydi kompüterə daxil olduqda model hələ “astma” və ya başqa klinik məna görmür. MATLAB baxımından başlanğıc nöqtəsi yalnız zamana görə dəyişən ədədi amplituda nümunələridir. Buna görə tədqiqatın hesablama zənciri əvvəlcə xam səsi standart nümunələmə quruluşuna gətirir, sonra səs-küyü azaldır və zaman–tezlik xüsusiyyətlərini çıxarır. Dərin öyrənmə modeli yalnız bu mərhələlərdən sonra işə düşür.
Mənbənin 2-ci səhifəsindəki Şəkil 1 bu zənciri beş əsas blokla göstərir: Raw Audio Input → Signal Preprocessing → Feature Extraction → CNN-LSTM Model → Classification Output. Məlumat artırılması yalnız təlim zamanı istifadə olunan opsional mərhələ kimi göstərilmişdir.
Məlumat dəsti mənbəyə görə necə bölünüb?
Mənbə ICBHI 2017-dəki 920 qeyddən keyfiyyət filtrindən sonra 895 tənəffüs dövründən istifadə etdiyini bildirir. Mənbənin verdiyi cədvəl belədir:
| Mənbənin sinif etiketi | Tənəffüs dövrü | Nisbət (%) | Training | Validation | Test |
|---|---|---|---|---|---|
| Healthy | 312 | 34,8 | 218 | 47 | 47 |
| Asthma | 348 | 38,9 | 244 | 52 | 52 |
| Lung Cancer | 235 | 26,3 | 165 | 35 | 35 |
| Cəmi | 895 | 100 | 627 | 134 | 134 |
Bu cədvəl mənbə məqalənin öz eksperimental dizaynını düzgün şəkildə əks etdirir. Lakin xüsusilə 235 Lung Cancer dövrünün ICBHI məlumat dəstindən necə əldə edildiyi açıqlanmamış və xarici məlumat dəsti doğrulaması ilə uyğun gəlmir. Buna görə sonrakı bütün performans cədvəlləri “mənbənin bildirdiyi təsnifat” kimi oxunmalıdır.
3-cü səhifədəki üç spektroqram nə göstərir?
Mənbə Şəkil 2-də eyni STFT təsvir formatında Healthy, Asthma və Lung Cancer kimi etiketlədiyi üç nümunə göstərir. Healthy nümunəsi aşağı enerjili və daha homogen, Asthma nümunəsi xüsusilə 500–2500 Hz arasında üfüqi/davamlı yüksək enerji zolaqlarına malik, Lung Cancer kimi etiketlənən nümunə isə nizamsız yüksək tezlikli qısa enerji partlayışları şəklində şərh olunur.
Bu təsvirlər CNN qolunun niyə istifadə edilmək istəndiyini izah edir: CNN yalnız ümumi enerjiyə baxmır; spektroqram üzərindəki yerli forma, zolaq, kənar və zaman–tezlik teksturalarını öyrənməyə çalışır. Lakin məlumat etiketi problemi həll edilmədən vizual nümunələrin ağciyər xərçənginə xas klinik biomarker olduğu irəli sürülə bilməz.
MATLAB preprocessing zənciri
Mənbə preprocessing-i beş ardıcıl mərhələyə ayırır. Birinci mərhələ bütün qeydlərin 16 kHz nümunələmə tezliyinə gətirilməsidir. Beləliklə, müxtəlif orijinal sampling rate-lərə malik qeydlər eyni zaman oxunda emal edilə bilir. İkinci mərhələdə əmsalı \(\alpha=0.97\) kimi verilən first-order pre-emphasis tətbiq olunur. Üçüncü mərhələdə z-score amplitude normalisation, dördüncü mərhələdə spectral-subtraction noise reduction və son mərhələdə energy-envelope ilə zero-crossing-rate thresholding əsaslı respiratory-cycle segmentation həyata keçirilir.
Mənbə bu əməliyyatların MATLAB R2023a üzərində Audio Toolbox və Signal Processing Toolbox ilə, paralel doğrulama məqsədilə isə Python üzərində də həyata keçirildiyini bildirir. Əhəmiyyətli mənbə bütövlüyü problemi isə preprocessing tənliklərinə Eq. 1, Eq. 9 və Eq. 10 kimi istinad verilməsinə baxmayaraq bu tənliklərin yüklənmiş PDF-də görünməməsidir. Buna görə Verianla burada çatışmayan düsturları ümumi bilikdən tamamlamır.
Spektroqram niyə 128×128 pikselə çevrilir?
Mənbə CNN girişini 128×128×1 grayscale spectrogram kimi müəyyənləşdirir. Buradakı ilk iki rəqəm görüntünün zaman–tezlik müstəvisində ölçüsünü, son rəqəm isə tək boz səviyyəli kanalı göstərir.
CNN baxımından sabit giriş ölçüsü vacibdir. Müxtəlif tənəffüs dövrlərinin müddətləri dəyişsə də, modelin convolution qatlarına eyni geometrik ölçüdə məlumat verilməsi tələb olunur. Mənbə bu standartlaşdırmanın ətraflı resize üsulunu izah etmir; yalnız yekun spektroqram ölçüsünü verir.
MFCC nədir və mənbədə neçə əmsaldan istifadə olunub?
Mənbə feature-extraction təsvirində hər tənəffüs nümunəsi üçün 13 MFCC coefficient əldə edildiyini göstərir. MFCC-lər səsin spektral zərfini daha sıxılmış təqdimat şəklində daşımaq üçün istifadə olunur.
Tədqiqatdakı arxitektura baxımından spektroqram və MFCC eyni məlumatı eyni formada təqdim etmir. Spektroqram CNN-yə ikiölçülü görüntü verərkən, MFCC ardıcıllığı BiLSTM qoluna zaman ardıcıllığı kimi təqdim olunur. Beləliklə, biri məkan zaman–tezlik quruluşunu, digəri ardıcıl akustik dinamikanı öyrənməyə çalışır.
DWT niyə ayrıca istifadə olunub?
Mənbə DWT üçün Daubechies-4 (db4) wavelet və 5 level decomposition istifadə etdiyini bildirir. Wavelet analizi qısamüddətli keçici hadisələrin müxtəlif miqyaslarda təqdim olunmasına imkan verir. Tədqiqat xüsusilə crackle tipli qısamüddətli keçici məlumatların wavelet tərəfindən tamamlayıcı şəkildə tutula biləcəyini fərz edir.
Ablation nəticələri bu xüsusiyyət qrupunun çıxarılmasının accuracy-ni %94,2-dən %91,8-ə endirdiyini, yəni mənbə təcrübəsində 2,4 faiz bəndlik töhfə ilə əlaqələndirildiyini göstərir.
4-cü səhifədəki xüsusiyyət tərkibi
Mənbənin Şəkil 6-sındakı dairəvi qrafik xüsusiyyət tərkibini vizual olaraq təxminən dörd qrupa bölür: spektroqram, MFCC, DWT statistics və time-domain xüsusiyyətləri. Eyni şəkil sağ tərəfdə 36-dimensional numerical feature vector göstərir.
Lakin eyni səhifədəki arxitektura mətni BiLSTM-nin “MFCC sequence” emal etdiyini bildirir. DWT və time-domain dəyişənlərinin 36 ölçülü vektor vasitəsilə BiLSTM-yə verilib-verilmədiyi, ayrıca dense qatına daxil olub-olmadığı və ya MFCC sequence-ə necə əlavə edildiyi açıq şəkildə göstərilməyib. Bu çatışmazlıq tədqiqatı MATLAB mühitində eynilə yenidən istehsal etmək istəyən biri üçün vacibdir.
CNN qolu necə qurulub?
CNN qolu üç convolutional block ehtiva edir. Mənbə filtr saylarını ardıcıllıqla 32, 64 və 128 kimi verir. Hər blokda batch normalisation, 2×2 max-pooling və \(p=0.25\) dropout istifadə olunur.
Bu qolun sonunda:
\[ f_{\mathrm{CNN}}\in\mathbb{R}^{128} \]
ölçülü təqdimat əldə edildiyi və CNN qolunun təxminən 1,2 milyon parametr ehtiva etdiyi bildirilir.
Convolution filtrləri spektroqramın hamısını bir dəfəyə əzbərləmək əvəzinə kiçik sahələr üzərində təkrar istifadə olunan filtrlərlə işləyir. Daha dərin qatlara keçdikcə daha sadə yerli enerji nümunələrindən daha mürəkkəb zaman–tezlik naxışlarına doğru təqdimat qurulması hədəflənir.
BiLSTM qolu necə işləyir?
Mənbəyə görə BiLSTM qolunda iki bidirectional LSTM layer mövcuddur. Bunların birincisi 128 unit, ikincisi 64 unit ehtiva edir.
Qolun sonunda:
\[ f_{\mathrm{LSTM}}\in\mathbb{R}^{128} \]
ölçülü təqdimat yaradılır və bu qolun təxminən 0,8 milyon parametr daşıdığı bildirilir.
“Bidirectional” ifadəsinin əhəmiyyəti ondadır ki, MFCC zaman addımı yalnız özündən əvvəlki nümunələrlə deyil, təlim zamanı ardıcıllığın sonrakı hissəsindəki kontekstlə də birlikdə təqdim oluna bilir. Beləliklə, tənəffüs dövrünün zaman daxilində inkişafı CNN-nin spektroqram nümunələrini tamamlayan ikinci informasiya kanalı olur.
İki model necə birləşdirilir?
Mənbənin açıq şəkildə verdiyi fusion əməliyyatı:
\[ f_{\mathrm{fused}} ================== [f_{\mathrm{CNN}};f_{\mathrm{LSTM}}] \in\mathbb{R}^{256} \]
şəklindədir.
128 ölçülü CNN və 128 ölçülü BiLSTM çıxışı ardıcıl birləşdirilərək 256 ölçülü feature-fusion vektoru əldə edilir. Bundan sonra mənbə:
Dense(128) → Dropout(0.5) → Dense(3) → Softmax
zəncirini müəyyənləşdirir.
Son Dense(3) qatındakı üç çıxış mənbənin Healthy, Asthma və Lung Cancer kimi müəyyən etdiyi üç sinfi təmsil edir.
Model niyə təxminən 2,1 milyon parametrdir?
Mənbə hesablama cədvəlində bütün CNN–LSTM sistemini təxminən 2,1 milyon trainable parameter ilə bildirir. CNN qolu təxminən 1,2 milyon, BiLSTM qolu isə təxminən 0,8 milyon kimi verildiyindən qalan parametrlər fusion-dan sonrakı dense təsnifat bölməsini də əhatə edir.
Class imbalance necə nəzərə alınıb?
Mənbə siniflər arasında nümunə sayı bərabər olmadığı üçün multi-class cross-entropy loss daxilində class weights istifadə edir:
\[ w_c= \frac{N}{C,N_c} \]
Burada \(N\) ümumi nümunə sayını, \(C\) sinif sayını və \(N_c\) müvafiq sinfə aid nümunə sayını təmsil edir. Beləliklə, az nümunəli siniflərdəki səhvlərin loss funksiyasındakı çəkisinin artırılması hədəflənir.
Təlim parametrləri
| Təlim parametri | Mənbə dəyəri |
|---|---|
| Optimiser | Adam |
| Learning rate | 0,001 |
| \(\beta_1\) | 0,9 |
| \(\beta_2\) | 0,999 |
| Batch size | 32 |
| Maksimum epoch | 100 |
| Early-stopping patience | 15 |
| Cross-validation | 5-fold stratified |
| Time stretching | ×0,9–1,1 |
| Pitch shifting | ±2 semitone |
| Gaussian noise | \(\sigma=0.005\) |
Data augmentation yalnız training tərəfində tətbiq olunur. Bu fərq vacibdir: test məlumatına augmentation tətbiq edilməsi performans ölçümünün mənasını dəyişdirə bilərdi.
Early stopping niyə lazımdır?
Mənbədə maksimum təlim 100 epoch kimi müəyyənləşdirilsə də validation loss minimum dəyərinə təxminən 45-ci epoch ətrafında çatmış və ən yaxşı model bu nöqtədə checkpoint edilmişdir. Early stopping təxminən 60-cı epoch ətrafında işə düşmüşdür.
Mənbənin bildirdiyi training loss başlanğıcda 1,098 ikən 0,142-yə qədər enmiş; minimum validation loss isə 0,186 olmuşdur. Müəlliflər train və validation əyriləri arasındakı dar fərqi ciddi overfitting müşahidə edilməməsi kimi şərh edirlər.
Beş müxtəlif modelin müqayisəsi
Mənbənin öz təcrübələri daxilində hibrid model bütün tək-qollu baseline modellərdən daha yüksək nəticə verir. CNN ilə BiLSTM-nin birləşməsi mənbədə yalnız spektroqram və ya yalnız MFCC istifadəsinə nisbətən daha yüksək performansla əlaqələndirilir.
Accuracy niyə təkbaşına kifayət deyil?
Accuracy ümumi düzgün qərarların nisbətidir; lakin siniflər balanssız olduqda təkbaşına yanıltıcı ola bilər. Buna görə mənbə precision, recall, F1-score, specificity, ROC-AUC və confusion matrix də bildirir.
Bu yanaşma MATLAB və süni intellekt öyrənilməsi baxımından son dərəcə dəyərlidir. Xüsusilə səhiyyə təsnifatlarında modelin yalnız “neçə nümunəni düzgün bildiyi” deyil, müəyyən sinifdəki real halları hansı nisbətdə tuta bildiyi də əhəmiyyətlidir.
Mənbənin sinif əsaslı nəticələri
| Mənbə etiketi | Precision (%) | Recall (%) | F1 (%) | Specificity (%) | Test nümunəsi |
|---|---|---|---|---|---|
| Healthy | 95,7 | 96,2 | 95,9 | 97,8 | 47 |
| Asthma | 92,8 | 94,1 | 93,4 | 96,2 | 52 |
| Lung Cancer | 93,1 | 89,2 | 91,1 | 97,5 | 35 |
| Macro average | 93,9 | 93,2 | 93,5 | 97,2 | 134 |
Mənbə ən aşağı recall dəyərinin %89,2 ilə Lung Cancer etiketində olduğunu; bunu sinif balanssızlığı və Asthma ilə 500–2500 Hz bölgəsindəki oxşar wheeze akustikası ilə əlaqələndirir. Bu izah mənbə müəlliflərinin şərhidir; məlumat etiketlərinin klinik mənşəyi doğrulanmadığından müstəqil klinik nəticə kimi qəbul edilməməlidir.
Confusion matrix-in real sayları
6-cı səhifədəki Şəkil 5, 134 nümunəlik test dəsti üçün xam sayları açıq şəkildə verir:
| Həqiqi \ Proqnoz | Healthy | Asthma | Lung Cancer |
|---|---|---|---|
| Healthy | 45 | 2 | 0 |
| Asthma | 2 | 48 | 1 |
| Lung Cancer | 0 | 4 | 33 |
Mənbənin öz şərhinə görə ən böyük tək off-diagonal xəta dörd Lung Cancer nümunəsinin Asthma kimi təsnif edilməsidir.
ROC analizi
| Mənbə etiketi | One-vs-rest AUC |
|---|---|
| Healthy | 0,978 |
| Asthma | 0,969 |
| Lung Cancer | 0,965 |
Mənbə bütün ROC əyrilərinin təsadüfi təsnifatçının 0,5 AUC xəttindən yuxarı olduğunu bildirir. Beş qatlı cross-validation üçün %95 confidence interval kölgələri Şəkil 7-də göstərilmişdir.
Ablation study nədir?
Ablation tədqiqatında bir model komponenti və ya xüsusiyyət qrupu növbə ilə çıxarılır və performansın nə qədər azaldığı müşahidə olunur. Beləliklə, modelin hansı informasiya kanalından daha çox asılı olduğu anlaşılmağa çalışılır.
Mənbənin ən aydın modelləşdirmə nəticəsi budur: spektroqram çıxarıldıqda performans ən kəskin şəkildə azalır. Bununla belə, yalnız spektroqram modeli %91,1-də qalarkən bütün xüsusiyyətlərin birləşməsi %94,2-yə çatır. Müəlliflər bunu müxtəlif xüsusiyyət modalitələrinin tamamlayıcı informasiya daşıması kimi şərh edirlər.
BiLSTM-nin töhfəsi necə ölçülüb?
Mənbə CNN-only baseline-ın %88,6 dəqiqliyini hibrid sistemin %94,2 nəticəsi ilə müqayisə edir; həmçinin frequency-sensitivity bölməsində BiLSTM temporal component-ın CNN-only quruluşa nisbətən 3,1 faiz bəndlik töhfə verdiyini bildirir. Bu iki ifadə birbaşa eyni arifmetik fərq deyil; mənbədə müxtəlif kontekstlərdə verilib və burada bir-birinə çevrilmir.
Hansı tezlik sahəsi daha ayırdedicidir?
Mənbə frequency-band sensitivity analizində ayırdedici informasiyanın:
| Tezlik aralığı | Mənbənin bildirdiyi töhfə | Mənbə şərhi |
|---|---|---|
| 0–500 Hz | %23 | Normal breath |
| 500–2500 Hz | %45 | Wheeze patterns |
| 2500–8000 Hz | %32 | Crackles / high-frequency information |
şəklində paylandığını bildirir. Lakin bu %23/%45/%32 dəyərlərinin hansı riyazi sensitivity hesabından əldə edildiyi məqalədə ətraflı müəyyənləşdirilməyib.
Hesablama performansı
| Model | Parametr (M) | Training (dəq) | Inference (ms) | Yaddaş (MB) |
|---|---|---|---|---|
| SVM + MFCC | — | 12,3 | 2,1 | 45 |
| Random Forest | — | 18,7 | 5,4 | 128 |
| CNN | 1,2 | 142,5 | 8,3 | 156 |
| BiLSTM | 0,8 | 98,4 | 12,7 | 98 |
| CNN–LSTM | 2,1 | 215,8 | 15,2 | 234 |
Bu cədvəl mühüm maşın öyrənməsi həqiqətini göstərir: mənbənin ən yüksək accuracy dəyərini verən model eyni zamanda ən uzun training müddətinə və ən yüksək yaddaş istifadəsinə malikdir. Daha mürəkkəb model hər meyarda avtomatik olaraq “daha yaxşı” deyil; dəqiqliklə hesablama xərci arasında dizayn kompromisi mövcuddur.
15,2 ms nə deməkdir?
Mənbə CNN–LSTM üçün 15,2 ms inference müddəti bildirir və bunu 400 ms pəncərə uzunluğundakı streaming audio üçün 25 ms tələbindən qısa olması səbəbindən real-zaman istifadəsinə uyğun kimi şərh edir.
Burada diqqət edilməli məqam ifadənin vahididir. Cədvəldə “Inference (ms)” yazıldığı halda mətndə “15.2 ms/sample” deyilir. Əgər “sample” burada tək 16 kHz audio sample mənasını versəydi, bu şərh düzgün olmazdı. Mənbənin kontekstinə görə nəzərdə tutulanın bir model nümunəsi / analiz pəncərəsi olması daha ehtimal edilir; lakin məqalə bunu açıq şəkildə müəyyənləşdirmir.
Statistik əhəmiyyətlilik testi
Mənbə beş qatlı cross-validation nəticələri üzərində paired t-test tətbiq etdiyini bildirir:
| Müqayisə | t | p |
|---|---|---|
| CNN–LSTM vs CNN | 3,42 | 0,026 |
| CNN–LSTM vs BiLSTM | 4,18 | 0,013 |
| CNN–LSTM vs Random Forest | 6,73 | 0,002 |
Hər üç müqayisədə mənbə \(p<0.05\) nəticəsinə çatır. Bununla belə, yalnız beş fold üzərində t-test tətbiqi kiçik nümunəli statistik müqayisədir; performans iddiasının məlumat etiketi və subject leakage kimi əsas məlumat problemlərini təkbaşına həll etmir.
Ədəbiyyatda daha yüksək accuracy olduğu halda mənbə niyə %94,2-ni vacib sayır?
Məqalə öz metodunun mütləq accuracy rekordu olduğunu iddia etmir. Mənbə Cədvəl 6-da Zhang və həmkarlarının 2024-cü il dual-channel CNN-LSTM metodunun %99,01 accuracy bildirdiyini açıq şəkildə qəbul edir.
Müəlliflərin öz töhfə iddiası daha çox üç nöqtədədir: üç sinifli disease classification, MATLAB/Python ikili platformalı təkrar istehsal edilə bilmə və inference latency / memory footprint kimi hesablama profilinin bildirilməsi.
Lakin ilk töhfədəki “lung cancer” sinfinin məlumat mənşəyi doğrulanmadığı üçün bu töhfə Verianla tərəfindən sübut olunmuş klinik yenilik kimi qəbul edilmir.
MATLAB baxımından bu tədqiqatdan nə öyrənə bilərik?
Tədqiqatın ən faydalı tərəfi tək bir dərin öyrənmə şəbəkəsi deyil, başdan sona mühəndislik zənciridir. MATLAB öyrənən şəxsin burada görməli olduğu əlaqə belədir: xam siqnal standartlaşdırılmadan model öyrədilə bilməz; spektroqram və MFCC kimi təqdimatlar fərqli informasiya daşıyır; CNN və LSTM fərqli məlumat həndəsələrini emal edir; sinif balanssızlığı loss dizaynına təsir göstərir; augmentation yalnız təlimdə tətbiq edilməlidir; training accuracy təkbaşına kifayət deyil; validation, test, confusion matrix, ROC, ablation və cross-validation bir-birindən fərqli suallara cavab verir; həmçinin modelin yaddaş və inference müddəti də real sistem dizaynının bir hissəsidir.
Buna görə MATLAB-da biotibbi süni intellekt layihəsi “bir siqnalı spectrogram-a çevirib neural network-ə verməkdən” çox daha genişdir. Məlumatın mənşəyi və xəstə etiketlərinin doğruluğu hətta kodun özündən əvvəl gəlir. Bu tədqiqat məhz bu nöqtədə çox öyrədici əks-nümunə də təqdim edir: hesablama zənciri nə qədər inkişaf etmiş olsa da, hədəf etiketlərin mənbəyi doğrulanmırsa model performansının klinik mənası zəifləyir.
Tədqiqatın Metodu və Nəticələri
Mənbənin tədqiqat sualları
Məqalə dörd tədqiqat sualı müəyyənləşdirir. Birinci sual spektroqram xüsusiyyətlərinin tənəffüs səsi siniflərini klinik baxımdan mənalı sensitivity ilə ayırıb-ayırmamasıdır. İkinci sual hibrid CNN–LSTM arxitekturasının tək-model baseline-ları keçib-keçməməsidir. Üçüncü sual hansı feature modality-nin accuracy-yə ən böyük töhfəni verdiyidir. Dördüncü sual isə sistemin real-zaman istifadəsinə kifayət edəcək hesablama performansına malik olub-olmamasıdır.
Məlumatın hazırlanması
Mənbə 920 ICBHI qeydindən keyfiyyət filtrindən sonra 895 respiratory cycle istifadə etdiyini bildirir. Bunların %70-i training, %15-i validation və %15-i test üçün ayrılmışdır. Rəqəmlər müvafiq olaraq 627, 134 və 134-dür.
Burada yenidən vurğulanmalı məqam odur ki, split “stratified” kimi göstərilsə də patient-independent kimi müəyyənləşdirilməyib. Bir xəstəyə aid müxtəlif dövrlərin bir-birindən müstəqil məlumat nümunələri kimi müxtəlif bölmələrə düşüb-düşmədiyi məlum deyil.
Preprocessing
| Sıra | Mənbə əməliyyatı | Mənbə parametri |
|---|---|---|
| 1 | Resampling | 16 kHz |
| 2 | Pre-emphasis | \(\alpha=0.97\) |
| 3 | Amplitude normalisation | z-score |
| 4 | Noise reduction | spectral subtraction |
| 5 | Respiratory cycle segmentation | energy envelope + ZCR thresholding |
Feature extraction
Mənbədə birbaşa doğrulana bilən əsas girişlər 128×128 spektroqram, 13 MFCC əmsalı, db4 wavelet ilə beş səviyyəli DWT və time-domain xüsusiyyətləridir. Şəkil 6 əlavə olaraq 36 ölçülü numerical feature vector göstərir.
Model arxitekturası
| Qat / bölmə | Mənbə quruluşu |
|---|---|
| CNN input | 128×128×1 spektroqram |
| Convolution block 1 | 32 filtr + batch norm + 2×2 max-pool + dropout 0,25 |
| Convolution block 2 | 64 filtr + batch norm + 2×2 max-pool + dropout 0,25 |
| Convolution block 3 | 128 filtr + batch norm + 2×2 max-pool + dropout 0,25 |
| CNN embedding | 128 ölçü |
| BiLSTM layer 1 | 128 unit |
| BiLSTM layer 2 | 64 unit |
| BiLSTM embedding | 128 ölçü |
| Fusion | 256 ölçü |
| Dense | 128 |
| Dropout | 0,5 |
| Output | Dense(3) + softmax |
Əsas performans nəticəsi
Mənbənin yekun hibrid modeli %94,2 accuracy və 0,971 AUC-ROC əldə edir. Tək CNN %88,6, tək BiLSTM isə %90,5 accuracy səviyyəsində qalır. Beləliklə, mənbə məlumatları daxilində fusion modeli iki tək-qollu modeldən daha yüksək performans göstərir.
Xüsusiyyət töhfəsi nəticəsi
Ablation tədqiqatında ən böyük itki spektroqram çıxarıldıqda baş verir: %94,2 → %85,7. MFCC çıxarıldıqda %89,3, wavelet çıxarıldıqda %91,8 və time-domain çıxarıldıqda %93,5 əldə edilir.
Bu, mənbənin RQ3 sualına verdiyi cavabdır: öz təcrübəsində ən ayırdedici tək modalite spektroqramdır.
Hesablama xərci nəticəsi
Hibrid sistem 2,1 milyon parametr, 215,8 dəqiqəlik training, 15,2 ms inference və 234 MB memory footprint ilə sınaqdan keçirilmiş modellər arasında ən yüksək hesablayıcı xərclidir. Bununla yanaşı ən yüksək accuracy-ni də bu sistem verir.
Mənbənin öz məhdudiyyətləri
Müəlliflər 895 dövrlük məlumat dəstinin klinik miqyas baxımından kiçik olduğunu, Lung Cancer sinfinin %26,3 nisbətində az təmsil edildiyini, müstəqil xarici kohort validation həyata keçirilmədiyini, cancer stage və ya asthma severity kimi alt siniflərin nəzərə alınmadığını, interpretability yanaşmasının formal SHAP/LIME əvəzinə frequency-band sensitivity ilə məhdud qaldığını və ədəbiyyatdakı %99,01-lik Zhang tədqiqatı ilə müqayisənin fərqli augmentation strategiyalarından təsirləndiyini qəbul edirlər.
Verianla-nın mənbəyə əlavə etdiyi əsas doğrulama sərhədi
Mənbənin öz limitation bölməsinə əlavə olaraq Verianla baxımından ən mühüm problem məlumat etiketlərinin mənşəyidir. Rəsmi ICBHI qeydi 920 səs faylı, 126 şəxs və 6.898 respiratory cycle bildirdiyi halda dövrlərin mütəxəssislər tərəfindən normal, crackle, wheeze və ya crackle+wheeze kimi işarələndiyini açıq şəkildə bildirir. Xəstəlik səviyyəsində ICBHI istifadəsini izah edən nəşrlər məlumat dəstindəki diaqnozları COPD, Healthy, Bronchiectasis, Bronchiolitis, URTI, Pneumonia, Asthma və LRTI kimi göstərir; bunların içində lung cancer yoxdur.
Buna görə mənbədəki “235 Lung Cancer respiratory cycles” ifadəsinin təkrar istehsal edilə bilən məlumat uyğunlaşdırılması olmadan qəbul edilməsi mümkün deyil. Mənbənin MATLAB kodu, xəstə identifikatorları siyahısı və ya 235 dövrü hansı diaqnostik metadata-dan yaratdığı yayımlanarsa, bu məsələ ayrıca yenidən qiymətləndirilə bilər.
Nəticə
MATLAB və dərin öyrənmə perspektivindən baxdıqda tədqiqat; səs preprocessing, spektroqram, MFCC, wavelet, CNN, BiLSTM, feature fusion, class weighting, augmentation, early stopping, cross-validation, confusion matrix, ROC, ablation və inference profiling anlayışlarının bir tədqiqat zəncirində necə bir araya gətirilə biləcəyini göstərən zəngin nümunədir.
Elmi diaqnostika perspektivindən isə eyni tədqiqat mühüm bir prinsipi xatırladır: modelin %94,2 dəqiqlik verməsi hədəf siniflərin düzgün müəyyənləşdirildiyini sübut etmir. Süni intellekt yalnız ona verilən etiketləri öyrənir. Etiketlərin klinik mənbəyi doğrulanmadıqda daha yaxşı neural network arxitekturası bu əsas problemi həll edə bilməz. Buna görə Verianla baxımından bu tədqiqatın ən düzgün istifadəsi “MATLAB ilə tənəffüs səsi təsnifatının texniki iş axınını öyrətmək”dir; mövcud formada “ağciyər xərçəngini tənəffüs səsindən %94,2 dəqiqliklə diaqnoz edən doğrulanmış sistem” kimi təqdim etmək deyil.
Mənbə və Metod Qeydi
Tam özgün tədqiqat adı: Spectrogram-Based Detection of Lung Cancer and Asthma Using Deep Learning and MATLAB: A Hybrid CNN-LSTM Approach
Müəlliflər: Mridul Vats; Pooja Sabherwal; Monika Agrawal.
Müəllif sırası: Mənbədəki sıra olduğu kimi qorunmuşdur.
Qurumlar: Mənbə PDF Mridul Vats və Pooja Sabherwal üçün The NorthCap University, Department of Electronics and Communication Engineering; Monika Agrawal üçün IIT Delhi, Centre for Applied Research in Electronics (CARE) məlumatını verir.
Əlaqə müəllifi: SSRN qeyd səhifəsində Mridul Vats Contact Author kimi göstərilir.
Mənbə növü: Dərin öyrənmə və biotibbi siqnal emalı preprint-i.
Hədəf jurnal: Mənbə PDF-də Biomedical Signal Processing and Control-a göndərilmiş manuscript kimi görünür. Bu ifadə nəşr qəbulunu göstərmir.
Rəy statusu: Bu tədqiqat rəy prosesindən keçməmiş preprintdir; nəticələr bu nəşr mərhələsi nəzərə alınaraq qiymətləndirilməlidir.
Platforma: SSRN.
DOI: 10.2139/ssrn.6689273.
SSRN tarixi: 1 May 2026.
MATLAB: MATLAB R2023a, Audio Toolbox, Signal Processing Toolbox.
Python tərəfi: librosa, scipy, PyWavelets.
Mənbə koduna çıxış: Məqalə MATLAB və Python implementation script-lərinin corresponding author-dan əsaslandırılmış sorğu əsasında əldə edilə biləcəyini bildirir; yüklənmiş versiyada açıq daimi kod deposu verilməyib.
Maliyyələşdirmə: No external funding.
Maraqların toqquşması: Mənbə competing financial or personal interests olmadığını bildirir.
Məlumat çıxışı: Mənbə ICBHI 2017 Respiratory Sound Database-dən istifadə edir. Rəsmi ICBHI qeydi məlumat dəstini 920 qeyd, 126 şəxs və 6.898 respiratory cycle kimi müəyyənləşdirir.
Kritik məlumat-etiket xəbərdarlığı: Mənbə 312 Healthy, 348 Asthma və 235 Lung Cancer dövründən istifadə etdiyini iddia edir. Xarici biblioqrafik doğrulamada ICBHI diaqnoz sinifləri arasında ağciyər xərçəngi tapılmayıb. ICBHI-ni xəstəlik səviyyəsində istifadə edən nəşrlərdə COPD, healthy, bronchiectasis, bronchiolitis, URTI, pneumonia, asthma və LRTI sinifləri bildirilir. Mənbə məqalə 235 lung-cancer etiketinin haradan gəldiyini açıqlamır.
Xəstə əsaslı split xəbərdarlığı: Mənbə %70/%15/%15 stratified split və 5-fold stratified cross-validation bildirir, lakin subject-independent partition açıq şəkildə göstərilmir. Buna görə eyni xəstənin müxtəlif tənəffüs dövrlərinin təlim və test dəstləri arasında paylanıb-paylanmadığı doğrulana bilmir.
Arxitekturanın təkrar istehsal edilə bilməsi xəbərdarlığı: DWT və time-domain features ablation analizində model komponenti kimi göründüyü halda, arxitektura izahında yekun fusion açıq şəkildə yalnız CNN spectrogram embedding və BiLSTM MFCC embedding arasında göstərilmişdir. Bu xüsusiyyətlərin real network bağlantısı tam müəyyənləşdirilməyib.
Tənlik çatışmazlığı: Mənbə Eq. 1–15 aralığındakı müxtəlif tənliklərə istinad edir, lakin yüklənmiş PDF-də onların mühüm hissəsi görünmür. Çatışmayan ifadələr Verianla tərəfindən xarici bilikdən yenidən yaradılmayıb.
Klinik istifadə sərhədi: Bu tədqiqat klinik diaqnostika testi, prospektiv xəstə tədqiqatı və ya müstəqil xəstəxana doğrulaması deyil. External validation həyata keçirilməyib. Məlumat etiketləmə problemi həll edilmədən “lung-cancer detection” performansının klinik etibarlılığı göstərilmiş sayıla bilməz.
Elmi məzmun mənbəyi: MATLAB/Python preprocessing, CNN–BiLSTM arxitekturası, bütün model parametrləri, dataset cədvəli, model nəticələri, confusion matrix, ROC, ablation, təlim dinamikası, inference/yaddaş dəyərləri və mənbə müəlliflərin şərhləri yüklənmiş 10 səhifəlik məqaləyə əsaslanır. Xarici mənbə araşdırması yalnız biblioqrafik kimlik və ICBHI məlumat quruluşunun müstəqil doğrulanması üçün istifadə edilmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib