

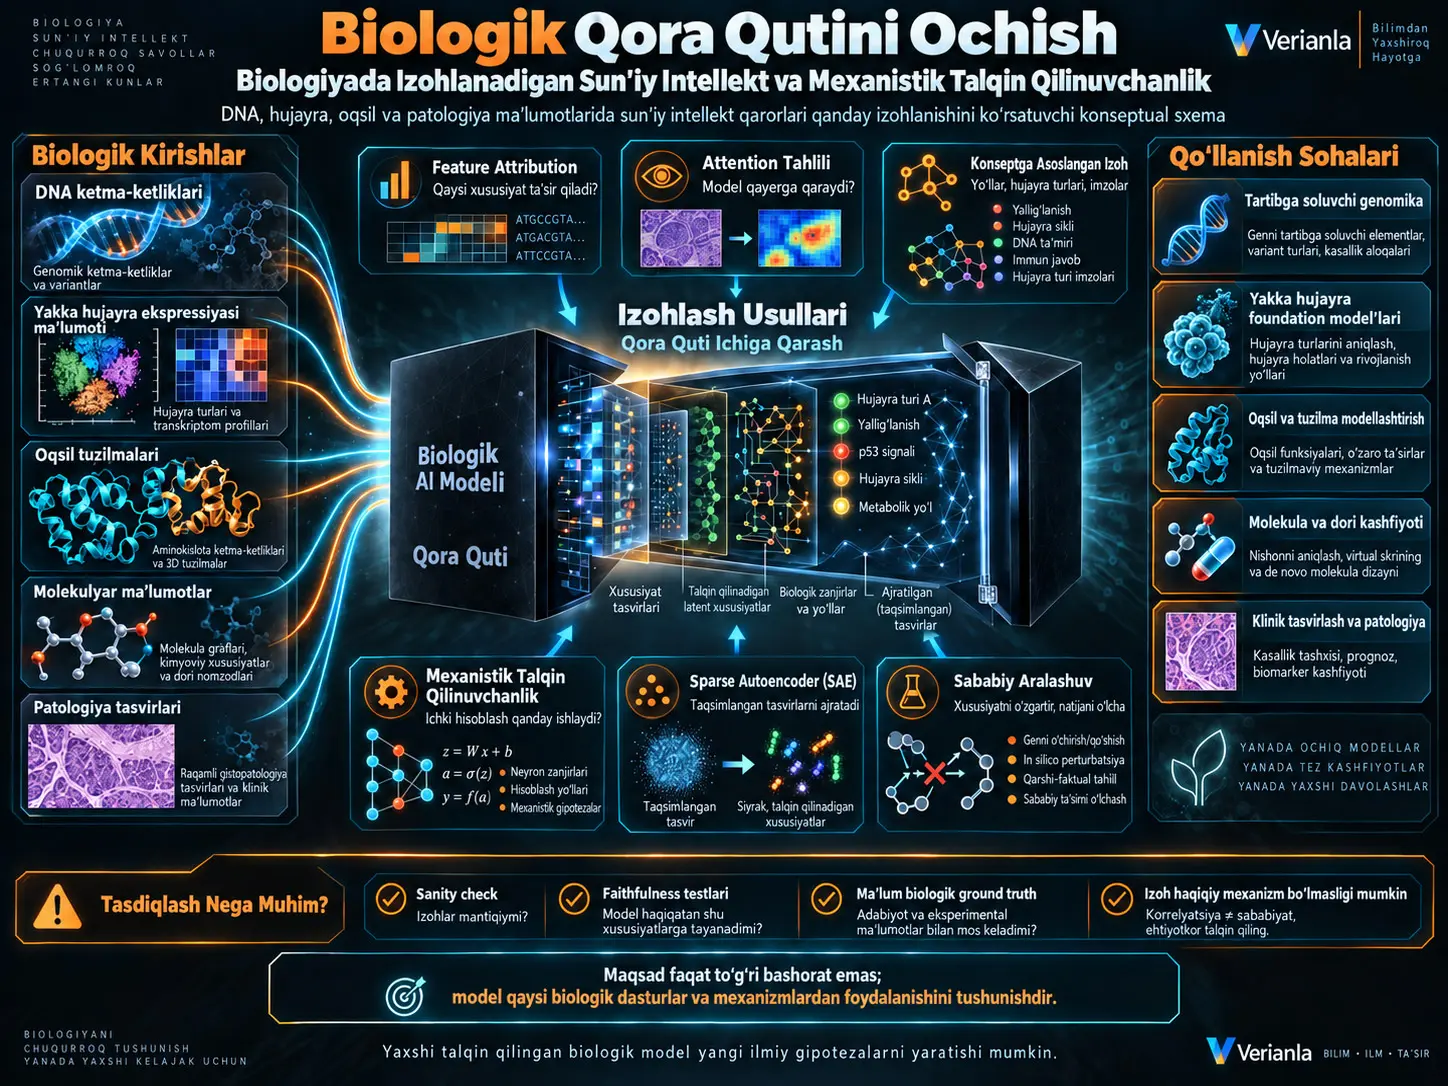
Izohlanadigan sun’iy intellekt (Explainable Artificial Intelligence, XAI) — sun’iy intellekt modelining bashorat yoki qarorlari qaysi kirishlar, tushunchalar yoki ichki hisob-kitoblarga tayanganini odamlar tekshira oladigan holga keltirishga intiladigan usullar majmuasidir. Olivia Denvisning survey tadqiqoti biologiyada qo‘llanadigan izohlash usullarini feature attribution, attention tahlili, concept-based explanation va mechanistic interpretability yo‘nalishlari bo‘yicha; qo‘llanmalarni esa genomika, bir-hujayrali foundation model’lar, oqsil modellashtirish, dori kashfiyoti va biotibbiy tasvirlash sohalarida tasniflaydi. Surveyning asosiy urg‘usi shundaki, biologik sun’iy intellekt tadqiqotlari faqat to‘g‘ri bashorat beruvchi modellardan model ichida qaysi biologik dasturlar va hisoblash mexanizmlari shakllanayotganini o‘rganadigan yondashuvlarga tomon siljimoqda.
Bu o‘zgarishda sparse autoencoder’lar (SAE) ayniqsa muhim ahamiyat kasb etdi. SAE’lar yirik sun’iy neyron tarmoqlarining bir-biriga qorishib ketgan ichki tasvirlarini siyrakroq va talqin qilinadigan xususiyatlarga ajratishni maqsad qiladi. Survey ushbu usulning til modellaridan biologik foundation model’larga ko‘chirilishi hujayra turi, gen dasturi yoki gistologik tuzilma kabi biologik tushunchalarni taqsimlangan embedding’lar ichidan ajratishga qaratilgan yangi tadqiqot yo‘nalishini shakllantirganini ta’kidlaydi.
Tadqiqot ayni paytda muhim ogohlantirish beradi: izohning vizual jihatdan ishontiruvchi bo‘lishi uning haqiqatan ham modelning qaror mexanizmini ifodalashini anglatmaydi. Attention xaritalari, saliency map’lar yoki feature attribution qiymatlari modeldan mustaqil naqshlar, kirishning o‘z geometriyasi yoki korrelyatsiyalar tufayli chalg‘ituvchi bo‘lishi mumkin. Shu sababli biologik XAI maqsadi faqat izoh yaratish emas, balki izohning model xatti-harakatiga haqiqatan bog‘langanini faithfulness testlari, sanity check’lar va imkon qadar aralashuv tajribalari bilan tasdiqlashdir.
Nega biologiyada sun’iy intellektning qora quti bo‘lishi alohida muammo?
Ko‘plab muhandislik qo‘llanmalarida modelning maqsadi to‘g‘ri qaror chiqarish bo‘lishi mumkin. Biologiyada esa model ko‘pincha bevosita ilmiy tushunish vositasidir. Biolog faqat DNA ketma-ketligining regulyator ekanini bilishni istamaydi; qaysi nukleotidlar ta’sirli ekanini, qaysi motiv transkripsiya faktorining bog‘lanishini boshqarishini va qaysi mexanizm orqali gen ifodasi o‘zgarishini ham bilishni xohlaydi.
Xuddi shu holat oqsillar, hujayralar va molekulalar uchun ham amal qiladi. Oqsil modeli to‘g‘ri tuzilmani bashorat qilishi mumkin; biroq qaysi aminokislota munosabatlari modelni shu tuzilmaga olib kelgani alohida ilmiy savoldir. Bir-hujayrali model hujayra turini to‘g‘ri tasniflashi mumkin; ammo qaror haqiqatan biologik gen dasturiga yoki texnik batch ta’siriga tayangan-tayanmagani noma’lum bo‘lsa, model ilmiy jihatdan chalg‘ituvchi bo‘lishi mumkin.
Survey shu sababli biologiyada izohlanadiganlik faqat ishonch yoki foydalanuvchi tajribasi masalasi emas, balki bevosita ilmiy gipoteza ishlab chiqish bilan bog‘liq ekanini ilgari suradi.
Biologiyada Izohlanadigan Sun’iy Intellekt Nima Qilishga Intiladi?
Biologik XAI model chiqishi qaysi biologik kirishlar, ifodalangan tushunchalar yoki ichki hisoblash jarayonlari bilan bog‘liq ekanini aniqlab, bashoratni biologik jihatdan mazmunli izohga aylantirishga intiladi; biroq bunday izoh ilmiy qiymatga ega bo‘lishi uchun uning model xatti-harakatiga haqiqatan faithful ekani alohida tasdiqlanishi kerak.
Intrinsic va post-hoc izoh
Survey ikki asosiy yondashuvni bir-biridan ajratadi. Intrinsic interpretability — modelning o‘z tuzilmasi tushunarli bo‘lishidir. Siyrak chiziqli modellar, qisqa qaror ro‘yxatlari yoki biologik ma’noga ega latent o‘zgaruvchilarga ega arxitekturalar bunga misol bo‘lishi mumkin.
Post-hoc explanation esa murakkab va bevosita o‘qib bo‘lmaydigan model o‘qitilgandan keyin uning xatti-harakatini tushuntirish uchun qo‘shimcha usullardan foydalanadi. SHAP, Integrated Gradients yoki Grad-CAM kabi usullar shu toifaga kiradi.
Post-hoc yondashuv kuchli modellarni tekshirish imkonini beradi; biroq izoh modelning o‘zi emas, model haqida keyinchalik hisoblangan obyekt hisoblanadi. Shu sababli izoh modelning haqiqiy qaror mantiqiga sodiqmi yoki yo‘qmi, alohida sinovdan o‘tkazilishi kerak.
Local va global izoh
Bir local explanation bitta model chiqishiga e’tibor qaratadi. Masalan, ma’lum bir DNA ketma-ketligi nega enhancer sifatida tasniflanganini yoki ma’lum hujayra nega T hujayrasi deb aniqlanganini tushuntirishga urinadi.
Global explanation esa modelning umumiy xatti-harakatini o‘rganadi. Masalan, genom bo‘ylab model doimiy ravishda qaysi motivlardan foydalanishi yoki oqsil modeli ichida ayrim attention head’lar odatda qaysi strukturaviy munosabatlarni ifodalashi o‘rganilishi mumkin.
Feature attribution
Feature-attribution usullari model chiqishidagi o‘zgarish qaysi kirish xususiyatlari bilan bog‘liqligini ballashga urinadi. Biologiya nuqtai nazaridan bu yondashuv ayniqsa tabiiy, chunki kirish xususiyatlarining o‘zi ko‘pincha fizik yoki biologik birliklardir:
- DNA modelida nukleotid,
- bir-hujayrali modelda gen,
- oqsil modelida aminokislota qoldig‘i,
- molekula modelida atom yoki bog‘,
- gistopatologiya modelida piksel yoki tasvir hududi.
Survey ko‘rib chiqadigan asosiy feature-attribution usullari LIME, SHAP, Integrated Gradients, DeepLIFT, Layer-wise Relevance Propagation va Grad-CAM hisoblanadi.
| Usullar oilasi | Asosiy savol | Tipik chiqish | Biologik qo‘llash shakli |
|---|---|---|---|
| LIME | Ushbu bitta bashorat atrofida qaysi xususiyatlar ta’sirli? | Mahalliy surrogate model | Muayyan namunaning xususiyat hissalari |
| SHAP | Har bir xususiyatning bashoratga marginal hissasi qanday? | Shapley asosidagi muhimlik qiymatlari | Gen, klinik xususiyat yoki molekulyar xususiyat attribution’i |
| Integrated Gradients | Kirishdan chiqishgacha gradient bo‘ylab qaysi xususiyatlar hissa qo‘shadi? | Har bir kirish bo‘yicha attribution | Nukleotid, aminokislota yoki tasvir pikseli muhimlik xaritasi |
| DeepLIFT | Aktivatsiya referensga nisbatan qanday o‘zgaradi? | Hissa ballari | Ayniqsa genomik motiv tahlili |
| Grad-CAM | Tasvirning qaysi hududlari sinf ballini qo‘llab-quvvatlaydi? | Issiqlik xaritasi | Gistopatologiya va tibbiy tasvirlash |
| TCAV | Model inson tomonidan belgilangan tushunchaga sezgirmi? | Concept activation yo‘nalishi | Yo‘lak, hujayra turi yoki biologik imzo tahlili |
| Sparse Autoencoder | Taqsimlangan ichki tasvirlar qaysi siyrak xususiyatlarga ajratilishi mumkin? | Talqin qilinadigan latent xususiyatlar | Foundation model ichidagi hujayra turi yoki to‘qima dasturlarini ajratish |
Nega Attention Og‘irliklari O‘z-o‘zicha Izoh Hisoblanmaydi?
Attention og‘irliklari model muayyan tokenlar orasida qaysi axborot yo‘llariga og‘irlik berganini ko‘rsatishi mumkin, biroq bir xil model chiqishi turli attention taqsimotlari bilan hosil qilinishi mumkinligi sababli yuqori attention qiymati o‘z-o‘zicha sababiy yoki faithful izoh emas; biologiyada attention xaritalari shu bois tasdiqlanishi kerak bo‘lgan gipotezalar sifatida ko‘rilishi lozim.
Bu farq oqsil modellari uchun ayniqsa muhim. Oqsil ketma-ketligidagi tokenlar aminokislotalarni ifodalaganda, attention head’ning ayrim qoldiqlarga yuqori og‘irlik berishi biologik jihatdan jozibali ko‘rinishi mumkin. Ammo bu haqiqatan bog‘lanish interfeysi, kontakt hududi yoki funksional motivni anglatishini faqat mustaqil strukturaviy ma’lumot bilan taqqoslab ko‘rsatish mumkin.
Survey oqsil til modellari bo‘yicha ishlarda ayrim attention head’larning strukturaviy kontaktlar, bog‘lanish hududlari va post-translational modification joylari bilan aloqasi miqdoriy taqqoslashlar orqali o‘rganilganini misol qilib keltiradi. Asosiy metodologik saboq shuki, attention vizualizatsiyasi natija emas, boshlang‘ich nuqta bo‘lishi kerak.
Tushunchaga asoslangan izohlar
Bitta nukleotid yoki gen darajasidagi attribution biolog o‘ylaydigan tushuncha ko‘lamidan past bo‘lishi mumkin. Tadqiqotchi ko‘pincha “qaysi gen?” o‘rniga “qaysi yo‘lak?”, “qaysi hujayra dasturi?” yoki “qaysi biologik jarayon?” deb so‘raydi.
Concept-based usullar model aktivatsiyalarining inson tomonidan belgilangan yuqori darajadagi tushunchalar bilan aloqasini o‘rganishni maqsad qiladi. Survey ko‘rib chiqadigan Testing with Concept Activation Vectors (TCAV) muayyan tushuncha uchun aktivatsiya fazosida yo‘nalish o‘rganadi va model bashoratlarining shu yo‘nalishga sezgirligini o‘lchaydi.
Biologiya bu yondashuv uchun boy maydon yaratadi, chunki gen to‘plamlari, hujayra turi imzolari, molekulyar yo‘laklar va funksional ontologiyalar insonlar tomonidan avvaldan belgilangan tushuncha lug‘atlarini hosil qiladi.
Mexanistik Talqin Qilinuvchanlik Feature Attribution’dan Qanday Farq Qiladi?
Feature attribution bashorat qaysi kirishlar bilan bog‘liq ekanini so‘rasa, mechanistic interpretability modelning ichki aktivatsiyalari va og‘irliklarida qaysi xususiyatlar ifodalanganini, bu xususiyatlar qaysi bog‘lanishlar orqali birlashishini va muayyan chiqishni hosil qilish uchun qaysi hisoblash zanjirlari ishlashini aniqlashga urinadi.
Shu sababli mexanistik talqin qilinuvchanlik modelni tashqaridan so‘roq qilish o‘rniga uning ichki tuzilishini teskari muhandislik obyektiga aylantiradi. Maqsad faqat “bu gen muhim” deyish emas, model muayyan hujayra dasturini qaysi latent tasvirda kodlaganini va bu tasvir keyingi qatlamlarda qaysi hisoblashga ta’sir qilganini aniqlashdir.
Superposition muammosi
Zamonaviy neyron tarmoqlarda bitta neyron faqat bitta insonga tushunarli xususiyatni ifodalaydi degan faraz ko‘pincha to‘g‘ri emas. Tarmoq o‘zidagi fizik neyronlar sonidan ko‘proq xususiyatni bir-biriga ustma-ust tushadigan yo‘nalishlarda kodlashi mumkin. Survey bu holatni superposition tushunchasi bilan izohlaydi.
Natijada bitta neyron bir nechta tushuncha bilan bog‘liq bo‘lishi mumkin va “bu neyron T hujayrasini ifodalaydi” kabi to‘g‘ridan-to‘g‘ri talqinlar chalg‘ituvchi bo‘lishi mumkin.
Sparse Autoencoder Biologik Foundation Model’larda Nima Beradi?
Sparse autoencoder zich va bir-biriga ustma-ust tushgan model aktivatsiyalarini kengroq, ammo siyrak faollashadigan xususiyatlar lug‘atiga ajratishga urinib, alohida latent xususiyatlarni muayyan hujayra turlari, gen dasturlari yoki gistologik tuzilmalar kabi biologik tushunchalar bilan moslashtirishni osonlashtiradi.
SAE yondashuvida modelning o‘z parametrlaridan ko‘ra ma’lum oraliq qatlam aktivatsiyalari tahlil qilinadi. Autoencoder bu aktivatsiyalarni yuqori o‘lchamli feature dictionary orqali qayta tiklashni o‘rganadi; sparsity cheklovi bir xil namunada faqat oz sonli xususiyatlarning kuchli faollashishini rag‘batlantiradi.
Survey ayniqsa ta’kidlaydigan rivojlanish — bu usulning katta til modellari talqinidan biologik foundation model’larga ko‘chirilishidir. Manba patologiya foundation model’larida gistologik tuzilmalar bilan va bir-hujayrali foundation model tasvirlarida hujayra turi dasturlari bilan bog‘lanishi mumkin bo‘lgan sparse xususiyatlar xabar qilingan tadqiqotlarni muhokama qiladi.
Buning ilmiy ahamiyati faqat latent xususiyatlarga nom berish emas. Agar muayyan SAE xususiyati faollashtirilishi yoki bostirilishi orqali model chiqishini tizimli ravishda o‘zgartirish mumkin bo‘lsa, izoh korrelyatsiyadan aralashuv darajasiga yaqinlashadi.
Regulyator genomika
Genomika XAI biologiyada erta qo‘llanilgan sohalardan biridir. DNA ketma-ketliklari bevosita model kirishi bo‘lganda har bir nukleotid yoki motiv uchun attribution hisoblash mumkin.
Survey DeepBind, DeepSEA, Basset, ExPecto, BPNet va Enformer kabi model oilalarini shu rivojlanish yo‘nalishida muhokama qiladi. Ayniqsa base-resolution modellarni DeepLIFT va motiv kashfiyoti usullari bilan birlashtirish nafaqat ma’lum motivlarni qayta topish, balki motivlarning birgalikda qanday tashkil etilishi haqida gipotezalar yaratish imkonini ham bergan.
Bir-hujayrali foundation model’lar
Geneformer, scGPT, scFoundation va Universal Cell Embeddings kabi modellar millionlab hujayralardan o‘rganilgan taqsimlangan tasvirlarni yaratadi. Bu embedding’lar hujayra turini tasniflash va perturbation prediction kabi downstream vazifalarda qo‘llanishi mumkin; biroq embedding o‘lchami biologik jihatdan nimani ifodalashi ko‘pincha bevosita ma’lum emas.
Surveyga ko‘ra, mexanistik talqin qilinuvchanlikni biologiyaga ko‘chirishning eng yaqqol misollaridan biri shu sohadir. Sparse dictionary learning orqali latent xususiyatlarni hujayra turi va gene-set dasturlari bilan moslashtirish foundation model’ning ichki tasvirini biologlar ishlatadigan tushunchalar lug‘atiga yaqinlashtiradi.
Biroq xususiyat bilan gene-set orasidagi korrelyatsiya o‘z-o‘zicha mexanistik xulosa emas. Survey ayniqsa muayyan latent xususiyatlarga aralashib, model xatti-harakati o‘zgaradimi yoki yo‘qmi, tekshirishni kuchliroq dalil standarti sifatida ilgari suradi.
Oqsil modellari
Oqsil til modellari yuz millionlab oqsil ketma-ketliklaridan strukturaviy va funksional tasvirlarni o‘rganishi mumkin. Oqsil tokenlarining bevosita aminokislota qoldiqlariga mos kelishi talqin qilinuvchanlik nuqtai nazaridan alohida afzallik beradi.
Attention head’larning kontakt nuqtalari, bog‘lanish hududlari yoki post-translational modification joylari bilan mos kelish-kelmasligi bevosita strukturaviy annotatsiyalar bilan taqqoslanishi mumkin. Bu xususiyat oqsil modellarini mechanistic interpretability va sparse dictionary usullari uchun kuchli nishonga aylantiradi.
Molekula va dori kashfiyoti
Graph neural network’lar molekulalarni atom va bog‘lardan tashkil topgan graflar sifatida qayta ishlaydi. Molekula faolligini tushuntirish ko‘pincha qaysi subgraf yoki kimyoviy guruh bashoratga hissa qo‘shayotganini aniqlash deganidir.
Survey GNNExplainer kabi usullar bashoratni imkon qadar saqlab qoladigan kichik molekulyar subgrafni topishga intilishini tushuntiradi. Shunday qilib izoh shunchaki muhimlik balli bo‘lishdan chiqib, kimyogar tekshira oladigan molekulyar motivga aylanishi mumkin.
Klinik tasvirlash va raqamli patologiya
Gistopatologiya va boshqa biotibbiy tasvirlarda Grad-CAM hamda saliency asosidagi usullar tasniflash qaroriga ta’sir qiluvchi tasvir hududlarini belgilash uchun keng qo‘llaniladi.
Ammo bu soha XAI’ning eng muhim xavfini ham yaqqol ko‘rsatadi: o‘sma tasniflagichi haqiqiy gistologik xususiyat o‘rniga skaner artefakti, shifoxona belgisi yoki tasvirlash protokolidan foydalanishi mumkin. Vizual izoh bunday shortcut’larni sezishga yordam beradi; biroq noto‘g‘ri ishlab chiqilgan izohlash usuli ayni artefaktni biologik signal sifatida ko‘rsatishi ham mumkin.
Tadqiqotning Usuli va Natijalari
Bu tadqiqot qanday usuldan foydalangan?
Tadqiqot yangi eksperimental model ishlab chiqmaydi. Muallif mavjud XAI va mechanistic interpretability adabiyotini konseptual taksonomiya ostida birlashtiradi. Survey ikki mustaqil o‘qdan foydalanadi:
- Usul o‘qi: feature attribution, attention analysis, concept-based explanation va mechanistic interpretability.
- Qo‘llash o‘qi: genomika, bir-hujayrali/foundation model’lar, oqsillar, molekula va dori kashfiyoti, klinik tasvirlash va patologiya.
| Soha | Model kirishi / tasviri | Tipik talqin qilinuvchanlik savoli | Tasdiqlash imkoniyati |
|---|---|---|---|
| Regulyator genomika | DNA ketma-ketligi | Qaysi nukleotid yoki motiv chiqishga ta’sir qiladi? | Ma’lum motivlar, bog‘lanish va regulyator tajribalar |
| Bir-hujayrali biologiya | Gen ifodasi / hujayra embedding’i | Qaysi gen dasturi yoki hujayra holati ifodalanmoqda? | Gene-set, hujayra turi annotatsiyasi va perturbation |
| Oqsil modellari | Aminokislota ketma-ketligi / internal representation | Model qaysi strukturaviy yoki funksional munosabatni kodlaydi? | Oqsil tuzilmalari, kontakt va bog‘lanish hududlari |
| Molekula va dori kashfiyoti | Atom-bog‘ grafi | Qaysi sub-tuzilma faollik bashoratini boshqaradi? | Kimyoviy tajribalar va tuzilma-faollik munosabati |
| Raqamli patologiya | Tasvir | Model qaysi to‘qima hududlariga tayanadi? | Patologiya annotatsiyasi va klinik tasdiqlash |
Izohning to‘g‘ri ekanini qanday bilamiz?
Surveyning eng kuchli metodologik xabarlaridan biri shuki, izoh alohida baholanishi kerak. Model bashorati to‘g‘ri bo‘lsa ham, izohi noto‘g‘ri bo‘lishi mumkin.
Manba uchta asosiy tasdiqlash yondashuvini ilgari suradi:
- Sanity check: Model og‘irliklari yoki yorliqlar tasodifiylashtirilganda izoh ham o‘zgaradimi?
- Faithfulness testi: Muhim deb da’vo qilingan xususiyat olib tashlanganda yoki o‘zgartirilganda model chiqishi haqiqatan ta’sirlanadimi?
- Biologik ground truth taqqoslovi: Attribution yoki model xususiyati ma’lum motiv, bog‘lanish hududi, pathway yoki hujayra turi annotatsiyasi bilan mos keladimi?
Bu tekshiruvlarning maqsadi izohning inson ko‘ziga mazmunli ko‘rinishini emas, modelning haqiqiy hisob-kitobi bilan bog‘liqligini sinashdir.
Nega Sababiy Aralashuv Kuchliroq Izoh Testidir?
Sababiy aralashuv model ichida muayyan latent xususiyat yoki zanjir nazoratli tarzda kamaytirilganda yoki kuchaytirilganda chiqishdagi o‘zgarishni o‘lchagani uchun faqat korrelyatsiyani ko‘rsatishdan kuchliroq; bu yondashuv biologiyadagi perturbation tajribasi mantiqini sun’iy neyron tarmog‘ining ichki tasvirlariga qo‘llaydi.
Agar latent feature muayyan hujayra turi bilan korrelyatsiya ko‘rsatsa, bu o‘z-o‘zicha o‘sha feature model qarori uchun zarur ekanini isbotlamaydi. Xususiyat o‘chirib qo‘yilganda hujayra tasnifi yoki boshqa downstream xatti-harakat tizimli ravishda o‘zgarsa, mexanistik aloqa uchun kuchliroq dalil olinadi.
Survey bu interventionist standartni biologiyaning eksperimental madaniyatiga ayniqsa mos deb hisoblaydi.
Ochiq muammo: biologik ground truth to‘liq emas
XAI’ning biologiyadagi asosiy paradokslaridan biri shuki, izoh to‘g‘rimi yoki yo‘qmi tekshirish uchun biologik haqiqat kerak; biroq o‘rganilayotgan mexanizmning o‘zi ko‘pincha hali to‘liq ma’lum emas.
Genom modeli noma’lum hududni muhim deb ko‘rsatganda ikki izoh mumkin:
- model haqiqatan yangi biologik regulyator elementni aniqlagan;
- model ma’lumotlar to‘plamidagi artefaktga tayangan.
Faqat attribution xaritasiga qarab bu ikki imkoniyatni ajratib bo‘lmaydi. Yangi biologik tajriba yoki mustaqil tasdiqlash kerak bo‘lishi mumkin.
Ochiq muammo: foundation model miqyosi
Biologik foundation model’lar kattalashgan sari har bir neyron yoki circuit’ni inson tomonidan alohida tahlil qilish imkonsizlashadi. Sparse dictionary learning bu muammoni qisman avtomatlashtirishni va’da qiladi; biroq survey dictionary size tanlovi, bitta biologik tushunchaning bir nechta sparse feature’ga bo‘linishi va xususiyatlarning circuit darajasida bir-biriga ulanishi kabi muammolar hali hal etilmaganini ta’kidlaydi.
Interpretability by design
Manbaning tadqiqot kun tartibidagi yana bir yo‘nalish — modelni o‘qitgandan keyin tushuntirish o‘rniga uni boshidan biologik jihatdan mazmunli latent tuzilmalar bilan loyihalash.
Masalan, latent o‘zgaruvchilar bevosita pathway, hujayra turi yoki biofizik kattaliklar bilan cheklansa, post-hoc izohga ehtiyoj kamayishi mumkin. Biroq buning model aniqligi va umumlashtirishiga qanday ta’sir qilishi alohida o‘rganilishi kerak.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
Survey qo‘llab-quvvatlaydi: Biologik XAI adabiyoti oddiy feature attribution’dan yuqori darajadagi konseptual va mexanistik tahlillarga tomon kengaymoqda. Sparse autoencoder va circuit analysis kabi usullarni biologik foundation model’larga qo‘llash boshlangani model ichidagi tasvirlarni biologik tushunchalar bilan bog‘lash uchun yangi imkoniyatlar ochmoqda. Shunga qaramay explanation faithfulness mustaqil ravishda sinovdan o‘tkazilishi kerak.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
Survey qo‘llab-quvvatlamaydi: Har bir attention map biologik mexanizmni ifodalaydi, har bir saliency map ishonchli, sparse autoencoder feature’lari avtomatik ravishda haqiqiy biologik obyektlarga mos keladi yoki mechanistic interpretability hozirgi holatida biologik foundation model’larni to‘liq yechib bo‘lgan degan xulosaga kelib bo‘lmaydi.
Bundan tashqari, survey yangi biologik mexanizmlarni o‘z tajribalari bilan kashf qilmaydi va havola qilgan barcha tadqiqotlar natijalarini qayta ishlab chiqarmaydi.
Manba va Usul Qaydi
Asl tadqiqot: Opening the Biological Black Box: A Survey of Explainable and Mechanistic Interpretability Methods for AI in Biology.
Muallif: Olivia Denvis.
Affiliatsiya: Independent Researcher.
Manba turi: Survey / SSRN preprint.
Tadqiqot sanasi: 15-iyun 2026.
SSRN e’lon sanasi: 23-iyun 2026.
SSRN Abstract ID: 6968318.
DOI: 10.2139/ssrn.6968318.
Taqriz holati: Manba taqrizdan o‘tgan jurnal maqolasi sifatida emas, preprint sifatida e’lon qilingan.
Nashr litsenziyasi / huquq holati: SSRN yozuvi ochiq Creative Commons qayta foydalanish litsenziyasini ko‘rsatmaydi va himoyalangan materialdan ruxsatsiz qayta foydalanishga yo‘l qo‘yilmasligini bildiradi. Shu sababli Verianla matni manbadagi iboralarning qayta nashri emas; adabiyot surveyida bayon qilingan ilmiy tushunchalarning mustaqil o‘quviy sintezidir.
Yangi tajriba/ma’lumot: Tadqiqot yangi biologik tajriba, ma’lumotlar to‘plami yoki benchmark yaratmaydi. Adabiyotdagi XAI va mechanistic interpretability ishlarini tasniflaydi va baholaydi.
Asosiy metodologik cheklov: Survey bayon qilgan natijalarning eksperimental dalillari tegishli birlamchi tadqiqotlarda mavjud. Muayyan usul yoki qo‘llanmaning batafsil samaradorligini baholash uchun asl manbaga qaytish kerak.
Asosiy epistemik cheklov: Biologiyada ground truth qisman va bahsli bo‘lishi mumkin. Shu sababli model izohining ma’lum biologiya bilan mos kelmasligi har doim izoh noto‘g‘ri ekanini; mos kelishi esa avtomatik ravishda sababiy mexanizm ekanini anglatmaydi.
Havolalar qamrovi: Survey 44 tadqiqot asosida klassik XAI, biologik deep learning qo‘llanmalari, foundation model’lar, mechanistic interpretability va explanation-validation adabiyotlarini birlashtiradi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan