

Ovozli sunʼiy intellekt modellari endi faqat nutqni yozuvga aylantirmaydi. Foydalanuvchi ovozini, nutq kontekstini va baʼzan fondagi atrof-muhit tovushlarini ham tushunishga harakat qiladi. Masalan, suhbat paytida yomgʻir ovozi, mashina signali, changyutgich, it vovillashi yoki chaqaloq yigʻisi eshitilishi mumkin.
Yang Xiao va hamkasblari tayyorlagan ushbu maqola katta ovoz–til modellerining koʻp turli suhbatlarda bu atrof-muhit tovushlarini qanchalik eslab qolishini oʻrganadi. Ishning asosiy topilmasi ancha eʼtiborga loyiq: Modellar suhbatdagi soʻz va maʼno axborotini atrof-muhit tovushlariga qaraganda yaxshiroq eslaydi. Fon tovushlari esa suhbat uzaygan sari tezroq unutiladi.
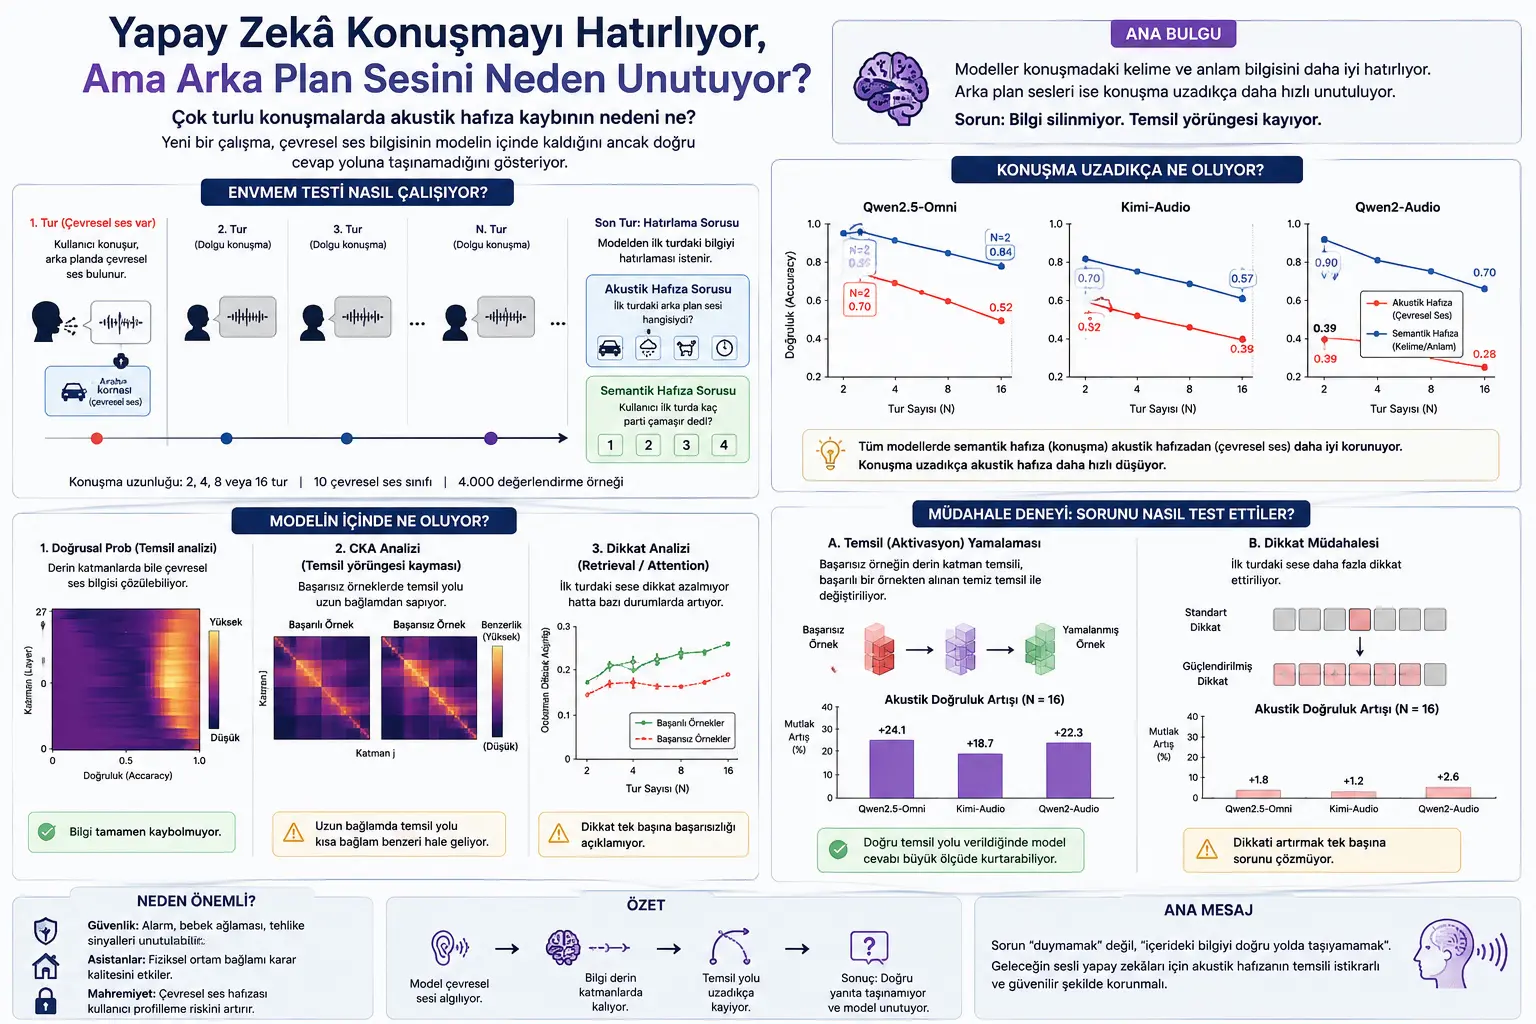
Tadqiqotchilar bu holatni oʻlchash uchun EnvMem nomli nazorat qilinadigan sinov tizimini quradi. Birinchi suhbat turiga bir atrof-muhit tovushi joylashtiriladi. Keyin suhbat bir necha tur davom etadi. Eng oxirida modelga yo suhbatdagi matnli axborot yoki fondagi atrof-muhit tovushi soʻraladi.
Natijalarga koʻra muammo oddiygina “model ovozni butunlay yoʻqotadi” emas. Atrof-muhit tovushi axboroti modelning chuqur qatlamlarida hali ham ajratib olinishi mumkin. Ammo bu axborot javob hosil qilish yoʻliga toʻgʻri shaklda koʻchirilmaydi. Maqola bunga representational trajectory drift, yaʼni vakillik trayektoriyasi siljishi deb ataydi.
Ovozli yordamchilar bilan gaplashganda faqat soʻzlar boʻlmaydi. Fonida eshik qoʻngʻirogʻi, signal, transport, yomgʻir, chaqaloq yigʻisi yoki mashina tovushi boʻlishi mumkin. Bu tovushlar baʼzan kontekst uchun muhimdir.
Masalan, xavfsizlik tizimida signal tovushi, texnik xizmat yordamchisida mashina tovushi, uy yordamchisida chaqaloq yigʻisi yoki suv ovozi muhim boʻlishi mumkin. Agar sunʼiy intellekt bu tovushlarni dastlab sezib, keyin suhbat davom etgan sari unutsa, qaror qabul qilish jarayoni zaiflashishi mumkin.
Mavjud katta ovoz–til modellari odatda suhbatdagi maʼnoni yaxshiroq saqlaydi. Foydalanuvchi “kir yuvishni uch partiya qilaman” desa, model buni bir necha turdan keyin eslay oladi. Lekin xuddi shu birinchi suhbatda fonda mashina signali boʻlsa, bir necha turdan keyin buni eslashda koʻproq qiynaladi.
Bu holat ikki savolni kun tartibiga qoʻyadi:
1. Modellar suhbatdagi soʻz axborotini mi, yo atrof-muhit tovushi axborotini mi yaxshiroq eslaydi?
2. Atrof-muhit tovushi unutilayotgan boʻlsa, bu axborot haqiqatan model ichidan oʻchirilgani uchunmi, yo axborot ichkarida turgan holda javob hosil qilishda ishlatilmagani uchunmi?
Maqolaning asl qiymati shu yerda. Tadqiqotchilar faqat model ballariga qaramaydi; modelning ichki qatlamlarini tahlil qilib, xato qayerda paydo boʻlishini tushunishga harakat qiladi.
Usul nima taklif qiladi?
Tadqiqotchilar bu muammoni oʻrganish uchun EnvMem nomli sinov doirasini yaratadi.
EnvMem mantiqi oddiy:
- Birinchi foydalanuvchi nutqiga bir atrof-muhit tovushi qoʻshiladi.
- Bu atrof-muhit tovushi faqat birinchi turda boʻladi.
- Keyingi suhbatlar toʻldiruvchi suhbatlar sifatida davom etadi.
- Eng oxirida modelga koʻp variantli savol beriladi.
- Savol yo birinchi suhbatdagi matnli axborotni, yo fondagi atrof-muhit tovushini eslashga qaratilgan boʻladi.
Masalan, birinchi suhbatda foydalanuvchi kir yuvish haqida gapiradi va fonda mashina signali bor. Keyin suhbat davom etadi. Eng oxirida modelga ikki xil turdagi savol berilishi mumkin:
Akustik xotira savoli:
Birinchi ovozli xabar fonida qaysi atrof-muhit tovushi bor edi?
Semantik xotira savoli:
Foydalanuvchi birinchi suhbatda kir yuvish uchun necha partiya deb aytgan edi?
Bu dizayn muhim, chunki matnli axborot va atrof-muhit tovushi bir xil boshlangʻich kontekstdan keladi. Shunday qilib modelning suhbat axborotini mi yo atrof-muhit tovushini mi yaxshiroq eslayotgani adolatroq oʻlchanishi mumkin.
EnvMem maʼlumotlar toʻplamida 10 atrof-muhit tovushi sinfi ishlatiladi:
- Yomgʻir
- Momaqaldiroq
- Dengiz toʻlqinlari
- Motor ovozi
- Changyutgich
- Mashina signali
- It ovozi
- Chaqaloq yigʻisi
- Soat tiktaki
- Sharaq-sharaq yonayotgan olov
Suhbat uzunliklari 2, 4, 8 va 16 tur sifatida oʻzgartiriladi. Shunday qilib suhbat uzaygan sari atrof-muhit tovushi xotirasining qanday buzilishi oʻlchanadi.
Formulalar nima haqida?
Maqoladagi formulalar sinov tuzilmasini va xotira yoʻqolishini oʻlchash usulini tushuntiradi. Oʻquvchi uchun soddalashtirsak, ikkita asosiy gʻoya bor.
Birinchi gʻoya: Koʻp turli suhbat tuzilmasi
Maqola suhbatni ketma-ket turlar sifatida taʼriflaydi. Birinchi turda foydalanuvchi gapiradi va bu nutqqa atrof-muhit tovushi qoʻshiladi. Keyingi turlar suhbatni uzaytiradi. Eng oxirgi turda esa modeldan birinchi turdagi axborotni eslashi soʻraladi.
Bu yerda muhim nuqta quyidagicha: Atrof-muhit tovushi faqat birinchi turda bor. Keyingi turlarda takrorlanmaydi. Shunday qilib modelning haqiqatan oldingi tovushni eslayotgani yoki eslamayotgani sinovdan oʻtkaziladi.
Ikkinchi gʻoya: Akustik xotira yoʻqolishini semantik xotira yoʻqolishi bilan solishtirish
Maqola suhbat uzaygan sari modelning ikki turdagi axborotdagi aniqlik pasayishini solishtiradi:
- Akustik axborot: Fon tovushi nima edi?
- Semantik axborot: Suhbatda aytilgan matnli fakt nima edi?
Agar akustik aniqlik tezroq tushsa, model atrof-muhit tovushini suhbat maʼnosiga qaraganda tezroq unutayotgan demakdir.
Shu sababli maqoladagi farq oʻlchovi quyidagini bildiradi:
Suhbat uzayganda atrof-muhit tovushi xotirasi soʻz/maʼno xotirasiga qaraganda tezroq buziladimi?
Natijalarga koʻra javob ha. Modellar atrof-muhit tovushi axborotini suhbatdagi semantik axborotga qaraganda moʻrtroq ushlab turadi.
Grafik / Jadval / Sxema asosiy xabari
EnvMem sxemasi:
Maqoladagi birinchi katta sxema sinovning qanday qurilganini koʻrsatadi. Birinchi suhbat turiga atrof-muhit tovushi joylashtiriladi, keyingi turlar suhbatni uzaytiradi, eng oxirida modeldan yo atrof-muhit tovushini, yo matnli axborotni eslashi soʻraladi. Sxemaning asosiy xabari quyidagicha: Tadqiqotchilar tasodifiy haqiqiy suhbatlar oʻrniga nazorat qilinadigan xotira sinovini quradi. Shunday qilib ovoz va maʼno xotirasi alohida-alohida oʻlchanishi mumkin.
Akustik va semantik xotira grafigi:
Maqoladagi samaradorlik grafigi Qwen2.5-Omni, Kimi-Audio va Qwen2-Audio modellerining 2, 4, 8 va 16 turli suhbatlardagi muvaffaqiyatini koʻrsatadi. Grafiklarning asosiy xabari aniq: Suhbat uzaygan sari ham matnli, ham akustik xotira pasayadi; biroq atrof-muhit tovushi xotirasi tezroq buziladi.
Qatlamma-qatlam linear probing grafigi:
Maqoladagi linear probing grafigi atrof-muhit tovushi axborotining modelning qaysi qatlamlarida ajratib olinishi mumkinligini koʻrsatadi. Qiziqarli natija quyidagicha: Model notoʻgʻri javob bersa ham, chuqur qatlamlarda atrof-muhit tovushi axboroti hali ham topilishi mumkin. Yaʼni axborot butunlay oʻchirilmagan.
CKA issiqlik xaritalari:
CKA grafiklari muvaffaqiyatli va muvaffaqiyatsiz urinishlarda modelning ichki vakillik yoʻli qanday oʻzgarishini koʻrsatadi. Asosiy xabar quyidagicha: Muvaffaqiyatsiz holatlarda vakillik uzoq kontekstni toʻgʻri koʻchiradigan yoʻldan ogʻadi va qisqa kontekstga oʻxshash ishlov berish tartibiga siljiydi. Bu ham “vakillik trayektoriyasi siljishi” gʻoyasini qoʻllab-quvvatlaydi.
Diqqat tahlili grafigi:
Maqola modelning birinchi atrof-muhit tovushi boʻlgan suhbatga yetarli diqqat qaratayotganini ham oʻrganadi. Natija hayratlanarli: Diqqat taqsimoti yolgʻiz oʻzi muvaffaqiyatsizlikni tushuntirmaydi. Hatto baʼzi uzun kontekstlarda model birinchi turga koʻproq diqqat qaratayotgandek koʻrinsa ham, toʻgʻri javob bera olmasligi mumkin.
Faollashtirishni yamoqlash grafigi:
Maqoladagi aralashuv tajribasida muvaffaqiyatsiz modelning chuqur qatlam vakilligi toʻgʻri namunadan olingan toza vakillik bilan almashtiriladi. Bu amal toʻgʻri javob ulushini jiddiy oshiradi. Asosiy xabar quyidagicha: Muammo diqqatni oshirish bilan hal boʻlmaydi; toʻgʻri hizalangan ichki vakillik kerak boʻlganda model javobni qutqara oladi.
Tajribalar qanday oʻtkazilgan?
Tadqiqotchilar uchta katta ovoz–til modelini sinaydi:
- Qwen2.5-Omni
- Qwen2-Audio
- Kimi-Audio
Bu modeller ovoz va nutq kirishlarini bevosita qayta ishlay oladigan ochiq ogʻirlikli zamonaviy arxitekturalar sifatida tanlanadi.
Har bir sinov namunasida model koʻp turli ovozli suhbat oladi. Birinchi suhbatda atrof-muhit tovushi bor. Keyingi turlar faqat suhbatni uzaytiradi. Eng oxirida modeldan toʻrt variantli savolga javob berishi soʻraladi.
Sinov ikki shaklda oʻtkaziladi:
1. Akustik eslash sinovi
Modeldan birinchi suhbatdagi atrof-muhit tovushini tanlashi soʻraladi.
2. Semantik eslash sinovi
Modeldan birinchi suhbatda aytilgan matnli axborotni tanlashi soʻraladi.
Jami 4.000 baholash namunasi yaratiladi. Buning 2.000 tasi akustik savollar, 2.000 tasi semantik savollar uchun ishlatiladi.
Tadqiqotchilar bundan tashqari model ichini oʻrganish uchun ikkita tahlil usulini qoʻllaydi:
Linear probing:
Modelning turli qatlamlarida atrof-muhit tovushi axboroti hali ham ajratib olinishi mumkinmi, deb qaraladi.
CKA tahlili:
Muvaffaqiyatli va muvaffaqiyatsiz namunalarda modelning ichki vakillik tuzilmasi bir-biriga qanchalik oʻxshashligi oʻlchanadi.
Nihoyat ikki turdagi aralashuv sinab koʻriladi:
- Chuqur qatlamdagi vakillikni oʻzgartirish
- Diqqat mexanizmini birinchi tovushga koʻproq eʼtibor qaratadigan qilib oʻzgartirish
Shu orqali muammo vakillik darajasidami, yo diqqat darajasidami, deb sinovdan oʻtkaziladi.
Natijalar nima koʻrsatmoqda?
Natijalar bir necha muhim nuqtaga ishora qiladi.
Birinchidan, modeller suhbatdagi maʼno axborotini atrof-muhit tovushi axborotidan yaxshiroq eslaydi. Masalan, Qwen2.5-Omni modelida 2 turli suhbatda semantik aniqlik taxminan 0.92 boʻlsa, akustik aniqlik taxminan 0.70 darajasida qoladi. Suhbat 16 turga chiqqanda semantik aniqlik taxminan 0.84 ga tushadi, akustik aniqlik esa taxminan 0.56 gacha pasayadi.
Ikkinchidan, bu farq faqat dastlabki sezish zaifligidan kelib chiqmaydi. Suhbat uzaygan sari atrof-muhit tovushlari matnli axborotga qaraganda tezroq buziladi.
Uchinchidan, atrof-muhit tovushi axboroti butunlay yoʻqolmaydi. Linear probing tahlillari model notoʻgʻri javob berganda ham chuqur qatlamlarda atrof-muhit tovushi sinfining hali ham ajratib olinishi mumkinligini koʻrsatadi. Bu juda muhim topilma. Chunki muammo “axborot oʻchirildi” emas; “axborot toʻgʻri javob hosil qilish yoʻliga mos formatda koʻchirilmadi”dek koʻrinadi.
Toʻrtinchidan, diqqat mexanizmi yolgʻiz oʻzi tushuntiruvchi emas. Modelga birinchi atrof-muhit tovushi boʻlgan qismga koʻproq diqqat qaratish muvaffaqiyatsiz javoblarni sezilarli darajada tuzatmaydi.
Beshinchidan, chuqur qatlam vakilligini toʻgʻri va toza namunadan olingan vakillik bilan almashtirish muvaffaqiyatsiz javoblarning muhim qismini qutqara oladi. Bu natija asosiy tor joy vakillik darajasida ekanini qoʻllab-quvvatlaydi.
Maqolaning eng kuchli natijasi quyidagicha umumlashtirilishi mumkin:
Ovozli sunʼiy intellekt modeli atrof-muhit tovushini butunlay unutmaydi; biroq bu axborotni uzoq suhbat davomida toʻgʻri vakillik yoʻlida ushlab turishda qiynaladi.
Bu nima uchun muhim?
Bu ish kelajakdagi ovozli yordamchilar uchun muhim muammoni koʻrsatadi.
Bugun ovozli sunʼiy intellekt tizimlari asosan “foydalanuvchi nima dedi?” savoliga eʼtibor qaratadi. Ammo haqiqiy hayotda “fonda nima boʻlyapti?” savoli ham muhim boʻlishi mumkin.
Masalan:
- Uy yordamchisi chaqaloq yigʻisini eslab qolishi kerakmi?
- Xavfsizlik tizimi signal tovushini suhbat davomida saqlay olishi kerakmi?
- Texnik xizmat yordamchisi mashina tovushidagi ogohlantirish belgisini keyingi suhbatlarda kontekst sifatida ishlatishi kerakmi?
- Sogʻliq yoki favqulodda holat tizimida atrof-muhit tovushlari qaror jarayoniga hissa qoʻsha oladimi?
Bunday ilovalarda modelning faqat suhbatni emas, atrof-muhit akustik kontekstini ham ishonchli tarzda eslashi kerak.
Ammo bu ayni paytda maxfiylik xavfini ham kattalashtiradi. Chunki atrof-muhit tovushlaridan odam uyda mi, ishda mi, yoʻlda mi ekani; yonida chaqaloq bormi-yoʻqmi; kundalik tartibi yoki nozik muhit maʼlumotlari chiqarib olinishi mumkin. Shu sababli akustik xotira texnologiyalari rivojlantirilayotganda ochiq rozilik, maʼlumot saqlash chegarasi va xavfsizlik choralari kerak.
Diqqat nuqtalari
Bu ish kuchli tahlil taqdim etsa-da, baʼzi cheklovlarni oʻz ichiga oladi.
Birinchidan, EnvMem nazorat qilinadigan va sintetik sinov muhitidan foydalanadi. Suhbatlar bitta TTS ovozi bilan yaratilgan. Haqiqiy hayotdagi turli soʻzlovchilar, aksentlar, mikrofon sifati, spontan suhbatlar va bir-biriga ustma-ust tushgan atrof-muhit tovushlari bu sinovda toʻliq aks ettirilmaydi.
Ikkinchidan, har suhbatda faqat bitta atrof-muhit tovushi birinchi turga joylashtiriladi. Haqiqiy hayotda atrof-muhit tovushlari doimiy oʻzgarishi, bir vaqtda bir necha tovush boʻlishi yoki fon shovqini suhbat davomida davom etishi mumkin.
Uchinchidan, ishdagi aralashuvlar amaliy mahsulot yechimi sifatida emas, tashxis qoʻyish maqsadida qilinadi. Yaʼni chuqur qatlam vakilligini oʻzgartirish usuli bugungi holatida toʻgʻridan-toʻgʻri kundalik tizimlarga qoʻllanadigan yechim emas.
Toʻrtinchidan, ish muayyan modeller bilan chegaralangan. Qwen2.5-Omni, Qwen2-Audio va Kimi-Audio ustida topilgan natijalar muhim boʻlsa-da, barcha ovozli sunʼiy intellekt modellari uchun qatʼiy umumlashtirish toʻgʻri boʻlmaydi.
Beshinchidan, atrof-muhit tovushi xotirasining kuchayishi maxfiylik jihatidan ikki tomonlama. Yaxshiroq eslaydigan tizimlar foydaliroq boʻlishi mumkin; lekin foydalanuvchi muhitini uzoqroq kuzatish va profil yaratish xavfini ham keltirib chiqarishi mumkin.
Xulosa
Bu maqola katta ovoz–til modellerining suhbatdagi maʼno axborotini atrof-muhit tovushi axborotidan mustahkamroq ushlab turishini koʻrsatadi. Modellar koʻp turli suhbatlarda “foydalanuvchi nima dedi?” savoliga “fonda nima bor edi?” savoliga qaraganda yaxshiroq javob beradi.
Tadqiqotchilarning eng muhim topilmasi atrof-muhit tovushi axborotining butunlay yoʻqolmaganidir. Axborot modelning chuqur qatlamlarida hali ham ajratib olinishi mumkin. Lekin uzoq kontekstlarda bu axborot toʻgʻri javob hosil qilish jarayoni bilan mos tarzda koʻchirilmaydi. Bu holatga vakillik trayektoriyasi siljishi deyiladi.
Verianla nuqtai nazaridan maqolaning asosiy xabari quyidagicha:
Ovozli sunʼiy intellektlarning haqiqatan atrofini tushuna olishi uchun faqat nutqni yozuvga aylantirishi yetmaydi. Fon tovushlarini uzoq suhbat davomida toʻgʻri vakillik qilib, kerak boʻlganda ishonchli tarzda eslay olishi kerak. Ammo bu qobiliyat maxfiylik va xavfsizlik masʼuliyati bilan birgalikda rivojlantirilishi lozim.
Manba va usul eslatmasi
Bu kontent Yang Xiao, Siyi Wang, Han Yin, Hong Jia, Vidhyasaharan Sethu, Eun-Jung Holden va Ting Dang tomonidan tayyorlangan “Why Can’t They Remember? Uncovering Representation and Retrieval Bottlenecks in Multi-Turn Acoustic Memory” nomli akademik ishdan foydalanib Verianla tahririy formatida oʻziga xos tarzda tayyorlangan.
Bu yozuv soʻzma-soʻz tarjima emas; maqoladagi usul, EnvMem sinov tuzilmasi, grafklar, formulalar, tajribalar, model ichi tahlillari va natijalar soddalashtirilib oʻzbek oʻquvchilari uchun qayta yozilgan. Kontent axborot va taʼlim maqsadini koʻzlaydi. Ovozli yordamchilar, atrof-muhit tovushini kuzatish, xavfsizlik tizimlari yoki foydalanuvchi profilini yaratish kabi sohalarda etik, huquqiy va maxfiylik talablari hisobga olinishi kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan