

Səsli süni intellekt modelləri artıq yalnız danışığı mətnə çevirmir. Onlar istifadəçinin səsini, danışıq kontekstini və bəzən arxa fondakı ətraf mühit səslərini də anlamağa çalışırlar. Məsələn, danışıq zamanı yağış səsi, avtomobil siqnalı, tozsoran, it hürməsi və ya körpə ağlaması eşidilə bilər.
Yang Xiao və həmkarlarının hazırladığı bu məqalə böyük səs-dil modellərinin çoxturlu söhbətlərdə bu ətraf mühit səslərini nə dərəcədə xatırlaya bildiyini araşdırır. Tədqiqatın əsas tapıntısı kifayət qədər diqqətçəkicidir: Modellər danışıqda keçən söz və məna məlumatını ətraf mühit səslərinə nisbətən daha yaxşı xatırlayırlar. Arxa fon səsləri isə söhbət uzandıqca daha sürətlə unudulur.
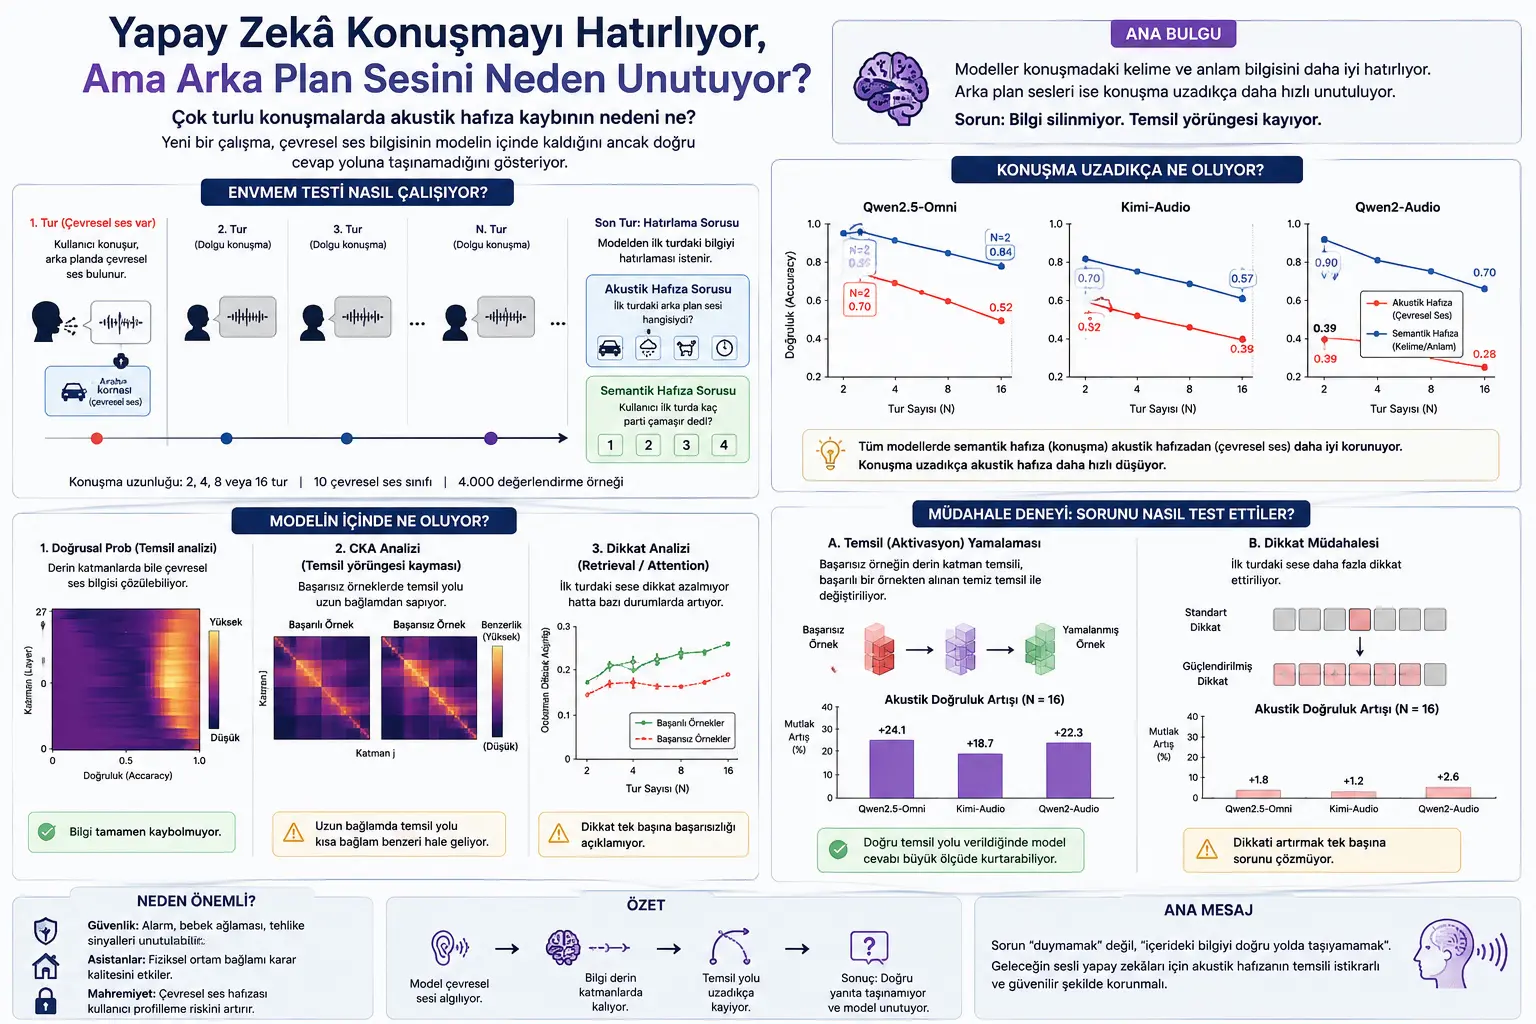
Tədqiqatçılar bunu ölçmək üçün EnvMem adlı nəzarətli test sistemi qururlar. İlk danışıq turuna bir ətraf mühit səsi yerləşdirilir. Sonra söhbət bir neçə tur davam edir. Sonda modelə ya danışıqda keçən mətn məlumatı, ya da arxa fondakı ətraf mühit səsi barədə sual verilir.
Nəticələrə görə problem sadəcə “model səsi tamamilə itirir” deyil. Ətraf mühit səsi barədə məlumat modelin dərin qatlarında hələ də deşifrə oluna bilir. Lakin bu məlumat cavab yaratma yoluna düzgün şəkildə daşına bilmir. Məqalə bunu representational trajectory drift, yəni təmsil trayektoriyasının sürüşməsi adlandırır.
Səsli assistentlərlə danışarkən yalnız sözlər olmur. Arxa fonda qapı zəngi, siqnal, trafik, yağış, körpə ağlaması və ya maşın səsi ola bilər. Bu səslər bəzən kontekst üçün vacibdir.
Məsələn, təhlükəsizlik sistemində siqnal səsi, texniki xidmət assistentində maşın səsi, ev assistentində körpə ağlaması və ya su səsi kritik ola bilər. Əgər süni intellekt bu səsləri ilk anda qavrayıb sonra söhbət irəlilədikcə unudursa, qərarvermə prosesi zəifləyə bilər.
Mövcud böyük səs-dil modelləri adətən danışıqda məna məlumatını daha yaxşı qoruyur. İstifadəçi “paltarları üç partiyada yuyacağam” deyibsə, model bunu bir neçə tur sonra xatırlaya bilir. Amma eyni ilk danışıqda arxa fonda avtomobil siqnalı varsa, bir neçə tur sonra bunu xatırlamaqda daha çox çətinlik çəkir.
Bu vəziyyət iki sualı gündəmə gətirir:
1. Modellər danışıqda söz məlumatını, yoxsa ətraf mühit səsi məlumatını daha yaxşı xatırlayırlar?
2. Ətraf mühit səsi unudulursa, bu məlumat həqiqətən modelin daxilindən silindiyi üçün baş verir, yoxsa məlumat daxildə qaldığı halda cavab istehsalında istifadə edilə bilmədiyi üçün?
Məqalənin əsas dəyəri də buradadır. Tədqiqatçılar yalnız model ballarına baxmır; modelin daxili qatlarını təhlil edərək xətanın harada yarandığını anlamağa çalışırlar.
Metod Nə Təklif Edir?
Tədqiqatçılar bu problemi araşdırmaq üçün EnvMem adlı test çərçivəsi yaradırlar.
EnvMem-in məntiqi sadədir:
- İlk istifadəçi danışığına bir ətraf mühit səsi əlavə edilir.
- Bu ətraf mühit səsi yalnız ilk turda olur.
- Sonrakı söhbətlər doldurucu danışıq kimi davam edir.
- Sonda modelə çoxseçimli sual verilir.
- Sual ya ilk danışıqda olan mətn məlumatını, ya da arxa fondakı ətraf mühit səsini xatırlamağa yönəlir.
Məsələn, ilk danışıqda istifadəçi paltar yumaqdan danışır və arxa fonda avtomobil siqnalı var. Daha sonra söhbət davam edir. Sonda modelə iki fərqli növdə sual verilə bilər:
Akustik yaddaş sualı:
İlk səsli mesajın arxa fonunda hansı ətraf mühit səsi var idi?
Semantik yaddaş sualı:
İstifadəçi ilk danışıqda paltar üçün neçə partiya demişdi?
Bu dizayn vacibdir, çünki mətn məlumatı və ətraf mühit səsi eyni başlanğıc kontekstindən gəlir. Beləliklə, modelin danışıq məlumatını, yoxsa ətraf mühit səsini daha yaxşı xatırladığı daha ədalətli şəkildə ölçülə bilir.
EnvMem verilənlər dəstində 10 ətraf mühit səsi sinfi istifadə olunur:
- Yağış
- Göy gurultusu
- Dəniz dalğaları
- Mühərrik səsi
- Tozsoran
- Avtomobil siqnalı
- İt səsi
- Körpə ağlaması
- Saatın tık-tık səsi
- Çatırtılı od səsi
Danışıq uzunluğu 2, 4, 8 və 16 tur olaraq dəyişdirilir. Beləliklə, söhbət uzandıqca ətraf mühit səsi yaddaşının necə pozulduğu ölçülür.
Formullar Nəyi İzah Edir?
Məqalədəki formullar test quruluşunu və yaddaş itkisinin necə ölçüldüyünü izah edir. Oxucu üçün sadələşdirsək, iki əsas fikir var.
Birinci fikir: Çoxturlu söhbət quruluşu
Məqalə söhbəti ardıcıl turlar kimi müəyyənləşdirir. İlk turda istifadəçi danışır və bu danışığa ətraf mühit səsi əlavə olunur. Sonrakı turlar söhbəti uzadır. Ən son turda isə modeldən ilk turdakı məlumatı xatırlaması istənilir.
Burada vacib məqam budur: Ətraf mühit səsi yalnız ilk turda var. Sonrakı turlarda təkrar olunmur. Beləliklə, modelin həqiqətən əvvəlki səsi xatırlayıb-xatırlamadığı yoxlanılır.
İkinci fikir: Akustik yaddaş itkisi ilə semantik yaddaş itkisini müqayisə etmək
Məqalə söhbət uzandıqca modelin iki növ məlumatdakı dəqiqlik azalmasını müqayisə edir:
- Akustik məlumat: Arxa fon səsi nə idi?
- Semantik məlumat: Danışıqda keçən mətn faktı nə idi?
Əgər akustik dəqiqlik daha sürətlə azalırsa, model ətraf mühit səsini danışığın mənasına nisbətən daha tez unudur deməkdir.
Buna görə məqalədəki fərq ölçümü bu sualı ifadə edir:
Söhbət uzandıqda ətraf mühit səsi yaddaşı söz/məna yaddaşına nisbətən daha sürətlə pozulurmu?
Nəticələrə görə cavab bəlidir. Modellər ətraf mühit səsi məlumatını danışıqda olan semantik məlumata nisbətən daha kövrək şəkildə saxlayırlar.
Qrafik / Cədvəl / Sxemin Əsas Mesajı
EnvMem sxemi:
Məqalədəki ilk böyük sxem testin necə qurulduğunu göstərir. İlk danışıq turuna ətraf mühit səsi yerləşdirilir, sonrakı turlar söhbəti uzadır, sonda modeldən ya ətraf mühit səsini, ya da mətn məlumatını xatırlaması istənilir. Sxemin əsas mesajı budur: Tədqiqatçılar təsadüfi real söhbətlər əvəzinə nəzarətli yaddaş testi qururlar. Beləliklə, səs və məna yaddaşı ayrı-ayrılıqda ölçülə bilir.
Akustik və semantik yaddaş qrafiki:
Məqalədəki performans qrafiki Qwen2.5-Omni, Kimi-Audio və Qwen2-Audio modellərinin 2, 4, 8 və 16 turlu söhbətlərdə uğurunu göstərir. Qrafiklərin əsas mesajı aydındır: Söhbət uzandıqca həm mətn, həm də akustik yaddaş zəifləyir; lakin ətraf mühit səsi yaddaşı daha sürətlə pozulur.
Qat-qat xətti prob qrafiki:
Məqalədəki xətti prob qrafiki ətraf mühit səsi məlumatının modelin hansı qatlarında deşifrə oluna bildiyini göstərir. Maraqlı nəticə budur: Model yanlış cavab versə belə, dərin qatlarda ətraf mühit səsi məlumatı hələ də mövcud ola bilir. Yəni məlumat tamamilə silinməyib.
CKA istilik xəritələri:
CKA qrafikləri uğurlu və uğursuz sınaqlarda modelin daxili təmsil yolunun necə dəyişdiyini göstərir. Əsas mesaj budur: Uğursuz hallarda təmsil uzun konteksti düzgün daşıyan yoldan yayınır və qısa kontekstə bənzər emal qaydasına keçir. Bu da “təmsil trayektoriyasının sürüşməsi” fikrini dəstəkləyir.
Diqqət təhlili qrafiki:
Məqalə modelin ilk ətraf mühit səsi olan danışığa kifayət qədər diqqət edib-etmədiyini də araşdırır. Nəticə təəccüblüdür: Diqqət paylanması təkbaşına uğursuzluğu izah etmir. Hətta bəzi uzun kontekstlərdə model ilk tura daha çox diqqət edir kimi görünsə belə, düzgün cavab verə bilməyə bilər.
Aktivasiya yamalama qrafiki:
Məqalədəki müdaxilə təcrübəsində uğursuz modelin dərin qat təmsili düzgün nümunədən götürülən təmiz təmsillə əvəz edilir. Bu əməliyyat düzgün cavab nisbətini ciddi şəkildə artırır. Əsas mesaj budur: Problem diqqəti artırmaqla həll olunmur; düzgün hizalanmış daxili təmsil lazım olduqda modelin cavabı xilas edilə bilir.
Təcrübələr Necə Aparılıb?
Tədqiqatçılar üç böyük səs-dil modelini sınaqdan keçirirlər:
- Qwen2.5-Omni
- Qwen2-Audio
- Kimi-Audio
Bu modellər səs və danışıq girişlərini birbaşa emal edə bilən açıq çəkili müasir arxitekturalar kimi seçilib.
Hər test nümunəsində model çoxturlu səsli söhbət alır. İlk danışıqda ətraf mühit səsi var. Sonrakı turlar yalnız söhbəti uzadır. Sonda modeldən dörd variantlı suala cavab verməsi istənilir.
Test iki formada aparılır:
1. Akustik xatırlama testi
Modeldən ilk danışıqda olan ətraf mühit səsini seçməsi istənilir.
2. Semantik xatırlama testi
Modeldən ilk danışıqda keçən mətn məlumatını seçməsi istənilir.
Ümumilikdə 4.000 qiymətləndirmə nümunəsi yaradılır. Bunun 2.000-i akustik suallar, 2.000-i isə semantik suallar üçün istifadə olunur.
Tədqiqatçılar modelin daxilini araşdırmaq üçün əlavə olaraq iki təhlil üsulundan istifadə edirlər:
Linear probing:
Modelin müxtəlif qatlarında ətraf mühit səsi məlumatının hələ də deşifrə olunub-olunmadığı yoxlanılır.
CKA analizi:
Uğurlu və uğursuz nümunələrdə modelin daxili təmsil strukturunun bir-birinə nə qədər bənzədiyi ölçülür.
Sonda iki növ müdaxilə sınaqdan keçirilir:
- Dərin qatdakı təmsilin dəyişdirilməsi
- Diqqət mexanizminin ilk səsə daha çox yönələcək şəkildə dəyişdirilməsi
Beləliklə, problemin təmsil səviyyəsində, yoxsa diqqət səviyyəsində olduğu yoxlanılır.
Nəticələr Nəyi Göstərir?
Nəticələr bir neçə vacib məqama işarə edir.
Birincisi, modellər danışıqda məna məlumatını ətraf mühit səsi məlumatından daha yaxşı xatırlayırlar. Məsələn, Qwen2.5-Omni modelində 2 turlu söhbətdə semantik dəqiqlik təxminən 0.92 olduğu halda, akustik dəqiqlik təxminən 0.70 səviyyəsində qalır. Söhbət 16 tura çatdıqda semantik dəqiqlik təxminən 0.84-ə enərkən, akustik dəqiqlik təxminən 0.56-ya qədər geriləyir.
İkincisi, bu fərq yalnız ilkin qavramanın zəifliyindən qaynaqlanmır. Söhbət uzandıqca ətraf mühit səsləri mətn məlumatına nisbətən daha sürətlə pozulur.
Üçüncüsü, ətraf mühit səsi məlumatı tamamilə yox olmur. Xətti prob təhlilləri model yanlış cavab verdikdə belə, dərin qatlarda ətraf mühit səsi sinfinin hələ də deşifrə oluna bildiyini göstərir. Bu çox vacib tapıntıdır. Çünki problem “məlumat silindi” deyil; daha çox “məlumat düzgün cavab istehsalı yoluna uyğun formatda daşına bilmədi” kimi görünür.
Dördüncüsü, diqqət mexanizmi təkbaşına izah üçün kifayət deyil. Modeli ilk ətraf mühit səsi olan hissəyə daha çox diqqət etməyə məcbur etmək uğursuz cavabları nəzərəçarpacaq dərəcədə düzəltmir.
Beşincisi, dərin qat təmsilini düzgün və təmiz nümunədən alınan təmsillə əvəz etmək uğursuz cavabların mühüm hissəsini xilas edə bilir. Bu nəticə əsas darboğazın təmsil səviyyəsində olduğunu dəstəkləyir.
Məqalənin ən güclü nəticəsi belə ümumiləşdirilə bilər:
Səsli süni intellekt modeli ətraf mühit səsini tamamilə unutmur; lakin bu məlumatı uzun söhbət boyunca düzgün təmsil yolunda saxlamaqda çətinlik çəkir.
Bu Niyə Vacibdir?
Bu tədqiqat gələcəyin səsli assistentləri üçün vacib problemi göstərir.
Bu gün səsli süni intellekt sistemləri əsasən “istifadəçi nə dedi?” sualına fokuslanır. Lakin real həyatda “arxa fonda nə baş verir?” sualı da vacib ola bilər.
Məsələn:
- Ev assistenti körpə ağlamasını xatırlamalıdırmı?
- Təhlükəsizlik sistemi siqnal səsini söhbət boyunca qoruya bilməlidirmi?
- Texniki xidmət assistenti maşın səsindəki xəbərdarlıq əlamətini sonrakı söhbətlərdə kontekst kimi istifadə edə bilməlidirmi?
- Sağlamlıq və ya təcili yardım sistemində ətraf mühit səsləri qərarvermə prosesinə töhfə verə bilərmi?
Belə tətbiqlərdə modelin yalnız danışığı deyil, ətraf mühitin akustik kontekstini də etibarlı şəkildə xatırlaması lazımdır.
Lakin bu, eyni zamanda məxfilik riskini də artırır. Çünki ətraf mühit səslərindən şəxsin evdə, işdə və ya trafikdə olduğu; yanında körpə olub-olmadığı; gündəlik rejimi və ya həssas mühit məlumatları çıxarıla bilər. Buna görə akustik yaddaş texnologiyaları hazırlanarkən açıq razılıq, məlumat saxlama limiti və təhlükəsizlik tədbirləri tələb olunur.
Diqqət Edilməli Məqamlar
Bu tədqiqat güclü təhlil təqdim etsə də, bəzi məhdudiyyətlərə malikdir.
Birincisi, EnvMem nəzarətli və sintetik test mühitindən istifadə edir. Danışıqlar tək bir TTS səsi ilə yaradılıb. Real həyatda müxtəlif danışanlar, aksentlər, mikrofon keyfiyyəti, spontan danışıq və üst-üstə düşən ətraf mühit səsləri bu testdə tam şəkildə təmsil olunmur.
İkincisi, hər söhbətdə yalnız bir ətraf mühit səsi ilk tura yerləşdirilir. Real həyatda ətraf mühit səsləri davamlı dəyişə bilər, eyni anda bir neçə səs ola bilər və ya arxa fon səs-küyü söhbət boyunca davam edə bilər.
Üçüncüsü, tədqiqatdakı müdaxilələr praktik məhsul həlli kimi deyil, diaqnostik məqsədlə aparılır. Yəni dərin qat təmsilini dəyişdirmə üsulu indiki halında birbaşa gündəlik sistemlərə tətbiq ediləcək həll deyil.
Dördüncüsü, tədqiqat müəyyən modellərlə məhdudlaşır. Qwen2.5-Omni, Qwen2-Audio və Kimi-Audio üzərində əldə edilən nəticələr vacib olsa da, bütün səsli süni intellekt modellərinə qəti şəkildə ümumiləşdirmək düzgün olmaz.
Beşincisi, ətraf mühit səsi yaddaşının güclənməsi məxfilik baxımından ikitərəfli məsələdir. Daha yaxşı xatırlayan sistemlər daha faydalı ola bilər; lakin istifadəçinin mühitini daha uzun müddət izləmə və profilləşdirmə riski də yarada bilər.
Nəticə
Bu məqalə böyük səs-dil modellərinin danışıqda məna məlumatını ətraf mühit səsi məlumatından daha möhkəm saxladığını göstərir. Modellər çoxturlu söhbətlərdə “istifadəçi nə dedi?” sualına “arxa fonda nə var idi?” sualına nisbətən daha yaxşı cavab verirlər.
Tədqiqatçıların ən vacib tapıntısı ətraf mühit səsi məlumatının tamamilə itməməsidir. Məlumat modelin dərin qatlarında hələ də deşifrə oluna bilir. Lakin uzun kontekstlərdə bu məlumat düzgün cavab yaratma prosesi ilə uyğun şəkildə daşına bilmir. Buna təmsil trayektoriyasının sürüşməsi deyilir.
Verianla baxımından məqalənin əsas mesajı budur:
Səsli süni intellektlərin həqiqətən ətrafını anlaya bilməsi üçün yalnız danışığı mətnə çevirməsi kifayət deyil. Arxa fon səslərini uzun söhbət boyunca düzgün təmsil edib lazım olduqda etibarlı şəkildə xatırlaya bilməlidir. Lakin bu qabiliyyət məxfilik və təhlükəsizlik məsuliyyəti ilə birlikdə inkişaf etdirilməlidir.
Mənbə və Metod Qeydi
Bu məzmun Yang Xiao, Siyi Wang, Han Yin, Hong Jia, Vidhyasaharan Sethu, Eun-Jung Holden və Ting Dang tərəfindən hazırlanmış “Why Can’t They Remember? Uncovering Representation and Retrieval Bottlenecks in Multi-Turn Acoustic Memory” adlı akademik tədqiqatdan istifadə edilərək Verianla redaksiya formatında orijinal şəkildə hazırlanıb.
Bu yazı sözbəsöz tərcümə deyil; məqalədəki metod, EnvMem test quruluşu, qrafiklər, formullar, təcrübələr, modeldaxili təhlillər və nəticələr sadələşdirilərək Azərbaycan dilli oxucu üçün yenidən izah olunub. Məzmun məlumatlandırma və təhsil məqsədi daşıyır. Səsli assistentlər, ətraf mühit səsinin izlənməsi, təhlükəsizlik sistemləri və ya istifadəçi profilləşdirməsi kimi sahələrdə etik, hüquqi və məxfilik tələbləri nəzərə alınmalıdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib