

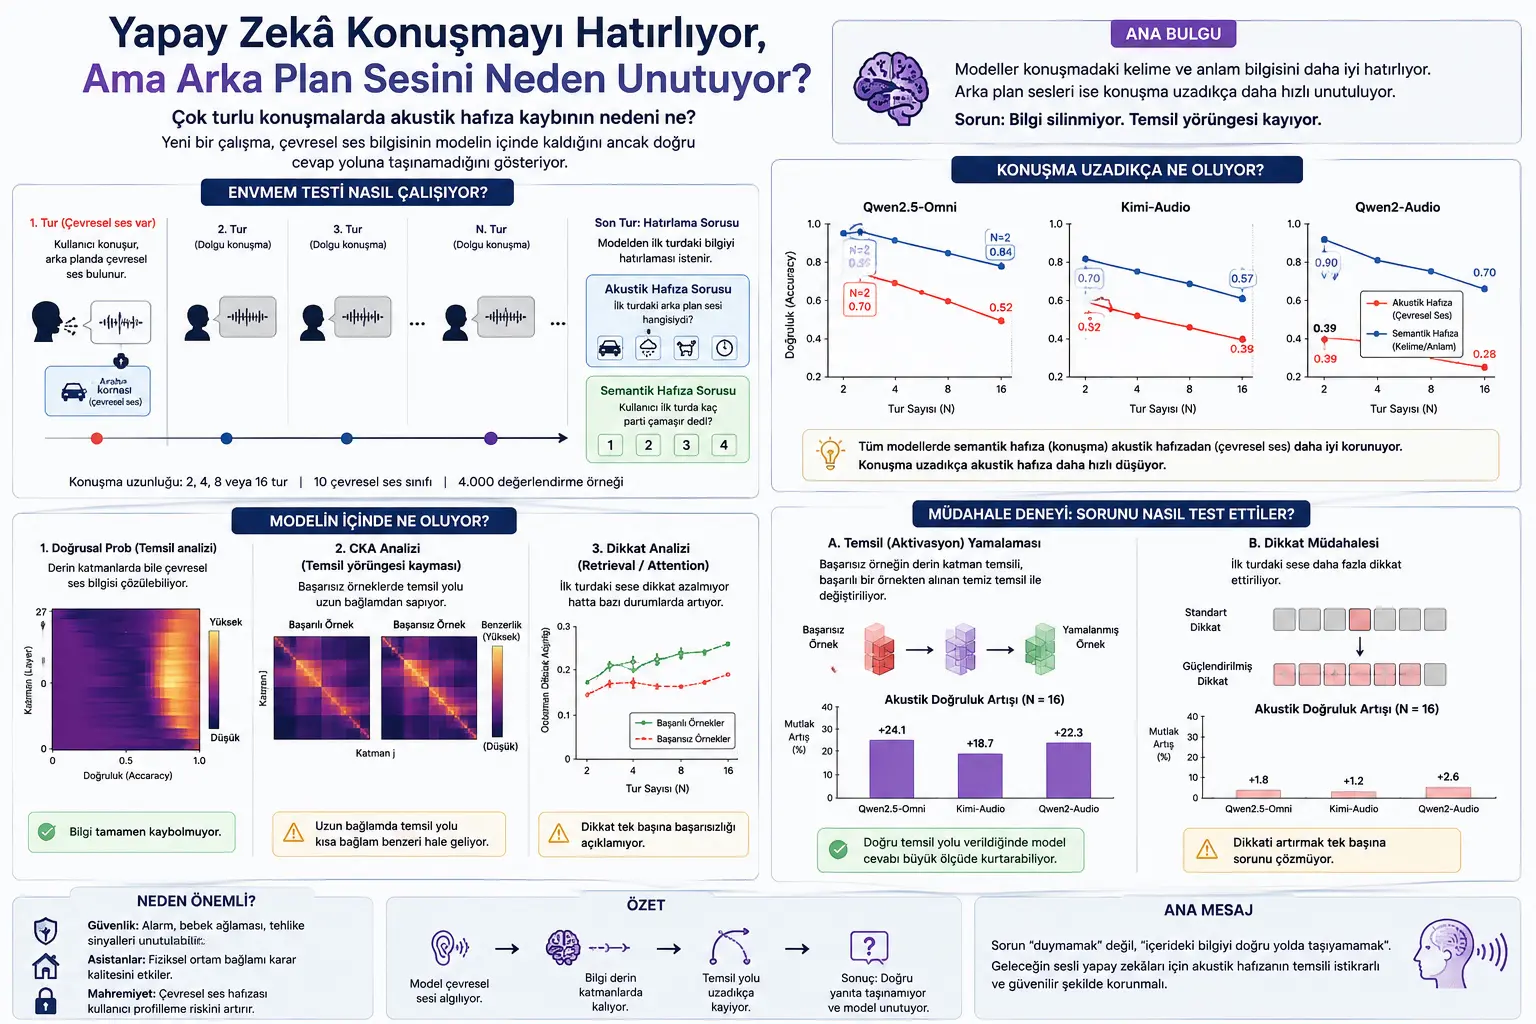
Үндүү жасалма интеллект моделдери азыр болгону сүйлөөнү жазууга айландырбайт. Колдонуучунун үнүн, сүйлөө контекстин жана кээде фондогу айлана-чөйрө үндөрүн да түшүнүүгө аракет кылат. Мисалы, сүйлөшүү учурунда жамгыр үнү, машина сигналы, чаң соргуч, ит үргөнү же бала ыйлаганы угулушу мүмкүн.
Yang Xiao жана кесиптештери даярдаган бул макала чоң үн–тил моделдеринин көп турдуу сүйлөшүүлөрдө бул айлана-чөйрө үндөрүн канчалык эстеп каларын изилдейт. Иштин негизги жыйынтыгы кыйла көңүл бурарлык: Моделдер сүйлөшүүдөгү сөз жана маани маалыматын айлана-чөйрө үндөрүнө караганда жакшыраак эстеп калат. Фон үндөрү болсо сүйлөшүү узарган сайын тезирээк унутулат.
Изилдөөчүлөр бул абалды өлчөө үчүн EnvMem деп аталган көзөмөлдүү сыноо тутумун курат. Биринчи сүйлөшүү туруна бир айлана-чөйрө үнү жайгаштырылат. Андан кийин сүйлөшүү бир нече тур уланат. Акырында моделге же сүйлөшүүдөгү тексттик маалымат, же фондогу айлана-чөйрө үнү суралат.
Жыйынтыктарга караганда көйгөй жөн гана «модель үндү толугу менен жоготот» эмес. Айлана-чөйрө үнү жөнүндөгү маалымат моделдин терең катмарларында дагы эле ажыратылып алынышы мүмкүн. Бирок бул маалымат жооп чыгаруу жолуна туура формада өткөрүлбөйт. Макала муну representational trajectory drift, б.а. өкүлчүлүк траекториясынын жылышы деп атайт.
Үндүү жардамчылар менен сүйлөшкөндө болгону сөздөр болбойт. Фондо эшик коңгуроосу, сигнал, жол кыймылы, жамгыр, бала ыйлаганы же машина үнү болушу мүмкүн. Бул үндөр кээде контекст үчүн маанилүү.
Мисалы, коопсуздук тутумунда сигнал үнү, тейлөө жардамчысында машина үнү, үй жардамчысында бала ыйлаганы же суу үнү маанилүү болушу мүмкүн. Эгер жасалма интеллект бул үндөрдү алгач байкап, кийин сүйлөшүү уланган сайын унутса, чечим кабыл алуу процесси начарлашы мүмкүн.
Учурдагы чоң үн–тил моделдери адатта сүйлөшүүдөгү маанини жакшыраак сактайт. Колдонуучу «кир жууну үч партия кылам» десе, модель муну бир нече турдан кийин эстеп кала алат. Бирок ошол эле биринчи сүйлөшүүдө фондо машина сигналы болсо, бир нече турдан кийин муну эстеп калууда көбүрөөк кыйналат.
Бул абал эки суроону күндөлүккө чыгарат:
1. Моделдер сүйлөшүүдөгү сөз маалыматынбы, же айлана-чөйрө үнү маалыматынбы жакшыраак эстеп калат?
2. Айлана-чөйрө үнү унутулуп жатса, бул маалымат чынында моделдин ичинен өчүрүлгөнү үчүнбү, же маалымат ичинде турганы менен жооп чыгарууда колдонулбаганы үчүнбү?
Макаланын чыныгы баалуулугу ушул жерде. Изилдөөчүлөр болгону моделдин упайларына карабайт; моделдин ички катмарларын талдап, ката кайда пайда болгонун түшүнүүгө аракет кылат.
Ыкма эмне сунуштайт?
Изилдөөчүлөр бул көйгөйдү изилдөө үчүн EnvMem деп аталган сыноо алкагын түзөт.
EnvMem’дин логикасы жөнөкөй:
- Биринчи колдонуучу сүйлөөсүнө бир айлана-чөйрө үнү кошулат.
- Бул айлана-чөйрө үнү болгону биринчи турда болот.
- Кийинки сүйлөшүүлөр толтуруучу сүйлөшүү катары уланат.
- Акырында моделге көп варианттуу суроо берилет.
- Суроо же биринчи сүйлөшүүдөгү тексттик маалыматты, же фондогу айлана-чөйрө үнүн эстеп калууга багытталган болот.
Мисалы, биринчи сүйлөшүүдө колдонуучу кир жуу жөнүндө айтат жана фондо машина сигналы бар. Андан кийин сүйлөшүү уланат. Акырында моделге эки башка түрдөгү суроо берилиши мүмкүн:
Акустикалык эс суроосу:
Биринчи үндүү билдирүүнүн фонунда кайсы айлана-чөйрө үнү болгон?
Семантикалык эс суроосу:
Колдонуучу биринчи сүйлөшүүдө кир жуу үчүн канча партия деген?
Бул дизайн маанилүү, анткени тексттик маалымат жана айлана-чөйрө үнү бир эле баштапкы контексттен келет. Ошентип моделдин сүйлөшүү маалыматынбы же айлана-чөйрө үнүнбү жакшыраак эстеп калганы адилеттүүрөөк өлчөнө алат.
EnvMem маалымат топтомунда 10 айлана-чөйрө үнү классы колдонулат:
- Жамгыр
- Күн күркүрөө
- Деңиз толкундары
- Мотор үнү
- Чаң соргуч
- Машина сигналы
- Ит үнү
- Бала ыйлаганы
- Саат тык-тыгы
- Шартылдаган от
Сүйлөшүү узундуктары 2, 4, 8 жана 16 тур катары өзгөртүлөт. Ошентип сүйлөшүү узарган сайын айлана-чөйрө үнү эсинин кантип бузулары өлчөнөт.
Формулалар эмнени түшүндүрөт?
Макаладагы формулалар сыноо түзүмүн жана эс жоготуусун өлчөө ыкмасын түшүндүрөт. Окурман үчүн жөнөкөйлөтсөк, эки негизги идея бар.
Биринчи идея: Көп турдуу сүйлөшүү түзүмү
Макала сүйлөшүүнү ырааттуу турлар катары аныктайт. Биринчи турда колдонуучу сүйлөйт жана бул сүйлөөгө айлана-чөйрө үнү кошулат. Кийинки турлар сүйлөшүүнү узартат. Акыркы турда болсо моделден биринчи турдагы маалыматты эстеп калуусу суралат.
Бул жердеги маанилүү жагдай мындай: Айлана-чөйрө үнү болгону биринчи турда бар. Кийинки турларда кайталанбайт. Ошентип моделдин чынында мурунку үндү эстеп калып-калбаганы сыналат.
Экинчи идея: Акустикалык эс жоготуусун семантикалык эс жоготуусу менен салыштыруу
Макала сүйлөшүү узарган сайын моделдин эки түрдөгү маалыматтагы тактык төмөндөшүн салыштырат:
- Акустикалык маалымат: Фон үнү эмне болгон?
- Семантикалык маалымат: Сүйлөшүүдө айтылган тексттик факты эмне болгон?
Эгер акустикалык тактык тезирээк түшсө, модель айлана-чөйрө үнүн сүйлөшүү маанисине караганда тезирээк унутуп жатат дегенди билдирет.
Ошондуктан макаладагы айырма өлчөөсү төмөнкүнү айтат:
Сүйлөшүү узарганда айлана-чөйрө үнү эси сөз/маани эсине караганда тезирээк бузулабы?
Жыйынтыктарга караганда жооп ооба. Моделдер айлана-чөйрө үнү маалыматын сүйлөшүүдөгү семантикалык маалыматка караганда мортураак кармап турат.
График / Таблица / Схема негизги билдирүүсү
EnvMem схемасы:
Макаладагы биринчи чоң схема сыноонун кантип курулганын көрсөтөт. Биринчи сүйлөшүү туруна айлана-чөйрө үнү жайгаштырылат, кийинки турлар сүйлөшүүнү узартат, акырында моделден же айлана-чөйрө үнүн, же тексттик маалыматты эстеп калуусу суралат. Схеманын негизги билдирүүсү мындай: Изилдөөчүлөр кокустук чыныгы сүйлөшүүлөрдүн ордуна көзөмөлдүү эс сыноосун курат. Ошентип үн жана маани эси өз-өзүнчө өлчөнө алат.
Акустикалык жана семантикалык эс графиги:
Макаладагы натыйжалуулук графиги Qwen2.5-Omni, Kimi-Audio жана Qwen2-Audio моделдеринин 2, 4, 8 жана 16 турдуу сүйлөшүүлөрдөгү ийгилигин көрсөтөт. Графиктердин негизги билдирүүсү ачык: Сүйлөшүү узарган сайын тексттик да, акустикалык да эс төмөндөйт; бирок айлана-чөйрө үнү эси тезирээк бузулат.
Катмар-катмар linear probing графиги:
Макаладагы linear probing графиги айлана-чөйрө үнү маалыматынын моделдин кайсы катмарларында ажыратылып алынарын көрсөтөт. Кызыктуу жыйынтык мындай: Модель туура эмес жооп берсе да, терең катмарларда айлана-чөйрө үнү маалыматы дагы эле табылышы мүмкүн. Башкача айтканда, маалымат толугу менен өчүрүлгөн эмес.
CKA жылуулук карталары:
CKA графиктери ийгиликтүү жана ийгиликсиз аракеттерде моделдин ички өкүлчүлүк жолунун кантип өзгөрөрүн көрсөтөт. Негизги билдирүү мындай: Ийгиликсиз учурларда өкүлчүлүк узун контекстти туура өткөргөн жолдон четтейт жана кыска контекстке окшош иштетүү тартибине жылат. Бул да «өкүлчүлүк траекториясынын жылышы» идеясын колдойт.
Көңүл бөлүштүрүү анализинин графиги:
Макала моделдин биринчи айлана-чөйрө үнү бар сүйлөшүүгө жетиштүү көңүл буруп жатканын да изилдейт. Жыйынтык таң калыштуу: Көңүл бөлүштүрүү өзү эле ийгиликсиздикти түшүндүрбөйт. Атүгүл кээ бир узун контексттерде модель биринчи турга көбүрөөк көңүл буруп жаткандай көрүнсө да, туура жооп бере албай калышы мүмкүн.
Активдештирүүнү жамоо графиги:
Макаладагы кийлигишүү тажрыйбасында ийгиликсиз моделдин терең катмар өкүлчүлүгү туура үлгүдөн алынган таза өкүлчүлүк менен алмаштырылат. Бул амал туура жооп үлүшүн олуттуу жогорулатат. Негизги билдирүү мындай: Көйгөй көңүлдү күчөтүү менен чечилбейт; туура тегизделген ички өкүлчүлүк керек болгондо модель жоопту куткара алат.
Тажрыйбалар кантип жүргүзүлгөн?
Изилдөөчүлөр үч чоң үн–тил моделин сынайт:
- Qwen2.5-Omni
- Qwen2-Audio
- Kimi-Audio
Бул моделдер үн жана сүйлөө киргизүүлөрүн түздөн-түз иштете алган ачык салмактуу заманбап архитектуралар катары тандалат.
Ар бир сыноо үлгүсүндө модель көп турдуу үндүү сүйлөшүү алат. Биринчи сүйлөшүүдө айлана-чөйрө үнү бар. Кийинки турлар болгону сүйлөшүүнү узартат. Акырында моделден төрт варианттуу суроого жооп берүүсү суралат.
Сыноо эки формада жүргүзүлөт:
1. Акустикалык эстеп калуу сыноосу
Моделден биринчи сүйлөшүүдөгү айлана-чөйрө үнүн тандоосу суралат.
2. Семантикалык эстеп калуу сыноосу
Моделден биринчи сүйлөшүүдө айтылган тексттик маалыматты тандоосу суралат.
Жалпысынан 4.000 баалоо үлгүсү түзүлөт. Анын 2.000и акустикалык суроолор, 2.000и семантикалык суроолор үчүн колдонулат.
Изилдөөчүлөр мындан тышкары моделдин ичин изилдөө үчүн эки талдоо ыкмасын колдонот:
Linear probing:
Моделдин ар кандай катмарларында айлана-чөйрө үнү маалыматы дагы эле ажыратылып алынабы деп каралат.
CKA анализи:
Ийгиликтүү жана ийгиликсиз үлгүлөрдө моделдин ички өкүлчүлүк түзүмү бири-бирине канчалык окшош экени өлчөнөт.
Акырында эки түрдөгү кийлигишүү сыналат:
- Терең катмардагы өкүлчүлүктү өзгөртүү
- Көңүл бөлүштүрүү механизмин биринчи үнгө көбүрөөк багытталгыдай өзгөртүү
Ошентип көйгөй өкүлчүлүк деңгээлиндеби, же көңүл бөлүштүрүү деңгээлиндеби деп сыналат.
Жыйынтыктар эмнени көрсөтөт?
Жыйынтыктар бир нече маанилүү жагдайга көрсөтөт.
Биринчиден, моделдер сүйлөшүүдөгү маани маалыматын айлана-чөйрө үнү маалыматынан жакшыраак эстеп калат. Мисалы, Qwen2.5-Omni моделинде 2 турдуу сүйлөшүүдө семантикалык тактык болжол менен 0.92 болсо, акустикалык тактык болжол менен 0.70 деңгээлинде калат. Сүйлөшүү 16 турга чыкканда семантикалык тактык болжол менен 0.84кө түшөт, акустикалык тактык болсо болжол менен 0.56га чейин төмөндөйт.
Экинчиден, бул айырма болгону баштапкы кабыл алуунун начарлыгынан келип чыкпайт. Сүйлөшүү узарган сайын айлана-чөйрө үндөрү тексттик маалыматка караганда тезирээк бузулат.
Үчүнчүдөн, айлана-чөйрө үнү маалыматы толугу менен жоголбойт. Linear probing анализдери модель туура эмес жооп бергенде да терең катмарларда айлана-чөйрө үнү классынын дагы эле ажыратылып алынарын көрсөтөт. Бул өтө маанилүү жыйынтык. Анткени көйгөй «маалымат өчүрүлдү» эмес; «маалымат туура жооп чыгаруу жолуна ылайык форматта өткөрүлгөн жок» сыяктуу көрүнөт.
Төртүнчүдөн, көңүл бөлүштүрүү механизми өзү эле түшүндүрмө бербейт. Моделге биринчи айлана-чөйрө үнү бар бөлүмгө көбүрөөк көңүл буруу ийгиликсиз жоопторду байкаларлык түрдө оңдой албайт.
Бешинчиден, терең катмар өкүлчүлүгүн туура жана таза үлгүдөн алынган өкүлчүлүк менен алмаштыруу ийгиликсиз жооптордун маанилүү бөлүгүн куткара алат. Бул жыйынтык негизги бөтөлкө моюнчасы өкүлчүлүк деңгээлинде экенин колдойт.
Макаланын эң күчтүү жыйынтыгы төмөнкүчө жыйынтыкталышы мүмкүн:
Үндүү жасалма интеллект модели айлана-чөйрө үнүн толугу менен унутпайт; бирок бул маалыматты узун сүйлөшүү бою туура өкүлчүлүк жолунда кармап турууда кыйналат.
Бул эмне үчүн маанилүү?
Бул иш келечектеги үндүү жардамчылар үчүн маанилүү көйгөйдү көрсөтөт.
Бүгүн үндүү жасалма интеллект тутумдары негизинен «колдонуучу эмне деди?» суроосуна көңүл бурат. Бирок чыныгы турмушта «фондо эмне болуп жатат?» суроосу да маанилүү болушу мүмкүн.
Мисалы:
- Үй жардамчысы бала ыйлаганын эстеп калышы керекпи?
- Коопсуздук тутуму сигнал үнүн сүйлөшүү бою сактай алышы керекпи?
- Тейлөө жардамчысы машина үнүндөгү эскертүү белгисин кийинки сүйлөшүүлөрдө контекст катары колдоно алышы керекпи?
- Саламаттык же өзгөчө кырдаал тутумунда айлана-чөйрө үндөрү чечим процессине салым кошо алабы?
Мындай колдонмолордо моделдин болгону сүйлөшүүнү эмес, айлана-чөйрө акустикалык контекстин да ишенимдүү эстеп калышы керек.
Бирок бул ошол эле учурда купуялуулук тобокелдигин да чоңойтот. Анткени айлана-чөйрө үндөрүнөн адам үйдөбү, жумуштабы, жолдобу экени; жанында бала бар-жок экени; күнүмдүк тартиби же сезимтал чөйрө маалыматтары чыгарылышы мүмкүн. Ошондуктан акустикалык эс технологиялары өнүктүрүлүп жатканда ачык макулдук, маалымат сактоо чеги жана коопсуздук чаралары керек.
Көңүл буруу керек болгон жактар
Бул иш күчтүү анализ сунуштаса да, айрым чектөөлөрдү камтыйт.
Биринчиден, EnvMem көзөмөлдүү жана синтетикалык сыноо чөйрөсүн колдонот. Сүйлөшүүлөр бир TTS үнү менен түзүлгөн. Чыныгы турмуштагы ар кандай сүйлөөчүлөр, акценттер, микрофон сапаты, стихиялуу сүйлөшүүлөр жана биринин үстүнө бири чыккан айлана-чөйрө үндөрү бул сыноодо толук чагылдырылбайт.
Экинчиден, ар бир сүйлөшүүдө болгону бир айлана-чөйрө үнү биринчи турга жайгаштырылат. Чыныгы турмушта айлана-чөйрө үндөрү тынымсыз өзгөрүшү, бир учурда бир нече үн болушу же фон ызы-чуусу сүйлөшүү бою уланышы мүмкүн.
Үчүнчүдөн, иштеги кийлигишүүлөр практикалык продукт чечими катары эмес, диагноз коюу максатында жасалат. Башкача айтканда, терең катмар өкүлчүлүгүн өзгөртүү ыкмасы бүгүнкү абалында түздөн-түз күнүмдүк тутумдарга колдонула турган чечим эмес.
Төртүнчүдөн, иш белгилүү моделдер менен чектелген. Qwen2.5-Omni, Qwen2-Audio жана Kimi-Audio үстүндө табылган жыйынтыктар маанилүү болсо да, бардык үндүү жасалма интеллект моделдери үчүн катуу жалпылоо туура болбойт.
Бешинчиден, айлана-чөйрө үнү эсинин күчөшү купуялуулук жагынан эки тараптуу. Жакшыраак эстеп калган тутумдар пайдалуураак болушу мүмкүн; бирок колдонуучу чөйрөсүн узагыраак байкоо жана профилдөө тобокелдигин да жаратышы мүмкүн.
Жыйынтык
Бул макала чоң үн–тил моделдеринин сүйлөшүүдөгү маани маалыматын айлана-чөйрө үнү маалыматынан бекемүрөөк кармап турарын көрсөтөт. Моделдер көп турдуу сүйлөшүүлөрдө «колдонуучу эмне деди?» суроосуна «фондо эмне болгон?» суроосуна караганда жакшыраак жооп берет.
Изилдөөчүлөрдүн эң маанилүү жыйынтыгы — айлана-чөйрө үнү маалыматы толугу менен жоголбогону. Маалымат моделдин терең катмарларында дагы эле ажыратылып алынышы мүмкүн. Бирок узун контексттерде бул маалымат туура жооп чыгаруу процесси менен шайкеш өткөрүлбөйт. Бул абал өкүлчүлүк траекториясынын жылышы деп аталат.
Verianla көз карашынан макаланын негизги билдирүүсү мындай:
Үндүү жасалма интеллекттердин чынында айлана-чөйрөсүн түшүнө алышы үчүн болгону сүйлөөнү жазууга айландыруу жетишсиз. Фон үндөрүн узун сүйлөшүү бою туура өкүлчүлүк кылып, керек болгондо ишенимдүү эстеп кала алышы керек. Бирок бул жөндөм купуялуулук жана коопсуздук жоопкерчилиги менен кошо өнүктүрүлүшү керек.
Булак жана ыкма эскертмеси
Бул контент Yang Xiao, Siyi Wang, Han Yin, Hong Jia, Vidhyasaharan Sethu, Eun-Jung Holden жана Ting Dang тарабынан даярдалган “Why Can’t They Remember? Uncovering Representation and Retrieval Bottlenecks in Multi-Turn Acoustic Memory” аттуу академиялык иштен пайдаланылып Verianla редакциялык форматында өзгөчө даярдалган.
Бул жазуу сөзмө-сөз котормо эмес; макаладагы ыкма, EnvMem сыноо түзүмү, графиктер, формулалар, тажрыйбалар, модел ичи анализдери жана жыйынтыктар жөнөкөйлөтүлүп кыргыз окурмандар үчүн кайра жазылган. Контент маалымат жана билим берүү максатын көздөйт. Үндүү жардамчылар, айлана-чөйрө үнүн көзөмөлдөө, коопсуздук тутумдары же колдонуучуну профилдөө сыяктуу тармактарда этикалык, укуктук жана купуялуулук талаптары эске алынышы керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген