

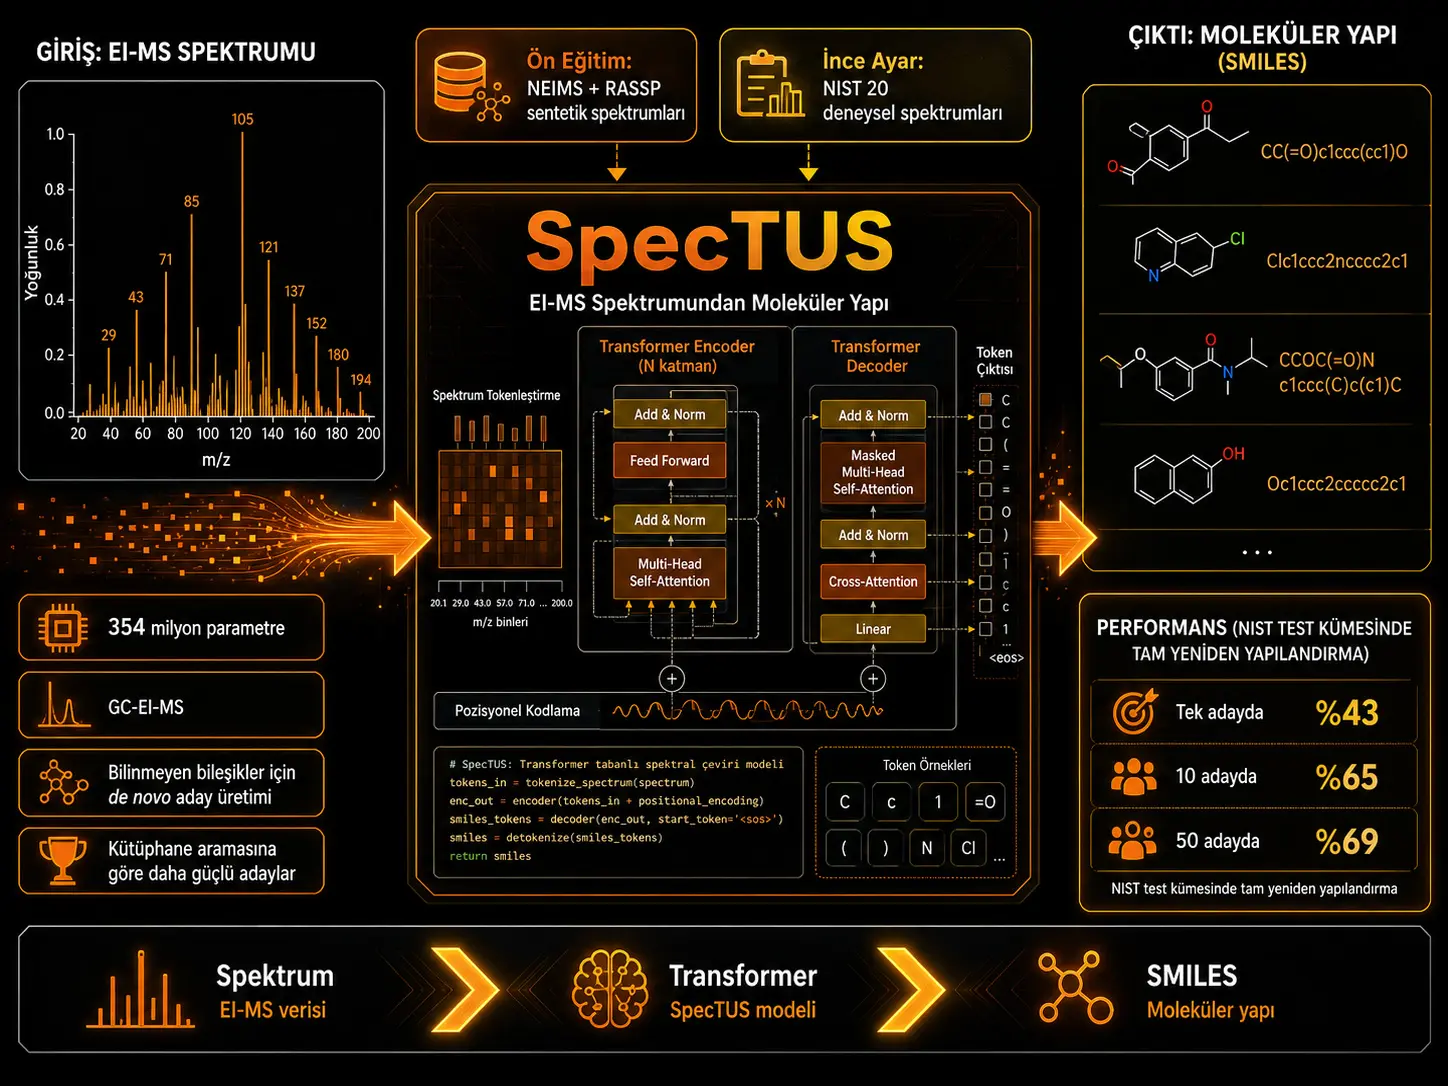
Bu tədqiqat qaz xromatoqrafiyası–elektron ionlaşmalı kütlə spektrometriyası (GC-EI-MS) ilə əldə olunan aşağı ayırdetməli kütlə spektrindən molekulyar quruluşu birbaşa yaratmağı hədəfləyən SpecTUS adlı dərin öyrənmə modelini təqdim edir. Ənənəvi EI-MS identifikasiya üsulları çox vaxt ölçülən spektri istinad spektr kitabxanasında axtarır. SpecTUS isə sorğulanan birləşmənin spektr kitabxanasında olmasını tələb etmədən spektrdəki kütlə/yük və intensivlik məlumatlarını emal edib molekulu SMILES ardıcıllığı kimi yaratmağa çalışır.
SpecTUS 354 milyon öyrədilə bilən parametrə malik encoder–decoder Transformer arxitekturasıdır. Model əvvəlcə NEIMS və RASSP tərəfindən yaradılmış geniş sintetik EI-MS məlumat dəstlərində əvvəlcədən öyrədilib, sonra NIST 20 eksperimental GC-EI-MS spektrləri ilə incə tənzimlənib. Modelin girişini spektrdəki m/z və nisbi intensivlik cütləri, çıxışını isə simvol-simvol yaradılan molekulyar SMILES təsviri təşkil edir.
NIST 20-dən ayrılmış 28.267 spektrlik test dəstində SpecTUS yalnız bir quruluş təklif etdikdə birləşmələrin %43-ünü tam olaraq yenidən qurub. On namizəd yaradıldıqda tam yenidən qurma nisbəti %65-ə, 50 namizəd ssenarisində %69-a yüksəlib. Tək namizəd ssenarisində SpecTUS təklifi Morgan barmaq izi Tanimoto oxşarlığı və dəqiq uyğunluq yoxlamasına əsaslanan müqayisədə NIST test nümunələrinin %76-sında hibrid verilənlər bazası axtarışının nəticəsindən daha yaxşı olub; on namizədli müqayisədə bu nisbət %84-dür.
Performans bütün məlumat mənbələrində eyni deyil. Daha ciddi kurasiya olunmuş NIST və SWGDRUG spektrlərində nəticələr yüksək olduğu halda Cayman və MONA kimi daha heterogen məlumat dəstlərində dəqiqlik azalıb. Bundan əlavə, təlim dəstindəki strukturlara getdikcə daha az bənzəyən molekullar seçildikdə performans kəskin şəkildə aşağı düşür. Buna görə tədqiqat SpecTUS-un təlim zamanı görmədiyi birləşmələrə müəyyən dərəcədə ümumiləşə bildiyini göstərsə də, tamamilə yeni kimyəvi quruluş fəzasının həll edildiyini göstərmir.
Türkiyə baxımından tədqiqat məhkəmə kimyası, ətraf mühit analizi, dərman/narkotik analizi və kiçik molekul xarakterizasiyasında GC-EI-MS istifadə edən tədqiqat laboratoriyaları üçün metodoloji cəhətdən diqqətəlayiqdir. Lakin model Türkiyədəki laboratoriya cihazları, nümunə hazırlama prosesləri və ya yerli analit dəstləri üzərində ayrıca doğrulanmayıb. Xüsusən spektr keyfiyyəti və ölçmə protokolu performansa təsir etdiyindən yerli tətbiq üçün müstəqil doğrulama və mütəxəssis kimyaçı qiymətləndirməsi tələb olunur.
Niyə spektral kitabxana axtarışından kənar üsula ehtiyac var?
GC-MS analizində birləşmələr əvvəlcə qaz xromatoqrafiyası ilə ayrılır. Sonra neytral molekullar ionlaşdırılır və kütlə spektrometri yaranan ionların kütlə/yük nisbətlərini (m/z) və nisbi bolluqlarını ölçür. Nəticə hər bir birləşməyə aid spektral piklər toplusudur.
Tədqiqatın diqqət mərkəzi elektron ionlaşmasıdır (EI). GC-EI-MS-də onilliklərdir geniş istifadə olunan təxminən 70 eV elektron enerjisi müxtəlif spektral kitabxanalar arasında nisbətən ardıcıl parçalanma nümunələri yarada bilər. Bununla belə, eyni birləşmənin spektrində cihaz və ölçmə şəraitindən asılı fərqlər yenə də mövcud ola bilər.
Ənənəvi yanaşmada sorğu spektri ölçülmüş istinad spektrləri ilə müqayisə olunur. Tədqiqat iki əsas üsuldan istifadə edir:
- Simple Similarity Search (SSS): oxşar m/z qiymətlərində spektral pikləri uyğunlaşdırır.
- Hybrid Similarity Search (HSS): fraqment ionları ilə yanaşı neytral itkilərdən də istifadə edir və sorğu ilə istinad molekulu arasındakı molekulyar çəki fərqini nəzərə alır.
HSS xüsusilə sorğulanan birləşmə kitabxanada yoxdursa SSS-dən daha faydalı ola bilər. Lakin üsulun mühüm məhdudiyyəti sorğu birləşməsinin düzgün molekulyar çəki məlumatından istifadə etməsidir; bu məlumat aşağı ayırdetməli EI-MS spektrlərindən həmişə etibarlı şəkildə əldə olunmaya bilər.
Daha əsas məhdudiyyət isə spektral kitabxananın əhatə dairəsidir. Birləşmə istinad kitabxanasında ümumiyyətlə yoxdursa standart axtarış düzgün molekulun özünü geri qaytara bilməz; yalnız mövcud namizədlər arasından ən yaxın quruluşu təklif edə bilər. SpecTUS spektrdən birbaşa yeni molekulyar quruluş yaratmağa çalışaraq bu məhdudiyyəti aşmağı hədəfləyir.
SpecTUS-un əsas ideyası nədir?
SpecTUS problemi bir növ “tərcümə” problemi kimi nəzərdən keçirir. Təbii dil modelinin bir dildəki ardıcıllığı başqa dildəki ardıcıllığa çevirməsi kimi, model EI-MS spektrini molekulyar quruluş təsvirinə çevirir:
EI-MS spektri → Transformer → SMILES molekul ardıcıllığı
Girişdə hər spektral pik iki məlumat daşıyır: tam ədədə yuvarlaqlaşdırılmış m/z qiyməti və nisbi intensivlik. Çıxışda isə model molekulyar quruluşu SMILES simvollarını avtoreqressiv şəkildə, yəni əvvəl yaratdığı simvollardan istifadə edərək ardıcıllıqla yaradır.
Model arxitekturası nə qədər böyükdür?
SpecTUS BART yanaşmasına əsaslanan, 354 milyon öyrədilə bilən parametrə malik encoder–decoder Transformer-dir. Mənbədə arxitekturanın əsas ölçüləri belə verilir:
| Arxitektura xüsusiyyəti | SpecTUS qiyməti |
|---|---|
| Encoder bloklarının sayı | 12 |
| Decoder bloklarının sayı | 12 |
| Attention head sayı | 16 |
| Embedding ölçüsü | 1024 |
| Feed-forward gizli qat ölçüsü | 4096 |
| Ümumi öyrədilə bilən parametr | 354 milyon |
Modelin giriş limitləri maksimum 300 spektral pik, maksimum m/z = 500 və maksimum 100 simvol uzunluğunda SMILES kimi müəyyən edilib. Bu filtrlər NIST məlumatlarının təxminən %3-nün xaric edilməsinə səbəb olub.
Spektr model üçün necə kodlaşdırılır?
Tədqiqatda m/z qiymətləri ən yaxın tam ədədə yuvarlaqlaşdırılır. Nisbi intensivliklər isə birbaşa çox yüksək dəqiqlikli ədədi giriş kimi istifadə olunmaq əvəzinə loqarifmik intervallara bölünür. Son modeldə intensivlik qiymətləri əsası 1,28 olan loqarifmik çevirmə ilə 30 bin daxilində təmsil olunur.
Model üç öyrədilə bilən embedding dəstindən istifadə edir:
- m/z qiymətləri üçün embedding,
- intensivlik binləri üçün embedding,
- SMILES simvolları üçün embedding.
Encoder-a göndərilən hər spektral pikin təsviri m/z embedding-i ilə intensivlik embedding-inin cəmindən ibarətdir. Decoder tərəfində isə hər addım bir SMILES simvolunu təmsil edir.
Sintetik məlumatlar niyə istifadə edildi?
Real eksperimental GC-EI-MS spektrlərinin sayı mümkün molekulyar quruluş fəzası ilə müqayisədə məhduddur. Tədqiqatçılar buna görə modeli əvvəlcə xeyli daha geniş sintetik kimyəvi fəzada öyrədib, sonra real eksperimental spektrlərə uyğunlaşdırıblar.
ZINC20-dən ilkin olaraq təxminən 1,8 milyard SMILES ardıcıllığı toplanıb. Hər məlumat toplama mərhələsində 100 simvoldan qısa 30 milyon pozulmamış SMILES təsadüfi seçilib, sonra strukturlar kanonikləşdirilib, təkrarlanan qeydlər çıxarılıb və stereokimya məlumatı silinib. NIST 20-də olan birləşmələr məlumat sızmasının qarşısını almaq üçün sintetik əvvəlcədən təlim birləşmələrindən uzaqlaşdırılıb.
RASSP-nin emal edə bildiyi element və alt-formul məhdudiyyətlərindən sonra iki toplama mərhələsində təxminən 4,7 milyon və 4,8 milyon birləşmə qalıb. Hər birləşmə üçün həm NEIMS, həm də RASSP modeli ilə spektr yaradıldığından sintetik məlumat kolleksiyalarında ümumilikdə təxminən 9,4 milyon və 9,6 milyon spektr olub. Bu məlumat dəstləri təlim/doğrulama/test üçün 0,90/0,05/0,05 nisbətində bölünüb.
Əvvəlcədən təlim nə qədər davam etdi?
Son SpecTUS əvvəlcədən təlimi NEIMS və RASSP mənbələrinin 1:1 balanslaşdırılmış qarışığında aparılıb. Mənbə son əvvəlcədən təlim mərhələsində 17,2 milyon təlim spektrinin təxminən üç dəfə emal edildiyini bildirir.
| Əvvəlcədən təlim xüsusiyyəti | Qiymət |
|---|---|
| Batch ölçüsü | 128 |
| Yeniləmə addımı | 448.000 |
| Avadanlıq | 1 × NVIDIA H100 GPU |
| Ümumi müddət | 58 saat |
Əvvəlcədən təlimin sonunda tam quruluş yenidən yaratma nisbəti RASSP tərəfindən yaradılan spektrlərdə %38, NEIMS spektrlərində %29 və real NIST spektrlərində yalnız %3 olub. Buna baxmayaraq, yaradılan SMILES-lərin %96-sının etibarlı kanonik molekul olduğu bildirilib. Tədqiqatçılar bunu əvvəlcədən təlimin molekulyar quruluş qaydalarını və atom kütləsi–m/z əlaqəsini öyrənməsi üçün baza kimi şərh edirlər.
Real NIST spektrləri ilə incə tənzimləmə necə aparıldı?
NIST 20 GC-EI-MS kitabxanasında korlanmış və ya annotasiyasız spektrlər təmizlənib, stereokimya məlumatları çıxarılıb, SMILES təsvirləri kanonikləşdirilib və deyterium ehtiva edən birləşmələr çıxarılıb. Modelin m/z, pik sayı və SMILES uzunluğu limitləri də tətbiq edilib.
Ətraflı metod bölməsində son NIST bölünməsi belə verilir:
| NIST 20 alt dəsti | Spektr sayı |
|---|---|
| Təlim | 224.737 |
| Doğrulama | 28.177 |
| Test | 28.267 |
Təkrarlanan birləşmələrin müxtəlif split-lərə düşməsinə icazə verilməyib. Beləliklə, eyni molekulun təlim və test dəstlərində olmasının qarşısı alınmağa çalışılıb.
Mənbədaxili say qeydi: Məqalənin başqa bölmələrində NIST təlim/incə tənzimləmə ölçüsü 232.025 və 232.035 kimi də yazılıb. Ətraflı məlumat dəsti bölməsindəki 224.737 təlim spektri qiyməti bu iki ifadə ilə uyğun gəlmir. Buna görə bu üç say tək bir “düzəldilmiş” qiymətə çevrilməməlidir.
İncə tənzimləmə nə qədər davam etdi?
Model NIST təlim dəstində 296.000 yeniləmə addımı boyunca öyrədilib və hər spektrin təxminən 80 dəfə emal edildiyi bildirilib. İncə tənzimləmə yenə də tək NVIDIA H100 GPU-da nəzarət qiymətləndirmələri daxil olmaqla təxminən 28 saat davam edib.
Maraqlıdır ki, NIST incə tənzimləməsi zamanı modelin sintetik spektrləri tam yenidən qurma qabiliyyəti sürətlə azaldığı halda eksperimental NIST doğrulama göstəricisi güclü şəkildə yüksəlib. Tədqiqat bunu modelin sintetik məlumat paylanmasından real eksperimental paylanmaya uyğunlaşmasının nəticəsi kimi göstərir.
Hansı dizayn seçimləri eksperimental olaraq müqayisə edildi?
Tədqiqatçılar yalnız son modeli bildirməklə kifayətlənməyib, beş ayrıca inkişaf eksperimenti aparıblar.
1. İntensivlik binləndirilməsi
Xətti və loqarifmik intensivlik təmsil üsulları müqayisə edilib. Həddindən artıq kobud təmsil, xüsusən aşağı intensivlikli piklərdə məlumat itkisinə səbəb olub. 30 binli loqarifmik yanaşma dörd onluq mərtəbəli xətti kodlaşdırma ilə müqayisədə doğrulama Acc1 qiymətini təxminən 0,9 faiz bəndi artırarkən təxminən 10 milyon daha az öyrədilə bilən parametr tələb edib və son model üçün seçilib.
2. SMILES, SELFIES və tokenləşdirmə
SMILES əsaslı modellər SELFIES əsaslı modeldən doğrulama Acc1 baxımından 1,7–5,8 faiz bəndi daha yüksək nəticə verib. Bundan əlavə, təbii dil modellərində çox vaxt üstünlük verən daha böyük Byte Pair Encoding lüğətləri burada fayda verməyib. Ən sadə simvol səviyyəli SMILES kodlaşdırması digər BPE variantlarından təxminən 3,5–4 faiz bəndi daha yaxşı nəticə verib.
3. Sintetik əvvəlcədən təlim qarışığı
Sintetik əvvəlcədən təlim almayan model ilə RASSP, NEIMS və onların qarışıqları müqayisə edilib. Sintetik əvvəlcədən təlim alan modellər yalnız real məlumatda incə tənzimlənən modelə görə doğrulama Acc1-də təxminən 7–10 faiz bəndi üstünlük təmin edib. NEIMS və RASSP-nin 1:1 qarışığı ən yaxşı nəticəni verib.
4. Spektr mənbə etiketi
<rassp>, <neims> və <nist> kimi xüsusi mənbə tokenlərindən istifadənin son performansa nəzərəçarpan töhfəsi olmayıb. Tək ümumi mənbə tokenindən istifadə edən variant Acc1-də təxminən 0,2 faiz bəndi daha yüksək nəticə göstərib. Buna baxmayaraq, tədqiqatçılar gələcəkdə xüsusi məlumat dəstlərinə incə tənzimləmə üçün mənbə tokeni mexanizmini son modeldə saxlayıblar.
5. Təlim müddəti və məlumat miqdarının miqyaslandırılması
Əvvəlcədən təlim müddəti, incə tənzimləmə müddəti və sintetik məlumat ölçüsü ayrıca artırıldıqda performans yaxşılaşıb. Son tam miqyaslı `8.6M_448k_296k` konfiqurasiyası başlanğıc kimi istifadə olunan `4.2M_112k_74k` model ilə müqayisədə Acc1 qiymətini 5,4 faiz bəndi artırıb.
Tədqiqat çıxışı necə qiymətləndirir?
Acck, modelin yaratdığı ilk k namizəd arasında real molekulun tam şəkildə tapılma nisbətidir. Bu metrik yalnız oxşar quruluşu deyil, dəqiq molekulyar uyğunluğu qiymətləndirir.
Simk, k namizəd içində real molekula ən çox bənzəyən quruluşun Morgan molekulyar barmaq izi üzrə Tanimoto oxşarlığını ölçür.
Tədqiqat həmçinin SpecTUS-u başqa üsulla birbaşa müqayisə etmək üçün win rate və at-least-as-good nisbətlərindən istifadə edir. Tanimoto barmaq izləri müxtəlif molekullarda bəzən 1,0 oxşarlıq verə bildiyinə görə sıralama funksiyasına dəqiq quruluş uyğunluğu yoxlaması da əlavə edilib.
Niyə BDC adlı süni müqayisə istifadə olunur?
Best Database Candidate (BDC) real tətbiqdə əlçatmaz nəzəri yuxarı həddir. BDC sorğu molekulunun real quruluşunu artıq bildiyimizi fərz edib istinad kitabxanasındakı strukturlar arasından Morgan barmaq izi baxımından ona ən yaxın olanı seçir.
Beləliklə, BDC praktik identifikasiya üsulu deyil. Tədqiqatdakı rolu “verilənlər bazasında daha yaxşı quruluş onsuz da yoxdursa, axtarış alqoritmini təkmilləşdirməyin həddi nədir?” sualına yuxarı hədd yaratmaqdır.
Şəkil 1 nəyi izah edir?
Tədqiqatın metod sxemi SpecTUS-un iki mərhələli təlimini və son çıxarışını birlikdə göstərir. Əvvəlcədən təlim tərəfində ZINC-dən gələn SMILES strukturları NEIMS/RASSP vasitəsilə sintetik spektrlərə çevrilərək SpecTUS-a öyrədilir. İncə tənzimləmə mərhələsində eksperimental NIST spektrləri ilə real SMILES etiketləri istifadə olunur. Çıxarış zamanı isə bu axın tərs istiqamətdə işləyir: analiz edilən EI-MS spektri birbaşa SpecTUS-a daxil olur və model sıralanmış bir və ya bir neçə SMILES namizədi yaradır.
Tədqiqatın dəstəklədiyi nəticələr
- SpecTUS test birləşmələri təlim məlumat dəstlərindən ayrıldıqda belə aşağı ayırdetməli GC-EI-MS spektrlərindən yeni molekulyar quruluş namizədləri yarada bilib.
- NIST test dəstində tək namizəd tam quruluş dəqiqliyi %43, 10 namizəd dəqiqliyi %65 və 50 namizəd dəqiqliyi %69-dur.
- NIST-də tək SpecTUS namizədi HSS-nin tək namizədindən nümunələrin %76-sında daha yaxşı struktur namizəd yaradıb.
- NIST və SWGDRUG kimi daha yaxşı kurasiya olunmuş spektrlərdə model Cayman və MONA ilə müqayisədə daha yüksək performans göstərib.
- Sintetik məlumatda əvvəlcədən təlim yalnız eksperimental NIST məlumatı ilə təlimdən daha yüksək doğrulama performansı təmin edib.
- Birdən çox sintetik spektr generatorunun birlikdə istifadəsi tək mənbə ilə müqayisədə üstünlük yaradıb.
Tədqiqatın dəstəkləmədiyi və ya sübut etmədiyi nəticələr
- SpecTUS hər naməlum molekulu etibarlı şəkildə müəyyən edə bilən universal kimyəvi identifikasiya sistemi deyil.
- Modelin birinci sıradakı çıxışı müstəqil doğrulama olmadan qəti identifikasiya sübutu kimi qiymətləndirilməməlidir.
- Model tamamilə yeni və təlim kimyasından çox uzaq strukturlarda yüksək dəqiqlik zəmanəti vermir.
- Tədqiqat modelin laboratoriya mütəxəssisini əvəz edə bildiyini göstərmir.
- Model çıxışlarının parçalanma ağacı və ya pik-annotasiya mexanizmi ilə izah oluna bildiyi göstərilməyib.
- Cayman və MONA-dakı performans azalması bütün laboratoriya və cihaz şəraitində eyni dəqiqliyin gözlənilməməli olduğunu göstərir.
Tədqiqatın Metodu və Nəticələri
Qiymətləndirmə məlumat dəstləri
Model yalnız NIST test splitində deyil, müstəqil mənbələrdən götürülən SWGDRUG, Cayman və MONA EI-MS məlumatlarında da qiymətləndirilib. Təlim məlumatları ilə üst-üstə düşən birləşmələr və model limitlərini aşan nümunələr çıxarıldıqdan sonra istifadə olunan spektr sayı belədir:
| Test məlumat dəsti | Orijinal spektr sayı | Filtrdən sonra istifadə olunan spektr sayı |
|---|---|---|
| NIST test | 29.218 | 28.267 |
| SWGDRUG | 3.589 | 1.640 |
| Cayman | 2.262 | 469 |
| MONA | 18.914 | 5.015 |
Filtrləmə NIST təlim dəsti ilə üst-üstə düşmələrin çıxarılmasını, deyterium ehtiva edən strukturların silinməsini, m/z > 500 olan nümunələrin, 300-dən çox spektral piki olan spektrlərin və 100 simvolu aşan SMILES ardıcıllıqlarının xaric edilməsini əhatə edir.
NIST-də dəqiq molekulun yenidən qurulması
NIST-dəki 28.267 test spektri tədqiqatın ən əhatəli və yaxşı nəzarət olunan qiymətləndirməsidir. Namizəd sayı artırıldıqda real molekulun təklif siyahısında tapılma ehtimalı yüksəlir.
Bir namizəddən 10 namizədə keçmək 22 faiz bəndi əlavə tam uyğunluq təmin edir. Bunun əksinə, 10 namizəddən 50 namizədə keçid yalnız 4 faiz bəndi əlavə qazanc verir. Bu nəticə namizəd sayının məhdudiyyətsiz artırılmasının mütəxəssis qiymətləndirməsi yükü ilə birlikdə nəzərə alınmalı olduğunu göstərir.
Niyə çox namizədli nəticələrdə mütəxəssis hələ də lazımdır?
SpecTUS hər namizəd üçün öz sıralama ehtimalını yaradır; lakin tədqiqatçılar bu sıralamanın mütəxəssis qiymətləndirməsini əvəz edəcək qədər etibarlı olmadığını müəyyən ediblər. Hətta 10 namizəd yaradılan ssenaridə modelin ilk sıradakı namizədi orta hesabla yalnız bir namizəd yaradılan ssenaridəki namizəddən bir qədər aşağı dəqiqliyə malikdir.
Buna görə tədqiqat üç istifadə ssenarisi müəyyən edir:
- 1 namizəd: manual yük ən aşağıdır, yüksək həcmli analizlər üçün uyğundur; lakin dəqiqlik daha aşağıdır.
- 10 namizəd: dəqiqlik və mütəxəssis yoxlama yükü arasında daha balanslı ssenari.
- 50 namizəd: modelin potensialını artırır, lakin manual yoxlama yükünü ciddi şəkildə yüksəldir.
Struktur oxşarlığı baxımından HSS ilə müqayisə
NIST testində SpecTUS-un tək namizəd üçün orta Morgan/Tanimoto oxşarlığı 0,67-dir. HSS-nin 50 namizədlik nəticəsində belə bu qiymət 0,62 kimi bildirilir. SWGDRUG-da SpecTUS tək namizəd ortalaması 0,69, HSS50 isə 0,61-dir.
| Məlumat dəsti | SpecTUS 1 namizəd Sim1 | HSS 50 namizəd Sim50 | BDC nəzəri yuxarı həddi | SpecTUS 10 namizəd Sim10 |
|---|---|---|---|---|
| NIST test | 0,67 | 0,62 | 0,72 | 0,81 |
| SWGDRUG | 0,69 | 0,61 | 0,69 | 0,82 |
On namizədli SpecTUS bu iki məlumat dəstində istinad kitabxanasında mümkün olan ən yaxın molekulu təmsil edən BDC qiymətindən də yüksək orta oxşarlıq təmin edə bilir. Bunun səbəbi SpecTUS-un yalnız mövcud kitabxana strukturları arasından seçim etməyə məcbur olmaması və yeni strukturlar yarada bilməsidir.
HSS-ə qarşı birbaşa qalibiyyət nisbəti
NIST testində tək namizədli SpecTUS eyni şərtdəki HSS namizədindən test nümunələrinin %76-sında qəti şəkildə daha yaxşı struktur təklif edib. On namizədli halda bu nisbət %84-ə çatır. Mənbənin bütün namizəd ssenariləri birlikdə nəzərə alındıqda NIST-dəki SpecTUS–HSS qalibiyyət nisbəti %76–86 aralığındadır.
SWGDRUG üçün aralıq %72–85, Cayman üçün %63–74, MONA üçün %62–65 kimi bildirilir. Spektr kurasiyası azaldıqca SpecTUS-un üstünlüyünün də daralması giriş məlumatının keyfiyyətinə həssaslığı açıq göstərir.
Verilənlər bazasının nəzəri ən yaxşı namizədini belə keçmək mümkündürmü?
BDC sorğunun real quruluşunu bildiyimizi fərz edən nəzəri verilənlər bazası yuxarı həddidir. Buna baxmayaraq, NIST-də tək SpecTUS namizədi halların %47-sində, SWGDRUG-da %45-ində BDC-dən daha yaxşı nəticə göstərib.
On namizəd yaradıldıqda SpecTUS həm NIST, həm SWGDRUG-da nümunələrin %70-ində BDC-dən daha yaxşı, Cayman-da isə %56-sında daha yaxşı namizəd yarada bilib. Bu nəticə de novo yaradılmanın əsas üstünlüyünü göstərir: düzgün və ya daha yaxın molekulyar quruluş istinad kitabxanasında olmasa belə model yeni namizəd yarada bilər.
Şəkil 3-ün əsas mesajı
Şəkil 3 SSS, HSS və SpecTUS-un NIST, SWGDRUG, Cayman və MONA üzərində orta struktur oxşarlıqlarını 1, 10 və 50 namizəd ssenarilərində birlikdə göstərir. SpecTUS-un dəqiqlik qiymətləri ayrıca qara işarələrlə verilir.
NIST və SWGDRUG sütunlarında SpecTUS-un üstünlüyü ən aydın vəziyyətdədir. Cayman və xüsusilə MONA-ya keçdikdə bütün üsulların struktur oxşarlığı azalır və SpecTUS ilə HSS arasındakı fərq kiçilir. Tədqiqatçılar bunu spektrlərin yaradılma və kurasiya keyfiyyətindəki fərqlərlə əlaqələndirirlər.
Şəkil 4 nəyi göstərir?
Şəkil 4-ün A paneli SpecTUS-u HSS ilə, B paneli isə nəzəri BDC yuxarı həddi ilə birbaşa müqayisə edir. Qırmızı sütunlar SpecTUS-un qəti şəkildə üstün olduğu nümunələri, açıq rəngli əlavə hissə isə bərabərliklərin də daxil edildiyi “ən azı onun qədər yaxşı” nisbətini göstərir.
NIST və SWGDRUG-da namizəd sayı artdıqca SpecTUS-un HSS qarşısındakı üstünlüyü aydınlaşır, MONA-da isə əlavə namizədlərdən əldə olunan fayda daha məhduddur. Bu mənzərə daha çox namizəd yaratmağın təkbaşına zəif spektr məlumatını kompensasiya edə bilmədiyini göstərir.
Model həqiqətən tamamilə yeni kimyada ümumiləşirmi?
Tədqiqatın ən mühüm hədd sınaqlarından biri test molekullarının təlim dəstindəki strukturlara struktur oxşarlığının sistemli şəkildə azaldılmasıdır. Tədqiqatçılar maximum common edge subgraph (MCES) məsafəsindən istifadə etməklə NIST test dəstini getdikcə daha fərqli molekullarla məhdudlaşdırıblar.
Məsafə həddi T = 10 olduqda ilkin NIST test dəstinin yalnız %1,7-si, yəni 469 struktur qalıb. Bu ən çətin şərtdə SpecTUS 10 namizəd daxilində yalnız 19 molekulu tam olaraq yenidən qura bilib, orta struktur oxşarlığı isə 0,38 səviyyəsinə düşüb.
Bu nəticə təxminən %4 Acc10-a uyğun gəlir və modelin funksional həddini açıq şəkildə göstərir. SpecTUS əvvəllər görmədiyi molekulları proqnozlaşdıra bilsə də, təlim zamanı öyrəndiyi kimyəvi nümunələrdən tamamilə uzaq strukturlar üçün yüksək ümumiləşmə göstərmir.
Tipik struktur proqnoz səhvləri hansılardır?
Şəkil 5-də NIST test dəstindən 200 təsadüfi sorğunun SpecTUS10 və HSS10 oxşarlıqları müqayisə olunub və beş nümunə ətraflı göstərilib. Tədqiqatçılar üç tipik səhv formasını müəyyən edirlər:
- təkrarlanan karbon zəncirlərini lazım olduğundan uzun və ya qısa yaratmaq,
- düzgün funksional qrupu yanlış aromatik halqa atomuna bağlamaq,
- böyük molekulyar altstrukturları özləri düzgün həll etdiyi halda bu altstrukturları bir-birinə yanlış bağlamaq.
Şəkil 5 həmçinin Tanimoto/Morgan ölçüsünün öz məhdudiyyətini göstərir. Uzun və təkrarlanan zəncirlərdə iki fərqli molekul bəzən eyni barmaq izinə malikmiş kimi Tanimoto = 1 nəticəsi verə bilər. Buna görə tədqiqat dəqiq struktur uyğunluğunu ayrıca yoxlayır.
Çıxarış sürəti
Model üç fərqli avadanlıq sinfində sınaqdan keçirilib. Aşağıdakı qiymətlər bir spektr üçün 1, 10 və ya 50 struktur namizədi yaratma vaxtlarıdır:
| Avadanlıq | 1 namizəd | 10 namizəd | 50 namizəd |
|---|---|---|---|
| NVIDIA H100 80 GB | 0,2 s | 0,4 s | 1,9 s |
| NVIDIA Quadro RTX 5000 16 GB | 0,5 s | 1,1 s | 7,6 s |
| Xeon Gold 6130 CPU + 8 GB RAM | 8 s | 36 s | 450 s |
Bu müddətlər modelin laboratoriya iş axınlarında istifadə oluna biləcəyini göstərir, lakin avadanlığa xasdır. Xüsusilə CPU üzərində 50 namizəd yaratmaq 7,5 dəqiqəyə çatır; buna görə “sürətli” ifadəsi namizəd sayı və avadanlıq kontekstindən ayrı istifadə edilməməlidir.
İzaholunma məhdudiyyəti
SpecTUS müəyyən bir molekulu niyə yaratdığını kimyəvi parçalanma addımları vasitəsilə izah etmir. Modelin aralıq çıxışında pik annotasiyaları, parçalanma ağacları və ya təklif olunan namizədlərin istinad spektrləri yoxdur.
Bu vəziyyət yanlış namizədin mütəxəssis tərəfindən addım-addım düzəldilməsini çətinləşdirir. Model güclü namizəd generatoru olsa da, proqnozun kimyəvi əsaslandırmasını özü izah edən alət deyil.
Nəticələrin elmi mənası
Tədqiqatın əsas yeniliyi aşağı ayırdetməli GC-EI-MS-də yalnız spektral kitabxana axtarmaq əvəzinə spektri birbaşa molekulyar quruluşa çevirən böyük Transformer modelinin tətbiqidir. Test birləşmələrinin təlim birləşmələrindən ayrılması SpecTUS-un yalnız əzbərləmə etmədiyini və müəyyən ümumiləşmə qabiliyyəti inkişaf etdirdiyini dəstəkləyir.
Bununla yanaşı, struktur baxımından çox uzaq test birləşmələrindəki kəskin performans azalması modelin “naməlum” anlayışının sərhədlərini göstərir. Model təlimdə eynilə görmədiyi strukturları yarada bilər; lakin bunu böyük ölçüdə daha əvvəl öyrəndiyi kimyəvi alt nümunələri yeni formada birləşdirərək edir.
Mənbə və Metod Qeydi
Tam orijinal tədqiqat adı: SpecTUS: Spectral Translator for Unknown Structures Annotation from EI-MS Spectra
Müəlliflər və sırası: Adam Hájek; Michal Starý; Elliott Price; Filip Jozefov; Helge Hecht; Aleš Křenek.
Bərabər töhfə / bərabər birinci müəlliflik: Araşdırılan tədqiqatda bərabər töhfə bəyanı yoxdur.
Məsul müəllif: Aleš Křenek.
Qurumlar: Adam Hájek və Aleš Křenek — Institute of Computer Science, Masaryk University, Brno, Czech Republic. Michal Starý — School of Computation, Information and Technology, Technical University Munich, Garching bei München, Germany. Elliott Price və Helge Hecht — RECETOX, Masaryk University, Brno, Czech Republic. Filip Jozefov — Faculty of Informatics, Masaryk University, Brno, Czech Republic.
Mənbə növü / resenziya: Resenziyadan keçmiş tədqiqat məqaləsi.
Jurnal: Analytical Chemistry.
Nəşriyyat: American Chemical Society.
Biblioqrafik məlumat: Anal. Chem. 2026, 98, 21670–21682.
DOI: 10.1021/acs.analchem.6c02423.
Göndərilmə / reviziya / qəbul / nəşr: 14 aprel 2026 / 29 iyun 2026 / 30 iyun 2026 / 13 iyul 2026.
Rəsmi bağlantı:https://doi.org/10.1021/acs.analchem.6c02423
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Məlumat və kod əlçatanlığı: Tədqiqatın mənbə kodu, məlumat hazırlama və qiymətləndirmə iş axınları GitHub üzərindən paylaşılıb. Sintetik məlumat dəstləri və əvvəlcədən öyrədilmiş model Hugging Face-də dərc olunub. Bununla belə, NIST-in kommersiya lisenziyası şərtlərinə görə NIST 20 üzərində incə tənzimlənmiş son model sərbəst paylana bilmir. NIST lisenziyasına malik istifadəçilərin dərc olunmuş split və skriptlərlə incə tənzimləməni təkrar edə biləcəyi bildirilib.
Maraqlar toqquşması: Müəlliflər rəqabət yaradan maliyyə marağının olmadığını bəyan edirlər.
Maliyyələşdirmə: Tədqiqat Çexiya Təhsil, Gənclər və İdman Nazirliyinin e-Infrastruktura CZ (LM2023054) və RECETOX Research Infrastructure (LM2023069) layihələri ilə Avropa İttifaqı Horizon 2020 proqramının CETOCOEN Excellence layihəsi (857560) tərəfindən dəstəklənib. Hesablama resursları e-INFRA CZ layihəsi No. 90254 vasitəsilə təmin olunub.
Müəllif töhfələri: Adam Hájek SpecTUS-u tətbiq edib, eksperiment dizaynında iştirak edib, eksperimentləri aparıb və məqalənin yazılmasına töhfə verib. Michal Starý model və eksperiment dizaynına töhfə verib. Elliott Price məlumat hazırlama, eksperiment dizaynı və qiymətləndirmə üçün istiqamətləndirmə təmin edib. Filip Jozefov məlumat hazırlama/split əməliyyatlarını və sintetik məlumat yaradılmasını həyata keçirib. Helge Hecht qiymətləndirməyə töhfə verib. Aleš Křenek tədqiqata rəhbərlik edib, RASSP dəyişikliklərini və təlimini həyata keçirib, sintetik məlumat yaradılmasına, eksperiment dizaynına və məqalənin yazılmasına töhfə verib və göndərmə/reviziya proseslərini idarə edib.
Mənbədaxili məlumat dəsti uyğunsuzluğu: Ətraflı metod bölməsində NIST 20 təlim split-i 224.737 spektr kimi verildiyi halda giriş bölməsində 232.025, baseline bölməsində 232.035 spektr ifadələri mövcuddur. Bu saylar səssiz şəkildə tək qiymətə çevrilməyib. Bu Verianla mətnindəki təlim/doğrulama/test cədvəlində ətraflı “Fine-Tuning Data Set” bölməsinin 224.737 / 28.177 / 28.267 bölgüsü əsas götürülüb.
Metodoloji məhdudiyyətlər: SpecTUS aşağı ayırdetməli GC-EI-MS üçün hazırlanıb və giriş spektrinin keyfiyyətinə həssasdır. Model müəyyən proqnozlar üçün kimyəvi parçalanma izahı yaratmır. Çox namizədli ssenarilərdə namizədlərin modeldaxili sıralaması təkbaşına etibarlı hesab edilməyib və mütəxəssis qiymətləndirməsi zəruri görülüb. Təlim strukturlarından çox uzaq molekulyar strukturlarda tam yenidən qurma performansı nəzərəçarpacaq dərəcədə azalır.
Məzmun metodu: Bu Verianla məqaləsinin elmi tapıntıları yalnız araşdırılan tədqiqatın mətni, cədvəlləri, şəkilləri və müəlliflərin təqdim etdiyi nəticələrə əsaslanır. Xarici doğrulama yalnız DOI, nəşriyyat, jurnal və resenziya kimi biblioqrafik identifikasiya sahələri üçün istifadə olunub; tədqiqata kənardan yeni performans nəticəsi və ya kimyəvi tapıntı əlavə edilməyib.
Meta Teqlər
GC-EI-MS, SpecTUS, molekulyar quruluş annotasiyası, kütlə spektrometriyası, Transformer modeli
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib