

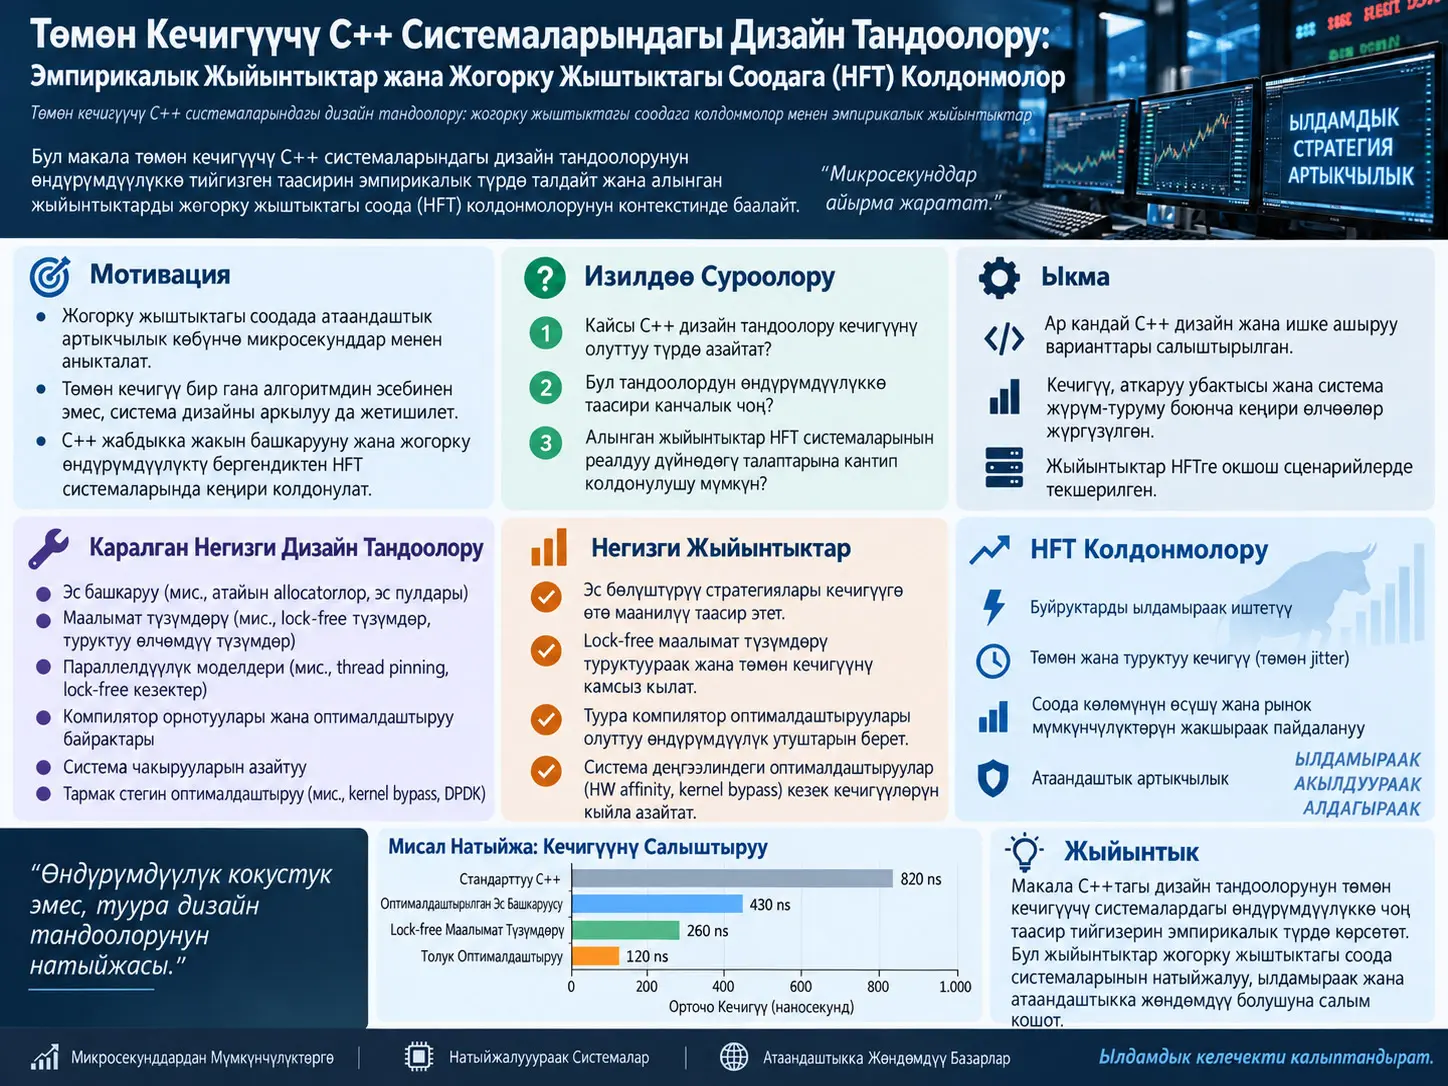
Жогорку жыштыктагы соода системаларында өндүрүмдүүлүк бир алгоритмдин ылдамдыгы менен гана аныкталбайт. Базар маалымат пакети системага келгенден тартып ага жооп болгон буйрук сыртка жөнөтүлгөнгө чейин өтүүчү tick-to-trade кечигүүсү операциялык системанын scheduler’и, interrupts, kernel housekeeping, page faults, TLB жүрүмү, cache locality, C++ башкаруу агымы, эс бөлүү, thread synchronization жана тармак протокол стеги сыяктуу көп катмардын биргелешкен натыйжасы болуп саналат.
Khalid Mohammad бул катмарларды микроbenchmark аркылуу өз-өзүнчө текшерип, төмөн кечигүүчү программалык инженерияда кайсы дизайн тандоолору типтүү кечигүүгө, кайсылары болсо tail latency деп аталган сейрек, бирок өтө чоң кечигүү секириктерине таасир этерин изилдейт.
Негизги жыйынтык: бир эле “эң жакшы оптималдаштыруу” жок. Real-time scheduler median wakeup latency’ни азайтат, бирок терең tail учурларын жалгыз жок кыла албайт. Kernel деңгээлиндеги CPU isolation, RCU/workqueue ажыратуу жана interrupt steering p99.9 жана p99.99 кечигүүлөрүн алда канча күчтүү кыскарта алат.
Эс тарабында биринчи кайрылууда page fault жаратпай, барактарды алдын ала populate кылуу 2 µs чамасындагы first-touch чыгымын 20 ns деңгээлине түшүргөн. Explicit 2 MB HugeTLB 4 KB барактарга салыштырмалуу TLB miss үлүшүн %1,33төн %0,09га, cycles/access маанисин 290дон 43,12ге түшүргөн.
C++ катмарында stateless lambda inline function’га жакын турат; std::function ошол эле тажрыйбада 5,68× кымбат. RTTI негизиндеги dynamic_cast explicit tagging’ге салыштырмалуу 3,6× көп cycle колдонгон. Object pool жалпы new/delete’ке караганда 3,7× ылдамдык берген, heap allocation’дун tail latency’си болсо жогору калган.
Data-oriented дизайн маалыматтын жайгашуусу процессордун эсептөө күчүнөн да маанилүү болушу мүмкүн экенин көрсөтөт. Sequential memory access ≈5,35 cycles/access, random pointer chasing ≈378 cycles/access. False sharing эки thread тажрыйбасында убакытты 7,5× көбөйткөн; Structure of Arrays Array of Structures’ке караганда risk loop’ту тез бүтүргөн.
Тармак катмарында Linux UDP жолу менен AF_XDP жолу бир машинанын network namespace жана veth чөйрөсүндө салыштырылган. Kernel stack орточо ≈200 µs болсо, AF_XDP ≈8 µs; p50 ≈218 µsтен 6 µsке түшкөн. Бирок AF_XDP p99 ≈80 µs бойдон калган; kernel bypass tail latency’ни толук жоготпойт.
Жалпы инженердик жыйынтык: төмөн кечигүү бир тез функциядан эмес, критикалык жолдогу белгисиз жай жолдорду системалуу алып салуудан пайда болот.
Төмөн кечигүүчү системаларда негизги өлчөм эмне?
Жалпы программаларда throughput же операция саны жетиштүү болушу мүмкүн. HFT системаларында болсо сейрек кечигүү секириги да экономикалык мааниге ээ.
Ошондуктан p50 → p99 → p99.9 → p99.99 → максимум кечигүү чынжыры толук каралышы керек.
Scheduler тандоо өзү эле төмөн кечигүү береби?
Жок. cyclictest’те SCHED_FIFO типтүү wakeup latency боюнча CFS’тен тез, бирок терең tail’де kernel interference дагы киришет.
| Percentile | CFS | CFS Tuned | SCHED_FIFO |
|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs |
| p99 | 67 µs | 811 µs | 15 µs |
| p99.9 | 1383 µs | 929 µs | 1287 µs |
| p99.99 | 3386 µs | 1916 µs | 2673 µs |
SCHED_FIFO p50ни 55 µsтен 5 µsке түшүрөт, бирок p99.9 дагы 1287 µs болгондуктан ири секириктер жалгыз scheduler кезегинен чыкпайт.
CPU isolation tail latency’ге эмне үчүн күчтүү таасир берет?
Thread белгилүү CPU’га pin кылынса да, ошол ядро timer tick, RCU callback, kernel workqueue же hardware interrupt аркылуу үзгүлтүккө учурашы мүмкүн. Изилдөө isolcpus, nohz_full, rcu_nocbs, cpuset/cgroup жана workqueue relocation’ди бирге колдонуп latency-critical ядрону kernel housekeeping’ден бөлөт.
| Percentile | CFS | CFS + Isolation | RT | RT + Isolation |
|---|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs | 5 µs |
| p99 | 67 µs | 61 µs | 15 µs | 10 µs |
| p99.9 | 1383 µs | 77 µs | 1287 µs | 33 µs |
| p99.99 | 3386 µs | 201 µs | 2673 µs | 174 µs |
Median дээрлик өзгөрбөйт, бирок p99.9 жана p99.99 кескин кыскарат. Scheduler типтүү кечигүүгө, isolation ultra-tail жүрүмүнө көбүрөөк таасир этет.
Interrupt steering эмне кошот?
| Өлчөм | Isolation жок | Isolation | Isolation + IRQ Steering |
|---|---|---|---|
| p99.9 | 1287 µs | 33 µs | 40 µs |
| p99.99 | 2673 µs | 174 µs | 109 µs |
| Maximum | 4673 µs | 564 µs | 399 µs |
IRQ’ларды latency-sensitive CPU’дан алыстатуу p99.99 жана maximum маанилерин дагы төмөндөтөт; бир percentile бүт оптималдаштырууну түшүндүрбөйт.
Page fault жана huge pages
Linux anonymous memory’ни demand paging менен байланыштырат. 512 MB anonymous mapping тажрыйбасында 131.000дей minor page fault чыккан жана биринчи кайрылуу баасы барак башына 2 µs болгон. MAP_POPULATE steady-state first access’ти 20 ns деңгээлине түшүргөн. Бирок memory pressure болсо mlock/mlockall сыяктуу чаралар керек болушу мүмкүн.
| Барак түзүлүшү | Cycles / Access | dTLB Miss Rate |
|---|---|---|
| 4 KB | ≈290 | ≈%1,33 |
| Transparent Huge Pages | ≈241 | ≈%0,47 |
| Explicit HugeTLB 2 MB | 43,12 | %0,09 |
Explicit HugeTLB cycles/accessти 6–7× азайтат. THP болсо collapse, split жана compaction себептүү millisecond tail spike жаратышы мүмкүн.
VM tuning, mitigations жана C-state
| Percentile | Демейки | VM tuning кийин |
|---|---|---|
| p50 | 92 µs | 30 µs |
| p99 | 204 µs | 556 µs |
| p99.9 | 4415 µs | 4898 µs |
| p99.99 | 7630 µs | 7076 µs |
| Maximum | 9230 µs | 8013 µs |
Median жакшырат, бирок p99 жана p99.9 начарлайт. Демек hot path ичинде runtime allocation’дон качып, эсти алдын ала бөлүү ишенимдүү.
| Өлчөм | Mitigations ON | Mitigations OFF |
|---|---|---|
| Raw syscall | 2850 cycles | 306 cycles |
| libc syscall | 2815 cycles | 278 cycles |
| Context switch | 24.301 cycles | 14.829 cycles |
| sched pipe | 7,76 µs/op | 4,76 µs/op |
Mitigations өчүрүлгөндө syscall жана context switch арзандайт, бирок бул коопсуздук тобокелдигин жогорулатышы мүмкүн. Бул жалпы системалар үчүн түз сунуш эмес.
| Абал | p99 | p99.9 | p99.99 |
|---|---|---|---|
| C-state ON / Idle | 54 µs | 57 µs | 175 µs |
| C-state OFF / Idle | 54 µs | 55 µs | 58 µs |
| C-state ON / Stress | 77 µs | 144 µs | 182 µs |
| C-state OFF / Stress | 70 µs | 149 µs | 197 µs |
Idle шартта C-state өчүрүү p99.99ти кыскартат; stress шартта ошол эле пайда дайыма көрүнбөйт.
C++ hot path жыйынтыктары
| Dispatch | 1 тип | 4 тип | 8 тип |
|---|---|---|---|
| Static | 1,32 ms | 8,75 ms | 10,02 ms |
| Virtual | 1,94 ms | 9,19 ms | 10,38 ms |
Virtual dispatch бир типте 1,47× кымбат. Бирок ABI-stable интерфейстерде, plugin системаларда жана cold path’те dynamic polymorphism маанилүү болушу мүмкүн.
| Move түзүлүшү | Wall Time |
|---|---|
| noexcept move | 101,6 s |
| non-noexcept move | 263,4 s |
noexcept ар дайым тездетпейт, бирок std::vector reallocation’да move noexcept болбосо copy жолуна өтүп, 2,6× айырма жаратышы мүмкүн.
| Callable | Relative Cost |
|---|---|
| Inline function | 1,00× |
| Stateless lambda | 1,03× |
| std::function | 5,68× |
dynamic_cast explicit tagging’ге караганда 3,6× көп cycle жана 7,6× көп instruction колдонгон. std::function’дун чыгымы lambdaдан эмес, type erasure жана indirect dispatchтен чыгат.
Cache locality, allocation жана concurrency
PGO 50 миллион order workload’унда execution time’ды 1,791 sтен 1,766 sке түшүргөн. Бул чоң эмес, бирок production hot path’те топтолгон майда жакшыруулар маанилүү болушу мүмкүн.
| Өлчөм | Baseline | PGO |
|---|---|---|
| Execution Time | 1,791 s | 1,766 s |
| Cycles | 6,20 B | 6,11 B |
| Instructions | 12,77 B | 11,07 B |
| LLC Load Misses | 419 K | 398 K |
| Операция | Median | p99.9 | Maximum |
|---|---|---|---|
| new | 82 cycles | 8586 cycles | 172.401 cycles |
| Pool allocate | 32 cycles | 246 cycles | 81.756 cycles |
| delete | 60 cycles | 433 cycles | 73.471 cycles |
| Pool deallocate | 34 cycles | 262 cycles | 52.153 cycles |
Object pool’дун артыкчылыгы айрыкча p99.9 tail’де көрүнөт. Sequential array ≈5,35 cycles/access, random pointer chasing ≈378 cycles/access болуп, айырма 70×.
| Кириш түрү | Cycles / Access |
|---|---|
| Sequential array | ≈5,35 |
| Random pointer chasing | ≈378 |
Hot/cold data бөлүү иш убактысын 1,08746 sтен 0,91845 sке, cache missesти 7,8×10⁷ден 3,5×10⁷ге түшүргөн. False sharing 4,16 s, cache-line padded 0,55 s болуп, 7,5× айырма жараткан.
| Дүзүлүш | Cycles | Убакыт |
|---|---|---|
| False sharing | 2,73×10¹⁰ | 4,16 s |
| Cache-line padded | 3,61×10⁹ | 0,55 s |
AoS 258 ms, SoA 145 ms; SIMD scalar 406 ms, AVX 370 ms болгон. Маалымат contiguous жана vector-friendly болсо SIMD көбүрөөк пайдалуу.
Lock-free жана AF_XDP
| Операция | p50 | p99.9 | p99.99 |
|---|---|---|---|
| Lock Push | 80 | 17.785 | 32.115 cycles |
| Lock-Free Push | 47 | 294 | 378 cycles |
| Lock Pop | 81 | 12.958 | 46.048 cycles |
| Lock-Free Pop | 25 | 226 | 278 cycles |
SPSC ring buffer’де lock-free tail’ди кескин жакшыртат, бирок көп contention шартында CAS retry cache-line ping-pong жаратып mutex’тен начар болушу мүмкүн.
Классикалык жол NIC → Driver → sk_buff → IP/UDP Stack → Socket → System Call → User Space, AF_XDP жолу NIC → XDP → AF_XDP → UMEM → User Space.
| Тармак жолу | Mean | p50 | p99 |
|---|---|---|---|
| Kernel Stack | ≈200 µs | ≈218 µs | ≈300 µs |
| AF_XDP | ≈8 µs | ≈6 µs | ≈80 µs |
Бул benchmark production HFT network’үн эмес, бир машинанын namespace/veth чөйрөсүн өлчөйт.
Метод жана булак эскертүүсү
Тажрыйба чөйрөсү
| Компонент | Колдонулган чөйрө |
|---|---|
| CPU | Intel Core i5-6500 @ 3,20 GHz |
| Ядро | 4 core / 1 thread per core |
| RAM | 3,7 GiB |
| NUMA | Бир node |
| Linux kernel | 6.8.0-90-generic |
| Compiler | GCC 13.3.0 |
| Default build | -O2 |
| CPU governor | performance |
Жалпы үлгү: scheduler median’га, kernel isolation жана IRQ steering p99.9/p99.99ге көбүрөөк таасир этет; hot path’теги page fault, heap allocation, syscall жана futex чоң tail spike жарата алат; cache locality көп учурда арифметикалык оптималдаштыруудан күчтүүрөөк; kernel bypass орточо latency’ни азайтса да residual tail калат.
Түпнуска аталыш: Design Choices in Low-Latency C++ Systems: Empirical Insights with Applications to High-Frequency Trading
Автор: Khalid Mohammad.
Мекеме: Department of Computer Science, Indian Institute of Technology Kharagpur.
Дата: 3-апрель 2026; SSRN жүктөлгөн дата: 17-апрель 2026; SSRN ID: 6513601; DOI: 10.2139/ssrn.6513601.
Чектөөлөр: Натыйжалар Intel i5-6500, белгилүү Linux/GCC версиялары жана namespace/veth тармак чөйрөсү менен чектелет. Изилдөө trading alpha же стратегия кирешесин эмес, ultra-low-latency software engineering принциптерин текшерет.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген