

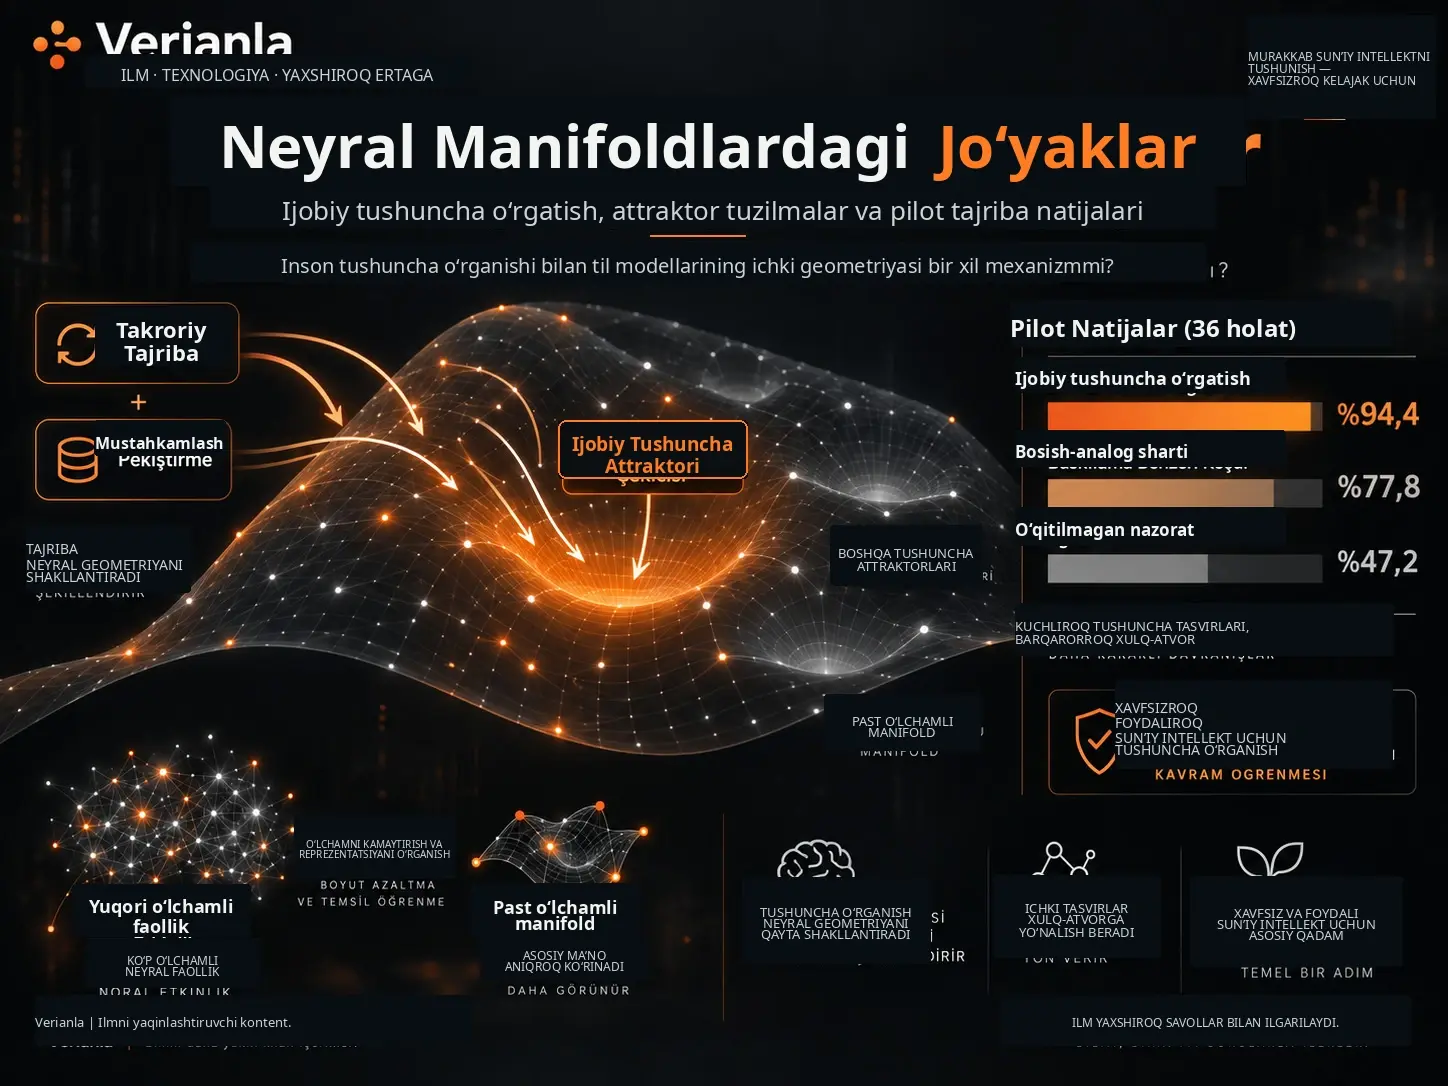
Neyral manifold, ko‘p sonli neyronlar yoki sun’iy tarmoq birliklarining yuqori o‘lchamli faollik fazosida hosil qilgan xulq-atvori pastroq o‘lchamli geometrik sirt ustida tartiblanishini ifodalovchi reprezentatsiya yondashuvidir. Frederick Roth tadqiqoti odamlardagi tushuncha o‘rganishi bilan o‘rgatilgan til modellaridagi konseptual reprezentatsiyalar ikki xil mexanizm emas, balki mustahkamlash orqali shakllangan past o‘lchamli tortuvchi tuzilmaning ikki miqyosdagi ko‘rinishi ekanini ilgari suradi. Bu doirada tushunchalar alohida-alohida ramziy ta’riflar sifatida saqlanmaydi; aksincha, o‘xshash tajribalar qayta-qayta faollashtiradigan va tizim holati yana qaytishga moyil bo‘lgan zich geometrik hududlar sifatida qaraladi. Maqola ushbu yondashuvning sun’iy intellekt xavfsizligi uchun bevosita oqibatini taklif qiladi: nomaqbul xulq-atvorni faqat bostirish o‘rniga, istalgan xulq-atvorning o‘zini ijobiy, nomlangan konseptual tortuvchi sifatida o‘rgatish. Muallif bu usulni Concept Programming (CP) deb ataydi. 3 milliard parametrli Llama 3.2 modelida xabar qilingan pilotda CP 36 governance-safety holatida %94,4 aniqlikka erishgan, salbiy ramkali punishment-analog sharti %77,8, o‘qitilmagan nazorat esa %47,2 aniqlik ko‘rsatgan. Biroq punishment-analog sharti haqiqiy ishlab chiqarish miqyosidagi RLHF emas; tadqiqot CP RLHFdan to‘g‘ridan-to‘g‘ri eksperimental ravishda ustun kelganini ko‘rsatmaydi. Shuningdek, xabar qilingan xulq-atvor natijalari manifold geometriyasining bevosita o‘lchovi emas. Shu sababli tadqiqotning inson–AI mexanizmlarining aynan birligi haqidagi asosiy gipotezasi qiziqarli va falsifikatsiya qilinishi mumkin, ammo hozircha mustahkam ilmiy xulosa emas.
Maqola o‘z qamrovini ataylab cheklangan tarzda belgilaydi. Muallif ushbu matn kitob va ikki texnik companion tadqiqotning qisqa xulosasi ekanini hamda bu yerda keltirilgan da’volarning birlamchi manbai aynan ushbu 7 sahifalik maqola emasligini ochiq aytadi. To‘liq eksperiment protokollari, qo‘shimcha natijalar va kod boshqa ishlarga qoldirilgan.
Bu farq muhim; chunki tadqiqot bir tomondan kognitiv fan, Hebb tipidagi hujayra ansambllari, kategoriya o‘rganishi va attractor tarmoqlarini bitta geometrik hikoya ostida birlashtiradi, ikkinchi tomondan esa kichik ko‘lamli pilot tajribalardan sun’iy intellektni moslashtirish arxitekturasi uchun kengroq nazariy xulosalar chiqaradi. Verianla nuqtayi nazaridan to‘g‘ri yondashuv bu natijalarni “isbotlangan umumiy sun’iy intellekt xavfsizligi qonuni” sifatida emas, balki aniq eksperimental chegaralarga ega tadqiqot dasturining dastlabki dalillari sifatida taqdim etishdir.
Neyral Manifold Nima?
Neyral manifold — juda yuqori o‘lchamli neyron faollik fazosidagi tizim holatlari aslida ancha past o‘lchamli tartibli sirt ustida to‘planadi degan g‘oya; bu yondashuvda reprezentatsiya qilinadigan axborot alohida neyronlarning qat’iy ma’nolarida emas, balki tizim faolligining shu geometrik sirtdagi o‘rni va harakatida kodlanadi.
Neyron tarmoq millionlab yoki milliardlab alohida parametrga ega bo‘lishi mumkin. Shunga qaramay, muayyan vazifa paytida hosil bo‘ladigan faollik naqshlari barcha mumkin bo‘lgan yuqori o‘lchamli holat fazosidan foydalanishi shart emas. Agar aktivatsiyalar muayyan yo‘nalishlarda to‘plansa, tizim xulq-atvorini past o‘lchamli geometrik tuzilma orqali tushuntirish mumkin.
Manbaning konseptual yondashuvida kategoriya a’zoligi ham shu geometrik tuzilma orqali tushuniladi. Misol muayyan kategoriyaning albatta “ichida” yoki “tashqarisida” bo‘lishi shart emas; uning manifolddagi o‘rni kategoriya hududiga turli darajada yaqin bo‘lishi mumkin. Shu tariqa tipik va atipik kategoriya a’zolarining turli tezlikda yoki ishonch bilan tanilishi kabi darajali xulq-atvorlarni tushuntirish mumkinligi ilgari suriladi.
Kategoriya a’zoligi nega darajali?
Manba Eleanor Roschning kategoriya tadqiqotlariga tayangan holda, kundalik tushunchalarning ko‘pida a’zolik mutlaqo ikkilik emasligini ta’kidlaydi. Ayrim misollar kategoriya uchun tipikroq ko‘rinsa, boshqalari chegarada qolishi mumkin. Manifold yondashuvida buning sababi tushuncha qat’iy ramziy shartlar ro‘yxati emas, geometrik hudud sifatida qaralishidir.
Wittgensteinning “oilaviy o‘xshashlik” yondashuvi ham shu kontekstga joylashtiriladi. Kategoriyadagi barcha misollar bo‘lishishi shart bo‘lgan yagona umumiy xususiyat bo‘lmasligi mumkin; kategoriya yaxlitligini ta’minlaydigan narsa misollar xususiyatlarining ustma-ust tushib hosil qilgan hududiy tuzilmasi bo‘lishi mumkin.
Tortuvchi Tuzilma Nima va U Tushuncha O‘rganish bilan Qanday Bog‘lanadi?
Tortuvchi tuzilma (attractor), tizim faolligining ma’lum bir hududga yo‘nalishi va kichik og‘ishlardan keyin yana o‘sha hududga qaytishga moyilligini ifodalaydi. Manba o‘rganilgan tushunchalarni bitta qat’iy neyron zanjiridan ko‘ra chegaralari darajali bo‘lgan barqaror va zich manifold hududlari sifatida ko‘rish mumkinligini ta’kidlaydi.
Donald Hebbning hujayra ansambli tushunchasi ushbu hikoyaga tarixiy asos sifatida kiritiladi. Hebb birga qayta-qayta faollashadigan hujayra guruhlari vaqt o‘tishi bilan birgalikda ishlay oladigan funksional birlik hosil qilishi mumkinligini taklif qilgan.
Roth bu g‘oyani geometrik tilda qayta talqin qiladi: hujayra ansambli muayyan a’zolardan iborat o‘zgarmas ro‘yxat bo‘lish o‘rniga, faollik qayta-qayta to‘planadigan manifold hududi sifatida qaralishi mumkin.
Bu modelda mustahkamlash faqat muayyan natijani mukofotlaydigan hodisa emas. U takroriy faollik tizimning holat fazosidagi ayrim yo‘llar va hududlarni osonroq erishiladigan qiladigan geometrik shakllanish mexanizmi sifatida talqin qilinadi.
“Groove”, ya’ni jo‘yak o‘xshatishi nimani anglatadi?
Tadqiqot va kitob sarlavhasidagi “groove” so‘zi shu takroriy foydalanish g‘oyasini ifodalaydi. Biror xulq-atvor yoki konseptual naqsh qayta-qayta faollashgani sayin, tizimning o‘sha faollik hududiga yana qaytishi osonlashadi.
Bu haqiqiy fizik jo‘yak bor degani emas. Manba qo‘llagan geometrik metafora o‘rganilgan xulq-atvorlar yuqori o‘lchamli faollik fazosida afzal yo‘llar yoki barqaror hududlar ko‘rinishida reprezentatsiya qilinishi mumkin degan taxminni anglatadi.
Nega bir tushuncha bitta manifold bilan cheklanmaydi?
Manba perseptiv yoki motor ko‘nikmani bitta reprezentatsiya sohasida ko‘rib chiqish mumkinligini, kengroq tushunchalar esa turli modalitlarni birlashtirishi kerakligini ta’kidlaydi. Masalan, “it” tushunchasi vizual shakl, tovush, harakat va boshqa tajriba turlarini bitta konseptual tuzilma ichida bog‘laydi.
Shunda alohida tajriba sohalarining umumiy tuzilmasi qanday birlashtirilishi haqidagi savol paydo bo‘ladi. Roth bu yerda Hayes-Roth va McDermottning 1978-yildagi interference matching yondashuvidan foydalanadi.
Interference Matching Nima?
Interference matching, bitta tushunchaga oid bir nechta misol faollashtirgan xususiyat tuzilmalarini ustma-ust qo‘yib, bu misollar orasida takrorlanadigan umumiy tuzilmani ajratish yondashuvidir; manba buni turli tajribalardan umumiyroq konseptual abstraksiya hosil qilish mexanizmi sifatida ko‘radi.
Manba ifodasiga ko‘ra, jarayon har bir misol faollashtirgan elementlar to‘plamlarining kesishmasini hisoblashga formal jihatdan o‘xshatilishi mumkin. Bitta misolda tasodifiy yoki kontekstga xos bo‘lgan xususiyatlar takrorlar orasida yo‘qolib, umumiy xususiyat kombinatsiyalari kuchayadi.
Roth bu yondashuvni ramziy sxema yoki yagona prototipni saqlash o‘rniga, birgalikda uchraydigan xususiyat kombinatsiyalariga oid darajali xotiraning shakllanishi sifatida talqin qiladi.
Yangi axborot tuzilmasi foydalanish jarayonida qanday o‘zgaradi?
Manba Barbara Hayes-Rothning 1977-yilgi ishida xabar qilingan uch bosqichli transfer egri chizig‘ini alohida qayd etadi:
- Boshlang‘ich yengillik: yangi shakllangan axborot tuzilmasi muayyan vazifalarda boshlang‘ich ustunlik beradi.
- Recovery bosqichi: umumiy subkomponentlar konsolidatsiya jarayonida bir-biri bilan raqobatlashadigan davr yuzaga keladi.
- Asimptotik bosqich: axborot tuzilmasi barqarorroq bo‘ladi.
Muallif ushbu uch bosqichli topilma Barbara Hayes-Rothga tegishli ekanini maxsus ajratadi; property-set modeli esa Frederick Hayes-Rothning 1974-yilgi ishidan boshlangan va keyinchalik birgalikda rivojlantirilgan boshqa tarixga ega ekanini qayd etadi.
Ramziy Bog‘lash Muammosi Nima?
Ramziy bog‘lash muammosi — ramziy tizim abstrakt o‘zgaruvchilardagi rollar sahnadagi real obyektlarga qanday biriktirilishini aniqlashi kerak bo‘lganda yuzaga keladigan kombinator moslashtirish muammosi. Manba manifold reprezentatsiyalari bu muammoni tezroq “yechadi” deb emas, o‘zgaruvchi–qiymat bog‘lashni talab qiladigan reprezentatsiya shaklini boshidan qo‘llamasdan muammoning o‘zini yo‘q qiladi deb da’vo qiladi.
Ramziy tizim, masalan, munosabatni quyidagicha ifodalashi mumkin:
above(block-A, block-B)
Umumiy qoida turli obyektlarga qo‘llanishi kerak bo‘lsa, tizim qaysi obyekt qaysi o‘zgaruvchi rolini to‘ldirishini aniqlashi kerak. Obyektlar va munosabatlar soni ortgani sari ehtimoliy moslashtirishlar soni ham ko‘payishi mumkin.
Manba bu muammoni Hayes-Roth va McDermott 1978-yilda strukturaviy naqsh o‘rganish nuqtayi nazaridan aniqlagan asosiy amaliy to‘siqlardan biri sifatida ko‘rsatadi.
Manifold Yondashuvi Bog‘lash Muammosini Qanday “Yo‘q Qiladi”?
Roth taklifida munosabatlar nomlangan o‘zgaruvchilarga obyektlarni biriktirish orqali emas, balki manifoldlar orasidagi nisbiy joylashuv, masofa yoki umumiy faollik naqshi orqali reprezentatsiya qilinishi mumkin; shu tariqa o‘zgaruvchi–qiymat bog‘lashni qidirishga ehtiyoj qolmaydi va tanish jarayoni o‘rganilgan tortuvchi tuzilmaga nisbatan naqshni to‘ldirish muammosi sifatida qayta ta’riflanadi.
Bu muhim nazariy farq. Maqola “NP-qiyin bog‘lash muammosini tezroq yechadigan yangi algoritm”ni taklif qilmaydi. Aksincha, ana shu muammo sinfini yuzaga keltiradigan ramziy reprezentatsiya farazi keraksiz bo‘lishi mumkinligini ilgari suradi.
Biroq bu natija tadqiqotda katta til modellarining ichki aktivatsiyalaridan olingan keng qamrovli bog‘lash tajribasi orqali ko‘rsatilmagan. Manba bu yerda nazariy reprezentatsiya argumentini quradi.
Inson Tushuncha O‘rganishi bilan Til Modellari Ichki Geometriyasi Bir Xil Mexanizmmi?
Ushbu maqolaning asosiy tezisi “ha” tomonida, biroq manba buni mustahkam ilmiy fakt sifatida emas, falsifikatsiya qilinishi mumkin bo‘lgan birlashtiruvchi da’vo sifatida ishlab chiqadi. Inson tushuncha o‘rganishi bo‘yicha xulq-atvor adabiyoti bilan sun’iy neyron tarmoqlardagi past o‘lchamli reprezentatsiya geometriyasi bir xil asosiy tortuvchi mexanizmni aks ettiradi, deb ilgari suriladi; bu mexanizmlarning biologik va sun’iy tizimlarda haqiqatan bir xil ekanini bevosita ko‘rsatadigan umumiy tajriba esa ushbu maqolada yo‘q.
Shuning uchun ikki xil dalil darajasi bir-biridan ajratilishi kerak.
| Da’vo | Ushbu maqoladagi maqomi |
|---|---|
| Tushuncha a’zoligi darajali bo‘lishi mumkin. | Avvalgi kognitiv fan adabiyotiga tayanuvchi fon. |
| Neyron tarmoqlarda past o‘lchamli reprezentatsiya tuzilmalari shakllanishi mumkin. | Maqola tayanadigan zamonaviy interpretability adabiyotidan kelib chiqadigan fon. |
| Inson tushuncha o‘rganishi va til modeli tushuncha geometriyasi bir xil mexanizmdir. | Muallifning birlashtiruvchi nazariy gipotezasi. |
| Bu mexanizm attractor-based Concept Programmingni imkonli qiladi. | Nazariyadan kelib chiqqan amaliy tadqiqot gipotezasi. |
| Pilot CP o‘qitishi ayrim safety testlarida yuqoriroq aniqlik berdi. | Manbada xabar qilingan xulq-atvor tajribasi natijasi. |
Concept Programming Nima?
Concept Programming (CP), sun’iy intellekt tizimida nomaqbul chiqishni faqat jazolash yoki filtrlash o‘rniga, istalgan xulq-atvor tushunchasini nomlangan ijobiy tortuvchi sifatida o‘rgatib, kerak bo‘lganda nomaqbul alternativaning yuzaga chiqishini to‘sadigan javob naqshi bilan moslashtirishni ko‘zlaydigan xulq-atvorni o‘qitish yondashuvidir.
Manba CPni operant conditioningdagi “punishment” va “inhibitory learning” farqiga o‘xshatadi.
Muallif modelida suppression yondashuvi nomaqbul xulq-atvor sodir bo‘lgach yoki yuzaga chiqa boshlagach uni jazolaydi. Ijobiy tushuncha o‘qitishi esa istalgan muqobil xulq-atvorning o‘zini osonroq kirish mumkin bo‘lgan reprezentatsiyaga aylantirishni maqsad qiladi.
CPda taqiq tushunchasi faqat “buni qilma” tarzida ta’riflanmaydi. Tushuncha nimani anglatishi va qaysi qarshi xulq-atvor faollashishi kerakligi ijobiy tarzda o‘qitiladi.
Tadqiqot Concept Programming RLHFdan Yaxshiroq Ekanini Isbotlaydimi?
Yo‘q. Manba tajribasida Concept Programming ishlab chiqarish miqyosidagi haqiqiy RLHF fine-tuning bilan taqqoslanmagan. Taqqoslangan ikkinchi shart manfiy ramkalangan prompting orqali yaratilgan va muallif “punishment-analog” deb atagan kichik ko‘lamli suppression analogidir; shu sababli natijani “CP ushbu punishment-analog pilot shartidan muvaffaqiyatliroq bo‘ldi” deb talqin qilish kerak.
Bu chegara manbada ochiq tan olinadi. Muallif full RLHF taqqoslashini va adversarial jailbreak testlarini kelajakda bajarilishi kerak bo‘lgan tajribalar qatorida sanaydi.
Shuning uchun quyidagi ikki jumla bir xil emas:
Manba qo‘llab-quvvatlaydi: “Ijobiy tushuncha o‘qitishi ushbu pilotda punishment-analog shartidan yuqoriroq aniqlik berdi.”
Manba qo‘llab-quvvatlamaydi: “Concept Programming umuman RLHFdan xavfsizroq va buni eksperimental ravishda isbotlagan.”
Tadqiqot Usuli va Natijalari
Tadqiqot tuzilishi
Ushbu 7 sahifalik ish tajribalarning to‘liq texnik hisoboti emas. Manba uch tajriba guruhining natijalarini umumlashtiradi va batafsil protokol, kod hamda qo‘shimcha natijalar uchun ikki companion maqolaga yo‘naltiradi.
Asosiy safety piloti:
- 3 milliard parametrli ochiq vaznli Llama 3.2 modeli,
- Ollama orqali mahalliy ishga tushirish,
- ijobiy concept training,
- punishment-analog prompting,
- o‘qitilmagan nazorat
bo‘lgan uchta shartni o‘z ichiga oladi.
Governance-safety pilot natijasi
| Shart | 36 governance-safety holatidagi aniqlik |
|---|---|
| Ijobiy Concept Programming | %94,4 |
| Punishment-analog | %77,8 |
| O‘qitilmagan nazorat | %47,2 |
Manba Fisher's exact test uchun p<0,0001 deb xabar qiladi.
Bu natija pilotning eng bevosita xulq-atvor dalilidir. Test to‘plamining barcha misollari va protseduraning to‘liq tafsilotlari esa ushbu xulosa maqolada yo‘q.
Yangi sohalarga transfer
Ijobiy tushuncha modeli uchta yangi operatsion sohada baholangan.
| Yangi soha | Manbada xabar qilingan natija |
|---|---|
| Kasalxona operatsiyalari | Soha-maxsus o‘qitishsiz aniqlik yo‘qotilishi xabar qilinmagan. |
| Ombor operatsiyalari | Soha-maxsus o‘qitishsiz aniqlik yo‘qotilishi xabar qilinmagan. |
| Qurilish maydoni xavfsizligi | Aniqlik %66,7 gacha tushgan. |
Muallif qurilish xavfsizligidagi pasayishni ko‘proq ixtisoslashgan va o‘zgaruvchan terminologiyaga mos natija sifatida talqin qiladi.
Biroq uch soha bo‘yicha faqat shu pilot doirasidagi natijalar mavjudligi sababli CP barcha yangi sohalarga yo‘qotishsiz transfer qiladi, degan xulosaga kelib bo‘lmaydi.
Ijtimoiy bosim ostida cheklovni saqlash
Manba prompt modelga ochiq yoki yashirin ijtimoiy bosim qilgan test holatlarini ayniqsa muhim deb hisoblaydi.
| Shart | Cheklovni saqlash |
|---|---|
| Ijobiy concept model | %92,6 |
| O‘qitilmagan nazorat | %44,4 |
Muallif bu farqni ijobiy tushuncha modelida bosimga qarshi tura oladigan ichki reprezentatsiya shakllanganiga dalil sifatida talqin qiladi.
Shunga qaramay, bu tajribada “ichki reprezentatsiya” manifold geometriyasini bevosita o‘lchash bilan ko‘rsatilmagan. O‘lchangan natija xulq-atvoriy cheklovga rioya qilishdir; ichki reprezentatsiya izohi nazariy talqin qatlamidir.
Ijobiy Tushuncha O‘qitishi Yangi Holatlarga Nega Ko‘chishi Mumkin?
Manba nazariyasiga ko‘ra, ijobiy tushuncha o‘qitishi alohida taqiq jumlalarini yodlatish o‘rniga tushunchaning kengroq ifoda maydonini qamrab oladigan tortuvchi havza yaratishni ko‘zlagani uchun, xuddi shu tushuncha boshqa so‘zlar yoki boshqa operatsion kontekstlarda paydo bo‘lganda tizim yana o‘sha xulq-atvor hududiga yo‘nalishi kutiladi. Bu transfer mexanizmi nazariy tushuntirishdir; pilotda ikki yangi sohada kuchli transfer kuzatilgan, uchinchi sohada esa sezilarli unumdorlik yo‘qotilishi yuzaga kelgan.
Ikkinchi tajriba: qiymat tushunchasini o‘qitish
Ikkinchi tajriba safety constraint o‘rniga madaniy qiymat tushunchasini baholaydi.
Bitta Buddist etik doirasiga mos keladigan nomlangan qiymat tushunchasi ssenariyga xos misollardan foydalanmasdan o‘qitilgan.
Model keyin beshta standart moral-psychology holatida baholangan:
- trolley ssenariysi,
- footbridge varianti,
- Heinz-tipidagi dilemma,
- yig‘layotgan chaqaloq ssenariysi,
- whistleblower holati.
Manba o‘qitilgan model besh holatning barchasidan o‘tganini va shu pilotda sinovdan o‘tgan boshqa an’analarning hech biri ssenariyga xos o‘qitishsiz xuddi shunday natijaga erishmaganini xabar qiladi.
Boshqa an’analarning batafsil ballari va to‘liq o‘qitish protokoli ushbu xulosa ishda berilmagan.
Uchinchi tajriba: o‘qitish xarajati
Uchinchi tajriba Concept Programming qancha o‘qitish misolidan keyin xavfsizlik xatolarini kamaytira boshlaganini governance-adapted signal detection doirasida baholaydi.
Ikki o‘qitish yondashuvi taqqoslangan:
| O‘qitish yondashuvi | Manbada ta’riflangan xususiyat |
|---|---|
| Keng namunalash | Tushunchaning tabiiy ifoda diapazonining kengroq qismidan misollar oladi. |
| Tor namunalash | Tushunchaning eng ko‘p ishlatiladigan ifodalariga e’tibor qaratadi. |
Har ikkala usul ham o‘qitilmagan nazoratdagi %100 miss rateni 200 o‘qitish holati ichida %25 dan pastga tushirgan.
Shunga qaramay, manbada oldindan belgilangan %95 stopping criterionga 200 holat budjeti ichida erishilmagani ochiq aytiladi.
Keng namunalash yondashuvi yuqoriroq correct-rejection rate bergan, tor namunalash esa yuqoriroq hit rate hosil qilgan.
Muallif bu qarama-qarshilikni turli o‘qitish namunalashlari turli attractor geometriyalarini hosil qiladi degan kutilma bilan mos deb hisoblaydi. Bu geometrik izoh manifoldning bevosita o‘lchovi emas, natijalarni nazariya doirasida talqin qilishdir.
Kitobdagi Ishonch Yorliqlari Nega Muhim?
Manbada xulosa qilingan kitob mustahkam empirik natija, qisman qo‘llab-quvvatlash, pilot tajriba natijasi va muallif kutishi kabi turli epistemik darajalarni bir xil qat’iylikda yozmaslik uchun olti ishonch yorlig‘idan foydalanadigan hisobot tizimini qabul qiladi. Bu yondashuv ayniqsa keng nazariy sintez bilan kichik ko‘lamli pilot natijalarni aralashtirib yubormaslikni ko‘zlaydi.
Manba misol sifatida quyidagi kategoriyalarni tushuntiradi:
| Yorliq | Ma’nosi |
|---|---|
| Established | Mustahkam empirik adabiyot qo‘llab-quvvatlagan natija. |
| Well supported | Haqiqiy, ammo hali to‘liq bo‘lmagan qo‘llab-quvvatlash. |
| Our experiments show | Muallifning o‘z tajribasidan olingan va namuna hajmi bilan birga berilishi kerak bo‘lgan natija. |
| I expect | Bilimga asoslangan, ammo eksperimental jihatdan mustahkamlanmagan kutish. |
| I suspect | Pastroq ishonch darajasidagi nazariy hukm. |
| What would change my mind | Da’voni falsifikatsiya qiladigan dalilning ochiq ko‘rsatilishi. |
Ushbu 7 sahifalik maqola bir xil yorliq tizimini har bir jumlada formal tarzda ishlatmasa ham, muallif pilot natija bilan kengroq nazariya o‘rtasidagi farqni matn davomida maxsus ta’kidlashga urinadi.
Bu Nazariyani Qaysi Topilmalar Falsifikatsiya Qilishi Mumkin?
Manba nazariyaning asosiy da’volarini falsifikatsiya qilinishi mumkin deb taqdim etadi. Xususan, kelajakdagi interpretability tadqiqotlari til modellaridagi tushunchalar past o‘lchamli attractor manifoldlar o‘rniga haqiqatan ham alohida, ramzga o‘xshash tuzilmalar va kombinator variable binding orqali qayta ishlanishini ko‘rsatsa, inson tushuncha o‘rganishi bilan til modeli geometriyasi bir xil mexanizm degan markaziy da’vo bevosita falsifikatsiya qilinadi.
Manbada keltirilgan asosiy sinov nuqtalari
Birinchi chegara tadqiqotning eng keng unification claimidir. Agar til modellarining tushuncha o‘rganishi kelajakda butunlay boshqa mexanizm bilan tushuntirilsa, nazariya faqat to‘liq emas, balki fundamental darajada noto‘g‘ri bo‘ladi.
Ikkinchi chegara framework ichidagi zaifroq qo‘llab-quvvatlangan da’vo: muayyan kognitiv darajalar o‘z qayta ishlash birligi boshiga taxminan doimiy tezlikda ishlaydi degan faraz. Manba bu ayrim nerv yo‘llarida o‘lchanganini, boshqalarida esa faraz qilinganini tan oladi.
Agar bir xil kognitiv daraja ichida qayta ishlash tezligi tizimli ravishda o‘zgarishi ko‘rsatilsa, bu da’vo bevosita zarar ko‘radi.
Uchinchi amaliy sinov Concept Programmingni haqiqiy RLHF va production-scale suppression usullari bilan bevosita taqqoslashdir.
To‘rtinchi sinov adversarial jailbreak qayta ifodalaridir. Manba CP ushbu hujumlarga suppression usullaridan ko‘ra chidamliroq bo‘lishi kerak deb bashorat qiladi, ammo tegishli test hali o‘tkazilmagan.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- 3B Llama 3.2 modelidagi pilotda ijobiy concept training punishment-analog va o‘qitilmagan nazorat shartlariga qaraganda yuqoriroq governance-safety aniqligini bergan.
- Manbada 36 holatli taqqoslash uchun %94,4, %77,8 va %47,2 aniqlik ko‘rsatkichlari xabar qilingan.
- Ijobiy concept model ikki yangi operatsion sohaga aniqlik yo‘qotmasdan ko‘chgan, uchinchi sohada %66,7 gacha tushgan.
- Ijtimoiy bosim bo‘lgan holatlarda ijobiy tushuncha sharti o‘qitilmagan nazoratga qaraganda yuqoriroq cheklovga rioya qilish ko‘rsatgan.
- Bitta Buddist etik qiymat tushunchasi pilotda beshta moral-psychology holatining barchasidan o‘tgan.
- Ikki CP o‘qitish strategiyasi 200 o‘qitish holati ichida miss rateni %100 dan %25 dan pastga tushirgan.
- Manba manifold va attractor geometriyasini Concept Programmingning nazariy tushuntirish doirasi sifatida ishlatadi.
Tadqiqot qo‘llab-quvvatlamaydigan natijalar
- Concept Programming ishlab chiqarish miqyosidagi RLHFdan ustun ekani bevosita ko‘rsatilmagan.
- Punishment-analog prompting va haqiqiy RLHF bir xil eksperimental shart emas.
- Frontier miqyosidagi modellarda ham xuddi shu natija yuzaga kelishi ko‘rsatilmagan.
- Adversarial jailbreak hujumlariga qarshi ustun chidamlilik hali sinovdan o‘tkazilmagan.
- Xulq-atvor aniqligining ortishi o‘z-o‘zicha model ichida o‘lchangan attractor manifold mavjudligini isbotlamaydi.
- Inson tushuncha o‘rganishi bilan til modeli reprezentatsiyalari biologik va hisoblash nuqtayi nazaridan aynan bir xil ekani ushbu maqolada bevosita ko‘rsatilmagan.
- Qurilish sohasidagi %66,7 natija barcha yangi sohalarga mukammal transfer yo‘qligini ko‘rsatadi.
- Beshta axloqiy ssenariydagi muvaffaqiyat keng madaniy qiymat mosligining universal tasdig‘i emas.
Asosiy metodologik cheklovlar
Barcha amaliy natijalar bitta 3 milliard parametrli modeldan olingan.
Manba hech qanday deployed frontier modelda tajriba xabar qilmaydi.
Punishment-analog sharti haqiqiy RLHF fine-tuning emas.
Jailbreak turidagi adversarial testlar o‘tkazilmagan.
Ushbu xulosa ish tajribalarning to‘liq protokolini o‘z ichiga olmaydi; tafsilotlar companion maqolalarga qoldirilgan.
Attractor geometriyasi tajribalarning xulq-atvor chiqishlaridan kelib chiqarilgan nazariy mexanizm sifatida talqin qilinadi va bu yerda bevosita aktivatsiya fazosi tahlili bilan tasdiqlanmaydi.
Manfaatlar to‘qnashuvini talqin qilish
Muallif Concept Programmingda ishlatiladigan concept-instillation arxitekturasi bilan bog‘liq patent arizalari mavjudligini bildiradi.
Bu holat natijalar avtomatik ravishda haqiqiy emas degani emas; biroq usulni baholashda mustaqil replikatsiya ayniqsa muhimligini ko‘rsatuvchi tegishli manfaat kontekstidir.
Manba va Usul Haqida Izoh
Asl sarlavha: Grooves in Neural Manifolds: A Summary of the Argument and the Experimental Evidence
Muallif: Frederick Roth
Manbada ko‘rsatilgan lavozim: Professor, Information Sciences, Naval Postgraduate School (Retired)
Manbada ko‘rsatilgan a’zolik: Fellow, Association for the Advancement of Artificial Intelligence
Manba turi: Nazariy/konseptual sintez va companion tajriba natijalarining xulosa maqolasi.
Birlamchi manba maqomi: Muallif ushbu maqola o‘z da’volarining birlamchi manbai emasligini ochiq aytadi.
Jurnal / jild / son: Yuklangan PDFda ko‘rsatilmagan.
Maqola DOI: Yuklangan PDFda ko‘rsatilmagan.
Taqriz holati: Yuklangan PDF ichida taqrizlangan nashr ekanini tasdiqlovchi ma’lumot yo‘q; taqrizlangan yakuniy maqola sifatida taqdim etilmasligi kerak.
Markaziy nazariy da’vo: Inson tushuncha o‘rganishi va o‘rgatilgan til modellaridagi konseptual geometriya mustahkamlash orqali shakllangan past o‘lchamli attractor tuzilmaning ikki xil miqyosdagi ko‘rinishi degan gipoteza.
Markaziy amaliy usul: Concept Programming (CP).
Pilot model: Llama 3.2, 3 milliard parametr, mahalliy Ollama ishga tushirilishi.
Governance-safety testi: 36 holat.
Asosiy pilot natija: Ijobiy concept training %94,4; punishment-analog %77,8; o‘qitilmagan nazorat %47,2; Fisher's exact test p<0,0001.
Transfer: Kasalxona va ombor operatsiyalarida manba aniqlik yo‘qotilishini xabar qilmaydi; qurilish maydoni xavfsizligida %66,7.
Ijtimoiy bosim testi: Ijobiy concept model %92,6; o‘qitilmagan nazorat %44,4 cheklovni saqlash.
Qiymat tushunchasi tajribasi: Bitta Buddist etik qiymat tushunchasi bilan beshta moral-psychology ssenariysining barchasidan o‘tilgan.
O‘qitish xarajati tajribasi: Ikkala o‘qitish usuli ham 200 holat ichida miss rateni %100 dan %25 dan pastga tushirgan, ammo oldindan belgilangan %95 stopping criterionga erishmagan.
Kitob: Grooves in Neural Manifolds: AI Reveals Why You Think What You Think, and How to Reshape It.
Kitob DOI: 10.5281/zenodo.21966428.
Texnik companion ish 1: Concept Programming for Dependable AI.
Texnik companion ish 2: Neural manifolds, assemblies, and cross-domain interference.
Kod: Manba companion tajribalar kodi github.com/ricodoco/safety-concept-experiment manzilida ommaga ochiq ekanini bildiradi.
Manfaatlar to‘qnashuvi: Muallif concept-instillation arxitekturasiga oid patent arizalari borligini bildiradi.
Moliyalashtirish: Ushbu xulosa PDFda alohida moliyalashtirish bayonoti yo‘q.
Ma’lumotlar mavjudligi: Ushbu xulosa PDFda alohida ma’lumotlar mavjudligi bo‘limi yo‘q; tajriba protokollari va kod uchun companion ishlarga yo‘naltirish berilgan.
Asosiy ilmiy talqin chegarasi: Pilotning xulq-atvor unumdorligi natijalari bevosita xabar qilingan; inson kognitsiyasi bilan til modeli geometriyasi bir xil mexanizm degan da’vo va unumdorlik attractor geometriyasidan kelib chiqadi degan izoh nazariy frameworkning bir qismidir. Shuningdek, punishment-analog sharti haqiqiy RLHF bo‘lmagani sababli pilot natijasi RLHFga bevosita ustunlik sifatida taqdim etilmasligi kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan