

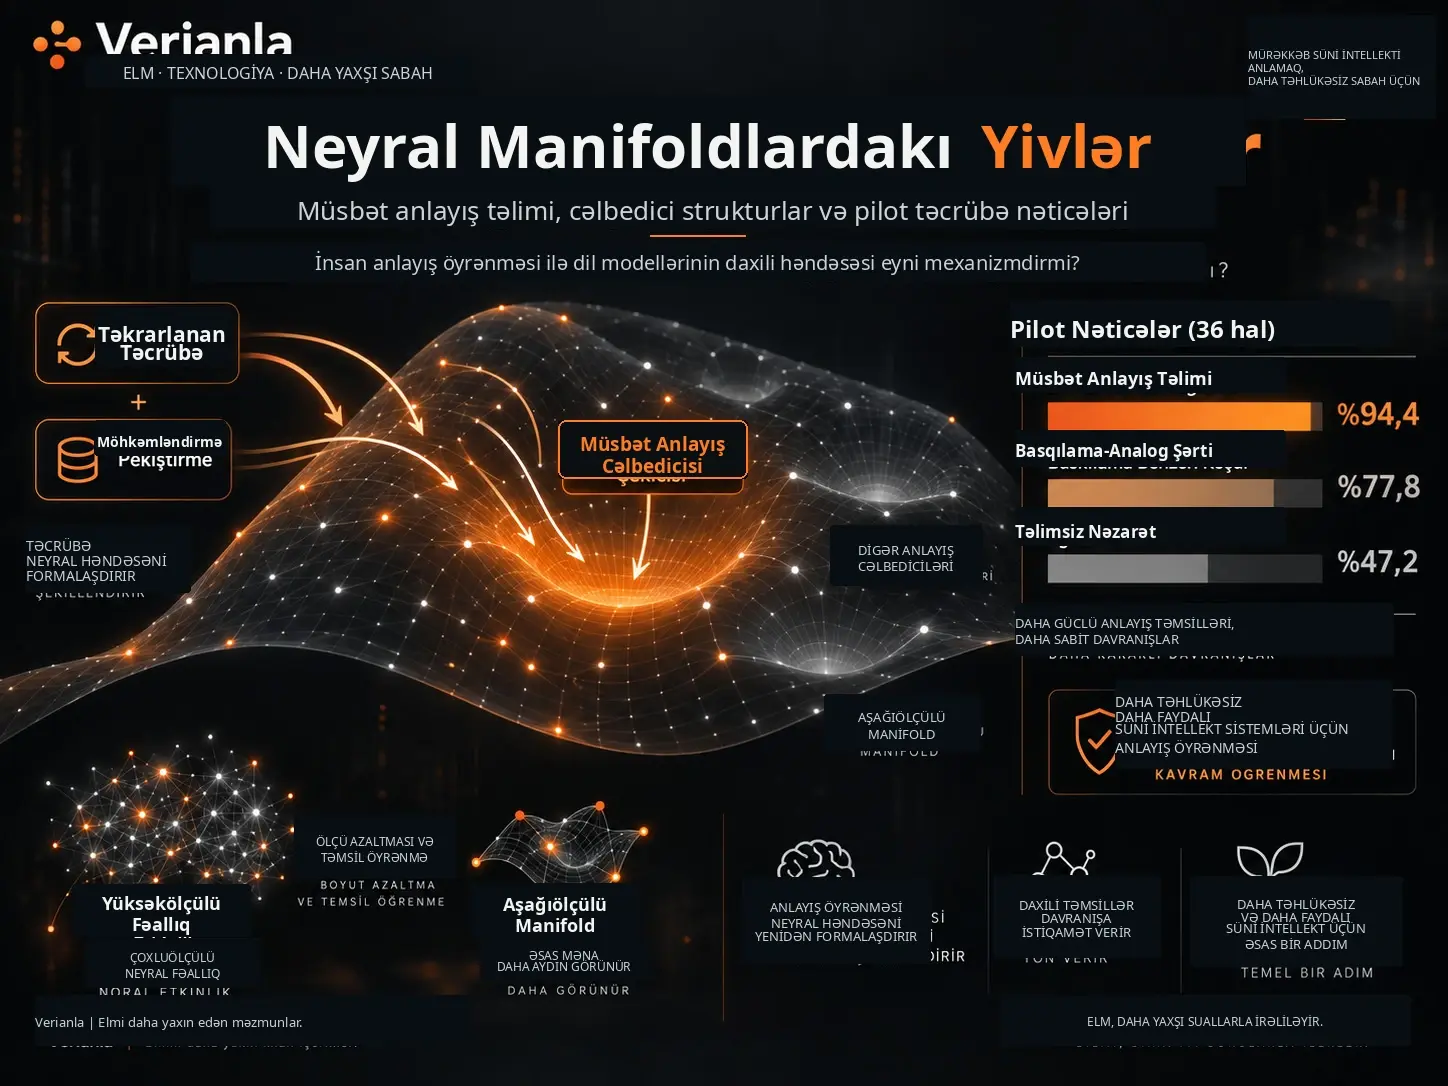
Neyral manifold, çoxsaylı neyronların və ya süni şəbəkə vahidlərinin yüksəkölçülü fəaliyyət məkanında yaratdığı davranışın daha aşağıölçülü həndəsi səth üzərində təşkil olunduğunu ifadə edən təmsil yanaşmasıdır. Frederick Roth-un işi insanlarda anlayış öyrənməsi ilə öyrədilmiş dil modellərindəki konseptual təmsillərin iki ayrı mexanizm deyil, möhkəmləndirmə ilə formalaşan aşağıölçülü cəlbedici strukturun iki miqyasda görünüşü olduğu hipotezini müdafiə edir. Bu çərçivədə anlayışlar ayrı-ayrı simvolik təriflər şəklində saxlanmaq əvəzinə, oxşar təcrübələrin təkrar-təkrar aktivləşdirdiyi və sistem vəziyyətinin geri qayıtmağa meyl göstərdiyi sıx həndəsi bölgələr kimi nəzərdən keçirilir. Məqalə bu yanaşmanın süni intellekt təhlükəsizliyi üçün birbaşa nəticəsi olduğunu irəli sürür: arzuolunmaz davranışları yalnız boğmaq əvəzinə, arzu olunan davranışın özünü pozitiv, adlandırılmış konseptual cəlbedici kimi öyrətmək. Müəllif bu üsulu Concept Programming (CP) adlandırır. 3 milyard parametrli Llama 3.2 üzərində bildirilən pilotda CP 36 governance-safety halında %94,4 dəqiqlik əldə etdiyi halda, mənfi çərçivəli punishment-analog şərti %77,8, təlimsiz nəzarət isə %47,2 dəqiqlik göstərmişdir. Bununla belə, punishment-analog şərti real istehsal miqyaslı RLHF deyil; iş CP-nin RLHF-ni birbaşa eksperimental olaraq üstələdiyini göstərmir. Həmçinin bildirilən davranış nəticələri manifold həndəsəsinin birbaşa ölçümü deyil. Buna görə də işin əsas insan–AI mexanizm eyniliyi hipotezi maraqlı və yanlışlana biləndir, lakin hələ yerləşmiş elmi nəticə deyil.
Məqalə öz əhatə dairəsini xüsusi olaraq məhdud müəyyənləşdirir. Müəllif bu mətnin kitabın və iki texniki companion işin qısa xülasəsi olduğunu və burada verilən iddiaların ilkin mənbəyinin bu 7 səhifəlik məqalə olmadığını açıq bildirir. Tam eksperiment protokolları, əlavə nəticələr və kod başqa işlərə buraxılmışdır.
Bu fərq vacibdir; çünki iş bir tərəfdən koqnitiv elm, Hebb tipli hüceyrə assambleyaları, kateqoriya öyrənməsi və attractor şəbəkələrini vahid həndəsi təsvir altında birləşdirir, digər tərəfdən isə kiçikmiqyaslı pilot eksperimentlərdən süni intellekt uyğunlaşdırma arxitekturası üçün daha geniş nəzəri nəticələr çıxarır. Verianla baxımından düzgün yanaşma bu nəticələri “sübut edilmiş ümumi süni intellekt təhlükəsizliyi qanunu” kimi deyil, açıq eksperimental sərhədləri olan tədqiqat proqramının ilkin sübutları kimi təqdim etməkdir.
Neyral Manifold Nədir?
Neyral manifold çox yüksəkölçülü neyron fəaliyyət məkanındakı sistem vəziyyətlərinin əslində daha aşağıölçülü nizamlı səth üzərində cəmlənməsi ideyasıdır; bu yanaşmada təmsil olunan informasiya ayrı-ayrı neyronların sabit mənalarında deyil, sistem fəaliyyətinin həmin həndəsi səth üzərindəki mövqeyi və hərəkətində kodlanır.
Sinir şəbəkəsi milyonlarla və ya milyardlarla ayrıca parametrə malik ola bilər. Buna baxmayaraq, müəyyən tapşırıq zamanı yaranan fəaliyyət nümunələrinin bütün mümkün yüksəkölçülü vəziyyət məkanından istifadə etməsi vacib deyil. Aktivləşmələr müəyyən istiqamətlərdə cəmlənirsə, sistem davranışı aşağıölçülü həndəsi struktur üzərində izah oluna bilər.
Mənbənin konseptual yanaşmasında kateqoriyaya üzvlük də bu həndəsi struktur vasitəsilə anlaşılır. Nümunə müəyyən kateqoriyanın mütləq “içində” və ya “xaricində” olmalı deyil; manifold üzərindəki mövqeyi kateqoriya bölgəsinə müxtəlif dərəcələrdə yaxın ola bilər. Beləliklə, tipik və atipik kateqoriya üzvlərinin fərqli sürət və ya əminliklə tanınması kimi dərəcəli davranışların izah edilə biləcəyi irəli sürülür.
Kateqoriyaya üzvlük niyə dərəcəlidir?
Mənbə Eleanor Rosch-un kateqoriya tədqiqatlarına əsaslanaraq gündəlik anlayışların çoxunda üzvlüyün tam ikili olmadığını vurğulayır. Bəzi nümunələr kateqoriyaya daha tipik görünərkən, bəziləri sərhəddə qala bilər. Manifold yanaşmasında bunun səbəbi anlayışın sərt simvolik şərtlər siyahısı deyil, həndəsi bölgə kimi götürülməsidir.
Wittgenstein-in “ailə oxşarlığı” yanaşması da bu kontekstə yerləşdirilir. Kateqoriyadakı bütün nümunələrin bölüşməli olduğu tək bir ortaq xüsusiyyət olmaya bilər; kateqoriya birliyini təmin edən şey nümunələrin xüsusiyyətlərinin üst-üstə düşərək yaratdığı regional struktur ola bilər.
Cəlbedici Struktur Nədir və Anlayış Öyrənməsi ilə Necə Əlaqələndirilir?
Cəlbedici struktur (attractor), sistem fəaliyyətinin müəyyən bölgəyə yönəlməsi və kiçik sapmalardan sonra yenidən eyni bölgəyə qayıtmağa meylini ifadə edir. Mənbə öyrənilmiş anlayışların tək sabit neyron dövrəsindən daha çox, sərhədləri dərəcəli olan sabit və sıx manifold bölgələri kimi düşünülə biləcəyini irəli sürür.
Donald Hebb-in hüceyrə assambleyası anlayışı bu təsvirə tarixi əsas kimi daxil edilir. Hebb birlikdə təkrar-təkrar aktivləşən hüceyrə qruplarının zamanla birlikdə işləyə bilən funksional vahid yarada biləcəyini irəli sürmüşdür.
Roth bu fikri həndəsi dillə yenidən şərh edir: hüceyrə assambleyası müəyyən üzvlərdən ibarət dəyişməz siyahı olmaq əvəzinə, fəaliyyətin təkrar-təkrar cəmləndiyi manifold bölgəsi kimi düşünülə bilər.
Bu modeldə möhkəmləndirmə yalnız müəyyən çıxışı mükafatlandıran hadisə deyil. Təkrarlanan fəaliyyətin sistemin vəziyyət məkanında müəyyən yolları və bölgələri daha asan əlçatan etdiyi həndəsi formalaşma mexanizmi kimi şərh olunur.
“Groove”, yəni yiv bənzətməsi nə deməkdir?
İşin və kitabın başlığındakı “groove” sözü bu təkrarlı istifadə fikrini ifadə edir. Davranış və ya konseptual nümunə təkrar-təkrar aktivləşdikcə sistemin eyni fəaliyyət bölgəsinə yenidən çatması daha asan olur.
Bu, fiziki yivin mövcud olduğu demək deyil. Mənbənin istifadə etdiyi həndəsi metafor öyrənilmiş davranışların yüksəkölçülü fəaliyyət məkanında üstün tutulan yollar və ya sabit bölgələr kimi təmsil oluna biləcəyi fərziyyəsini izah edir.
Anlayış niyə tək manifoldla məhdud sayılmır?
Mənbə qavrayış və ya motor bacarığın tək bir təmsil sahəsində nəzərdən keçirilə biləcəyini; daha geniş anlayışların isə fərqli modalitələri birləşdirməli olduğunu müdafiə edir. Məsələn, “it” anlayışı vizual forma, səs, hərəkət və başqa təcrübə növlərini eyni konseptual struktur daxilində əlaqələndirir.
Bu halda ayrı təcrübə sahələrinin ortaq strukturunun necə birləşdirildiyi sualı ortaya çıxır. Roth burada Hayes-Roth və McDermott-un 1978-ci il tarixli interference matching yanaşmasından istifadə edir.
Interference Matching Nədir?
Interference matching, bir anlayışa aid bir neçə nümunənin aktivləşdirdiyi xüsusiyyət strukturlarını üst-üstə gətirərək bu nümunələr arasında təkrarlanan ortaq strukturun ayrılması yanaşmasıdır; mənbə bunu fərqli təcrübələrdən daha ümumi konseptual abstraksiya yaratma mexanizmi kimi nəzərdən keçirir.
Mənbənin ifadəsi ilə proses hər nümunənin aktivləşdirdiyi element çoxluqlarının kəsişməsini hesablamağa formal olaraq bənzədilə bilər. Tək nümunədə təsadüfi və ya kontekstə xas xüsusiyyətlər təkrarlar arasında itərkən, ortaq xüsusiyyət kombinasiyaları güclənir.
Roth bu yanaşmanı simvolik sxem və ya tək prototip saxlamaq əvəzinə, birlikdə meydana çıxan xüsusiyyət kombinasiyalarına dair dərəcəli yaddaşın yaranması kimi şərh edir.
Yeni informasiya strukturu istifadə zamanı necə dəyişir?
Mənbə Barbara Hayes-Roth-un 1977-ci il işində bildirilən üçmərhələli transfer əyrisini ayrıca qeyd edir:
- Başlanğıc asanlaşdırması: yeni yaranan informasiya strukturu müəyyən tapşırıqlarda ilkin üstünlük yaradır.
- Recovery mərhələsi: ortaq alt komponentlərin konsolidasiya zamanı bir-biri ilə rəqabət etdiyi dövr yaranır.
- Asimptotik mərhələ: informasiya strukturu daha sabit olur.
Müəllif bu üçmərhələli tapıntının Barbara Hayes-Roth-a aid olduğunu xüsusi olaraq ayırır; property-set modelinin isə Frederick Hayes-Roth-un 1974-cü il işindən başlayıb daha sonra birlikdə inkişaf etdirilmiş fərqli tarixçəyə malik olduğunu bildirir.
Simvolik Bağlama Problemi Nədir?
Simvolik bağlama problemi simvolik sistemin abstrakt dəyişənlərdəki rolların səhnədəki real obyektlərə necə təyin ediləcəyini müəyyən etməli olduğu zaman yaranan kombinator uyğunlaşdırma problemidir. Mənbə manifold təmsillərinin bu problemi daha sürətli “həll etdiyini” deyil, dəyişən–dəyər bağlaması tələb edən təmsil formasını əvvəldən istifadə etməməklə problemin özünü aradan qaldırdığını müdafiə edir.
Simvolik sistem, məsələn, əlaqəni belə təmsil edə bilər:
above(block-A, block-B)
Ümumi qayda fərqli obyektlərə tətbiq ediləcəksə, sistem hansı obyektin hansı dəyişən rolunu doldurduğunu müəyyən etməlidir. Obyekt və əlaqə sayı artdıqca mümkün uyğunlaşdırmaların sayı arta bilər.
Mənbə bu problemi Hayes-Roth və McDermott-un 1978-ci ildə struktur nümunə öyrənməsi baxımından müəyyən etdikləri əsas praktik maneələrdən biri kimi təqdim edir.
Manifold Yanaşması Bağlama Problemini Necə “Aradan Qaldırır”?
Roth-un təklifində əlaqələr adlandırılmış dəyişənlərə obyekt təyin etməklə deyil, manifoldlar arasındakı nisbi mövqe, məsafə və ya ortaq fəaliyyət nümunəsi ilə təmsil edilə bilər; beləliklə dəyişən–dəyər bağlaması axtarışına ehtiyac qalmır və tanıma prosesi öyrənilmiş cəlbedici struktura qarşı nümunə tamamlama problemi kimi yenidən müəyyənləşdirilir.
Bu mühüm nəzəri fərqdir. Məqalə “NP-çətin bağlama problemini daha sürətli həll edən yeni alqoritm” təklif etmir. Əvəzində həmin problem sinfini yaradan simvolik təmsil fərziyyəsinin gərəksiz ola biləcəyini irəli sürür.
Lakin bu nəticə işdə böyük dil modellərinin daxili aktivləşmələrindən çıxarılan geniş bağlama eksperimenti ilə göstərilmir. Mənbə burada nəzəri təmsil arqumenti qurur.
İnsan Anlayış Öyrənməsi ilə Dil Modellərinin Daxili Həndəsəsi Eyni Mexanizmdirmi?
Bu məqalənin əsas tezisi “bəli” istiqamətindədir, lakin mənbə bunu yerləşmiş elmi fakt kimi deyil, yanlışlana bilən birləşdirici iddia kimi inkişaf etdirir. İnsan anlayış öyrənməsinin davranış ədəbiyyatı ilə süni neyron şəbəkələrindəki aşağıölçülü təmsil həndəsəsinin eyni əsas cəlbedici mexanizmi əks etdirdiyi irəli sürülür; bu mexanizmlərin bioloji və süni sistemlərdə həqiqətən eyni olduğunu birbaşa göstərən ortaq eksperiment isə bu məqalədə yoxdur.
Buna görə iki fərqli sübut səviyyəsi bir-birindən ayrılmalıdır.
| İddia | Bu məqalədəki statusu |
|---|---|
| Anlayışa üzvlük dərəcəli ola bilər. | Əvvəlki koqnitiv elm ədəbiyyatına əsaslanan fon məlumatı. |
| Sinir şəbəkələrində aşağıölçülü təmsil strukturları yarana bilər. | Məqalənin istinad etdiyi müasir interpretability ədəbiyyatına əsaslanan fon məlumatı. |
| İnsan anlayış öyrənməsi və dil modeli anlayış həndəsəsi eyni mexanizmdir. | Müəllifin birləşdirici nəzəri hipotezi. |
| Bu mexanizm attractor-based Concept Programming-i mümkün edir. | Nəzəriyyədən çıxarılan tətbiq edilə bilən tədqiqat hipotezi. |
| Pilot CP təlimi müəyyən safety testlərində daha yüksək dəqiqlik verdi. | Mənbədə bildirilən davranış eksperimentinin nəticəsi. |
Concept Programming Nədir?
Concept Programming (CP), süni intellekt sistemində arzuolunmaz çıxışı yalnız cəzalandırmaq və ya filtrləmək əvəzinə, arzu olunan davranış anlayışını adlandırılmış pozitiv cəlbedici kimi öyrədib lazım olduqda arzuolunmaz alternativin ortaya çıxmasına mane olacaq cavab nümunəsi ilə uyğunlaşdırmağı hədəfləyən davranış təlimi yanaşmasıdır.
Mənbə CP-ni operant conditioning-dəki “punishment” ilə “inhibitory learning” fərqinə bənzədir.
Müəllifin modelində suppression yanaşması arzuolunmaz davranışı baş verdikdən və ya ortaya çıxmağa başladıqdan sonra cəzalandırır. Pozitiv anlayış təlimi isə arzu olunan alternativ davranışın özünü daha əlçatan təmsilə çevirməyi hədəfləyir.
CP-də qadağa anlayışı yalnız “bunu etmə” formasında müəyyən edilmir. Anlayışın nəyi təmsil etdiyi və hansı əks davranışın aktivləşməli olduğu pozitiv şəkildə öyrədilir.
İş Concept Programming-in RLHF-dən Daha Yaxşı Olduğunu Sübut Edirmi?
Xeyr. Mənbənin eksperimentində Concept Programming istehsal miqyasında real RLHF fine-tuning ilə müqayisə edilməmişdir. Müqayisə edilən ikinci şərt mənfi çərçivəli prompting istifadə edilərək yaradılan və müəllifin “punishment-analog” adlandırdığı kiçikmiqyaslı suppression analoqudur; buna görə nəticə “CP bu punishment-analog pilot şərtindən daha uğurlu idi” şəklində oxunmalıdır.
Bu sərhəd mənbədə açıq şəkildə qəbul edilir. Müəllif full RLHF müqayisəsini və adversarial jailbreak testlərini gələcəkdə aparılmalı eksperimentlər sırasında göstərir.
Buna görə aşağıdakı iki cümlə ekvivalent deyil:
Mənbənin dəstəklədiyi: “Pozitiv anlayış təlimi bu pilotda punishment-analog şərtindən daha yüksək dəqiqlik verdi.”
Mənbənin dəstəkləmədiyi: “Concept Programming ümumilikdə RLHF-dən daha təhlükəsizdir və bunu eksperimental olaraq sübut edib.”
İşin Metodu və Nəticələri
Tədqiqatın quruluşu
Bu 7 səhifəlik iş eksperimentlərin tam texniki hesabatı deyil. Mənbə üç eksperiment qrupunun nəticələrini xülasə edir və ətraflı protokol, kod və əlavə nəticələr üçün iki companion məqaləyə yönləndirir.
Əsas safety pilotu:
- 3 milyard parametrli açıq çəkili Llama 3.2 modeli,
- Ollama vasitəsilə lokal işə salma,
- pozitiv concept training,
- punishment-analog prompting,
- təlimsiz nəzarət
olmaqla üç şərti əhatə edir.
Governance-safety pilot nəticəsi
| Şərt | 36 governance-safety halında dəqiqlik |
|---|---|
| Pozitiv Concept Programming | %94,4 |
| Punishment-analog | %77,8 |
| Təlimsiz nəzarət | %47,2 |
Mənbə Fisher's exact test üçün p<0,0001 bildirir.
Bu nəticə pilotun ən birbaşa davranış sübutudur. Test dəstinin bütün nümunələri və prosedurun tam detalları isə bu xülasə məqalədə yoxdur.
Yeni sahələrə transfer
Pozitiv anlayış modeli üç yeni əməliyyat sahəsində qiymətləndirilmişdir.
| Yeni sahə | Mənbədə bildirilən nəticə |
|---|---|
| Xəstəxana əməliyyatları | Sahəyə xüsusi təlim almadan dəqiqlik itkisi bildirilməmişdir. |
| Anbar əməliyyatları | Sahəyə xüsusi təlim almadan dəqiqlik itkisi bildirilməmişdir. |
| İnşaat sahəsi təhlükəsizliyi | Dəqiqlik %66,7-yə düşmüşdür. |
Müəllif tikinti təhlükəsizliyindəki azalmanı daha ixtisaslaşmış və dəyişkən terminologiya ilə uyğun nəticə kimi şərh edir.
Lakin üç sahə üzrə yalnız bu pilot çərçivəsində nəticələr olduğuna görə CP-nin bütün yeni sahələrə itkisiz transfer etdiyi qənaətinə gəlmək olmaz.
Sosial təzyiq altında məhdudiyyətin qorunması
Mənbə prompt-un modelə açıq və ya örtülü sosial təzyiq göstərdiyi test hallarını xüsusilə vacib sayır.
| Şərt | Məhdudiyyətin qorunması |
|---|---|
| Pozitiv concept model | %92,6 |
| Təlimsiz nəzarət | %44,4 |
Müəllif bu fərqi pozitiv anlayış modelində təzyiqə müqavimət göstərə bilən daxili təmsilin formalaşmasına dəstək kimi şərh edir.
Bununla belə, bu eksperimentdə “daxili təmsil” birbaşa manifold həndəsəsinin ölçülməsi ilə göstərilməmişdir. Ölçülən nəticə davranışsal məhdudiyyətə uyğunluqdur; daxili təmsil izahı nəzəri şərh qatıdır.
Pozitiv Anlayış Təlimi Yeni Vəziyyətlərə Niyə Transfer Oluna Bilər?
Mənbənin nəzəriyyəsinə görə pozitiv anlayış təlimi ayrı-ayrı qadağa cümlələrini əzbərlətmək əvəzinə anlayışın daha geniş ifadə sahəsini əhatə edən cəlbedici hövzə yaratmağı hədəflədiyi üçün, eyni anlayış fərqli sözlər və ya fərqli əməliyyat kontekstləri ilə ortaya çıxdıqda sistemin yenidən eyni davranış bölgəsinə yönəlməsi gözlənilir. Bu transfer mexanizmi nəzəri izahdır; pilotda iki yeni sahədə güclü transfer müşahidə edilmiş, üçüncü sahədə isə nəzərəçarpan performans itkisi yaranmışdır.
İkinci eksperiment: dəyər anlayışının təlimi
İkinci eksperiment safety constraint əvəzinə mədəni dəyər anlayışını qiymətləndirir.
Tək bir Buddist etik çərçivəsinə uyğun adlandırılmış dəyər anlayışı ssenariyə xüsusi nümunələr istifadə edilmədən öyrədilmişdir.
Model daha sonra beş standart moral-psychology halında qiymətləndirilmişdir:
- trolley ssenarisi,
- footbridge variantı,
- Heinz-tipli dilemma,
- ağlayan körpə ssenarisi,
- whistleblower halı.
Mənbə öyrədilmiş modelin beş halın hamısından keçdiyini və eyni pilotda sınaqdan keçirilən digər ənənələrin heç birinin ssenariyə xüsusi təlim olmadan eyni nəticəni əldə etmədiyini bildirir.
Digər ənənələrin ətraflı balları və tam təlim protokolu bu xülasə işdə verilmir.
Üçüncü eksperiment: təlim xərci
Üçüncü eksperiment Concept Programming-in neçə təlim nümunəsində təhlükəsizlik səhvlərini azaltmağa başladığını governance-adapted signal detection çərçivəsi ilə qiymətləndirir.
İki təlim yanaşması müqayisə edilmişdir:
| Təlim yanaşması | Mənbədə müəyyən edilən xüsusiyyət |
|---|---|
| Geniş nümunələmə | Anlayışın təbii ifadə diapazonunun daha geniş hissəsindən nümunələr istifadə edir. |
| Dar nümunələmə | Anlayışın ən çox istifadə olunan ifadələrinə fokuslanır. |
Hər iki üsul da təlimsiz nəzarətdəki %100 miss rate-i 200 təlim halı ərzində %25-dən aşağı endirmişdir.
Bununla belə, mənbədə əvvəlcədən müəyyən edilmiş %95 stopping criterion-a 200 hal büdcəsi daxilində çatılmadığı açıq şəkildə bildirilir.
Geniş nümunələmə yanaşması daha yüksək correct-rejection rate verərkən, dar nümunələmə daha yüksək hit rate yaratmışdır.
Müəllif bu ziddiyyəti fərqli təlim nümunələmələrinin fərqli attractor həndəsələri yaradacağı gözləntisi ilə uyğun sayır. Bu həndəsi izah birbaşa manifold ölçümü deyil, nəticələrin nəzəriyyə çərçivəsində şərhidir.
Kitabın Güvən Etiketləri Niyə Vacibdir?
Mənbədə xülasə edilən kitab yerləşmiş empirik nəticə, qismən dəstək, pilot eksperiment nəticəsi və müəllif gözləntisi kimi fərqli epistemik səviyyələri eyni dəqiqliklə yazmamaq məqsədilə altı güvən etiketi istifadə edən hesabat sistemi qəbul edir. Bu yanaşma xüsusilə geniş nəzəri sintezlə kiçikmiqyaslı pilot nəticələrin qarışdırılmasının qarşısını almağı hədəfləyir.
Mənbə nümunə kimi aşağıdakı kateqoriyaları izah edir:
| Etiket | Mənası |
|---|---|
| Established | Yerləşmiş empirik ədəbiyyat tərəfindən dəstəklənən nəticə. |
| Well supported | Həqiqi, lakin hələ tam olmayan dəstək. |
| Our experiments show | Müəllifin öz eksperimentindən gələn və nümunə ölçüsü ilə birlikdə verilməli nəticə. |
| I expect | Biliklərə əsaslanan, lakin eksperimental olaraq yerləşməmiş gözlənti. |
| I suspect | Daha aşağı güvən səviyyəsində nəzəri mühakimə. |
| What would change my mind | İddianın yanlışlanmasına səbəb olacaq sübutun açıq şəkildə göstərilməsi. |
Bu 7 səhifəlik məqalə eyni etiket sistemini formal olaraq hər cümlədə istifadə etməsə də, müəllif pilot nəticə ilə daha geniş nəzəriyyə arasındakı fərqi mətn boyunca xüsusi olaraq göstərməyə çalışır.
Bu Nəzəriyyəni Hansı Tapıntılar Yanlışlaya Bilər?
Mənbə nəzəriyyənin əsas iddialarını yanlışlana bilən kimi təqdim edir. Xüsusən gələcək interpretability tədqiqatları dil modellərindəki anlayışların aşağıölçülü attractor manifoldları əvəzinə həqiqətən ayrıq, simvolabənzər strukturlar və kombinator variable binding vasitəsilə işlənildiyini göstərsə, insan anlayış öyrənməsi ilə dil modeli həndəsəsinin eyni mexanizm olduğu mərkəzi iddia birbaşa yanlışlanmış olacaq.
Mənbədə göstərilən əsas sınaq nöqtələri
Birinci sərhəd işin ən geniş unification claim-idir. Dil modellərinin anlayış öyrənməsi gələcəkdə tamamilə fərqli mexanizmlə izah edilərsə, nəzəriyyə yalnız natamam deyil, əsas səviyyədə yanlış olacaq.
İkinci sərhəd framework daxilində daha zəif dəstəklənən iddiadır: müəyyən koqnitiv səviyyələrin öz emal vahidi başına təxminən sabit sürətlə işlədiyi fərziyyəsi. Mənbə bəzi sinir yollarında bunun ölçüldüyünü, digərlərində isə fərz edildiyini qəbul edir.
Eyni koqnitiv səviyyə daxilində emal sürətinin sistematik şəkildə dəyişdiyi göstərilərsə, bu iddia birbaşa zərər görəcək.
Üçüncü praktik sınaq Concept Programming-in real RLHF və production-scale suppression üsulları ilə birbaşa müqayisəsidir.
Dördüncü sınaq adversarial jailbreak yenidən ifadələridir. Mənbə CP-nin bu hücumlara suppression üsullarından daha davamlı olmalı olduğunu proqnozlaşdırır, lakin müvafiq test hələ aparılmayıb.
İşin dəstəklədiyi nəticələr
- 3B Llama 3.2 modelindəki pilotda pozitiv concept training punishment-analog və təlimsiz nəzarət şərtlərindən daha yüksək governance-safety dəqiqliyi vermişdir.
- Mənbədə 36 hal üzrə müqayisə üçün %94,4, %77,8 və %47,2 dəqiqlik nisbətləri bildirilmişdir.
- Pozitiv concept model iki yeni əməliyyat sahəsinə dəqiqlik itkisi olmadan transfer edilmiş, üçüncü sahədə %66,7-yə düşmüşdür.
- Sosial təzyiq ehtiva edən hallarda pozitiv anlayış şərti təlimsiz nəzarətdən daha yüksək məhdudiyyət uyğunluğu göstərmişdir.
- Bir Buddist etik dəyər anlayışı pilotda beş moral-psychology halının hamısından keçmişdir.
- İki CP təlim strategiyası 200 təlim halı ərzində miss rate-i %100-dən %25-in altına endirmişdir.
- Mənbə manifold və attractor həndəsəsini Concept Programming-in nəzəri izah çərçivəsi kimi istifadə edir.
İşin dəstəkləmədiyi nəticələr
- Concept Programming-in istehsal miqyaslı RLHF-dən üstün olduğu birbaşa göstərilməmişdir.
- Punishment-analog prompting ilə real RLHF eyni eksperimental şərt deyil.
- Frontier miqyaslı modellərdə eyni nəticənin ortaya çıxacağı göstərilməmişdir.
- Adversarial jailbreak hücumlarına qarşı üstün davamlılıq hələ sınaqdan keçirilməmişdir.
- Davranış dəqiqliyinin artması təkbaşına model daxilində ölçülmüş attractor manifoldunun varlığını sübut etmir.
- İnsan anlayış öyrənməsi ilə dil modeli təmsillərinin bioloji və hesablama baxımından eyni olduğu bu məqalədə birbaşa göstərilməmişdir.
- İnşaat sahəsindəki %66,7 nəticəsi bütün yeni sahələrə qüsursuz transfer olmadığını göstərir.
- Beş moral ssenaridəki uğur geniş mədəni dəyər uyğunluğunun universal təsdiqi deyil.
Əsas metodoloji məhdudiyyətlər
Bütün tətbiqi nəticələr tək bir 3 milyard parametrli modeldən gəlir.
Mənbə heç bir deployed frontier modeldə eksperiment bildirmir.
Punishment-analog şərti real RLHF fine-tuning deyil.
Jailbreak tipli adversarial testlər aparılmayıb.
Bu xülasə iş eksperimentlərin tam protokolunu ehtiva etmir; detallar companion məqalələrə buraxılıb.
Attractor həndəsəsi eksperimentlərin davranış nəticələrindən çıxarılan nəzəri mexanizm kimi şərh olunur, burada birbaşa aktivasiya məkanı analizi ilə təsdiqlənmir.
Maraqlar toqquşmasının şərhi
Müəllif Concept Programming-də istifadə olunan concept-instillation arxitekturası ilə bağlı patent müraciətlərinin olduğunu bəyan edir.
Bu vəziyyət nəticələrin avtomatik etibarsız olduğu demək deyil; lakin metodun qiymətləndirilməsində müstəqil replikasiyanın xüsusilə vacib olduğunu göstərən aidiyyəti maraq kontekstidir.
Mənbə və Metod Qeydi
Özgün başlıq: Grooves in Neural Manifolds: A Summary of the Argument and the Experimental Evidence
Müəllif: Frederick Roth
Mənbədə göstərilən vəzifə: Professor, Information Sciences, Naval Postgraduate School (Retired)
Mənbədə göstərilən üzvlük: Fellow, Association for the Advancement of Artificial Intelligence
Mənbə növü: Nəzəri/konseptual sintez və companion eksperiment nəticələrinin xülasə məqaləsi.
İlkin mənbə statusu: Müəllif bu məqalənin öz iddialarının ilkin mənbəyi olmadığını açıq şəkildə bildirir.
Jurnal / cild / nömrə: Yüklənmiş PDF-də göstərilməyib.
Məqalənin DOI-si: Yüklənmiş PDF-də göstərilməyib.
Hakemlik statusu: Yüklənmiş PDF-də hakemli nəşr olduğunu təsdiqləyən məlumat yoxdur; hakemli yekun məqalə kimi təqdim edilməməlidir.
Mərkəzi nəzəri iddia: İnsan anlayış öyrənməsi və öyrədilmiş dil modellərindəki konseptual həndəsənin möhkəmləndirmə ilə formalaşan aşağıölçülü attractor strukturun iki fərqli miqyasda görünüşü olduğu hipotezi.
Mərkəzi tətbiqi metod: Concept Programming (CP).
Pilot model: Llama 3.2, 3 milyard parametr, lokal Ollama işə salınması.
Governance-safety testi: 36 hal.
Əsas pilot nəticə: Pozitiv concept training %94,4; punishment-analog %77,8; təlimsiz nəzarət %47,2; Fisher's exact test p<0,0001.
Transfer: Xəstəxana və anbar əməliyyatlarında mənbə dəqiqlik itkisi bildirmir; inşaat sahəsi təhlükəsizliyində %66,7.
Sosial təzyiq testi: Pozitiv concept model %92,6; təlimsiz nəzarət %44,4 məhdudiyyət qorunması.
Dəyər anlayışı eksperimenti: Tək Buddist etik dəyər anlayışı ilə beş moral-psychology ssenarisinin hamısı keçilmişdir.
Təlim xərci eksperimenti: Hər iki təlim üsulu 200 hal ərzində miss rate-i %100-dən %25-in altına endirmiş, lakin əvvəlcədən müəyyən edilmiş %95 stopping criterion-a çatmamışdır.
Kitab: Grooves in Neural Manifolds: AI Reveals Why You Think What You Think, and How to Reshape It.
Kitab DOI-si: 10.5281/zenodo.21966428.
Texniki companion iş 1: Concept Programming for Dependable AI.
Texniki companion iş 2: Neural manifolds, assemblies, and cross-domain interference.
Kod: Mənbə companion eksperimentlərin kodunun github.com/ricodoco/safety-concept-experiment ünvanında ictimaiyyətə açıq olduğunu bildirir.
Maraqlar toqquşması: Müəllif concept-instillation arxitekturasına dair patent müraciətlərinin olduğunu bildirir.
Maliyyələşdirmə: Bu xülasə PDF-də ayrıca maliyyələşdirmə bəyanatı yoxdur.
Məlumat əlçatanlığı: Bu xülasə PDF-də ayrıca məlumat əlçatanlığı bölməsi yoxdur; eksperiment protokolları və kod üçün companion işlərə yönləndirmə edilir.
Əsas elmi şərh sərhədi: Pilotun davranış performansı nəticələri birbaşa bildirilmişdir; insan idrakı ilə dil modeli həndəsəsinin eyni mexanizm olduğu iddiası və performansın attractor həndəsəsindən qaynaqlandığı izahı nəzəri framework-ün bir hissəsidir. Həmçinin punishment-analog şərti real RLHF olmadığından pilot nəticə RLHF-yə birbaşa üstünlük kimi təqdim edilməməlidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib