

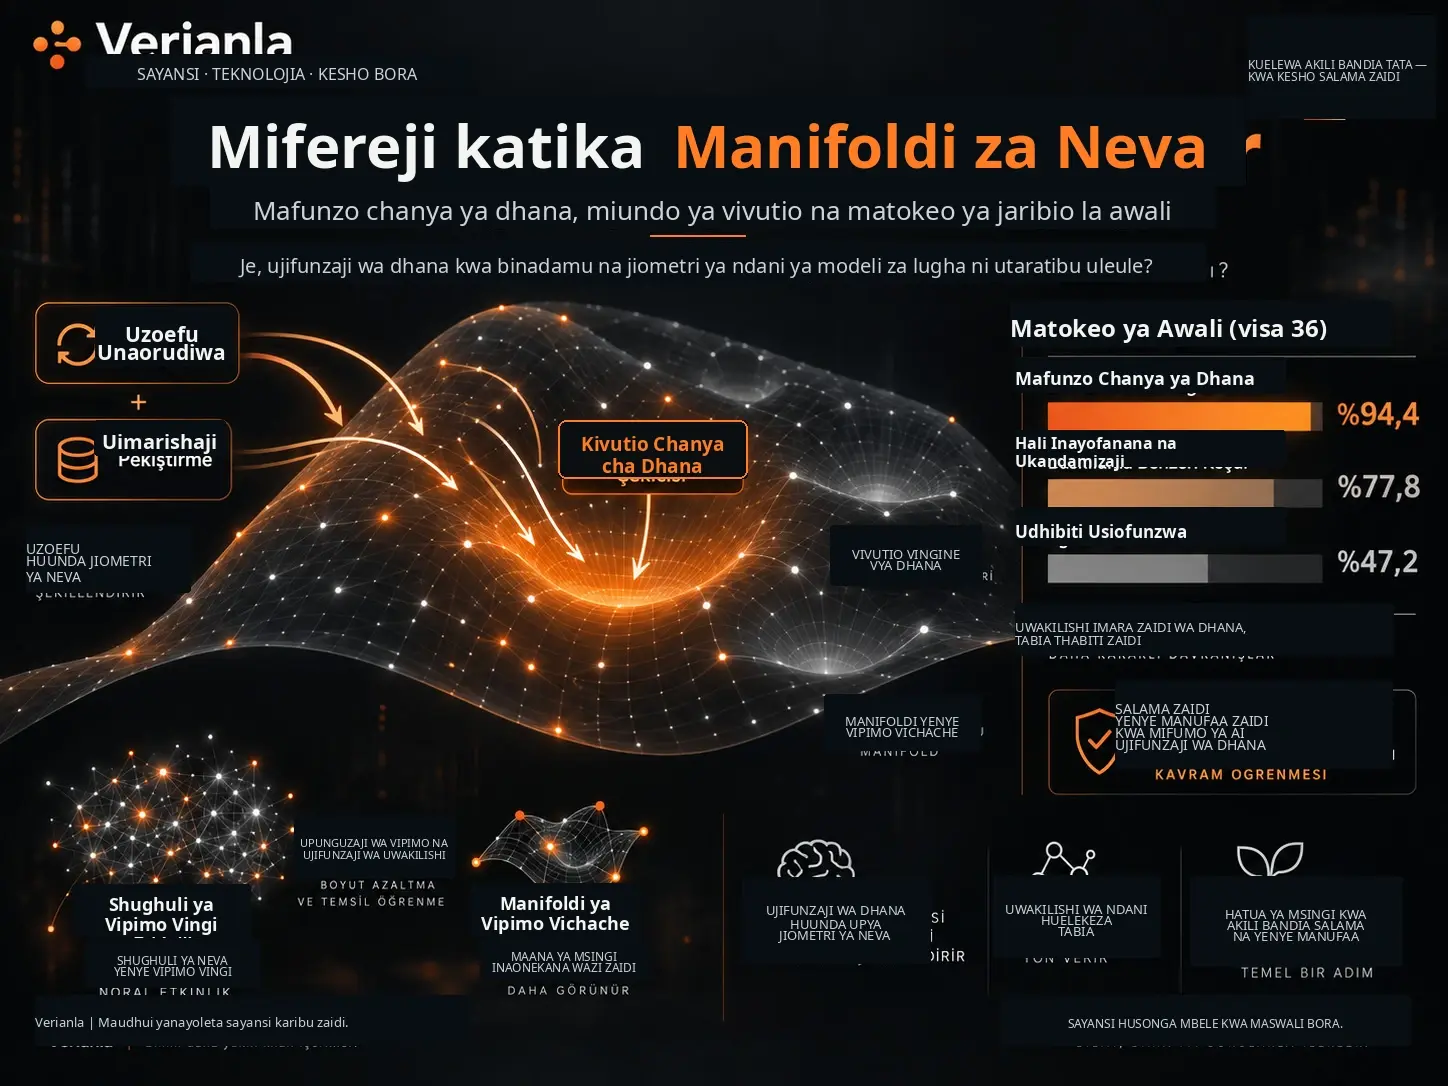
Manifoldi ya neva, ni mkabala wa uwakilishi unaoeleza kwamba tabia inayoundwa na idadi kubwa ya neuroni au vitengo vya mtandao bandia katika nafasi ya shughuli yenye vipimo vingi hupangwa juu ya uso wa kijiometri wenye vipimo vichache zaidi. Utafiti wa Frederick Roth unapendekeza nadharia kwamba ujifunzaji wa dhana kwa binadamu na uwakilishi wa dhana katika modeli za lugha zilizofunzwa si mifumo miwili tofauti, bali ni maonyesho katika mizani miwili ya muundo wa kivutio wenye vipimo vichache ulioundwa kwa uimarishaji. Katika mfumo huu, dhana hazihifadhiwi kama fasili za ishara moja moja; badala yake, huchukuliwa kama maeneo mazito ya kijiometri yanayoamilishwa mara kwa mara na uzoefu unaofanana na ambayo hali ya mfumo huwa na mwelekeo wa kurejea. Makala inapendekeza matokeo ya moja kwa moja ya mkabala huu kwa usalama wa akili bandia: badala ya kukandamiza tu tabia zisizotakiwa, kufundisha tabia inayotakiwa yenyewe kama kivutio chanya cha dhana kilichopewa jina. Mwandishi anaita mbinu hii Concept Programming (CP). Katika jaribio la awali lililoripotiwa kwenye Llama 3.2 yenye vigezo bilioni 3, CP ilipata usahihi wa %94,4 katika visa 36 vya governance-safety, huku hali ya punishment-analog yenye uundaji hasi ikipata %77,8 na udhibiti usiofunzwa %47,2. Hata hivyo, hali ya punishment-analog si RLHF halisi ya kiwango cha uzalishaji; utafiti hauonyeshi kwamba CP imeizidi RLHF moja kwa moja kwa majaribio. Aidha, matokeo ya kitabia yaliyoripotiwa si kipimo cha moja kwa moja cha jiometri ya manifold. Kwa hiyo, nadharia kuu ya ulinganifu wa utaratibu wa binadamu–AI ni ya kuvutia na inaweza kukanushwa, lakini bado si hitimisho la kisayansi lililoimarika.
Makala inaweka wazi kwamba upeo wake ni mdogo. Mwandishi anasema wazi kuwa maandishi haya ni muhtasari mfupi wa kitabu na tafiti mbili za kiufundi za companion, na kwamba chanzo cha msingi cha madai yaliyowasilishwa hapa si makala hii ya kurasa 7. Itifaki kamili za majaribio, matokeo ya ziada na msimbo vimeachwa kwenye kazi nyingine.
Tofauti hii ni muhimu; kwa sababu utafiti kwa upande mmoja unaunganisha sayansi ya utambuzi, makusanyo ya seli ya aina ya Hebb, ujifunzaji wa kategoria na mitandao ya attractor katika simulizi moja ya kijiometri, na kwa upande mwingine unatengeneza matokeo mapana ya kinadharia kwa usanifu wa ulinganishaji wa AI kutokana na majaribio madogo ya awali. Kwa mtazamo wa Verianla, mkabala sahihi ni kuwasilisha matokeo haya si kama “sheria ya jumla ya usalama wa AI iliyothibitishwa”, bali kama ushahidi wa awali wa programu ya utafiti yenye mipaka ya wazi ya majaribio.
Manifoldi ya Neva ni Nini?
Manifoldi ya neva ni wazo kwamba hali za mfumo katika nafasi ya shughuli za neva yenye vipimo vingi sana kwa kweli hujikusanya juu ya uso uliopangwa wenye vipimo vichache zaidi; katika mkabala huu, taarifa inayowakilishwa haijasimbwa katika maana zisizobadilika za neuroni moja moja, bali katika mahali na mwendo wa shughuli ya mfumo juu ya uso huo wa kijiometri.
Mtandao wa neva unaweza kuwa na mamilioni au mabilioni ya vigezo binafsi. Hata hivyo, mifumo ya shughuli inayojitokeza wakati wa kazi fulani si lazima itumie nafasi yote ya hali yenye vipimo vingi inayowezekana. Ikiwa uamilishaji unajikusanya katika mielekeo fulani, tabia ya mfumo inaweza kuelezwa kwa muundo wa kijiometri wenye vipimo vichache.
Katika mkabala wa kidhana wa chanzo, uanachama wa kategoria pia hueleweka kupitia muundo huu wa kijiometri. Mfano si lazima uwe kabisa “ndani” au “nje” ya kategoria fulani; nafasi yake kwenye manifold inaweza kuwa karibu na eneo la kategoria kwa viwango tofauti. Hivyo, inadaiwa kuwa tabia za kiwango, kama kutambua wanachama wa kawaida na wasio wa kawaida wa kategoria kwa kasi au kiwango tofauti cha uhakika, zinaweza kuelezwa.
Kwa nini uanachama wa kategoria ni wa viwango?
Kwa kutegemea tafiti za kategoria za Eleanor Rosch, chanzo kinasisitiza kwamba katika dhana nyingi za kila siku, uanachama si wa aina mbili kabisa. Baadhi ya mifano huonekana kuwa ya kawaida zaidi kwa kategoria, huku mingine ikibaki kwenye mpaka. Katika mkabala wa manifold, sababu ni kwamba dhana huchukuliwa kama eneo la kijiometri, si orodha ngumu ya masharti ya ishara.
Mkabala wa “mfanano wa kifamilia” wa Wittgenstein pia unawekwa katika muktadha huu. Huenda kusiwe na sifa moja ya pamoja ambayo mifano yote katika kategoria lazima ishirkiane; umoja wa kategoria unaweza kutokana na muundo wa eneo unaoundwa na mwingiliano wa sifa za mifano.
Muundo wa Kivutio ni Nini na Unahusishwaje na Ujifunzaji wa Dhana?
Muundo wa kivutio (attractor), unaeleza mwelekeo wa shughuli ya mfumo kuelekea eneo fulani na kurudi tena katika eneo hilo baada ya mikengeuko midogo. Chanzo kinapendekeza kwamba dhana zilizojifunzwa zinaweza kufikiriwa si kama mzunguko mmoja usiobadilika wa neva, bali kama maeneo thabiti na mazito ya manifold yenye mipaka ya viwango.
Dhana ya mkusanyiko wa seli ya Donald Hebb inaingizwa katika simulizi hii kama msingi wa kihistoria. Hebb alipendekeza kwamba vikundi vya seli vinavyoamilishwa pamoja mara kwa mara vinaweza baada ya muda kuunda kitengo cha utendaji kinachoweza kufanya kazi pamoja.
Roth anatafsiri upya wazo hili kwa lugha ya kijiometri: badala ya kuwa orodha isiyobadilika ya wanachama fulani, mkusanyiko wa seli unaweza kufikiriwa kama eneo la manifold ambalo shughuli hujikusanya mara kwa mara.
Katika modeli hii, uimarishaji si tukio tu linalozawadia matokeo fulani. Unatafsiriwa kama utaratibu wa uundaji wa kijiometri ambapo shughuli inayorudiwa hufanya njia na maeneo fulani katika nafasi ya hali ya mfumo kuwa rahisi kufikiwa.
Ulinganisho wa “groove”, yaani mfereji, unamaanisha nini?
Neno “groove” katika kichwa cha utafiti na kitabu linaeleza wazo hili la matumizi ya kurudia. Kadiri tabia au muundo wa dhana unavyoamilishwa mara kwa mara, ndivyo inavyokuwa rahisi kwa mfumo kufikia tena eneo lilelile la shughuli.
Hii haimaanishi kwamba kuna mfereji halisi wa kimwili. Metafora ya kijiometri inayotumiwa na chanzo inaeleza dhana kwamba tabia zilizojifunzwa zinaweza kuwakilishwa kama njia zinazopendelewa au maeneo thabiti katika nafasi ya shughuli yenye vipimo vingi.
Kwa nini dhana haionekani kuwa imezuiliwa kwenye manifold moja tu?
Chanzo kinapendekeza kwamba ujuzi wa utambuzi au wa mwendo unaweza kuchukuliwa katika eneo moja la uwakilishi; lakini dhana pana zaidi zinapaswa kuunganisha modaliti tofauti. Kwa mfano, dhana ya “mbwa” huunganisha umbo la kuona, sauti, mwendo na aina nyingine za uzoefu katika muundo mmoja wa kidhana.
Katika hali hii, swali linatokea kuhusu jinsi muundo wa pamoja wa maeneo tofauti ya uzoefu unavyounganishwa. Roth hapa anatumia mkabala wa interference matching wa Hayes-Roth na McDermott wa 1978.
Interference Matching ni Nini?
Interference matching, ni mkabala wa kuweka juu kwa juu miundo ya sifa inayowashwa na mifano mingi ya dhana ili kutenganisha muundo wa pamoja unaojirudia kati ya mifano hiyo; chanzo kinauchukulia kama utaratibu wa kuunda uondoaji wa kidhana wa jumla zaidi kutoka kwenye uzoefu tofauti.
Kwa mujibu wa chanzo, mchakato unaweza kufananishwa rasmi na kuhesabu makutano ya seti za vipengele vinavyoamilishwa na kila mfano. Sifa za bahati nasibu au zinazotegemea muktadha katika mfano mmoja hupotea kati ya marudio, huku michanganyiko ya sifa za pamoja ikiimarika.
Roth anatafsiri mkabala huu kama kuundwa kwa kumbukumbu ya viwango kuhusu michanganyiko ya sifa zinazojitokeza pamoja, badala ya kuhifadhi skimu ya ishara au mfano mmoja.
Muundo mpya wa taarifa hubadilika vipi wakati wa matumizi?
Chanzo kinataja kando mkunjo wa uhamisho wa hatua tatu ulioripotiwa katika utafiti wa Barbara Hayes-Roth wa 1977:
- Urahisishaji wa awali: muundo mpya wa taarifa hutoa faida ya mwanzo katika kazi fulani.
- Hatua ya Recovery: hutokea kipindi ambacho vipengele vidogo vya pamoja hushindana wakati wa uimarishaji.
- Hatua ya asimptoti: muundo wa taarifa huwa thabiti zaidi.
Mwandishi anatenganisha wazi kwamba matokeo haya ya hatua tatu ni ya Barbara Hayes-Roth; modeli ya property-set ina historia tofauti iliyoanza na kazi ya Frederick Hayes-Roth ya 1974 na baadaye ikaendelezwa kwa pamoja.
Tatizo la Kufungamanisha Ishara ni Nini?
Tatizo la kufungamanisha ishara ni tatizo la kulinganisha la kikombinatoria linalotokea pale mfumo wa ishara unapolazimika kuamua jinsi majukumu katika vigeu dhahania yanavyopaswa kupewa vitu halisi katika eneo. Chanzo hakidai kwamba uwakilishi wa manifold “hutatua” tatizo hili kwa kasi zaidi; kinadai kwamba huondoa tatizo lenyewe kwa kutotumia tangu mwanzo aina ya uwakilishi inayohitaji kufungamanisha kigeu–thamani.
Mfumo wa ishara unaweza, kwa mfano, kuwakilisha uhusiano hivi:
above(block-A, block-B)
Ikiwa kanuni ya jumla itatumika kwa vitu tofauti, mfumo unapaswa kuamua ni kitu kipi kinachojaza jukumu gani la kigeu. Kadiri idadi ya vitu na mahusiano inavyoongezeka, idadi ya ulinganifu unaowezekana inaweza pia kuongezeka.
Chanzo kinawasilisha tatizo hili kama mojawapo ya vikwazo vikuu vya vitendo vilivyotambuliwa na Hayes-Roth na McDermott mwaka 1978 kwa upande wa ujifunzaji wa mifumo ya kimuundo.
Mkabala wa Manifold “Huondoa” Tatizo la Kufungamanisha kwa Njia Gani?
Katika pendekezo la Roth, mahusiano yanaweza kuwakilishwa si kwa kugawa vitu kwa vigeu vilivyopewa majina, bali kwa nafasi ya jamaa, umbali au muundo wa shughuli ya pamoja kati ya manifold; hivyo hakuna haja ya utafutaji wa kufungamanisha kigeu–thamani na utambuzi hufafanuliwa upya kama tatizo la kukamilisha muundo dhidi ya muundo wa kivutio uliojifunzwa.
Hii ni tofauti muhimu ya kinadharia. Makala haipendekezi “algoriti mpya inayotatua tatizo la kufungamanisha la NP-hard kwa kasi zaidi”. Badala yake, inapendekeza kwamba dhana ya uwakilishi wa ishara inayozalisha darasa hilo la tatizo inaweza kuwa isiyo ya lazima.
Hata hivyo, hitimisho hili halijaonyeshwa katika utafiti kwa jaribio pana la kufungamanisha lililotokana na uamilishaji wa ndani wa modeli kubwa za lugha. Chanzo kinajenga hoja ya kinadharia ya uwakilishi hapa.
Je, Ujifunzaji wa Dhana kwa Binadamu na Jiometri ya Ndani ya Modeli za Lugha ni Utaratibu Uleule?
Hoja kuu ya makala hii inaelekea “ndiyo”, lakini chanzo kinaikuza si kama ukweli wa kisayansi uliokwishathibitika, bali kama dai la kuunganisha linaloweza kukanushwa. Inadaiwa kwamba fasihi ya kitabia ya ujifunzaji wa dhana kwa binadamu na jiometri ya uwakilishi yenye vipimo vichache katika mitandao bandia ya neva huakisi utaratibu uleule wa msingi wa kivutio; hata hivyo, makala hii haina jaribio la pamoja linaloonyesha moja kwa moja kwamba mifumo hii ni sawa kweli katika mifumo ya kibaolojia na bandia.
Kwa hiyo, viwango viwili tofauti vya ushahidi vinapaswa kutenganishwa.
| Dai | Hadhi yake katika makala hii |
|---|---|
| Uanachama wa dhana unaweza kuwa wa viwango. | Usuli unaotokana na fasihi ya awali ya sayansi ya utambuzi. |
| Miundo ya uwakilishi yenye vipimo vichache inaweza kuunda katika mitandao ya neva. | Usuli unaotokana na fasihi ya kisasa ya interpretability inayorejelewa na makala. |
| Ujifunzaji wa dhana kwa binadamu na jiometri ya dhana ya modeli ya lugha ni utaratibu uleule. | Nadharia ya kuunganisha ya mwandishi. |
| Utaratibu huu huwezesha attractor-based Concept Programming. | Nadharia tete ya utafiti inayoweza kutumika, iliyotokana na nadharia. |
| Mafunzo ya awali ya CP yalitoa usahihi wa juu katika baadhi ya vipimo vya safety. | Matokeo ya jaribio la kitabia yaliyoripotiwa katika chanzo. |
Concept Programming ni Nini?
Concept Programming (CP), ni mkabala wa mafunzo ya tabia unaolenga, badala ya kuadhibu au kuchuja tu matokeo yasiyotakiwa katika mfumo wa AI, kufundisha dhana ya tabia inayotakiwa kama kivutio chanya kilichopewa jina na kuilinganisha na muundo wa majibu unaozuia mbadala usiotakiwa kujitokeza inapohitajika.
Chanzo kinafananisha CP na tofauti kati ya “punishment” na “inhibitory learning” katika operant conditioning.
Katika modeli ya mwandishi, mkabala wa suppression huadhibu tabia isiyotakiwa baada ya kutokea au kuanza kujitokeza. Mafunzo ya dhana chanya hulenga kuifanya tabia mbadala inayotakiwa yenyewe kuwa uwakilishi unaopatikana kwa urahisi zaidi.
Katika CP, dhana ya marufuku haifafanuliwi tu kama “usifanye hivi”. Kile dhana inachowakilisha na ni tabia gani mbadala inayopaswa kuamilishwa hufundishwa kwa njia chanya.
Je, Utafiti Unathibitisha kwamba Concept Programming ni Bora Kuliko RLHF?
Hapana. Katika jaribio la chanzo, Concept Programming haikulinganishwa na RLHF fine-tuning halisi ya kiwango cha uzalishaji. Hali ya pili iliyolinganishwa ni analojia ndogo ya suppression iliyoundwa kwa prompting yenye uundaji hasi na ambayo mwandishi anaiita “punishment-analog”; kwa hiyo matokeo yanapaswa kusomwa kama “CP ilifanya vizuri zaidi kuliko hali hii ya awali ya punishment-analog”.
Kikomo hiki kinakubaliwa wazi katika chanzo. Mwandishi anaorodhesha ulinganisho wa full RLHF na vipimo vya adversarial jailbreak miongoni mwa majaribio yanayopaswa kufanywa baadaye.
Kwa hiyo sentensi mbili zifuatazo si sawa:
Kinachoungwa mkono na chanzo: “Mafunzo ya dhana chanya yalitoa usahihi wa juu kuliko hali ya punishment-analog katika pilot hii.”
Kinachokosa kuungwa mkono na chanzo: “Concept Programming kwa ujumla ni salama zaidi kuliko RLHF na imethibitisha hilo kwa majaribio.”
Mbinu na Matokeo ya Utafiti
Muundo wa utafiti
Utafiti huu wa kurasa 7 si ripoti kamili ya kiufundi ya majaribio. Chanzo kinafupisha matokeo ya makundi matatu ya majaribio na kuelekeza kwenye makala mbili za companion kwa itifaki za kina, msimbo na matokeo ya ziada.
Pilot kuu ya safety:
- modeli ya Llama 3.2 yenye vigezo bilioni 3 na uzani wazi,
- uendeshaji wa ndani kupitia Ollama,
- positive concept training,
- punishment-analog prompting,
- udhibiti usiofunzwa
inajumuisha hali tatu.
Matokeo ya pilot ya governance-safety
| Hali | Usahihi katika visa 36 vya governance-safety |
|---|---|
| Positive Concept Programming | %94,4 |
| Punishment-analog | %77,8 |
| Udhibiti usiofunzwa | %47,2 |
Chanzo kinaripoti kwa Fisher's exact test p<0,0001.
Matokeo haya ni ushahidi wa kitabia wa moja kwa moja zaidi wa pilot. Hata hivyo, mifano yote ya seti ya majaribio na maelezo kamili ya utaratibu hayapatikani katika makala hii ya muhtasari.
Uhamisho kwenda maeneo mapya
Modeli ya dhana chanya ilitathminiwa katika maeneo matatu mapya ya uendeshaji.
| Eneo jipya | Matokeo yaliyoripotiwa katika chanzo |
|---|---|
| Uendeshaji wa hospitali | Hakukuripotiwa kupungua kwa usahihi bila mafunzo maalum ya eneo. |
| Uendeshaji wa ghala | Hakukuripotiwa kupungua kwa usahihi bila mafunzo maalum ya eneo. |
| Usalama wa eneo la ujenzi | Usahihi ulipungua hadi %66,7. |
Mwandishi anatafsiri kupungua kwa usalama wa ujenzi kama matokeo yanayoendana na istilahi maalumu zaidi na zinazobadilika.
Lakini kwa kuwa kuna matokeo ya maeneo haya matatu tu ndani ya pilot hii, haiwezi kuhitimishwa kwamba CP huhamisha bila kupoteza usahihi katika maeneo yote mapya.
Uhifadhi wa kizuizi chini ya shinikizo la kijamii
Chanzo kinachukulia visa vya majaribio ambavyo prompt huweka shinikizo la kijamii la wazi au lililofichwa kwa modeli kuwa muhimu hasa.
| Hali | Uhifadhi wa kizuizi |
|---|---|
| Positive concept model | %92,6 |
| Udhibiti usiofunzwa | %44,4 |
Mwandishi anatafsiri tofauti hii kama msaada wa wazo kwamba uwakilishi wa ndani unaoweza kustahimili shinikizo umeundwa katika modeli ya dhana chanya.
Hata hivyo, katika jaribio hili “uwakilishi wa ndani” haukuonyeshwa kwa kipimo cha moja kwa moja cha jiometri ya manifold. Matokeo yaliyopimwa ni utiifu wa kizuizi cha kitabia; maelezo kuhusu uwakilishi wa ndani ni safu ya tafsiri ya kinadharia.
Kwa Nini Mafunzo ya Dhana Chanya Yanaweza Kuhamishwa kwa Hali Mpya?
Kwa mujibu wa nadharia ya chanzo, kwa sababu mafunzo ya dhana chanya yanalenga kuunda bonde la kivutio linalofunika wigo mpana wa namna dhana inavyoweza kuonyeshwa badala ya kukaririsha sentensi moja moja za marufuku, inatarajiwa kuwa mfumo utaelekezwa tena kwenye eneo lilelile la tabia dhana hiyo inapojitokeza kwa maneno tofauti au katika miktadha tofauti ya uendeshaji. Utaratibu huu wa uhamisho ni maelezo ya kinadharia; katika pilot, uhamisho mkubwa ulionekana katika maeneo mawili mapya, huku eneo la tatu likionyesha kupungua dhahiri kwa utendaji.
Jaribio la pili: mafunzo ya dhana ya thamani
Jaribio la pili linatathmini dhana ya thamani ya kitamaduni badala ya safety constraint.
Dhana ya thamani iliyopewa jina na inayolingana na mfumo mmoja wa maadili ya Kibudha ilifundishwa bila kutumia mifano mahususi ya matukio.
Baadaye modeli ilitathminiwa katika visa vitano vya kawaida vya moral-psychology:
- senario ya trolley,
- toleo la footbridge,
- tatizo la aina ya Heinz,
- senario ya mtoto anayelia,
- kisa cha whistleblower.
Chanzo kinaripoti kwamba modeli iliyofundishwa ilifaulu visa vyote vitano na kwamba hakuna mila nyingine zilizojaribiwa katika pilot hiyo iliyopata matokeo sawa bila mafunzo mahususi ya senario.
Alama za kina za mila nyingine na itifaki kamili ya mafunzo hazijatolewa katika utafiti huu wa muhtasari.
Jaribio la tatu: gharama ya mafunzo
Jaribio la tatu linatathmini ni baada ya mifano mingapi ya mafunzo Concept Programming huanza kupunguza makosa ya usalama, kwa kutumia mfumo wa governance-adapted signal detection.
Mbinu mbili za mafunzo zililinganishwa:
| Mkabala wa mafunzo | Sifa iliyoelezwa katika chanzo |
|---|---|
| Usampulishaji mpana | Hutumia mifano kutoka sehemu pana zaidi ya wigo wa asili wa namna dhana inavyoonyeshwa. |
| Usampulishaji mwembamba | Hulenga maneno yanayotumiwa mara nyingi zaidi kueleza dhana. |
Mbinu zote mbili zilipunguza miss rate ya %100 katika udhibiti usiofunzwa hadi chini ya %25 ndani ya visa 200 vya mafunzo.
Hata hivyo, chanzo kinasema wazi kwamba stopping criterion ya %95 iliyowekwa mapema haikufikiwa ndani ya bajeti ya visa 200.
Usampulishaji mpana ulitoa correct-rejection rate ya juu zaidi, huku usampulishaji mwembamba ukitoa hit rate ya juu zaidi.
Mwandishi anaona tofauti hii kuwa inayolingana na matarajio kwamba usampulishaji tofauti wa mafunzo utaumba jiometri tofauti za attractor. Maelezo haya ya kijiometri si kipimo cha moja kwa moja cha manifold, bali tafsiri ya matokeo ndani ya mfumo wa nadharia.
Kwa Nini Lebo za Uhakika za Kitabu ni Muhimu?
Kitabu kinachofupishwa katika chanzo kinatumia mfumo wa kuripoti wenye lebo sita za uhakika ili kuepuka kuandika viwango tofauti vya kiepistemolojia—kama matokeo thabiti ya kimaempiria, msaada wa sehemu, matokeo ya pilot na matarajio ya mwandishi—kwa kiwango kilekile cha uhakika. Mkabala huu unalenga hasa kuzuia kuchanganywa kwa usanisi mpana wa kinadharia na matokeo madogo ya pilot.
Chanzo kinaeleza kategoria zifuatazo kama mifano:
| Lebo | Maana |
|---|---|
| Established | Matokeo yanayoungwa mkono na fasihi ya kimaempiria iliyoimarika. |
| Well supported | Msaada halisi lakini ambao bado haujakamilika. |
| Our experiments show | Matokeo yanayotokana na jaribio la mwandishi mwenyewe na yanayopaswa kutolewa pamoja na ukubwa wa sampuli. |
| I expect | Matarajio yenye msingi wa maarifa lakini ambayo bado hayajawekwa kwa majaribio. |
| I suspect | Hukumu ya kinadharia yenye kiwango cha chini zaidi cha uhakika. |
| What would change my mind | Kueleza wazi ushahidi ambao ungekanusha dai. |
Ingawa makala hii ya kurasa 7 haitumii mfumo huo wa lebo rasmi katika kila sentensi, mwandishi anajaribu kusisitiza tofauti kati ya matokeo ya pilot na nadharia pana katika maandishi yote.
Ni Matokeo Gani Yangeweza Kukanusha Nadharia Hii?
Chanzo kinawasilisha madai makuu ya nadharia kama yanayoweza kukanushwa. Hasa, ikiwa utafiti wa baadaye wa interpretability utaonyesha kwamba dhana katika modeli za lugha zinachakatwa kwa miundo tofauti, inayofanana na ishara na kwa variable binding ya kikombinatoria badala ya manifoldi za attractor zenye vipimo vichache, dai kuu kwamba ujifunzaji wa dhana kwa binadamu na jiometri ya modeli ya lugha ni utaratibu uleule litakanushwa moja kwa moja.
Sehemu kuu za majaribio zilizotajwa katika chanzo
Kikomo cha kwanza ni unification claim pana zaidi ya utafiti. Ikiwa ujifunzaji wa dhana katika modeli za lugha utaelezwa siku zijazo kwa utaratibu tofauti kabisa, nadharia haitakuwa tu pungufu bali itakuwa potofu katika kiwango cha msingi.
Kikomo cha pili ni dai lenye msaada dhaifu zaidi ndani ya framework: dhana kwamba viwango fulani vya utambuzi hufanya kazi kwa kasi takribani thabiti kwa kila kitengo chao cha uchakataji. Chanzo kinakubali kwamba hili limepimwa katika baadhi ya njia za neva lakini limekadiriwa tu katika nyingine.
Ikiwa itaonyeshwa kwamba kasi ya uchakataji hubadilika kwa mfumo ndani ya kiwango kilekile cha utambuzi, dai hili litaathirika moja kwa moja.
Jaribio la tatu la vitendo ni kulinganisha moja kwa moja Concept Programming na RLHF halisi pamoja na mbinu za production-scale suppression.
Jaribio la nne ni uundaji upya wa adversarial jailbreak. Chanzo kinatabiri kwamba CP inapaswa kuwa sugu zaidi kwa mashambulizi haya kuliko mbinu za suppression, lakini jaribio husika bado halijafanywa.
Matokeo yanayoungwa mkono na utafiti
- Katika pilot ya modeli ya 3B Llama 3.2, positive concept training ilitoa usahihi wa governance-safety wa juu kuliko hali za punishment-analog na udhibiti usiofunzwa.
- Chanzo kinaripoti viwango vya usahihi vya %94,4, %77,8 na %47,2 katika ulinganisho wa visa 36.
- Positive concept model ilihamishwa kwenda maeneo mawili mapya ya uendeshaji bila kupoteza usahihi, na katika eneo la tatu ilishuka hadi %66,7.
- Katika visa vyenye shinikizo la kijamii, hali ya dhana chanya ilionyesha utiifu mkubwa zaidi wa kizuizi kuliko udhibiti usiofunzwa.
- Dhana moja ya thamani ya maadili ya Kibudha ilifaulu visa vyote vitano vya moral-psychology katika pilot.
- Mikakati miwili ya mafunzo ya CP ilipunguza miss rate kutoka %100 hadi chini ya %25 ndani ya visa 200 vya mafunzo.
- Chanzo kinatumia jiometri ya manifold na attractor kama mfumo wa kinadharia wa kueleza Concept Programming.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa moja kwa moja kwamba Concept Programming ni bora kuliko RLHF ya kiwango cha uzalishaji.
- Punishment-analog prompting na RLHF halisi si hali sawa ya majaribio.
- Haijaonyeshwa kwamba matokeo yaleyale yatatokea katika modeli za kiwango cha frontier.
- Ustahimilivu bora dhidi ya mashambulizi ya adversarial jailbreak bado haujajaribiwa.
- Kuongezeka kwa usahihi wa kitabia peke yake hakuthibitishi kuwepo kwa attractor manifold iliyopimwa ndani ya modeli.
- Haijaonyeshwa moja kwa moja katika makala hii kwamba ujifunzaji wa dhana kwa binadamu na uwakilishi wa modeli ya lugha ni sawa kibaolojia na kihesabu.
- Matokeo ya %66,7 katika eneo la ujenzi yanaonyesha kwamba hakuna uhamisho mkamilifu kwenda maeneo yote mapya.
- Mafanikio katika senario tano za maadili si uthibitisho wa ulimwengu wote wa ulinganifu mpana wa thamani za kitamaduni.
Mapungufu makuu ya kimethodolojia
Matokeo yote ya matumizi yanatokana na modeli moja yenye vigezo bilioni 3.
Chanzo hakiripoti jaribio katika deployed frontier model yoyote.
Hali ya punishment-analog si RLHF fine-tuning halisi.
Majaribio ya adversarial ya aina ya jailbreak hayajafanywa.
Utafiti huu wa muhtasari haujumuishi itifaki kamili ya majaribio; maelezo yameachwa kwa makala za companion.
Jiometri ya attractor inatafsiriwa kama utaratibu wa kinadharia unaotokana na matokeo ya kitabia ya majaribio, na hapa haijathibitishwa kwa uchanganuzi wa moja kwa moja wa nafasi ya uamilishaji.
Tafsiri ya mgongano wa maslahi
Mwandishi anatangaza kuwa ana maombi ya hataza yanayohusiana na usanifu wa concept-instillation unaotumiwa katika Concept Programming.
Hali hii haimaanishi moja kwa moja kwamba matokeo ni batili; lakini ni muktadha muhimu wa maslahi unaoonyesha kwamba urudiaji huru ni muhimu hasa katika kutathmini mbinu.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Grooves in Neural Manifolds: A Summary of the Argument and the Experimental Evidence
Mwandishi: Frederick Roth
Wadhifa uliotajwa katika chanzo: Professor, Information Sciences, Naval Postgraduate School (Retired)
Uanachama uliotajwa katika chanzo: Fellow, Association for the Advancement of Artificial Intelligence
Aina ya chanzo: Makala ya muhtasari wa usanisi wa kinadharia/kidhana na matokeo ya majaribio ya companion.
Hadhi ya chanzo cha msingi: Mwandishi anasema wazi kwamba makala hii si chanzo cha msingi cha madai yake mwenyewe.
Jarida / juzuu / toleo: Haijatajwa katika PDF iliyopakiwa.
DOI ya makala: Haijatajwa katika PDF iliyopakiwa.
Hali ya ukaguzi wa rika: PDF iliyopakiwa haina taarifa inayothibitisha kuwa ni chapisho lililopitiwa na rika; haipaswi kuwasilishwa kama makala ya mwisho iliyopitiwa na rika.
Dai kuu la kinadharia: Nadharia kwamba ujifunzaji wa dhana kwa binadamu na jiometri ya dhana katika modeli za lugha zilizofunzwa ni maonyesho katika mizani miwili tofauti ya muundo wa attractor wenye vipimo vichache ulioundwa kwa uimarishaji.
Mbinu kuu ya matumizi: Concept Programming (CP).
Modeli ya pilot: Llama 3.2, vigezo bilioni 3, uendeshaji wa ndani wa Ollama.
Kipimo cha governance-safety: Visa 36.
Matokeo makuu ya pilot: Positive concept training %94,4; punishment-analog %77,8; udhibiti usiofunzwa %47,2; Fisher's exact test p<0,0001.
Uhamisho: Chanzo hakiripoti kupungua kwa usahihi katika uendeshaji wa hospitali na ghala; katika usalama wa eneo la ujenzi %66,7.
Kipimo cha shinikizo la kijamii: Positive concept model %92,6; udhibiti usiofunzwa %44,4 katika uhifadhi wa kizuizi.
Jaribio la dhana ya thamani: Kwa dhana moja ya thamani ya maadili ya Kibudha, senario zote tano za moral-psychology zilifaulu.
Jaribio la gharama ya mafunzo: Mbinu zote mbili za mafunzo zilipunguza miss rate kutoka %100 hadi chini ya %25 ndani ya visa 200, lakini hazikufikia stopping criterion ya %95 iliyowekwa mapema.
Kitabu: Grooves in Neural Manifolds: AI Reveals Why You Think What You Think, and How to Reshape It.
DOI ya kitabu: 10.5281/zenodo.21966428.
Kazi ya kiufundi ya companion 1: Concept Programming for Dependable AI.
Kazi ya kiufundi ya companion 2: Neural manifolds, assemblies, and cross-domain interference.
Msimbo: Chanzo kinasema kwamba msimbo wa majaribio ya companion unapatikana hadharani katika github.com/ricodoco/safety-concept-experiment.
Mgongano wa maslahi: Mwandishi anaripoti kuwa ana maombi ya hataza yanayohusiana na usanifu wa concept-instillation.
Ufadhili: Hakuna tamko tofauti la ufadhili katika PDF hii ya muhtasari.
Upatikanaji wa data: PDF hii ya muhtasari haina sehemu tofauti ya upatikanaji wa data; inaelekeza kwenye kazi za companion kwa itifaki za majaribio na msimbo.
Kikomo kikuu cha tafsiri ya kisayansi: Matokeo ya utendaji wa kitabia wa pilot yameripotiwa moja kwa moja; dai kwamba utambuzi wa binadamu na jiometri ya modeli ya lugha ni utaratibu uleule, pamoja na maelezo kwamba utendaji unatokana na jiometri ya attractor, ni sehemu ya framework ya kinadharia. Aidha, kwa kuwa hali ya punishment-analog si RLHF halisi, matokeo ya pilot hayapaswi kuwasilishwa kama ubora wa moja kwa moja dhidi ya RLHF.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *