

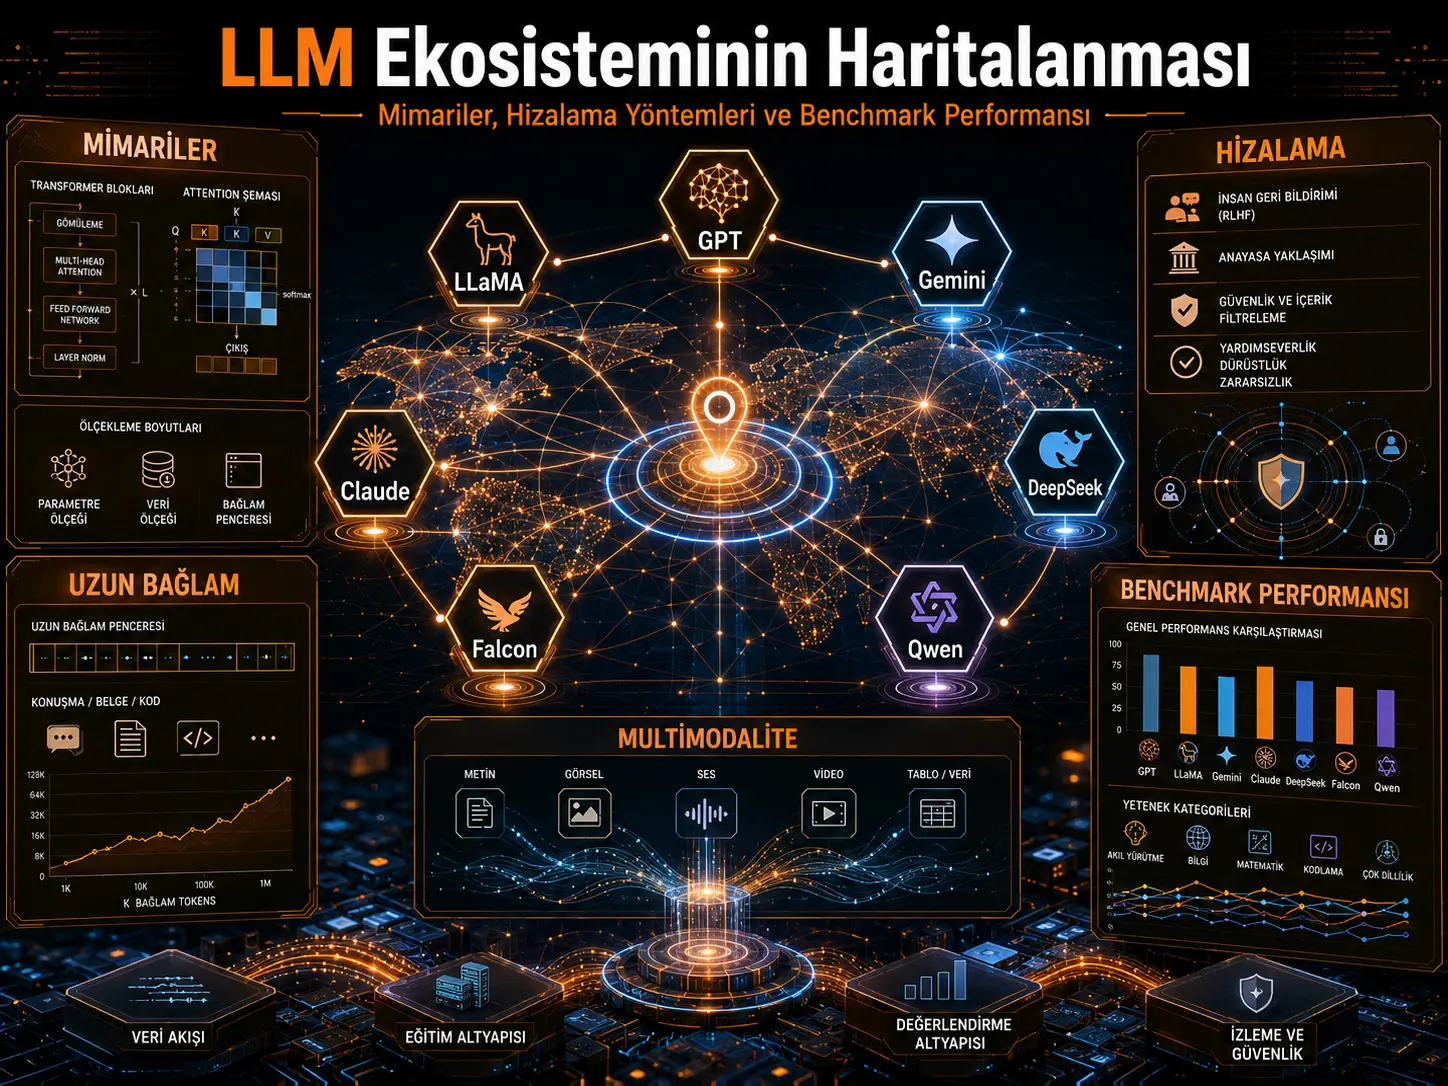
Katta til modellari endi faqat ko‘proq parametrga ega matn ishlab chiqaruvchilar sifatida rivojlanmayapti. Hozirgi tizimlar; attention mexanizmi qanday hisoblanishi, qaysi ekspertlar faollashtirilishi, yuz minglab yoki millionlab token uzunligidagi context qanday qayta ishlanishi, tasvir–ovoz–video kabi turli ma’lumot turlari qanday birlashtirilishi hamda inson afzalliklari va xavfsizlik qoidalari modelga qanday o‘tkazilishi kabi ko‘plab arxitektura va o‘qitish qarorlarining birikmasidan tashkil topadi. Ushbu sharh tadqiqoti GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon va Qwen kabi yetti yirik LLM oilasini umumiy taksonomiya ostida taqqoslashni maqsad qiladi.
Tadqiqotchilar ochiq texnik hisobotlar, model kartalari va model hujjatlaridan foydalanib 50 dan ortiq vakillik qiluvchi LLM arxitekturasini qayta tuzgan; modellarni attention mexanizmi, normallashtirish, pozitsion kodlash, dense yoki mixture-of-experts yo‘naltirish, context boshqaruvi, o‘qitish strategiyasi, moslashtirish va multimodal qobiliyat kabi o‘lchamlar bo‘yicha kodlagan. Tadqiqot shuningdek ushbu taksonomiyani interaktiv tarzda ko‘rib chiqish uchun ochiq manbali LLM Model Explorer interfeysini taqdim etadi.
Maqolaning qiyosiy benchmark jadvalida GPT-4/GPT-4o oilasi MMLU’da %86,4 va GSM8K’da %92,0; Gemini 1.5 HumanEval’da %74,9; Claude 3.x SWE-bench’da %49,0; DeepSeek oilasi GSM8K’da %89,4 va SWE-bench’da %42,5 sifatida keltirilgan. Biroq bu raqamlar bitta umumiy benchmark ishga tushirishida ishlab chiqilmagan. Ular turli model versiyalari, ishlab chiqaruvchi hisobotlari, leaderboard’lar, prompting usullari va baholash protokollaridan jamlangan. Shu sababli manba tadqiqot bu qiymatlar ko‘rsatkich xarakterida ekanini va modellar o‘rtasida to‘liq bevosita taqqoslab bo‘lmasligini ochiq aytadi.
Tadqiqotning asosiy hissasi muayyan bir LLM “g‘olib” ekanini e’lon qilishdan ko‘ra, zamonaviy katta til modellari qaysi dizayn o‘qlari bo‘yicha bir-biridan ajralishini ko‘rinadigan qilishdir. Sharh taklif qilgan asosiy yo‘nalishlar; yanada samarali attention mexanizmlariga o‘tish, uzun context uchun modulyar hisoblashni izlash, ochiq vaznli modellarda RoPE va RMSNorm kabi komponentlarning keng tarqalishi, multimodal tizimlarning kengayishi hamda RLHF, RLAIF yoki Constitutional AI kabi moslashtirish usullarining model ishlab chiqishda markaziy o‘ringa kelishidir.
Shu bilan birga taksonomiyadan chiqarilgan ayrim kuchli xulosalar eksperimental ravishda tasdiqlangan arxitektura qonunlari emas. Xususan, “32K’dan uzun context’ga ega barcha modellar sparse expert routing ishlatadi” degan xulosa tadqiqotning o‘z GPT-4o va Claude context jadvallari bilan mos kelmaydi. Benchmark farqlarini muayyan arxitektura xususiyatlariga bog‘laydigan izohlar ham nazoratli ablation tajribalaridan emas, oilalararo kuzatuv qiyoslashlaridan chiqarilgan.
| Tadqiqot qamrovi | Manbada bildirilgan tuzilma | Qanday talqin qilinishi kerak? |
|---|---|---|
| LLM oilasi | 7 | GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon va Qwen |
| Qayta tuzilgan arxitektura | 50+ | Texnik hujjatlar va model kartalaridan yuqori darajada qayta qurilgan. |
| Asosiy taqqoslash o‘qlari | Arxitektura, o‘qitish, moslashtirish, context, multimodallik, xavfsizlik, benchmark | Umumiy taksonomiya ostida o‘rganilgan. |
| Benchmark usuli | Ikkilamchi manbalardan xabar qilingan natijalar | Umumiy tajriba muhitida qayta o‘lchangan natijalar emas. |
| Interaktiv vosita | LLM Model Explorer | Taksonomiyadagi xususiyatlarni model kesimida taqqoslash imkonini beradi. |
| Asosiy ilmiy chegara | Nazoratli sababiy arxitektura taqqoslash yo‘q | Taksonomiya aloqalari gipoteza ishlab chiqaradi; sababiylikni isbotlamaydi. |
Nega faqat “necha milliard parametr?” savoli endi yetarli emas?
Katta til modellari dastlabki avlodlarida miqyosning oshishi asosiy taraqqiyot o‘qlaridan biri edi. Tadqiqotning tarixiy bayonida GPT-2’ning 2019-yildagi katta miqyosli oldindan o‘qitish yondashuvidan GPT-3’ning 175 milliard parametrigacha, keyin esa uzun context’li va multimodal modellarning paydo bo‘lishigacha bo‘lgan o‘zgarish tasvirlanadi.
Biroq tadqiqotchilarga ko‘ra, zamonaviy LLM dizayn maydoni endi bitta kattalik o‘qiga qisqartirilmaydi. Parametr soni yaqin bo‘lgan ikki tizim; attention mexanizmi, faol ekspertlar soni, normallashtirish usuli, pozitsion kodlash, ma’lumot aralashmasi, instruction tuning, moslashtirish yoki multimodal encoder tuzilmasi sababli juda farqli hisoblash va xulq-atvor profillarini ko‘rsatishi mumkin.
Tadqiqot qaysi yetti model oilasini o‘rganadi?
| Model oilasi | Manbada o‘rganilgan vakil modellar | Tadqiqot ajratib ko‘rsatgan asosiy xususiyat |
|---|---|---|
| GPT | GPT-2, GPT-3/3.5, GPT-4, GPT-4o, O1 | Decoder-only Transformer, katta miqyosli oldindan o‘qitish, multimodallik va RLHF |
| LLaMA | LLaMA, LLaMA 2, Code LLaMA | RoPE, GQA, RMSNorm va ochiq vaznli ekotizim |
| Gemini | Gemini 1.x va Gemini 1.5 | Multimodallik, uzun context va manbada MoE sifatida ta’riflangan tuzilma |
| Claude | Claude 2, Claude 3 va 3.5 variantlari | Uzun context, Constitutional AI va RLAIF |
| DeepSeek | DeepSeek-V2/V3 va Reasoner/R1 | MLA, MoE va reasoning yo‘naltirilgan o‘qitish |
| Falcon | Falcon 7B/40B/180B, Falcon 2, Falcon 3 va Mamba | Multi-query/multigroup attention va state-space variantlari |
| Qwen | Qwen, Qwen2 va Qwen-Max | RoPE, RMSNorm, SwiGLU, ko‘p tillilik va kod/matematika ixtisoslashuvi |
Attention mexanizmlari nega farqlashadi?
Klassik Transformer’dagi multi-head attention har bir attention head uchun alohida query, key va value proyeksiyalaridan foydalanadi. Katta modellarda ayniqsa key–value keshi uzun context va yuqori bir vaqtdagi foydalanuvchi yuki ostida muhim xotira xarajatiga aylanadi.
Tadqiqot bu muammoga turli oilalar turli yechimlar keltirganini ta’kidlaydi. LLaMA 2’da Grouped Query Attention (GQA), Falcon va Qwen oilasida multi-query yoki multigroup attention, DeepSeek’da esa Multi-Head Latent Attention (MLA) kabi yondashuvlar bu xarajatni kamaytirishni maqsad qiladi.
DeepSeek’ning MLA yondashuvi key–value ifodalarini pastroq o‘lchamli latent ko‘rinishlarga siqib, hisoblash va saqlash yukini kamaytirishni ko‘zlaydi. Falcon’ning multi-query/multigroup yondashuvi ham key va value proyeksiyalarini attention head’lari o‘rtasida ko‘proq ulashish orqali KV-cache yukini kamaytirishga qaratilgan.
Mixture-of-Experts nima beradi?
Mixture-of-Experts (MoE) yondashuvida modelning barcha parametrlari har bir token uchun bir vaqtda faollashtirilmaydi. Yo‘naltirish mexanizmi kirishga qarab muayyan ekspert quyi tarmoqlarini tanlaydi. Shunday qilib, umumiy model sig‘imi oshar ekan, token boshiga faol hisoblash umumiy parametr sonidan pastroq ushlab turilishi mumkin.
Manba tadqiqot bu yondashuvni ayniqsa Gemini va DeepSeek oilalarining masshtablash va uzun context strategiyalari bilan bog‘laydi. DeepSeek-R1 uchun 671 milliard umumiy parametrga nisbatan token boshiga taxminan 37 milliard faol parametr ma’lumoti berilgan.
Biroq MoE mavjudligi o‘z-o‘zidan yaxshiroq reasoning, uzunroq context yoki yuqoriroq benchmark performansining sababi sifatida qabul qilinmaydi. Yo‘naltirish usuli, o‘qitish ma’lumotlari, faol ekspertlar soni, attention arxitekturasi va post-training jarayoni natijalarga birgalikda ta’sir qiladi.
Falcon Mamba nega farqli?
Falcon Mamba 7B klassik self-attention o‘rniga Mamba state-space modelidan foydalanishi sababli tadqiqotdagi muhim arxitektura farqlaridan biridir. Manba buning uzun ketma-ketliklarda chiziqli vaqtli qayta ishlash va taxminan barqaror xotira xatti-harakatini maqsad qilganini bildiradi.
Falcon 3 oilasida Transformer va state-space yondashuvlarining birga mavjudligi zamonaviy LLM ishlab chiqish endi faqat Transformer ichidagi variatsiyalardan emas, attention tashqarisidagi uzun-ketma-ketlik arxitekturalaridan ham iboratligini ko‘rsatadi.
RMSNorm, RoPE va SwiGLU nega tez-tez uchraydi?
Tadqiqot taksonomiyasida ochiq vaznli model oilalarining bir qismida uch komponent tez-tez takrorlanishi ko‘rinadi: RMSNorm, Rotary Positional Embedding (RoPE) va SwiGLU.
RMSNorm normallashtirish xarajatini soddalashtiradi; RoPE esa attention mexanizmi ichiga nisbiy pozitsiya ma’lumotini olib kiradi. SwiGLU esa gated aktivatsiya tuzilmasidan foydalanadi. Tadqiqot LLaMA 2 va Qwen’ni bu komponentlarning yaqqol namunalari sifatida ko‘rib chiqadi.
Multimodal modellarda nima o‘zgaradi?
Matndan tashqaridagi tasvir, ovoz va video ma’lumotlarini qayta ishlash uchun model faqat bitta tokenizer va til decoder’dan iborat bo‘lishi yetarli emas. Tadqiqotda Gemini, GPT-4o va Claude 3 bu o‘zgarishning turli namunalari sifatida o‘rganiladi.
Gemini arxitektura sxemasida turli ma’lumot turlarining modality-specific encoder’lar orqali qayta ishlanib, cross-modal attention orqali umumiy latent makonga o‘tkazilishi ko‘rsatiladi. Tadqiqot GPT-4o’ni esa matn, kod, tasvir, ovoz va video bilan ishlay oladigan birlashgan multimodal dizayn sifatida ko‘rib chiqadi.
Moslashtirish: RLHF nima qiladi?
Reinforcement Learning from Human Feedback (RLHF), oldindan o‘qitilgan model faqat keyingi token ehtimolini optimallashtirish o‘rniga, inson afzalliklariga ko‘proq mos chiqishlar berishi uchun ishlatiladigan post-training usullaridan biridir.
Manba tadqiqot GPT-4, LLaMA 2, Claude, DeepSeek va Qwen kabi oilalarda turli supervised fine-tuning va afzallik optimallashtirish shakllari ishlatilganini bayon qiladi.
Shu bilan birga mualliflar RLHF xavfsizlikni qat’iy hal qilmasligini ta’kidlaydi. Inson fikr-mulohazasi qimmat; reward hacking paydo bo‘lishi mumkin; xavfsizlik o‘qitishi haddan tashqari rad etish xatti-harakatiga olib kelishi mumkin va jailbreak yoki adversarial prompting xavflari butunlay yo‘qolmaydi.
Constitutional AI va RLAIF nima?
Claude oilasi tadqiqotda alignment yondashuvi jihatidan alohida kategoriya sifatida ko‘rib chiqiladi. Constitutional AI’da modelning muayyan tamoyillar doirasida o‘z chiqishini tanqid qilishi va qayta tartibga solishi maqsad qilinadi. Reinforcement Learning from AI Feedback (RLAIF) esa inson baholashining bir qismini AI tomonidan berilgan fikr-mulohaza bilan qo‘llab-quvvatlashni o‘z ichiga oladi.
Manba mualliflari bu yondashuv inson annotatsiyasiga qaramlikni kamaytirishi mumkinligini, ammo AI fikr-mulohazasi modeldan kelib chiqadigan og‘ishlarni qayta ishlab chiqarish xavfiga ega ekanini bildiradi.
Taksonomiyaning uch asosiy naqshi
Maqola yetti model oilasini umumiy o‘lchamlarga joylashtirgach, uchta oilalararo naqshni taklif qiladi.
| Manbaning naqshi | Taqqoslangan o‘qlar | Mualliflarning xulosasi | Verianla talqin chegarasi |
|---|---|---|---|
| A — Alignment–Efficiency Divergence | Alignment strategiyasi × attention optimallashtirish | Chuqur moslashtirish bilan eng ilg‘or attention samaradorligi bir modelda birga ko‘rinmasligi ilgari suriladi. | Miqdoriy aniqlangan ikki o‘qda nazoratli performans testi emas. |
| B — Context–Routing Co-Adoption | Context uzunligi × expert routing | >32K context’li modellar sparse/modulyar routing ishlatishi ilgari suriladi. | Manbaning GPT-4o va Claude jadvallari bilan universal ifoda mos kelmaydi. |
| C — Open-Weight Convergence | Ochiqlik × normallashtirish × pozitsion kodlash | Ochiq vaznli modellar RMSNorm + RoPE atrofida klasterlashgani ilgari suriladi. | Model oilasi ichidagi barcha variantlar uchun bir xil darajada texnik ochiqlik mavjud emas. |
Pattern B’dagi ichki nomuvofiqlik nega muhim?
Tadqiqotning Pattern B matni, o‘rganilgan modellar ichida 32K’dan uzunroq context window beradigan “har bir model” sparse expert routing yoki selective state-space qatlamlaridan foydalanishini aytadi.
Biroq shu manbadagi qiyosiy jadval GPT-4/GPT-4o uchun 128K, Claude 2/3 uchun esa 100K–200K context window bildiradi. Bu ikki oilaning tegishli arxitektura xulosalarida sparse MoE yoki selective state-space routing ko‘rsatilmaydi.
Shu sababli manba ichidagi ma’lumotlar “uzun context bilan modulyar hisoblash ayrim oilalarda birga ko‘rinishi” talqinini qo‘llab-quvvatlashi mumkin; biroq “32K’dan yuqori barcha modellar buni ishlatadi” degan natijani o‘z jadvallari orqali qo‘llab-quvvatlamaydi.
“Ochiq model” bilan “ochiq manba” bir xil narsami?
Manba tadqiqotda modellar yopiq, ochiq vaznli, qisman ochiq yoki tadqiqot litsenziyali kabi turli kategoriyalarda ko‘rib chiqiladi. Bu farq muhim. Model vaznlarining e’lon qilinishi; o‘qitish ma’lumotlari, to‘liq o‘qitish kodi, post-training liniyasi va xavfsizlik tizimining hammasi ochiq degani emas.
Shu sababli tadqiqotdagi “open-source ecosystem” iborasi o‘qilganda har bir oila uchun haqiqiy ochiqlik darajasi farqli bo‘lishi mumkinligi hisobga olinishi kerak.
Benchmark natijalari nega bitta liga jadvali emas?
Maqolaning Tablo 2’si besh benchmark’ni yonma-yon beradi: MMLU, HumanEval, GSM8K, SWE-bench va MathVista. Lekin jadval hujayralarining hammasi bir xil model versiyasi, bir xil sana, bir xil prompting strategiyasi yoki bir xil evaluation harness ostida o‘lchanmagan.
Bundan tashqari jadval ayrim qatorlarda bitta modelni emas, oila ichidagi bir nechta variantni birgalikda ifodalaydi: “GPT-4/GPT-4o”, “Claude 3.x (Opus/Sonnet)”, “Gemini 1.5 (Pro/Ultra)” yoki “DeepSeek (V3/Reasoner)” kabi.
Shuning uchun bir qatordagi MMLU skori bilan shu qatordagi SWE-bench skorining albatta bir xil checkpoint yoki bir xil model variantidan kelgani faraz qilinmasligi kerak.
Ishlab chiqaruvchi va mustaqil benchmark farqi
Tadqiqot ishlab chiqaruvchilar tomonidan bildirilgan natijalar bilan mustaqil baholashlar o‘rtasida farqlar bo‘lishi mumkinligini va ishlab chiqaruvchi skorlari MMLU’da taxminan 2–8 foiz punkti, GPQA-Diamond va SWE-bench kabi yangiroq benchmark’larda ayrim hollarda taxminan 10–15 punkt yuqoriroq bo‘lishi mumkinligini bildiradi.
Mualliflar buning prompting usuli, baholash dasturi, model versiyasi va ehtimoliy evaluation-set contamination kabi omillardan kelib chiqishi mumkinligini aytadi. Shu bilan birga 2–8 va 10–15 punktlik farqlarni yuzaga keltirgan barcha juftlashtirilgan o‘lchovlarning xom ma’lumot jadvali maqolada taqdim etilmagan. Shu sababli bu oraliqlar mustaqil meta-analiz natijasi sifatida baholanmasligi kerak.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- Zamonaviy LLM oilalari bir xil asosiy Transformer ildizidan kelgan bo‘lsa-da, attention, normallashtirish, routing, context, multimodallik va alignment o‘lchamlarida sezilarli darajada farqlashadi.
- GQA, MQA, MLA, FlashAttention, MoE va state-space yondashuvlari katta miqyosli modellarda samaradorlik va uzun-ketma-ketlikni qayta ishlash muammolariga turli texnik yechimlar taklif qiladi.
- RLHF yagona alignment yondashuvi emas; Constitutional AI va RLAIF kabi alternativ yoki to‘ldiruvchi yondashuvlar ham ishlatiladi.
- Ochiq vaznli va yopiq model ishlab chiqish ekotizimlari shaffoflik, qayta ishlab chiqarish mumkinligi, xarajat va xavfsizlik muhandisligi bo‘yicha turli murosalarni o‘z ichiga oladi.
- Model tanlovi faqat benchmark skoriga emas, foydalanish sohasi, context ehtiyoji, multimodallik, xarajat, xavfsizlik va tarqatish sharoitlariga qarab amalga oshirilishi kerak.
- Benchmark natijalarini model versiyasi va baholash protokoli ma’lumotisiz bevosita taqqoslash ishonchli emas.
Tadqiqot isbotlamaydigan natijalar
- Har bir vazifa uchun bitta LLM oilasi mutlaq eng yaxshi ekani isbotlanmagan.
- Tablo 2 qiymatlari umumiy nazoratli tajribada olingan boshma-bosh model taqqoslashi emas.
- Bir benchmark farqi faqat bitta attention mexanizmi, MoE yoki alignment usuli tomonidan yaratilgani isbotlanmagan.
- Constitutional AI attention samaradorligi bilan zarur jismoniy trade-off hosil qilishi eksperimental ravishda ko‘rsatilmagan.
- Uzun context uchun sparse expert routing zarur shart ekani manba ma’lumotlari bilan isbotlanmaydi.
- Ochiq vaznli modellarning yopiq modellardan umuman xavfsizroq yoki xavfliroq ekani xulosasiga kelib bo‘lmaydi.
- Benchmark’dagi yuqori performans real dunyo ishonchliligi, factuality yoki xavfsiz foydalanish kafolati emas.
Turkiya nuqtai nazaridan nimani anglatadi?
Tadqiqot Turkiyaga xos LLM taqqoslashini qilmaydi va turkcha benchmark natijalarini alohida tajriba guruhi sifatida taqdim etmaydi. Shu sababli jadvalda yuqori natija ko‘rsatgan model turkcha huquq, sog‘liqni saqlash, ta’lim, sanoat yoki davlat amaliyotlarida xuddi shu performansni ko‘rsatadi deb faraz qilib bo‘lmaydi.
Turkiyadagi tashkilot uchun model tanlovi qilinadigan bo‘lsa, bu taksonomiya arxitektura bo‘yicha dastlabki saralash vositasi sifatida ishlatilishi mumkin; biroq turkcha til performansi, soha terminologiyasi, ma’lumot joylashuvi, shaxsiy ma’lumotlarni himoya qilish, kechikish, xarajat, ichki joylashtirish talablari va mahalliy foydalanish ssenariylari alohida sinovdan o‘tkazilishi kerak. Ushbu mahalliy tasdiqlash manba tadqiqot bajargan analiz emas.
Tadqiqot Usuli va Natijalari
Bu tadqiqot klassik sistematik sharhmi?
Maqola keng qamrovli sharh va taksonomiya tadqiqotidir; biroq manba matnda PRISMA singari sistematik adabiyot qidiruv protokoli, oldindan belgilangan ma’lumotlar bazasi qidiruv satrlari, kiritish/chiqarish oqim sxemasi yoki tadqiqot sifati meta-analizi taqdim etilmagan.
Mualliflar model tanlovini uch mezonga asoslaydi:
- texnik hujjatlashtirishning mavjudligi,
- arxitektura xilma-xilligi,
- tadqiqot va sanoat foydalanishi jihatidan ahamiyat.
Bu mezonlar bilan GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon va Qwen oilalari tanlangan.
Arxitekturalar qanday qayta tuzildi?
Mualliflar modellar arxitektura sxemalarini ommaga ochiq texnik hisobotlar, system card’lar va model hujjatlaridan qayta tuzgan. Ayniqsa yopiq tizimlarning implementation tafsilotlari e’lon qilinmagani uchun sxemalar yuqori darajada va umumiy abstraksiya darajasida saqlangan.
Baholangan asosiy arxitektura o‘lchamlari quyidagilardir:
- Multi-Head Attention (MHA), Grouped Query Attention (GQA), Multi-Query Attention (MQA) va Multi-Head Latent Attention (MLA),
- LayerNorm va RMSNorm,
- dense va mixture-of-experts routing,
- context handling va positional encoding,
- alignment va training pipeline’lari.
Taksonomiya qanday tuzildi?
Har bir model kategorik va sonli xususiyatlardan iborat xususiyat vektori bilan ifodalangan. Tadqiqot faqat ochiq hujjatlarda mavjud xususiyatlar kodlanganini va ma’lumot noaniq bo‘lganda ortiqcha tafsilotlardan qochish uchun “conservative labeling” qo‘llanganini bildiradi.
Keyin taksonomiya o‘lchamlari juft yoki ko‘p tomonlama munosabatlar orqali taqqoslangan. Masalan, alignment usuli attention samaradorligi bilan; context length expert routing bilan; model ochiqligi normallashtirish va positional encoding bilan birga o‘rganilgan.
Verianla Live: LLM taksonomiyasining tuzilish jarayoni
Bu jarayon manba tadqiqotning 3.1 bo‘limidagi metodologiyaga asoslanadi. “Natija” bosqichidagi strukturaviy naqshlar nazoratli eksperimental sababiylik emas, qiyosiy taksonomiyadan chiqarilgan xulosalardir.
| Bosqich | Manba tadqiqotdagi amal |
|---|---|
| 1. Model oilasi tanlovi | Hujjatlashtirish, arxitektura xilma-xilligi va tadqiqot/sanoat ahamiyati mezonlari bilan yetti oila tanlandi. |
| 2. Texnik manbalarni yig‘ish | Texnik hisobotlar, system card’lar va model hujjatlari ishlatildi. |
| 3. Arxitekturani qayta tuzish | 50 dan ortiq vakillik qiluvchi arxitektura umumiy abstraksiya darajasida qayta tuzildi. |
| 4. Xususiyatlarni kodlash | Attention, normallashtirish, routing, context, positional encoding, training va alignment o‘lchamlari kodlandi. |
| 5. Oilalararo taqqoslash | Taksonomiya o‘lchamlarining juft va ko‘p tomonlama munosabatlari o‘rganildi. |
| 6. Benchmark bilan bog‘lash | Taksonomiya naqshlari manbalarda bildirilgan benchmark natijalari bilan taqqoslandi. |
| 7. Gipoteza ishlab chiqarish | Alignment–efficiency, context–routing va open-weight convergence naqshlari taklif qilindi. |
Manbaning benchmark jadvali
Quyidagi qiymatlar maqolaning Tablo 2’sidan olingan. Manba tadqiqotning o‘z ogohlantirishi saqlanishi kerak: natijalar turli manba va protokollardan kelgani uchun qat’iy va bevosita model reytingi emas.
| Model oilasi | MMLU (%) | HumanEval Pass@1 (%) | GSM8K (%) | SWE-bench Pass@1 (%) | MathVista (%) |
|---|---|---|---|---|---|
| GPT-4 / GPT-4o | 86,4 | 67,0 | 92,0 | 33,2 | 63,8 |
| Claude 3.x (Opus/Sonnet) | 82,1 | 60,1 | 88,0 | 49,0 | 60,5 |
| Gemini 1.5 (Pro/Ultra) | 81,9 | 74,9 | 87,8 | 35,0 | 59,2 |
| LLaMA 2 (70B) | 68,9 | 48,1 | 56,8 | 18,0 | 44,1 |
| Falcon (180B/Falcon 2) | 66,5 | 45,2 | 55,4 | 15,3 | 41,6 |
| DeepSeek (V3/Reasoner) | 79,8 | 72,6 | 89,4 | 42,5 | 61,2 |
| Qwen (Qwen2/Qwen-Max) | 78,5 | 65,3 | 83,7 | 36,4 | 58,1 |
Benchmark’larning ma’nosi
| Benchmark | Tadqiqotdagi foydalanish maqsadi |
|---|---|
| MMLU | Turli bilim va muammo sohalarida umumiy til modeli performansi |
| HumanEval | Dasturlash/kod ishlab chiqarish performansi |
| GSM8K | Matematik so‘zli masala yechish |
| SWE-bench | Haqiqiy dasturiy ta’minot muhandisligi muammolari ustida kodlash qobiliyati |
| MathVista | Vizual va matematik mulohaza birlashgan vazifalar |
Model oilalarining context va multimodallik taqqoslashi
| Oila | Manbada bildirilgan context | Multimodal tuzilma | Moslashtirish / xavfsizlik |
|---|---|---|---|
| GPT-4 / GPT-4o | 128K GPT-4o | Matn, tasvir, ovoz, video | SFT, RLHF, PPO, moderatsiya va kontent filtrlari |
| GPT-O1 | 8K–32K | Matn | SFT, RLHF va reasoning yo‘naltirilgan mukofot modellari |
| LLaMA 2 | 4K | Matn | SFT, RLHF, Ghost Attention va safety reward modellari |
| Gemini 1.5 | 1M’gacha | Matn, tasvir, ovoz, video, kod | RLHF, expert gating va moderatsiya |
| Claude 2/3 | 100K–200K | Matn; Claude 3’da tasvir | Constitutional AI, RLAIF, self-critique va red teaming |
| Falcon | 4K–32K | Asosiy oila matn; Falcon 2’da VLM varianti | Safety classifier va LoRA asosidagi moslashtirish |
| DeepSeek R1/V3 | 32K–128K | Tadqiqotda asosan matn | GRPO, SFT, sintetik ma’lumot, rejection sampling |
| Qwen | 32K+ | Tadqiqotning qiyosiy jadvalida matn | SFT, RLHF, preference optimization va bias mitigation |
Taksonomiyaning benchmark farqlariga keltirgan izohi
Manba tadqiqotning Tablo 6’si uchta namunaviy benchmark farqini arxitektura o‘lchamlari bilan bog‘laydi:
| Benchmark | Oila A | Oila B | Skor farqi | Manba bog‘lagan taksonomiya o‘lchamlari |
|---|---|---|---|---|
| GSM8K | DeepSeek-V3: %89,4 | LLaMA 2: %56,8 | +32,6 foiz punkti | MLA/GQA, MTP/next-token prediction, rejection-sampled RL/Ghost Attention RLHF |
| SWE-bench | Claude 3.x: %49,0 | GPT-4o: %33,2 | +15,8 foiz punkti | Constitutional AI + RLAIF/RLHF-PPO va 200K/128K context |
| HumanEval | Gemini 1.5: %74,9 | LLaMA 2: %48,1 | +26,8 foiz punkti | MoE/dense Transformer va 1M/4K context |
Bu jadval bevosita mexanizm testi emas. Har bir taqqoslashda model oilalari ma’lumot, parametr, post-training, model versiyasi va evaluation protocol kabi ko‘plab boshqa o‘zgaruvchilarda ham farqlanadi. Manba tadqiqot buni ochiq tan olib, analizlar sababiylik emas, “structured explanatory hypotheses” hosil qilishini bildiradi.
Alignment–efficiency xulosasi nega gipoteza darajasida?
Mualliflar Claude’dagi Constitutional AI/RLAIF chuqurligi kamroq efficiency-optimized attention bilan birga ko‘rinishini, DeepSeek, Falcon va Gemini kabi attention samaradorligiga urg‘u beradigan oilalarda esa soddaroq moslashtirish liniyalari qo‘llanishini trade-off sifatida talqin qiladi.
Biroq tadqiqotda “alignment depth” va “attention efficiency” uchun umumiy miqdoriy skor aniqlanmagan; bir xil model ustida faqat alignment yoki faqat attention usuli o‘zgartirilib nazoratli ablatsiya qilinmagan. Shu sababli munosabat tadqiqotning taksonomik kuzatuvidir; hisoblash zaruriyati sifatida isbotlangan emas.
Context–routing xulosasidagi manba ichki nomuvofiqligi
Pattern B’ning asosiy jumlasi 32K’dan katta context window ishlatadigan har bir model sparse expert routing yoki selective state-space layer ishlatishini ilgari suradi.
Biroq shu maqolaning o‘z qiyosiy jadvalida:
- GPT-4o uchun 128K context,
- Claude 2/3 uchun 100K–200K context
bildirilgan bo‘lsa-da, bu oilalarning arxitektura izohlarida MoE yoki selective SSM routing berilmagan.
Shuning uchun “every >32K-context model” umumlashtirishi manba ichida izchil emas. Ushbu Verianla maqolasida mazkur naqsh faqat mualliflar taklif qilgan gipoteza sifatida berilgan.
Ochiq vaznli model yaqinlashuvi
Tadqiqotning Pattern C xulosasiga ko‘ra LLaMA 2, Falcon va Qwen kabi ochiq/ochiq vaznli tizimlar RoPE va RMSNorm kabi yaxshi ma’lum komponentlar atrofida ko‘proq klasterlashadi, yopiq modellar esa yanada geterogen dizayn maydonlariga tarqaladi.
Mualliflar buni ochiq model hamjamiyatlarida qayta ishlab chiqarilishi va tekshirilishi mumkin bo‘lgan komponentlarning tanlanishi bilan bog‘laydi. Ammo ayniqsa yopiq modellarning arxitektura tafsilotlari cheklanganligi sababli yopiq tizimlarning haqiqiy dizayn makoni to‘liq kuzatilmaydi. Bu xulosa ham tasdiqlangan sababiy mexanizm sifatida emas, qiyosiy taksonomiya talqini sifatida baholanishi kerak.
Biznes dunyosi va ijtimoiy natijalar
Tadqiqotga ko‘ra LLM’lar hujjat tayyorlash, kod ishlab chiqarish, ma’lumot tahlili va mijozlarni qo‘llab-quvvatlash kabi bilimga boy ishlarda mahsuldorlik salohiyatiga ega bo‘lsa-da, ravon, ammo xato kontent ishlab chiqarish, inson nazoratining kamayishi va noto‘g‘ri chiqishga ortiqcha ishonch kabi xavflarni keltirib chiqarishi mumkin.
Ta’limda shaxsiylashtirilgan fikr-mulohaza imkoniyatlari akademik halollik va tanqidiy fikrlash muammolari bilan birga ko‘rib chiqiladi. Kam resursli tillardagi performans farqlari esa nafaqat arxitektura, balki ma’lumot qamrovi va madaniy vakillik ham model xatti-harakatiga ta’sir qilishini ko‘rsatadi.
Tadqiqotning kelajakdagi tadqiqot mavzulari
- Standartlashtirilgan va qayta ishlab chiqariladigan LLM baholashi,
- kam resursli tillar va madaniy kontekstlarda cross-lingual generalization,
- uzun context va memory-augmented modellar,
- state-space va attention–memory gibridlari,
- model kartalari, ma’lumot varaqalari va bias audit mexanizmlari,
- red teaming va yanada shaffof xavfsizlik hisobotlari,
- hisoblash va energiya xarajatlarini kamaytirish,
- ma’lumot kelib chiqishi, intellektual mulk, maxfiylik va vakillik adolati.
Manba va Usul Haqida Izoh
| To‘liq asl tadqiqot nomi | Mapping the LLM Landscape: A Cross-Family Survey of Architectures, Alignment Methods, and Benchmark Performance |
|---|---|
| Mualliflar | Deepshikha Bhati; Fnu Neha; Devi Sri Bandaru; Matthew Weber; Ishan Dilipbhai Gajera |
| Mualliflar tartibi | 1. Deepshikha Bhati; 2. Fnu Neha; 3. Devi Sri Bandaru; 4. Matthew Weber; 5. Ishan Dilipbhai Gajera |
| Teng hissa / teng birinchi muallif | Manba tadqiqotda teng hissa yoki teng birinchi muallif bayonoti ko‘rsatilmagan. |
| Mas’ul muallif | Deepshikha Bhati |
| Muassasa | Department of Computer Science, Kent State University, Kent, Ohio, AQSH |
| Manba turi | Qiyosiy sharh, arxitektura taksonomiyasi va LLM model oilasi tahlili. |
| Hakamlik holati | Hakamli jurnalda chop etilgan sharh maqolasidir; preprint emas. |
| Jurnal | AI |
| Nashriyot | MDPI |
| Jild / son / maqola | 2026, 7(4), 142 |
| DOI | 10.3390/ai7040142 |
| Qabul qilingan sana | 11 Mart 2026 |
| Reviziya sanasi | 7 Aprel 2026 |
| Qabul sanasi | 11 Aprel 2026 |
| Nashr sanasi | 16 Aprel 2026 |
| Rasmiy havola | https://doi.org/10.3390/ai7040142 |
| Litsenziya | Creative Commons Attribution (CC BY). |
Tadqiqotning ma’lumot va analiz xususiyati
Bu tadqiqot yangi asosiy LLM o‘qitmaydi va yetti model oilasini umumiy hisoblash infratuzilmasida qayta benchmark qilmaydi. Asosiy ilmiy ma’lumot manbai ommaga ochiq texnik hisobotlar, system card’lar, model hujjatlari va benchmark manbalaridir.
Mualliflar bu hujjatlardan 50 dan ortiq model arxitekturasini umumiy abstraksiya darajasida qayta tuzgan, xususiyatlarini kodlagan va LLM Model Explorer ilovasi ichida yonma-yon taqqoslanadigan holga keltirgan.
Maqolaning ma’lumot mavjudligi bayonotiga ko‘ra analizda ishlatilgan ma’lumotlar asosiy matn ichida taqdim etilgan. Tadqiqot ishlab chiqqan LLM Model Explorer’ning manba kodi va jonli namoyish manzillari ham maqolaning usul bo‘limida ulashilgan.
Moliyalashtirish
Tadqiqot Kent State University’ning Open Access APC Support Fund dasturi tomonidan qisman qo‘llab-quvvatlangan.
Etika qo‘mitasi va xabardor rozilik
Manba tadqiqotda Institutional Review Board va informed consent maydonlari “Not applicable” deb bildirilgan. Tadqiqot inson ishtirokchilari ustida yangi tajriba yoki klinik ma’lumot to‘plashni o‘z ichiga olmaydi.
Manfaatlar to‘qnashuvi
Mualliflar manfaatlar to‘qnashuvi yo‘qligini bildirgan.
Muallif hissalari
Konseptuallashtirish: Deepshikha Bhati va Devi Sri Bandaru. Metodologiya: Deepshikha Bhati va Devi Sri Bandaru. Tasdiqlash: Deepshikha Bhati, Fnu Neha va Devi Sri Bandaru. Formal analiz: Deepshikha Bhati va Devi Sri Bandaru. Ko‘rib chiqish va tahrirlash: Deepshikha Bhati, Fnu Neha, Devi Sri Bandaru, Matthew Weber va Ishan Dilipbhai Gajera.
Tadqiqotning asosiy metodologik cheklovlari
- Model oilalari oldindan belgilangan sistematik adabiyot qidiruv protokoli o‘rniga hujjatlashtirish, xilma-xillik va ahamiyat mezonlari bilan tanlangan.
- Yopiq modellarning arxitektura va o‘qitish tafsilotlari to‘liq ochiqlanmagani uchun qayta tuzilgan sxemalar yuqori darajali abstraksiyalardir.
- 50 dan ortiq arxitekturaning barcha implementation tafsilotlari mustaqil ravishda tekshiriladigan emas.
- Benchmark skorlari bitta umumiy evaluation harness yordamida qayta hisoblanmagan.
- Ayrim benchmark qatorlari bitta model o‘rniga oiladagi bir nechta variantni birga ifodalaydi.
- Vendor-reported va independent benchmark natijalarining manbasi hujayra kesimida bitta jadvalda ajratilmagan.
- Benchmark natijalari prompting, model versiyasi, sana va baholash protokoli jihatidan farq qilishi mumkin.
- Taksonomiya o‘lchamlari orasidagi aloqalar kuzatuv/qiyosiy xarakterga ega; nazoratli ablatsiya tajribasi qilinmagan.
- Architecture–benchmark aloqalaridan sababiylik chiqarib bo‘lmaydi.
- Alignment depth va attention efficiency uchun umumiy miqdoriy indeks aniqlanmagan.
- “32K’dan uzun context’ga ega barcha modellar expert routing ishlatadi” xulosasi shu maqoladagi GPT-4o va Claude context ma’lumotlari bilan mos kelmaydi.
- Ochiq vaznli modellarning RMSNorm + RoPE yaqinlashuvi haqidagi talqin oila ichidagi barcha model variantlari uchun teng hujjatlashtirish darajasiga asoslanmaydi.
- Manba tadqiqot tez o‘zgaradigan texnologiya sohasini muayyan sana oralig‘ida xaritalaydi; taksonomiya kelajakdagi model avlodlarini avtomatik ravishda ifodalamaydi.
Manba ichidagi kritik nomuvofiqlikning ochiq qaydi
Manbaning Pattern B xulosasida “every model in our survey supporting context windows exceeding 32K tokens” uchun sparse expert routing yoki selective state-space yondashuvi mavjudligi ilgari suriladi. Bunga qarshi, shu tadqiqotning qiyosiy jadvali GPT-4o uchun 128K va Claude 2/3 uchun 100K–200K context window bergan holda, bu ikki oila uchun mazkur routing tuzilmalarini ko‘rsatmaydi. Shu sababli universal xarakterdagi Pattern B jumlasi manba ichidagi boshqa ma’lumotlar bilan izchil emas.
Pattern A va benchmark performansi izohlari uchun ham shunga o‘xshash tarzda sababiy qat’iylik ishlatilmasligi kerak. Tadqiqotning o‘zi benchmark farqlarini izohlarkan, mazkur analizlar causality hosil qilmasligini bildiradi.
Natijada tadqiqotning eng kuchli hissasi “qaysi LLM eng yaxshi?” savoliga qat’iy javob berishi emas. Asosiy hissa katta til modeli oilalarining arxitektura, o‘qitish, alignment, context, multimodallik va ochiqlik o‘lchamlarini bitta umumiy taqqoslash doirasiga joylashtirishi; model hujjatlaridan qayta tuzilgan arxitekturalarni tekshiriladigan taksonomiya va interaktiv vosita holiga keltirishidir.
Ushbu Verianla matnidagi ilmiy arxitektura izohlari, qiyosiy qiymatlar, xulosalar va cheklovlar yuklangan manba tadqiqotga asoslangan. Bibliografik identifikatsiya va hakamlik holatidan tashqari tashqi manbalardan yangi LLM performans natijasi asosiy ilmiy matnga qo‘shilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan