

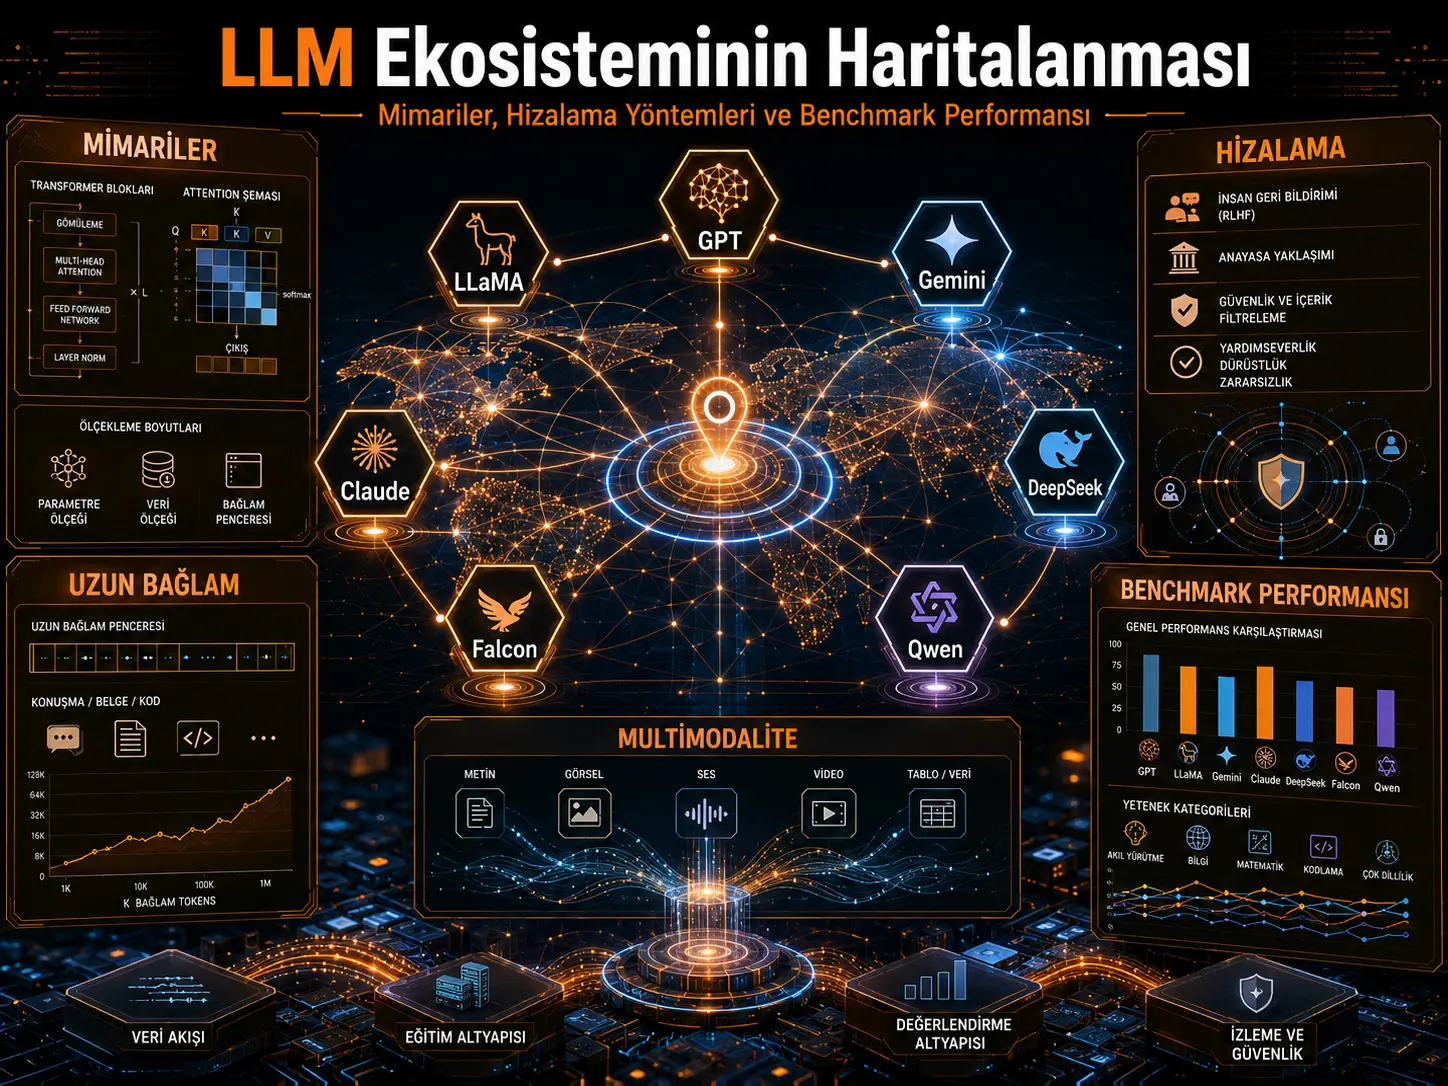
Моделҳои калони забонӣ дигар танҳо ҳамчун тавлидкунандагони матн бо параметрҳои бештар инкишоф намеёбанд. Системаҳои муосир аз маҷмӯи сершумори қарорҳои меъморӣ ва омӯзишӣ иборатанд: механизми attention чӣ гуна ҳисоб мешавад, кадом экспертҳо фаъол карда мешаванд, context бо дарозии садҳо ҳазор ё миллионҳо token чӣ гуна коркард мегардад, намудҳои гуногуни додаҳо мисли тасвир–садо–видео чӣ гуна муттаҳид карда мешаванд ва афзалиятҳои инсонӣ бо қоидаҳои амниятӣ чӣ гуна ба модел интиқол меёбанд. Ин таҳқиқоти шарҳӣ ҳадаф дорад ҳафт оилаи бузурги LLM, яъне GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon ва Qwen-ро зери як таксономияи муштарак муқоиса кунад.
Пажӯҳишгарон бо истифода аз гузоришҳои техникии оммавӣ, model card-ҳо ва ҳуҷҷатҳои моделӣ зиёда аз 50 меъмории намояндагии LLM-ро бозсозӣ кардаанд; моделҳоро аз рӯи чунин андозаҳо мисли механизми attention, нормализатсия, рамзгузории мавқеӣ, dense ё mixture-of-experts routing, идоракунии context, стратегияи омӯзиш, alignment ва қобилияти multimodal рамзгузорӣ кардаанд. Таҳқиқот инчунин барои баррасии интерактивии ин таксономия интерфейси кушодасарчашмаи LLM Model Explorer-ро пешниҳод мекунад.
Дар ҷадвали муқоисавии benchmark-и мақола оилаи GPT-4/GPT-4o дар MMLU %86,4 ва дар GSM8K %92,0; Gemini 1.5 дар HumanEval %74,9; Claude 3.x дар SWE-bench %49,0; оилаи DeepSeek дар GSM8K %89,4 ва дар SWE-bench %42,5 нишон дода шудааст. Аммо ин рақамҳо дар як иҷрои умумии benchmark тавлид нашудаанд. Онҳо аз версияҳои гуногуни модел, гузоришҳои истеҳсолкунандагон, leaderboard-ҳо, усулҳои prompting ва протоколҳои арзёбӣ гирд оварда шудаанд. Аз ин рӯ, таҳқиқоти манбаъ ба таври равшан қайд мекунад, ки арзишҳо хусусияти нишондиҳанда доранд ва байни моделҳо комилан мустақим муқоиса карда намешаванд.
Саҳми асосии таҳқиқот на эълон кардани он аст, ки кадом як LLM “ғолиб” мебошад, балки намоён сохтани он аст, ки моделҳои калони забонии муосир дар кадом меҳварҳои тарроҳӣ аз ҳам фарқ мекунанд. Тамоюлҳои асосие, ки шарҳ пешниҳод мекунад, инҳоянд: гузариш ба механизмҳои муассиртари attention, ҷустуҷӯи ҳисоббарории модулӣ барои context-и дароз, густариши ҷузъҳо мисли RoPE ва RMSNorm дар моделҳои кушодавзн, афзоиши системаҳои multimodal ва марказӣ шудани усулҳои alignment мисли RLHF, RLAIF ё Constitutional AI дар рушди модел.
Бо вуҷуди ин, баъзе хулосаҳои қавие, ки аз таксономия бароварда шудаанд, қонунҳои меъмории ба таври таҷрибавӣ тасдиқшуда нестанд. Хусусан хулосаи “ҳамаи моделҳое, ки context аз 32K дарозтар доранд, sparse expert routing истифода мебаранд” бо ҷадвалҳои context-и худи таҳқиқот барои GPT-4o ва Claude мувофиқ нест. Шарҳҳое, ки фарқҳои benchmark-ро ба хусусиятҳои муайяни меъморӣ мепайванданд, низ на аз таҷрибаҳои контролшудаи ablation, балки аз муқоисаҳои мушоҳидавии байни оилаҳо бароварда шудаанд.
| Доираи таҳқиқот | Сохтори дар манбаъ гузоришшуда | Чӣ гуна бояд тафсир шавад? |
|---|---|---|
| Оилаи LLM | 7 | GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon ва Qwen |
| Меъмории бозсозишуда | 50+ | Аз ҳуҷҷатҳои техникӣ ва model card-ҳо дар сатҳи баланд бозсозӣ шудааст. |
| Меҳварҳои асосии муқоиса | Меъморӣ, омӯзиш, alignment, context, multimodality, амният, benchmark | Зери як таксономияи муштарак баррасӣ шудааст. |
| Усули benchmark | Натиҷаҳои гузоришшуда аз манбаъҳои дуюмдараҷа | Натиҷаҳое нестанд, ки дар муҳити умумии таҷрибавӣ дубора чен шуда бошанд. |
| Абзори интерактивӣ | LLM Model Explorer | Муқоисаи хусусиятҳои таксономияро дар сатҳи модел таъмин мекунад. |
| Ҳадди асосии илмӣ | Муқоисаи меъмории сабабии контролшуда вуҷуд надорад | Робитаҳои таксономӣ гипотеза тавлид мекунанд; сабабиятро исбот намекунанд. |
Чаро танҳо саволи “чанд миллиард параметр?” дигар кофӣ нест?
Дар наслҳои аввали моделҳои калони забонӣ афзоиши миқёс яке аз меҳварҳои асосии пешрафт буд. Дар нақли таърихии таҳқиқот гузариш аз равиши омӯзиши пешакии миқёси калони GPT-2 дар соли 2019 то GPT-3 бо 175 миллиард параметр ва баъдан пайдоиши моделҳои context-и дароз ва multimodal тасвир карда мешавад.
Аммо ба гуфтаи пажӯҳишгарон, майдони тарроҳии LLM-и муосир дигар ба як меҳвари ягонаи бузургӣ коҳиш дода намешавад. Ду система бо шумораи параметрҳои наздик метавонанд бо сабаби механизми attention, шумораи экспертҳои фаъол, усули нормализатсия, рамзгузории мавқеӣ, омехтаи додаҳо, instruction tuning, alignment ё сохтори multimodal encoder профилҳои хеле гуногуни ҳисоббарорӣ ва рафторӣ нишон диҳанд.
Таҳқиқот кадом ҳафт оилаи моделро меомӯзад?
| Оилаи модел | Моделҳои намояндагии дар манбаъ баррасишуда | Хусусияти асосие, ки таҳқиқот таъкид мекунад |
|---|---|---|
| GPT | GPT-2, GPT-3/3.5, GPT-4, GPT-4o, O1 | Decoder-only Transformer, омӯзиши пешакии миқёси калон, multimodality ва RLHF |
| LLaMA | LLaMA, LLaMA 2, Code LLaMA | RoPE, GQA, RMSNorm ва экосистемаи кушодавзн |
| Gemini | Gemini 1.x ва Gemini 1.5 | Multimodality, context-и дароз ва сохторе, ки дар манбаъ ҳамчун MoE тавсиф шудааст |
| Claude | Claude 2, Claude 3 ва вариантҳои 3.5 | Context-и дароз, Constitutional AI ва RLAIF |
| DeepSeek | DeepSeek-V2/V3 ва Reasoner/R1 | MLA, MoE ва омӯзиши ба reasoning нигаронидашуда |
| Falcon | Falcon 7B/40B/180B, Falcon 2, Falcon 3 ва Mamba | Multi-query/multigroup attention ва вариантҳои state-space |
| Qwen | Qwen, Qwen2 ва Qwen-Max | RoPE, RMSNorm, SwiGLU, бисёрзабонӣ ва тахассус дар код/математика |
Чаро механизмҳои attention фарқ мекунанд?
Multi-head attention дар Transformer-и классикӣ барои ҳар attention head projection-ҳои ҷудогонаи query, key ва value истифода мебарад. Дар моделҳои калон, махсусан key–value cache дар шароити context-и дароз ва сарбории зиёди ҳамзамони корбарон ба харҷи муҳими хотира табдил меёбад.
Таҳқиқот таъкид мекунад, ки оилаҳои гуногун ба ин масъала ҳалли гуногун пешниҳод мекунанд. Дар LLaMA 2 Grouped Query Attention (GQA), дар оилаи Falcon ва Qwen multi-query ё multigroup attention ва дар DeepSeek равишҳое мисли Multi-Head Latent Attention (MLA) барои кам кардани ин харҷ равона шудаанд.
Равиши MLA-и DeepSeek мехоҳад намояндагии key–value-ро ба representation-ҳои latent-и андозаи пасттар фишурда, бори ҳисоббарорӣ ва нигоҳдориро кам кунад. Равиши multi-query/multigroup-и Falcon низ ба коҳиши бори KV-cache тавассути бештар муштарак кардани projection-ҳои key ва value миёни attention head-ҳо нигаронида шудааст.
Mixture-of-Experts чӣ медиҳад?
Дар равиши Mixture-of-Experts (MoE) ҳамаи параметрҳои модел барои ҳар token дар як вақт фаъол намешаванд. Механизми routing вобаста ба воридот зершакабаҳои муайяни экспертиро интихоб мекунад. Ҳамин тавр, ҳангоми афзоиши иқтидори умумии модел, ҳисоббарории фаъол барои ҳар token метавонад аз шумораи умумии параметрҳо пасттар нигоҳ дошта шавад.
Таҳқиқоти манбаъ ин равишро махсусан бо стратегияҳои миқёспазирӣ ва context-и дарози оилаҳои Gemini ва DeepSeek пайваст мекунад. Барои DeepSeek-R1 дар муқобили 671 миллиард параметри умумӣ, маълумоти тақрибан 37 миллиард параметри фаъол барои ҳар token дода мешавад.
Аммо мавҷудияти MoE худ ба худ ҳамчун сабаби reasoning-и беҳтар, context-и дарозтар ё performans-и баландтари benchmark қабул шуда наметавонад. Усули routing, додаҳои омӯзишӣ, шумораи экспертҳои фаъол, меъмории attention ва раванди post-training якҷоя ба натиҷаҳо таъсир мерасонанд.
Чаро Falcon Mamba фарқ мекунад?
Falcon Mamba 7B аз ҷумлаи фарқиятҳои муҳими меъморӣ дар таҳқиқот аст, зеро ба ҷои self-attention-и классикӣ модели Mamba state-space-ро истифода мебарад. Манбаъ қайд мекунад, ки ин равиш коркарди вақтӣ-хаттӣ ва рафтори хотираи тақрибан собитро дар пайдарпайиҳои дароз ҳадаф мегирад.
Ҳузури ҳамзамони равишҳои Transformer ва state-space дар оилаи Falcon 3 нишон медиҳад, ки рушди LLM-и муосир дигар танҳо аз вариатсияҳои дохили Transformer иборат нест, балки меъмориҳои берун аз attention барои пайдарпайиҳои дарозро низ дар бар мегирад.
Чаро RMSNorm, RoPE ва SwiGLU зиёд дида мешаванд?
Дар таксономияи таҳқиқот дар як қисми оилаҳои моделҳои кушодавзн такрори се ҷузъ зиёд дида мешавад: RMSNorm, Rotary Positional Embedding (RoPE) ва SwiGLU.
RMSNorm харҷи нормализатсияро содатар мекунад; RoPE бошад иттилооти мавқеи нисбиро ба дохили механизми attention мебарад. SwiGLU аз сохтори gated activation истифода мекунад. Таҳқиқот LLaMA 2 ва Qwen-ро ҳамчун намунаҳои равшани ин ҷузъҳо баррасӣ мекунад.
Дар моделҳои multimodal чӣ тағйир меёбад?
Барои коркарди иттилооти ғайриматнӣ, аз ҷумла тасвир, садо ва видео, кофӣ нест, ки модел танҳо аз як tokenizer ва decoder-и забонӣ иборат бошад. Дар таҳқиқот Gemini, GPT-4o ва Claude 3 ҳамчун намунаҳои гуногуни ин гузариш баррасӣ мешаванд.
Дар нақшаи меъмории Gemini нишон дода мешавад, ки намудҳои гуногуни додаҳо тавассути modality-specific encoder-ҳо коркард шуда, бо роҳи cross-modal attention ба як фазои муштараки latent гузаронида мешаванд. Таҳқиқот GPT-4o-ро ҳамчун тарҳи муттаҳиди multimodal баррасӣ мекунад, ки метавонад матн, код, тасвир, садо ва видеоро коркард кунад.
Ҳамсозӣ: RLHF чӣ мекунад?
Reinforcement Learning from Human Feedback (RLHF) яке аз усулҳои post-training аст, ки барои он истифода мешавад, то модели пешакӣ омӯзишдида ба ҷои танҳо оптимизатсияи эҳтимолияти token-и навбатӣ, натиҷаҳое диҳад, ки бо афзалиятҳои инсон бештар мувофиқ бошанд.
Таҳқиқоти манбаъ тавзеҳ медиҳад, ки дар оилаҳое мисли GPT-4, LLaMA 2, Claude, DeepSeek ва Qwen шаклҳои гуногуни supervised fine-tuning ва оптимизатсияи афзалият истифода шудаанд.
Бо вуҷуди ин, муаллифон таъкид мекунанд, ки RLHF амниятро ба таври қатъӣ ҳал намекунад. Feedback-и инсонӣ гарон аст; reward hacking метавонад пайдо шавад; омӯзиши амният метавонад ба рафтори аз ҳад зиёд радкунанда оварда расонад ва хатарҳои jailbreak ё adversarial prompting комилан аз байн намераванд.
Constitutional AI ва RLAIF чист?
Оилаи Claude дар таҳқиқот аз нигоҳи равиши alignment ҳамчун категорияи ҷудогона баррасӣ мешавад. Дар Constitutional AI ҳадаф ин аст, ки модел дар доираи принсипҳои муайян натиҷаи худро танқид ва аз нав танзим кунад. Reinforcement Learning from AI Feedback (RLAIF) бошад дастгирии як қисми арзёбии инсонро бо feedback-и аз тарафи AI додашуда дар бар мегирад.
Муаллифони манбаъ изҳор мекунанд, ки ин равиш метавонад вобастагӣ ба аннотатсияи инсонро кам кунад, аммо feedback-и AI хатари дубора тавлид кардани ғаразҳои аз модел сарчашмагирифтаро дорад.
Се намунаи асосии таксономия
Мақола пас аз ҷойгир кардани ҳафт оилаи модел дар андозаҳои муштарак се намунаи байниоилавиро пешниҳод мекунад.
| Намунаи манбаъ | Меҳварҳои муқоисашуда | Хулосаи муаллифон | Ҳадди тафсири Verianla |
|---|---|---|---|
| A — Alignment–Efficiency Divergence | Стратегияи alignment × оптимизатсияи attention | Пешниҳод мешавад, ки alignment-и амиқ ва самаранокии пешрафтаи attention дар як модел ҳамзамон дида намешаванд. | Ин санҷиши performans-и контролшуда дар ду меҳвари миқдоран муайяншуда нест. |
| B — Context–Routing Co-Adoption | Дарозии context × expert routing | Пешниҳод мешавад, ки моделҳои дорои context-и >32K sparse/modular routing истифода мекунанд. | Ифодаи умумӣ бо ҷадвалҳои GPT-4o ва Claude дар манбаъ мувофиқат намекунад. |
| C — Open-Weight Convergence | Кушодагӣ × нормализатсия × рамзгузории мавқеӣ | Пешниҳод мешавад, ки моделҳои кушодавзн дар атрофи RMSNorm + RoPE ҷамъ мешаванд. | Барои ҳамаи вариантҳои дохили оилаи модел сатҳи якхелаи шаффофияти техникӣ вуҷуд надорад. |
Чаро номутобиқатии дохилии Pattern B муҳим аст?
Матни Pattern B-и таҳқиқот мегӯяд, ки дар байни моделҳои баррасишуда “ҳар модел”-е, ки context window-и дарозтар аз 32K медиҳад, sparse expert routing ё қабатҳои selective state-space истифода мекунад.
Аммо ҷадвали муқоисавии ҳамон манбаъ барои GPT-4/GPT-4o 128K ва барои Claude 2/3 100K–200K context window гузориш медиҳад. Дар хулосаҳои меъмории марбут ба ин ду оила sparse MoE ё selective state-space routing зикр нашудааст.
Аз ин рӯ, додаҳои дохили манбаъ метавонанд тафсири “ҳамроҳ дида шудани context-и дароз ва ҳисоббарории модулӣ дар баъзе оилаҳо”-ро дастгирӣ кунанд; аммо хулосаи “ҳамаи моделҳои болотар аз 32K инро истифода мекунанд”-ро аз рӯи ҷадвалҳои худ дастгирӣ намекунанд.
Оё “модели кушода” ва “манбаи кушода” як чизанд?
Дар таҳқиқоти манбаъ моделҳо дар категорияҳои гуногун баррасӣ мешаванд: пӯшида, кушодавзн, қисман кушода ё дорои иҷозатномаи таҳқиқотӣ. Ин фарқ муҳим аст. Нашри вазнҳои модел маънои онро надорад, ки додаҳои омӯзишӣ, коди пурраи омӯзиш, хатти post-training ва тамоми системаи амниятӣ кушодаанд.
Аз ин рӯ, ҳангоми хондани ибораи “open-source ecosystem” дар таҳқиқот бояд ба назар гирифт, ки сатҳи воқеии кушодагӣ барои ҳар оила метавонад фарқ кунад.
Чаро натиҷаҳои benchmark як ҷадвали ягонаи лига нестанд?
Tablo 2-и мақола панҷ benchmark-ро паҳлу ба паҳлу медиҳад: MMLU, HumanEval, GSM8K, SWE-bench ва MathVista. Аммо ҳамаи ҳуҷайраҳои ҷадвал зери як версияи модел, як сана, як стратегияи prompting ё як evaluation harness чен нашудаанд.
Илова бар ин, ҷадвал дар баъзе сатрҳо як моделро не, балки якчанд вариантро дар дохили як оила якҷоя намояндагӣ мекунад: мисли “GPT-4/GPT-4o”, “Claude 3.x (Opus/Sonnet)”, “Gemini 1.5 (Pro/Ultra)” ё “DeepSeek (V3/Reasoner)”.
Аз ин рӯ, набояд фарз кард, ки скори MMLU дар як сатр ва скори SWE-bench дар ҳамон сатр ҳатман аз ҳамон checkpoint ё ҳамон варианти модел омадаанд.
Фарқи benchmark-и истеҳсолкунанда ва мустақил
Таҳқиқот мегӯяд, ки байни натиҷаҳои гузоришшуда аз ҷониби истеҳсолкунандагон ва арзёбиҳои мустақил фарқҳо буда метавонанд ва скорҳои истеҳсолкунандагон дар MMLU тақрибан 2–8 нуқтаи фоизӣ, дар benchmark-ҳои навтар мисли GPQA-Diamond ва SWE-bench бошад дар баъзе ҳолатҳо тақрибан 10–15 нуқта баландтар буда метавонанд.
Муаллифон қайд мекунанд, ки ин метавонад аз усули prompting, нармафзори арзёбӣ, версияи модел ва эҳтимоли evaluation-set contamination сарчашма гирад. Бо вуҷуди ин, ҷадвали хоми ҳамаи ченишҳои ҷуфтшуда, ки ин фарқҳои 2–8 ва 10–15 нуқтаро ба вуҷуд меоранд, дар мақола пешниҳод нашудааст. Аз ин рӯ, ин фосилаҳо набояд ҳамчун натиҷаи meta-analysis-и мустақил арзёбӣ шаванд.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Оилаҳои LLM-и муосир, ҳарчанд аз як решаи асосии Transformer сарчашма мегиранд, дар андозаҳои attention, нормализатсия, routing, context, multimodality ва alignment ба таври назаррас фарқ мекунанд.
- Равишҳои GQA, MQA, MLA, FlashAttention, MoE ва state-space барои масъалаҳои самаранокӣ ва коркарди пайдарпайиҳои дароз дар моделҳои миқёси калон ҳалли техникии гуногун пешниҳод мекунанд.
- RLHF ягона равиши alignment нест; равишҳои алтернативӣ ё пуркунанда мисли Constitutional AI ва RLAIF низ истифода мешаванд.
- Экосистемаҳои рушди моделҳои кушодавзн ва пӯшида аз нигоҳи шаффофият, бозтавлидпазирӣ, харҷ ва муҳандисии амният созишҳои гуногун доранд.
- Интихоби модел бояд на танҳо аз рӯи benchmark score, балки аз рӯи соҳаи истифода, ниёзи context, multimodality, харҷ, амният ва шароити deployment анҷом дода шавад.
- Муқоисаи мустақими натиҷаҳои benchmark бе иттилоъ дар бораи версияи модел ва протоколи арзёбӣ боэътимод нест.
Натиҷаҳое, ки таҳқиқот исбот намекунад
- Исбот нашудааст, ки барои ҳар вазифа як оилаи ягонаи LLM мутлақан беҳтарин аст.
- Арзишҳои Tablo 2 муқоисаи сарбасари моделҳо нестанд, ки дар таҷрибаи умумии контролшуда ба даст омада бошанд.
- Исбот нашудааст, ки фарқи benchmark танҳо аз як механизми attention, MoE ё усули alignment ба вуҷуд омадааст.
- Ба таври таҷрибавӣ нишон дода нашудааст, ки Constitutional AI бо самаранокии attention trade-off-и ҷисмонии ҳатмӣ месозад.
- Маълумоти манбаъ исбот намекунад, ки sparse expert routing барои context-и дароз шарти ҳатмӣ аст.
- Наметавон хулоса кард, ки моделҳои кушодавзн дар умум аз моделҳои пӯшида амнтар ё ноамнтаранд.
- Performans-и баланд дар benchmark кафолати боэътимодӣ, factuality ё истифодаи амн дар ҷаҳони воқеӣ нест.
Аз нигоҳи Туркия чӣ маъно дорад?
Таҳқиқот муқоисаи махсуси LLM барои Туркия анҷом намедиҳад ва натиҷаҳои benchmark-и туркиро ҳамчун гурӯҳи таҷрибавии ҷудогона пешниҳод намекунад. Аз ин рӯ, фарз кардан мумкин нест, ки моделе, ки дар ҷадвал натиҷаи баланд нишон медиҳад, дар ҳуқуқ, тандурустӣ, маориф, саноат ё барномаҳои давлатӣ ба забони туркӣ ҳамон performans-ро нишон медиҳад.
Агар барои як ташкилот дар Туркия интихоби модел анҷом дода шавад, ин таксономия метавонад ҳамчун абзори пешфилтркунии меъморӣ истифода шавад; аммо performans-и забони туркӣ, истилоҳоти соҳа, ҷойгиршавии додаҳо, ҳифзи додаҳои шахсӣ, таъхир, харҷ, талаботи мизбонии дохилисозмонӣ ва сенарияҳои маҳаллии истифода бояд ҷудогона санҷида шаванд. Ин тасдиқи маҳаллӣ таҳлиле нест, ки таҳқиқоти манбаъ анҷом додааст.
Усул ва Натиҷаҳои Таҳқиқот
Оё ин таҳқиқот шарҳи классикии систематикӣ аст?
Мақола як таҳқиқоти васеи шарҳӣ ва таксономӣ мебошад; аммо дар матни манбаъ протоколи ҷустуҷӯи систематикии адабиёт монанди PRISMA, сатрҳои пешакӣ муайяншудаи ҷустуҷӯ дар пойгоҳҳои додаҳо, нақшаи ҷараёни дохилкунӣ/истисно ё meta-analysis-и сифати таҳқиқот пешниҳод нашудааст.
Муаллифон интихоби моделро ба се меъёр асос мекунанд:
- мавҷудияти ҳуҷҷатгузории техникӣ,
- гуногунии меъморӣ,
- аҳамият аз нигоҳи таҳқиқот ва истифодаи саноатӣ.
Бо ин меъёрҳо оилаҳои GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon ва Qwen интихоб шудаанд.
Меъмориҳо чӣ гуна бозсозӣ шуданд?
Муаллифон нақшаҳои меъмории моделҳоро аз гузоришҳои техникии оммавӣ, system card-ҳо ва ҳуҷҷатҳои моделӣ бозсозӣ кардаанд. Азбаски ҷузъиёти implementation-и системаҳои пӯшида нашр нашудааст, нақшаҳо дар сатҳи баланд ва дар сатҳи умумии абстраксия нигоҳ дошта шудаанд.
Андозаҳои асосии меъмории арзёбишуда чунинанд:
- Multi-Head Attention (MHA), Grouped Query Attention (GQA), Multi-Query Attention (MQA) ва Multi-Head Latent Attention (MLA),
- LayerNorm ва RMSNorm,
- dense ва mixture-of-experts routing,
- context handling ва positional encoding,
- alignment ва training pipeline-ҳо.
Таксономия чӣ гуна сохта шуд?
Ҳар модел бо вектори хусусиятҳо намояндагӣ шудааст, ки аз хусусиятҳои категориявӣ ва ададӣ иборат аст. Таҳқиқот қайд мекунад, ки танҳо хусусиятҳои дар ҳуҷҷатҳои кушода мавҷудбуда рамзгузорӣ шудаанд ва ҳангоми номуайян будани иттилоот барои пешгирӣ аз зиёдаравӣ дар ҷузъиёт “conservative labeling” истифода шудааст.
Сипас андозаҳои таксономия тавассути робитаҳои дугона ё чандгона муқоиса шудаанд. Масалан, усули alignment бо самаранокии attention; context length бо expert routing; кушодагии модел бо нормализатсия ва positional encoding якҷоя баррасӣ шудаанд.
Verianla Live: Раванди сохтани таксономияи LLM
Ин раванд ба методологияи қисми 3.1-и таҳқиқоти манбаъ асос меёбад. Намунаҳои сохтории марҳилаи “Натиҷа” сабабияти таҷрибавии контролшуда нестанд, балки хулосаҳоест, ки аз таксономияи муқоисавӣ бароварда шудаанд.
| Марҳила | Амал дар таҳқиқоти манбаъ |
|---|---|
| 1. Интихоби оилаи модел | Бо меъёрҳои ҳуҷҷатгузорӣ, гуногунии меъморӣ ва аҳамияти таҳқиқот/саноат ҳафт оила интихоб шуд. |
| 2. Ҷамъоварии манбаъҳои техникӣ | Гузоришҳои техникӣ, system card-ҳо ва ҳуҷҷатҳои моделӣ истифода шуданд. |
| 3. Бозсозии меъморӣ | Зиёда аз 50 меъмории намояндагӣ дар сатҳи умумии абстраксия бозсозӣ шуд. |
| 4. Рамзгузории хусусиятҳо | Андозаҳои attention, нормализатсия, routing, context, positional encoding, training ва alignment рамзгузорӣ шуданд. |
| 5. Муқоисаи байниоилавӣ | Робитаҳои дугона ва чандгонаи андозаҳои таксономия баррасӣ шуданд. |
| 6. Пайванд додан бо benchmark | Намунаҳои таксономӣ бо натиҷаҳои benchmark-и дар манбаъҳо гузоришшуда муқоиса шуданд. |
| 7. Тавлиди гипотеза | Намунаҳои alignment–efficiency, context–routing ва open-weight convergence пешниҳод шуданд. |
Ҷадвали benchmark-и манбаъ
Арзишҳои зерин аз Tablo 2-и мақола гирифта шудаанд. Огоҳии худи таҳқиқоти манбаъ бояд нигоҳ дошта шавад: азбаски натиҷаҳо аз манбаъҳо ва протоколҳои гуногун меоянд, онҳо рейтинги қатъӣ ва мустақими моделҳо нестанд.
| Оилаи модел | MMLU (%) | HumanEval Pass@1 (%) | GSM8K (%) | SWE-bench Pass@1 (%) | MathVista (%) |
|---|---|---|---|---|---|
| GPT-4 / GPT-4o | 86,4 | 67,0 | 92,0 | 33,2 | 63,8 |
| Claude 3.x (Opus/Sonnet) | 82,1 | 60,1 | 88,0 | 49,0 | 60,5 |
| Gemini 1.5 (Pro/Ultra) | 81,9 | 74,9 | 87,8 | 35,0 | 59,2 |
| LLaMA 2 (70B) | 68,9 | 48,1 | 56,8 | 18,0 | 44,1 |
| Falcon (180B/Falcon 2) | 66,5 | 45,2 | 55,4 | 15,3 | 41,6 |
| DeepSeek (V3/Reasoner) | 79,8 | 72,6 | 89,4 | 42,5 | 61,2 |
| Qwen (Qwen2/Qwen-Max) | 78,5 | 65,3 | 83,7 | 36,4 | 58,1 |
Маънои benchmark-ҳо
| Benchmark | Ҳадафи истифода дар таҳқиқот |
|---|---|
| MMLU | Performans-и умумии модели забонӣ дар соҳаҳои гуногуни дониш ва масъала |
| HumanEval | Performans-и барномасозӣ/тавлиди код |
| GSM8K | Ҳалли масъалаҳои матнии математикӣ |
| SWE-bench | Қобилияти коднависӣ дар масъалаҳои воқеии муҳандисии нармафзор |
| MathVista | Вазифаҳое, ки reasoning-и визуалӣ ва математикӣ якҷоя мешаванд |
Муқоисаи context ва multimodality-и оилаҳои моделӣ
| Оила | Context-и дар манбаъ гузоришшуда | Сохтори multimodal | Alignment / амният |
|---|---|---|---|
| GPT-4 / GPT-4o | 128K GPT-4o | Матн, тасвир, садо, видео | SFT, RLHF, PPO, модератсия ва филтрҳои муҳтаво |
| GPT-O1 | 8K–32K | Матн | SFT, RLHF ва моделҳои мукофотии ба reasoning нигаронидашуда |
| LLaMA 2 | 4K | Матн | SFT, RLHF, Ghost Attention ва моделҳои safety reward |
| Gemini 1.5 | то 1M | Матн, тасвир, садо, видео, код | RLHF, expert gating ва модератсия |
| Claude 2/3 | 100K–200K | Матн; дар Claude 3 тасвир | Constitutional AI, RLAIF, self-critique ва red teaming |
| Falcon | 4K–32K | Оилаи асосӣ матн; дар Falcon 2 варианти VLM | Safety classifier ва alignment дар асоси LoRA |
| DeepSeek R1/V3 | 32K–128K | Дар таҳқиқот асосан матн | GRPO, SFT, додаҳои синтетикӣ, rejection sampling |
| Qwen | 32K+ | Дар ҷадвали муқоисавии таҳқиқот матн | SFT, RLHF, preference optimization ва bias mitigation |
Тавзеҳи таксономия барои фарқҳои benchmark
Tablo 6-и таҳқиқоти манбаъ се фарқи намунавии benchmark-ро бо андозаҳои меъморӣ мепайвандад:
| Benchmark | Оилаи A | Оилаи B | Фарқи score | Андозаҳои таксономие, ки манбаъ пайваст мекунад |
|---|---|---|---|---|
| GSM8K | DeepSeek-V3: %89,4 | LLaMA 2: %56,8 | +32,6 нуқтаи фоизӣ | MLA/GQA, MTP/next-token prediction, rejection-sampled RL/Ghost Attention RLHF |
| SWE-bench | Claude 3.x: %49,0 | GPT-4o: %33,2 | +15,8 нуқтаи фоизӣ | Constitutional AI + RLAIF/RLHF-PPO ва 200K/128K context |
| HumanEval | Gemini 1.5: %74,9 | LLaMA 2: %48,1 | +26,8 нуқтаи фоизӣ | MoE/dense Transformer ва 1M/4K context |
Ин ҷадвал санҷиши мустақими механизм нест. Дар ҳар муқоиса оилаҳои моделӣ дар бисёр тағйирёбандаҳои дигар низ фарқ мекунанд, аз ҷумла дода, параметр, post-training, версияи модел ва evaluation protocol. Таҳқиқоти манбаъ инро ошкоро қабул карда, мегӯяд, ки таҳлилҳо на сабабият, балки “structured explanatory hypotheses” месозанд.
Чаро хулосаи alignment–efficiency дар сатҳи гипотеза аст?
Муаллифон якҷоя дида шудани амиқии Constitutional AI/RLAIF дар Claude бо attention-и камтар efficiency-optimized ва дар оилаҳое мисли DeepSeek, Falcon ва Gemini, ки ба самаранокии attention бештар аҳамият медиҳанд, истифода шудани хатҳои содатари alignment-ро ҳамчун trade-off тафсир мекунанд.
Аммо дар таҳқиқот барои “alignment depth” ва “attention efficiency” score-и умумии миқдорӣ муайян нашудааст; дар як модел танҳо усули alignment ё танҳо усули attention иваз карда шуда, ablation-и контролшуда анҷом дода нашудааст. Аз ин рӯ, робита мушоҳидаи таксономии таҳқиқот аст; ҳамчун зарурати ҳисоббарорӣ исбот нашудааст.
Номутобиқатии дохилии манбаъ дар хулосаи Context–routing
Ҷумлаи асосии Pattern B иддао мекунад, ки ҳар модели дорои context window аз 32K калон sparse expert routing ё selective state-space layer истифода мекунад.
Аммо дар ҷадвали муқоисавии худи ҳамон мақола:
- барои GPT-4o 128K context,
- барои Claude 2/3 100K–200K context
гузориш шудааст, дар ҳоле ки дар тавзеҳоти меъмории ин оилаҳо MoE ё selective SSM routing дода нашудааст.
Аз ин рӯ, умумисозии “every >32K-context model” дар дохили манбаъ пайваста нест. Дар ин мақолаи Verianla намунаи мазкур танҳо ҳамчун гипотезаи пешниҳодкардаи муаллифон оварда шудааст.
Наздикшавии моделҳои кушодавзн
Мувофиқи хулосаи Pattern C-и таҳқиқот, системаҳои кушода/кушодавзн мисли LLaMA 2, Falcon ва Qwen бештар дар атрофи ҷузъҳои хуб шинохташуда мисли RoPE ва RMSNorm ҷамъ мешаванд, дар ҳоле ки моделҳои пӯшида ба майдонҳои тарроҳии гетерогенӣ бештар паҳн мешаванд.
Муаллифон инро бо афзал донистани ҷузъҳои бозтавлидшаванда ва санҷишпазир дар ҷомеаҳои моделҳои кушода пайваст мекунанд. Аммо азбаски махсусан ҷузъиёти меъмории моделҳои пӯшида маҳдуд аст, тамоми фазои воқеии тарроҳии системаҳои пӯшида мушоҳида карда намешавад. Ин хулоса низ бояд на ҳамчун механизми сабабии тасдиқшуда, балки ҳамчун тафсири таксономии муқоисавӣ арзёбӣ шавад.
Натиҷаҳои тиҷоратӣ ва иҷтимоӣ
Ба гуфтаи таҳқиқот, LLM-ҳо дар корҳои донишмеҳвар мисли омодасозии ҳуҷҷат, тавлиди код, таҳлили додаҳо ва дастгирии муштариён потенсиали маҳсулнокӣ доранд, аммо метавонанд хатарҳое ба вуҷуд оранд, аз ҷумла тавлиди муҳтавои равон, вале хато, кам шудани назорати инсонӣ ва эътимоди аз ҳад зиёд ба натиҷаи нодуруст.
Дар маориф имкониятҳои feedback-и шахсисозишуда ҳамроҳ бо масъалаҳои якпорчагии академӣ ва тафаккури интиқодӣ баррасӣ мешаванд. Фарқҳои performans дар забонҳои камманбаъ нишон медиҳанд, ки на танҳо меъморӣ, балки фарогирии додаҳо ва намояндагии фарҳангӣ низ ба рафтори модел таъсир мерасонанд.
Самтҳои таҳқиқотии ояндаи таҳқиқот
- Арзёбии стандартшуда ва бозтавлидшавандаи LLM,
- cross-lingual generalization дар забонҳои камманбаъ ва context-ҳои фарҳангӣ,
- context-и дароз ва моделҳои memory-augmented,
- гибридҳои state-space ва attention–memory,
- model card-ҳо, варақаҳои дода ва механизмҳои bias audit,
- red teaming ва гузоришдиҳии шаффофтар дар бораи амният,
- кам кардани харҷҳои ҳисоббарорӣ ва энергетикӣ,
- пайдоиши додаҳо, моликияти зеҳнӣ, махфият ва адолати намояндагӣ.
Ёддошт оид ба Манбаъ ва Усул
| Номи пурраи аслии таҳқиқот | Mapping the LLM Landscape: A Cross-Family Survey of Architectures, Alignment Methods, and Benchmark Performance |
|---|---|
| Муаллифон | Deepshikha Bhati; Fnu Neha; Devi Sri Bandaru; Matthew Weber; Ishan Dilipbhai Gajera |
| Тартиби муаллифон | 1. Deepshikha Bhati; 2. Fnu Neha; 3. Devi Sri Bandaru; 4. Matthew Weber; 5. Ishan Dilipbhai Gajera |
| Ҳамсаҳмӣ / ҳаммуаллифи якум | Дар таҳқиқоти манбаъ изҳороти ҳамсаҳмӣ ё ҳаммуаллифи якум нишон дода нашудааст. |
| Муаллифи масъул | Deepshikha Bhati |
| Муассиса | Department of Computer Science, Kent State University, Kent, Ohio, ИМА |
| Навъи манбаъ | Шарҳи муқоисавӣ, таксономияи меъморӣ ва баррасии оилаи моделҳои LLM. |
| Вазъи доварӣ | Мақолаи шарҳии дар маҷаллаи доваришуда нашршуда аст; preprint нест. |
| Маҷалла | AI |
| Ношир | MDPI |
| Ҷилд / шумора / мақола | 2026, 7(4), 142 |
| DOI | 10.3390/ai7040142 |
| Санаи қабулшавӣ | 11 Март 2026 |
| Санаи бозбинӣ | 7 Апрел 2026 |
| Санаи қабул | 11 Апрел 2026 |
| Санаи нашр | 16 Апрел 2026 |
| Пайванди расмӣ | https://doi.org/10.3390/ai7040142 |
| Иҷозатнома | Creative Commons Attribution (CC BY). |
Хусусияти дода ва таҳлили таҳқиқот
Ин таҳқиқот LLM-и нави асосӣ намеомӯзонад ва ҳафт оилаи моделро дар инфрасохтори умумии ҳисоббарорӣ дубора benchmark намекунад. Манбаи асосии додаҳои илмӣ гузоришҳои техникии оммавӣ, system card-ҳо, ҳуҷҷатҳои моделӣ ва манбаъҳои benchmark мебошанд.
Муаллифон аз ин ҳуҷҷатҳо зиёда аз 50 меъмории моделро дар сатҳи умумии абстраксия бозсозӣ карда, хусусиятҳояшонро рамзгузорӣ намуда ва онҳоро дар дохили барномаи LLM Model Explorer паҳлу ба паҳлу муқоисашаванда гардондаанд.
Мувофиқи изҳороти дастрасии додаҳои мақола, додаҳои дар таҳлил истифодашуда дар матни асосӣ пешниҳод шудаанд. Коди сарчашма ва нишонаҳои намоиши зиндаи LLM Model Explorer-и таҳиякардаи таҳқиқот низ дар қисми усули мақола мубодила шудаанд.
Маблағгузорӣ
Таҳқиқот аз ҷониби барномаи Open Access APC Support Fund-и Kent State University қисман дастгирӣ шудааст.
Кумитаи ахлоқ ва розигии огоҳона
Дар таҳқиқоти манбаъ майдонҳои Institutional Review Board ва informed consent ҳамчун “Not applicable” гузориш шудаанд. Таҳқиқот таҷрибаи нав бо иштирокчиёни инсонӣ ё ҷамъоварии додаҳои клиникиро дар бар намегирад.
Бархӯрди манфиатҳо
Муаллифон изҳор кардаанд, ки бархӯрди манфиатҳо вуҷуд надорад.
Саҳмҳои муаллифон
Консептуализатсия: Deepshikha Bhati ва Devi Sri Bandaru. Методология: Deepshikha Bhati ва Devi Sri Bandaru. Тасдиқ: Deepshikha Bhati, Fnu Neha ва Devi Sri Bandaru. Таҳлили расмӣ: Deepshikha Bhati ва Devi Sri Bandaru. Бозбинӣ ва таҳрир: Deepshikha Bhati, Fnu Neha, Devi Sri Bandaru, Matthew Weber ва Ishan Dilipbhai Gajera.
Маҳдудиятҳои асосии методологии таҳқиқот
- Оилаҳои модел ба ҷои протоколи пешакӣ муайяншудаи ҷустуҷӯи систематикии адабиёт бо меъёрҳои ҳуҷҷатгузорӣ, гуногунӣ ва аҳамият интихоб шудаанд.
- Азбаски ҷузъиёти меъморӣ ва омӯзиши моделҳои пӯшида пурра ошкор нашудааст, нақшаҳои бозсозишуда абстраксияҳои сатҳи баланд мебошанд.
- Ҳамаи ҷузъиёти implementation-и зиёда аз 50 меъморӣ мустақилона санҷишпазир нест.
- Скорҳои benchmark бо истифода аз як evaluation harness-и умумӣ дубора ҳисоб нашудаанд.
- Баъзе сатрҳои benchmark ба ҷои як модел якчанд вариантро дар як оила якҷоя намояндагӣ мекунанд.
- Манбаи натиҷаҳои vendor-reported ва independent benchmark дар як ҷадвал дар сатҳи ҳуҷайра ҷудо карда нашудааст.
- Натиҷаҳои benchmark метавонанд аз рӯи prompting, версияи модел, сана ва протоколи арзёбӣ фарқ кунанд.
- Робитаҳои байни андозаҳои таксономия мушоҳидавӣ/муқоисавӣ мебошанд; таҷрибаи контролшудаи ablation анҷом дода нашудааст.
- Аз робитаҳои Architecture–benchmark сабабият бароварда намешавад.
- Барои alignment depth ва attention efficiency индекси умумии миқдорӣ муайян нашудааст.
- Хулосаи “ҳамаи моделҳои дорои context аз 32K дарозтар expert routing истифода мекунанд” бо маълумоти context-и GPT-4o ва Claude дар ҳамон мақола мувофиқат намекунад.
- Тафсир дар бораи наздикшавии моделҳои кушодавзн ба RMSNorm + RoPE барои ҳамаи вариантҳои дохили оила ба сатҳи баробари ҳуҷҷатгузорӣ асос намеёбад.
- Таҳқиқоти манбаъ як соҳаи технологияи зудтағйирёбандаро дар фосилаи муайяни таърихӣ харитасозӣ мекунад; таксономия наслҳои ояндаи моделро ба таври худкор намояндагӣ намекунад.
Сабти ошкори номутобиқатии интиқодӣ дар дохили манбаъ
Дар хулосаи Pattern B-и манбаъ иддао мешавад, ки барои “every model in our survey supporting context windows exceeding 32K tokens” sparse expert routing ё равиши selective state-space вуҷуд дорад. Баръакс, ҷадвали муқоисавии ҳамон таҳқиқот барои GPT-4o 128K ва барои Claude 2/3 100K–200K context window медиҳад, вале барои ин ду оила сохторҳои routing-и мазкурро нишон намедиҳад. Аз ин рӯ, ҷумлаи дорои хусусияти умумии Pattern B бо маълумоти дигари дохили манбаъ мувофиқ нест.
Барои Pattern A ва шарҳҳои performans-и benchmark низ ба ҳамин тарз набояд қатъияти сабабӣ истифода шавад. Худи таҳқиқот ҳангоми тавзеҳи фарқҳои benchmark мегӯяд, ки таҳлилҳои мазкур causality ба вуҷуд намеоранд.
Дар натиҷа, саҳми қавитарини таҳқиқот додани ҷавоби қатъӣ ба саволи “кадом LLM беҳтарин аст?” нест. Саҳми асосӣ ҷойгир кардани андозаҳои меъморӣ, омӯзиш, alignment, context, multimodality ва кушодагии оилаҳои моделҳои калони забонӣ дар як чаҳорчӯбаи муқоисавии муштарак ва табдил додани меъмориҳои аз ҳуҷҷатҳои моделӣ бозсозишуда ба таксономияи баррасишаванда ва абзори интерактивӣ мебошад.
Шарҳҳои илмии меъморӣ, арзишҳои муқоисавӣ, хулосаҳо ва маҳдудиятҳои ин матни Verianla ба таҳқиқоти манбаи боршуда асос меёбанд. Ба ҷуз ҳувияти библиографӣ ва вазъи доварӣ, аз манбаъҳои беруна натиҷаи нави performans-и LLM ба матни асосии илмӣ илова нашудааст.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд