

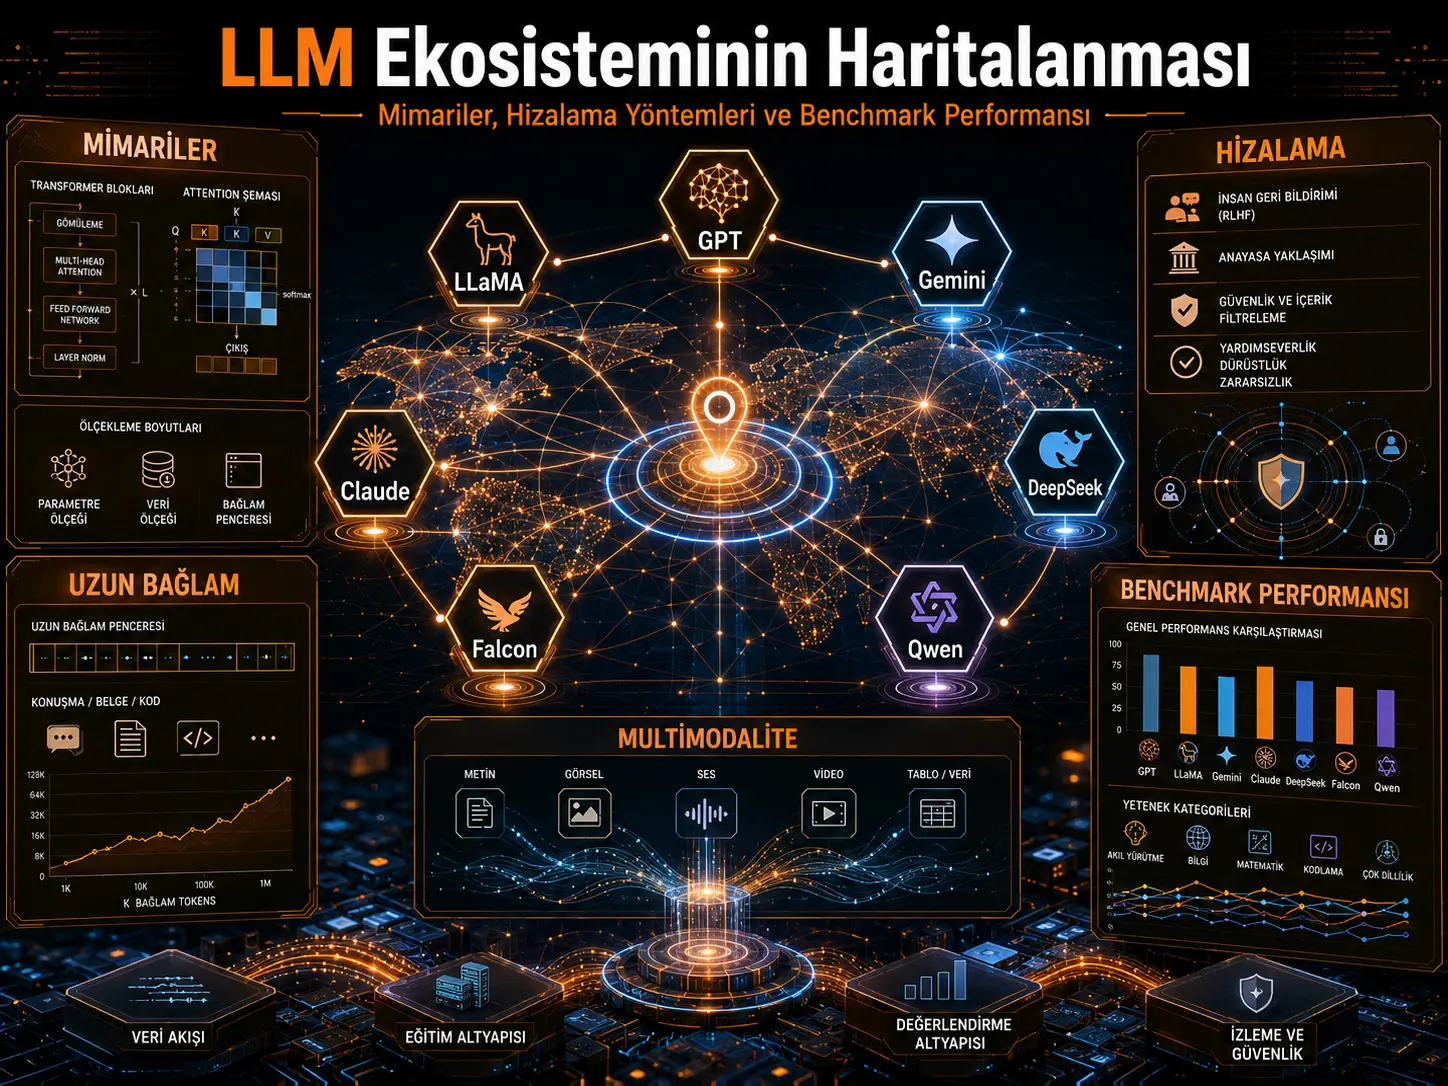
Büyük dil modelleri artık yalnızca daha fazla parametreye sahip metin üreticileri olarak gelişmiyor. Güncel sistemler; dikkat mekanizmasının nasıl hesaplandığı, hangi uzmanların etkinleştirildiği, yüz binlerce veya milyonlarca token uzunluğundaki bağlamın nasıl işlendiği, görüntü–ses–video gibi farklı veri türlerinin nasıl birleştirildiği ve insan tercihleriyle güvenlik kurallarının modele nasıl aktarıldığı gibi çok sayıda mimari ve eğitim kararının birleşiminden oluşuyor. Bu derleme çalışması, GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon ve Qwen olmak üzere yedi büyük LLM ailesini ortak bir taksonomi altında karşılaştırmayı amaçlıyor.
Araştırmacılar halka açık teknik raporlar, model kartları ve model belgelerinden yararlanarak 50'den fazla temsilî LLM mimarisini yeniden yapılandırmış; modelleri dikkat mekanizması, normalizasyon, konumsal kodlama, dense veya mixture-of-experts yönlendirme, bağlam yönetimi, eğitim stratejisi, hizalama ve multimodal yetenek gibi boyutlarda kodlamıştır. Çalışma ayrıca bu taksonomiyi etkileşimli olarak incelemek için açık kaynak kodlu bir LLM Model Explorer arayüzü sunmaktadır.
Makalenin karşılaştırmalı benchmark tablosunda GPT-4/GPT-4o ailesi MMLU'da %86,4 ve GSM8K'da %92,0; Gemini 1.5 HumanEval'da %74,9; Claude 3.x SWE-bench'te %49,0; DeepSeek ailesi GSM8K'da %89,4 ve SWE-bench'te %42,5 olarak listelenmiştir. Ancak bu rakamlar tek bir ortak benchmark koşusunda üretilmemiştir. Farklı model sürümleri, üretici raporları, leaderboard'lar, prompting yöntemleri ve değerlendirme protokollerinden derlenmiştir. Kaynak çalışma bu nedenle değerlerin gösterge niteliğinde olduğunu ve modeller arasında tam olarak doğrudan karşılaştırılamayacağını açıkça belirtmektedir.
Çalışmanın asıl katkısı belirli bir LLM'nin “kazanan” olduğunu ilan etmekten çok, modern büyük dil modellerinin hangi tasarım eksenlerinde birbirinden ayrıldığını görünür hâle getirmesidir. Derlemenin önerdiği başlıca eğilimler; daha verimli dikkat mekanizmalarına geçiş, uzun bağlam için modüler hesaplama arayışı, açık ağırlıklı modellerde RoPE ve RMSNorm gibi bileşenlerin yaygınlaşması, multimodal sistemlerin büyümesi ve RLHF, RLAIF veya Constitutional AI gibi hizalama yöntemlerinin model geliştirmede merkezi hâle gelmesidir.
Bununla birlikte taksonomiden türetilen bazı güçlü çıkarımlar deneysel olarak doğrulanmış mimari yasalar değildir. Özellikle “32K'dan uzun bağlama sahip bütün modeller sparse expert routing kullanır” çıkarımı çalışmanın kendi GPT-4o ve Claude bağlam tablolarıyla uyuşmamaktadır. Benchmark farklarını belirli mimari özelliklere bağlayan açıklamalar da kontrollü ablasyon deneylerinden değil, aileler arası gözlemsel karşılaştırmalardan türetilmiştir.
| Çalışmanın kapsamı | Kaynakta bildirilen yapı | Nasıl yorumlanmalı? |
|---|---|---|
| LLM ailesi | 7 | GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon ve Qwen |
| Yeniden oluşturulan mimari | 50+ | Teknik belge ve model kartlarından yüksek seviyede yeniden yapılandırılmıştır. |
| Temel karşılaştırma eksenleri | Mimari, eğitim, hizalama, bağlam, multimodalite, güvenlik, benchmark | Ortak bir taksonomi altında incelenmiştir. |
| Benchmark yöntemi | İkincil kaynaklardan raporlanan sonuçlar | Ortak deney ortamında yeniden ölçülmüş sonuçlar değildir. |
| Etkileşimli araç | LLM Model Explorer | Taksonomideki özelliklerin model bazında karşılaştırılmasını sağlar. |
| Temel bilimsel sınır | Kontrollü nedensel mimari karşılaştırması yok | Taksonomi ilişkileri hipotez üretir; nedenselliği kanıtlamaz. |
Neden yalnız “kaç milyar parametre?” sorusu artık yeterli değil?
İlk büyük dil modeli kuşaklarında ölçek artışı başlıca ilerleme eksenlerinden biriydi. Çalışmanın tarihsel anlatımında GPT-2'nin 2019'daki büyük ölçekli ön eğitim yaklaşımından GPT-3'ün 175 milyar parametresine, daha sonra uzun bağlamlı ve multimodal modellerin ortaya çıkışına uzanan bir dönüşüm anlatılmaktadır.
Fakat araştırmacılara göre modern LLM tasarım alanı artık tek bir büyüklük eksenine indirgenemez. Aynı parametre sayısına yakın iki sistem; attention mekanizması, aktif uzman sayısı, normalizasyon yöntemi, konumsal kodlama, veri karışımı, instruction tuning, hizalama veya multimodal encoder yapısı nedeniyle çok farklı hesaplama ve davranış profilleri gösterebilir.
Çalışma hangi yedi model ailesini inceliyor?
| Model ailesi | Kaynakta incelenen temsilî modeller | Çalışmanın öne çıkardığı temel özellik |
|---|---|---|
| GPT | GPT-2, GPT-3/3.5, GPT-4, GPT-4o, O1 | Decoder-only Transformer, büyük ölçekli ön eğitim, multimodalite ve RLHF |
| LLaMA | LLaMA, LLaMA 2, Code LLaMA | RoPE, GQA, RMSNorm ve açık ağırlıklı ekosistem |
| Gemini | Gemini 1.x ve Gemini 1.5 | Multimodalite, uzun bağlam ve kaynakta MoE olarak tanımlanan yapı |
| Claude | Claude 2, Claude 3 ve 3.5 varyantları | Uzun bağlam, Constitutional AI ve RLAIF |
| DeepSeek | DeepSeek-V2/V3 ve Reasoner/R1 | MLA, MoE ve reasoning odaklı eğitim |
| Falcon | Falcon 7B/40B/180B, Falcon 2, Falcon 3 ve Mamba | Multi-query/multigroup attention ve state-space varyantları |
| Qwen | Qwen, Qwen2 ve Qwen-Max | RoPE, RMSNorm, SwiGLU, çok dillilik ve kod/matematik uzmanlaşması |
Attention mekanizmaları neden farklılaşıyor?
Klasik Transformer'daki multi-head attention, her attention head için ayrı query, key ve value projeksiyonları kullanır. Büyük modellerde özellikle key–value önbelleği, uzun bağlam ve yüksek eşzamanlı kullanıcı yükü altında önemli bir bellek maliyetine dönüşür.
Çalışma bu soruna farklı ailelerin farklı çözümler getirdiğini vurgulamaktadır. LLaMA 2'de Grouped Query Attention (GQA), Falcon ve Qwen ailesinde multi-query veya multigroup attention, DeepSeek'te ise Multi-Head Latent Attention (MLA) gibi yaklaşımlar bu maliyeti azaltmayı hedeflemektedir.
DeepSeek'in MLA yaklaşımı, key–value temsillerini daha düşük boyutlu latent gösterimlere sıkıştırarak hesaplama ve depolama yükünü azaltmayı amaçlar. Falcon'un multi-query/multigroup yaklaşımı da key ve value projeksiyonlarının attention head'leri arasında daha fazla paylaşılması yoluyla KV-cache yükünü azaltmaya yöneliktir.
Mixture-of-Experts ne sağlıyor?
Mixture-of-Experts (MoE) yaklaşımında modelin bütün parametreleri her token için aynı anda etkinleştirilmez. Bir yönlendirme mekanizması girdiye göre belirli uzman alt ağlarını seçer. Böylece toplam model kapasitesi büyürken token başına aktif hesaplama toplam parametre sayısından daha düşük tutulabilir.
Kaynak çalışma bu yaklaşımı özellikle Gemini ve DeepSeek ailelerinin ölçeklenme ve uzun bağlam stratejileriyle ilişkilendirmektedir. DeepSeek-R1 için 671 milyar toplam parametreye karşı token başına yaklaşık 37 milyar aktif parametre bilgisi verilmektedir.
Ancak MoE'nin varlığı tek başına daha iyi reasoning, daha uzun bağlam veya daha yüksek benchmark performansının nedeni olarak kabul edilemez. Yönlendirme yöntemi, eğitim verisi, aktif uzman sayısı, attention mimarisi ve post-training süreci sonuçları birlikte etkiler.
Falcon Mamba neden farklı?
Falcon Mamba 7B, klasik self-attention yerine Mamba state-space modelini kullanması nedeniyle çalışmadaki önemli mimari ayrımlardan biridir. Kaynak, bunun uzun dizilerde doğrusal zamanlı işleme ve yaklaşık sabit bellek davranışı hedeflediğini belirtmektedir.
Falcon 3 ailesinde Transformer ve state-space yaklaşımlarının birlikte bulunması, modern LLM geliştirmesinin artık yalnız Transformer içindeki varyasyonlardan değil, attention dışı uzun-dizi mimarilerinden de oluştuğunu göstermektedir.
RMSNorm, RoPE ve SwiGLU neden sık görülüyor?
Çalışmanın taksonomisinde açık ağırlıklı model ailelerinin bir bölümünde üç bileşenin sık tekrarlandığı görülür: RMSNorm, Rotary Positional Embedding (RoPE) ve SwiGLU.
RMSNorm normalizasyon maliyetini sadeleştirirken; RoPE attention mekanizmasının içine göreli konum bilgisini taşır. SwiGLU ise gated aktivasyon yapısı kullanır. Çalışma LLaMA 2 ve Qwen'i bu bileşenlerin belirgin örnekleri olarak ele almaktadır.
Multimodal modellerde ne değişiyor?
Metin dışındaki görüntü, ses ve video bilgisini işlemek için modelin yalnız bir tokenizer ve dil decoder'ından ibaret olması yeterli değildir. Çalışmada Gemini, GPT-4o ve Claude 3 bu dönüşümün farklı örnekleri olarak incelenmektedir.
Gemini mimari şemasında farklı veri türlerinin modality-specific encoder'lar üzerinden işlenip cross-modal attention yoluyla ortak bir latent alana aktarılması gösterilmektedir. Çalışma GPT-4o'yu ise metin, kod, görüntü, ses ve video işleyebilen birleşik multimodal tasarım olarak ele almaktadır.
Hizalama: RLHF ne yapıyor?
Reinforcement Learning from Human Feedback (RLHF), önceden eğitilmiş modelin yalnız bir sonraki token olasılığını optimize etmek yerine, insan tercihleriyle daha uyumlu çıktılar vermesi için kullanılan post-training yöntemlerinden biridir.
Kaynak çalışma GPT-4, LLaMA 2, Claude, DeepSeek ve Qwen gibi ailelerde çeşitli supervised fine-tuning ve tercih optimizasyonu biçimlerinin kullanıldığını anlatmaktadır.
Bununla birlikte yazarlar RLHF'nin güvenliği kesin olarak çözmediğini vurgular. İnsan geri bildirimi pahalıdır; reward hacking ortaya çıkabilir; güvenlik eğitimi aşırı ret davranışına yol açabilir ve jailbreak ya da adversarial prompting riskleri tamamen ortadan kalkmaz.
Constitutional AI ve RLAIF nedir?
Claude ailesi, çalışmada alignment yaklaşımı açısından ayrı bir kategori olarak ele alınmaktadır. Constitutional AI'da modelin belirli ilkeler çerçevesinde kendi çıktısını eleştirmesi ve yeniden düzenlemesi amaçlanır. Reinforcement Learning from AI Feedback (RLAIF) ise insan değerlendirmesinin bir bölümünün AI tarafından sağlanan geri bildirimle desteklenmesini içerir.
Kaynak yazarları bu yaklaşımın insan anotasyonuna bağımlılığı azaltabileceğini, fakat AI geri bildiriminin model kaynaklı önyargıları yeniden üretme riski bulunduğunu belirtmektedir.
Taksonominin üç ana örüntüsü
Makale yedi model ailesini ortak boyutlara yerleştirdikten sonra üç çapraz-aile örüntüsü öneriyor.
| Kaynağın örüntüsü | Karşılaştırılan eksenler | Yazarların çıkarımı | Verianla yorum sınırı |
|---|---|---|---|
| A — Alignment–Efficiency Divergence | Alignment stratejisi × attention optimizasyonu | Derin hizalama ile en ileri attention verimliliğinin aynı modelde birlikte görülmediği öne sürülüyor. | Nicel olarak tanımlanmış iki eksende kontrollü performans testi değildir. |
| B — Context–Routing Co-Adoption | Bağlam uzunluğu × expert routing | >32K bağlamlı modellerin sparse/modüler routing kullandığı ileri sürülüyor. | Kaynağın GPT-4o ve Claude tablolarıyla evrensel ifade uyuşmuyor. |
| C — Open-Weight Convergence | Açıklık × normalizasyon × konumsal kodlama | Açık ağırlıklı modellerin RMSNorm + RoPE çevresinde kümelendiği öne sürülüyor. | Model ailesi içindeki bütün varyantlar için aynı düzeyde teknik açıklık bulunmuyor. |
Pattern B'deki iç tutarsızlık neden önemli?
Çalışmanın Pattern B metni, incelenen modeller içinde 32K'dan daha uzun context window sağlayan “her modelin” sparse expert routing veya selective state-space katmanları kullandığını ifade etmektedir.
Ancak aynı kaynakta bulunan karşılaştırma tablosu GPT-4/GPT-4o için 128K, Claude 2/3 için ise 100K–200K context window bildirmektedir. Bu iki ailenin ilgili mimari özetlerinde sparse MoE veya selective state-space routing belirtilmemektedir.
Bu nedenle kaynak içindeki veriler “uzun context ile modüler hesaplama arasında bazı ailelerde birlikte görülme” yorumunu destekleyebilir; fakat “32K'nın üzerindeki bütün modeller bunu kullanıyor” sonucunu kendi tabloları üzerinden desteklememektedir.
“Açık model” ile “açık kaynak” aynı şey mi?
Kaynak çalışmada modeller kapalı, açık ağırlıklı, kısmen açık veya araştırma lisanslı gibi farklı kategorilerde ele alınmaktadır. Bu ayrım önemlidir. Model ağırlıklarının yayımlanması; eğitim verisinin, tam eğitim kodunun, post-training hattının ve güvenlik sisteminin tamamının açık olduğu anlamına gelmez.
Bu nedenle çalışmadaki “open-source ecosystem” ifadesi okunurken her aile için gerçek açıklık düzeyinin farklı olabileceği dikkate alınmalıdır.
Benchmark sonuçları neden tek bir lig tablosu değildir?
Makalenin Tablo 2'si beş benchmark'ı yan yana verir: MMLU, HumanEval, GSM8K, SWE-bench ve MathVista. Fakat tablo hücrelerinin tamamı aynı model sürümü, aynı tarih, aynı prompting stratejisi veya aynı evaluation harness altında ölçülmemiştir.
Üstelik tablo bazı satırlarda tek bir modeli değil aile içindeki birden fazla varyantı birlikte temsil etmektedir: “GPT-4/GPT-4o”, “Claude 3.x (Opus/Sonnet)”, “Gemini 1.5 (Pro/Ultra)” veya “DeepSeek (V3/Reasoner)” gibi.
Dolayısıyla bir satırdaki MMLU skoru ile aynı satırdaki SWE-bench skorunun mutlaka aynı checkpoint veya aynı model varyantından geldiği varsayılmamalıdır.
Üretici ve bağımsız benchmark farkı
Çalışma, üreticiler tarafından raporlanan sonuçlarla bağımsız değerlendirmeler arasında farklar bulunabildiğini ve üretici skorlarının MMLU'da yaklaşık 2–8 yüzde puanı, GPQA-Diamond ve SWE-bench gibi daha yeni benchmark'larda bazı durumlarda yaklaşık 10–15 puan daha yüksek olabildiğini ifade etmektedir.
Yazarlar bunun prompting yöntemi, değerlendirme yazılımı, model sürümü ve olası evaluation-set contamination gibi etkenlerden kaynaklanabileceğini belirtmektedir. Bununla birlikte bu 2–8 ve 10–15 puanlık farkları oluşturan tüm eşleştirilmiş ölçümlerin ham veri tablosu makalede sunulmamaktadır. Bu nedenle bu aralıklar bağımsız bir meta-analiz sonucu olarak değerlendirilmemelidir.
Çalışmanın desteklediği sonuçlar
- Modern LLM aileleri aynı temel Transformer kökeninden gelseler de attention, normalizasyon, routing, context, multimodalite ve alignment boyutlarında önemli ölçüde farklılaşmaktadır.
- GQA, MQA, MLA, FlashAttention, MoE ve state-space yaklaşımları büyük ölçekli modellerde verimlilik ve uzun-dizi işleme sorunlarına yönelik farklı teknik çözümler sunmaktadır.
- RLHF tek alignment yaklaşımı değildir; Constitutional AI ve RLAIF gibi alternatif veya tamamlayıcı yaklaşımlar da kullanılmaktadır.
- Açık ağırlıklı ve kapalı model geliştirme ekosistemleri şeffaflık, yeniden üretilebilirlik, maliyet ve güvenlik mühendisliği bakımından farklı ödünleşimler içerir.
- Model seçimi yalnız benchmark skoruna değil kullanım alanı, context ihtiyacı, multimodalite, maliyet, güvenlik ve dağıtım koşullarına göre yapılmalıdır.
- Benchmark sonuçlarının model sürümü ve değerlendirme protokolü bilgisi olmadan doğrudan karşılaştırılması güvenilir değildir.
Çalışmanın kanıtlamadığı sonuçlar
- Her görev için tek bir LLM ailesinin mutlak olarak en iyi olduğu kanıtlanmamıştır.
- Tablo 2 değerleri ortak kontrollü deneyde elde edilmiş başa baş model karşılaştırması değildir.
- Bir benchmark farkının yalnız bir attention mekanizması, MoE veya alignment yöntemi tarafından oluşturulduğu kanıtlanmamıştır.
- Constitutional AI'ın attention verimliliğiyle zorunlu fiziksel bir trade-off oluşturduğu deneysel olarak gösterilmemiştir.
- Uzun context için sparse expert routing'in zorunlu koşul olduğu kaynak verileriyle kanıtlanmamaktadır.
- Açık ağırlıklı modellerin kapalı modellerden genel olarak daha güvenli veya daha güvensiz olduğu sonucuna varılamaz.
- Benchmark'taki yüksek performans gerçek dünya güvenilirliği, factuality veya güvenli kullanım garantisi değildir.
Türkiye açısından ne ifade ediyor?
Çalışma Türkiye'ye özgü bir LLM karşılaştırması yapmamaktadır ve Türkçe benchmark sonuçlarını ayrı bir deney grubu olarak sunmamaktadır. Bu nedenle tabloda yüksek sonuç gösteren bir modelin Türkçe hukuk, sağlık, eğitim, sanayi veya kamu uygulamalarında aynı performansı göstereceği varsayılamaz.
Türkiye'deki bir kuruluş için model seçimi yapılacaksa bu taksonomi mimari ön eleme aracı olarak kullanılabilir; ancak Türkçe dil performansı, alan terminolojisi, veri yerleşimi, kişisel verilerin korunması, gecikme, maliyet, kurum içi barındırma gereksinimleri ve yerel kullanım senaryoları ayrıca test edilmelidir. Bu yerel doğrulama, kaynak çalışmanın gerçekleştirdiği analiz değildir.
Çalışmanın Yöntemi ve Bulguları
Bu çalışma klasik sistematik derleme mi?
Makale kapsamlı bir derleme ve taksonomi çalışmasıdır; ancak kaynak metinde PRISMA benzeri bir sistematik literatür tarama protokolü, önceden belirlenmiş veri tabanı arama dizileri, dahil etme/dışlama akış şeması veya çalışma kalitesi meta-analizi sunulmamaktadır.
Yazarlar model seçimini üç ölçüte dayandırmaktadır:
- teknik dokümantasyonun bulunabilirliği,
- mimari çeşitlilik,
- araştırma ve endüstriyel kullanım açısından önem.
Bu ölçütlerle GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon ve Qwen aileleri seçilmiştir.
Mimariler nasıl yeniden oluşturuldu?
Yazarlar modellerin mimari şemalarını kamuya açık teknik raporlar, system card'lar ve model dokümantasyonlarından yeniden oluşturmuştur. Özellikle kapalı sistemlerin implementation ayrıntıları yayımlanmadığı için şemalar yüksek seviyede ve ortak soyutlama düzeyinde tutulmuştur.
Değerlendirilen başlıca mimari boyutlar şunlardır:
- Multi-Head Attention (MHA), Grouped Query Attention (GQA), Multi-Query Attention (MQA) ve Multi-Head Latent Attention (MLA),
- LayerNorm ve RMSNorm,
- dense ve mixture-of-experts routing,
- context handling ve positional encoding,
- alignment ve training pipeline'ları.
Taksonomi nasıl oluşturuldu?
Her model kategorik ve sayısal özelliklerden oluşan bir özellik vektörüyle temsil edilmiştir. Çalışma, yalnız açık dokümantasyonda bulunan özelliklerin kodlandığını ve bilgi belirsiz olduğunda aşırı ayrıntılandırmadan kaçınmak için “conservative labeling” uygulandığını belirtmektedir.
Ardından taksonomi boyutları ikili veya çoklu ilişkiler üzerinden karşılaştırılmıştır. Örneğin alignment yöntemi attention verimliliğiyle; context length expert routing ile; model açıklığı normalizasyon ve positional encoding ile birlikte incelenmiştir.
Verianla Live: LLM taksonomisinin oluşturulma süreci
Bu süreç kaynak çalışmanın 3.1 bölümündeki metodolojiye dayanır. “Sonuç” aşamasındaki yapısal örüntüler kontrollü deneysel nedensellik değil, karşılaştırmalı taksonomiden türetilmiş çıkarımlardır.
| Aşama | Kaynak çalışmadaki işlem |
|---|---|
| 1. Model ailesi seçimi | Dokümantasyon, mimari çeşitlilik ve araştırma/endüstri önemi ölçütleriyle yedi aile seçildi. |
| 2. Teknik kaynakların toplanması | Teknik raporlar, system card'lar ve model dokümantasyonu kullanıldı. |
| 3. Mimari yeniden yapılandırma | 50'den fazla temsilî mimari ortak bir soyutlama düzeyinde yeniden oluşturuldu. |
| 4. Özellik kodlama | Attention, normalizasyon, routing, context, positional encoding, training ve alignment boyutları kodlandı. |
| 5. Çapraz-aile karşılaştırması | Taksonomi boyutlarının ikili ve çoklu ilişkileri incelendi. |
| 6. Benchmark ile ilişkilendirme | Taksonomi örüntüleri kaynaklarda raporlanan benchmark sonuçlarıyla karşılaştırıldı. |
| 7. Hipotez üretimi | Alignment–efficiency, context–routing ve open-weight convergence örüntüleri önerildi. |
Kaynağın benchmark tablosu
Aşağıdaki değerler makalenin Tablo 2'sinden aktarılmıştır. Kaynak çalışmanın kendi uyarısı korunmalıdır: sonuçlar farklı kaynak ve protokollerden geldiği için kesin ve doğrudan model sıralaması değildir.
| Model ailesi | MMLU (%) | HumanEval Pass@1 (%) | GSM8K (%) | SWE-bench Pass@1 (%) | MathVista (%) |
|---|---|---|---|---|---|
| GPT-4 / GPT-4o | 86,4 | 67,0 | 92,0 | 33,2 | 63,8 |
| Claude 3.x (Opus/Sonnet) | 82,1 | 60,1 | 88,0 | 49,0 | 60,5 |
| Gemini 1.5 (Pro/Ultra) | 81,9 | 74,9 | 87,8 | 35,0 | 59,2 |
| LLaMA 2 (70B) | 68,9 | 48,1 | 56,8 | 18,0 | 44,1 |
| Falcon (180B/Falcon 2) | 66,5 | 45,2 | 55,4 | 15,3 | 41,6 |
| DeepSeek (V3/Reasoner) | 79,8 | 72,6 | 89,4 | 42,5 | 61,2 |
| Qwen (Qwen2/Qwen-Max) | 78,5 | 65,3 | 83,7 | 36,4 | 58,1 |
Benchmark'ların anlamı
| Benchmark | Çalışmadaki kullanım amacı |
|---|---|
| MMLU | Farklı bilgi ve problem alanlarında genel dil modeli performansı |
| HumanEval | Programlama/kod üretimi performansı |
| GSM8K | Matematiksel sözel problem çözme |
| SWE-bench | Gerçek yazılım mühendisliği problemleri üzerinde kodlama yeteneği |
| MathVista | Görsel ve matematiksel muhakemenin birleştiği görevler |
Model ailelerinin context ve multimodalite karşılaştırması
| Aile | Kaynakta bildirilen context | Multimodal yapı | Hizalama / güvenlik |
|---|---|---|---|
| GPT-4 / GPT-4o | 128K GPT-4o | Metin, görüntü, ses, video | SFT, RLHF, PPO, moderasyon ve içerik filtreleri |
| GPT-O1 | 8K–32K | Metin | SFT, RLHF ve reasoning odaklı ödül modelleri |
| LLaMA 2 | 4K | Metin | SFT, RLHF, Ghost Attention ve safety reward modelleri |
| Gemini 1.5 | 1M'a kadar | Metin, görüntü, ses, video, kod | RLHF, expert gating ve moderasyon |
| Claude 2/3 | 100K–200K | Metin; Claude 3'te görüntü | Constitutional AI, RLAIF, self-critique ve red teaming |
| Falcon | 4K–32K | Temel aile metin; Falcon 2'de VLM varyantı | Safety classifier ve LoRA tabanlı hizalama |
| DeepSeek R1/V3 | 32K–128K | Çalışmada esas olarak metin | GRPO, SFT, sentetik veri, rejection sampling |
| Qwen | 32K+ | Çalışmanın karşılaştırma tablosunda metin | SFT, RLHF, preference optimization ve bias mitigation |
Taksonominin benchmark farklarına getirdiği açıklama
Kaynak çalışmanın Tablo 6'sı üç örnek benchmark farkını mimari boyutlarla ilişkilendirmektedir:
| Benchmark | Aile A | Aile B | Skor farkı | Kaynağın ilişkilendirdiği taksonomi boyutları |
|---|---|---|---|---|
| GSM8K | DeepSeek-V3: %89,4 | LLaMA 2: %56,8 | +32,6 yüzde puanı | MLA/GQA, MTP/next-token prediction, rejection-sampled RL/Ghost Attention RLHF |
| SWE-bench | Claude 3.x: %49,0 | GPT-4o: %33,2 | +15,8 yüzde puanı | Constitutional AI + RLAIF/RLHF-PPO ve 200K/128K context |
| HumanEval | Gemini 1.5: %74,9 | LLaMA 2: %48,1 | +26,8 yüzde puanı | MoE/dense Transformer ve 1M/4K context |
Bu tablo doğrudan mekanizma testi değildir. Her karşılaştırmada model aileleri veri, parametre, post-training, model sürümü ve evaluation protocol dahil çok sayıda başka değişkende de farklılaşmaktadır. Kaynak çalışma bunu açıkça kabul ederek analizlerin nedensellik değil “structured explanatory hypotheses” oluşturduğunu belirtmektedir.
Alignment–efficiency çıkarımı neden hipotez düzeyinde?
Yazarlar Claude'daki Constitutional AI/RLAIF derinliğinin daha az efficiency-optimized attention ile birlikte görülmesini, DeepSeek, Falcon ve Gemini gibi attention verimliliğine ağırlık veren ailelerde ise daha basit hizalama hatlarının kullanılmasını bir trade-off olarak yorumlamaktadır.
Fakat çalışmada “alignment depth” ve “attention efficiency” için ortak nicel skor tanımlanmamış; aynı model üzerinde yalnız alignment veya yalnız attention yöntemi değiştirilerek kontrollü ablasyon yapılmamıştır. Bu nedenle ilişki çalışmanın taksonomik gözlemidir; hesaplamalı zorunluluk olarak kanıtlanmış değildir.
Context–routing çıkarımındaki kaynak içi uyuşmazlık
Pattern B'nin temel cümlesi, 32K'dan büyük context window kullanan her modelin sparse expert routing veya selective state-space layer kullandığını öne sürmektedir.
Fakat aynı makalenin kendi karşılaştırma tablosunda:
- GPT-4o için 128K context,
- Claude 2/3 için 100K–200K context
bildirilmesine rağmen bu ailelerin mimari açıklamalarında MoE veya selective SSM routing verilmemektedir.
Dolayısıyla “every >32K-context model” genellemesi kaynak içinde tutarlı değildir. Bu Verianla makalesinde söz konusu örüntü yalnız yazarların önerdiği hipotez olarak aktarılmıştır.
Açık ağırlıklı model yakınsaması
Çalışmanın Pattern C çıkarımına göre LLaMA 2, Falcon ve Qwen gibi açık/açık ağırlıklı sistemler RoPE ve RMSNorm gibi iyi bilinen bileşenlerin çevresinde daha fazla kümelenirken kapalı modeller daha heterojen tasarım alanlarına yayılmaktadır.
Yazarlar bunu açık model topluluklarında yeniden üretilebilir ve doğrulanabilir bileşenlerin tercih edilmesiyle ilişkilendirmektedir. Ancak özellikle kapalı modellerin mimari ayrıntıları sınırlı olduğu için kapalı sistemlerin gerçek tasarım uzayının tamamı gözlemlenemez. Bu çıkarım da doğrulanmış nedensel mekanizma olarak değil karşılaştırmalı taksonomi yorumu olarak değerlendirilmelidir.
İş dünyası ve toplumsal sonuçlar
Çalışmaya göre LLM'ler doküman hazırlama, kod üretimi, veri analizi ve müşteri desteği gibi bilgi yoğun işlerde üretkenlik potansiyeli taşırken akıcı fakat hatalı içerik üretimi, insan denetiminin azalması ve yanlış çıktıya aşırı güven gibi riskler oluşturabilir.
Eğitimde kişiselleştirilmiş geri bildirim fırsatları akademik bütünlük ve eleştirel düşünme sorunlarıyla birlikte ele alınmaktadır. Düşük kaynaklı dillerdeki performans farklılıkları ise yalnız mimarinin değil veri kapsamı ve kültürel temsilin de model davranışını etkilediğini göstermektedir.
Çalışmanın geleceğe yönelik araştırma başlıkları
- Standartlaştırılmış ve yeniden üretilebilir LLM değerlendirmesi,
- düşük kaynaklı diller ve kültürel bağlamlarda cross-lingual generalization,
- uzun context ve memory-augmented modeller,
- state-space ve attention–memory hibritleri,
- model kartları, veri sayfaları ve bias audit mekanizmaları,
- red teaming ve daha şeffaf güvenlik raporlaması,
- hesaplama ve enerji maliyetlerinin azaltılması,
- veri kökeni, fikrî mülkiyet, gizlilik ve temsil adaleti.
Kaynak ve Yöntem Notu
| Tam özgün çalışma adı | Mapping the LLM Landscape: A Cross-Family Survey of Architectures, Alignment Methods, and Benchmark Performance |
|---|---|
| Yazarlar | Deepshikha Bhati; Fnu Neha; Devi Sri Bandaru; Matthew Weber; Ishan Dilipbhai Gajera |
| Yazar sırası | 1. Deepshikha Bhati; 2. Fnu Neha; 3. Devi Sri Bandaru; 4. Matthew Weber; 5. Ishan Dilipbhai Gajera |
| Eş katkı / eş birinci yazar | Kaynak çalışmada eş katkı veya eş birinci yazar beyanı belirtilmemiştir. |
| Sorumlu yazar | Deepshikha Bhati |
| Kurum | Department of Computer Science, Kent State University, Kent, Ohio, ABD |
| Kaynak türü | Karşılaştırmalı derleme, mimari taksonomi ve LLM model ailesi incelemesi. |
| Hakemlik durumu | Hakemli dergide yayımlanmış derleme makalesidir; preprint değildir. |
| Dergi | AI |
| Yayınevi | MDPI |
| Cilt / sayı / makale | 2026, 7(4), 142 |
| DOI | 10.3390/ai7040142 |
| Alınma tarihi | 11 Mart 2026 |
| Revizyon tarihi | 7 Nisan 2026 |
| Kabul tarihi | 11 Nisan 2026 |
| Yayın tarihi | 16 Nisan 2026 |
| Resmî bağlantı | https://doi.org/10.3390/ai7040142 |
| Lisans | Creative Commons Attribution (CC BY). |
Çalışmanın veri ve analiz niteliği
Bu çalışma yeni bir temel LLM eğitmemekte ve yedi model ailesini ortak hesaplama altyapısında yeniden benchmark etmemektedir. Temel bilimsel veri kaynağı kamuya açık teknik raporlar, system card'lar, model dokümantasyonu ve benchmark kaynaklarıdır.
Yazarlar bu belgelerden 50'den fazla model mimarisini ortak bir soyutlama düzeyinde yeniden oluşturmuş, özelliklerini kodlamış ve bir LLM Model Explorer uygulaması içinde yan yana karşılaştırılabilir hâle getirmiştir.
Makalenin veri erişilebilirliği beyanına göre analizde kullanılan veriler ana metin içinde sunulmuştur. Çalışmanın geliştirdiği LLM Model Explorer'ın kaynak kodu ve canlı gösterim adresleri de makalenin yöntem bölümünde paylaşılmıştır.
Finansman
Çalışma, Kent State University'nin Open Access APC Support Fund programı tarafından kısmen desteklenmiştir.
Etik kurul ve bilgilendirilmiş onam
Kaynak çalışmada Institutional Review Board ve informed consent alanları “Not applicable” olarak bildirilmiştir. Çalışma insan katılımcılar üzerinde yeni deney veya klinik veri toplama içermemektedir.
Çıkar çatışması
Yazarlar çıkar çatışması bulunmadığını bildirmiştir.
Yazar katkıları
Kavramsallaştırma: Deepshikha Bhati ve Devi Sri Bandaru. Metodoloji: Deepshikha Bhati ve Devi Sri Bandaru. Doğrulama: Deepshikha Bhati, Fnu Neha ve Devi Sri Bandaru. Biçimsel analiz: Deepshikha Bhati ve Devi Sri Bandaru. Gözden geçirme ve düzenleme: Deepshikha Bhati, Fnu Neha, Devi Sri Bandaru, Matthew Weber ve Ishan Dilipbhai Gajera.
Çalışmanın temel yöntemsel sınırlılıkları
- Model aileleri önceden tanımlanmış sistematik literatür tarama protokolü yerine dokümantasyon, çeşitlilik ve önem ölçütleriyle seçilmiştir.
- Kapalı modellerin mimari ve eğitim ayrıntıları tam açıklanmadığından yeniden oluşturulan şemalar yüksek seviyeli soyutlamalardır.
- 50'den fazla mimarinin tüm implementation ayrıntıları bağımsız olarak doğrulanabilir değildir.
- Benchmark skorları tek bir ortak evaluation harness kullanılarak yeniden hesaplanmamıştır.
- Bazı benchmark satırları tek bir model yerine bir ailedeki birden fazla varyantı birlikte temsil etmektedir.
- Vendor-reported ve independent benchmark sonuçlarının kaynağı hücre bazında tek tabloda ayrıştırılmamıştır.
- Benchmark sonuçları prompting, model sürümü, tarih ve değerlendirme protokolü açısından farklılık gösterebilir.
- Taksonomi boyutları arasındaki ilişkiler gözlemsel/karşılaştırmalıdır; kontrollü ablasyon deneyi yapılmamıştır.
- Architecture–benchmark ilişkilerinden nedensellik çıkarılamaz.
- Alignment depth ve attention efficiency için ortak nicel indeks tanımlanmamıştır.
- “32K'dan uzun bağlama sahip bütün modeller expert routing kullanır” çıkarımı, aynı makaledeki GPT-4o ve Claude context bilgileriyle uyuşmamaktadır.
- Açık ağırlıklı modellerin RMSNorm + RoPE yakınsamasına ilişkin yorum aile içindeki bütün model varyantları için eşit dokümantasyon düzeyine dayanmamaktadır.
- Kaynak çalışma hızlı değişen bir teknoloji alanını belirli bir tarih aralığında haritalamaktadır; taksonomi gelecekteki model kuşaklarını otomatik olarak temsil etmez.
Kaynak içi kritik tutarsızlığın açık kaydı
Kaynağın Pattern B çıkarımında “every model in our survey supporting context windows exceeding 32K tokens” için sparse expert routing veya selective state-space yaklaşımı bulunduğu ileri sürülmektedir. Buna karşın aynı çalışmanın karşılaştırma tablosu GPT-4o için 128K ve Claude 2/3 için 100K–200K context window verirken bu iki aile için söz konusu routing yapıları belirtilmemektedir. Bu nedenle evrensel nitelikteki Pattern B cümlesi kaynak içindeki diğer bilgilerle tutarlı değildir.
Pattern A ve benchmark performans açıklamaları için de benzer biçimde nedensel kesinlik kullanılmamalıdır. Çalışmanın kendisi benchmark farklarını açıklarken söz konusu analizlerin causality oluşturmadığını belirtmektedir.
Sonuç olarak araştırmanın en güçlü katkısı “hangi LLM en iyidir?” sorusuna kesin cevap vermesi değildir. Esas katkı, büyük dil modeli ailelerinin mimari, eğitim, alignment, context, multimodalite ve açıklık boyutlarını tek bir ortak karşılaştırma çerçevesine yerleştirmesi; model belgelerinden yeniden oluşturulan mimarileri incelenebilir bir taksonomi ve etkileşimli araç hâline getirmesidir.
Bu Verianla metnindeki bilimsel mimari açıklamalar, karşılaştırma değerleri, çıkarımlar ve sınırlılıklar yüklenen kaynak çalışmaya dayanmaktadır. Bibliyografik kimlik ve hakemlik durumu dışında dış kaynaklardan yeni LLM performans sonucu ana bilimsel metne eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir