

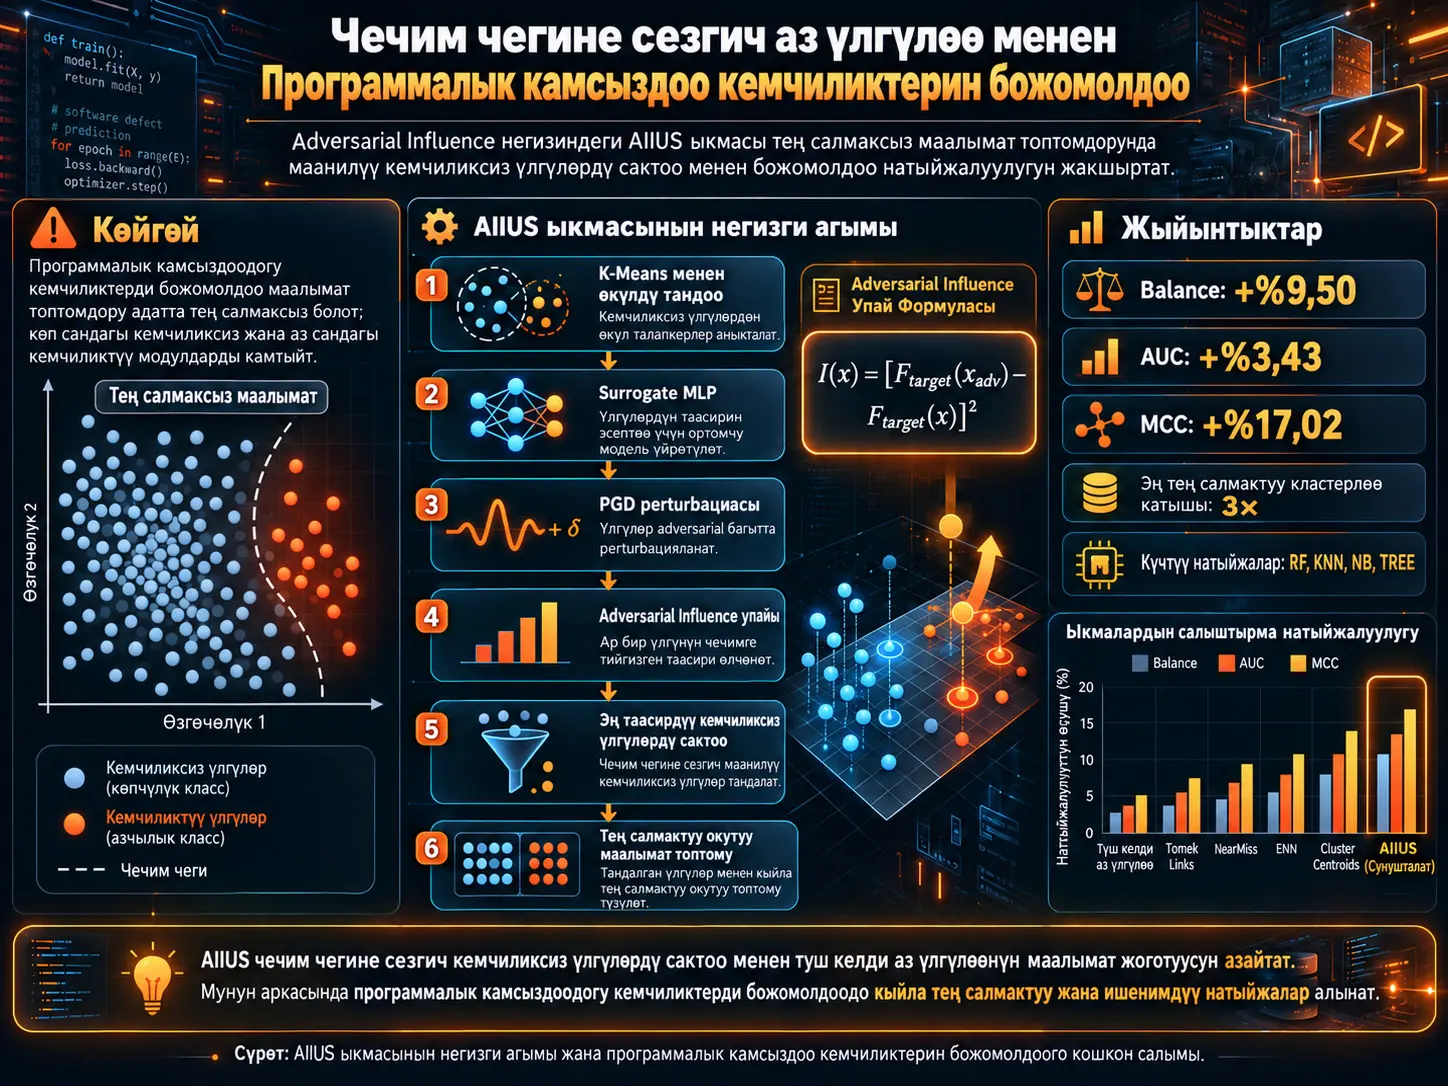
Программалык камсыздоодогу кемчиликтерди божомолдоо системалары кайсы код модулдарында кемчилик болуу ыктымалдыгы жогору экенин аныктоо аркылуу тестирлөө жана текшерүү ресурстарын натыйжалуураак пайдаланууга жардам бере алат. Бирок реалдуу программалык камсыздоо маалымат топтомдорунда кемчиликсиз модулдар көбүнчө кемчиликтүү модулдардан кыйла көп болот. Класстардын мындай тең салмаксыздыгы классификатордун жалпы тактыгы жогору көрүнгөнү менен кемчиликтүү үлгүлөрдү өткөрүп жиберишине же өтө көп жалган эскертүү чыгарышына алып келиши мүмкүн.
Бул изилдөө көпчүлүк класстагы кемчиликсиз үлгүлөрдү туш келди азайтуунун ордуна чечим чеги жагынан маанилүүрөөк көрүнгөн үлгүлөрдү сактоону максат кылган Adversarial Influence-Based Intelligent Undersampling (AIIUS) ыкмасын сунуштайт. Ыкманын негизги жаңылыгы болгон Adversarial Influence, үлгүгө чакан жана багытталган пертурбация колдонулганда максаттуу классификатордун кемчилик ыктымалдыгы боюнча божомолу канчалык өзгөрөрүн өлчөйт. Божомолдун өзгөрүшү жогору болгон көпчүлүк үлгүлөрү моделдин чечим кабыл алуу жүрүм-туруму үчүн көбүрөөк маалымат берүүчү талапкерлер катары артыкчылыкка ээ болот.
AIIUS үч негизги баскычтан турат. Адегенде кемчиликсиз үлгүлөр K-Means менен кластерленип, маалыматтардын бөлүштүрүлүшүн чагылдырган кичирээк талапкерлер топтому түзүлөт. Андан кийин дифференциалдануучу surrogate MLP үстүндө PGD пертурбациялары түзүлөт жана бул түпнуска/adversarial үлгүлөр максаттуу black-box классификаторго берилип, Adversarial Influence эсептелет. Акыркы баскычта талапкерлер influence упайы боюнча иреттелип, кемчиликтүү үлгүлөрдүн санына барабар болгон эң жогорку таасирдүү кемчиликсиз үлгүлөр сакталат.
Ыкма 18 жалпыга ачык программалык камсыздоо кемчиликтери боюнча маалымат топтомунда жана беш башка классификатордо алты кайра үлгүлөө ыкмасы менен салыштырылат. Булак өкүлчүлүктүү baseline-дарга салыштырмалуу орточо Balance боюнча %9,50, AUC боюнча %3,43 жана MCC боюнча %17,02 жакшырганын билдирет. Ошол эле учурда AIIUS бардык классификаторлордо жана бардык метрикаларда эң жогорку натыйжаны бербейт; артыкчылык айрыкча MCC жана Balance сыяктуу класстардын тең салмаксыздыгына туруктуураак көрсөткүчтөрдө ачык көрүнөт.
Программалык камсыздоо кемчиликтерин божомолдоодо класстардын тең салмаксыздыгы эмне үчүн көйгөй жаратат?
Программалык камсыздоо долбоорундагы модулдардын көпчүлүгү кемчиликсиз болушу мүмкүн. Мындай учурда окутуу маалыматтарындагы көпчүлүк класс, башкача айтканда кемчиликсиз үлгүлөр, кемчиликтүү үлгүлөрдүн санынан бир нече, атүгүл ондогон эсе көп болушу мүмкүн.
Булакта изилденген маалымат топтомдорунда тең салмаксыздык катышы
\[ IR=\frac{N_{\mathrm{maj}}}{N_{\mathrm{min}}} \]
деп аныкталат. Бул жерде \(N_{\mathrm{maj}}\) кемчиликсиз көпчүлүк үлгүлөрүнүн, ал эми \(N_{\mathrm{min}}\) кемчиликтүү азчылык үлгүлөрүнүн санын билдирет.
Изилдөөдөгү 18 маалымат топтомунда бул катыш болжол менен 3,50дөн 25,08ге чейин өзгөрөт.
Мындай бөлүштүрүүдө жалпы тактыкты гана оптималдаштырган модель көпчүлүк классты өтө көп тандап, сыртынан жогорку ийгилик көрсөтүшү мүмкүн. Бирок практикалык жактан эки ката маанилүү:
- Кемчиликтүү модулду кемчиликсиз деп кабыл алуу, башкача айтканда false negative, чыныгы кемчиликтин байкалбай калышына алып келиши мүмкүн.
- Кемчиликсиз модулду кемчиликтүү деп жарыялоо, башкача айтканда false positive, керексиз тестирлөө жана текшерүү чыгымдарын жаратышы мүмкүн.
Oversampling менен undersampling ортосундагы айырма
Oversampling азчылык классын чоңойтууга аракет кылат. SMOTE сыяктуу ыкмалар бар болгон кемчиликтүү үлгүлөрдүн арасында синтетикалык чекиттерди түзөт. Бул ыкма класстардын катышын тең салмактай алат, бирок синтетикалык үлгүлөрдүн ызы-чууну же класстардын бири-бирине дал келишин көбөйтүү коркунучу бар.
Undersampling болсо көпчүлүк класстан айрым үлгүлөрдү алып салат. Артыкчылыгы синтетикалык кемчиликтүү үлгү түзбөйт; бирок кайсы көпчүлүк үлгүлөрүнүн өчүрүлүшү маанилүү болуп калат.
Туш келди undersampling чечим чегин аныктаган маанилүү кемчиликсиз үлгүлөрдү да алып салышы мүмкүн. AIIUS дал ушул жерден башталат: көпчүлүк үлгүлөрүнүн баары бирдей даражада керексиз эмес.
Adversarial Influence эмнени өлчөйт?
Adversarial Influence — чакан жана багытталган пертурбациядан кийин максаттуу классификатордун божомол ыктымалдыгы канчалык өзгөрөрүн өлчөгөн, моделдин реакциясына негизделген үлгүнүн маанилүүлүк упайы. Максат маалымат геометриясын же классификатордун бир чекиттеги белгисиздигин гана карабастан, моделдин жергиликтүү өзгөрүүгө берген реакциясын пайдалануу болуп саналат.
Кемчиликсиз \(x\) үлгүсү жана анын adversarial аналогу \(x_{\mathrm{adv}}\) үчүн:
\[ \boxed{ I(x)= \left( F_{\mathrm{target}}(x_{\mathrm{adv}}) - F_{\mathrm{target}}(x) \right)^2 } \]
деп аныкталат.
Бул жерде:
- \(F_{\mathrm{target}}(x)\): максаттуу классификатор түпнуска үлгү үчүн чыгарган кемчилик ыктымалдыгы,
- \(F_{\mathrm{target}}(x_{\mathrm{adv}})\): пертурбация колдонулган үлгү үчүн чыгарылган ыктымалдык,
- \(I(x)\): божомол өзгөрүшүнүн квадраты менен аныкталган Adversarial Influence мааниси.
Маани чоңойгон сайын максаттуу модель ошол үлгүнүн жакын аймагындагы пертурбацияга көбүрөөк сезгич экени түшүнүлөт. Изилдөө бул сезгичтикти чечим чеги жагынан үлгүнүн маанилүүлүгүнө байланышкан прокси-сигнал катары колдонот.
Белгисиздик өлчөөсүнөн айырмасы эмнеде?
Стандарттуу uncertainty ыкмасы көбүнчө классификатордун учурдагы божомолу 0,5 сыяктуу чечим босогосуна канчалык жакын экенин карайт.
Adversarial Influence болсо башка суроо берет:
«Бул чекитке чакан жана багытталган өзгөртүү киргизсем, моделдин божомолу канчалык жылат?»
Демек өлчөө статикалык божомол ыктымалдыгына караганда моделдин жергиликтүү реакция жүрүм-турумуна негизделет.
Маанилүү чечмелөө чеги
Adversarial Influence математикалык чечим-чегине чейинки түз аралык эмес жана үлгү маалымат топтомунан алынып салынганда кайра окутулган моделдин чеги канчалык өзгөрөрүн түздөн-түз эсептебейт. Бул изилдөө аны чечим жүрүм-турумуна болгон жергиликтүү сезгичтиктен алынган instance-importance өлчөмү катары колдонот.
Изилдөөнүн Ыкмасы жана Натыйжалары
AIIUSтун үч баскычы
| Баскыч | Иш-аракет | Максат |
|---|---|---|
| 1 | K-Means менен өкүл тандоо | Көпчүлүк класстагы ашыкчалыкты азайтып, жалпы бөлүштүрүүнү сактоого аракет кылуу |
| 2 | Surrogate негизиндеги PGD жана Adversarial Influence | Ар бир талапкердин максаттуу модель үчүн жергиликтүү чечим сезгичтигин өлчөө |
| 3 | Influence-guided undersampling | Эң жогорку influence маанисине ээ кемчиликсиз үлгүлөрдү сактап, тең салмактуу маалымат түзүү |
Биринчи баскыч: K-Means менен талапкерлер топтому
Кемчиликсиз көпчүлүк класс
\[ S_{\mathrm{maj}} \]
үстүндө K-Means колдонулат.
Кластерлердин саны:
\[ K=\lambda|S_{\mathrm{min}}| \]
деп аныкталат.
Негизги тажрыйбаларда:
\[ \lambda=3 \]
колдонулат.
Ар бир кластердин центроидуна эң жакын чыныгы кемчиликсиз үлгү тандалат. Ошентип болжол менен
\[ 3|S_{\mathrm{min}}| \]
өлчөмүндөгү көпчүлүк талапкерлер топтому алынат.
Бул баскычтын максаты түздөн-түз акыркы undersampling жүргүзүү эмес. K-Means бул жерде adversarial баалоого кире турган үлгүлөрдүн санын азайтуу менен бирге көпчүлүк класстын ар башка аймактарынан өкүлдөрдү сактоого кызмат кылат.
Экинчи баскыч: surrogate модель
KNN жана Random Forest сыяктуу максаттуу моделдерде керектүү кириш градиенттери түздөн-түз болбошу мүмкүн. Ошондуктан изилдөө:
\[ F_{\mathrm{surrogate}} \]
менен белгиленген дифференциалдануучу MLPни окутат.
Surrogate максаттуу моделдин чечим жүрүм-турумун болжолдуу чагылдыруу жана PGD пертурбациясы кайсы багытта түзүлөрүн аныктоо үчүн колдонулат.
Бирок акыркы Adversarial Influence surrogate чыгышынан гана эсептелбейт. Түпнуска жана adversarial үлгүлөр кайрадан максаттуу классификаторго берилип, чыныгы максат-модель божомолунун өзгөрүшү өлчөнөт.
PGD пертурбациясы
Бир үлгү үчүн баштапкы абал:
\[ x_0=x \]
деп алынат жана PGD итерациясы:
\[ x_{t+1} = \Pi_{\|\delta\|_\infty\leq\epsilon} \left[ x_t+ \alpha\, \mathrm{sign} \left( \nabla_x \mathcal L(F_{\mathrm{surrogate}}(x_t)) \right) \right] \]
түрүндө колдонулат.
Бул жерде:
- \(\epsilon\): максималдуу пертурбация өлчөмү,
- \(\alpha\): кадам өлчөмү,
- \(T\): PGD итерацияларынын саны.
Бул үч параметр кол менен туруктуу коюлбастан Differential Evolution аркылуу тандалат. Оптималдаштыруу максаты — окутуу маалыматтарындагы cross-validated MCC.
Үчүнчү баскыч: influence-guided selection
Бардык өкүл кемчиликсиз үлгүлөрдүн \(I(x)\) упайлары эсептелгенден кийин үлгүлөр чоңдон кичинеге иреттелет.
Эң жогорку influence маанисине ээ
\[ |S_{\mathrm{min}}| \]
кемчиликсиз үлгү тандалат:
\[ |\widetilde S_{\mathrm{maj}}| = |S_{\mathrm{min}}|. \]
Акыркы тең салмактуу маалымат топтому:
\[ D_{\mathrm{balance}} = \widetilde S_{\mathrm{maj}} \cup S_{\mathrm{min}} \]
түрүндө түзүлөт.
AIIUS алгоритминин кыскача мазмуну
- Маалыматты кемчиликтүү жана кемчиликсиз класстарга бөл.
- \(K=\lambda|S_{\mathrm{min}}|\) аныкта.
- Кемчиликсиз үлгүлөрдү K-Means менен \(K\) кластерге бөл.
- Ар бир кластердин центроидуна эң жакын чыныгы үлгүнү танда.
- Surrogate MLPни окут.
- PGD параметрлерин Differential Evolution менен аныкта.
- Ар бир өкүл үчүн adversarial үлгү түз.
- Target classifier аркылуу Adversarial Influence эсепте.
- Үлгүлөрдү influence упайы боюнча иретте.
- Эң жогорку упайлуу \(|S_{\mathrm{min}}|\) кемчиликсиз үлгүнү сакта.
- Кемчиликтүү үлгүлөр менен бириктирип 1:1 тең салмактуу окутуу топтомун түз.
Тажрыйба маалымат топтомдору
Изилдөө төрт ачык маалымат булагынан 18 маалымат топтомун колдонот:
- AEEEM: JDT, LC, ML, PDE
- NASA: CM1, MW1, PC1, PC3, PC4
- PROMISE: ant-1.3, camel-1.0, synapse-1.0, xalan-2.4
- SOFTLAB: AR1, AR3, AR4, AR5, AR6
Белгилердин саны болжол менен 20дан 61ге чейин өзгөрөт.
Эң жогорку тең салмаксыздык катышы PROMISE camel-1.0 маалымат топтомунда:
\[ IR=25.08 \]
деп билдирилет.
Беш максаттуу классификатор
- K-Nearest Neighbors (KNN)
- Random Forest (RF)
- Decision Tree (TREE)
- Logistic Regression (LR)
- Naive Bayes (NB)
Булак аларды scikit-learnдеги демейки параметрлер менен колдонот.
Алты baseline
- UFIDSF
- SB-GAN
- Cluster-based undersampling
- Random Undersampling
- Borderline-SMOTE
- SMOTE
Тажрыйба протоколу
Алгач ар бир сандык белги:
\[ x_i^{(j)} \leftarrow \log(x_i^{(j)}+1) \]
өзгөртүүсүнөн өткөрүлөт.
Андан кийин stratified 5-fold cross-validation колдонулат. Resampling окутуу fold-унда гана жасалат. Test fold түпнуска класс бөлүштүрүлүшү менен бааланат.
Бүт процедура 10 ар башка random initialization менен кайталанып, натыйжалардын орточосу алынат.
Колдонулган натыйжалуулук көрсөткүчтөрү
Probability of Detection / Recall:
\[ PD= \frac{TP}{TP+FN} \]
Probability of False Alarm:
\[ PF= \frac{FP}{TN+FP} \]
Balance:
\[ Balance = 1- \frac{ \sqrt{ PF^2+(1-PD)^2 } }{ \sqrt2 } \]
Мындан тышкары AUC жана MCC колдонулат.
MCC айрыкча тең салмаксыз классификацияда пайдалуу, анткени TP, TN, FP жана FNнин баарын чогуу эске алат:
\[ MCC= \frac{ TP\times TN-FP\times FN }{ \sqrt{ (TP+FP)(TP+FN)(TN+FP)(TN+FN) } }. \]
AIIUS башка кайра үлгүлөө ыкмаларына салыштырмалуу кандай натыйжа берет?
Булактын жалпы жыйынтыгына ылайык, AIIUS өкүлчүлүктүү baseline ыкмаларына салыштырмалуу орточо Balance боюнча %9,50, AUC боюнча %3,43 жана MCC боюнча %17,02 өсүш берет. Эң туруктуу артыкчылык MCC жана Balance боюнча көрүнөт; бирок ыкма ар бир classifier-metric айкалышында биринчи эмес.
Balance натыйжалары
| Классификатор | AIIUS Balance | Натыйжанын орду |
|---|---|---|
| KNN | 0,688 | Эң жогорку орточо |
| LR | 0,698 | Эң жогорку орточо |
| NB | 0,650 | Эң жогорку эмес |
| RF | 0,732 | Эң жогорку орточо |
| TREE | 0,662 | Эң жогорку орточо |
Мисалы, RF үстүндө UFIDSFтин PD мааниси жогору болгону менен PF мааниси да 0,350гө чейин көтөрүлөт. AIIUS болсо PD=0,768 жана PF=0,189 айкалышы менен жогорураак Balance=0,732 берет.
Бул натыйжа AIIUS көбүрөөк кемчилик табууну гана эмес, кемчиликти табуу менен жалган эскертүүнүн ортосундагы тең салмакты көздөөрүн көрсөтөт.
AUC натыйжалары
AIIUSтун орточо AUC маанилери:
- KNN: 0,723
- LR: 0,755
- NB: 0,691
- RF: 0,760
- TREE: 0,689
RF жана TREEде AIIUS эң жогорку орточо AUC берет. KNN, LR жана NBде болсо айрым baseline-дар жогорураак мааниге жетет.
MCC натыйжалары
AIIUSтун орточо MCC маанилери:
| Классификатор | AIIUS MCC |
|---|---|
| KNN | 0,316 |
| LR | 0,330 |
| NB | 0,299 |
| RF | 0,387 |
| TREE | 0,274 |
AIIUS KNN, NB, RF жана TREEде эң жогорку орточо MCCге жетет. LRде эң жогорку натыйжа SMOTEтун 0,338 мааниси; AIIUS 0,330 менен андан бир аз төмөн калат.
Random Forest үчүн көңүл бурчу натыйжа
Random Forest үчүн орточо MCC:
| Ыкма | Орточо MCC |
|---|---|
| AIIUS | 0,387 |
| UFIDSF | 0,310 |
| SB-GAN | 0,323 |
| Cluster | 0,269 |
| RUS | 0,325 |
| Borderline-SMOTE | 0,335 |
| SMOTE | 0,337 |
AIIUS, UFIDSF менен маалымат-топтому боюнча салыштырууда RF астында 18/0/0 Win/Draw/Loss натыйжасын алат.
K-Means баскычы эмне үчүн керек?
K-Means эсептөө чыгымын азайтуу үчүн гана колдонулбайт. Изилдөөнүн негиздемеси боюнча чечим чегине өтө жакын үлгүлөрдү гана сактоо көпчүлүк класстын коопсуз жана тыгыз аймактарын таптакыр өкүлсүз калтырышы мүмкүн. Адегенде бөлүштүрүүнүн ар башка аймактарынан өкүлдөрдү алуу, андан кийин алардын арасынан influence негизинде тандоо ушул эки максатты айкалыштырууга аракет кылат.
Clustering-ratio тажрыйбасы
Булак төмөнкү орнотууларды салыштырат:
- No-cluster
- \(1\times|S_{\mathrm{min}}|\)
- \(2\times|S_{\mathrm{min}}|\)
- \(3\times|S_{\mathrm{min}}|\)
- \(3.5\times|S_{\mathrm{min}}|\)
Жалпы жыйынтык:
\[ \boxed{\lambda=3} \]
орнотуусу орточо натыйжалуулук менен маалымат топтомдорунун ортосундагы туруктуулуктун эң тең салмактуу тандоосу болуп саналат.
Бул натыйжа бардык classifier-лар үчүн монотондуу эмес. Мисалы, KNN no-cluster шартында айрым орточо көрсөткүчтөрдө жакшыраак болушу мүмкүн; бирок стандарттык четтөөнүн жогору болушу ыкма маалыматты бөлүүгө көбүрөөк сезгич болгонун көрсөтөт.
PCA визуалдаштыруу
NASA PC4 мисалында булак үч баскычтуу PCA визуалдаштыруусун берет:
- Түпнуска тең салмаксыз маалымат,
- K-Meansтен кийинки өкүл кемчиликсиз үлгүлөр,
- Adversarial Influence тандоосунан кийинки тең салмактуу маалымат.
Бул визуал AIIUS «көпчүлүк классты туш келди кесүүнүн» ордуна эки баскычтуу бөлүштүрүү + чечим-сезгичтик ыкмасын колдонорун түшүндүрөт.
Татаалыраак surrogate модель AIIUSту жакшыртабы?
Булакта стандарттуу MLP Deep-MLP, CNN жана ResNet surrogate архитектуралары менен салыштырылат. Натыйжалар татаалыраак surrogate моделдер MCC жагынан туруктуу жана чоң артыкчылык бербегенин көрсөтөт. Бул маалымат масштабы үчүн стандарттуу MLP жетиштүү чечим-функциясын жакындатуу катары колдонулат.
| Классификатор | MLP | Deep-MLP | CNN | ResNet |
|---|---|---|---|---|
| KNN | 0,316 | 0,316 | 0,314 | 0,315 |
| LR | 0,330 | 0,298 | 0,316 | 0,311 |
| NB | 0,299 | 0,301 | 0,301 | 0,299 |
| RF | 0,387 | 0,390 | 0,382 | 0,385 |
| TREE | 0,274 | 0,279 | 0,281 | 0,275 |
Бул жерде максат surrogate максаттуу модель менен толук бирдей болушу эмес; adversarial пертурбация түзүү үчүн максаттуу чечим жүрүм-турумун жетиштүү деңгээлде жакын чагылдыруу.
AIIUSтун эсептөө чыгымы
Биринчи баскычта K-Means болжол менен:
\[ O( |S_{\mathrm{maj}}| K d I_{\mathrm{km}} ) \]
чыгымына ээ.
Surrogate окутуу:
\[ O(ENd) \]
ал эми PGD бөлүгү болжол менен:
\[ O(KT) \]
деп берилет.
Target classifier суроолору:
\[ O(KC_{\mathrm{target}}) \]
жана influence упайларын иреттөө:
\[ O(K\log K) \]
чыгымына ээ.
Булак K-Means жана үйрөнүү итерацияларын практикада кичинекей туруктуулар катары алып, жалпы түзүмдү болжол менен
\[ O\!\left( (|S_{\mathrm{maj}}||S_{\mathrm{min}}|+N)d \right) \]
түрүндө жыйынтыктайт.
Изилдөө колдогон жыйынтыктар
- Чечим чегинин сезгичтиги көпчүлүк-класс үлгүлөрүн тандоо үчүн колдонулуучу сигнал катары иштей алат.
- AIIUS 18 SDP маалымат топтомунда көп baseline-дарга каршы өзгөчө MCC жана Balance боюнча күчтүү натыйжаларды көрсөткөн.
- K-Means менен орточо көлөмдөгү талапкерлер топтомун түзүү натыйжалуулук менен туруктуулукту бирге жакшырта алат.
- Булакта \(3\times\) clustering катышы жалпысынан эң тең салмактуу иш чекити болуп саналат.
- Стандарттуу MLP surrogate бул тажрыйбаларда татаалыраак surrogate архитектуралардан туруктуу түрдө начар эмес.
- Black-box максаттуу классификаторлордо surrogate аркылуу түзүлгөн пертурбациялар instance ranking максатында колдонулушу мүмкүн.
Изилдөө колдобогон чечмелөөлөр
- AIIUS ар бир маалымат топтомунда, classifier жана метрикада эң жакшы ыкма эмес.
- Adversarial Influence чечим чегине чейинки так геометриялык аралыкты өлчөбөйт.
- Жогорку influence үлгүнү алып салуу кайра окутулган чечим чегин так канчалык өзгөртөрүн түздөн-түз көрсөтпөйт.
- Изилдөө adversarial чабуул иштеп чыгууну максат кылбайт; пертурбациялар үлгүнүн маанилүүлүгүн өлчөө үчүн колдонулат.
- Натыйжалар бардык тең салмаксыз классификация көйгөйлөрүнө автоматтык түрдө жалпыланбайт.
- Чоңураак же убакыт-критикалык маалымат чөйрөлөрүндө кошумча PGD жана surrogate чыгымы маанисиз экени көрсөтүлгөн эмес.
- Surrogate модель максаттуу чечим жүрүм-турумун жетиштүү чагылдыра албаса, influence иретинин сапаты төмөндөшү мүмкүн.
Булак жана Ыкма жөнүндө Эскертүү
Түпнуска аталыш: Decision-Boundary Aware Undersampling via Adversarial Influence for Imbalanced Software Defect Prediction
Авторлор: Shuo Feng, Rongping Li, Jacky Keung, Xiao Yu, Yucheng Shi, Mingliang Xu.
Corresponding author: Yucheng Shi.
Мекемелер: School of Computer Science and Artificial Intelligence, Zhengzhou University; Department of Computer Science, City University of Hong Kong; State Key Laboratory of Blockchain and Data Security, Zhejiang University.
Булак түрү: Программалык инженерия жана машина үйрөнүүсү тармагындагы эксперименттик изилдөө preprint-и.
Платформа: SSRN.
SSRN Abstract ID: 6963912.
DOI: 10.2139/ssrn.6963912.
SSRN жарыяланган күнү: 18-июнь 2026.
Рецензия абалы: Булак PDF анын рецензиядан өтпөгөн preprint экенин ачык көрсөтөт.
Автордук укук/лицензия мамилеси: Изилдөө 2026-жылдын июнунда SSRNге жүктөлгөн. SSRN кийин жарыялаган лицензия түшүндүрмөсү ачык лицензия мүмкүнчүлүгү киргизилгенге чейин демейки коргоо all-rights-reserved болгонун билдирет. Булакта ачык CC лицензиясы көрсөтүлбөгөндүктөн, Verianla тексти сактык кайра-колдонуу мамилеси менен даярдалган; булактын сүйлөмдөрү жана түпнуска фигура жайгашуулары кайра жарыяланган эмес.
Маалыматтар: 18 жалпыга ачык software defect prediction маалымат топтому; AEEEM, NASA, PROMISE жана SOFTLAB.
Классификаторлор: KNN, Random Forest, Decision Tree, Logistic Regression, Naive Bayes.
Baseline ыкмалары: UFIDSF, SB-GAN, Cluster, Random Undersampling, Borderline-SMOTE ve SMOTE.
Баалоо: Stratified 5-fold cross-validation, 10 кайталанган тажрыйба, MCC, AUC, Balance, PD жана PF.
Статистика: Wilcoxon signed-rank тести, Cliff's delta жана Win/Draw/Loss талдоосу.
Негизги методологиялык чектөө: Adversarial Influence surrogate аркылуу түзүлгөн пертурбациялардын target classifier божомолунда жараткан өзгөрүшүнө негизделет. Ошондуктан surrogate-target чечим функциясынын шайкештиги ыкманын негизги божомолдорунун бири.
Визуалдык кайра куруу: Абдан ылайыктуу. Толук оригиналдуу Verianla схемасы менен тең салмаксыз feature-space, K-Means өкүлдөрү, чечим чеги, adversarial пертурбация жебелери, influence ranking жана акыркы тең салмактуу маалымат топтому көрсөтүлүшү мүмкүн.
Verianla Live / Live Figure: Ылайыктуу. Үлгүлөр чечим мейкиндигинде кантип азайтылары жана жогорку-influence көпчүлүк үлгүлөрү гана кантип сакталарын туруктуу концептуалдык маалымат топтомунда анимация менен түшүндүрүүгө болот.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген