

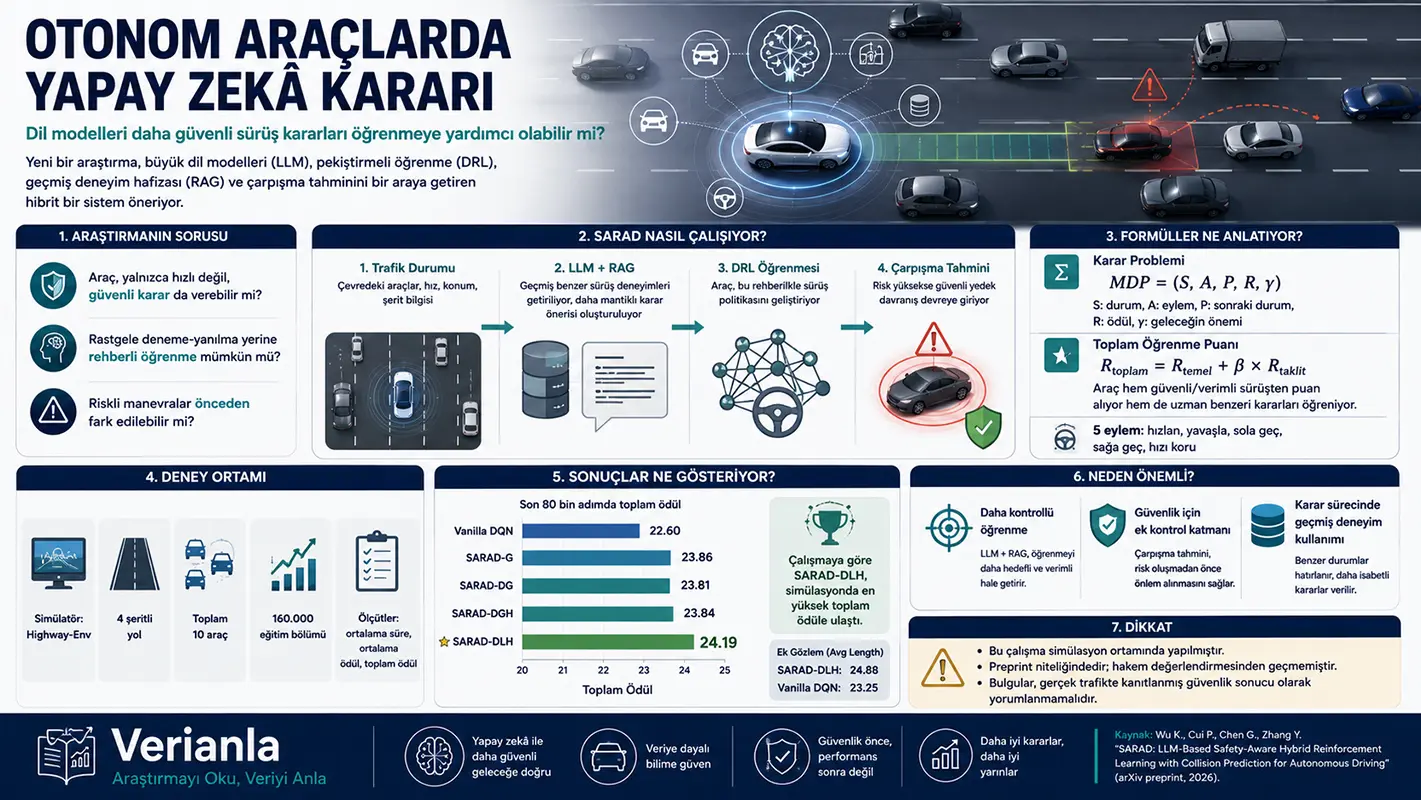
Avtonom transport uchun asosiy muammo: “Hozir nima qilishim kerak?”
Avtonom transport yo‘lda harakatlanayotganda doimiy qaror qabul qilishi kerak. Oldidagi transport sekinlashsa tormozlashi kerakmi? Yon chiziq bo‘sh bo‘lsa chiziq almashtirishi kerakmi? Tezlanish xavfsizmi? Yoki mavjud tezlikni saqlash to‘g‘riroqmi?
Inson haydovchilar bu qarorlarni tajriba, diqqat va sezgi bilan qabul qiladi. Sun’iy intellekt tizimlarida esa bu qarorlar raqamli ma’lumotlar bilan modellashtiriladi. Transport o‘z holatini, tezligini, atrofidagi transportlarning joylashuvi va harakatlarini baholab keyingi harakatni tanlashga harakat qiladi.
Ushbu maqolaning chiqish nuqtasi aynan shu yerda boshlanadi:
Avtonom transport ham tez, ham xavfsiz qaror qabul qila oladimi?
An’anaviy Chuqur Mustahkamlovchi O‘qitish usullari, ya’ni DRL, transportga sinab ko‘rish-xato qilish yo‘li bilan xulq o‘rgatadi. Ammo bu usul o‘rganishning dastlabki bosqichlarida tasodifiy harakatlarni sinab ko‘rishi mumkin. Avtonom haydash kabi xavfsizlik jihatidan muhim sohalarda bu jiddiy muammodir. Chunki real hayotda tasodifiy chiziq almashtirish, to‘satdan tezlanish yoki noto‘g‘ri vaqtda tormozlash qabul qilinadigan o‘rganish usuli emas.
Katta Til Modellarini esa transport holatini matn sifatida izohlab mantiqiyroq takliflar ishlab chiqishi mumkin. Ammo ularning ham boshqa muammosi bor: real vaqtda qaror qabul qilishda kechikish yuz berishi mumkin. Avtonom transportda qarorning faqat to‘g‘ri bo‘lishi yetarli emas; o‘z vaqtida berilishi ham kerak.
SARAD nomli tizim shu ikki yondashuvni birlashtirishga urinadi. Til modeli o‘rganishning erta bosqichida transportga mazmunliroq yo‘naltirish beradi. Mustahkamlovchi o‘qitish tizimi esa vaqt o‘tishi bilan tez qaror qabul qila oladigan siyosatni o‘rganadi. Qo‘shimcha ravishda, to‘qnashuvni bashorat qilish qatlami taklif etilgan qarorning xavfli yoki emasligini tekshiradi.
Tadqiqotchilar tizimni qanday qurgan?
Tadqiqotda avtonom transport muammosi qaror jarayoni sifatida modellashtiriladi. Buni soddalashtirib shunday tushunish mumkin:
Transport har lahzada atrofni kuzatadi. Bu kuzatuvda transportning o‘z holati va tezligi hamda boshqa transportlarning joylashuvi va tezlik ma’lumotlari bor. Keyin tizim beshta asosiy harakatdan birini tanlaydi:
- Tezlan
- Sekinlash
- Chapga chiziq almashtir
- O‘ngga chiziq almashtir
- Mavjud tezlikni saqla
Bu tuzilma maqolada Markov Decision Process, ya’ni Markov qaror jarayoni sifatida ta’riflanadi:
MDP = (S, A, P, R, γ)
Bu formulani o‘quvchi uchun shunday o‘qish mumkin:
S — transport ko‘rgan holat. Ya’ni yo‘l, transportlarning joylashuvi, tezliklar va atrof ma’lumoti.
A — transport tanlay oladigan harakatlar. Masalan, tezlanish yoki chiziq almashtirish.
P — bir harakatdan keyin muhitning qanday o‘zgarishi mumkinligini ifodalaydi.
R — tanlangan harakatning qanchalik yaxshi yoki yomonligini ko‘rsatadigan mukofot.
γ — tizimning kelajakdagi mukofotlarni qanchalik muhim deb bilishini belgilovchi koeffitsient.
Bu yerdagi mantiq sodda: Transport faqat “hozir nima yaxshi?” deb qaramaydi. Shu bilan birga “bu harakat birozdan keyin nimaga olib keladi?” savolini ham hisobga olishga harakat qiladi.
Transport atrofni qanday raqamga aylantiradi?
Maqolada transport ko‘rgan yo‘l muhiti quyidagi turdagi ma’lumotlar bilan ifodalanadi:
st = transportning joylashuvi + transportning tezligi + atrofidagi transportlarning joylashuvi va tezligi
Ya’ni tizim uchun transport sahna aslida foto emas, raqamli jadvalga o‘xshaydi. Har bir transport uchun taxminan quyidagi ma’lumotlar ishlatiladi:
- x joylashuvi
- y joylashuvi
- x yo‘nalishidagi tezligi
- y yo‘nalishidagi tezligi
Buni kundalik til bilan shunday aytish mumkin:
Avtonom transport “oldimdagi transport mendan necha metr oldinda, qanday tezlikda ketmoqda, yon chiziqdagi transport menga yaqinlashyaptimi?” kabi ma’lumotlarni raqamli kuzatadi.
Bu muhim, chunki sun’iy intellekt qarorini shu raqamlar orqali beradi. Inson haydovchi oynadan qarab sezgi bilan qaror qabul qilsa, sun’iy intellekt atrofni koordinata va tezlik qiymatlari bilan tushunishga harakat qiladi.
Tizimning o‘rganish mantig‘i: yaxshi qarorga mukofot, xavfli qarorga jarima
Mustahkamlovchi o‘qitishda tizim qilgan harakatlaridan ball olib o‘rganadi. Maqoladagi mukofot tizimi ham shu mantiqqa asoslanadi.
Tadqiqotchilar ikki turdagi mukofotdan foydalanadi:
Birinchisi, transportning o‘z haydash muvaffaqiyatini o‘lchaydigan asosiy mukofot. Transport xavfsiz va samarali harakatlansa mukofot oshadi. To‘qnashuv bo‘lsa jarima oladi.
Ikkinchisi, til modeli taklif qilgan xulqqa yaqinlik bilan bog‘liq qo‘shimcha mukofot. Bu transportning o‘rganish davomida butunlay tasodifiy harakat qilishi o‘rniga til modeli mantiqiyroq deb bilgan harakatlarga yaqin qolishiga yordam beradi.
Maqolada bu umumiy tuzilma quyidagicha ko‘rsatiladi:
Rtotal = Rorigin + β × Rimit
Bu formulaning sodda ma’nosi shunday:
Jami o‘rganish bali = haydashdan kelgan asosiy ball + til modeli taklifiga yaqinlikdan kelgan qo‘shimcha ball
Bu yerdagi Rorigin — transportning tezlik, oldinga siljish va to‘qnashuv holatiga ko‘ra olgan asosiy bali.
Rimit — transport harakatining til modeli qo‘llab-quvvatlagan “mutaxassis taklifiga” qanchalik o‘xshashligini ifodalaydi.
β — shu qo‘shimcha mukofotning jami qarorda qanchalik ta’sirli bo‘lishini belgilovchi og‘irlik.
Bu nuqtada muhim farq bor: Tizim til modelini ko‘r-ko‘rona taqlid qilmaydi. Til modeli o‘qituvchi kabi ishlaydi, lekin yakuniy qaror o‘rganish tizimi tomonidan vaqt o‘tishi bilan rivojlantiriladi. Bu “o‘qituvchili o‘rganish” bilan “o‘z tajribasi orqali o‘rganish” o‘rtasidagi ko‘prik sifatida tushunilishi mumkin.
SARAD’ning uch asosiy qismi
Maqolada berilgan tizim sxemasiga ko‘ra SARAD uch asosiy qismdan iborat.
Birinchi qism — DRL tizimi. Bu bo‘lim transportning haydash siyosatini o‘rganadi. Ya’ni qaysi holatda qaysi harakat mosroq bo‘lishini vaqt o‘tishi bilan rivojlantiradi.
Ikkinchi qism — LLM va RAG tizimi. LLM, ya’ni Katta Til Modeli, transport sahnasini matn sifatida izohlaydi. RAG tizimi esa o‘tmishdagi haydash tajribalaridan o‘xshash holatlarni topib til modeliga yordam beradi. Shunday qilib model faqat umumiy bilimiga emas, ilgari yozib olingan o‘xshash haydash misollariga tayangan holda qaror ishlab chiqadi.
Uchinchi qism — to‘qnashuvni bashorat qilish moduli. Bu modul taklif etilgan harakatning xavfli yoki emasligini bashorat qilishga urinadi. Agar tizim “bu harakat to‘qnashuv xavfini o‘z ichiga olishi mumkin” degan xulosaga kelsa, qoidalarga asoslangan xavfsizlik xulqi ishga tushishi mumkin.
Bu tuzilmani inson haydovchi misoli bilan o‘ylaylik:
- DRL — doimiy mashq qilayotgan haydovchiga o‘xshaydi.
- LLM — tajribali murabbiyning izohlariga o‘xshaydi.
- RAG — o‘tmishda yuz bergan o‘xshash voqealar xotirasiga o‘xshaydi.
- To‘qnashuvni bashorat qilish moduli esa “to‘xta, bu harakat xavfli bo‘lishi mumkin” degan xavfsizlik nazoratiga o‘xshaydi.
RAG tizimi nima uchun kerak?
RAG — “Retrieval-Augmented Generation” iborasining qisqartmasi. O‘zbekchaga taxminan “qayta olish bilan kuchaytirilgan ishlab chiqarish” deb tarjima qilinishi mumkin.
Bu tizimning maqsadi til modelining faqat o‘z umumiy bilimiga tayanishini oldini olishdir. SARAD’da transport haydash paytida ba’zi tajribalarni yozib oladi. Masalan:
- Qaysi holatda qaysi qaror berildi?
- Bu qaror xavfsiz midimi?
- To‘qnashuv bo‘ldimi?
- Transport qanday tezlikda edi?
- Yaqin atrofdagi transportlar qanday harakatlandi?
Keyinroq o‘xshash holat uchraganda tizim o‘tmishdagi o‘xshash tajribalarni olib keladi va til modeliga yordamchi ma’lumot sifatida taqdim etadi.
Bu kundalik hayotda quyidagiga o‘xshaydi:
Haydovchi avvalroq xavfli chorrahada to‘satdan chiziq almashtirishning riskli ekanini boshidan o‘tkazgan bo‘lsa, o‘xshash holatda ehtiyotkorroq tutishi mumkin. SARAD’ning RAG moduli ham sun’iy intellektga shunga o‘xshash xotira berishga urinadi.
To‘qnashuvni bashorat qilish moduli nima uchun muhim?
Bu tadqiqotning eng muhim xavfsizlik qismlaridan biri to‘qnashuvni bashorat qilish moduli. Chunki sun’iy intellekt taklif qilgan har bir qaror to‘g‘ri bo‘lmasligi mumkin.
Maqolada bu modul taklif etilgan harakatning to‘qnashuv xavfini o‘z ichiga olishi yoki olmasligini bashorat qilish uchun mo‘ljallangan. Tizim holat va harakat ma’lumotini oladi; so‘ng bu harakatning xavfli yoki emasligini baholaydi.
Sodda tarzda shunday tushunish mumkin:
Transport “chap chiziqqa o‘t” qarorini ishlab chiqsa, xavfsizlik moduli shunday so‘raydi:
“Chap chiziqqa o‘tsak, yaqin atrofdagi transportlar bilan to‘qnashuv ehtimoli bormi?”
Agar xavf yuqori ko‘rinsa, tizim bu qarorni bevosita qo‘llash o‘rniga xavfsizroq xulqqa o‘tishi mumkin. Maqolada bunday zaxira xavfsizlik xulqlari orasida favqulodda tormozlash, chiziqda qolish va xavfsiz masofani saqlash kabi variantlar ko‘rsatiladi.
Bu bo‘lim muhim, chunki avtonom tizimlarda faqat qaror ishlab chiqish yetarli emas. Qaror qo‘llanilishidan oldin xavfsizlik jihatidan tekshirilishi kerak.
Tajriba qanday o‘tkazilgan?
Tadqiqotchilar tizimni real trafikda emas, Highway-Env nomli simulyatsiya muhitida sinab ko‘rgan. Simulyatsiyada to‘rt chiziqli yo‘l ishlatilgan. Har bir chiziq 4 metr kenglikda ta’riflangan. Muhitda jami 10 ta harakatlanuvchi transport bor; ulardan biri qaror qabul qiluvchi avtonom transport.
Transportlar tanlay oladigan harakatlar yana beshta variant bilan cheklangan:
- Chapga chiziq almashtir
- O‘ngga chiziq almashtir
- Tezlan
- Sekinlash
- Tezlikni saqla
Tajribalarda bir bo‘lim, ya’ni episode, ikki holatda tugaydi: Transport to‘qnashsa yoki haydash muddati 40 soniyadan oshsa.
Tadqiqotchilar muvaffaqiyatni uch mezon bilan baholagan:
1. O‘rtacha haydash muddati
Transport to‘qnashmasdan yoki bo‘lim tugamasdan qancha vaqt harakatlana oldi?
2. O‘rtacha mukofot
Transport har qadamda qanchalik yaxshi qarorlar berdi?
3. Jami mukofot
Butun bo‘lim davomida to‘plangan umumiy ko‘rsatkich qanday bo‘ldi?
Bu uch mezon birgalikda o‘qilishi kerak. Faqat uzoq vaqt ketish yetarli emas; transport bir vaqtning o‘zida samarali va xavfsiz qarorlar ham berishi kerak.
Grafiklar va jadvallar nima ko‘rsatadi?
Maqolada turli SARAD versiyalari klassik DQN usuli bilan solishtirilgan.
Klassik DQN — mustahkamlovchi o‘qitishning asosiy usullaridan biri. Bu tadqiqotda solishtirish nuqtasi sifatida ishlatilgan. SARAD versiyalari esa tizimga turli qo‘shimcha qismlar qo‘shilgan holatlardir.
II-jadval butun o‘qitish jarayoni davomida olingan natijalarni ko‘rsatadi. Bu yerda SARAD-DGH modeli o‘rtacha mukofot va jami mukofot jihatidan eng yuqori qiymatni oladi. SARAD-DLH esa o‘rtacha haydash uzunligi jihatidan ajralib turadi.
Masalan, butun jarayonda:
- Vanilla DQN jami mukofot: 20.6767
- SARAD-DGH jami mukofot: 21.5301
- SARAD-DLH jami mukofot: 21.4075
Bu jadval SARAD oilasidagi modellerining simulyatsiya ichida klassik DQN’ga nisbatan yaxshiroq natijalar ishlab chiqishi mumkinligini ko‘rsatadi.
III-jadval esa o‘qitishning so‘nggi 80 ming qadamiga qaraydi. Bu bo‘lim muhim, chunki modelning o‘rganish jarayoni yanada yetilgan bosqichini ko‘rsatadi.
So‘nggi 80 ming qadamda:
- Vanilla DQN jami mukofot: 22.5967
- SARAD-G jami mukofot: 23.8556
- SARAD-DG jami mukofot: 23.8098
- SARAD-DGH jami mukofot: 23.8439
- SARAD-DLH jami mukofot: 24.1935
Bu natijalarda SARAD-DLH eng yuqori jami mukofotga erishadi. SARAD-DLH modelida LLM asosidagi to‘qnashuvni bashorat qilish moduli va RAG qo‘llab-quvvatlangan tuzilma birgalikda ishlatiladi. Bu esa tadqiqotchilar taklif qilgan xavfsizlik qatlamining o‘rganishning so‘nggi bosqichlarida kuchliroq ko‘rsatkich berishi mumkinligini ko‘rsatadi.
Grafiklarda ham o‘xshash tendensiya ko‘rinadi. O‘qitish ilgarilagan sari barcha modellerining ko‘rsatkichi oshadi. Ammo SARAD modelleri ayniqsa keyingi bosqichlarda DQN’ga nisbatan yuqoriroq va barqarorroq chiziqlarga chiqishi mumkin. Shunday bo‘lsa-da, maqola grafiklarning bitta vakillik o‘qitish ishini ko‘rsatishini qayd etadi. Shu sababli natijalar kuchli ishora bersa-da, turli senariylar bilan qayta sinab ko‘rilishi kerak.
Bu tadqiqotdan nima o‘rganamiz?
Bu maqola bizga muhim fikr beradi: Sun’iy intellekt tizimlarida bitta usulga ishonish o‘rniga turli usullarni birgalikda ishlatish muvozanatliroq natijalar berishi mumkin.
Mustahkamlovchi o‘qitish tez qaror olishni o‘rganishi mumkin, ammo boshida xavfli sinovlar qilishi mumkin. Katta til modelleri tushuntiriladigan va mantiqiyroq takliflar berishi mumkin, ammo real vaqtdagi qaror uchun sekin qolishi mumkin. RAG tizimi o‘tmish tajribasini ishga solishi mumkin. To‘qnashuvni bashorat qilish moduli esa taklif etilgan qarorlarni xavfsizlik nazoratidan o‘tkazishi mumkin.
Bu uyg‘unlashuv avtonom transport tadqiqotlarida xavfsizroq va tushuntiriladiganroq qaror tizimlarini rivojlantirish uchun muhim yo‘nalish beradi.
Bu yerdagi asosiy dars shunday:
Avtonom transportlarda sun’iy intellekt faqat “nima qilishni” bilmasligi kerak; shu bilan birga “bu qaror xavfsizmi?” savolini ham berishi kerak.
Bu nima uchun muhim?
Avtonom haydash texnologiyalari nafaqat avtomobillar, balki kelajakda logistika, jamoat transporti, robototexnika tizimlari, aqlli shaharlar va sanoat avtomatizatsiyasi uchun ham muhim.
Bunday tizimlarda qaror xatosi faqat texnik xato emas; xavfsizlik riskini keltirib chiqarishi mumkin. Shu sababli sun’iy intellekt modellerining faqat yuqori ko‘rsatkich berishi yetarli emas. Qaror jarayonlarining kuzatiladigan, tushuntiriladigan va xavfsizlik qatlamlari bilan qo‘llab-quvvatlangan bo‘lishi kerak.
SARAD yondashuvi shu jihatdan o‘rgatuvchi misol beradi. Tizim til modelini bevosita haydovchi o‘rindig‘iga o‘tqazmaydi. Buning o‘rniga til modelini yo‘riqnoma, mustahkamlovchi o‘qitishni haydash siyosati o‘rganuvchisi, to‘qnashuvni bashorat qilish modulini esa xavfsizlik nazorat nuqtasi sifatida ishlatadi.
Bu farq muhim. Chunki real dunyoda xavfsizlik jihatidan muhim tizimlarda sun’iy intellekt qarorlarining nazoratsiz qo‘llanilishi o‘rniga qatlamli nazorat tuzilmalari mazmunliroq tadqiqot yo‘nalishi bo‘lishi mumkin.
E’tibor berilishi kerak bo‘lgan nuqtalar
Bu tadqiqotning natijalari ehtiyotkorlik bilan o‘qilishi kerak.
Birinchidan, tadqiqot real trafikda emas, simulyatsiya muhitida o‘tkazilgan. Simulyatsiyalar tadqiqot uchun foydali, ammo real yo‘lda inson xulqi, ob-havo sharoitlari, sensor xatolari, yo‘l nuqsonlari va kutilmagan voqealar ancha murakkabroq.
Ikkinchidan, tadqiqot preprint. Ya’ni peer-reviewdan o‘tmagan. Natijalar mustaqil akademik baholash va turli tajribalar bilan qo‘llab-quvvatlanmasdan aniq qabul qilinmasligi kerak.
Uchinchidan, maqoladagi grafiklar bitta vakillik o‘qitish ishini ko‘rsatadi. Turli boshlang‘ich sharoitlar va turli transport senariylari natijalarni o‘zgartirishi mumkin.
To‘rtinchidan, LLM asosidagi tizimlarda kechikish hali ham muhim muammo. Tadqiqotchilar bu kechikishni kamaytirish uchun LLM’dan foydalanishni ko‘proq o‘rganishning erta bosqichida qo‘llashni taklif qiladi. Ammo real vaqtdagi avtonom haydash tizimlarida bu mavzu juda ehtiyotkorlik bilan sinab ko‘rilishi kerak.
Nihoyat, to‘qnashuvni bashorat qilish moduli xavfsizlik jihatidan muhim g‘oya bersa-da, bunday tizimning real trafikda ishlatilishi uchun ancha kengroq sinovlar, xavfsizlik tekshiruvlari va huquqiy/texnik baholashlar kerak.
Xulosa
SARAD tadqiqoti avtonom transportlarda sun’iy intellekt qarorlarining qanday qilib xavfsizroq va o‘rgatuvchiroq qilinishi mumkinligiga oid e’tiborga molik tadqiqot misolini beradi. Model transportning butunlay tasodifiy sinab ko‘rish-xato qilish bilan o‘rganishi o‘rniga katta til modeli yo‘naltirishi, o‘tmish tajriba xotirasi va to‘qnashuvni bashorat qilish qatlamidan foydalanadi.
Simulyatsiya natijalari bu gibrid yondashuvning klassik DQN usuliga nisbatan ba’zi ko‘rsatkichlarda yaxshiroq natijalar berishi mumkinligini ko‘rsatadi. Ammo bu natijalar real trafik uchun bevosita xavfsizlik isboti emas.
Shunday bo‘lsa-da, tadqiqot sun’iy intellekt tadqiqotlarida muhim nuqtani eslatadi:
Kelajakning aqlli tizimlari faqat tez qaror beradigan emas, qarorlarini o‘tmish tajriba bilan solishtiradigan, xavflarni oldindan baholaydigan va zarurat bo‘lsa xavfsiz alternativaga qayta oladigan tizimlar bo‘lishi kerak.
Manba va usul eslatmasi
Ushbu material Kangyu Wu, Peng Cui, Guoxi Chen va Ya Zhang tomonidan tayyorlangan “SARAD: LLM-Based Safety-Aware Hybrid Reinforcement Learning with Collision Prediction for Autonomous Driving” nomli akademik ishdan foydalanib, Verianla tahririyat formatida o‘ziga xos tarzda tayyorlangan.
Bu tadqiqot preprint xususiyatiga ega va peer-reviewdan o‘tmagan. Material axborot va ta’lim maqsadini ko‘zlaydi. Avtonom transport ishlab chiqish, transport xavfsizligi, muhandislik amaliyoti yoki sun’iy intellekt tizimi loyihalash bo‘yicha professional maslahat o‘rnini bosmaydi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan